La manipulation manuelle des données retarde les résultats et freine l'avancement des projets. C'est pourquoi les data engineers et les analystes recherchent en permanence des LLM plus rapides et moins coûteux pour leurs tâches quotidiennes.
Dolly est un modèle d'IA open source développé par Databricks qui peut, entre autres, aider les analystes, les ingénieurs et d'autres professionnels à simplifier leur travail dans de nombreux secteurs. Étant open source, chacun peut utiliser son code d'entraînement pour créer des LLM plus performants et personnalisés selon ses besoins.
Découvrons tout cela dans notre tutoriel Databricks Dolly.
Pourquoi Databricks Dolly ?
Ce qui rend Databricks Dolly particulièrement intéressant par rapport à d'autres outils, c'est son approche de la personnalisation pour des entreprises de toutes tailles. Il transforme les LLM, technologies autrefois exclusives et onéreuses, en outils polyvalents que chaque entreprise peut s'approprier et adapter.
Source : Databricks
Les atouts de Dolly
Voici comment Dolly peut vous aider :
- Personnalisation : Adapte les LLM aux besoins de votre organisation pour faciliter la gestion des workflows.
- Économique : Permet de créer à moindre coût des modèles d'instruction personnalisés, de manière efficace.
- Agile : Donne aux entreprises les moyens d'optimiser leurs workflows de données, d'automatiser des processus complexes et de générer des insights plus efficacement.
- Accessible : Améliore l'efficacité opérationnelle en rendant l'IA avancée plus accessible et adaptable aux cas d'usage métier.
- Sécurisé : Offre une alternative crédible pour développer des applications d'IA sans les risques de sécurité ou de conformité souvent associés aux outils reposant sur des API.
Vous voulez en savoir plus sur les capacités des grands modèles de langage ? Suivez ce cours sur les concepts des LLM.
Premiers pas avec Databricks Dolly
Voyons maintenant comment tirer le meilleur parti de Dolly selon vos besoins.
Aperçu des fonctionnalités de Databricks Dolly
Dolly est affiné sur un jeu de données spécialisé, databricks-dolly-15k, pour offrir des fonctionnalités proches de celles de modèles plus massifs comme GPT. Vous pouvez ainsi créer des LLM personnalisés pour brainstormer des idées, générer du texte et exécuter des tâches spécifiques à la demande.
Configurer votre environnement avec Databricks Dolly
Suivez ces instructions pour préparer votre environnement Databricks Dolly et générer des réponses.
Si vous disposez d'une machine équipée de GPU A100, vous pouvez utiliser ce modèle avec la bibliothèque transformers.
Étape 1 : Exécutez le code suivant dans votre notebook Databricks pour installer les bibliothèques transformers et accelerate :
%pip install "accelerate>=0.16.0,<1" "transformers[torch]>=4.28.1,<5" "torch>=1.13.1,<2"Étape 2 : Importez ensuite pipeline depuis la bibliothèque transformers :
from transformers import pipeline
import torch
instruct_pipeline = pipeline(model="databricks/dolly-v2-12b", torch_dtype=torch.bfloat16, trust_remote_code=True, device_map="auto")
Étape 3 : Vous pouvez alors générer des réponses avec la pipeline :
instruct_pipeline("Explain to me the difference between nuclear fission and fusion.")Utiliser le LLM Databricks Dolly
Opérations de base avec Dolly
Voici quelques opérations de base que vous pouvez effectuer avec Dolly :
Génération de texte
- Les rédacteurs et créateurs de contenu peuvent générer des brouillons, des plans ou des textes aboutis sur n'importe quel sujet, gagnant ainsi du temps et de l'effort.
- Les entreprises et les marketeurs peuvent créer des accroches, des descriptions produit ou des campagnes marketing engageantes.
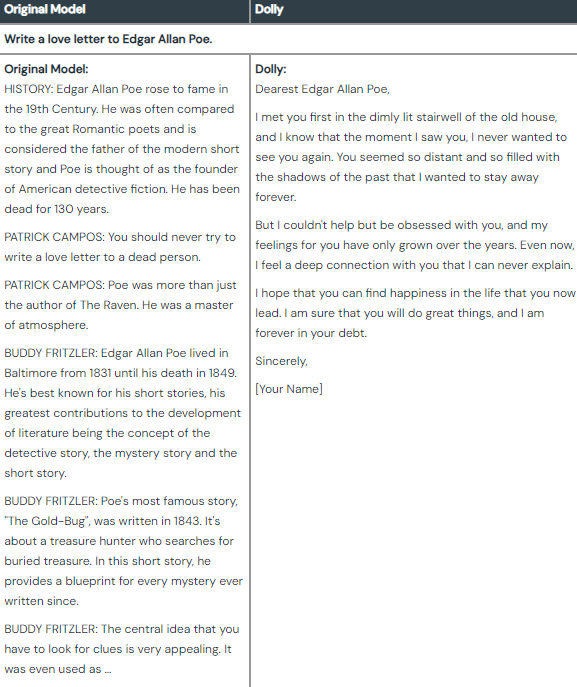
Différence entre le résultat du modèle d'origine et les résultats affinés de Dolly. [Source : Databricks]
Idéation (brainstorming)
- Les dirigeant·e·s et entrepreneur·e·s peuvent explorer de nouveaux produits, services ou modèles économiques potentiels.
- Les écrivain·e·s, artistes et designers peuvent utiliser Dolly comme source d'inspiration et d'idées originales pour nourrir leurs projets créatifs.
- Vous pouvez même l'utiliser pour réfléchir à des idées en contexte personnel, par exemple pour organiser un événement ou résoudre des défis du quotidien.

Différence entre le résultat du modèle d'origine et les résultats affinés de Dolly. [Source : Databricks]
Questions-réponses ouvertes
- Les étudiant·e·s peuvent poser des questions et obtenir des explications détaillées sur des sujets complexes.
- Les professionnel·le·s et chercheur·euse·s peuvent demander des informations de contexte sur des thématiques particulières.
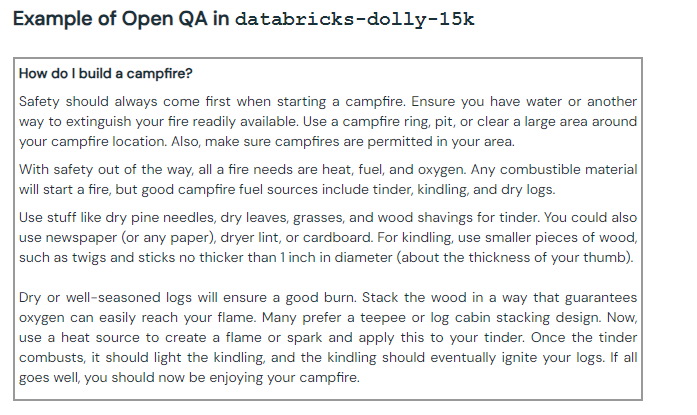
Exemple de question/réponse ouverte avec Dolly. [Source : Databricks]
Techniques avancées
Dolly ne se limite pas aux opérations de base : vous pouvez également lui appliquer plusieurs techniques avancées :
Affinage sur des données personnalisées
Vous pouvez utiliser de grands modèles de langage pré-entraînés comme base pour affiner vos propres LLM personnalisés. Vous améliorerez ainsi la capacité du modèle à suivre des instructions et pourrez effectuer des tâches adaptées à vos besoins.
Curation de données d'instruction spécifiques à un domaine
Pour spécialiser vos LLM dans des secteurs particuliers, complétez les données d'instruction standard avec des prompts sur mesure pour le domaine visé (santé, finance, ingénierie, etc.).
En affinant sur des jeux de données spécifiques contenant vocabulaire, formats et connaissances du domaine, le modèle fournit des sorties précises et pertinentes, contextualisées selon le langage et les conventions de ce secteur.
Intégrer des entrées de données dynamiques
Vous pouvez entraîner votre modèle à intégrer des entrées dynamiques comme des images, de la vidéo et de l'audio. Il ira ainsi au-delà du texte et pourra générer du contenu en s'appuyant simultanément sur plusieurs flux de données.
Créer des applications avec Databricks Dolly
Si la version initiale de Dolly offre des capacités opérationnelles de base, vous pouvez ajuster le modèle existant pour créer des applications comme des chatbots.
Créer un chatbot
Vous pouvez créer un chatbot personnalisé avec Databricks Dolly en deux grandes étapes.
Préparation des données et création d'une base vectorielle
Pour créer un chatbot, commencez par configurer la base vectorielle de Databricks (Chroma) afin de collecter et ingérer des données via Databricks Lakehouse, Delta Lake et Delta Live Tables.
Commencez par installer les bibliothèques nécessaires.
%pip install -U chromadb==0.3.22 langchain==0.0.164 transformers==4.29.0 accelerate==0.19.0Exécutez la commande suivante dans votre notebook Databricks.
%run ./_resources/00-init $catalog=hive_metastore $db=dbdemos_llmSupposons maintenant que vous construisiez un chatbot sur le jardinage.
Remarque : si vous souhaitez tester vous-même cette démo, assurez-vous d'installer db demos dans le notebook Databricks.
1. Comme nous utilisons un jeu de données de jardinage d'exemple depuis dbdemos, extrayez le dataset avec la commande « sh ».
%sh
#Pour rester simple, nous allons télécharger et extraire le dataset avec des commandes bash standard
#Installer 7zip pour extraire le fichier
apt-get install -y p7zip-full

rm -r /tmp/gardening
mkdir -p /tmp/gardening
cd /tmp/gardening
#Télécharger et extraire l'archive gardening
curl -L https://archive.org/download/stackexchange/gardening.stackexchange.com.7z -o gardening.7z
7z x gardening.7z
#Déplacer le dataset vers notre bucket principal
mkdir -p /dbfs/dbdemos/product/llm/gardening/raw
cp -f Posts.xml /dbfs/dbdemos/product/llm/gardening/raw
2. Vous pouvez maintenant vérifier les informations du dataset.
%fs ls /dbdemos/product/llm/gardening/raw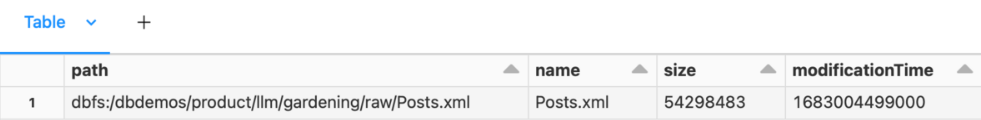
Nettoyage et préparation des questions/réponses :
1. Inspecter le dataset brut.
gardening_raw_path = demo_path+"/gardening/raw"

print(f"loading raw xml dataset under {gardening_raw_path}")

raw_gardening = spark.read.format("xml").option("rowTag", "row").load(f"{gardening_raw_path}/Posts.xml")
display(raw_gardening)
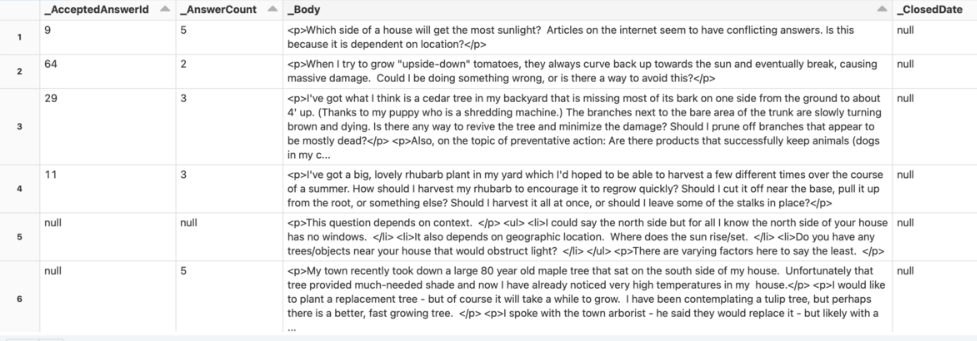
2. Le code ci-dessous convertit une chaîne au format HTML en texte et utilise BeautifulSoup pour analyser le HTML et extraire le texte.
from bs4 import BeautifulSoup

#UDF pour convertir du contenu html en texte

@pandas_udf("string")
def html_to_text(html):
  return html.apply(lambda x: BeautifulSoup(x).get_text())

gardening_df =(raw_gardening
                  .filter("_Score >= 5") # ne garder que les bonnes questions/réponses
                  .filter(length("_Body") <= 1000) # retirer les questions trop longues
                  .withColumn("body", html_to_text("_Body"))

#Convertir html en texte

                  .withColumnsRenamed({"_Id": "id", "_ParentId": "parent_id"})
                  .select("id", "body", "parent_id"))

# Sauvegarder le contenu 'brut' pour le chargement ultérieur des questions

gardening_df.write.mode("overwrite").saveAsTable(f"gardening_dataset")
display(spark.table("gardening_dataset"))
3. Associer maintenant les questions et les réponses.
gardening_df = spark.table("gardening_dataset")

# Auto-jointure pour assembler questions et réponses

qa_df = gardening_df.alias("a").filter("parent_id IS NULL") \
         .join(gardening_df.alias("b"), on=[col("a.id") == col("b.parent_id")]) \
         .select("b.id", "a.body", "b.body") \
         .toDF("answer_id", "question", "answer")

# Préparer le dataset d'entraînement : question suivie des meilleures réponses.

docs_df = qa_df.select(col("answer_id"), F.concat(col("question"), F.lit("\n\n"), col("answer"))).toDF("source", "text")
display(docs_df)
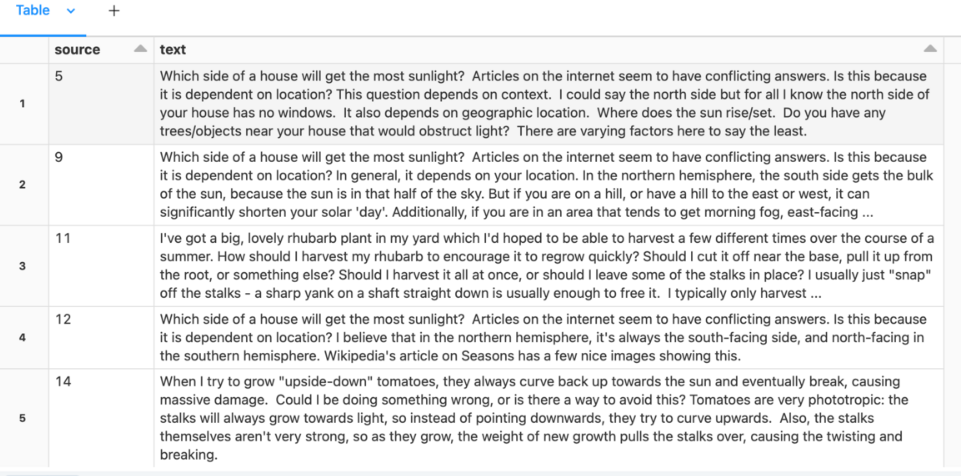
Convertir les documents en représentations vectorielles :
from langchain.embeddings import HuggingFaceEmbeddings

# Télécharger le modèle depuis Hugging Face

hf_embed = HuggingFaceEmbeddings(model_name="sentence-transformers/all-mpnet-base-v2")
Indexer les documents dans la base vectorielle Databricks pour une meilleure recherche :
dbutils.widgets.dropdown("reset_vector_database", "false", ["false", "true"], "Recompute embeddings for chromadb")
gardening_vector_db_path = demo_path+"/vector_db"

# Ne pas recalculer les embeddings s'ils sont déjà disponibles

compute_embeddings = dbutils.widgets.get("reset_vector_database") == "true" or is_folder_empty(gardening_vector_db_path)

if compute_embeddings:
  print(f"creating folder {gardening_vector_db_path} under our blob storage (dbfs)")
  dbutils.fs.rm(gardening_vector_db_path, True)
  dbutils.fs.mkdirs(gardening_vector_db_path)
4. Créez maintenant la base documentaire en stockant votre dataset dans la base vectorielle.
from langchain.docstore.document import Document
from langchain.vectorstores import Chroma

# Import si vous souhaitez diviser en fragments.
# from langchain.text_splitter import CharacterTextSplitter

all_texts = spark.table("gardening_training_dataset")

print(f"Saving document embeddings under /dbfs{gardening_vector_db_path}")

if compute_embeddings:

  # Convertir les lignes en Documents langchain.
  # Si vous souhaitez indexer sur des périodes plus courtes, utilisez plutôt le champ text_short.

  documents = [Document(page_content=r["text"], metadata={"source": r["source"]}) for r in all_texts.collect()]

  # Les phrases longues peuvent nécessiter une division. Mais il est préférable de résumer comme ci-dessus.

  # text_splitter = CharacterTextSplitter(separator="\n", chunk_size=1000, chunk_overlap=100)

  # documents = text_splitter.split_documents(documents)

  # Initialiser chromadb avec le modèle sentence-transformers/all-mpnet-base-v2 chargé depuis Hugging Face (hf_embed).

  db = Chroma.from_documents(collection_name="gardening_docs", documents=documents, embedding=hf_embed, persist_directory="/dbfs"+gardening_vector_db_path)
  db.similarity_search("dummy") # forcer la persistance des métadonnées (?)
  db.persist()
Cela enregistrera les embeddings de documents sous /dbfs/dbdemos/product/llm/vector_db
Et voilà : votre dataset de Q/R est prêt.
Cependant, une fois terminé, redémarrez votre noyau Python pour libérer la mémoire.
Conception de prompts pour questions/réponses
À cette étape, vous posez une question et le système recherche du contenu similaire dans le dataset de Q&R. Il construit ensuite un prompt contenant ce contenu et l'envoie à Dolly, qui génère une réponse à afficher à l'utilisateur.
Voici comment procéder :
- Téléchargez 2 embeddings depuis Hugging Face :
# Démarrez ici pour charger une base déjà sauvegardée

from langchain.embeddings import HuggingFaceEmbeddings
from langchain.vectorstores import Chroma

if len(get_available_gpus()) == 0:

 Exception("Running dolly without GPU will be slow. We recommend you switch to a Single Node cluster with at least 1 GPU to properly run this demo.")
gardening_vector_db_path = "/dbfs"+demo_path+"/vector_db"
hf_embed = HuggingFaceEmbeddings(model_name="sentence-transformers/all-mpnet-base-v2")

db = Chroma(collection_name="gardening_docs", embedding_function=hf_embed, persist_directory=gardening_vector_db_path)
2. Effectuez maintenant une recherche par similarité entre questions.
def get_similar_docs(question, similar_doc_count):
 return db.similarity_search(question, k=similar_doc_count)

# Testons avec les mûres :

for doc in get_similar_docs("how to grow blackberry?", 2):
 print(doc.page_content)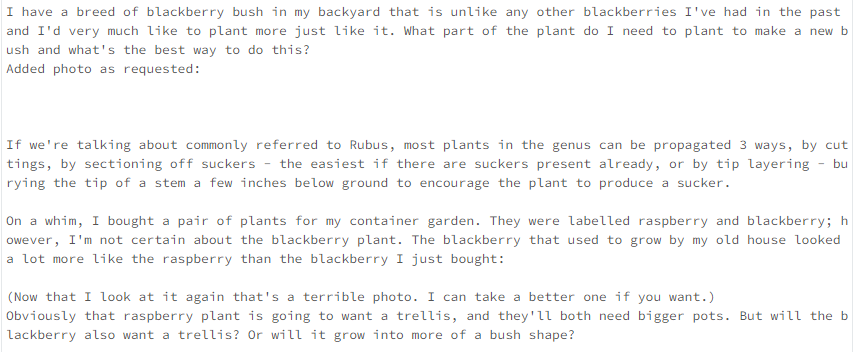
3. Utilisez un modèle de langage et un prompt pour construire, avec LangChain, un système qui répond aux questions.
from transformers import AutoTokenizer, AutoModelForCausalLM, pipeline
import torch
from langchain import PromptTemplate
from langchain.llms import HuggingFacePipeline
from langchain.chains.question_answering import load_qa_chain

def build_qa_chain():
  torch.cuda.empty_cache()
  model_name = "databricks/dolly-v2-7b" # vous pouvez utiliser dolly-v2-3b ou dolly-v2-7b pour des modèles plus petits et des inférences plus rapides.

  # Augmentez max_new_tokens pour une réponse plus longue
  # D'autres réglages peuvent améliorer les résultats ! Testez différentes valeurs
  instruct_pipeline = pipeline(model=model_name, torch_dtype=torch.bfloat16, trust_remote_code=True, device_map="auto",
                               return_full_text=True, max_new_tokens=256, top_p=0.95, top_k=50)
  # Remarque : si vous utilisez dolly 12B ou un modèle plus petit mais un GPU avec moins de 24 Go de RAM, utilisez le mode 8bit. Nécessite %pip install bitsandbytes
  # Définition du contenu de notre prompt.
  # langchain chargera nos documents similaires comme {context}
  template = """Below is an instruction that describes a task. Write a response that appropriately completes the request.

  Instruction:
  You are a gardener and your job is to help provide the best gardening answer.
  Use only information in the following paragraphs to answer the question at the end. Explain the answer with reference to these paragraphs. If you don't know, say that you do not know.

  {context}

  Question: {question}

  Response:
  """
  prompt = PromptTemplate(input_variables=['context', 'question'], template=template)

  hf_pipe = HuggingFacePipeline(pipeline=instruct_pipeline)
  # Définissez verbose=True pour voir le prompt complet :
  return load_qa_chain(llm=hf_pipe, chain_type="stuff", prompt=prompt, verbose=True)
# La construction de la chaîne va charger Dolly et peut prendre plusieurs minutes selon la taille du modèle
qa_chain = build_qa_chain()Les principaux réglages qui impactent les performances sont :
- « Max_new_tokens » : réduisez pour des sorties plus rapides et plus concises.
- « Num_beams » : avec la recherche par faisceaux, plus de faisceaux augmentent le temps d'exécution de manière approximativement linéaire.
4. C'est tout. Vous pouvez maintenant définir la fonction de réponse simple aux questions.
def answer_question(question):
 similar_docs = get_similar_docs(question, similar_doc_count=2)

 result = qa_chain({"input_documents": similar_docs, "question": question})
 result_html = f"<p><blockquote style=\"font-size:24\">{question}</blockquote></p>"
 result_html += f"<p><blockquote style=\"font-size:18px\">{result['output_text']}</blockquote></p>"
 result_html += "<p><hr/></p>"
 for d in result["input_documents"]:
   source_id = d.metadata["source"]
   result_html += f"<p><blockquote>{d.page_content}<br/>(Source: <a href=\"https://gardening.stackexchange.com/a/{source_id}\">{source_id}</a>)</blockquote></p>"
 displayHTML(result_html)
Vous pouvez maintenant lui poser une question liée au jardinage.
answer_question("What is the best kind of soil to grow blueberries in?")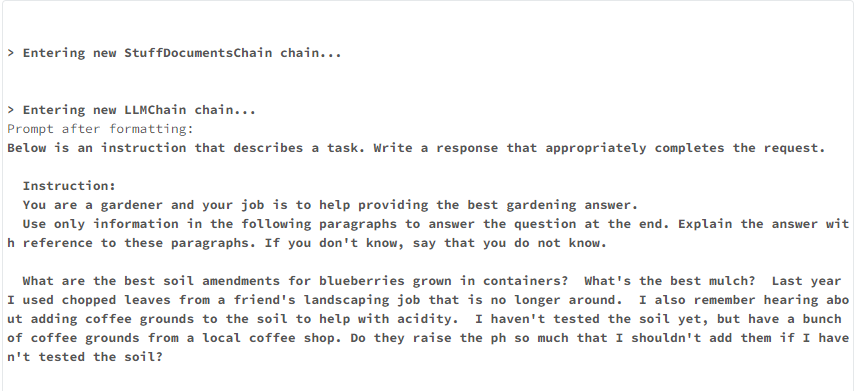
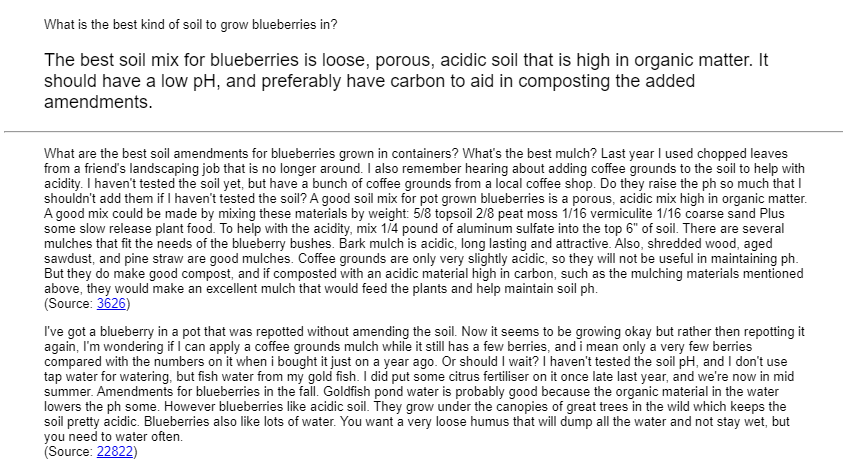
Consultez dbdemo pour créer un chatbot ici.
Cas d'usage concrets
Grâce à ses capacités avancées de TALN, les LLM personnalisés construits avec Dolly s'appliquent à de nombreux cas d'usage réels. En voici quelques exemples fréquents :
1. Synthèse automatisée de données pour les analystes financiers
Dolly peut traiter de grands jeux de données et produire des synthèses concises afin d'aider les analystes à saisir rapidement les éléments clés.
Par exemple, un chercheur en finance peut avoir besoin de comprendre rapidement les tendances historiques des cours boursiers. Dolly peut analyser les données et fournir une vue d'ensemble claire, lui faisant gagner un temps précieux.
2. Nettoyage et prétraitement des données dans la distribution
Dans les entreprises de retail, les analystes manipulent d'immenses datasets contenant des transactions issues de milliers de magasins. Or, les données brutes des magasins comportent souvent des incohérences, des valeurs manquantes, des doublons et d'autres erreurs.
Dolly peut identifier ces incohérences, valeurs manquantes et erreurs potentielles afin que les data scientists travaillent sur des données propres pour extraire des insights et créer des visualisations.
3. Veille continue de la recherche dans l'industrie pharmaceutique
Dans les laboratoires pharmaceutiques, les scientifiques doivent se tenir à jour des dernières publications dans plusieurs disciplines. Passer en revue manuellement des centaines d'articles chaque semaine est chronophage.
À la place, ils peuvent utiliser Databricks Dolly LLM pour analyser les articles et extraire les éléments clés comme les objectifs, méthodes, résultats et conclusions. Il peut agréger des synthèses multi-pages et mettre en avant les points saillants de chaque publication.
Défis et limites
Comme toute technologie de LLM pionnière, Dolly présente certaines limites et difficultés. Voici trois faiblesses principales de Dolly :
- Peut halluciner ou générer des réponses factuellement incorrectes, car il est entraîné sur un dataset bien plus petit que ChatGPT.
- Sa personnalisation et son affinage peuvent être complexes, nécessitant un certain niveau d'expertise en apprentissage automatique et en TALN.
- Rencontre des difficultés sur des questions mathématiques, des problèmes de programmation et l'ajout d'humour dans les réponses.
Atténuer les limites de Dolly LLM
Bien qu'il n'existe pas encore de techniques éprouvées pour pallier les limites actuelles de Dolly, Databricks poursuit ses recherches et vise à améliorer ses modèles d'IA. Dolly en est un exemple, actuellement en version 2, et d'autres progrès sont attendus dans les années à venir.
Conclusion et prochaines étapes
Databricks Dolly est un modèle d'IA open source disponible pour un usage commercial. Vous pouvez utiliser son code d'entraînement et ses jeux de données pour créer des LLM spécifiques répondant à vos besoins.
Prêt à aller au-delà de ce tutoriel Databricks Dolly et à perfectionner vos compétences ? Commencez par ces ressources :
Bon apprentissage !