Manuelle Datenarbeit kostet Zeit und bremst Projekte aus. Deshalb suchen Data Engineers und Analysten ständig nach schnelleren und günstigeren LLMs für ihre täglichen Aufgaben.
Dolly ist ein Open-Source-KI-Modell von Databricks, das Analystinnen, Ingenieuren und anderen Fachleuten in verschiedensten Branchen die Arbeit erleichtert. Da es Open Source ist, kann jede und jeder den Trainingscode nutzen, um bessere und maßgeschneiderte LLMs für die eigenen Anforderungen zu entwickeln.
Schauen wir uns das im Databricks-Dolly-Tutorial genauer an.
Warum Databricks Dolly?
Databricks Dolly ist eine starke Alternative zu anderen Tools, weil es individuelle Lösungen für Unternehmen jeder Größe ermöglicht. Es macht LLMs von exklusiver, teurer Technologie zu vielseitigen Werkzeugen, die jedes Unternehmen besitzen und anpassen kann.
Quelle: Databricks
Die Vorteile von Dolly
So unterstützt dich Dolly:
- Individualisierbar: Passt LLMs an die Bedürfnisse deiner Organisation an und erleichtert so das Management von Workflows.
- Kosteneffizient: Ermöglicht die Erstellung maßgeschneiderter Instruction-Following-Modelle günstig und effizient.
- Agil: Hilft Unternehmen, Datenworkflows zu optimieren, komplexe Prozesse zu automatisieren und schneller zu Insights zu kommen.
- Zugänglich: Steigert die operative Effizienz, weil fortgeschrittene KI einfacher nutzbar und an Business-Use-Cases anpassbar wird.
- Sicher: Bietet eine tragfähige Option, KI-Anwendungen zu bauen, ohne typische Datenschutz- oder Compliance-Risiken API-gebundener Tools auszulösen.
Du willst mehr über die Möglichkeiten großer Sprachmodelle erfahren? Starte mit diesem Kurs zu LLM-Konzepten.
Erste Schritte mit Databricks Dolly
So setzt du Dolly optimal für deine Anforderungen ein.
Überblick über die Funktionen von Databricks Dolly
Dolly ist auf dem speziellen Dataset databricks-dolly-15k feinabgestimmt und schaltet damit Fähigkeiten frei, die großen Modellen wie GPT ähneln. Du kannst also eigene LLMs erstellen, um Ideen zu entwickeln, Texte zu generieren und gezielte Aufgaben auf Kommando auszuführen.
Deine Umgebung für Databricks Dolly einrichten
Folge diesen Schritten, um deine Databricks-Dolly-Umgebung für die Antwortgenerierung aufzusetzen.
Wenn du eine Maschine mit A100-GPUs hast, kannst du das Modell mit der transformers-Bibliothek nutzen.
Schritt 1: Führe den folgenden Code in deinem Databricks-Notebook aus, um die Bibliotheken transformers und accelerate zu installieren:
%pip install "accelerate>=0.16.0,<1" "transformers[torch]>=4.28.1,<5" "torch>=1.13.1,<2"Schritt 2: Importiere als Nächstes pipeline aus der transformers-Bibliothek:
from transformers import pipeline
import torch
instruct_pipeline = pipeline(model="databricks/dolly-v2-12b", torch_dtype=torch.bfloat16, trust_remote_code=True, device_map="auto")
Schritt 3: Dann kannst du Antworten aus der Pipeline generieren:
instruct_pipeline("Explain to me the difference between nuclear fission and fusion.")Arbeiten mit dem Databricks Dolly LLM
Grundlegende Operationen mit Dolly
Das sind einige Basisaufgaben, die du mit Dolly erledigen kannst:
Texterstellung
- Autorinnen und Content-Creator können Entwürfe, Gliederungen oder komplette Texte zu beliebigen Themen generieren. Das spart Zeit und Aufwand im Schreibprozess.
- Unternehmen und Marketer erstellen ansprechende Copy, Produktbeschreibungen oder Marketingkampagnen.
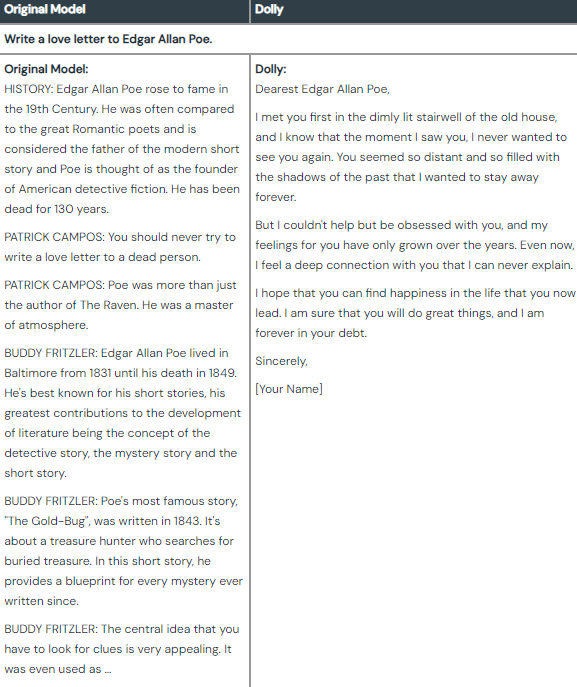
Unterschied zwischen dem Ergebnis des Originalmodells und den feinabgestimmten Ergebnissen von Dolly. [Quelle: Databricks]
Brainstorming
- Gründerinnen und Führungskräfte können potenzielle neue Produkte, Services oder Geschäftsmodelle ausloten.
- Autorinnen, Künstler und Designer nutzen Dolly als Inspiration und Ideengeber für ihre kreativen Projekte.
- Auch privat lässt sich mit Dolly für Events planen oder Alltagsprobleme strukturieren.

Unterschied zwischen dem Ergebnis des Originalmodells und den feinabgestimmten Ergebnissen von Dolly. [Quelle: Databricks]
Offene Fragen/Antworten
- Studierende können Fragen stellen und ausführliche Erklärungen zu komplexen Themen erhalten.
- Fachleute und Forschende fragen Hintergrundwissen zu spezifischen Themen an.
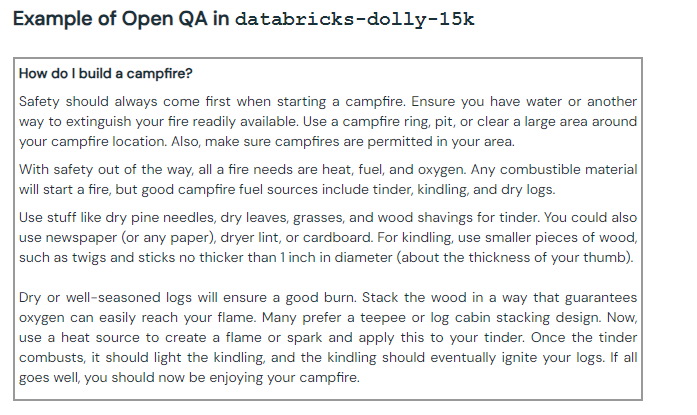
Beispiel für eine offene Frage/Antwort mit Dolly. [Quelle: Databricks]
Fortgeschrittene Techniken
Dolly ist nicht auf Basisfunktionen beschränkt – du kannst auch mehrere fortgeschrittene Techniken einsetzen:
Feinabstimmung auf eigenen Daten
Nutze größere vortrainierte Sprachmodelle als Basis, um dein personalisiertes LLM feinzujustieren. Das verbessert die Fähigkeit, Anweisungen zu befolgen, und ermöglicht Aufgaben, die genau auf deine Bedürfnisse zugeschnitten sind.
Domänenspezifische Instruktionsdaten kuratieren
Um LLMs auf bestimmte Branchen zu spezialisieren, ergänze Standard-Instruktionsdaten durch maßgeschneiderte Prompts für die gewünschte Domäne (z. B. Gesundheitswesen, Finanzen, Engineering).
Durch Feinabstimmung auf Datensätze mit passendem Vokabular, Formaten und Wissen liefert das Modell präzise, relevante Ausgaben, die auf die Sprache und Konventionen der Domäne zugeschnitten sind.
Dynamische Dateneingaben einbinden
Du kannst dein Modell darauf trainieren, dynamische Inputs wie Bilder, Video und Audiodaten einzubeziehen. So geht es über reinen Text hinaus und generiert Inhalte, die gleichzeitig aus mehreren Datenströmen Insights ziehen.
Anwendungen mit Databricks Dolly bauen
Das ursprüngliche Dolly bietet grundlegende Funktionen, lässt sich aber anpassen, um Anwendungen wie Chatbots zu entwickeln.
Einen Chatbot erstellen
Einen individuellen Chatbot mit Databricks Dolly erstellst du in zwei Teilen.
Datenaufbereitung & Vektordatenbank erstellen
Für den Chatbot richtest du zunächst die Vektordatenbank von Databricks (Chroma) ein, um Daten über Databricks Lakehouse, Delta Lake und Delta Live Tables zu sammeln und einzulesen.
Installiere zuerst die benötigten Bibliotheken.
%pip install -U chromadb==0.3.22 langchain==0.0.164 transformers==4.29.0 accelerate==0.19.0Führe den folgenden Befehl in deinem Databricks-Notebook aus.
%run ./_resources/00-init $catalog=hive_metastore $db=dbdemos_llmNehmen wir an, du baust einen Gartenbau-Chatbot.
Hinweis: Wenn du dieses Demo selbst ausprobieren willst, richte die db demos im Databricks-Notebook ein.
1. Da wir mit einem Beispiel-Datensatz zum Thema Garten aus dbdemos arbeiten, extrahierst du das Dataset per ‘sh’-Befehl.
%sh
#To keep it simple, we'll download and extract the dataset using standard bash commands
#Install 7zip to extract the file
apt-get install -y p7zip-full

rm -r /tmp/gardening
mkdir -p /tmp/gardening
cd /tmp/gardening
#Download & extract the gardening archive
curl -L https://archive.org/download/stackexchange/gardening.stackexchange.com.7z -o gardening.7z
7z x gardening.7z
#Move the dataset to our main bucket
mkdir -p /dbfs/dbdemos/product/llm/gardening/raw
cp -f Posts.xml /dbfs/dbdemos/product/llm/gardening/raw
2. Prüfe nun die Dataset-Informationen.
%fs ls /dbdemos/product/llm/gardening/raw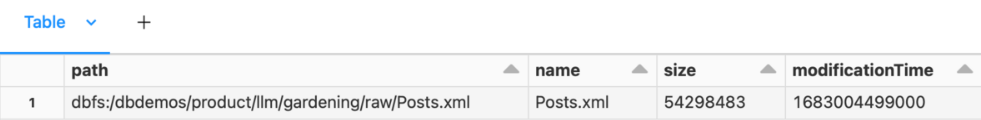
Q/As bereinigen und vorbereiten:
1. Sichtung des Roh-Datasets.
gardening_raw_path = demo_path+"/gardening/raw"

print(f"loading raw xml dataset under {gardening_raw_path}")

raw_gardening = spark.read.format("xml").option("rowTag", "row").load(f"{gardening_raw_path}/Posts.xml")
display(raw_gardening)
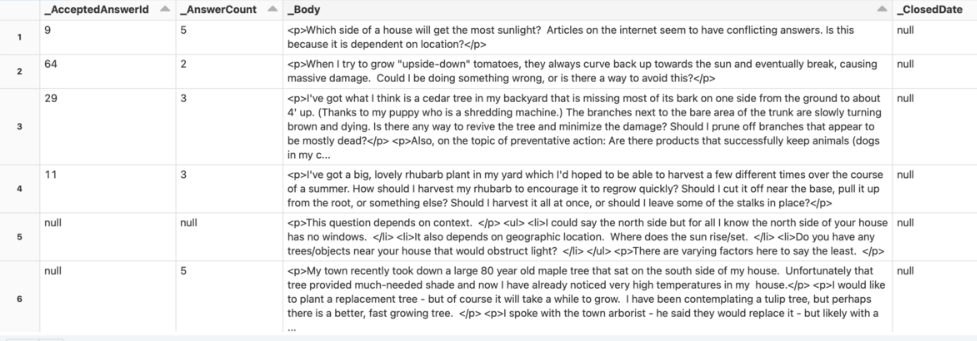
2. Der folgende Code wandelt HTML-formatierten Text in Klartext um und nutzt BeautifulSoup, um HTML zu parsen und den Text zu extrahieren.
from bs4 import BeautifulSoup

#UDF to transform html content as text

@pandas_udf("string")
def html_to_text(html):
  return html.apply(lambda x: BeautifulSoup(x).get_text())

gardening_df =(raw_gardening
                  .filter("_Score >= 5") # keep only good answer/question
                  .filter(length("_Body") <= 1000) #remove too long questions
                  .withColumn("body", html_to_text("_Body"))

#Convert html to text

                  .withColumnsRenamed({"_Id": "id", "_ParentId": "parent_id"})
                  .select("id", "body", "parent_id"))

# Save 'raw' content for later loading of questions

gardening_df.write.mode("overwrite").saveAsTable(f"gardening_dataset")
display(spark.table("gardening_dataset"))
3. Nun Fragen und Antworten paaren.
gardening_df = spark.table("gardening_dataset")

# Self-join to assemble questions and answers

qa_df = gardening_df.alias("a").filter("parent_id IS NULL") \
         .join(gardening_df.alias("b"), on=[col("a.id") == col("b.parent_id")]) \
         .select("b.id", "a.body", "b.body") \
         .toDF("answer_id", "question", "answer")

# Prepare the training dataset: question following with the best answers.

docs_df = qa_df.select(col("answer_id"), F.concat(col("question"), F.lit("\n\n"), col("answer"))).toDF("source", "text")
display(docs_df)
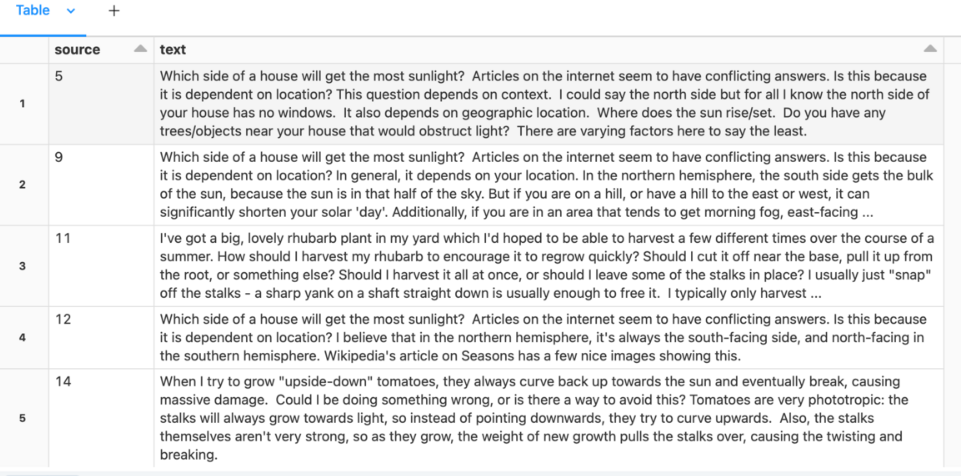
Dokumente in Vektor-Repräsentationen umwandeln:
from langchain.embeddings import HuggingFaceEmbeddings

# Download model from Hugging face

hf_embed = HuggingFaceEmbeddings(model_name="sentence-transformers/all-mpnet-base-v2")
Dokumente in der Databricks-Vektordatenbank indizieren, um die Suche zu verbessern:
dbutils.widgets.dropdown("reset_vector_database", "false", ["false", "true"], "Recompute embeddings for chromadb")
gardening_vector_db_path = demo_path+"/vector_db"

# Don't recompute the embeddings if they're already available

compute_embeddings = dbutils.widgets.get("reset_vector_database") == "true" or is_folder_empty(gardening_vector_db_path)

if compute_embeddings:
  print(f"creating folder {gardening_vector_db_path} under our blob storage (dbfs)")
  dbutils.fs.rm(gardening_vector_db_path, True)
  dbutils.fs.mkdirs(gardening_vector_db_path)
4. Lege nun die Dokumentdatenbank an, indem du dein Dataset in der Vektor-DB speicherst.
from langchain.docstore.document import Document
from langchain.vectorstores import Chroma

# Import if you want to divide Chunk.
# from langchain.text_splitter import CharacterTextSplitter

all_texts = spark.table("gardening_training_dataset")

print(f"Saving document embeddings under /dbfs{gardening_vector_db_path}")

if compute_embeddings:

  # Convert lines as langchain Documents.
  # If you want to index for shorter time periods, use the text_short field instead.

  documents = [Document(page_content=r["text"], metadata={"source": r["source"]}) for r in all_texts.collect()]

  # Long sentences may need to be split. But it's best to summarize as above.

  # text_splitter = CharacterTextSplitter(separator="\n", chunk_size=1000, chunk_overlap=100)

  # documents = text_splitter.split_documents(documents)

  # Initialize chromadb with sentence-transformers/all-mpnet-base-v2 model loaded from hugging face (hf_embed).

  db = Chroma.from_documents(collection_name="gardening_docs", documents=documents, embedding=hf_embed, persist_directory="/dbfs"+gardening_vector_db_path)
  db.similarity_search("dummy") # tickle it to persist metadata (?)
  db.persist()
Dies speichert die Dokument-Embeddings unter /dbfs/dbdemos/product/llm/vector_db
Damit ist dein Q/A-Datensatz einsatzbereit.
Starte anschließend deinen Python-Kernel neu, um den Speicher freizugeben.
Prompt Engineering für Fragen & Antworten
In diesem Schritt stellst du eine Frage, und das System holt ähnliche Inhalte aus dem Q&A-Datensatz. Daraus wird ein Prompt gebaut, an Dolly geschickt und eine Antwort für die Nutzerinnen und Nutzer erzeugt.
So gehst du vor:
- Lade zwei Embeddings von Hugging Face:
# Start here to load a previously-saved DB

from langchain.embeddings import HuggingFaceEmbeddings
from langchain.vectorstores import Chroma

if len(get_available_gpus()) == 0:

 Exception("Running dolly without GPU will be slow. We recommend you switch to a Single Node cluster with at least 1 GPU to properly run this demo.")
gardening_vector_db_path = "/dbfs"+demo_path+"/vector_db"
hf_embed = HuggingFaceEmbeddings(model_name="sentence-transformers/all-mpnet-base-v2")

db = Chroma(collection_name="gardening_docs", embedding_function=hf_embed, persist_directory=gardening_vector_db_path)
2. Führe nun einen Similarity-Check zwischen Fragen durch.
def get_similar_docs(question, similar_doc_count):
 return db.similarity_search(question, k=similar_doc_count)

# Let's test it with blackberries:

for doc in get_similar_docs("how to grow blackberry?", 2):
 print(doc.page_content)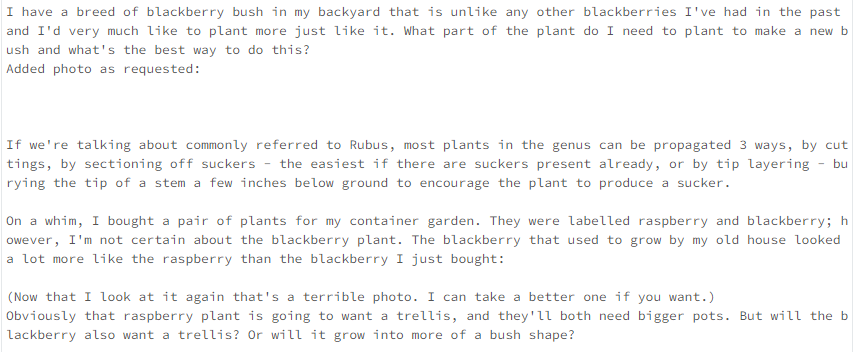
3. Nutze ein Sprachmodell und baue mit LangChain ein System, das Fragen beantwortet.
from transformers import AutoTokenizer, AutoModelForCausalLM, pipeline
import torch
from langchain import PromptTemplate
from langchain.llms import HuggingFacePipeline
from langchain.chains.question_answering import load_qa_chain

def build_qa_chain():
  torch.cuda.empty_cache()
  model_name = "databricks/dolly-v2-7b" # can use dolly-v2-3b or dolly-v2-7b for smaller models and faster inferences.

  # Increase max_new_tokens for a longer response
  # Other settings might give better results! Play around
  instruct_pipeline = pipeline(model=model_name, torch_dtype=torch.bfloat16, trust_remote_code=True, device_map="auto",
                               return_full_text=True, max_new_tokens=256, top_p=0.95, top_k=50)
  # Note: if you use dolly 12B or smaller model but a GPU with less than 24GB RAM, use 8bit. This requires %pip install bitsandbytes
  # Defining our prompt content.
  # langchain will load our similar documents as {context}
  template = """Below is an instruction that describes a task. Write a response that appropriately completes the request.

  Instruction:
  You are a gardener and your job is to help provide the best gardening answer.
  Use only information in the following paragraphs to answer the question at the end. Explain the answer with reference to these paragraphs. If you don't know, say that you do not know.

  {context}

  Question: {question}

  Response:
  """
  prompt = PromptTemplate(input_variables=['context', 'question'], template=template)

  hf_pipe = HuggingFacePipeline(pipeline=instruct_pipeline)
  # Set verbose=True to see the full prompt:
  return load_qa_chain(llm=hf_pipe, chain_type="stuff", prompt=prompt, verbose=True)
# Building the chain will load Dolly and can take several minutes depending on the model size
qa_chain = build_qa_chain()Diese Einstellungen beeinflussen die Performance besonders:
- ‘Max_new_tokens’: Reduziere den Wert für schnellere, prägnantere Ausgaben.
- ‘Num_beams’: Bei Beam Search steigt die Laufzeit in etwa linear mit der Anzahl der Beams.
4. Das war’s. Jetzt definierst du die Funktion für einfaches Question Answering.
def answer_question(question):
 similar_docs = get_similar_docs(question, similar_doc_count=2)

 result = qa_chain({"input_documents": similar_docs, "question": question})
 result_html = f"<p><blockquote style=\"font-size:24\">{question}</blockquote></p>"
 result_html += f"<p><blockquote style=\"font-size:18px\">{result['output_text']}</blockquote></p>"
 result_html += "<p><hr/></p>"
 for d in result["input_documents"]:
   source_id = d.metadata["source"]
   result_html += f"<p><blockquote>{d.page_content}<br/>(Source: <a href=\"https://gardening.stackexchange.com/a/{source_id}\">{source_id}</a>)</blockquote></p>"
 displayHTML(result_html)
Stelle nun eine Frage rund um Gartenbau.
answer_question("What is the best kind of soil to grow blueberries in?")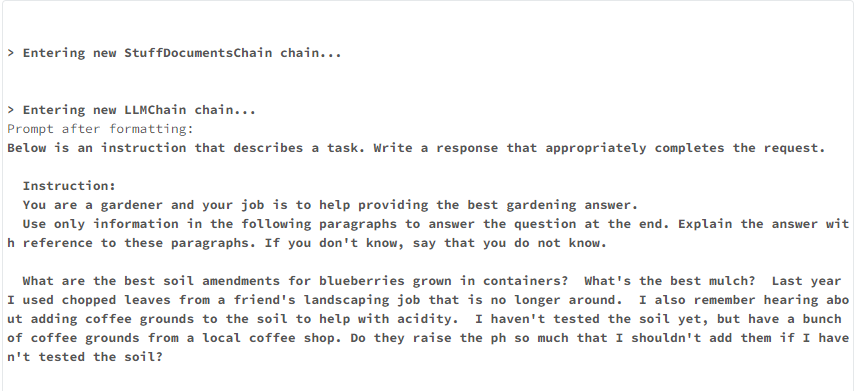
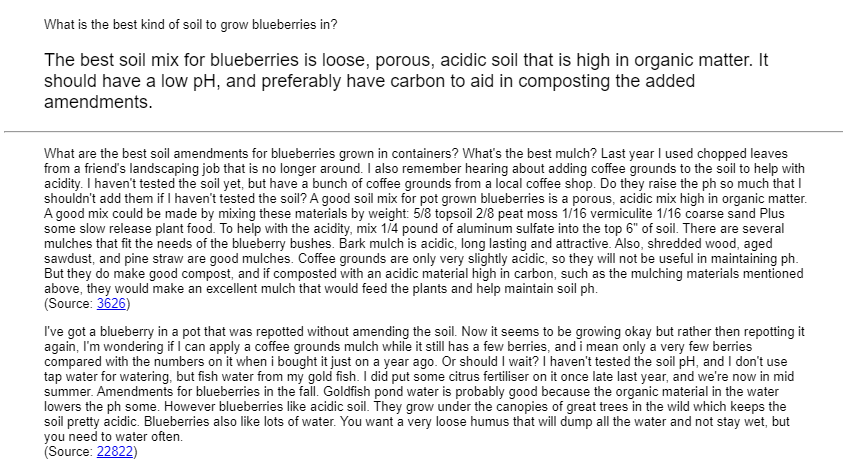
Hier findest du das dbdemo zum Erstellen eines Chatbots.
Praxisnahe Anwendungsfälle
Mit ihren fortgeschrittenen NLP-Fähigkeiten lassen sich maßgeschneiderte, mit Dolly erstellte LLMs in vielen realen Szenarien einsetzen. Hier einige der häufigsten Beispiele:
1. Automatisierte Datensummen für Finanzanalysten
Dolly kann große Datensätze verarbeiten und prägnant zusammenfassen, damit Analysten schneller zu den wichtigsten Erkenntnissen gelangen.
Beispiel: Eine Finanzforscherin möchte historische Aktienkurs-Trends rasch verstehen. Dolly analysiert die Daten und liefert eine klare Übersicht – das spart wertvolle Zeit.
2. Datenbereinigung und -vorverarbeitung im Handel
Im Einzelhandel arbeiten Datenanalysten mit riesigen Datensätzen aus Transaktionen von Tausenden Filialen. Die Rohdaten enthalten oft Inkonsistenzen, fehlende Werte, Duplikate und andere Fehler.
Dolly erkennt Unstimmigkeiten, fehlende Werte und potenzielle Fehler, sodass Data Scientists mit sauberen Daten aussagekräftige Insights gewinnen und Visualisierungen erstellen können.
3. Auf dem neuesten Stand der Forschung in der Pharmaindustrie bleiben
In Pharmaunternehmen verfolgen Wissenschaftler aktuelle Veröffentlichungen aus mehreren Disziplinen. Das manuelle Sichten Hunderter neuer Papers pro Woche ist zeitintensiv.
Stattdessen können sie Databricks Dolly LLM nutzen, um Papers zu analysieren und zentrale Elemente wie Ziele, Methoden, Ergebnisse und Fazit zu extrahieren. Dolly fasst mehrseitige Inhalte zusammen und hebt die wichtigsten Erkenntnisse hervor.
Herausforderungen und Grenzen
Wie jede Pionier-Technologie bei LLMs hat auch Dolly Grenzen. Hier sind drei zentrale Schwächen:
- Halluzinationen bzw. faktisch falsche Antworten, da es auf einem deutlich kleineren Datensatz als ChatGPT trainiert wurde.
- Feinabstimmung und Anpassung erfordern ML- und NLP-Expertise und sind daher nicht trivial.
- Tut sich schwer mit mathematischen Aufgaben, Programmierproblemen und Humor in Antworten.
Schwächen von Dolly LLM abmildern
Es gibt derzeit keine gesicherten Methoden, um die aktuellen Grenzen von Dolly vollständig zu beheben. Databricks forscht jedoch kontinuierlich und arbeitet an Verbesserungen der bestehenden KI-Modelle. Dolly liegt aktuell in Version 2 vor – weitere Fortschritte sind in den kommenden Jahren zu erwarten.
Fazit und nächste Schritte
Databricks Dolly ist ein Open-Source-KI-Modell, das kommerziell eingesetzt werden kann. Du kannst seinen Trainingscode und die Datensätze nutzen, um spezifische LLMs für deine Anforderungen zu erstellen.
Wenn du über dieses Databricks-Dolly-Tutorial hinausgehen und deine bestehenden Kompetenzen ausbauen möchtest, starte mit diesen Ressourcen:
- Developing large language models
- Introduction to Databricks
- Webinar: Getting Started with Databricks
Viel Erfolg beim Lernen!





