
कोर्स
LangChain के साथ LLM एप्लिकेशन विकसित करना
3 घंटा
51.3K
DeepSeek-R1 को स्थानीय रूप से चलाने से आपको मॉडल निष्पादन पर पूर्ण नियंत्रण मिलता है और बाहरी सर्वरों पर निर्भरता नहीं रहती। स्थानीय रूप से DeepSeek-R1 चलाने के कुछ फायदे:
Ollama, मॉडल डाउनलोड, क्वांटाइज़ेशन, और निष्पादन को सहजता से संभालकर स्थानीय रूप से LLMs चलाना सरल बनाता है।
सबसे पहले, आधिकारिक वेबसाइट से Ollama डाउनलोड और इंस्टॉल करें।
डाउनलोड पूरा होने पर, Ollama एप्लिकेशन को वैसे ही इंस्टॉल करें जैसे आप किसी अन्य एप्लिकेशन को करते हैं।
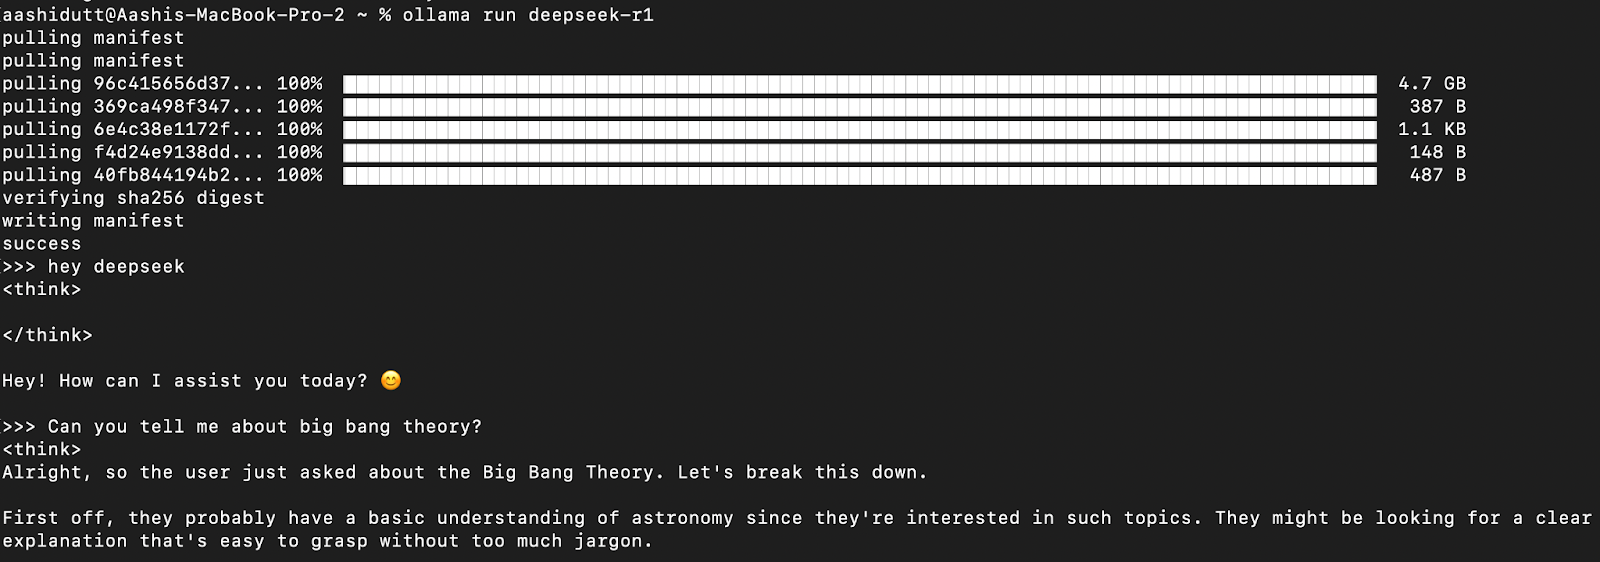
आइए सेटअप को परखें और अपना मॉडल डाउनलोड करें। टर्मिनल लॉन्च करें और निम्न कमांड टाइप करें।
ollama run deepseek-r1Ollama, DeepSeek R1 मॉडलों की एक रेंज प्रदान करता है, जो 1.5B पैरामीटर्स से लेकर पूरे 671B पैरामीटर मॉडल तक है। 671B मॉडल मूल DeepSeek-R1 है, जबकि छोटे मॉडल Qwen और Llama आर्किटेक्चर पर आधारित डिस्टिल्ड वर्ज़न हैं। यदि आपका हार्डवेयर 671B मॉडल को सपोर्ट नहीं कर सकता, तो आप नीचे दिए गए कमांड का उपयोग करके आसानी से छोटा वर्ज़न चला सकते हैं और नीचे दिए गए X को अपनी इच्छित पैरामीटर साइज से बदल दें (1.5b, 7b, 8b, 14b, 32b, 70b, 671b):
ollama run deepseek-r1:Xbइस लचीलापन के साथ, सुपरकंप्यूटर न होने पर भी आप DeepSeek-R1 की क्षमताओं का उपयोग कर सकते हैं।
DeepSeek-R1 को लगातार चलाने और API के माध्यम से सर्व करने के लिए, Ollama सर्वर शुरू करें:
ollama serveयह मॉडल को अन्य एप्लिकेशनों के साथ एकीकरण के लिए उपलब्ध कराएगा।
मॉडल डाउनलोड हो जाने के बाद, आप सीधे टर्मिनल में DeepSeek-R1 के साथ इंटरैक्ट कर सकते हैं।
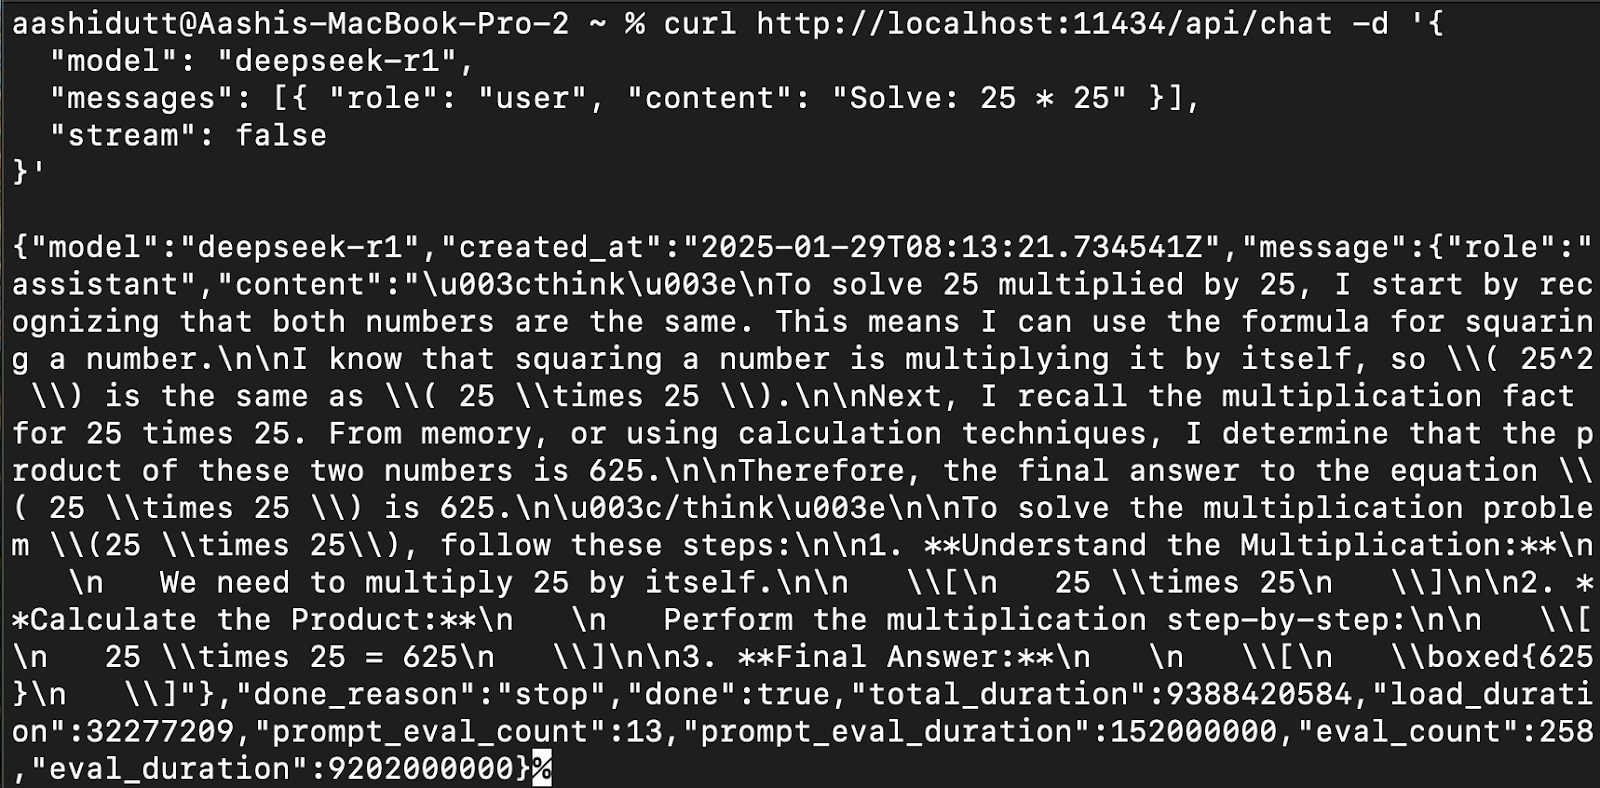
एप्लिकेशनों में DeepSeek-R1 को एकीकृत करने के लिए, curl का उपयोग करके Ollama API का उपयोग करें:
curl http://localhost:11434/api/chat -d '{
  "model": "deepseek-r1",
  "messages": [{ "role": "user", "content": "Solve: 25 * 25" }],
  "stream": false
}'
curl एक कमांड-लाइन टूल है जो Linux में मूल रूप से उपलब्ध है और macOS पर भी काम करता है। यह टर्मिनल से सीधे HTTP अनुरोध करने की अनुमति देता है, जिससे APIs के साथ इंटरैक्ट करने के लिए यह बेहतरीन टूल बनता है।
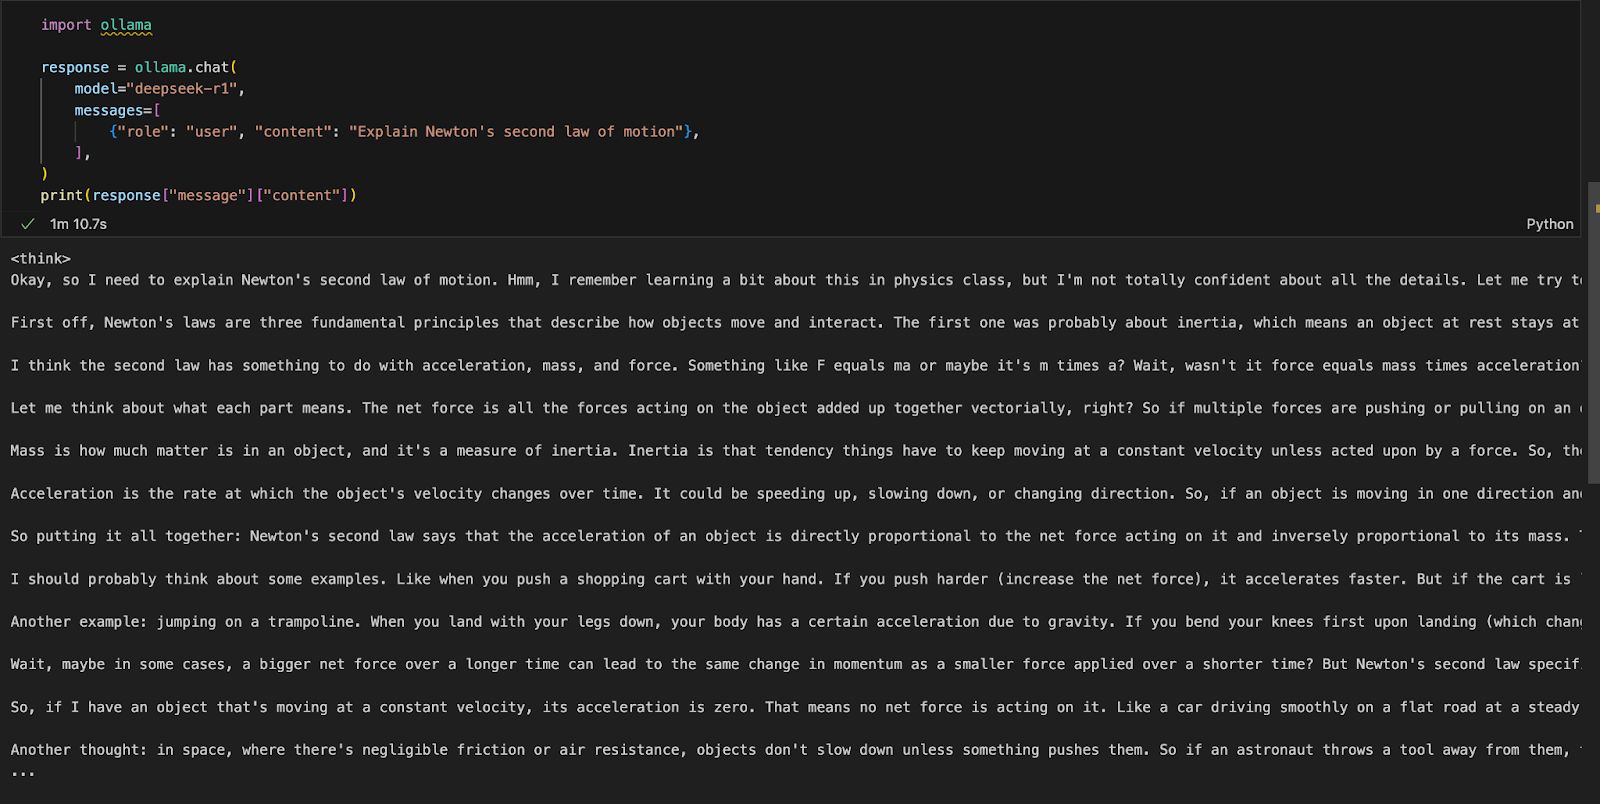
हम किसी भी पसंदीदा IDE में Ollama चला सकते हैं। आप निम्न कोड का उपयोग करके Ollama का Python पैकेज इंस्टॉल कर सकते हैं:
!pip install ollamaOllama इंस्टॉल होने के बाद, मॉडल के साथ इंटरैक्ट करने के लिए निम्न स्क्रिप्ट का उपयोग करें:
import ollama
response = ollama.chat(
    model="deepseek-r1",
    messages=[
        {"role": "user", "content": "Explain Newton's second law of motion"},
    ],
)
print(response["message"]["content"])
फ़ंक्शन ollama.chat() मॉडल का नाम और उपयोगकर्ता प्रॉम्प्ट लेता है और इसे वार्तालाप के रूप में प्रोसेस करता है। स्क्रिप्ट तब मॉडल की प्रतिक्रिया को निकालकर प्रिंट करती है।
आइए Gradio का उपयोग करके एक सरल डेमो ऐप बनाते हैं ताकि DeepSeek-R1 के साथ दस्तावेज़ों को क्वेरी और विश्लेषित किया जा सके।
इम्प्लीमेंटेशन शुरू करने से पहले, सुनिश्चित कर लें कि निम्न टूल और लाइब्रेरीज़ इंस्टॉल हैं:
आवश्यक निर्भरताएँ इंस्टॉल करने के लिए निम्न कमांड चलाएँ:
!pip install langchain chromadb gradio
!pip install -U langchain-community
ऊपर दी गई निर्भरताएँ इंस्टॉल होने के बाद, निम्न इम्पोर्ट कमांड चलाएँ:
import gradio as gr
from langchain_community.document_loaders import PyMuPDFLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.vectorstores import Chroma
from langchain_community.embeddings import OllamaEmbeddings
import ollamaलाइब्रेरीज़ इम्पोर्ट हो जाने के बाद, हम अपलोड किए गए PDF को प्रोसेस करेंगे।
def process_pdf(pdf_bytes):
    if pdf_bytes is None:
        return None, None, None

    loader = PyMuPDFLoader(pdf_bytes)
    data = loader.load()

    text_splitter = RecursiveCharacterTextSplitter(
        chunk_size=500, chunk_overlap=100
    )
    chunks = text_splitter.split_documents(data)

    embeddings = OllamaEmbeddings(model="deepseek-r1")
    vectorstore = Chroma.from_documents(
        documents=chunks, embedding=embeddings, persist_directory="./chroma_db"
    )
    retriever = vectorstore.as_retriever()

    return text_splitter, vectorstore, retriever
फ़ंक्शन process_pdf:
PyMuPDFLoader का उपयोग कर टेक्स्ट एक्सट्रैक्ट करता है।RecursiveCharacterTextSplitter का उपयोग कर टेक्स्ट को खंडों में बाँटता है।OllamaEmbeddings का उपयोग कर वेक्टर एम्बेडिंग्स जनरेट करता है।एम्बेडिंग्स प्राप्त हो जाने के बाद, अब हमें इन्हें साथ जोड़ना है। combine_docs() फ़ंक्शन कई रिट्रीव किए गए दस्तावेज़ खंडों को एक स्ट्रिंग में मिला देता है।
def combine_docs(docs):
    return "\n\n".join(doc.page_content for doc in docs)
क्योंकि रिट्रीवल-आधारित मॉडल पूरे दस्तावेज़ की बजाय प्रासंगिक अंश खींचते हैं, यह फ़ंक्शन सुनिश्चित करता है कि निकाला गया कंटेंट पठनीय और ठीक प्रकार से फ़ॉर्मैटेड रहे, ताकि उसे DeepSeek-R1 को पास किया जा सके।
अब हमारा मॉडल के लिए इनपुट तैयार है। आइए Ollama का उपयोग करके DeepSeek R1 सेट अप करें।
import re

def ollama_llm(question, context):
    formatted_prompt = f"Question: {question}\n\nContext: {context}"

    response = ollama.chat(
        model="deepseek-r1",
        messages=[{"role": "user", "content": formatted_prompt}],
    )

    response_content = response["message"]["content"]

    # Remove content between <think> and </think> tags to remove thinking output
    final_answer = re.sub(r"<think>.*?</think>", "", response_content, flags=re.DOTALL).strip()

    return final_answer
फ़ंक्शन ollama_llm() उपयोगकर्ता के प्रश्न और रिट्रीव किए गए दस्तावेज़ संदर्भ को एक स्ट्रक्चर्ड प्रॉम्प्ट में फ़ॉर्मैट करता है। यह फ़ॉर्मैट किया गया इनपुट ollama.chat() के माध्यम से DeepSeek-R1 को भेजा जाता है, जो दिए गए संदर्भ में प्रश्न को प्रोसेस कर प्रासंगिक उत्तर लौटाता है। यदि आपको मॉडल की सोच-विचार स्क्रिप्ट के बिना उत्तर चाहिए, तो अंतिम उत्तर लौटाने के लिए strip() फ़ंक्शन का उपयोग करें।
अब हमारे पास सभी आवश्यक घटक हैं, आइए अपने डेमो के लिए RAG पाइपलाइन बनाते हैं।
def rag_chain(question, text_splitter, vectorstore, retriever):
    retrieved_docs = retriever.invoke(question)
    formatted_content = combine_docs(retrieved_docs)
    return ollama_llm(question, formatted_content)
ऊपर दिया गया फ़ंक्शन पहले retriever.invoke(question) का उपयोग करके वेक्टर स्टोर में खोज करता है, और सबसे प्रासंगिक दस्तावेज़ अंश लौटाता है। इन अंशों को combine_docs फ़ंक्शन से एक स्ट्रक्चर्ड इनपुट में फ़ॉर्मैट किया जाता है और ollama_llm को भेजा जाता है, ताकि DeepSeek-R1 रिट्रीव किए गए कंटेंट के आधार पर तथ्यपूर्ण उत्तर जनरेट करे।
हमारी RAG पाइपलाइन तैयार है। अब, हम स्थानीय रूप से Gradio इंटरफेस बनाएँगे जो DeepSeek-R1 मॉडल के साथ मिलकर PDF इनपुट को प्रोसेस करे और उससे संबंधित प्रश्नों का उत्तर दे।
def ask_question(pdf_bytes, question):
    text_splitter, vectorstore, retriever = process_pdf(pdf_bytes)

    if text_splitter is None:
        return None  # No PDF uploaded

    result = rag_chain(question, text_splitter, vectorstore, retriever)
    return {result}


interface = gr.Interface(
    fn=ask_question,
    inputs=[
        gr.File(label="Upload PDF (optional)"),
        gr.Textbox(label="Ask a question"),
    ],
    outputs="text",
    title="Ask questions about your PDF",
    description="Use DeepSeek-R1 to answer your questions about the uploaded PDF document.",
)

interface.launch()
हम निम्न चरण करते हैं:
process_pdf फ़ंक्शन का उपयोग करके PDF प्रोसेस करें।rag_chain() फ़ंक्शन को पास करें ताकि प्रासंगिक जानकारी रिट्रीव हो और संदर्भानुकूल उत्तर जनरेट हो।gr.Interface() फ़ंक्शन का उपयोग करके लेआउट परिभाषित करें, जो इनपुट के रूप में PDF फ़ाइल और टेक्स्ट क्वेरी लेता है।interface.launch() का उपयोग कर एप्लिकेशन शुरू करें।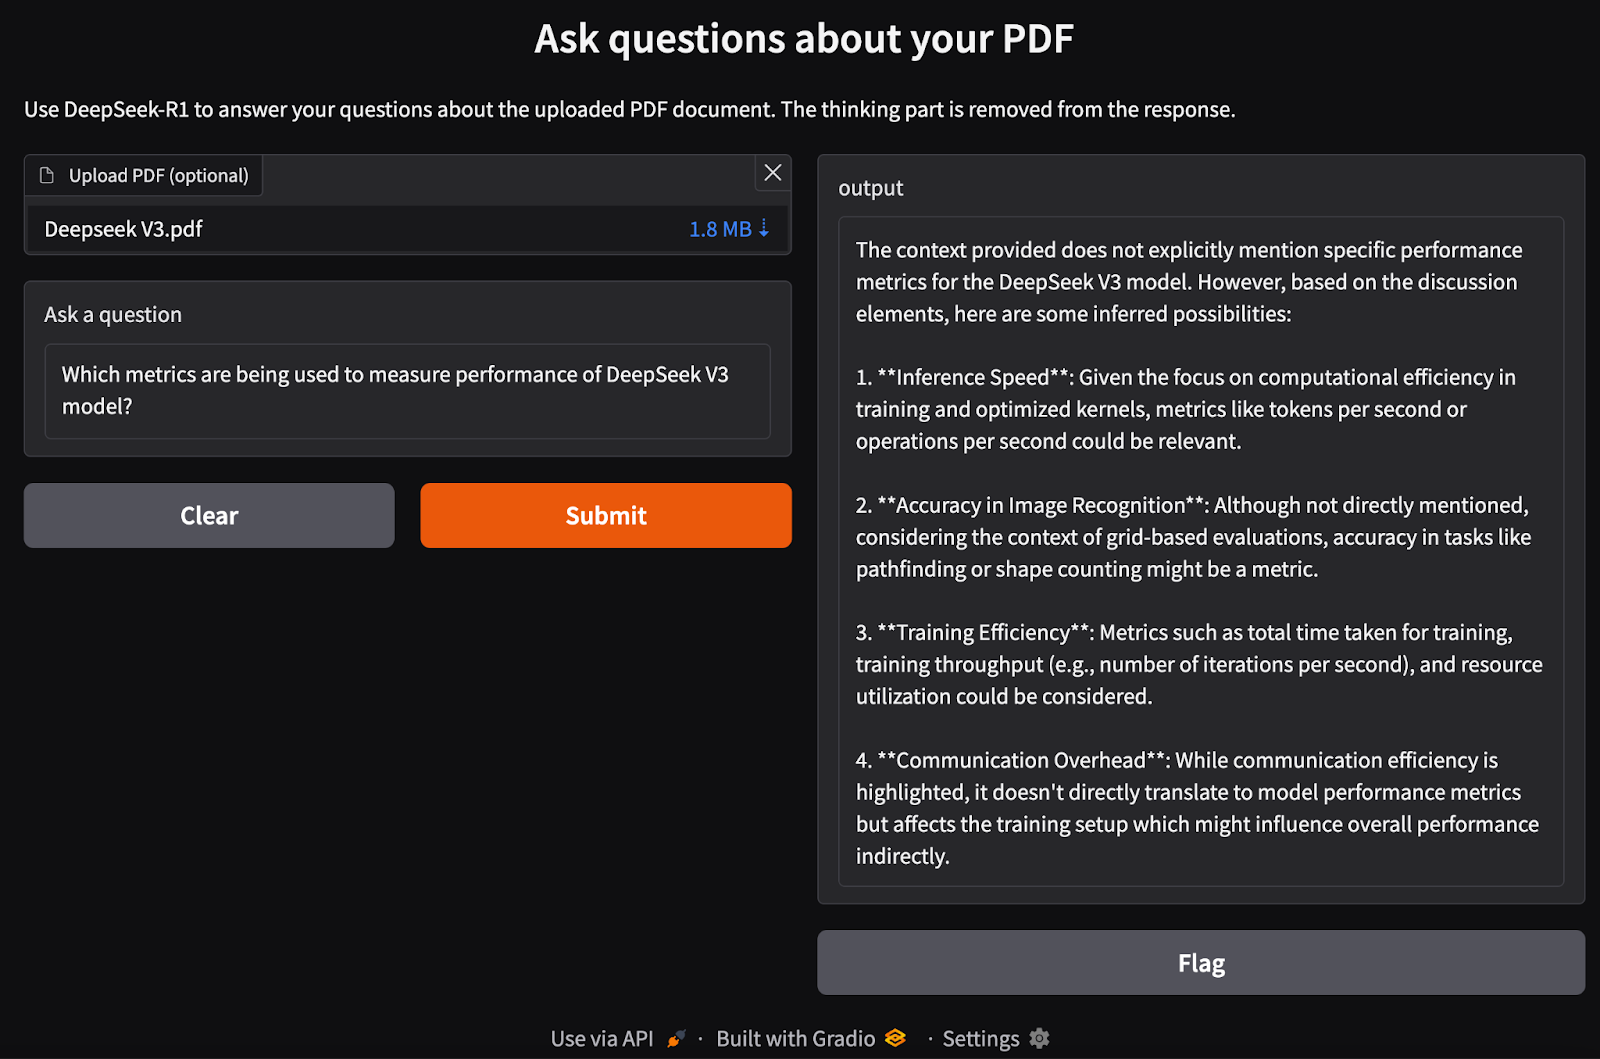
Ollama के साथ स्थानीय रूप से DeepSeek-R1 चलाने से तेज़, निजी और लागत-प्रभावी मॉडल इन्फरेंस संभव होता है। सरल इंस्टॉलेशन प्रक्रिया, CLI इंटरैक्शन, API सपोर्ट, और Python इंटीग्रेशन के साथ, आप DeepSeek-R1 को सामान्य क्वेरी से लेकर जटिल रिट्रीवल-आधारित कार्यों तक विभिन्न AI एप्लिकेशनों के लिए उपयोग कर सकते हैं।
AI में नवीनतम विकासों से अवगत रहने के लिए, मैं ये ब्लॉग सुझाता/सुझाती हूँ:
इन कोर्सेज़ के साथ AI सीखें!
कोर्स
कोर्स
लर्निंग पाथ