मुख्य सामग्री पर जाएं

Apache Spark आर्किटेक्चर: डेटा प्रैक्टिशनर्स के लिए मार्गदर्शिका

समझें कि Apache Spark बड़े पैमाने पर डेटा कैसे प्रोसेस करता है—इसके बुनियादी घटकों से लेकर वे एडवांस्ड फ़ीचर्स तक जो आधुनिक बिग डेटा वर्कफ़्लोज़ को शक्ति देते हैं।
अपडेट किया गया 25 सित॰ 2026  · 15 मि॰ पढ़ें

AI के साथ खोजें

ChatGPTClaudePerplexity

क्या आपने कभी किसी Spark जॉब को डीबग करने की कोशिश की है जो अचानक फेल हो गया हो—और फिर महसूस किया हो कि आप पूरी तरह खो गए हैं क्योंकि Spark का “रैबिट होल” कितना गहरा है? 

जब मैंने पहली बार Apache Spark के साथ काम किया, तो मुझे लगा बस कुछ PySpark ट्रांसफॉर्मेशन लिख दूँगा और Spark “जादुई" तरीके से क्लस्टर में स्केल हो जाएगा। मैं गलत था। Spark का परफॉर्मेंस पूरी तरह इस बात पर निर्भर करता है कि परदे के पीछे क्या हो रहा है, आप उसे कितना समझते हैं।

यह गाइड उनके लिए है जो Spark को ब्लैक बॉक्स की तरह नहीं देखना चाहते। हम Spark की आर्किटेक्चर को समझेंगे—मास्टर-वर्कर मॉडल और एक्ज़िक्यूशन वर्कफ़्लो से लेकर मेमोरी मैनेजमेंट और फॉल्ट टॉलरेंस मैकेनिज़्म तक। 

यदि आप तेज़, फॉल्ट-टॉलरेंट और कुशल बिग डेटा एप्लिकेशन बनाना चाहते हैं, तो आप सही जगह पर हैं!

Apache Spark की बुनियादी आर्किटेक्चर

आप अपनी पहली PySpark लाइन लिखने से पहले ही Spark आपके लिए कुछ आर्किटेक्चरल फैसले कर चुका होता है। Spark सिर्फ इन-मेमोरी कम्प्यूटिंग की वजह से तेज़ नहीं है, बल्कि इसलिए भी कि यह मास्टर-वर्कर आर्किटेक्चर पर बना है जो स्केल करता है और रीयल-वर्ल्ड की गड़बड़ियों—जैसे नोड क्रैशes, Java Virtual Machine (JVM) समस्याएँ, और असंगत डेटा वॉल्यूम—को झेल सकता है।

आइए Spark की कोर आर्किटेक्चर को समझते हैं और देखते हैं कि यह आधुनिक बिग डेटा वर्कफ़्लो में आज भी इतना प्रभावी क्यों है।

मास्टर-वर्कर पैरेडाइम

Spark के केंद्र में मास्टर-वर्कर मॉडल है। इसे ऐसे समझें:

  • ड्राइवर (मास्टर): यह Spark का दिमाग है। यह आपका main() फंक्शन चलाता है, Spark कॉन्टेक्स्ट बनाता है, DAG शेड्यूलिंग संभालता है और क्लस्टर को निर्देश देता है कि क्या करना है।
  • एक्ज़ीक्यूटर (वर्कर्स): ये मसल्स हैं। ये आपके टास्क्स चलाते हैं, डेटा को मेमोरी में रखते हैं और ड्राइवर को रिपोर्ट करते हैं।

यह सेटअप आपको ट्रांसफॉर्मेशन परिभाषित करने पर ध्यान केंद्रित करने देता है, और Spark तय करता है कि उन्हें एक्ज़ीक्यूटर्स पर समानांतर में कहाँ और कैसे चलाना है। 

मुझे इस डिज़ाइन की सबसे अच्छी बात यह लगती है कि यह डिप्लॉयमेंट-एग्नॉस्टिक है। वही कोड आपके लोकल मशीन पर, Kubernetes या Mesos पर—जहाँ भी डिप्लॉय करें—चलता है। इससे आप लोकल में डेवलप और टेस्ट कर सकते हैं और बिना कोड दोबारा लिखे क्लस्टर्स तक स्केल कर सकते हैं।

और ड्राइवर-वर्कर के अलगाव का एक और बड़ा फायदा: फॉल्ट आइसोलेशन बेहतर होता है। यदि कोई वर्कर नोड टास्क चलाते समय मर जाता है, तो Spark उस टास्क को किसी दूसरे वर्कर को सौंप सकता है, बिना आपकी एप्लिकेशन को क्रैश किए।

कोर कंपोनेंट्स

आइए देखते हैं ड्राइवर और नोड्स के भीतर क्या होता है। 
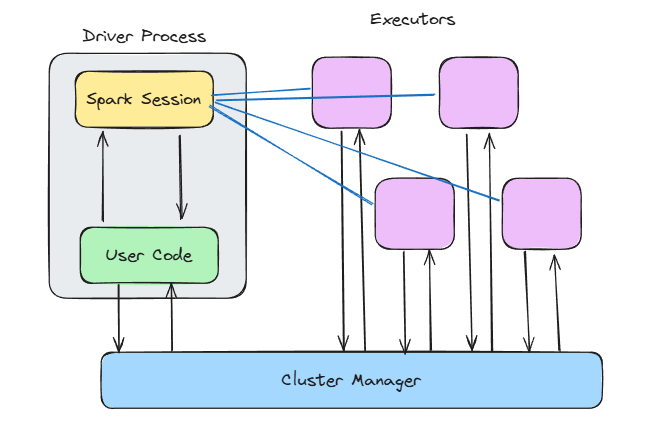
Spark आर्किटेक्चर दर्शाता डायग्राम

Spark आर्किटेक्चर। चित्र: लेखक।

Spark कॉन्टेक्स्ट

जब आप SparkContext() कॉल करते हैं या SparkSession.builder.getOrCreate() उपयोग करते हैं, तो आप Spark के अंदरूनी “जादू” का गेटवे खोलते हैं।

Spark कॉन्टेक्स्ट:

  • आपके क्लस्टर मैनेजर से कनेक्ट होता है
  • एक्ज़ीक्यूटर्स अलोकेट करता है
  • जॉब स्टेटस और एक्ज़िक्यूशन प्लान का हिसाब रखता है

Spark परदे के पीछे एक Directed Acyclic Graph (DAG) बनाता है। यह DAG स्टेजेज़ और टास्क्स में तोड़ा जाता है और फिर समानांतर में चलाया जाता है।

DAG शेड्यूलर तय करता है कि कौन-से टास्क साथ चल सकते हैं, और टास्क शेड्यूलर उन्हें एक्ज़ीक्यूटर्स को असाइन करता है। इसी बीच, ब्लॉक मैनेजर यह सुनिश्चित करता है कि जरूरत के मुताबिक डेटा कैश, शफ़ल या रीलोड हो। 

यह लेयर्ड डिज़ाइन Spark को बेहद लचीला बनाता है—आप मेमोरी, स्टोरेज और कम्प्यूट को स्वतंत्र रूप से फ़ाइन-ट्यून कर सकते हैं।

यदि आप Spark ट्रांसफॉर्मेशन या फीचर इंजीनियरिंग पर काम कर रहे हैं, तो Feature Engineering with PySpark कोर्स देखें और इस आर्किटेक्चर को एक्शन में देखें।

एक्ज़ीक्यूटर रनटाइम

काम यहीं होता है—एक्ज़ीक्यूटर्स पर।

हर एक्ज़ीक्यूटर चलाता है:

  • एक या अधिक टास्क (थ्रेडेड)
  • डेटा कैश करने और शफ़ल आउटपुट के लिए मेमोरी का एक हिस्सा
  • अपना अलग JVM इंस्टेंस, जो दूसरों से आइसोलेटेड होता है

आप प्रत्येक एक्ज़ीक्यूटर की मेमोरी, उपयोग होने वाले कोर की संख्या, और मेमोरी कम पड़ने पर डिस्क पर लिखना है या नहीं—इन सबको कॉन्फ़िगर कर सकते हैं। 

लेकिन सावधान रहें: यदि आप पर्याप्त मेमोरी अलॉट नहीं करते, तो बार-बार आउट-ऑफ़-मेमोरी एरर्स मिलेंगे। वहीं, बहुत ज़्यादा मेमोरी अलॉट करना भी सही नहीं—रिसोर्स बर्बाद होते हैं। मॉनिटरिंग और ट्यूनिंग यहाँ बेहद ज़रूरी हैं।

एक्ज़िक्यूशन वर्कफ़्लो: कोड से क्लस्टर तक

PySpark कोड लिखना आसान लगता है। आप DataFrame को फ़िल्टर करते हैं, जॉइन करते हैं, एग्रीगेट करते हैं और रन हिट कर देते हैं। लेकिन उस साफ़-सुथरे API के पीछे, Spark चुपचाप एक एक्ज़िक्यूशन इंजन स्पिन-अप करता है जो कई नोड्स में काम फैला सकता है। 

आइए देखें परदे के पीछे क्या होता है।

लॉजिकल से फिजिकल प्लान में रूपांतरण

ज्यादातर Spark उपयोगकर्ता शुरू में यह नहीं समझते: जब आप PySpark कोड लिखते हैं, तो वह तुरंत रन नहीं होता। आप एक प्लान बना रहे होते हैं, और Spark का Catalyst Optimizer उस प्लान को लेकर उसे कुशल एक्ज़िक्यूशन स्ट्रेटेजी में बदलता है।

यह चार चरणों में काम करता है:
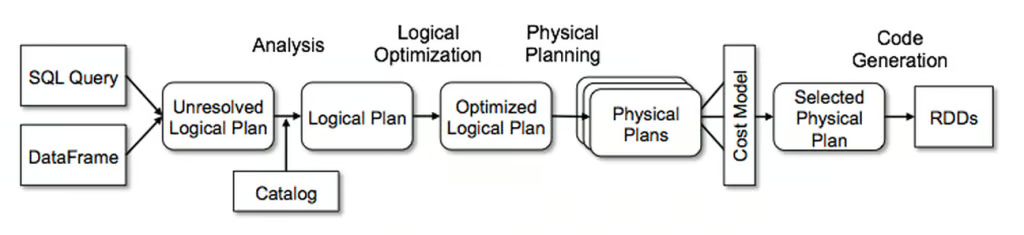
  1. एनालिसिस: Spark कॉलम नाम, डेटा टाइप और टेबल रेफरेंस रिज़ॉल्व करता है, ताकि सब वैध हो।
  2. लॉजिकल ऑप्टिमाइज़ेशन: यहाँ Spark प्रेडिकेट पुशडाउन और कॉन्स्टेंट फोल्डिंग जैसी रूल्स लागू करता है। फ़िल्टर्स को ऑप्टिमाइज़ करता है और प्रोजेक्शंस को जोड़ता है।
  3. फिजिकल प्लानिंग: Spark कई एक्ज़िक्यूशन स्ट्रेटेजीज़ पर विचार कर सबसे कुशल चुनता है (डेटा साइज, पार्टिशनिंग आदि के आधार पर)।
  4. कोड जेनरेशन: अंत में, होल-स्टेज कोड जेनरेशन के जरिए JVM बाइटकोड बनाता है। 

Spark के Catalyst Optimizer का डायग्राम दर्शाती छवि

Spark का Catalyst Optimizer। छवि: Databricks।

तो .select(), .join(), और .groupBy() की वह चेन लाइन-बाय-लाइन नहीं चलती। उसे एनालाइज़, ऑप्टिमाइज़ और कंपाइल किया जाता है ताकि क्लस्टर पर तेज़ी से चले।

अगर आप सबसे उपयोगी PySpark कमांड्स की चीट शीट चाहते हैं, तो यह देखें: PySpark Cheat Sheet।

DAG शेड्यूलर और स्टेज क्रिएशन

जब प्लान तैयार हो जाता है, तो DAG शेड्यूलर नियंत्रण संभालता है।

यह जॉब को शफ़ल बाउंड्रीज़ के आधार पर स्टेजेज़ में तोड़ता है—जहाँ Spark तय करता है कि क्या सीक्वेंशियली होगा और क्या समानांतर चल सकता है।

दो मुख्य प्रकार के स्टेज होते हैं:

  • ShuffleMapStage: इसमें शफ़ल शामिल होता है, जो आमतौर पर groupBy() या join() जैसी वाइड ट्रांसफॉर्मेशन से होता है। डेटा पार्टिशन होता है और नेटवर्क पर भेजा जाता है। यह स्टेज प्रकार ResultStage की गणना के लिए आवश्यक है।
  • ResultStage: ये स्टेज आउटपुट पैदा करते हैं—जैसे डिस्क पर लिखना या ड्राइवर को रिजल्ट लौटाना।

मेरी एक महत्वपूर्ण सीख: शफ़ल को कम से कम रखें। शफ़ल किसी स्टेज के खत्म होने से पहले होना ही पड़ता है और यह महँगा होता है। आपको समझना होगा कि आपके DAG में वे कहाँ होते हैं और क्या आप कोड को और ऑप्टिमाइज़ कर उनकी संख्या घटा सकते हैं। 

टास्क एक्ज़िक्यूशन लाइफ़साइकल

DAG शेड्यूलर के सभी स्टेज बनाने के बाद, वे अलग-अलग एक्ज़ीक्यूटर्स पर रन हो सकते हैं। 

टास्क एक्ज़िक्यूशन लाइफ़साइकल कुछ यूँ दिखता है:

  1. टास्क सीरियलाइज़ेशन: ड्राइवर टास्क इंस्ट्रक्शंस को सीरियलाइज़ कर एक्ज़ीक्यूटर्स को भेजता है।
  2. शफ़ल राइट फ़ेज़: Spark पार्टिशन किए गए आउटपुट को लोकल डिस्क पर लिखता है।
  3. फ़ेच फ़ेज़: अगली स्टेज के एक्ज़ीक्यूटर्स क्लस्टर में दूसरों से संबंधित शफ़ल फ़ाइलें फ़ेच करते हैं।
  4. डीसीरियलाइज़ेशन और एक्ज़िक्यूशन: एक्ज़ीक्यूटर्स डेटा को डीसीरियलाइज़ करके आपका लॉजिक चलाते हैं और ज़रूरत पड़ने पर कैश या लिख देते हैं।
  5. गार्बेज कलेक्शन: JVM अपने-आप उस मेमोरी को रिक्लेम करता है जिसका Spark एप्लिकेशन अब उपयोग नहीं कर रहा। यह स्टेप मेमोरी लीक रोकने और स्मूथ रन के लिए ज़रूरी है।

मेरे अनुभव से एक छोटा संकेत: यदि आपका Spark जॉब पहले ठीक चलने के बाद अचानक अटक रहा है, तो अक्सर वजह गार्बेज कलेक्शन या शफ़ल फ़ेच डिलेज़ होते हैं। हमेशा अपना कोड जाँचें और Spark की आर्किटेक्चर को समझें ताकि आप इन्हें प्रभावी ढंग से ऑप्टिमाइज़ कर सकें।

मेमोरी मैनेजमेंट आर्किटेक्चर

Spark का मेमोरी मैनेजमेंट बहुत जटिल विषय है—और यदि आप नहीं समझते, तो यह आपको घंटों की डीबगिंग में उलझा सकता है। 

तो आइए देखें कि Spark अंदरखाने मेमोरी कैसे मैनेज करता है, ताकि आप अवगत रहें और धीमे कोड या आउट-ऑफ़-मेमोरी एरर्स की घंटों की डीबगिंग से बच सकें।

यूनिफ़ाइड मेमोरी मॉडल

Spark 1.6 से पहले, मेमोरी को सख्ती से execution (शफ़ल और जॉइन) और storage (कैशिंग) के बीच बाँटा गया था। Spark 1.6 के साथ यूनिफ़ाइड मेमोरी मॉडल आया। 

यूनिफ़ाइड मेमोरी मॉडल में डेटा तीन मुख्य पूल में बँटा होता है:

  • रिज़र्व्ड मेमोरी: Spark इंटरनल्स और सिस्टम के लिए थोड़ी मेमोरी। 
  • Spark मेमोरी: यह execution डेटा और कैशिंग—दोनों के लिए होती है। यह डायनामिक रूप से शेयर होती है। अगर आपके जॉब को शफ़ल्स के लिए ज़्यादा और कैशिंग के लिए कम (या उल्टा) मेमोरी चाहिए, तो Spark अनुकूलित हो जाता है।
  • यूज़र मेमोरी: Spark एप्लिकेशन में यूज़र कोड चलाने हेतु यूज़र-परिभाषित डेटा स्ट्रक्चर्स के लिए जगह।

Spark मेमोरी पूल आगे दो पूल में बाँटा होता है:

  1. एक्ज़ीक्यूटर मेमोरी: प्रोसेसिंग टास्क के चरणों के दौरान आवश्यक टेम्पररी डेटा (जैसे शफ़ल, जॉइन, एग्रीगेशन, …) स्टोर करता है। 
  2. स्टोरेज मेमोरी पूल: डेटा कैश करने और इंटरनल डेटा स्ट्रक्चर स्टोर करने के लिए। 

यह इलास्टिसिटी Spark को अनिश्चित डेटा वॉल्यूम के साथ ज्यादा लचीला बनाती है। 

हालाँकि, जब आपको पता न हो कि अंदर क्या चल रहा है, तो कुछ कंट्रोल कम भी हो सकता है। उदाहरण के लिए, यदि आप एक बड़ा DataFrame cache() करते हैं और उसी स्टेज में महँगे एग्रीगेशन भी हैं, तो Spark शफ़ल के लिए जगह बनाने को आपका cached डेटा evict कर सकता है।

ऑफ-हीप और कॉलमनर स्टोरेज

Spark के ऑफ-हीप और कॉलमनर स्टोरेज में Tungsten इंजन काम आता है। 

Tungsten ने कई ऑप्टिमाइज़ेशन दिए, जिन्होंने Spark के परफॉर्मेंस को बेहतर किया:

  • ऑफ-हीप मेमोरी मैनेजमेंट: Spark अब कुछ डेटा JVM हीप के बाहर स्टोर करता है, जिससे गार्बेज कलेक्शन ओवरहेड घटता है और मेमोरी मैनेजमेंट अधिक प्रेडिक्टेबल होता है।
  • बाइनरी फ़ॉर्मैट स्टोरेज: डेटा कॉम्पैक्ट, कैश-फ्रेंडली बाइनरी रूप में स्टोर होता है, जिससे CPU उपयोग बेहतर होता है और वेक्टराइज़्ड एक्ज़िक्यूशन संभव होती है।
  • कैश-अवेयर एल्गोरिद्म: Spark अब CPU कैश का बेहतर उपयोग कर सकता है, RAM या डिस्क से अनावश्यक रीड्स से बचते हुए।

और यदि आप DataFrames के साथ काम कर रहे हैं, तो आप ये ऑप्टिमाइज़ेशन पहले से ही उपयोग कर रहे हैं। यही वजह है कि मैं लोगों को रॉ RDDs के बजाय DataFrames और SQL APIs उपयोग करने के लिए प्रेरित करता हूँ—आप बिना अतिरिक्त ट्यूनिंग के Catalyst और Tungsten की पूरी क्षमता पाते हैं।

यदि आप डेटा क्लीनिंग पाइपलाइंस पर काम कर रहे हैं, तो आप इसे Cleaning Data with PySpark में एक्शन में देखेंगे।

फॉल्ट टॉलरेंस मैकेनिज़्म

यदि आप डिस्ट्रीब्यूटेड सिस्टम्स के साथ काम करते हैं, तो एक बात तय है: वे फेल होते हैं। नोड्स क्रैश होते हैं। नेटवर्क एरर्स आते हैं। एक्ज़ीक्यूटर्स की मेमोरी खत्म हो जाती है और वे बंद हो जाते हैं।

लेकिन Spark इन समस्याओं को संभालने के लिए बना है और यह सुनिश्चित करता है कि आपके जॉब्स फिर भी सफल हों। 

आइए देखें कि Spark अस्थिरताओं के बावजूद आपके जॉब्स की सफलता कैसे सुनिश्चित करता है।

RDD लिनीएज ट्रैकिंग

Resilient Distributed Datasets (RDDs) Spark का मौलिक डेटा स्ट्रक्चर हैं—और इन्हें “resilient” यूँ ही नहीं कहा जाता। 

Spark लिनीएज का उपयोग करता है ताकि किसी नोड फेल होने और डेटा लॉस की स्थिति में प्रत्येक RDD को फिर से कंप्यूट किया जा सके। 

तो जब कोई नोड फेल होता है, Spark लिनीएज ग्राफ की मदद से खोया हुआ डेटा दोबारा कंप्यूट कर देता है। 

व्यवहार में यह ऐसे काम करता है: 

  • नैरो डिपेंडेंसीज़ (जैसे map() या filter()): Spark को सिर्फ खोई हुई पार्टिशन को फिर से कंप्यूट करना होता है।
  • वाइड डिपेंडेंसीज़ (जैसे groupBy() या join()): Spark को कई पार्टिशन से डेटा फ़ेच करना पड़ सकता है, क्योंकि इसे कई स्टेज के आउटपुट की जरूरत हो सकती है। 

लिनीएज की वजह से आपको फ़ेल्योर मैन्युअली नहीं संभालने पड़ते। हालाँकि, यदि आपका लिनीएज ग्राफ बहुत लंबा हो जाए—सैकड़ों ट्रांसफॉर्मेशन के साथ—तो खोया डेटा फिर से कंप्यूट करना महँगा हो सकता है। यहीं चेकपॉइंटिंग काम आती है।

चेकपॉइंटिंग और राइट-अहेड लॉग्स

जटिल वर्कफ़्लो या स्ट्रीमिंग जॉब्स में, Spark केवल लिनीएज पर निर्भर नहीं रह सकता। यहाँ चेकपॉइंटिंग काम आती है।

आप rdd.checkpoint() कॉल कर वर्तमान RDD स्टेट को किसी विश्वसनीय स्टोरेज (जैसे HDFS) में परसिस्ट कर सकते हैं। 

इसके बाद Spark लिनीएज को ट्रंकेट कर देता है। एरर होने पर यह डेटा को दोबारा कंप्यूट करने की बजाय सीधे लोड कर लेता है।

स्ट्रक्चर्ड स्ट्रीमिंग में, Spark ट्रांज़िट में डेटा लॉस रोकने के लिए write-ahead logs (WALs) का भी उपयोग करता है। 

इसे स्थिर बनाती हैं ये बातें: 

  • रिलायबल रिसीवर्स: प्रोसेसिंग से पहले इनकमिंग डेटा को लॉग में लिखते हैं।
  • एक्ज़ीक्यूटर हार्टबीट्स: ये नियमित सिग्नल बताते हैं कि एक्ज़ीक्यूटर्स जीवित और स्वस्थ हैं।
  • चेकपॉइंट डायरेक्टरीज़: स्ट्रीमिंग जॉब्स के लिए, इनमें ऑफ़सेट्स, मेटाडेटा और आउटपुट स्टेट रहता है—ताकि आप वहीं से दोबारा शुरू कर सकें जहाँ छोड़ा था।

बैच प्रोसेसिंग जॉब्स के लिए चेकपॉइंटिंग वैकल्पिक है, लेकिन स्ट्रीमिंग पाइपलाइंस के लिए आवश्यक। 

मान लीजिए आपका Spark जॉब 10 घंटे चलने के बाद फेल हो गया, लेकिन आप चेकपॉइंटिंग और WALs की बदौलत वहीं से फिर शुरू कर पाए जहाँ छोड़ा था। 

एडवांस्ड आर्किटेक्चरल फ़ीचर्स

अब तक आपने देखा कि Spark जॉब्स को कैसे प्रोसेस करता है और मेमोरी व फ़ेल्योर कैसे संभालता है।

इस सेक्शन में, हम कुछ एडवांस्ड अपग्रेड्स देखेंगे, जो Spark को और ज़्यादा डायनेमिक, रीयल-टाइम और एडैप्टेबल बनाते हैं।

एडैप्टिव क्वेरी एक्ज़िक्यूशन (AQE)

AQE Spark 3.0 में आया और रनटाइम के दौरान इकट्ठा हुई स्टैटिस्टिक्स के आधार पर एक्ज़िक्यूशन प्लान को डायनामिकली एडजस्ट करके क्वेरी परफॉर्मेंस बेहतर करता है।

AQE की विशेषताएँ:

  • जॉइन स्ट्रेटेजी का डायनेमिक स्विच: यदि आपका ब्रॉडकास्ट जॉइन मेमोरी में फिट नहीं होगा, तो AQE उसे सॉर्ट-मर्ज जॉइन में बदल देता है।
  • शफ़ल पार्टिशन का कोएलस: छोटी-छोटी शफ़ल पार्टिशन को बड़ी में मर्ज करना, जिससे ओवरहेड घटता है।
  • स्क्यूड डेटा हैंडल करना: AQE स्क्यूड पार्टिशन को स्प्लिट कर सकता है, ताकि एक्ज़िक्यूशन समय बैलेंस रहे।

यह फ़ीचर गेम-चेंजर है—क्योंकि अब कई जॉब्स, जिनके लिए पहले मैन्युअल ट्यूनिंग और ट्रायल-एंड-एरर चाहिए था, रीयल-टाइम में एडैप्ट कर सकते हैं।

बस इसे कॉन्फ़िगरेशन में स्पष्ट रूप से सक्षम करें (spark.sql.adaptive.enabled = true)। और यदि आप Spark 3.0+ पर हैं, तो इसे न सक्षम करने की कोई वजह नहीं।

स्ट्रक्चर्ड स्ट्रीमिंग आर्किटेक्चर

Structured Streaming, Spark के इंजन को रीयल-टाइम डोमेन तक बढ़ा देता है—वह भी बिना कोई नया API सीखे।

परदे के पीछे यह माइक्रो-बैचिंग ही लागू करता है। लेकिन यह संभालता है:

  • ऑफ़सेट मैनेजमेंट: Spark सटीक ट्रैक करता है कि सोर्स (Kafka, सॉकेट, फ़ाइल आदि) से कौनसा डेटा पढ़ा गया। सही कॉन्फ़िगरेशन पर यह स्ट्रॉन्ग exactly-once गारंटी देता है।
  • वॉटरमार्किंग: टाइम-बेस्ड एग्रीगेशन में, Spark वॉटरमार्क का उपयोग करता है यह तय करने के लिए कि लेट डेटा कब “बहुत लेट” है। यह इवेंट-टाइम प्रोसेसिंग के लिए महत्वपूर्ण है।
  • स्टेट स्टोर्स: जब आप विंडोड एग्रीगेशन या स्ट्रीमिंग जॉइन करते हैं, तो Spark माइक्रो-बैचेज़ के बीच स्टेट बनाए रखता है। यह स्टेट डिस्क पर स्टोर होता है और डेटा लॉस से बचाने को चेकपॉइंट किया जाता है।

यहाँ की सबसे शक्तिशाली बात है—स्ट्रीमिंग, बैचिंग जैसी लगती है। आप groupBy() या filter() लिखते हैं और Spark बाकी सब सँभालता है—बिना किसी विशेष टूलचेन के स्ट्रीमिंग एनालिटिक्स सुलभ हो जाती है।

सिक्योरिटी आर्किटेक्चर

यदि आप प्रोडक्शन में Spark चला रहे हैं—खासकर वित्त, हेल्थकेयर या ऐसे ही क्षेत्रों में—तो आपको पता होना चाहिए कि Spark ऑथेंटिकेशन, एन्क्रिप्शन और ऑडिटेबिलिटी को कैसे संभालता है।

तो आइए इन टॉपिक्स में गहराई से उतरते हैं और देखते हैं Spark इन्हें कैसे संभालता है।

ऑथेंटिकेशन और एन्क्रिप्शन

Spark में कई सिक्योरिटी फ़ीचर्स हैं जिन्हें आपको पहले सक्षम करना होता है। लेकिन एक बार सक्षम कर लेने पर, Spark सुरक्षित कम्युनिकेशन और ऑथेंटिकेशन के लिए अच्छा टूलबॉक्स देता है: 

  • ऑथेंटिकेशन (SASL): Spark Simple Authentication and Security Layer (SASL) का उपयोग करता है ताकि सिर्फ अधिकृत उपयोगकर्ता और सेवाएँ ही जॉब सबमिट कर सकें या क्लस्टर से कनेक्ट हो सकें।
  • इन-ट्रांज़िट एन्क्रिप्शन (AES-GCM, SSL/TLS): Spark नोड्स के बीच कम्युनिकेशन को AES-GCM (ऑथेंटिकेटेड एन्क्रिप्शन) या TLS से एन्क्रिप्ट करता है। यह जॉब डेटा को स्निफ़िंग से बचाता है—मल्टी-टेनेंट या क्लाउड एन्वायरनमेंट्स में विशेष रूप से महत्वपूर्ण।
  • Kerberos इंटिग्रेशन: यदि आप Hadoop/YARN पर चल रहे हैं, तो Spark सुरक्षित यूज़र ऑथेंटिकेशन के लिए Kerberos के साथ इंटिग्रेट करता है। इससे आपके Spark जॉब्स सीधे एंटरप्राइज़ identity और access मैनेजमेंट सिस्टम्स से जुड़ जाते हैं।
  • UI एक्सेस कंट्रोल: Spark Web UI संवेदनशील जानकारी (जैसे लॉग्स, इनपुट पाथ, SQL क्वेरीज़) दिखा सकता है, इसलिए spark.acls.enable=true और spark.ui.view.acls व spark.ui.view.acls.groups सेट कर इसे सीमित करें।

आप सभी सिक्योरिटी फ़ीचर्स आधिकारिक डॉक्यूमेंटेशन में देख सकते हैं। देखें और सुनिश्चित करें कि अपनी Spark एप्लिकेशंस को सुरक्षित करने के लिए आवश्यक फ़ीचर्स सक्षम किए गए हैं।

ऑडिट और कंप्लायंस

किसने क्या और कब किया—यह लॉग करना भी बेहद ज़रूरी है। 

Spark सपोर्ट करता है: 

  • इवेंट लॉगिंग: सक्षम होने पर (spark.eventLog.enabled=true) Spark हर जॉब, स्टेज और टास्क इवेंट को डिस्क पर रिकॉर्ड करता है। आप इन लॉग्स से जॉब हिस्ट्री रिप्ले कर सकते हैं या ऑडिट आवश्यकताओं को पूरा कर सकते हैं।
  • रोल-बेस्ड एक्सेस कंट्रोल (RBAC): Spark खुद RBAC नहीं देता, लेकिन यदि आप Databricks, EMR या OpenShift जैसे प्लेटफ़ॉर्म्स के जरिए Spark उपयोग करते हैं, तो आमतौर पर इन्फ्रास्ट्रक्चर लेयर पर RBAC मिलता है। Spark एक परिभाषित identity के साथ जॉब सबमिट करता है, जो डेटा और कम्प्यूट रिसोर्सेज़ तक पहुँच नियंत्रित करती है।
  • सोर्स-लेवल डेटा मास्किंग और एक्सेस कंट्रोल: Spark कई सोर्सेज़ (Parquet, Delta Lake, Hive, आदि) से पढ़ता है, और आपका एक्सेस कंट्रोल यहीं लागू होना चाहिए।

परफॉर्मेंस ऑप्टिमाइज़ेशन पैटर्न्स

Spark काफ़ी शक्तिशाली और तेज़ है—और यदि आपको पता हो कि कहाँ समायोजन करने हैं, तो इसे और भी तेज़ बनाया जा सकता है। 

कई क्षेत्र हैं जहाँ आप Spark से अधिकतम लाभ पाने के लिए ऑप्टिमाइज़ कर सकते हैं। तो आइए हर क्षेत्र में थोड़ा गहराई से जाएँ।

शफ़ल ऑप्टिमाइज़ेशन

यदि Spark की कोई कमजोर कड़ी है, तो वह शफ़ल है। शफ़ल तब होता है जब डेटा को पार्टिशन के बीच मूव करना पड़ता है—आम तौर पर groupByKey(), distinct() या join() जैसे वाइड ट्रांसफॉर्मेशन के बाद।

और जब शफ़ल गलत हो जाए, तो भारी डिस्क I/O, लंबे गार्बेज कलेक्शन पॉज़ या ऐसी स्क्यूड टास्क्स मिलती हैं जो खत्म ही नहीं होतीं। 

शफ़ल बेहतर करने के कुछ तरीके:

  • प्राथमिकता दें reduceByKey() के ऊपर groupByKey(): reduceByKey() शफ़ल से पहले लोकल एग्रीगेशन करता है, जबकि groupByKey() सबकुछ नेटवर्क पर भेजता है।
  • स्मार्टली repartition करें: समानांतरता बढ़ाने के लिए .repartition(n) या घटाने के लिए .coalesce(n) उपयोग करें। इसे Spark की डिफ़ॉल्ट पार्टिशनिंग पर न छोड़ें।
  • ब्रॉडकास्ट जॉइन (सोच-समझकर) उपयोग करें: यदि एक डेटासेट छोटा है, तो उसे सभी वर्कर्स पर ब्रॉडकास्ट करें। साइज लिमिट नियंत्रित करने के लिए spark.sql.autoBroadcastJoinThreshold सेट करें।
  • से बचें collect(): संभव हो तो इससे बचें—डेटा ड्राइवर पर खींचना परफॉर्मेंस गिरा देता है।

मेमोरी कॉन्फ़िगरेशन गाइडलाइंस

Spark की मेमोरी ट्यूनिंग विज्ञान जैसी लग सकती है, पर यह चेकलिस्ट इसे आसान बना देगी:

  • पर्याप्त मेमोरी आवंटित करें: Spark क्लस्टर के लिए कम से कम 6 GB से शुरू करें और अपनी ज़रूरत के अनुसार समायोजित करें।
  • Spark मेमोरी फ़्रैक्शन पर विचार करें: डिफ़ॉल्ट रूप से 60% Spark में मेमोरी फ़्रैक्शन होता है। यदि आपकी एप्लिकेशन DataFrame/Dataset ऑपरेशंस पर बहुत निर्भर है या आपको अधिक यूज़र मेमोरी चाहिए, तो इसे बढ़ाएँ। 
  • प्रति एक्ज़ीक्यूटर सही कोर संख्या उपयोग करें: आमतौर पर 3–5 उत्तम हैं। बहुत कम होंगे तो अंडरयूटिलाइज़ेशन, बहुत ज़्यादा होंगे तो टास्क कंटेंशन।
  • डायनामिक अलोकेशन सक्षम करें (यदि सपोर्टेड): Spark वर्कलोड के आधार पर एक्ज़ीक्यूटर्स को ऊपर/नीचे स्केल कर सकता है। 
spark.dynamicAllocation.enabled=true
spark.dynamicAllocation.minExecutors=2
spark.dynamicAllocation.maxExecutors=20
  • स्टोरेज फ़्रैक्शन समायोजित करें: यदि आपको अधिक कैशिंग चाहिए, तो spark.memory.storageFraction बढ़ाएँ।
  • मॉनिटर और प्रोफ़ाइल करें: Spark UI या VisualVM जैसे टूल्स से मेमोरी खपत ट्रैक करें और बॉटलनेक्स पहचानें।

मेमोरी कॉन्फ़िगरेशन समायोजित करने से बड़ा लाभ हो सकता है। मैंने सिर्फ मेमोरी कॉन्फ़िगरेशन बदलकर—बिना एक भी कोड लाइन बदले—30 मिनट के जॉब को 8 मिनट में ला दिया था।

क्लस्टर साइज़िंग फ़ॉर्मूलाज़

यह वह हिस्सा है जहाँ ज़्यादातर टीमें चूक जाती हैं—क्योंकि वे क्लस्टर आकार का अनुमान लगा लेती हैं, सही आकलन नहीं करतीं। 

लेकिन आप नीचे दिए फ़ॉर्मूलाज़ से बेहतर कर सकते हैं: 

  1. पार्टिशन की संख्या निर्धारित करें: 
    • अपने डेटा साइज और वांछित पार्टिशन साइज के आधार पर आवश्यक पार्टिशन संख्या निकालें। 
    • सामान्य गाइडलाइन: अनकंप्रेस्ड डेटा के प्रति 128 MB से 256 MB पर एक पार्टिशन।
    • फ़ॉर्मूला: पार्टिशन = Round up(कुल डेटा साइज ÷ पार्टिशन साइज)।
  2. कुल कोर की संख्या निकालें: 
    • इतने कोर चाहिए कि सभी पार्टिशन समानांतर में प्रोसेस हो सकें।
    • फ़ॉर्मूला: टोटल कोर = Round up(पार्टिशन की संख्या ÷ प्रति कोर पार्टिशन)।
  3. प्रति एक्ज़ीक्यूटर मेमोरी निर्धारित करें: 
    • प्रति एक्ज़ीक्यूटर कोर, पार्टिशन साइज और ओवरहेड के आधार पर मेमोरी निकालें।
    • फ़ॉर्मूला: प्रति एक्ज़ीक्यूटर मेमोरी = बेस मेमोरी × (1 + ओवरहेड प्रतिशत)।
  4. एक्ज़ीक्यूटर्स की संख्या निकालें: 
    • कुल कोर और प्रति एक्ज़ीक्यूटर कोर के आधार पर एक्ज़ीक्यूटर्स की संख्या तय करें।
    • फ़ॉर्मूला: एक्ज़ीक्यूटर्स = Round up(टोटल कोर ÷ प्रति एक्ज़ीक्यूटर कोर)।
  5. कुल मेमोरी निकालें: 
    • क्लस्टर के लिए आवश्यक कुल मेमोरी = एक्ज़ीक्यूटर्स की संख्या × प्रति एक्ज़ीक्यूटर मेमोरी।

उदाहरण के लिए: 

  • इनपुट: 500GB डेटा, पार्टिशन साइज ~128MB
  • पार्टिशन: ~4,000 पार्टिशन
  • कोर: 4,000 पार्टिशन / 4 पार्टिशन प्रति कोर = 1,000
  • प्रति एक्ज़ीक्यूटर मेमोरी: मान लें 8 GB प्रति एक्ज़ीक्यूटर और 20% ओवरहेड। 8 GB * 1.20 = 9.6 GB
  • एक्ज़ीक्यूटर्स: 1,000 कोर / 4 कोर प्रति एक्ज़ीक्यूटर = 250 एक्ज़ीक्यूटर्स
  • कुल मेमोरी: 250 एक्ज़ीक्यूटर्स * 9.6GB = 2,400 GB

पर याद रखें: यह केवल एक अनुमान है। इसे शुरुआती बिंदु मानें और फिर प्रोफाइलिंग से आगे ऑप्टिमाइज़ करें।

उभरते आर्किटेक्चरल ट्रेंड्स

Spark एक दशक से मौजूद है, पर आज भी काफ़ी प्रासंगिक है। क्लाउड-नेटिव प्लेटफ़ॉर्म, GPU एक्सेलेरेशन और कड़ी ML इंटिग्रेशन की बदौलत यह पहले से तेज़ी से विकसित हो रहा है।

यदि आप आज भी Spark को वैसा ही उपयोग कर रहे हैं जैसा तीन साल पहले करते थे, तो संभव है कि आप परफॉर्मेंस और नए फ़ीचर्स—दोनों ही टेबल पर छोड़ रहे हों।

आइए कुछ नए फ़ीचर्स पर नज़र डालें।

Photon इंजन (Databricks)

यदि आप Databricks के साथ काम करते हैं, तो आपने शायद Photon के बारे में सुना और काम किया होगा।

Databricks के बारे में अधिक जानना चाहते हैं तो Introduction to Databricks कोर्स देखें।

Photon, Databricks Lakehouse प्लेटफ़ॉर्म पर नेक्स्ट-जनरेशन इंजन है जो कम लागत पर तेज़ क्वेरी परफॉर्मेंस देता है। यह Spark APIs से संगत है, इसलिए इसका उपयोग करने के लिए आपको Spark कोड बदलने की ज़रूरत नहीं। 

यह आपके SQL और PySpark कोड को उल्लेखनीय रूप से बूस्ट करता है।

Photon में निम्नलिखित फ़ीचर्स शामिल हैं: 

  • वेक्टराइज़्ड एक्ज़िक्यूशन: Photon कॉलमनर बैचों में डेटा प्रोसेस करता है, SIMD (Single Instruction, Multiple Data) CPU निर्देशों का लाभ लेकर एक साथ कई मूल्यों पर ऑपरेशन करता है। पारंपरिक Spark रो-बाय-रो एक्ज़िक्यूशन करता है और मेमोरी अलोकेशन व गार्बेज कलेक्शन के लिए JVM पर अधिक निर्भर रहता है।
  • C++ रनटाइम (कोई JVM ओवरहेड नहीं): जावा गार्बेज कलेक्शन नहीं—जो बड़े Spark जॉब्स में बॉटलनेक बन सकता है। C++ में मेमोरी सटीकता से मैनेज होती है।
  • बेहतर क्वेरी ऑप्टिमाइज़ेशन: Photon Spark के Catalyst Optimizer से गहराई से इंटिग्रेट होता है, साथ ही एक्ज़िक्यूशन के दौरान अपने ऑप्टिमाइज़ेशन (जैसे रनटाइम फ़िल्टरिंग, एडैप्टिव कोड पाथ्स, जॉइन और एग्रीगेशन ऑप्टिमाइज़ेशन) भी लाता है। 
  • हार्डवेयर एक्सेलेरेशन: आधुनिक हार्डवेयर सपोर्ट (जैसे NVIDIA GPUs, Intel CPUs के AVX-512 इंस्ट्रक्शन सेट, AWS पर Graviton (ARM) प्रोसेसर्स)। 

Serverless Spark

Serverless बेहतरीन है—आपको क्लस्टर्स मैनेज नहीं करने पड़ते, रिसोर्सेज़ पहले से प्रोविज़न नहीं करने होते, और आप सिर्फ उतने समय का भुगतान करते हैं जितना Spark वाकई चल रहा होता है। 

और Spark के लिए सर्वरलेस, Databricks Serverless, AWS Glue, और GCP Dataproc Serverless जैसी सेवाओं में पहले से उपलब्ध है।

और यह शानदार क्यों है:

  • ऑटोमैटिक स्केलिंग: प्लेटफ़ॉर्म जॉब की वास्तविक ज़रूरत के हिसाब से कम्प्यूट स्केल करता है, यानी आपको नोड्स की संख्या का अनुमान नहीं लगाना पड़ता।
  • लागत-कुशलता: आप सिर्फ उपयोग के मुताबिक भुगतान करते हैं—idle सर्वर्स के लिए नहीं। 
  • सरलता: क्लस्टर सेटअप, कॉन्फ़िगरेशन या मेन्टेनेन्स का झंझट नहीं—प्लेटफ़ॉर्म संभालता है।
  • परफॉर्मेंस: तेज़ एक्ज़ीक्यूशन संभव—क्योंकि आपके लिए कॉन्फ़िगरेशन और सेटअप ऑप्टिमाइज़ होते हैं।

Serverless Spark, इंटरैक्टिव एनालिटिक्स, ऐड-हॉक जॉब्स या अप्रत्याशित वर्कलोड्स के लिए आदर्श है।

पर सावधानी रखें: लंबे समय तक चलने वाली, स्थिर पाइपलाइंस फिक्स्ड क्लस्टर्स पर अब भी सस्ती पड़ सकती हैं। हमेशा लागत और लेटेंसी—दोनों नापें।

MLflow इंटिग्रेशन

जैसे-जैसे इंडस्ट्री शिफ्ट हो रही है, डेटा इंजीनियरिंग और AI के बीच की रेखा धुंधली हो रही है। जैसा कि Deepak Goyal, CEO & Founder, Azurelib Academy, ने DataFramed पॉडकास्ट में बताया

डेटा इंजीनियरिंग आने वाले AI शिफ्ट में एक अहम और बुनियादी भूमिका निभाने वाली है।

Deepak Goyal, CEO & Founder at Azurelib Academy

यदि आप स्केल पर मशीन लर्निंग कर रहे हैं और मॉडलों को प्रोडक्शन में ले जाना चाहते हैं, तो सिर्फ Spark काफ़ी नहीं है। आपको MLOps सिद्धांत चाहिए—जैसे एक्सपेरिमेंट ट्रैकिंग, मॉडल वर्शनिंग और रीप्रोड्यूसिबिलिटी। यहीं MLflow फ़िट बैठता है। 

MLflow अब Spark के साथ इंटिग्रेट होता है और आपकी पाइपलाइंस में पूरा MLOps स्टैक लेकर आता है।

आप कर सकते हैं: 

  • एक्सपेरिमेंट ट्रैक करें: Spark ML जॉब्स से पैरामीटर, मेट्रिक्स और आर्टिफ़ैक्ट्स को mlflow.log_param() और mlflow.log_metric() से लॉग करें।
  • मॉडल वर्शनिंग: pyspark.ml या sklearn से मॉडल सीधे MLflow के मॉडल रजिस्ट्री में सेव करें।
  • मॉडल सर्व करें: MLflow की मॉडल सर्विंग से ट्रेन किए मॉडल्स को REST एंडपॉइंट्स पर डिप्लॉय करें।

आपको टूल बदलने की ज़रूरत नहीं। ट्रेनिंग, फीचर इंजीनियरिंग और स्कोरिंग के लिए Spark ही उपयोग करें, और MLOps टास्क्स के लिए MLflow।

निष्कर्ष

यदि आप Spark से ज़्यादा परिचित नहीं हैं, तो यह एक बड़ा ब्लैक बॉक्स लगता है। आप थोड़ा PySpark लिखते हैं, रन दबाते हैं और उम्मीद करते हैं कि काम हो जाए। 

कभी यह मेरे लिए बढ़िया चला, तो कभी लंबे डीबगिंग सेशन में बदल गया—यह समझने में कि गड़बड़ कहाँ हुई। 

जब तक मैंने परदे के पीछे झाँकना शुरू नहीं किया, चीज़ें मेरे लिए समझ में नहीं आईं—और यह समझने में काफ़ी समय लगा कि सच में हो क्या रहा है।

यदि मुझे फिर से शुरू करना हो, तो मैं इन बातों पर फ़ोकस करता: 

  • सीखें कि Spark आपका कोड जॉब्स, स्टेजेज़ और टास्क्स में कैसे तोड़ता है।
  • मेमोरी को समझें।
  • शफ़ल्स पर नज़र रखें।
  • छोटे से शुरू करें और लोकल मोड में चीज़ें चलाएँ। हाथ गंदे करें।

यही तो हमने इस लेख में सीखा।

यदि आप सीखना जारी रखना चाहते हैं, तो ये शुरुआती-अनुकूल संसाधन सुझाऊँगा:

  • Introduction to PySpark: यदि आप अभी सहज हो रहे हैं, तो यह एक बेहतरीन हैंड्स-ऑन शुरुआती बिंदु है।
  • Cleaning Data with PySpark: डेटा क्लीन करना सीखें—क्योंकि वास्तविक दुनिया का डेटा हमेशा मैला होता है।
  • The Top 20 Spark Interview Questions: यह सिर्फ इंटरव्यू के लिए नहीं, आपकी समझ गहरी करने के लिए भी है।
  • Top 4 Apache Spark Certifications in 2025: अगर आप सर्टिफ़िकेशंस के जरिए अपने कौशल का प्रमाण चाहते हैं।

FAQs

मैं अपने Spark डिप्लॉयमेंट के लिए सही क्लस्टर मैनेजर कैसे चुनूँ?

Spark कई क्लस्टर मैनेजर्स (YARN, Mesos, Kubernetes और standalone) सपोर्ट करता है। चुनाव आपके मौजूदा इंफ्रास्ट्रक्चर, रिसोर्स शेयरिंग की ज़रूरत और ऑपरेशनल विशेषज्ञता पर निर्भर है: YARN Hadoop क्लस्टर्स पर अच्छी तरह इंटिग्रेट होता है, Kubernetes कंटेनराइज़्ड पोर्टेबिलिटी देता है, और Mesos मल्टी-टेनेंट आइसोलेशन में बेहतर है।

एक्सटर्नल शफ़ल सर्विस क्या है और यह परफॉर्मेंस कैसे सुधारती है?

एक्सटर्नल शफ़ल सर्विस शफ़ल फ़ाइल सर्विंग को एक्ज़ीक्यूटर लाइफ़साइकल से अलग करती है, जिससे डायनामिक अलोकेशन संभव होता है और एक्ज़ीक्यूटर इविक्शन के दौरान डेटा लॉस घटता है। यह एक्ज़ीक्यूटर्स के बंद होने के बाद भी शफ़ल फ़ाइलें उपलब्ध रखती है—जिससे स्टेज रिट्राइ तेज़ होते हैं और भारी लोड में डिस्क I/O बचता है।

ब्रॉडकास्ट जॉइन अंदर से कैसे काम करता है और इसे कब उपयोग करना चाहिए?

ब्रॉडकास्ट जॉइन्स में, Spark एक छोटी लुकअप टेबल हर एक्ज़ीक्यूटर को भेजता है ताकि फुल डेटा शफ़ल से बचा जा सके। जब जॉइन का एक पक्ष spark.sql.autoBroadcastJoinThreshold (डिफ़ॉल्ट 10 MB) से छोटा हो, तब इसका उपयोग करें—यह नेटवर्क I/O बहुत घटाता है और स्क्यूड की-डिस्ट्रिब्यूशन पर जॉइन्स तेज़ करता है।

Spark में JVM गार्बेज कलेक्शन ट्यूनिंग के लिए सर्वोत्तम प्रथाएँ क्या हैं?

Spark UI या VisualVM जैसे टूल्स से GC पॉज़ मॉनिटर करें और कम पॉज़-टाइम के लिए G1GC कलेक्टर प्राथमिकता दें। एक्ज़ीक्यूटर मेमोरी में ओवरहेड के लिए हेडरूम रखें (spark.executor.memoryOverhead) और -XX:InitiatingHeapOccupancyPercent को ट्यून करें ताकि GC पहले ट्रिगर हो—लंबे स्टॉप-द-वर्ल्ड पॉज़ से बचाव के लिए।

मैं Spark जॉब्स को तेज़ करने के लिए GPU एक्सेलेरेशन का उपयोग कैसे कर सकता/सकती हूँ?

Apache Spark के लिए NVIDIA RAPIDS Accelerator का उपयोग करें ताकि SQL और DataFrame ऑपरेशंस को ट्रांसपेरेंट रूप से GPUs पर ऑफ़लोड किया जा सके। यह Spark के एक्ज़िक्यूशन इंजन में प्लग होता है और CPU-आधारित ऑपरेटर्स की जगह GPU-एक्सेलेरेटेड समकक्ष लगाता है—उपयुक्त वर्कलोड्स में 10× तक तेज़ी देता है।

Spark में स्टैटिक और डायनामिक रिसोर्स अलोकेशन में क्या अंतर है?

स्टैटिक अलोकेशन जॉब की पूरी अवधि के लिए एक्ज़ीक्यूटर्स की संख्या तय कर देती है—पूर्वानुमेयता मिलती है लेकिन idle रिसोर्सेज़ का जोखिम रहता है। डायनामिक अलोकेशन लंबित टास्क्स और वर्कलोड के आधार पर एक्ज़ीक्यूटर्स माँगती या छोड़ती है—शेयर्ड एन्वायरनमेंट्स में उतार-चढ़ाव वाले जॉब्स के लिए क्लस्टर उपयोग बेहतर होता है।

S3 जैसी क्लाउड स्टोरेज पर बेहतरीन परफॉर्मेंस के लिए Spark को कैसे कॉन्फ़िगर करना चाहिए?

S3 ट्रांसफ़र एक्सेलेरेशन सक्षम करें, spark.hadoop.fs.s3a.connection.maximum ट्यून करें, और eventual consistency हैंडल करने के लिए consistent view (S3A v2) का उपयोग करें। लिखने से पहले छोटी फ़ाइलें coalesce करें और S3A कमिटर्स पर विचार करें—लिस्ट-ऑपरेशन ओवरहेड घटाने और राइट थ्रूपुट बढ़ाने के लिए।

Kerberos और TLS के साथ मैं Spark कम्युनिकेशन को कैसे सुरक्षित कर सकता/सकती हूँ?

RPC के लिए TLS सक्षम करें (spark.ssl.enabled) और SASL/Kerberos कॉन्फ़िगर करें (spark.authenticate and spark.kerberos.keytab) ताकि म्यूचुअल ऑथेंटिकेशन लागू हो। क्रेडेंशियल्स को सुरक्षित, HDFS-एक्सेसिबल कीटैब में रखें और Spark UI एक्सेस ACL सेटिंग्स से सीमित करें ताकि अनधिकृत डेटा एक्सपोज़र न हो।

Pandas UDFs क्या हैं और वे नियमित UDFs से कब अधिक कुशल होती हैं?

Pandas UDFs (वेक्टराइज़्ड UDFs) Apache Arrow का उपयोग करती हैं ताकि JVM और Python के बीच डेटा बैचों में एक्सचेंज हो—सीरियलाइज़ेशन ओवरहेड काफी घट जाता है। वे पारंपरिक रो-बाय-रो UDFs की तुलना में जटिल न्यूमेरिकल ऑपरेशंस के लिए अधिक कुशल होती हैं—खासतौर पर जब PySpark में बड़े कॉलमनर बैच प्रोसेस किए जाते हैं।

कस्टम डेटा सोर्सेज़ के लिए DataSource V2 API, V1 की तुलना में क्या लाभ देता है?

DataSource V2 एक क्लीन, अधिक मॉड्यूलर इंटरफ़ेस देता है जो push-down फ़िल्टर्स, पार्टिशन प्रूनिंग और स्ट्रीमिंग सोर्सेज़ को नैटिवली सपोर्ट करता है। यह रीड/राइट पर अधिक सूक्ष्म नियंत्रण और Spark के Catalyst Optimizer के साथ बेहतर इंटिग्रेशन सक्षम करता है—नतीजतन कस्टम कनेक्टर्स के लिए अधिक परफॉर्मेंस और आसान मेंटेनेबिलिटी मिलती है।


Patrick Brus's photo
Author
Patrick Brus
LinkedIn

मैं एक क्लाउड इंजीनियर हूं, जिसकी इलेक्ट्रिकल इंजीनियरिंग, मशीन लर्निंग और प्रोग्रामिंग में मजबूत नींव है। मेरा करियर कंप्यूटर विज़न से शुरू हुआ, जहां मैंने इमेज क्लासिफिकेशन पर काम किया, और बाद में MLOps तथा DataOps की ओर रुख किया। मैं MLOps प्लेटफ़ॉर्म बनाता हूं, डेटा वैज्ञानिकों का सहयोग करता हूं, और मशीन लर्निंग वर्कफ़्लो को सुगम बनाने के लिए Kubernetes-आधारित समाधान प्रदान करता हूं।

विषय
PySpark
डेटा इंजीनियरिंग

इन कोर्सेज़ के साथ Spark के बारे में और जानें!

कोर्स

Python में Spark SQL परिचय

4 घंटा
21.1K
Python में SQL का उपयोग करके Spark में डेटा को मैनिपुलेट करना और मशीन लर्निंग फीचर सेट बनाना सीखें।
विवरण देखेंRight Arrow
पाठ्यक्रम शुरू करें

कोर्स

PySpark परिचय

4 घंटा
34.3K
PySpark में महारत हासिल करें ताकि बड़े डेटा को आसानी से संभाल सकें—विशाल डेटासेट को प्रोसेस, क्वेरी और ऑप्टिमाइज़ करना सीखें, शक्तिशाली एनालिटिक्स के लिए!
और देखेंRight Arrow