

एजेंटिक RAG प्रोजेक्ट का अवलोकन
आइए, मैं आपको चरण-दर-चरण बताता हूँ कि हम क्या बना रहे हैं। यह यहाँ दिखाई गई आर्किटेक्चर पर आधारित एक RAG पाइपलाइन बनाने के बारे में है:
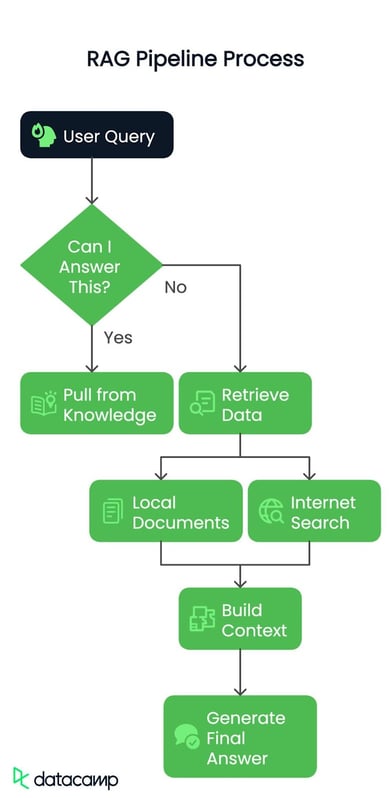
चरण 1: उपयोगकर्ता का प्रश्न
चाहे सवाल सरल हो या जटिल, सब कुछ उपयोगकर्ता के प्रश्न से शुरू होता है। यही वह चिंगारी है जो हमारी पाइपलाइन को चालू करती है।
चरण 2: प्रश्न की रूटिंग
अगला, सिस्टम जांचता है: क्या मैं इसका उत्तर दे सकता हूँ?
हाँ? यह मौजूदा ज्ञान से उत्तर निकालता है और तुरंत दे देता है।
नहीं? तो अब गहराई में जाने का समय! प्रश्न अगले चरण में रूट हो जाता है।
चरण 3: डेटा प्राप्त करना
यदि उत्तर तुरंत उपलब्ध नहीं है, तो पाइपलाइन दो संभावित स्रोतों में जाती है:
- स्थानीय दस्तावेज़: हम एक प्री-प्रोसेस्ड PDF को अपने नॉलेज बेस के रूप में उपयोग करेंगे, जहाँ सिस्टम प्रासंगिक सूचना के टुकड़े खोजेगा।
- इंटरनेट सर्च: यदि अधिक संदर्भ चाहिए, तो पाइपलाइन बाहरी स्रोतों तक पहुंचकर नवीनतम जानकारी स्क्रैप कर सकती है।
चरण 4: संदर्भ बनाना
प्राप्त डेटा—चाहे PDF से हो या वेब से—को एक सुसंगत, प्राप्त संदर्भ में संकलित किया जाता है। इसे ऐसे समझें जैसे पहेली के सारे टुकड़े इकट्ठा करना, उन्हें जोड़ने से पहले।
चरण 5: अंतिम उत्तर जनरेशन
आखिर में, यह संदर्भ एक बड़े भाषा मॉडल (LLM) को दिया जाता है ताकि वह स्पष्ट और सटीक उत्तर तैयार कर सके। यह केवल डेटा प्राप्त करने भर की बात नहीं है, बल्कि उसे समझने और सर्वोत्तम तरीके से प्रस्तुत करने की बात है।
अंत तक, हमारे पास एक स्मार्ट, कुशल RAG पाइपलाइन होगी जो वास्तविक दुनिया के संदर्भ के साथ प्रश्नों का गतिशील रूप से उत्तर दे सकेगी।
स्थानीय डेटा स्रोत
शुरुआत के लिए, मैं एक वास्तविक दुनिया के दस्तावेज़ को हमारे स्थानीय डेटा स्रोत के रूप में उपयोग करने जा रहा हूँ। जिस दस्तावेज़ पर हम काम करेंगे, वह है Generative AI Principles। इसमें ढेर सारी मूल्यवान अंतर्दृष्टियाँ हैं, इसलिए हमारी पाइपलाइन के लिए यह एकदम उपयुक्त टेस्ट केस होगा। आपको फ़ाइल का एक सारांश भी चाहिए होगा, जिसे मैं रूटिंग उद्देश्यों के लिए उपयोग कर रहा हूँ। आप सारांश फ़ाइल यहाँ से ले सकते हैं।
यहाँ वह सब है जिसकी आपको चरण-दर-चरण शुरुआत करने के लिए आवश्यकता होगी।
पूर्वापेक्षाएँ
शुरू करने से पहले, कुछ चीज़ें हैं जो आपके पास होनी चाहिए:
- Groq API कुंजी: आपको Groq से एक API कुंजी चाहिए, जिसे आप यहाँ से प्राप्त कर सकते हैं: Groq API Console
- Gemini API कुंजी: एजेंट्स के साथ ऑर्केस्ट्रेशन में Gemini मदद करेगा; Groq बहुत तेज़ प्रतिक्रियाएँ देता है, लेकिन मौजूदा रेट लिमिट्स के कारण कभी-कभी अटक सकता है: Gemini API Console
- Serper.dev API कुंजी: किसी भी इंटरनेट सर्च फ़ंक्शनैलिटी के लिए, हम Serper.dev का उपयोग करेंगे। यहाँ पंजीकरण करके अपनी API कुंजी प्राप्त करें: Serper.dev API Key
पैकेज इंस्टॉल करना
सुनिश्चित कर लें कि हमारे पास सही टूल्स इंस्टॉल हैं। अपना टर्मिनल खोलें और आवश्यक Python पैकेज इंस्टॉल करने के लिए निम्न कमांड चलाएँ:
pip install langchain-groq faiss-cpu crewai serper pypdf2 python-dotenv setuptools sentence-transformers huggingface distutils`एनवायरनमेंट सेट करना
एक बार जब आपके पास कुंजियाँ और पैकेज तैयार हों, तो आप आगे बढ़ने के लिए तैयार हैं! मैं आपकी API कुंजियों को .env फ़ाइल में या अपने कोडबेस में सुरक्षित रूप से सेव करने की सलाह देता हूँ। आपका .env फ़ाइल कुछ इस तरह दिख सकती है:
import os from dotenv
import load_dotenv from langchain.vectorstores
import FAISS from langchain.document_loaders
import PyPDFLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_huggingface.embeddings import HuggingFaceEmbeddings
from langchain_groq import ChatGroq
from crewai_tools import SerperDevTool
from crewai import Agent, Task, Crew, LLM
load_dotenv()
GROQ_API_KEY = os.getenv("GROQ_API_KEY")
SERPER_API_KEY = os.getenv("SERPER_API_KEY")
GEMINI=os.getenv("GEMINI")मैंने एनवायरनमेंट वेरिएबल्स लोड किए ताकि API कुंजियाँ और संवेदनशील डेटा हार्डकोड किए बिना सुरक्षित रूप से मैनेज किए जा सकें। इससे स्क्रिप्ट सुरक्षित रहती है और ज़रूरत पड़ने पर मैं एक ही जगह (.env फ़ाइल) में कुंजियाँ बदल सकता/सकती हूँ।
संक्षेप में, ये इम्पोर्ट किए गए पैकेज और फ़ंक्शंस क्या करेंगे:
- os: ऑपरेटिंग सिस्टम इंटरफ़ेस यूटिलिटीज़ प्रदान करता है।
- dotenv:
.envफ़ाइलों से एनवायरनमेंट वेरिएबल्स लोड करता है। - FAISS: समानता खोज और रीट्रीवल के लिए वेक्टर स्टोर।
- PyPDFLoader: PDF दस्तावेज़ों से टेक्स्ट सामग्री निकालता है।
- RecursiveCharacterTextSplitter: टेक्स्ट को प्रबंधनीय हिस्सों में रिकर्सिव रूप से विभाजित करता है।
- HuggingFaceEmbeddings: HuggingFace मॉडलों का उपयोग करके टेक्स्ट एम्बेडिंग्स बनाता है।
- ChatGroq: Groq हार्डवेयर एक्सेलेरेशन द्वारा संचालित चैट इंटरफ़ेस।
- SerperDevTool: वेब सर्च करने का टूल।
- ScrapeWebsiteTool: वेब पेजों से डेटा निकालता है।
- Agent: भूमिका और लक्ष्य के साथ AI इकाई परिभाषित करता है।
- Task: किसी एजेंट के लिए विशिष्ट उद्देश्य या कार्रवाई दर्शाता है।
- Crew: संयोजित वर्कफ़्लोज़ के लिए एजेंट्स और कार्यों का समन्वय करता है।
- LLM: टेक्स्ट प्रतिक्रियाएँ जनरेट करने के लिए बड़े भाषा मॉडल का इंटरफ़ेस।
LLMs को इनिशियलाइज़ करना
हम दो भाषा मॉडलों को इनिशियलाइज़ करके शुरू करते हैं:
llm: रूटिंग और उत्तर जनरेट करने जैसे सामान्य कार्यों के लिए। हमllama-3.3-70b-specdecमॉडल का उपयोग करेंगे।crew_llm: विशेष रूप से वेब-स्क्रैपिंग एजेंट के लिए, क्योंकि इसे थोड़ी अलग कॉन्फ़िगरेशन (जैसे अधिक रचनात्मक आउटपुट के लिए टेम्परेचर) की जरूरत होती है। हमgemini/gemini-1.5-flashमॉडल उपयोग करेंगे।
# Initialize LLM
llm = ChatGroq(
model="llama-3.3-70b-specdec",
temperature=0,
max_tokens=500,
timeout=None,
max_retries=2,
)
crew_llm = LLM(
model="gemini/gemini-1.5-flash",
api_key=GEMINI,
max_tokens=500,
temperature=0.7
)डिसीजन मेकर जोड़ना
नीचे दिया गया check_local_knowledge() फ़ंक्शन एक निर्णयकर्ता के रूप में काम करता है। मैंने एक प्रॉम्प्ट बनाया जहाँ मैंने उपयोगकर्ता का प्रश्न और कुछ स्थानीय संदर्भ (PDF से) पास किया। मॉडल "Yes" या "No" में से एक के साथ प्रतिक्रिया देता है, यह बताते हुए कि क्या प्रश्न का उत्तर देने के लिए स्थानीय रूप से पर्याप्त जानकारी है। यदि नहीं, तो हम वेब स्क्रैपिंग का सहारा लेंगे।
def check_local_knowledge(query, context):
"""Router function to determine if we can answer from local knowledge"""
prompt = '''Role: Question-Answering Assistant
Task: Determine whether the system can answer the user's question based on the provided text.
Instructions:
- Analyze the text and identify if it contains the necessary information to answer the user's question.
- Provide a clear and concise response indicating whether the system can answer the question or not.
- Your response should include only a single word. Nothing else, no other text, information, header/footer.
Output Format:
- Answer: Yes/No
Study the below examples and based on that, respond to the last question.
Examples:
Input:
Text: The capital of France is Paris.
User Question: What is the capital of France?
Expected Output:
Answer: Yes
Input:
Text: The population of the United States is over 330 million.
User Question: What is the population of China?
Expected Output:
Answer: No
Input:
User Question: {query}
Text: {text}
'''
formatted_prompt = prompt.format(text=context, query=query)
response = llm.invoke(formatted_prompt)
return response.content.strip().lower() == "yes"वेब सर्चिंग और स्क्रैपिंग एजेंट
अगला, हम crewai लाइब्रेरी का उपयोग करके एक वेब सर्चिंग और स्क्रैपिंग एजेंट सेट करते हैं। यह एजेंट एक सर्च टूल (SerperDevTool) का उपयोग करके उपयोगकर्ता के प्रश्न से संबंधित लेख ढूँढता है। टास्क विवरण यह सुनिश्चित करता है कि एजेंट क्या निकालना है, यह जानता हो, और वह प्रासंगिक वेब सामग्री का सारांश बनाता है। यह ऐसा है जैसे इंटरनेट से डेटा लाने के लिए किसी विशेषज्ञ कार्यकर्ता को भेजना।
इसके बाद, get_web_content() फ़ंक्शन वेब स्क्रैपिंग एजेंट चलाता है। यह इनपुट के रूप में प्रश्न भेजता है और सबसे प्रासंगिक लेख का संक्षिप्त सारांश प्राप्त करता है। यह कच्चा परिणाम लौटाता है, जो हमारा संदर्भ बनता है यदि राउटर तय करता है कि स्थानीय जानकारी पर्याप्त नहीं है।
def setup_web_scraping_agent():
"""Setup the web scraping agent and related components"""
search_tool = SerperDevTool() # Tool for performing web searches
scrape_website = ScrapeWebsiteTool() # Tool for extracting data from websites
# Define the web search agent
web_search_agent = Agent(
role="Expert Web Search Agent",
goal="Identify and retrieve relevant web data for user queries",
backstory="An expert in identifying valuable web sources for the user's needs",
allow_delegation=False,
verbose=True,
llm=crew_llm
)
# Define the web scraping agent
web_scraper_agent = Agent(
role="Expert Web Scraper Agent",
goal="Extract and analyze content from specific web pages identified by the search agent",
backstory="A highly skilled web scraper, capable of analyzing and summarizing website content accurately",
allow_delegation=False,
verbose=True,
llm=crew_llm
)
# Define the web search task
search_task = Task(
description=(
"Identify the most relevant web page or article for the topic: '{topic}'. "
"Use all available tools to search for and provide a link to a web page "
"that contains valuable information about the topic. Keep your response concise."
),
expected_output=(
"A concise summary of the most relevant web page or article for '{topic}', "
"including the link to the source and key points from the content."
),
tools=[search_tool],
agent=web_search_agent,
)
# Define the web scraping task
scraping_task = Task(
description=(
"Extract and analyze data from the given web page or website. Focus on the key sections "
"that provide insights into the topic: '{topic}'. Use all available tools to retrieve the content, "
"and summarize the key findings in a concise manner."
),
expected_output=(
"A detailed summary of the content from the given web page or website, highlighting the key insights "
"and explaining their relevance to the topic: '{topic}'. Ensure clarity and conciseness."
),
tools=[scrape_website],
agent=web_scraper_agent,
)
# Define the crew to manage agents and tasks
crew = Crew(
agents=[web_search_agent, web_scraper_agent],
tasks=[search_task, scraping_task],
verbose=1,
memory=False,
)
return crew
def get_web_content(query):
"""Get content from web scraping"""
crew = setup_web_scraping_agent()
result = crew.kickoff(inputs={"topic": query})
return result.rawवेक्टर डेटाबेस बनाना
setup_vector_db() फ़ंक्शन एक PDF फ़ाइल से वेक्टर डेटाबेस सेट करता है। मैंने इसे चरण-दर-चरण ऐसे किया:
- PDF लोड करें: सामग्री निकालने के लिए मैंने
PyPDFLoaderका उपयोग किया। - टेक्स्ट को हिस्सों में बाँटना: मैंने
RecursiveCharacterTextSplitterका उपयोग कर PDF सामग्री को छोटे हिस्सों में बाँटा (1000 कैरेक्टर्स, 50 कैरेक्टर ओवरलैप के साथ)। इससे डेटा प्रबंधनीय और सर्च करने योग्य बनता है। - वेक्टर DB बनाना: मैंने सेंटेंस-ट्रांसफॉर्मर मॉडल का उपयोग करके हिस्सों को एम्बेड किया और उन्हें FAISS वेक्टर डेटाबेस में स्टोर किया। यह मुझे प्रासंगिक टेक्स्ट को कुशलतापूर्वक खोजने देता है।
इसके बाद, get_local_content() फ़ंक्शन उपयोगकर्ता के प्रश्न से संबंधित शीर्ष 5 सबसे प्रासंगिक हिस्सों के लिए वेक्टर डेटाबेस को क्वेरी करता है। फिर इन हिस्सों को एकल स्ट्रिंग संदर्भ में जोड़ता है।
def setup_vector_db(pdf_path):
"""Setup vector database from PDF"""
# Load and chunk PDF
loader = PyPDFLoader(pdf_path)
documents = loader.load()
text_splitter = RecursiveCharacterTextSplitter(
chunk_size=1000,
chunk_overlap=50
)
chunks = text_splitter.split_documents(documents)
# Create vector database
embeddings = HuggingFaceEmbeddings(
model_name="sentence-transformers/all-mpnet-base-v2"
)
vector_db = FAISS.from_documents(chunks, embeddings)
return vector_db
def get_local_content(vector_db, query):
"""Get content from vector database"""
docs = vector_db.similarity_search(query, k=5)
return " ".join([doc.page_content for doc in docs])अंतिम उत्तर जनरेट करना
जब मेरे पास संदर्भ आ जाता है (चाहे स्थानीय दस्तावेज़ों से या वेब स्क्रैपिंग से), तो मैं उसे उपयोगकर्ता के प्रश्न के साथ भाषा मॉडल को पास करता हूँ। LLM बातचीत के प्रारूप में संदर्भ और प्रश्न दोनों को मिलाकर अंतिम उत्तर जनरेट करता है।
मुख्य क्वेरी प्रोसेसिंग का प्रवाह इस प्रकार है:
- रूटिंग: मैं
check_local_knowledge()का उपयोग करता/करती हूँ यह तय करने के लिए कि क्या स्थानीय PDF सामग्री में प्रश्न का उत्तर देने के लिए पर्याप्त डेटा है। - यदि "Yes" है, तो मैं वेक्टर डेटाबेस से प्रासंगिक हिस्से लाता/लाती हूँ।
- यदि "No" है, तो मैं वेब से प्रासंगिक लेख स्क्रैप करता/करती हूँ।
- अंतिम उत्तर: संदर्भ मिलने के बाद, मैं उसे LLM को पास करता/करती हूँ ताकि अंतिम प्रतिक्रिया जनरेट हो सके।
def generate_final_answer(context, query):
"""Generate final answer using LLM"""
messages = [
(
"system",
"You are a helpful assistant. Use the provided context to answer the query accurately.",
),
("system", f"Context: {context}"),
("human", query),
]
response = llm.invoke(messages)
return response.content
def process_query(query, vector_db, local_context):
"""Main function to process user query"""
print(f"Processing query: {query}")
# Step 1: Check if we can answer from local knowledge
can_answer_locally = check_local_knowledge(query, local_context)
print(f"Can answer locally: {can_answer_locally}")
# Step 2: Get context either from local DB or web
if can_answer_locally:
context = get_local_content(vector_db, query)
print("Retrieved context from local documents")
else:
context = get_web_content(query)
print("Retrieved context from web scraping")
# Step 3: Generate final answer
answer = generate_final_answer(context, query)
return answerअंत में, हम main() फ़ंक्शन के साथ सब कुछ जोड़ते हैं:
def main():
# Setup
pdf_path = "genai-principles.pdf"
# Initialize vector database
print("Setting up vector database...")
vector_db = setup_vector_db(pdf_path)
# Get initial context from PDF for routing
local_context = get_local_content(vector_db, "")
# Example usage
query = "What is Agentic RAG?"
result = process_query(query, vector_db, local_context)
print("\nFinal Answer:")
print(result)
if __name__ == "__main__":
main()ऊपर, हमने:
- वेक्टर डेटाबेस सेट किया: PDF को लोड किया और प्रोसेस किया।
- स्थानीय संदर्भ इनिशियलाइज़ किया: हमने राउटर को संदर्भ के रूप में पास करने के लिए PDF से कुछ सामान्य सामग्री प्राप्त की।
- एक उदाहरण प्रश्न चलाया: हमने एक नमूना प्रश्न (
"What is Agentic RAG?") चलाया और अंतिम उत्तर प्रिंट किया।
कार्यक्रम का आउटपुट यह है:
Agentic RAG is a technique for building Large Language Model (LLM) powered applications that incorporates AI agents. It is an extension of the traditional Retrieval-Augmented Generation (RAG) approach, which uses an external knowledge source to provide the LLM with relevant context and reduce hallucinations.
In traditional RAG pipelines, the retrieval component is typically composed of an embedding model and a vector database, and the generative component is an LLM. At inference time, the user query is used to run a similarity search over the indexed documents to retrieve the most similar documents to the query and provide the LLM with additional context.
Agentic RAG, on the other hand, introduces AI agents that are designed to interact with the user query and provide additional context to the LLM. These agents can be thought of as "virtual assistants" that help the LLM to better understand the user's intent and retrieve relevant documents.
The key components of Agentic RAG include:
1. AI agents: These are the virtual assistants that interact with the user query and provide additional context to the LLM.
2. Retrieval component: This is the component that retrieves the most similar documents to the user query.
3. Generative component: This is the component that uses the retrieved documents to generate the final output.
Agentic RAG has several benefits, including:
1. Improved accuracy: By providing additional context to the LLM, Agentic RAG can improve the accuracy of the generated output.
2. Enhanced user experience: Agentic RAG can help to reduce the complexity of the user interface and provide a more natural and intuitive experience.
3. Increased flexibility: Agentic RAG can be easily extended to support new use cases and applications.
However, Agentic RAG also has some limitations, including:
1. Increased complexity: Agentic RAG requires additional components and infrastructure, which can increase the complexity of the system.
2. Higher computational requirements: Agentic RAG requires more computational resources to handle the additional complexity of the AI agents and the retrieval component.
3. Training requirements: Agentic RAG requires more data and training to learn the behaviour of the AI agents and the retrieval component.आउटपुट की व्याख्या
जब मैंने यह प्रश्न पूछा, "What is Agentic RAG?" जो उपलब्ध दस्तावेज़ में स्पष्ट रूप से मौजूद नहीं था, तो सिस्टम ने अपनी लचीलापन और बुद्धिमत्ता दिखाई। crewAI एजेंट्स ने राउटर की इस समझ का उपयोग करते हुए क्वेरी को सही ढंग से रूट किया कि बाहरी संदर्भ आवश्यक है। एजेंट्स ने वेब से सबसे प्रासंगिक लेख को स्क्रैप किया, उसकी सामग्री का विश्लेषण किया और एक सूचित प्रतिक्रिया जनरेट की।
सिस्टम ने एजेंटिक RAG, उसके घटकों (AI एजेंट्स, रीट्रीवल, और जेनरेटिव एलिमेंट्स), लाभ (सटीकता, उपयोगकर्ता अनुभव, और लचीलापन), और सीमाएँ (जटिलता, कम्प्यूटेशनल आवश्यकताएँ, और प्रशिक्षण आवश्यकताएँ) का स्पष्ट विवरण प्रदान किया।
यह पाइपलाइन की उस क्षमता को दर्शाता है जो संदर्भ को गतिशील रूप से लाती है और अपने प्रारंभिक डेटासेट से परे प्रश्नों पर भी सटीक, संक्षिप्त और मूल्यवान अंतर्दृष्टि देती है।
निष्कर्ष
हमारी बनाई पाइपलाइन एक गतिशील, बहु-चरणीय प्रक्रिया है जो मौजूदा और बाहरी ज्ञान को मिलाकर उपयोगकर्ता प्रश्नों को कुशलतापूर्वक संभालती है।
सिस्टम विविध प्रश्नों के अनुरूप गतिशील रूप से ढल सकता है और सटीक, उपयोगकर्ता-अनुकूल उत्तर प्रदान कर सकता है। स्थानीय डेटा, लाइव इंटरनेट सर्च, और एक सहज इंटरफ़ेस के एकीकरण के साथ, RAG पाइपलाइन वास्तविक दुनिया के अनुप्रयोगों के लिए एक मज़बूत और व्यावहारिक समाधान साबित होती है। अगले कदम के रूप में, इस वर्कफ़्लो का उपयोग करके अपना कुछ बनाने की कोशिश करें।

सीनियर GenAI इंजीनियर और कंटेंट क्रिएटर, जिन्होंने GenAI और डेटा साइंस पर ज्ञान साझा करके 2 करोड़ व्यूज़ हासिल किए हैं।
कितनी बार आपने चाहा है कि आपका AI सिर्फ वही न दोहराए जो वह पहले से जानता है, बल्कि उससे आगे बढ़कर कुछ करे? एक ऐसे व्यक्ति के रूप में जिसने अनगिनत घंटे AI सिस्टम्स को निखारने में लगाए हैं, मैं कह सकता हूँ कि पारंपरिक मॉडल, प्रभावशाली होने के बावजूद, अक्सर उस बुलबुले में फंसे लगते हैं जो सिर्फ उनके ट्रेनिंग डेटा तक सीमित है। यहीं पर एजेंटिक RAG तस्वीर में आता है।
एजेंटिक RAG में, एजेंटिक AI की निर्णय-क्षमता रीट्रीवल-ऑगमेंटेड जेनरेशन (RAG) की अनुकूलनशीलता से मिलती है। साथ मिलकर, ये एक ऐसा सिस्टम बनाते हैं जो स्वतःस्फूर्त तरीके से जानकारी तक पहुंच सकता है, उसका तर्क कर सकता है और प्रासंगिक जानकारी जनरेट कर सकता है।
मैंने पहले एजेंटिक RAG पर एक लेख लिखा है जो सैद्धांतिक दृष्टिकोण से आपको इसके बारे में सब कुछ समझने में मदद करेगा। यह लेख अधिक हाथ-से-हाथ का है, तो आइए उसी पर ध्यान दें।