कई लोगों के लिए, लार्ज लैंग्वेज मॉडल (LLMs) मुख्य रूप से संवादात्मक इंटरफ़ेस के रूप में उपयोग होते हैं। आप प्रश्न पूछते हैं, मॉडल उत्तर देता है, और वहीं इंटरैक्शन समाप्त हो जाता है।
हालांकि, LLMs इससे अधिक करने में सक्षम हैं: इन्हें ऐसे सिस्टम में एम्बेड किया जा रहा है जो स्वायत्त रूप से योजना बना सकते हैं, याद रख सकते हैं और कार्रवाई कर सकते हैं—इन्हीं से LLM एजेंट बनते हैं। एजेंटिक सिस्टम आधुनिक एनालिटिक्स और बिज़नेस वर्कफ़्लो में तेजी से लोकप्रिय हो रहे हैं।
इस लेख के अंत तक, आप समझ जाएंगे कि LLM एजेंट क्या होते हैं, वे कैसे बनाए जाते हैं, एजेंटों के अलग-अलग प्रकार क्या हैं, और वे कहाँ मूल्य पैदा कर सकते हैं।
इस लेख की जानकारी का अधिकतम लाभ उठाने के लिए, इसे AI Fundamentals स्किल ट्रैक के साथ जोड़कर पढ़ें ताकि AI और LLMs पर अपनी जानकारी ताज़ा कर सकें।
LLM एजेंट क्या है?
आइए बात करते हैं कि LLM एजेंट मानक भाषा मॉडलों से कैसे भिन्न हैं।
आपका सामान्य LLM इंटरफ़ेस, जैसे चैटबॉट, केवल प्रॉम्प्ट ले सकता है और अपनी ट्रेनिंग के आधार पर उत्तर दे सकता है—बिना बाहरी कार्रवाइयों या स्टेट के। इसके विपरीत, एक LLM एजेंट LLM को अपने मुख्य तर्क इंजन (यानी मस्तिष्क) के रूप में उपयोग करता है और उसके इर्द-गिर्द सहायक घटक जोड़ता है, जो उसे तर्क करने, योजना बनाने और निष्पादित करने की क्षमता देते हैं।
LLM एजेंट फोकस को ऑटोमेशन से बढ़ाकर ऑटोनॉमी पर ले आते हैं।
ऑटोमेशन LLMs को इनपुट लेने और चरणों की एक शृंखला का पालन करके आउटपुट बनाने में सक्षम बनाता है। ऑटोनॉमी के साथ, हम LLM को टूल्स का एक सेट और यह क्षमता देते हैं कि वह स्थिति के बारे में जो जानता है, उसके आधार पर समाधान तक पहुँचने का सर्वोत्तम तरीका स्वयं तय करे। यह LLM को “स्वतंत्र” रूप से कार्य करने के लिए अधिक लचीलापन और जटिलता देता है।
एक साधारण LLM को ऐसे विशेषज्ञ सलाहकार की तरह सोचें जो अपने ज्ञान के आधार पर प्रश्नों का उत्तर देता है। एक LLM एजेंट उसी विशेषज्ञ की तरह है जो एक टीम का नेतृत्व करता है: यह तय करता है कि कौन से प्रश्न पूछने हैं, किन टीम सदस्यों (टूल्स) से परामर्श करना है, और उनके उत्तरों को समाधान में कैसे संयोजित करना है।
LLM एजेंट के मुख्य घटक
एक LLM एजेंट कई मुख्य घटकों से मिलकर बनता है:
- स्वयं LLM (मस्तिष्क)
- योजना बनाने का लॉजिक
- मेमोरी
- टूल्स
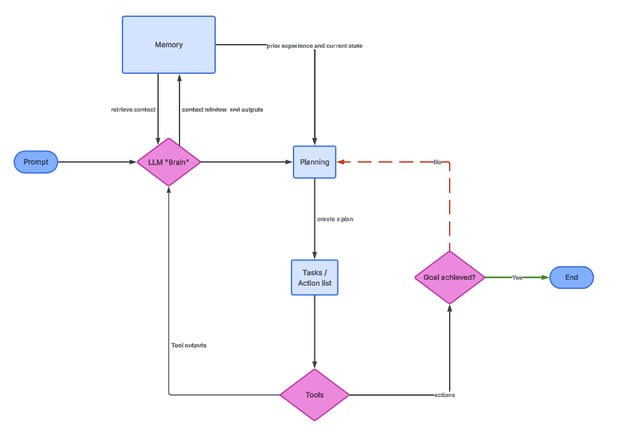
निम्न ग्राफ़ इन सभी के बीच संबंध को दर्शाता है।
LLM मस्तिष्क
LLM एजेंट का संज्ञानात्मक कोर है। यह उपयोगकर्ता के लक्ष्य की व्याख्या करता है, मध्यवर्ती चरणों पर तर्क करता है, और तय करता है कि कौन सी कार्रवाई करनी है। व्यवहार में, LLM को एक से अधिक बार बार-बार कॉल किया जाता है।
हर बार जब LLM को कॉल किया जाता है, तो उसे ऐसा संदर्भ मिलता है जिसमें मूल लक्ष्य, पूर्व की गई कार्रवाइयाँ, टूल आउटपुट और प्रासंगिक मेमोरी शामिल हो सकती है। इस जानकारी के आधार पर यह अगली कार्रवाई तय करता है। इससे LLM एक स्थिर टेक्स्ट जनरेटर की तुलना में नियंत्रक की तरह अधिक कार्य करता है।
डेटा प्रैक्टिशनर्स के लिए यह समझना महत्वपूर्ण है कि LLM सीधे कोड या क्वेरी निष्पादित नहीं करता। यह संरचित निर्देश उत्पन्न करता है जिन्हें अन्य घटक व्याख्यायित करते हैं। किसी एजेंट की गुणवत्ता अक्सर इस पर निर्भर करती है कि ये निर्देश कितनी अच्छी तरह सीमाबद्ध और वैलिडेट किए गए हैं।
योजना बनाने का लॉजिक
प्लानिंग लॉजिक वह तंत्र है जो एजेंटों को जटिल समस्याओं को छोटे-छोटे चरणों में विभाजित कर हल करने देता है। बिना प्लानिंग के, एक एजेंट सब कुछ एक ही उत्तर में सुलझाने की कोशिश करेगा, जो अक्सर त्रुटियों या हैलुसिनेशन की ओर ले जाता है।
प्लानिंग चरण में, एजेंट एक उच्च-स्तरीय उद्देश्य को छोटे-छोटे कार्यों में तोड़ता है। उदाहरण के लिए, “कस्टमर चर्न का विश्लेषण करें” को “कस्टमर डेटा लोड करें”, “चर्न रेट की गणना करें”, “ट्रेन्ड्स की पहचान करें”, और “निष्कर्षों का सारांश दें” में बदला जा सकता है। प्रत्येक उप-कार्य क्रमिक या सशर्त रूप से निष्पादित होता है।
एक लोकप्रिय तकनीक है Chain-of-Thought (CoT), जो मॉडल को क्रमिक प्रॉम्प्ट के रूप में क्रियाओं की श्रृंखला जोड़कर स्पष्ट रूप से तर्क करने के लिए प्रोत्साहित करता है।
ReAct (रीज़निंग और एक्टिंग) इससे एक कदम आगे जाता है और तर्क-ट्रेस को टूल-इनवोकेशन और बाहरी ऑब्ज़र्वेशन के साथ इंटरलीव करता है। यह बाहरी फीडबैक एजेंटों को ग्राउंडेड रहने और तब स्वयं-सुधार करने में मदद करता है जब मध्यवर्ती परिणाम अपेक्षा से मेल नहीं खाते।
मेमोरी
मेमोरी एजेंट को इंटरैक्शन और कार्रवाइयों के दौरान पूर्व जानकारी का पुन: उपयोग करके निरंतरता बनाए रखने देती है। बिना मेमोरी के हर चरण अलग-थलग होगा, और एजेंट को बार-बार वही ज्ञान फिर से खोजने के लिए मजबूर होना पड़ेगा।
शॉर्ट-टर्म मेमोरी आमतौर पर LLM के कॉन्टेक्स्ट विंडो के भीतर होती है। इसमें हालिया संदेश, मध्यवर्ती तर्क, और टूल आउटपुट शामिल होते हैं। कंप्यूटर आर्किटेक्चर में RAM की तरह, यह मेमोरी तेज़ लेकिन सीमित होती है और कॉन्टेक्स्ट सीमा पार होते ही गायब हो जाती है।
लॉन्ग-टर्म मेमोरी बाहरी रूप से लागू की जाती है, अक्सर वेक्टर डेटाबेस का उपयोग करके। RAG (Retrieval-Augmented Generation) जैसी तकनीकें एजेंट को प्रासंगिक दस्तावेज़ों या पिछले इंटरैक्शनों को पुनर्प्राप्त करके उन्हें मौजूदा संदर्भ में इंजेक्ट करने देती हैं।
टूल्स
टूल्स एजेंट की क्षमताओं को भाषा से परे विस्तारित करते हैं। वे एजेंट को वास्तविक दुनिया, जैसे डेटाबेस, APIs, और कंप्यूटेशन इंजनों के साथ इंटरैक्ट करने देते हैं।
एजेंट के दृष्टिकोण से, टूल्स परिभाषित इनपुट और आउटपुट वाले कॉल करने योग्य फंक्शंस होते हैं। LLM तय करता है कि कब किसी टूल का उपयोग करना है, कौन से आर्ग्युमेंट देने हैं, और परिणाम की व्याख्या कैसे करनी है। यही निर्णय-क्षमता एजेंटों को स्क्रिप्टेड वर्कफ़्लोज़ से अलग करती है।
टूल्स में Google सर्च, SQL निष्पादन, Python इंटरप्रेटर, और APIs जैसी विशेषताएँ शामिल हो सकती हैं। एजेंट के पास प्रभावी रूप से वही तकनीकी टूल्स होते हैं जो हमारे पास हैं, और वह उन्हें मिलाकर समाधान लागू कर सकता है।
ऊपर दी गई छवि सामान्य LLM एजेंट आर्किटेक्चर को दर्शाती है। मस्तिष्क मेमोरी और प्लानिंग की जानकारी देता है, जो फिर टूल्स का उपयोग करते हुए कार्यों की श्रृंखला शुरू करता है।
LLM एजेंट के प्रकार
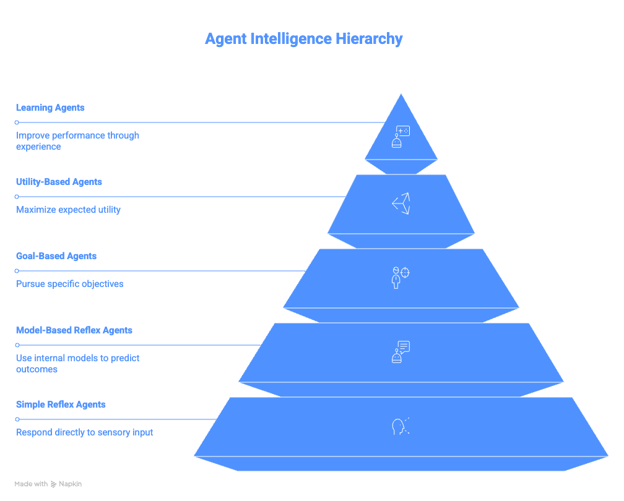
यह अनुभाग सबसे बुनियादी रिफ्लेक्स एजेंटों से लेकर जटिल लर्निंग एजेंटों तक की विभिन्न श्रेणियों का सार प्रस्तुत करता है।
सिंपल रिफ्लेक्स एजेंट
सिंपल रिफ्लेक्स एजेंट सीधे कंडीशन-एक्शन नियमों पर काम करते हैं। वे इतिहास, भविष्य के परिणामों या वैकल्पिक कार्रवाइयों पर विचार नहीं करते। यदि कोई शर्त पूरी होती है, तो संबंधित कार्रवाई तुरंत निष्पादित हो जाती है।
यह सादगी उन्हें लागू करना आसान बनाती है, लेकिन वे अत्यंत नाज़ुक होते हैं। कोई भी अप्रत्याशित इनपुट या गायब संकेत गलत व्यवहार का कारण बन सकता है। वे बदलते परिवेश के अनुकूल भी नहीं हो सकते।
ईमेल अनसब्सक्राइब बॉट का उदाहरण इस सीमा को उजागर करता है। यह अपना कार्य तेज़ी से करता है पर जागरूकता की कमी अवांछित परिणामों तक ले जा सकती है।
मॉडल-आधारित रिफ्लेक्स एजेंट
मॉडल-आधारित रिफ्लेक्स एजेंट आंतरिक पर्यावरण-प्रतिनिधित्व बनाए रखकर सिंपल रिफ्लेक्स एजेंटों में सुधार करते हैं। यह आंतरिक मॉडल उन्हें उन चीज़ों पर तर्क करने देता है जो तुरंत दिखाई नहीं देतीं।
समय के साथ स्टेट को ट्रैक करके, ये एजेंट आंशिक अवलोकनीयता को संभाल सकते हैं। वे याद रखते हैं कि क्या हो चुका है और भविष्य की कार्रवाइयों को सूचित करने के लिए उस जानकारी का उपयोग करते हैं।
Copilot या Cursor AI जैसे IDE असिस्टेंट इसके मजबूत उदाहरण हैं। वे किसी सत्र के दौरान फ़ाइलों, वेरिएबल्स और फ़ंक्शनों की जागरूकता बनाए रखते हैं, जिससे साधारण पैटर्न मैचिंग की तुलना में अधिक बुद्धिमान सुझाव संभव होते हैं। वे अगली श्रेणी के एजेंटों के पुल का भी काम करते हैं।
गोल-आधारित एजेंट
गोल-आधारित एजेंट ट्रिगर्स के बजाय परिणामों के इर्द-गिर्द डिज़ाइन किए जाते हैं। वे शुद्ध रूप से प्रतिक्रियात्मक होने की बजाय इस आधार पर कार्रवाइयों की योजना और मूल्यांकन करते हैं कि क्या वे सिस्टम को वांछित उद्देश्य के करीब लाती हैं।
ये एजेंट ऐसी योजनाएँ बनाते हैं जिनमें अनेक चरण और सशर्त शाखाएँ शामिल हो सकती हैं। यदि एक तरीका विफल हो जाए, तो वे वैकल्पिक पथ आजमा सकते हैं। इससे वे रिफ्लेक्स-आधारित एजेंटों की तुलना में कहीं अधिक लचीले हो जाते हैं।
उदाहरण के लिए, यात्रा कार्यक्रम बनाना दिखाता है कि एक उच्च-स्तरीय लक्ष्य को कैसे कई समन्वित कार्रवाइयों में विभाजित किया जा सकता है।
एजेंट केवल “मुझे एक इटिनरेरी दें” जैसे सरल प्रॉम्प्ट का जवाब देकर जानकारी दोहराता नहीं है। इसके बजाय, वह लक्ष्य को छोटे उप-समस्याओं में तोड़ सकता है, जैसे:
- हम शहरों के बीच कैसे यात्रा करें?
- हर शहर में सबसे अच्छे रेस्तरां कौन से हैं?
- हम अलग-अलग गतिविधियों को एक साथ कैसे शेड्यूल करें?
इटिनरेरी बनाने का लक्ष्य तब इन प्रत्येक समस्याओं के समाधानों को मिलाकर प्राप्त किया जाता है।
यूटिलिटी-आधारित एजेंट
यूटिलिटी-आधारित एजेंट अनुकूलन (ऑप्टिमाइज़ेशन) लाकर गोल-आधारित एजेंटों का विस्तार करते हैं। केवल लक्ष्य तक पहुँचना ही नहीं, वे “यूटिलिटी फ़ंक्शन” का उपयोग करके विभिन्न परिणामों का मूल्यांकन करते हैं।
यूटिलिटी फ़ंक्शन लागत, समय, जोखिम, या उपयोगकर्ता वरीयता जैसे मानदंडों के आधार पर परिणामों को स्कोर देता है। फिर एजेंट वह एक्शन क्रम चुनता है जो समग्र यूटिलिटी को अधिकतम करता है।
यह दृष्टिकोण सिफारिश प्रणालियों और ऑप्टिमाइज़ेशन समस्याओं में आम है—जैसे किसी स्थान तक सर्वोत्तम मार्ग ढूँढना, सही उत्पादों की सिफारिश करना, या किसी खास उपयोगकर्ता को दिखाने के लिए सर्वश्रेष्ठ विश्लेषण तैयार करना।
लर्निंग एजेंट
लर्निंग एजेंट समय के साथ बिना स्पष्ट री-प्रोग्रामिंग के अपने व्यवहार में सुधार करने के लिए डिज़ाइन किए जाते हैं।
हर इटरेशन के साथ, एजेंट फीडबैक प्राप्त करता है और उस जानकारी का उपयोग अपने प्रदर्शन में सुधार के लिए करता है। वे ऐसे वातावरणों में काम करते हैं जहाँ इष्टतम व्यवहार पहले से ज्ञात नहीं होता और हर नई स्थिति के लिए स्पष्ट री-प्रोग्रामिंग की आवश्यकता नहीं होती।
दो मुख्य घटक होते हैं: “क्रिटिक” और “लर्निंग एलिमेंट”। “क्रिटिक” परिणामों का मूल्यांकन कर फीडबैक देता है। “लर्निंग एलिमेंट” इस फीडबैक का उपयोग भविष्य के निर्णयों को समायोजित करने के लिए करता है। समय के साथ, एजेंट उपयोगकर्ता वरीयताओं या पर्यावरणीय बाधाओं के साथ अधिक संरेखित हो जाता है।
उदाहरण के लिए, कल्पना करें कि एक LLM एजेंट आपके लिए दैनिक समाचारों का सार प्रस्तुत करता है। वह आपके व्यवहार का अवलोकन कर आपकी वरीयताओं के अनुरूप ढल सकता है। यदि एजेंट देखता है कि आप “खेल” के सारांश शायद ही खोलते हैं, लेकिन “भोजन और पेय” में रुचि रखते हैं, तो वह खेल के सारांश देना बंद कर सकता है और इसके बजाय खास व्यंजनों या रेस्तरां में आपकी रुचि पर ध्यान केंद्रित कर सकता है।
LLM एजेंटों का सारांश
निम्न तालिका LLM एजेंटों के प्रकारों के बीच अंतरों का सार प्रस्तुत करती है।
|
एजेंट
|
मुख्य विचार
|
मेमोरी
|
प्लानिंग
|
लर्निंग
|
जटिलता
|
उदाहरण
|
|
सिंपल रिफ्लेक्स एजेंट
|
किसी शर्त को सीधे एक कार्रवाई से मैप करता है
|
नहीं
|
कोई नहीं
|
नहीं
|
बहुत कम
|
ऐसे ईमेल को स्वतः आर्काइव करना जिनमें “unsubscribe” शब्द हो
|
|
मॉडल-आधारित रिफ्लेक्स एजेंट
|
पर्यावरण का आंतरिक मॉडल बनाए रखता है
|
हाँ (स्टेट ट्रैकिंग)
|
न्यूनतम
|
नहीं
|
कम
|
IDE असिस्टेंट जो किसी सत्र में पहले परिभाषित वेरिएबल्स या फ़ाइलों को याद रखता है
|
|
गोल-आधारित एजेंट
|
विशिष्ट उद्देश्य तक पहुँचने के लिए कार्रवाई करता है
|
हाँ
|
हाँ
|
नहीं
|
मध्यम
|
बिज़नेस ट्रिप के लिए उड़ानें, होटल और परिवहन बुक करना
|
|
यूटिलिटी-आधारित एजेंट
|
वरीयताओं के आधार पर सर्वोत्तम परिणाम चुनता है
|
हाँ
|
हाँ
|
नहीं
|
मध्यम से उच्च
|
ट्रैवल एजेंट जो लागत बनाम अवधि बनाम आराम को ऑप्टिमाइज़ करता है
|
|
लर्निंग एजेंट
|
समय के साथ फीडबैक के आधार पर व्यवहार में सुधार करता है
|
हाँ
|
हाँ
|
हाँ
|
उच्च
|
न्यूज़ एजेंट जो उपयोगकर्ता एंगेजमेंट पैटर्न के आधार पर कंटेंट को अनुकूलित करता है
|
LLM एजेंट बनाने के लोकप्रिय फ्रेमवर्क
यह अनुभाग LLM एजेंट सिस्टम बनाने में उपयोग होने वाले सामान्य फ्रेमवर्क का परिचय कराता है।
LangChain
LangChain LLM-संचालित सिस्टम बनाने के लिए एक मॉड्यूलर फ्रेमवर्क प्रदान करता है। इसका मुख्य विचार है कि सरल घटकों को जोड़कर जटिल वर्कफ़्लो बनाए जा सकते हैं। यह विभिन्न LLMs से संवाद करने की चुनौती को संभालता है और उस प्रक्रिया को Python ऑब्जेक्ट्स के माध्यम से उपयोगकर्ता के लिए एब्स्ट्रैक्ट कर देता है।
LangChain में “चेन” इसकी प्रमुख अवधारणा है, जो प्रॉम्प्ट, मॉडल और पार्सर को जोड़कर दोहराने योग्य वर्कफ़्लो बनाती है। उदाहरण के लिए, आप एक PromptTemplate लेते हैं, जिसे LLM को दिया जाता है और फिर एक OutputParser द्वारा प्रोसेस किया जाता है।
LCEL (LangChain Expression Language) एक घोषणात्मक सिंटैक्स देता है जो उपयोगकर्ताओं को पाइप (|) का उपयोग करके विज़ुअल रूप से चेन कंपोज़ करने देता है। तो पारंपरिक Python वर्कफ़्लो की बजाय, जहाँ आपको प्रॉम्प्ट्स को स्पष्ट रूप से अपने मॉडल में फ़ीड करना पड़ता है, आप बस chain = prompt | model लिख सकते हैं और टेम्पलेटिंग LangChain पर छोड़ सकते हैं।
और अधिक जटिल कार्यक्षमता के लिए, LangChain उपयोगकर्ताओं को Wikipedia, Python REPLs, और Google Search जैसे टूल अपने एजेंटों में जोड़ने देता है
LangGraph LangChain की कार्यक्षमता पर आधारित है और इन अवधारणाओं को मेमोरी के साथ जोड़ता है ताकि स्टेटफुल, प्रोडक्शन-ग्रेड एजेंट आर्किटेक्चर मिलें जिनमें निष्पादन प्रवाह पर स्पष्ट नियंत्रण हो।
LangGraph से आगे, LangChain का इकोसिस्टम और बढ़ गया है—एजेंटों को आसानी से ऑब्ज़र्व करने के तरीके (LangSmith) और ड्रैग-एंड-ड्रॉप इंटरफ़ेस (LangFlow) तक।
LlamaIndex
LlamaIndex दस्तावेज़-केंद्रित वर्कफ़्लोज़ में उत्कृष्ट है—90+ असंरचित फ़ाइल प्रकारों के लिए उच्च-सटीकता OCR और पार्सिंग प्रदान करता है, और वैकल्पिक रूप से बुद्धिमान रिट्रीवल और एक्सट्रैक्शन के लिए एजेंटिक वर्कफ़्लो के साथ संयोजित करता है।
इसके डेटा कनेक्टर्स अनेक स्रोतों से इनजेशन को सरल बनाते हैं, जबकि इसकी इंडेक्सिंग संरचनाएँ रिट्रीवल को ऑप्टिमाइज़ करती हैं। VectorStoreIndex सेमान्टिक सर्च के लिए सबसे आम विकल्प है।
क्वेरी इंजन रिट्रीवल और जेनरेशन का ऑर्केस्ट्रेशन करते हैं, जबकि राउटर्स एजेंट-जैसी निर्णय-क्षमता लाते हैं—किसी दिए गए क्वेरी के लिए सबसे उपयुक्त डेटा सोर्स का चयन करके।
CrewAI
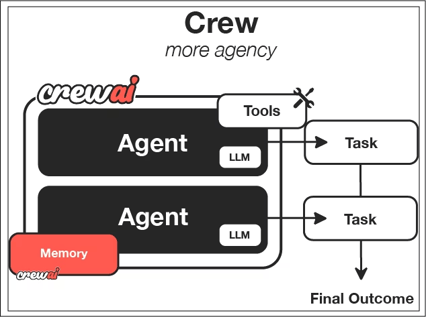
CrewAI सहयोग पर केंद्रित है। एकल एजेंट के बजाय, यह अलग-अलग भूमिकाओं वाले अनेक एजेंटों को साथ काम करने में सक्षम बनाता है।
यह “क्रूज़” के विचार पर ध्यान देता है—एजेंटों का परिभाषित सेट। प्रत्येक एजेंट को एक पर्सोना, लक्ष्य और बैकस्टोरी सौंपी जाती है, जो उसके व्यवहार को आकार देती है।
टास्क यह परिभाषित करते हैं कि क्या करना है और सफलता कैसी दिखती है। आप किसी व्यक्तिगत टास्क का स्वरूप, कुछ पैरामीटर, अपेक्षित आउटपुट, और कौन से एजेंट उस टास्क पर काम करेंगे—इन सबको परिभाषित करते हैं।
प्रोसेस तय करते हैं कि टास्क कैसे निष्पादित होंगे: क्रमिक, पदानुक्रमित, या ऑर्केस्ट्रेटर-वर्कर पैटर्न के माध्यम से जहाँ एक प्रमुख एजेंट जटिल टास्क को गतिशील रूप से डीकंपोज़ करता है—इंसानी टीमों की नकल करते हुए।
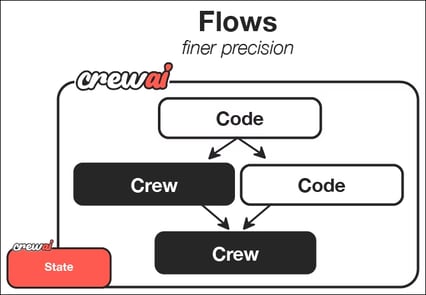
CrewAI दस्तावेज़ीकरण से हम देख सकते हैं कि फ़्लो क्रूज़ को ऑर्केस्ट्रेट और ट्रिगर करने का तरीका प्रदान करते हैं। प्रत्येक क्रू परिभाषित भूमिकाओं और टास्क के साथ LLM एजेंटों का उपयोग करके विशिष्ट कार्य करता है और वांछित परिणाम उत्पन्न करता है।
सही फ्रेमवर्क का चुनाव
फ्रेमवर्क चुनना आपके समस्या-डोमेन और बाधाओं पर निर्भर करता है। प्रस्तुत प्रत्येक फ्रेमवर्क की अपनी-अपनी ताकतें हैं:
- LangChain: लचीलापन और नियंत्रण प्रदान करता है, तथा प्रत्येक टूल कैसे काम करता है इस पर सर्वोत्तम दृश्यता देता है
- LlamaIndex: दस्तावेज़-केंद्रित वर्कफ़्लोज़ में उत्कृष्ट, जहाँ पार्सिंग महत्वपूर्ण है
- CrewAI: जब सहयोग और भूमिका-विभाजन महत्वपूर्ण हो, और आप इस बात पर कम केंद्रित हों कि एजेंट काम कैसे पूरा करते हैं—तब बेहतरीन
अपने डेटा की जटिलता, आवश्यक स्वायत्तता के स्तर, और ऑपरेशनल बाधाओं पर विचार करें। कोई सार्वभौमिक रूप से सही विकल्प नहीं है।
अपने निर्णय में सहायता के लिए, आप हमारे लेख भी देख सकते हैं जो क्रमशः LangChain और Llamaindex की तुलना, तथा CrewAI और LangGraph के बीच करते हैं।
LLM एजेंट के उपयोग के मामले
LLM एजेंटों के उपयोग के मामले मूलतः असीमित हैं—और आपकी कल्पना तक ही सीमित हैं।
कोडिंग असिस्टेंट
आधुनिक कोडिंग असिस्टेंट एजेंटिक वर्कफ़्लो का उपयोग करके परिवर्तनों की योजना, निष्पादन और सत्यापन करते हैं। वे कोडबेस को एक्सप्लोर कर सकते हैं, समाधान जनरेट कर सकते हैं, टेस्ट चला सकते हैं, और त्रुटियों को क्रमिक रूप से ठीक कर सकते हैं।
उदाहरण के लिए, Cursor आपके IDE में नेटिव रूप से इंटीग्रेट होता है और आपको लाइनें पूरी करने या डाउनस्ट्रीम प्रभाव वाले पाइपलाइनों में बदलाव ठीक करने में मदद करता है। Claude Code आपको टेस्ट लिखने, पूरे स्क्रिप्ट बनाने, या किसी रिपो में आपके कोड में असंगतियों का आकलन करने में मदद कर सकता है। हम GitHub Copilot का उपयोग पुल रिक्वेस्ट लिखने और रिक्वेस्ट वर्कफ़्लो के हिस्से के रूप में कोड टेस्ट करने में कर सकते हैं।
इससे डेवलपर की भूमिका हर लाइन लिखने से हटकर बुद्धिमान सिस्टम की निगरानी और मार्गदर्शन करने पर शिफ्ट हो जाती है। डेटा प्रैक्टिशनर्स के लिए, इससे प्रयोग और प्रोटोटाइपिंग में नाटकीय रूप से तेजी आ सकती है।
यदि आप LLM-संचालित कोडिंग असिस्टेंट के साथ शुरुआत करना चाहते हैं, तो मैं Software Development with GitHub Copilot कोर्स लेने की सिफारिश करता/करती हूँ।
बिज़नेस इंटेलिजेंस
एजेंटिक BI सिस्टम उपयोगकर्ताओं को प्राकृतिक भाषा में प्रश्न पूछने और क्रियान्वयन योग्य इनसाइट्स प्राप्त करने देते हैं। एजेंट प्रश्नों को SQL में अनुवाद कर सकता है, क्वेरी चला सकता है, और परिणामों की व्याख्या कर सकता है।
आप अपनी टीम के किसी वरिष्ठ सदस्य से बात करने की तरह अपने डेटा से बात कर सकते हैं और वास्तविक समय में नए इनसाइट्स और विज़ुअलाइज़ेशन प्राप्त कर सकते हैं। इससे डैशबोर्ड पर निर्भरता कम होती है और गैर-तकनीकी टीम सदस्यों के लिए खोजपूर्ण विश्लेषण संभव होता है।
दस्तावेज़ीकरण और सूचना संश्लेषण
रिसर्च एजेंट सूचना एकत्रण और संश्लेषण को स्वचालित करते हैं। वे वेब खोजते हैं, स्रोत लाते हैं, और निष्कर्षों का सारांश देते हैं; कुछ सिस्टम बुनियादी स्रोत-गुणवत्ता फ़िल्टर भी शामिल करते हैं। वे Notion जैसे वेबसाइटों पर होस्ट आंतरिक दस्तावेज़ों या Slack के भीतर संदेशों को भी देख सकते हैं।
इन सभी सूचना स्रोतों तक पहुँच के साथ, LLM एजेंट न केवल शीघ्रता से जानकारी का संश्लेषण कर सकते हैं, बल्कि पूरी डॉक्यूमेंटेशन और सार-संDocuments भी जनरेट कर सकते हैं ताकि टीमें जल्दी से जानकारी साझा कर सकें।
यह विशेष रूप से तेज़ी से बदलते डोमेनों में मूल्यवान है जहाँ स्थिर डेटासेट जल्दी अप्रचलित हो जाते हैं। एजेंट लगातार ताज़ा इनसाइट्स उपलब्ध कराते हैं।
यह देखने के लिए कि लोग AI एजेंट कैसे उपयोग कर रहे हैं, हमारा टॉप 10 AI एजेंट प्रोजेक्ट्स पर गाइड देखें।
एजेंटिक वर्कफ़्लोज़ में प्रमुख चुनौतियाँ
एजेंटिक वर्कफ़्लोज़ शानदार और बेहद शक्तिशाली हैं, लेकिन अपनी चुनौतियों के साथ आते हैं। एजेंट चरणों का भ्रम गढ़ सकते हैं, टूल आउटपुट की गलत व्याख्या कर सकते हैं, या लंबे/अनपेक्षित लूप में फँस सकते हैं। प्रोडक्शन सिस्टम के लिए गार्डरेल्स, वैलिडेशन और ऑब्ज़र्वेबिलिटी अत्यंत महत्वपूर्ण हैं।
हर एजेंट एक्शन अक्सर एक LLM कॉल मांगता है। जटिल कार्यों में दर्जनों कॉल लग सकते हैं, जिससे लैटेंसी और API लागत बढ़ती है। साथ ही, आपको क्लाउड स्टोरेज, क्लाउड कंप्यूटिंग, और अन्य इन्फ्रास्ट्रक्चर जैसी अतिरिक्त लागतें भी वहन करनी पड़ सकती हैं ताकि LLM एजेंट चल सके।
स्वायत्त सिस्टम को डीबग करना नियतात्मक कोड की तुलना में कठिन होता है। यह समझना कि एजेंट ने कोई निर्णय क्यों लिया, स्टेट, मेमोरी और तर्क-चरणों का ट्रेस करना मांगता है।
आप किस एजेंट फ्रेमवर्क का उपयोग करते हैं, इस पर निर्भर करते हुए यह असाधारण रूप से चुनौतीपूर्ण हो सकता है। कुछ फ्रेमवर्क, जैसे CrewAI, अपनी अतिरिक्त जटिलता के कारण अधिक गहराई से एब्स्ट्रैक्ट करते हैं, जबकि LangChain जैसे अपेक्षाकृत सीधे फ्रेमवर्क का फोकस आपके LLMs तक पहुँच को सरल बनाना है।
निष्कर्ष
हम अलग-थलग चैटबॉट्स से आगे बढ़कर पूरी तरह एजेंटिक वर्कफ़्लोज़ की ओर जा रहे हैं जो तर्क कर सकते हैं, योजना बना सकते हैं और कार्रवाई कर सकते हैं। भले ही यह अभी शुरुआती चरण में है, यह पैरेडाइम पहले से ही डेटा सिस्टम के निर्माण और उपयोग के तरीके को नया आकार दे रहा है।
आकांक्षी डेटा प्रैक्टिशनर्स के लिए, आज LLM एजेंटों के बारे में सीखना कल की भूमिकाओं के लिए एक मजबूत बढ़त देता है। ये सिस्टम बुद्धिमान ऑटोमेशन का भविष्य दर्शाते हैं।
इन LLM एजेंटों का अभ्यास और निर्माण शुरू करें हमारे Designing Agentic Systems with LangChain कोर्स के साथ!


कई लोगों के लिए, लार्ज लैंग्वेज मॉडल (LLMs) मुख्य रूप से संवादात्मक इंटरफ़ेस के रूप में उपयोग होते हैं। आप प्रश्न पूछते हैं, मॉडल उत्तर देता है, और वहीं इंटरैक्शन समाप्त हो जाता है।
हालांकि, LLMs इससे अधिक करने में सक्षम हैं: इन्हें ऐसे सिस्टम में एम्बेड किया जा रहा है जो स्वायत्त रूप से योजना बना सकते हैं, याद रख सकते हैं और कार्रवाई कर सकते हैं—इन्हीं से LLM एजेंट बनते हैं। एजेंटिक सिस्टम आधुनिक एनालिटिक्स और बिज़नेस वर्कफ़्लो में तेजी से लोकप्रिय हो रहे हैं।
इस लेख के अंत तक, आप समझ जाएंगे कि LLM एजेंट क्या होते हैं, वे कैसे बनाए जाते हैं, एजेंटों के अलग-अलग प्रकार क्या हैं, और वे कहाँ मूल्य पैदा कर सकते हैं।
इस लेख की जानकारी का अधिकतम लाभ उठाने के लिए, इसे AI Fundamentals स्किल ट्रैक के साथ जोड़कर पढ़ें ताकि AI और LLMs पर अपनी जानकारी ताज़ा कर सकें।
LLM एजेंट क्या है?
आइए बात करते हैं कि LLM एजेंट मानक भाषा मॉडलों से कैसे भिन्न हैं।
आपका सामान्य LLM इंटरफ़ेस, जैसे चैटबॉट, केवल प्रॉम्प्ट ले सकता है और अपनी ट्रेनिंग के आधार पर उत्तर दे सकता है—बिना बाहरी कार्रवाइयों या स्टेट के। इसके विपरीत, एक LLM एजेंट LLM को अपने मुख्य तर्क इंजन (यानी मस्तिष्क) के रूप में उपयोग करता है और उसके इर्द-गिर्द सहायक घटक जोड़ता है, जो उसे तर्क करने, योजना बनाने और निष्पादित करने की क्षमता देते हैं।
LLM एजेंट फोकस को ऑटोमेशन से बढ़ाकर ऑटोनॉमी पर ले आते हैं।
ऑटोमेशन LLMs को इनपुट लेने और चरणों की एक शृंखला का पालन करके आउटपुट बनाने में सक्षम बनाता है। ऑटोनॉमी के साथ, हम LLM को टूल्स का एक सेट और यह क्षमता देते हैं कि वह स्थिति के बारे में जो जानता है, उसके आधार पर समाधान तक पहुँचने का सर्वोत्तम तरीका स्वयं तय करे। यह LLM को “स्वतंत्र” रूप से कार्य करने के लिए अधिक लचीलापन और जटिलता देता है।
एक साधारण LLM को ऐसे विशेषज्ञ सलाहकार की तरह सोचें जो अपने ज्ञान के आधार पर प्रश्नों का उत्तर देता है। एक LLM एजेंट उसी विशेषज्ञ की तरह है जो एक टीम का नेतृत्व करता है: यह तय करता है कि कौन से प्रश्न पूछने हैं, किन टीम सदस्यों (टूल्स) से परामर्श करना है, और उनके उत्तरों को समाधान में कैसे संयोजित करना है।
LLM एजेंट के मुख्य घटक
एक LLM एजेंट कई मुख्य घटकों से मिलकर बनता है:
निम्न ग्राफ़ इन सभी के बीच संबंध को दर्शाता है।
LLM मस्तिष्क
LLM एजेंट का संज्ञानात्मक कोर है। यह उपयोगकर्ता के लक्ष्य की व्याख्या करता है, मध्यवर्ती चरणों पर तर्क करता है, और तय करता है कि कौन सी कार्रवाई करनी है। व्यवहार में, LLM को एक से अधिक बार बार-बार कॉल किया जाता है।
हर बार जब LLM को कॉल किया जाता है, तो उसे ऐसा संदर्भ मिलता है जिसमें मूल लक्ष्य, पूर्व की गई कार्रवाइयाँ, टूल आउटपुट और प्रासंगिक मेमोरी शामिल हो सकती है। इस जानकारी के आधार पर यह अगली कार्रवाई तय करता है। इससे LLM एक स्थिर टेक्स्ट जनरेटर की तुलना में नियंत्रक की तरह अधिक कार्य करता है।
डेटा प्रैक्टिशनर्स के लिए यह समझना महत्वपूर्ण है कि LLM सीधे कोड या क्वेरी निष्पादित नहीं करता। यह संरचित निर्देश उत्पन्न करता है जिन्हें अन्य घटक व्याख्यायित करते हैं। किसी एजेंट की गुणवत्ता अक्सर इस पर निर्भर करती है कि ये निर्देश कितनी अच्छी तरह सीमाबद्ध और वैलिडेट किए गए हैं।
योजना बनाने का लॉजिक
प्लानिंग लॉजिक वह तंत्र है जो एजेंटों को जटिल समस्याओं को छोटे-छोटे चरणों में विभाजित कर हल करने देता है। बिना प्लानिंग के, एक एजेंट सब कुछ एक ही उत्तर में सुलझाने की कोशिश करेगा, जो अक्सर त्रुटियों या हैलुसिनेशन की ओर ले जाता है।
प्लानिंग चरण में, एजेंट एक उच्च-स्तरीय उद्देश्य को छोटे-छोटे कार्यों में तोड़ता है। उदाहरण के लिए, “कस्टमर चर्न का विश्लेषण करें” को “कस्टमर डेटा लोड करें”, “चर्न रेट की गणना करें”, “ट्रेन्ड्स की पहचान करें”, और “निष्कर्षों का सारांश दें” में बदला जा सकता है। प्रत्येक उप-कार्य क्रमिक या सशर्त रूप से निष्पादित होता है।
एक लोकप्रिय तकनीक है Chain-of-Thought (CoT), जो मॉडल को क्रमिक प्रॉम्प्ट के रूप में क्रियाओं की श्रृंखला जोड़कर स्पष्ट रूप से तर्क करने के लिए प्रोत्साहित करता है।
ReAct (रीज़निंग और एक्टिंग) इससे एक कदम आगे जाता है और तर्क-ट्रेस को टूल-इनवोकेशन और बाहरी ऑब्ज़र्वेशन के साथ इंटरलीव करता है। यह बाहरी फीडबैक एजेंटों को ग्राउंडेड रहने और तब स्वयं-सुधार करने में मदद करता है जब मध्यवर्ती परिणाम अपेक्षा से मेल नहीं खाते।
मेमोरी
मेमोरी एजेंट को इंटरैक्शन और कार्रवाइयों के दौरान पूर्व जानकारी का पुन: उपयोग करके निरंतरता बनाए रखने देती है। बिना मेमोरी के हर चरण अलग-थलग होगा, और एजेंट को बार-बार वही ज्ञान फिर से खोजने के लिए मजबूर होना पड़ेगा।
शॉर्ट-टर्म मेमोरी आमतौर पर LLM के कॉन्टेक्स्ट विंडो के भीतर होती है। इसमें हालिया संदेश, मध्यवर्ती तर्क, और टूल आउटपुट शामिल होते हैं। कंप्यूटर आर्किटेक्चर में RAM की तरह, यह मेमोरी तेज़ लेकिन सीमित होती है और कॉन्टेक्स्ट सीमा पार होते ही गायब हो जाती है।
लॉन्ग-टर्म मेमोरी बाहरी रूप से लागू की जाती है, अक्सर वेक्टर डेटाबेस का उपयोग करके। RAG (Retrieval-Augmented Generation) जैसी तकनीकें एजेंट को प्रासंगिक दस्तावेज़ों या पिछले इंटरैक्शनों को पुनर्प्राप्त करके उन्हें मौजूदा संदर्भ में इंजेक्ट करने देती हैं।
टूल्स
टूल्स एजेंट की क्षमताओं को भाषा से परे विस्तारित करते हैं। वे एजेंट को वास्तविक दुनिया, जैसे डेटाबेस, APIs, और कंप्यूटेशन इंजनों के साथ इंटरैक्ट करने देते हैं।
एजेंट के दृष्टिकोण से, टूल्स परिभाषित इनपुट और आउटपुट वाले कॉल करने योग्य फंक्शंस होते हैं। LLM तय करता है कि कब किसी टूल का उपयोग करना है, कौन से आर्ग्युमेंट देने हैं, और परिणाम की व्याख्या कैसे करनी है। यही निर्णय-क्षमता एजेंटों को स्क्रिप्टेड वर्कफ़्लोज़ से अलग करती है।
टूल्स में Google सर्च, SQL निष्पादन, Python इंटरप्रेटर, और APIs जैसी विशेषताएँ शामिल हो सकती हैं। एजेंट के पास प्रभावी रूप से वही तकनीकी टूल्स होते हैं जो हमारे पास हैं, और वह उन्हें मिलाकर समाधान लागू कर सकता है।
ऊपर दी गई छवि सामान्य LLM एजेंट आर्किटेक्चर को दर्शाती है। मस्तिष्क मेमोरी और प्लानिंग की जानकारी देता है, जो फिर टूल्स का उपयोग करते हुए कार्यों की श्रृंखला शुरू करता है।
LLM एजेंट के प्रकार
यह अनुभाग सबसे बुनियादी रिफ्लेक्स एजेंटों से लेकर जटिल लर्निंग एजेंटों तक की विभिन्न श्रेणियों का सार प्रस्तुत करता है।
सिंपल रिफ्लेक्स एजेंट
सिंपल रिफ्लेक्स एजेंट सीधे कंडीशन-एक्शन नियमों पर काम करते हैं। वे इतिहास, भविष्य के परिणामों या वैकल्पिक कार्रवाइयों पर विचार नहीं करते। यदि कोई शर्त पूरी होती है, तो संबंधित कार्रवाई तुरंत निष्पादित हो जाती है।
यह सादगी उन्हें लागू करना आसान बनाती है, लेकिन वे अत्यंत नाज़ुक होते हैं। कोई भी अप्रत्याशित इनपुट या गायब संकेत गलत व्यवहार का कारण बन सकता है। वे बदलते परिवेश के अनुकूल भी नहीं हो सकते।
ईमेल अनसब्सक्राइब बॉट का उदाहरण इस सीमा को उजागर करता है। यह अपना कार्य तेज़ी से करता है पर जागरूकता की कमी अवांछित परिणामों तक ले जा सकती है।
मॉडल-आधारित रिफ्लेक्स एजेंट
मॉडल-आधारित रिफ्लेक्स एजेंट आंतरिक पर्यावरण-प्रतिनिधित्व बनाए रखकर सिंपल रिफ्लेक्स एजेंटों में सुधार करते हैं। यह आंतरिक मॉडल उन्हें उन चीज़ों पर तर्क करने देता है जो तुरंत दिखाई नहीं देतीं।
समय के साथ स्टेट को ट्रैक करके, ये एजेंट आंशिक अवलोकनीयता को संभाल सकते हैं। वे याद रखते हैं कि क्या हो चुका है और भविष्य की कार्रवाइयों को सूचित करने के लिए उस जानकारी का उपयोग करते हैं।
Copilot या Cursor AI जैसे IDE असिस्टेंट इसके मजबूत उदाहरण हैं। वे किसी सत्र के दौरान फ़ाइलों, वेरिएबल्स और फ़ंक्शनों की जागरूकता बनाए रखते हैं, जिससे साधारण पैटर्न मैचिंग की तुलना में अधिक बुद्धिमान सुझाव संभव होते हैं। वे अगली श्रेणी के एजेंटों के पुल का भी काम करते हैं।
गोल-आधारित एजेंट
गोल-आधारित एजेंट ट्रिगर्स के बजाय परिणामों के इर्द-गिर्द डिज़ाइन किए जाते हैं। वे शुद्ध रूप से प्रतिक्रियात्मक होने की बजाय इस आधार पर कार्रवाइयों की योजना और मूल्यांकन करते हैं कि क्या वे सिस्टम को वांछित उद्देश्य के करीब लाती हैं।
ये एजेंट ऐसी योजनाएँ बनाते हैं जिनमें अनेक चरण और सशर्त शाखाएँ शामिल हो सकती हैं। यदि एक तरीका विफल हो जाए, तो वे वैकल्पिक पथ आजमा सकते हैं। इससे वे रिफ्लेक्स-आधारित एजेंटों की तुलना में कहीं अधिक लचीले हो जाते हैं।
उदाहरण के लिए, यात्रा कार्यक्रम बनाना दिखाता है कि एक उच्च-स्तरीय लक्ष्य को कैसे कई समन्वित कार्रवाइयों में विभाजित किया जा सकता है।
एजेंट केवल “मुझे एक इटिनरेरी दें” जैसे सरल प्रॉम्प्ट का जवाब देकर जानकारी दोहराता नहीं है। इसके बजाय, वह लक्ष्य को छोटे उप-समस्याओं में तोड़ सकता है, जैसे:
इटिनरेरी बनाने का लक्ष्य तब इन प्रत्येक समस्याओं के समाधानों को मिलाकर प्राप्त किया जाता है।
यूटिलिटी-आधारित एजेंट
यूटिलिटी-आधारित एजेंट अनुकूलन (ऑप्टिमाइज़ेशन) लाकर गोल-आधारित एजेंटों का विस्तार करते हैं। केवल लक्ष्य तक पहुँचना ही नहीं, वे “यूटिलिटी फ़ंक्शन” का उपयोग करके विभिन्न परिणामों का मूल्यांकन करते हैं।
यूटिलिटी फ़ंक्शन लागत, समय, जोखिम, या उपयोगकर्ता वरीयता जैसे मानदंडों के आधार पर परिणामों को स्कोर देता है। फिर एजेंट वह एक्शन क्रम चुनता है जो समग्र यूटिलिटी को अधिकतम करता है।
यह दृष्टिकोण सिफारिश प्रणालियों और ऑप्टिमाइज़ेशन समस्याओं में आम है—जैसे किसी स्थान तक सर्वोत्तम मार्ग ढूँढना, सही उत्पादों की सिफारिश करना, या किसी खास उपयोगकर्ता को दिखाने के लिए सर्वश्रेष्ठ विश्लेषण तैयार करना।
लर्निंग एजेंट
लर्निंग एजेंट समय के साथ बिना स्पष्ट री-प्रोग्रामिंग के अपने व्यवहार में सुधार करने के लिए डिज़ाइन किए जाते हैं।
हर इटरेशन के साथ, एजेंट फीडबैक प्राप्त करता है और उस जानकारी का उपयोग अपने प्रदर्शन में सुधार के लिए करता है। वे ऐसे वातावरणों में काम करते हैं जहाँ इष्टतम व्यवहार पहले से ज्ञात नहीं होता और हर नई स्थिति के लिए स्पष्ट री-प्रोग्रामिंग की आवश्यकता नहीं होती।
दो मुख्य घटक होते हैं: “क्रिटिक” और “लर्निंग एलिमेंट”। “क्रिटिक” परिणामों का मूल्यांकन कर फीडबैक देता है। “लर्निंग एलिमेंट” इस फीडबैक का उपयोग भविष्य के निर्णयों को समायोजित करने के लिए करता है। समय के साथ, एजेंट उपयोगकर्ता वरीयताओं या पर्यावरणीय बाधाओं के साथ अधिक संरेखित हो जाता है।
उदाहरण के लिए, कल्पना करें कि एक LLM एजेंट आपके लिए दैनिक समाचारों का सार प्रस्तुत करता है। वह आपके व्यवहार का अवलोकन कर आपकी वरीयताओं के अनुरूप ढल सकता है। यदि एजेंट देखता है कि आप “खेल” के सारांश शायद ही खोलते हैं, लेकिन “भोजन और पेय” में रुचि रखते हैं, तो वह खेल के सारांश देना बंद कर सकता है और इसके बजाय खास व्यंजनों या रेस्तरां में आपकी रुचि पर ध्यान केंद्रित कर सकता है।
LLM एजेंटों का सारांश
निम्न तालिका LLM एजेंटों के प्रकारों के बीच अंतरों का सार प्रस्तुत करती है।
एजेंट
मुख्य विचार
मेमोरी
प्लानिंग
लर्निंग
जटिलता
उदाहरण
सिंपल रिफ्लेक्स एजेंट
किसी शर्त को सीधे एक कार्रवाई से मैप करता है
नहीं
कोई नहीं
नहीं
बहुत कम
ऐसे ईमेल को स्वतः आर्काइव करना जिनमें “unsubscribe” शब्द हो
मॉडल-आधारित रिफ्लेक्स एजेंट
पर्यावरण का आंतरिक मॉडल बनाए रखता है
हाँ (स्टेट ट्रैकिंग)
न्यूनतम
नहीं
कम
IDE असिस्टेंट जो किसी सत्र में पहले परिभाषित वेरिएबल्स या फ़ाइलों को याद रखता है
गोल-आधारित एजेंट
विशिष्ट उद्देश्य तक पहुँचने के लिए कार्रवाई करता है
हाँ
हाँ
नहीं
मध्यम
बिज़नेस ट्रिप के लिए उड़ानें, होटल और परिवहन बुक करना
यूटिलिटी-आधारित एजेंट
वरीयताओं के आधार पर सर्वोत्तम परिणाम चुनता है
हाँ
हाँ
नहीं
मध्यम से उच्च
ट्रैवल एजेंट जो लागत बनाम अवधि बनाम आराम को ऑप्टिमाइज़ करता है
लर्निंग एजेंट
समय के साथ फीडबैक के आधार पर व्यवहार में सुधार करता है
हाँ
हाँ
हाँ
उच्च
न्यूज़ एजेंट जो उपयोगकर्ता एंगेजमेंट पैटर्न के आधार पर कंटेंट को अनुकूलित करता है
LLM एजेंट बनाने के लोकप्रिय फ्रेमवर्क
यह अनुभाग LLM एजेंट सिस्टम बनाने में उपयोग होने वाले सामान्य फ्रेमवर्क का परिचय कराता है।
LangChain
LangChain LLM-संचालित सिस्टम बनाने के लिए एक मॉड्यूलर फ्रेमवर्क प्रदान करता है। इसका मुख्य विचार है कि सरल घटकों को जोड़कर जटिल वर्कफ़्लो बनाए जा सकते हैं। यह विभिन्न LLMs से संवाद करने की चुनौती को संभालता है और उस प्रक्रिया को Python ऑब्जेक्ट्स के माध्यम से उपयोगकर्ता के लिए एब्स्ट्रैक्ट कर देता है।
LangChain में “चेन” इसकी प्रमुख अवधारणा है, जो प्रॉम्प्ट, मॉडल और पार्सर को जोड़कर दोहराने योग्य वर्कफ़्लो बनाती है। उदाहरण के लिए, आप एक
PromptTemplateलेते हैं, जिसे LLM को दिया जाता है और फिर एकOutputParserद्वारा प्रोसेस किया जाता है।LCEL (LangChain Expression Language) एक घोषणात्मक सिंटैक्स देता है जो उपयोगकर्ताओं को पाइप (
|) का उपयोग करके विज़ुअल रूप से चेन कंपोज़ करने देता है। तो पारंपरिक Python वर्कफ़्लो की बजाय, जहाँ आपको प्रॉम्प्ट्स को स्पष्ट रूप से अपने मॉडल में फ़ीड करना पड़ता है, आप बसchain = prompt | modelलिख सकते हैं और टेम्पलेटिंग LangChain पर छोड़ सकते हैं।और अधिक जटिल कार्यक्षमता के लिए, LangChain उपयोगकर्ताओं को Wikipedia, Python REPLs, और Google Search जैसे टूल अपने एजेंटों में जोड़ने देता है
LangGraph LangChain की कार्यक्षमता पर आधारित है और इन अवधारणाओं को मेमोरी के साथ जोड़ता है ताकि स्टेटफुल, प्रोडक्शन-ग्रेड एजेंट आर्किटेक्चर मिलें जिनमें निष्पादन प्रवाह पर स्पष्ट नियंत्रण हो।
LangGraph से आगे, LangChain का इकोसिस्टम और बढ़ गया है—एजेंटों को आसानी से ऑब्ज़र्व करने के तरीके (LangSmith) और ड्रैग-एंड-ड्रॉप इंटरफ़ेस (LangFlow) तक।
LlamaIndex
LlamaIndex दस्तावेज़-केंद्रित वर्कफ़्लोज़ में उत्कृष्ट है—90+ असंरचित फ़ाइल प्रकारों के लिए उच्च-सटीकता OCR और पार्सिंग प्रदान करता है, और वैकल्पिक रूप से बुद्धिमान रिट्रीवल और एक्सट्रैक्शन के लिए एजेंटिक वर्कफ़्लो के साथ संयोजित करता है।
इसके डेटा कनेक्टर्स अनेक स्रोतों से इनजेशन को सरल बनाते हैं, जबकि इसकी इंडेक्सिंग संरचनाएँ रिट्रीवल को ऑप्टिमाइज़ करती हैं। VectorStoreIndex सेमान्टिक सर्च के लिए सबसे आम विकल्प है।
क्वेरी इंजन रिट्रीवल और जेनरेशन का ऑर्केस्ट्रेशन करते हैं, जबकि राउटर्स एजेंट-जैसी निर्णय-क्षमता लाते हैं—किसी दिए गए क्वेरी के लिए सबसे उपयुक्त डेटा सोर्स का चयन करके।
CrewAI
CrewAI सहयोग पर केंद्रित है। एकल एजेंट के बजाय, यह अलग-अलग भूमिकाओं वाले अनेक एजेंटों को साथ काम करने में सक्षम बनाता है।
यह “क्रूज़” के विचार पर ध्यान देता है—एजेंटों का परिभाषित सेट। प्रत्येक एजेंट को एक पर्सोना, लक्ष्य और बैकस्टोरी सौंपी जाती है, जो उसके व्यवहार को आकार देती है।
टास्क यह परिभाषित करते हैं कि क्या करना है और सफलता कैसी दिखती है। आप किसी व्यक्तिगत टास्क का स्वरूप, कुछ पैरामीटर, अपेक्षित आउटपुट, और कौन से एजेंट उस टास्क पर काम करेंगे—इन सबको परिभाषित करते हैं।
प्रोसेस तय करते हैं कि टास्क कैसे निष्पादित होंगे: क्रमिक, पदानुक्रमित, या ऑर्केस्ट्रेटर-वर्कर पैटर्न के माध्यम से जहाँ एक प्रमुख एजेंट जटिल टास्क को गतिशील रूप से डीकंपोज़ करता है—इंसानी टीमों की नकल करते हुए।
CrewAI दस्तावेज़ीकरण से हम देख सकते हैं कि फ़्लो क्रूज़ को ऑर्केस्ट्रेट और ट्रिगर करने का तरीका प्रदान करते हैं। प्रत्येक क्रू परिभाषित भूमिकाओं और टास्क के साथ LLM एजेंटों का उपयोग करके विशिष्ट कार्य करता है और वांछित परिणाम उत्पन्न करता है।
सही फ्रेमवर्क का चुनाव
फ्रेमवर्क चुनना आपके समस्या-डोमेन और बाधाओं पर निर्भर करता है। प्रस्तुत प्रत्येक फ्रेमवर्क की अपनी-अपनी ताकतें हैं:
अपने डेटा की जटिलता, आवश्यक स्वायत्तता के स्तर, और ऑपरेशनल बाधाओं पर विचार करें। कोई सार्वभौमिक रूप से सही विकल्प नहीं है।
अपने निर्णय में सहायता के लिए, आप हमारे लेख भी देख सकते हैं जो क्रमशः LangChain और Llamaindex की तुलना, तथा CrewAI और LangGraph के बीच करते हैं।
LLM एजेंट के उपयोग के मामले
LLM एजेंटों के उपयोग के मामले मूलतः असीमित हैं—और आपकी कल्पना तक ही सीमित हैं।
कोडिंग असिस्टेंट
आधुनिक कोडिंग असिस्टेंट एजेंटिक वर्कफ़्लो का उपयोग करके परिवर्तनों की योजना, निष्पादन और सत्यापन करते हैं। वे कोडबेस को एक्सप्लोर कर सकते हैं, समाधान जनरेट कर सकते हैं, टेस्ट चला सकते हैं, और त्रुटियों को क्रमिक रूप से ठीक कर सकते हैं।
उदाहरण के लिए, Cursor आपके IDE में नेटिव रूप से इंटीग्रेट होता है और आपको लाइनें पूरी करने या डाउनस्ट्रीम प्रभाव वाले पाइपलाइनों में बदलाव ठीक करने में मदद करता है। Claude Code आपको टेस्ट लिखने, पूरे स्क्रिप्ट बनाने, या किसी रिपो में आपके कोड में असंगतियों का आकलन करने में मदद कर सकता है। हम GitHub Copilot का उपयोग पुल रिक्वेस्ट लिखने और रिक्वेस्ट वर्कफ़्लो के हिस्से के रूप में कोड टेस्ट करने में कर सकते हैं।
इससे डेवलपर की भूमिका हर लाइन लिखने से हटकर बुद्धिमान सिस्टम की निगरानी और मार्गदर्शन करने पर शिफ्ट हो जाती है। डेटा प्रैक्टिशनर्स के लिए, इससे प्रयोग और प्रोटोटाइपिंग में नाटकीय रूप से तेजी आ सकती है।
यदि आप LLM-संचालित कोडिंग असिस्टेंट के साथ शुरुआत करना चाहते हैं, तो मैं Software Development with GitHub Copilot कोर्स लेने की सिफारिश करता/करती हूँ।
बिज़नेस इंटेलिजेंस
एजेंटिक BI सिस्टम उपयोगकर्ताओं को प्राकृतिक भाषा में प्रश्न पूछने और क्रियान्वयन योग्य इनसाइट्स प्राप्त करने देते हैं। एजेंट प्रश्नों को SQL में अनुवाद कर सकता है, क्वेरी चला सकता है, और परिणामों की व्याख्या कर सकता है।
आप अपनी टीम के किसी वरिष्ठ सदस्य से बात करने की तरह अपने डेटा से बात कर सकते हैं और वास्तविक समय में नए इनसाइट्स और विज़ुअलाइज़ेशन प्राप्त कर सकते हैं। इससे डैशबोर्ड पर निर्भरता कम होती है और गैर-तकनीकी टीम सदस्यों के लिए खोजपूर्ण विश्लेषण संभव होता है।
दस्तावेज़ीकरण और सूचना संश्लेषण
रिसर्च एजेंट सूचना एकत्रण और संश्लेषण को स्वचालित करते हैं। वे वेब खोजते हैं, स्रोत लाते हैं, और निष्कर्षों का सारांश देते हैं; कुछ सिस्टम बुनियादी स्रोत-गुणवत्ता फ़िल्टर भी शामिल करते हैं। वे Notion जैसे वेबसाइटों पर होस्ट आंतरिक दस्तावेज़ों या Slack के भीतर संदेशों को भी देख सकते हैं।
इन सभी सूचना स्रोतों तक पहुँच के साथ, LLM एजेंट न केवल शीघ्रता से जानकारी का संश्लेषण कर सकते हैं, बल्कि पूरी डॉक्यूमेंटेशन और सार-संDocuments भी जनरेट कर सकते हैं ताकि टीमें जल्दी से जानकारी साझा कर सकें।
यह विशेष रूप से तेज़ी से बदलते डोमेनों में मूल्यवान है जहाँ स्थिर डेटासेट जल्दी अप्रचलित हो जाते हैं। एजेंट लगातार ताज़ा इनसाइट्स उपलब्ध कराते हैं।
यह देखने के लिए कि लोग AI एजेंट कैसे उपयोग कर रहे हैं, हमारा टॉप 10 AI एजेंट प्रोजेक्ट्स पर गाइड देखें।
एजेंटिक वर्कफ़्लोज़ में प्रमुख चुनौतियाँ
एजेंटिक वर्कफ़्लोज़ शानदार और बेहद शक्तिशाली हैं, लेकिन अपनी चुनौतियों के साथ आते हैं। एजेंट चरणों का भ्रम गढ़ सकते हैं, टूल आउटपुट की गलत व्याख्या कर सकते हैं, या लंबे/अनपेक्षित लूप में फँस सकते हैं। प्रोडक्शन सिस्टम के लिए गार्डरेल्स, वैलिडेशन और ऑब्ज़र्वेबिलिटी अत्यंत महत्वपूर्ण हैं।
हर एजेंट एक्शन अक्सर एक LLM कॉल मांगता है। जटिल कार्यों में दर्जनों कॉल लग सकते हैं, जिससे लैटेंसी और API लागत बढ़ती है। साथ ही, आपको क्लाउड स्टोरेज, क्लाउड कंप्यूटिंग, और अन्य इन्फ्रास्ट्रक्चर जैसी अतिरिक्त लागतें भी वहन करनी पड़ सकती हैं ताकि LLM एजेंट चल सके।
स्वायत्त सिस्टम को डीबग करना नियतात्मक कोड की तुलना में कठिन होता है। यह समझना कि एजेंट ने कोई निर्णय क्यों लिया, स्टेट, मेमोरी और तर्क-चरणों का ट्रेस करना मांगता है।
आप किस एजेंट फ्रेमवर्क का उपयोग करते हैं, इस पर निर्भर करते हुए यह असाधारण रूप से चुनौतीपूर्ण हो सकता है। कुछ फ्रेमवर्क, जैसे CrewAI, अपनी अतिरिक्त जटिलता के कारण अधिक गहराई से एब्स्ट्रैक्ट करते हैं, जबकि LangChain जैसे अपेक्षाकृत सीधे फ्रेमवर्क का फोकस आपके LLMs तक पहुँच को सरल बनाना है।
निष्कर्ष
हम अलग-थलग चैटबॉट्स से आगे बढ़कर पूरी तरह एजेंटिक वर्कफ़्लोज़ की ओर जा रहे हैं जो तर्क कर सकते हैं, योजना बना सकते हैं और कार्रवाई कर सकते हैं। भले ही यह अभी शुरुआती चरण में है, यह पैरेडाइम पहले से ही डेटा सिस्टम के निर्माण और उपयोग के तरीके को नया आकार दे रहा है।
आकांक्षी डेटा प्रैक्टिशनर्स के लिए, आज LLM एजेंटों के बारे में सीखना कल की भूमिकाओं के लिए एक मजबूत बढ़त देता है। ये सिस्टम बुद्धिमान ऑटोमेशन का भविष्य दर्शाते हैं।
इन LLM एजेंटों का अभ्यास और निर्माण शुरू करें हमारे Designing Agentic Systems with LangChain कोर्स के साथ!