

TabPy क्या है
TabPy एक फ्रेमवर्क है जो Tableau को Python कोड निष्पादित करने में सक्षम बनाता है। यह उपयोगकर्ताओं को Tableau के calculated field के भीतर Python स्क्रिप्ट चलाने या Python API का उपयोग करके TabPy सर्वर पर फ़ंक्शन्स डिप्लॉय करने की अनुमति देता है।
TabPy एक शक्तिशाली टूल है जो विभिन्न कॉन्फ़िगरेशन और यूटिलिटी के साथ आता है। आप इसे Tableau विज़ुअलाइज़ेशन के साथ एकीकृत कर सकते हैं, और जब भी पैरामीटर बदले जाते हैं, Python स्क्रिप्ट स्वचालित रूप से चलकर आपको डायनेमिक विज़ुअलाइज़ेशन अनुभव प्रदान करेगी।
क्यों TabPy?
हालाँकि Tableau डेटा फ़ील्ड बनाने, बदलने और साफ़ करने के लिए समृद्ध कार्यक्षमता प्रदान करता है, हम सरल सांख्यिकीय फ़ंक्शन तक सीमित रहते हैं। उन्नत सांख्यिकी जैसे कि मशीन लर्निंग को अनलॉक करने के लिए, हम Tableau के साथ शक्तिशाली Python लाइब्रेरीज़ को एकीकृत करेंगे।
एक इंटरैक्टिव DataCamp कोर्स करके Tableau में विभिन्न सांख्यिकीय तकनीकें सीखें।
इस ट्यूटोरियल में, हम एक TabPy सर्वर सेटअप करना सीखेंगे और एक सरल मशीन लर्निंग प्रोजेक्ट पर काम करेंगे। हम AirBnB Amsterdam लिस्टिंग्स को विभिन्न क्लस्टर्स में बाँटने के लिए K Means एल्गोरिदम का उपयोग करेंगे।
TabPy सेटअप करना
TabPy सर्वर सेटअप करना सरल है। आप टर्मिनल में `pip` या Jupyter Notebook में `!pip` का उपयोग करके TabPy इंस्टॉल कर सकते हैं। यह स्वतः ही Python के लिए सर्वर और क्लाइंट API इंस्टॉल कर देगा।
pip install tabpyसर्वर चलाने के लिए, हम टर्मिनल में `tabpy` टाइप करेंगे। कुछ सेकंड में आप देखेंगे कि सर्वर लोकली 9004 पोर्ट पर चल रहा है।
tabpyआउटपुट
... Password file is not specified: Authentication is not enabled
... Call context logging is disabled
... Initializing TabPy...
... Initializing TabPy Server...
... Done initializing TabPy.
... Setting max request size to 104857600 bytes
... Initializing models...
... Web service listening on port 9004TabPy सर्वर कॉन्फ़िगरेशन
आप नीचे दिए गए कमांड और कॉन्फ़िग फ़ाइल का उपयोग करके अपना TabPy सर्वर कॉन्फ़िगर कर सकते हैं।
tabpy --config=path/to/my/config/file.confआप इन चीज़ों को कॉन्फ़िगर कर सकते हैं:
- HTTP बनाम HTTPS कनेक्शन
- उपयोगकर्ता प्रबंधन
- लॉगिंग
TabPy आपको सुरक्षा और गुणवत्ता आश्वासन की कंपनी नीति के अनुसार सर्वर को कस्टमाइज़ करने की स्वतंत्रता देता है। आप सैंपल कॉन्फ़िग फ़ाइल देख सकते हैं और विशिष्ट आवश्यकताओं के साथ सर्वर सेटअप करना सीख सकते हैं।
TabPy को Heroku पर डिप्लॉय करना
यदि आप Tableau Cloud या Tableau Server का उपयोग कर रहे हैं, तो आपको TabPy सर्वर को किसी क्लाउड या वेब होस्टिंग प्लेटफ़ॉर्म पर डिप्लॉय करना होगा। आप यह Docker फ़ाइल का उपयोग करके या सीधे Heroku पर सर्वर डिप्लॉय करके कर सकते हैं।
Heroku पर रिमोट सर्वर चलाने के लिए:
- ब्राउज़र के माध्यम से अपने Heroku खाते में लॉगिन करें, और यदि आपका खाता नहीं है, तो नि:शुल्क साइन अप करें।
- GitHub पर TabPy रिपोजिटरी पर जाएँ और Readme में "Deploy to Heroku" बटन पर क्लिक करें।
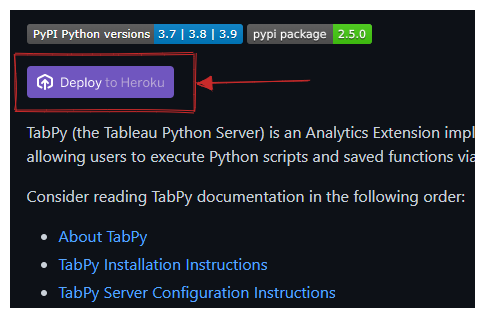
- निर्देशों का पालन करें। सर्वर का नाम लिखें और सर्वर लोकेशन चुनें।
- एनवायरनमेंट वैरिएबल्स username और password सेट करें।
आपका सर्वर बिना झंझट के डिप्लॉय हो गया है। आप URL और पोर्ट नंबर के साथ Tableau को कनेक्ट कर सकते हैं।
TabPy से कनेक्ट करना
Tableau के साथ कनेक्ट करने से पहले यह सुनिश्चित करें कि आपका TabPy सर्वर लोकली या रिमोटली चल रहा हो।
सर्वर से कनेक्ट करने के लिए, हमें Help मेनू पर क्लिक करना है और Settings and Performance > Manage Analytics Extension Connection चुनना है। इससे एक नई विंडो खुलेगी जिसमें विभिन्न कनेक्शन प्रकार होंगे: TabPy, Einstein Discovery, RServe, और Analytics Extension API।
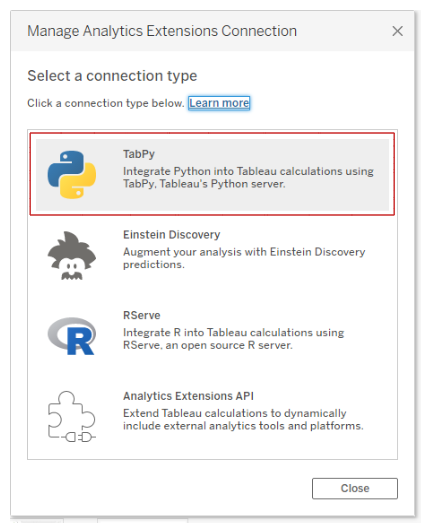
हम TabPy विकल्प चुनेंगे, जिससे एक और विंडो खुलेगी जो हमसे Hostname, Port, Username, और Password जोड़ने के लिए कहेगी। हमने username और password सेट नहीं किया है, इसलिए हम उन्हें अनदेखा करेंगे।
अगले चरण में, हम Hostname के रूप में “localhost” और Port को “9004” जोड़ेंगे और Test Connection पर क्लिक करेंगे। टेस्ट पास होने के बाद, हम कनेक्शन कॉन्फ़िगरेशन को सेव कर देंगे।
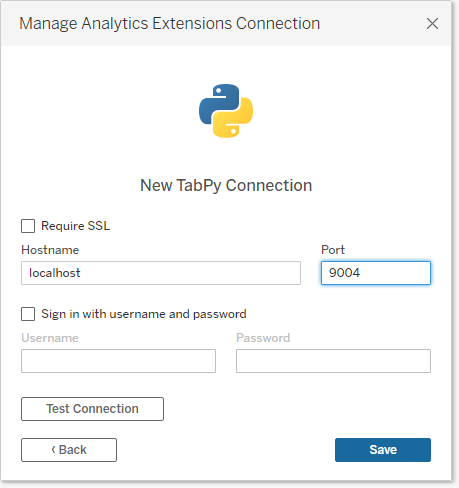
Tableau कैलकुलेशन के साथ Python का उपयोग
Calculated field में Python स्क्रिप्ट चलाने के लिए, आउटपुट के आधार पर आपको इनमें से किसी एक स्क्रिप्ट फ़ंक्शन की ज़रूरत होगी:
- SCRIPT_BOOL
- SCRIPT_INT
- SCRIPT_REAL
- SCRIPT_STR
यदि आपका फ़ंक्शन बूलियन मान लौटाता है, तो SCRIPT_BOOL फ़ंक्शन का उपयोग करें। आप हमेशा integers प्राप्त कर सकते हैं और फिर native फ़ंक्शन्स का उपयोग करके उन्हें अन्य प्रकारों में बदल सकते हैं।
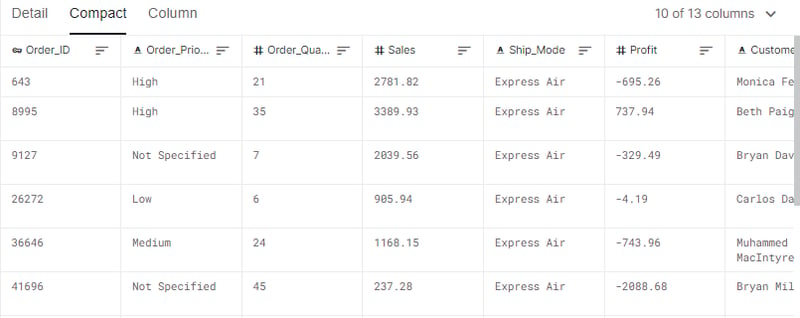
इस सेक्शन में, हम Kaggle से store sales डेटा सेट का उपयोग करेंगे। Sales और Profit डेटा फ़ील्ड Pearson correlation coefficient की गणना करते हैं।
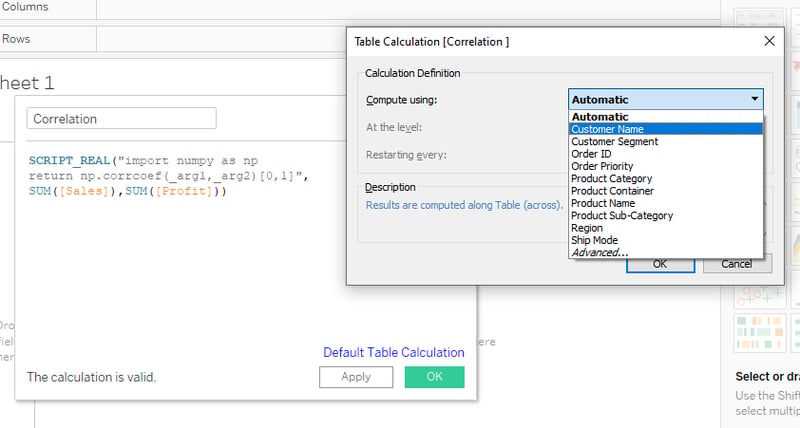
SCRIPT_REAL को दो भागों की आवश्यकता होती है। पहला डबल इनवर्टेड कॉमा में Python स्क्रिप्ट और दूसरा भाग aggregated arguments हैं।
हम Numpy Python पैकेज का उपयोग Sales और Profit arguments के बीच सहसंबंध की गणना के लिए करेंगे। हम तर्कों को सीधे नहीं जोड़ सकते। इसके बजाय, हम “_arg1” और “_arg2” जैसे placeholders का उपयोग करते हैं। उदाहरण के लिए, SUM([Profit]) क्रम में दूसरा है, और यह “_arg2” से जुड़ा है।
हम np.corrcoef मैट्रिक्स से केवल correlation coefficient निकाल रहे हैं ताकि एकल कॉलम लौटाया जा सके।
SCRIPT_REAL("import numpy as np
return np.corrcoef(_arg1,_arg2)[0,1]",
SUM([Sales]),SUM([Profit]))“Correlation” calculated field में स्क्रिप्ट जोड़ने के बाद, apply बटन पर क्लिक करें। यह स्क्रिप्ट चलाएगा और Customer Name के अनुरूप मान लौटाएगा।
OK बटन दबाने से पहले, “Default Table Calculation” टेक्स्ट पर क्लिक करें और विकल्प को Automatic से बदलकर Customer Name कर दें।
उत्पाद श्रेणी और ग्राहक विभाजन का स्कैटर प्लॉट विज़ुअलाइज़ करने के लिए:
- Product Category और Sales डेटा फ़ील्ड को Columns शेल्फ पर ड्रैग और ड्रॉप करें।
- फिर, Customer Segment और Profit डेटा फ़ील्ड को Rows शेल्फ पर ड्रैग और ड्रॉप करें।
- Customer Name को Marks सेक्शन में Detail बटन पर ड्रैग और ड्रॉप करें।
- अंत में, नए बनाए गए calculated field Correlation को Marks सेक्शन में Label बटन पर ड्रैग और ड्रॉप करें।
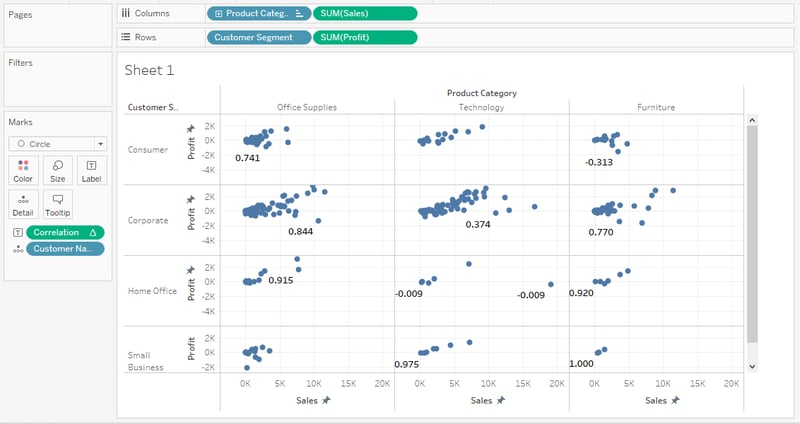
ऊपर दिया गया ग्राफ़ उत्पाद श्रेणी और ग्राहक सेगमेंट के आधार पर ग्राहकों का correlation coefficient दिखाता है। Furniture श्रेणी और Small Business ग्राहकों के बीच उच्च सहसंबंध है।
Tableau में क्लस्टरिंग हेतु Python स्क्रिप्ट
इस सेक्शन में, हम Airbnb Amsterdam डेटा सेट का उपयोग K-means क्लस्टरिंग एल्गोरिदम और scikit-learn मशीन लर्निंग फ्रेमवर्क के साथ क्लस्टर बनाने के लिए करेंगे।
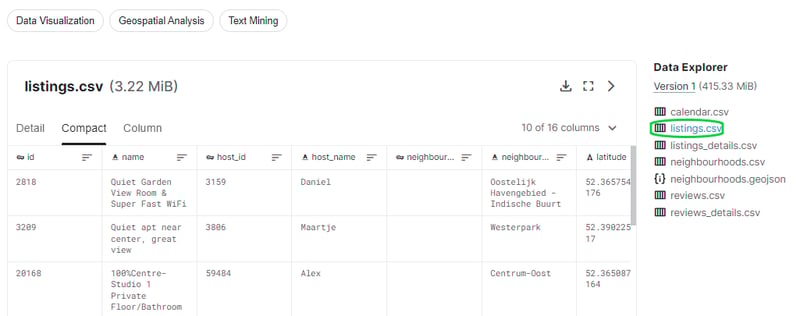
TabPy स्क्रिप्टिंग में कूदने से पहले, हमें Jupyter Notebook पर डेटा सेट का विश्लेषण और समझ बनानी होगी।
प्रोजेक्ट इनिशियलाइज़ेशन
हम डेटा इनजेशन और क्लीनिंग के लिए pandas, डेटा विज़ुअलाइज़ेशन के लिए matplotlib और seaborn, और डेटा प्रोसेसिंग व क्लस्टरिंग एल्गोरिदम के लिए scikit-learn का उपयोग करेंगे।
पहले, हम आवश्यक Python पैकेज इम्पोर्ट करेंगे और “listing.csv” फ़ाइल इनजेस्ट करेंगे। फिर, .isna().sum() का उपयोग करके missing values की जाँच करेंगे।
mport pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.preprocessing import LabelEncoder
from sklearn.cluster import KMeans
df = pd.read_csv("listings.csv")
df.isna().sum()जैसा कि हम देख सकते हैं, neighbourhood_group, last_review, और reviews_per_month में कई missing मान हैं। इन कॉलम्स को इम्प्यूट या ड्रॉप करने के बजाय, हम इन्हें अपने मॉडल के प्रशिक्षण में शामिल नहीं करेंगे।
id 0
name 38
host_id 0
host_name 4
neighbourhood_group 20030
neighbourhood 0
latitude 0
longitude 0
room_type 0
price 0
minimum_nights 0
number_of_reviews 0
last_review 2406
reviews_per_month 2406
calculated_host_listings_count 0
availability_365 0
dtype: int64डेटा प्रोसेस करना
हम एक X डेटा फ़्रेम बनाएँगे जिसमें प्रशिक्षण के लिए आवश्यक फ़ीचर्स होंगे। इन फ़ीचर्स में missing values नहीं हैं, न ही unique IDs या उच्च सहसंबंध। उदाहरण के लिए, हम id, name, host_id, host_name, latitude, और longitude को शामिल नहीं करेंगे।
हमारे पास श्रेणीबद्ध कॉलम हैं, और इन्हें संख्यात्मक में बदलने के लिए हम LabelEncoder() का उपयोग करेंगे। इन्हें कई कैटेगोरिकल कॉलम्स पर लागू करने के लिए हम Pandas की .apply() फ़ंक्शन का उपयोग करेंगे।
X = df[['neighbourhood',
'room_type',
'price',
'minimum_nights',
'number_of_reviews',
'availability_365',
'calculated_host_listings_count']]
LE = LabelEncoder()
cat = ['neighbourhood','room_type']
X[cat] = X[cat].apply(LE.fit_transform)
X.head()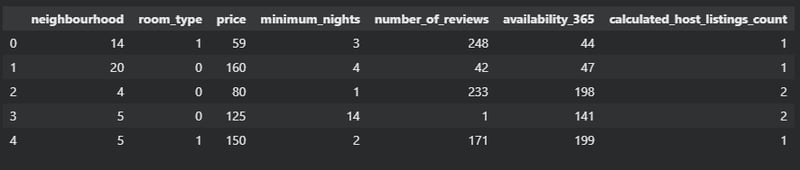
जैसा कि हम देख सकते हैं, अंतिम डेटा फ़्रेम में सात कॉलम हैं जिनमें संख्यात्मक मान हैं।
K Means क्लस्टर Elbow खोजना
Elbow मेथड का उपयोग किसी विशेष डेटा सेट में क्लस्टर्स की इष्टतम संख्या निर्धारित करने के लिए किया जाता है। हम n_clusters और .inertia_ का उपयोग करके कोहनी-जैसे पैटर्न वाले रेखा ग्राफ़ प्रदर्शित करेंगे। Inertia निकटतम क्लस्टर सेंटर तक नमूनों की वर्ग दूरी का योग है।
नीचे दिया गया कोड 1 से 9 तक चलेगा और clusters array में inertia मान जोड़ देगा। फिर हम इस जानकारी का उपयोग क्लस्टर्स बनाम inertia का रेखा ग्राफ़ प्लॉट करने के लिए करेंगे।
clusters = []
for i in range(1, 10):
km = KMeans(n_clusters=i).fit(X)
clusters.append(km.inertia_)
fig, ax = plt.subplots(figsize=(12, 8))
sns.lineplot(x=list(range(1, 10)), y=clusters, ax=ax)
ax.set_title('Searching for Elbow')
ax.set_xlabel('Clusters')
ax.set_ylabel('Inertia');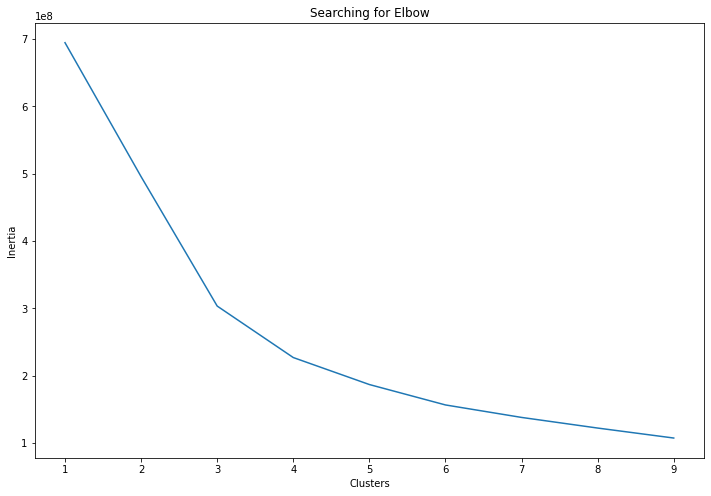
ग्राफ़ दिखाता है कि पहला आर्च 3 पर और दूसरा आर्च 4 पर है। हम Tableau विज़ुअल विश्लेषण में दोनों क्लस्टर्स को शामिल करेंगे।
आप हमारे ट्यूटोरियल का पालन करके scikit-learn के साथ Python में K Mean क्लस्टरिंग के बारे में और सीख सकते हैं।
N-Cluster पैरामीटर बनाना
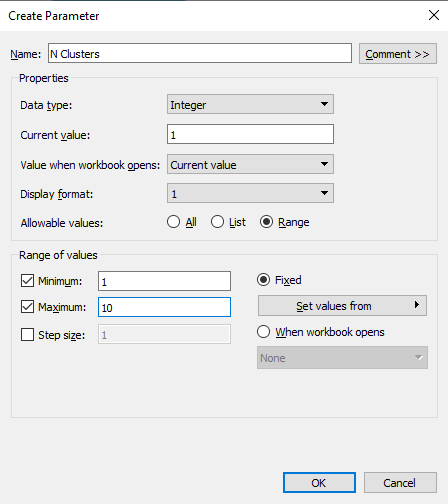
कोड में मैन्युअली क्लस्टर की संख्या जोड़ने से बचने के लिए, हम 1 से 10 की रेंज वाला एक पैरामीटर बनाएँगे।
हम Data सेक्शन में राइट-क्लिक करके और Create Parameter विकल्प चुनकर पैरामीटर्स बना सकते हैं। Data type को Integer, Current value को 1 में बदलें, और Range पर क्लिक करके Minimum 1 और Maximum 10 मान जोड़ें।
Calculated Field में Python स्क्रिप्ट
अब हम कोड को Jupyter Notebook से Tableau calculated field में ट्रांसफ़र करेंगे। Tableau calculated field को डेटा सेट लोड करने की आवश्यकता नहीं होती। हमारे पास आवश्यक डेटा फ़ील्ड पहले से हैं, और हम उन्हें SCRIPT_INT arguments का उपयोग करके इस्तेमाल करेंगे।
- हम argument एक और दो को LabelEncoder का उपयोग करके संख्यात्मक प्रकार में बदलेंगे।
- सभी arguments प्राप्त करें और उन्हें उपयुक्त वैरिएबल नाम दें।
- N को छोड़कर सभी इनपुट arguments को कॉलम्स में स्टैक करेंगे।
- “N” संख्या वाले क्लस्टर्स के साथ एक मॉडल परिभाषित करें। हम N Clusters पैरामीटर का उपयोग करके इस वैरिएबल को बदल सकते हैं।
- अंत में, फ़ीचर्स का उपयोग करके क्लस्टर्स को ट्रेन और प्रेडिक्ट करें।
- आउटपुट को integers की सूची के रूप में लौटाएँ।
स्क्रिप्ट का दूसरा भाग aggregated डेटा फ़ील्ड्स और एक पैरामीटर है।
आप नीचे दिए गए कोड की समीक्षा करके arguments और डेटा फ़ील्ड्स के बीच संबंध समझ सकते हैं।
SCRIPT_INT("from sklearn.preprocessing import LabelEncoder
from sklearn.cluster import KMeans
LE = LabelEncoder()
neighbourhood = LE.fit_transform(_arg1)
room_type = LE.fit_transform(_arg2)
price = _arg3
minimum_nights = _arg4
number_of_reviews = _arg5
availability_365 = _arg6
calculated_host_listings_count = _arg7
N = _arg8[0]
X = np.column_stack(
[
neighbourhood,
room_type,
price,
minimum_nights,
number_of_reviews,
availability_365,
calculated_host_listings_count,
]
)
kmeans = KMeans(n_clusters=N, random_state=35)
return kmeans.fit_predict(X).tolist()
",
ATTR([Neighbourhood]),
ATTR([Room Type]),
AVG([Price]),
MEDIAN([Minimum Nights]),
SUM([Number Of Reviews]),
AVG([Availability 365]),
AVG([Calculated Host Listings Count]),
[N Clusters]
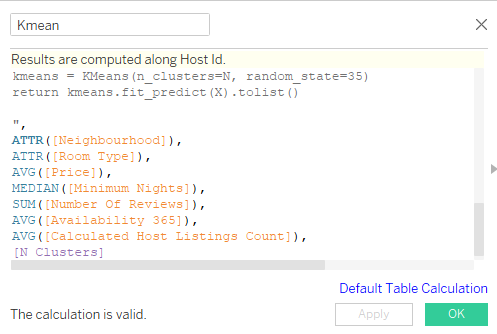
)एक नया calculated field (Kmean) बनाएँ और ऊपर दिया गया कोड कॉपी-पेस्ट करें। सुनिश्चित करें कि आपके परिणाम Host Id के साथ compute हो रहे हों। आप Default Table Calculation नीले टेक्स्ट पर क्लिक करके इसे संशोधित कर सकते हैं।
डेटा विज़ुअलाइज़ेशन
नीचे दी गई विज़ुअलाइज़ेशन बनाने के लिए, हमें चरणों की एक शृंखला का पालन करना होगा।
- Price डेटा फ़ील्ड को Columns शेल्फ पर और Number of Reviews को Rows शेल्फ पर ड्रैग और ड्रॉप करें।
- ऊपर Analysis मेनू में जाएँ और Aggregate Measures को अनचेक करें।
- Host Id डेटा फ़ील्ड को Marks सेक्शन में Detail पर, और Kmean calculated field को Color पर ड्रैग और ड्रॉप करें।
- राइट-क्लिक करके और विकल्प तक पहुँचकर Kmean calculated field को Discrete में बदलें।
- Parameters सेक्शन में N Clusters पर राइट-क्लिक करें और दाएँ ओर स्लाइडर दिखाने के लिए Show Parameters चुनें।
- रियल-टाइम में परिणाम देखने के लिए N Clusters स्लाइडर को 3 या 4 पर समायोजित करें।
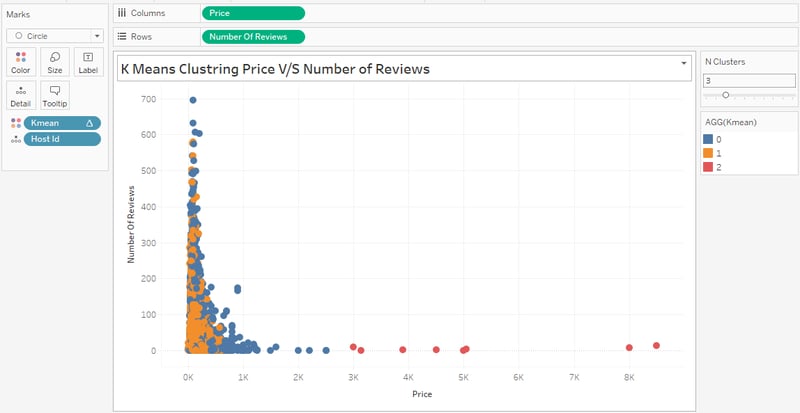
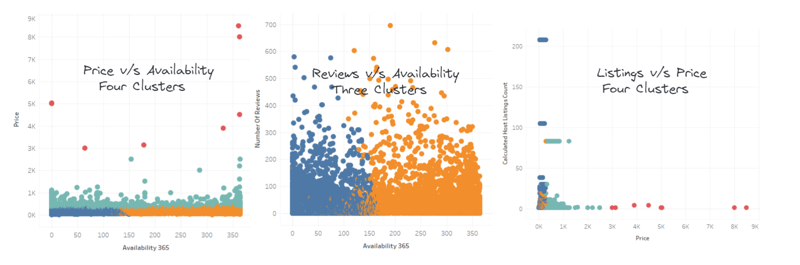
अगले भाग में, हम डेटा फ़ील्ड्स और क्लस्टर्स की संख्या बदलकर कई विज़ुअलाइज़ेशन शीट बनाएँगे।
- Price v/s Availability: हमें चार क्लस्टर्स दिखते हैं। इस जानकारी के आधार पर, हम Airbnb या किसी भी होटल व्यवसाय के लिए सिफारिश प्रणाली बना सकते हैं।
- Review v/s Availability: N Clusters 3 होने के बावजूद हमें केवल दो बड़े क्लस्टर्स दिखते हैं।
- Listings v/s Price: हमें लाल, नीले और हरे क्लस्टर्स दिखते हैं। कोने में पीला हरे और नीले से घिरा हुआ है।
हमारा Analyzing Data in Tableau कोर्स करके उन्नत एनालिटिक्स और विज़ुअलाइज़ेशन के बारे में और जानें। यह आपको डेटा तैयारी, अन्वेषण, मैपिंग विश्लेषण, समूह, सेट और पैरामीटर्स समझने में मदद करेगा।
यदि आपको क्लस्टरिंग ट्यूटोरियल पसंद आया, तो डेटा पॉइंट्स को मानचित्र पर कन्वर्ट करने का प्रयास करें। बस Latitude और Longitude को Columns और Rows शेल्फ पर ड्रैग और ड्रॉप करें।

आप हमारे Cluster Analysis in the Tableau ट्यूटोरियल का पालन करके बिना TabPy के भी क्लस्टर्स बना सकते हैं।
निष्कर्ष
TabPy को एकीकृत करके, आप अपने वर्तमान डेटा एनालिटिक्स सेटअप को स्वचालित और बेहतर बनाने की असीम संभावनाएँ खोल देंगे। हम इसका उपयोग डीप लर्निंग मॉडल्स को एनालिटिक्स डैशबोर्ड में एकीकृत करने, जटिल सांख्यिकीय कार्य करने, और निरंतर एकीकरण व विकास लागू करने के लिए भी कर सकते हैं।
TabPy इंटीग्रेशन कुछ प्रतिबंधों के साथ आता है, जैसे कि सिंगल आउटपुट। ये प्रतिबंध केवल उन व्यक्तियों को प्रभावित करेंगे जो डेटा साइंटिस्ट या मशीन लर्निंग इंजीनियर हैं।
इस पोस्ट में, हमने TabPy (Tableau के लिए Python सर्वर) के बारे में सीखा और इसका उपयोग करके K Mean क्लस्टर्स कैसे बनाएँ, यह देखा। ई-कॉमर्स, ट्रैवल और एंटरटेनमेंट उद्योग में ग्राहकों के व्यवहार को समझने के लिए क्लस्टर्स बनाना महत्वपूर्ण है। हमने K Means क्लस्टर का उपयोग किया, लेकिन आप बेहतर परिणामों के लिए अन्य एल्गोरिदम का भी उपयोग कर सकते हैं।
शीर्ष क्लस्टरिंग एल्गोरिदमों की सूची:
- Affinity Propagation
- Agglomerative Hierarchical Clustering
- BIRCH (Balanced Iterative Reducing and Clustering using Hierarchies)
- DBSCAN (Density-Based Spatial Clustering of Applications with Noise)
- Gaussian Mixture Models (GMM)
- Mean Shift Clustering
यदि आप Tableau में नए हैं और डेटा विज़ुअलाइज़ेशन एवं सांख्यिकीय गणना के बारे में सब कुछ सीखना चाहते हैं, तो Tableau Fundamentals स्किल ट्रैक करें।
इस ट्यूटोरियल श्रृंखला के दूसरे भाग में, हम TabPy का उपयोग करके जटिल Python स्क्रिप्ट्स का अन्वेषण करते हैं। हम TabPy सर्वर पर Facebook Prophet फ़ोरकास्ट मॉडल डिप्लॉय करना और डायनेमिक टाइम सीरीज़ विज़ुअलाइज़ेशन बनाना सीखेंगे।