कोर्स
SQL में बिज़नेस डेटा का विश्लेषण
4 घंटा
48.5K
किसी डेटाबेस की संरचना कई मायनों में Excel जैसी लग सकती है। हालांकि, सामान्य रूप से डेटाबेस, Excel स्प्रेडशीट्स से अधिक शक्तिशाली होते हैं। यहाँ तीन कारण हैं जिनसे आप ऐसा कह सकते हैं:
SQL के साथ शुरुआत करने के लिए उत्साहित हैं? DataCamp के पास शुरुआत के लिए बेहतरीन सामग्री है; learn SQL उन ट्रैक्स को दर्शाता है जिनसे आप अपनी SQL कुशलताओं को निखार सकते हैं!
अब SQL क्वेरियों में और गहराई से उतरते हैं…
SQL क्वेरी एक स्टेटमेंट है जो विभिन्न SQL कमांड्स को साथ जोड़कर बनाया जाता है। ये SQL कमांड्स मिलकर किसी विशिष्ट कार्य को पूरा करते हैं ताकि डेटाबेस में संग्रहीत और DBMS के माध्यम से प्रबंधित आपके डेटा तक पहुँच, प्रबंधन, संशोधन, अपडेट, नियंत्रण और संगठन किया जा सके।
SQL बेहद बहुमुखी है, और डेटा वैज्ञानिकों व इंजीनियरों से लेकर मार्केटर्स और मानव संसाधन टीमों तक—लगभग हर कोई इसका उपयोग करता है, यानी जो भी अधिक डेटा-साक्षर होना चाहता है!
यह केवल टेक उद्योगों में ही उपयोग नहीं होता या बड़ी कंपनियों तक सीमित नहीं है। हर आकार के कई उद्योग इसे सीधे या परोक्ष रूप से उपयोग करते हैं। उदाहरण के लिए, वित्त और स्वास्थ्य सेवा उद्योगों में काम करने वाले पेशेवर अक्सर SQL का उपयोग करते हैं, क्योंकि वे बड़े पैमाने पर डेटा उत्पन्न करते हैं।
डेटा नया कमोडिटी है, और बड़े डेटा को सँभालने और उस पर काम करने में SQL एक बहुत शक्तिशाली उपकरण है। सोच रहे हैं कि आप SQL का अधिकतम लाभ कैसे उठा सकते हैं? DataCamp का What can you do with SQL ट्यूटोरियल देखें जो आपको इस प्रश्न का उत्तर देने में मदद करेगा।
क्वेरी बनाने में जाने से पहले, यह प्रश्न सोचें: “मैं अपनी SQL क्वेरी कहाँ लिखूँ और चलाऊँ?”
DataCamp का Learn SQL hub Mac या Windows मशीन पर SQL के साथ काम शुरू करने और शुरुआत करने के लिए अच्छा प्रारंभिक बिंदु हो सकता है।
लेकिन यदि आप केवल डेटाबेस की नैटिव भाषा—SQL—सीखना शुरू करना चाहते हैं, तो आप DataCamp के Introduction to SQL course से शुरुआत कर सकते हैं। यह कोर्स SQL का वह सिंटैक्स सिखाता है जो PostgreSQL, MySQL, SQL Server, और Oracle जैसे कई प्रकार के डेटाबेस में समान है। आप DataCamp के इनबिल्ट SQL इंटरफ़ेस के साथ काम करेंगे और RDBMS की शुरुआती सेटअप झंझटों से नहीं जूझना पड़ेगा।
DataCamp के पास एक शानदार नोटबुक टूल भी है जहाँ आप अपनी खुद की नोटबुक्स बना सकते हैं: DataLab। DataLab एक सहयोगी क्लाउड-आधारित नोटबुक है जो आपको डेटा का विश्लेषण करने, अपनी टीम के साथ सहयोग करने और अंतर्दृष्टि साझा करने देती है। DataLab को इस तरह डिज़ाइन किया गया है कि वह आपको डेटा साइंस सीखने से लेकर उसे करने तक ले जाए। बिल्ट-इन डेटासेट्स के साथ, आप कुछ मिनटों में ही डेटा का विश्लेषण शुरू कर सकते हैं।
अब आइए उस डेटासेट पर नज़र डालें जिसके साथ हम इस ट्यूटोरियल में काम करेंगे।
हम ‘films’ से शुरू करेंगे — एक SQL टेबल जिसमें 10 फ़िल्मों का डेटा है। यह डेटा, DataCamp के Introduction to SQL course में उपयोग किए गए IMDb Film डेटासेट का एक छोटा सा सबसेट है, जिसका हमने पहले उल्लेख किया था।
|
title |
release_year |
budget |
gross |
imdb_score |
|
|
1 |
The Godfather |
1972 |
6000000 |
134821952 |
9.2 |
|
2 |
The Dark Knight |
2008 |
185000000 |
533316061 |
9 |
|
3 |
The Godfather: Part II |
1974 |
13000000 |
57300000 |
9 |
|
4 |
Schindler's List |
1993 |
22000000 |
96067179 |
8.9 |
|
5 |
Pulp Fiction |
1994 |
8000000 |
107930000 |
8.9 |
|
6 |
The Lord of the Rings: The Return of the King |
2003 |
94000000 |
377019252 |
8.9 |
|
7 |
Fight Club |
1999 |
63000000 |
37023395 |
8.8 |
|
8 |
Inception |
2010 |
160000000 |
292568851 |
8.8 |
|
9 |
Star Wars: Episode V - The Empire Strikes Back |
1980 |
18000000 |
290158751 |
8.8 |
|
10 |
The Shawshank Redemption |
1994 |
25000000 |
28341469 |
9.3 |
‘films’ टेबल में दस रिकॉर्ड्स हैं — फ़िल्मों के नाम 10 पंक्तियों में संग्रहीत हैं। फ़ील्ड्स वो पाँच कॉलम हैं जो फ़िल्म से संबंधित जानकारी रखते हैं।
आइए ऊपर दी गई ‘films’ टेबल की जाँच के लिए कुछ बुनियादी SQL कमांड्स से अभ्यास शुरू करें। हम आपसे यह अपेक्षा नहीं करते कि आप तुरंत समाधान क्वेरियाँ चलाएँ… बल्कि इन्हें कुछ प्रमुख अवधारणाएँ सीखने के आधार के रूप में उपयोग करें। इसलिए चिंता न करें यदि आपने अभी तक वह प्लेटफ़ॉर्म तय नहीं किया है जहाँ से आप क्वेरियाँ चलाना चाहते हैं।
ध्यान रखें कि SQL कीवर्ड्स या कमांड्स केस सेंसिटिव नहीं होते; ‘select’ लिखना ‘SELECT’ लिखने के समान है।
हम प्रत्येक SQL स्टेटमेंट के अंत में सेमीकोलन का उपयोग करेंगे। कुछ डेटाबेस सिस्टम्स में यह मानक है, और इसका उद्देश्य प्रत्येक SQL स्टेटमेंट को अलग करना होता है ताकि उन्हें सर्वर को एक ही कॉल में चलाया जा सके।
एक प्रश्न से शुरुआत करते हैं। Q1: टेबल में संग्रहीत फ़िल्में कौन-सी हैं?
SELECT स्टेटमेंट का उपयोग डेटाबेस टेबल से वे फ़ील्ड्स चुनने के लिए किया जाता है जिन्हें आप देखना चाहते हैं। Q1 के लिए, आपको ‘title’ फ़ील्ड चाहिए।
FROM कमांड/कीवर्ड यह निर्दिष्ट करता है कि डेटाबेस में किस विशेष टेबल से आप डेटा निकालना चाहते हैं। याद रखें, एक डेटाबेस में कई टेबल्स हो सकती हैं।
सिंटैक्स: SELECT column1, column2, … FROM table_name;
SQL क्वेरी: SELECT title FROM films;
परिणाम:
|
title |
|
|
1 |
The Godfather |
|
2 |
The Dark Knight |
|
3 |
The Godfather: Part II |
|
4 |
Schindler's List |
|
5 |
Pulp Fiction |
|
6 |
The Lord of the Rings: The Return of the King |
|
7 |
Fight Club |
|
8 |
Inception |
|
9 |
Star Wars: Episode V - The Empire Strikes Back |
|
10 |
The Shawshank Redemption |
आप सोच रहे होंगे, अगर आपने ऊपर दी गई टेबल कभी देखी ही नहीं, तो SELECT स्टेटमेंट में निर्दिष्ट करने के लिए कॉलम के नाम आपको कैसे पता चलेंगे। बढ़िया सवाल! हम इस ट्यूटोरियल में आगे चलकर जादुई ‘*’ (आस्टेरिस्क) के बारे में सीखेंगे।
Q2: 2010 में रिलीज़ होने वाली फ़िल्में कौन-सी हैं?
इस प्रश्न के लिए, आप फ़िल्मों को “फ़िल्टर” करना चाहते हैं ताकि आपके पास वे फ़िल्मों के नाम हों जो इस शर्त को पूरा करती हैं: ‘release_year’ 2010 है।
आप ‘WHERE’ क्लॉज़ का उपयोग केवल उन्हीं रिकॉर्ड्स को निकालने के लिए कर सकते हैं जो किसी निर्दिष्ट शर्त को पूरा करते हैं।
सिंटैक्स: SELECT column1, column2, … FROM table_name WHERE condition;
SQL क्वेरी: SELECT title, release_year FROM films WHERE release_year = 2010;
परिणाम:
|
title |
release_year |
|
|
1 |
Inception |
2010 |
WHERE क्लॉज़ के भीतर निम्नलिखित ऑपरेटर्स का उपयोग किया जा सकता है:
|
Operator |
Description |
|
= |
बराबर |
|
> |
से बड़ा |
|
< |
से छोटा |
|
>= |
से बड़ा या बराबर |
|
<= |
से छोटा या बराबर |
|
<> or != |
बराबर नहीं। |
|
BETWEEN |
किसी दिए गए दायरे के बीच |
|
LIKE |
दिए गए पैटर्न से मेल खाते पैटर्न की खोज |
|
IN |
कई संभावित मान निर्दिष्ट करता है |
आप SQL में सरल अंकगणितीय क्रियाएँ +, -, *, / जैसे गणितीय प्रतीकों का उपयोग करके कर सकते हैं। हालाँकि, आप इन प्रतीकों का उपयोग करके केवल कॉलम्स के बीच ऑपरेशंस कर सकते हैं। आप ऑपरेशंस के क्रम को नियंत्रित करने के लिए कोष्ठकों का भी उपयोग कर सकते हैं।
पर चिंता न करें, अधिक जटिल ऑपरेशंस के लिए — SQL में एग्रीगेट फ़ंक्शंस हैं जो आपको एक ही पंक्ति के भीतर ऑपरेशंस करने की अनुमति देते हैं। हम इस विषय को आगे ट्यूटोरियल में कवर करेंगे।
Q3: ‘films’ टेबल में प्रत्येक फ़िल्म द्वारा कमाया गया मुनाफ़ा निकालें।
संकेत: Gross - Budget करें और परिणाम को ‘movie_profit’ नामक कॉलम में AS का उपयोग करते हुए सहेजें
SQL क्वेरी: SELECT title, (gross - budget) AS movie_profit FROM films
परिणाम:
|
title |
movie_profit |
|
|
1 |
The Godfather |
128821952 |
|
2 |
The Dark Knight |
348316061 |
|
3 |
The Godfather: Part II |
44300000 |
|
4 |
Schindler's List |
74067179 |
|
5 |
Pulp Fiction |
99930000 |
|
6 |
The Lord of the Rings: The Return of the King |
283019252 |
|
7 |
Fight Club |
-25976605 |
|
8 |
Inception |
132568851 |
|
9 |
Star Wars: Episode V - The Empire Strikes Back |
272158751 |
|
10 |
The Shawshank Redemption |
3341469 |
अस्वीकरण: फ़िल्म प्रेमियों को Fight Club के लिए नकारात्मक मुनाफ़ा खल सकता है। उपयोग किया गया फ़ॉर्मूला ((gross - budget) AS movie_profit) बहुत सरल है और सच में, दिए गए फ़ॉर्मूले और डेटा के अनुसार यही सही परिणाम है।
लेकिन ऊपर दिया गया उदाहरण आपको डेटा संग्रह प्रक्रिया के प्रति सतर्क रहने की याद दिलाने के लिए है! साधारण डेटा जाँच भी डेटा त्रुटियों को उजागर कर सकती है जो डेटा संग्रह या डेटा भंडारण प्रक्रिया (जैसे डेटा टाइप बदलना, आदि) में गलती के कारण हो सकती हैं — ऐसा इस डेटासेट को बनाते समय हुआ हो सकता है।
हमेशा उस डेटा पर ध्यान दें जिसके साथ आप काम कर रहे हैं!
WHERE क्लॉज़ को AND, OR और NOT ऑपरेटर्स के साथ अन्य शर्तीय क्लॉज़ के साथ जोड़ा जा सकता है। AND और OR ऑपरेटर्स का उपयोग एक से अधिक शर्तों के आधार पर रिकॉर्ड्स को फ़िल्टर करने के लिए किया जाता है, और NOT ऑपरेटर किसी शर्त को नकारने के लिए उपयोग होता है।
आइए उदाहरणों के माध्यम से इनका उपयोग देखें:
Q4: वे फ़िल्में कौन-सी हैं जो 2010 में रिलीज़ हुईं और जिनकी रेटिंग 9 से अधिक है?
सिंटैक्स: SELECT column1, column2, … FROM table_name WHERE condition1 AND condition2 AND condition3 AND condition4…..;
SQL क्वेरी: SELECT title, release_year, imdb_score FROM films WHERE release_year = 2010 AND imdb_score >= 9;
AND ऑपरेटर तभी रिकॉर्ड दिखाता है जब AND से अलग की गई सभी शर्तें सत्य हों।
‘films’ टेबल में हमारे पास ‘Inception’ है। यह release_year = 2010 के लिए सत्य है, लेकिन imdb_score >= 9 के लिए असत्य है और इस प्रकार दोनों AND शर्तें पूरी नहीं होतीं। इसलिए क्वेरी एक खाली परिणाम सेट लौटाती है।
Q5: वे फ़िल्में कौन-सी हैं जो 2010 में रिलीज़ हुईं या जिनकी रेटिंग 9 से अधिक है?
सिंटैक्स: SELECT column1, column2, … FROM table_name WHERE condition1 OR condition2 OR condition3 OR condition4…..;
SQL क्वेरी: SELECT title, release_year, imdb_score FROM films WHERE release_year = 2010 OR imdb_score >= 9;
परिणाम:
|
title |
release_year |
imdb_score |
|
|
1 |
The Godfather |
1972 |
9.2 |
|
2 |
The Dark Knight |
2008 |
9 |
|
3 |
The Godfather: Part II |
1974 |
9 |
|
4 |
Inception |
2010 |
8.8 |
|
5 |
The Shawshank Redemption |
1994 |
9.3 |
OR ऑपरेटर किसी भी एक शर्त के TRUE होने पर रिकॉर्ड दिखाता है।
फ़िल्में: The Godfather, The Dark Knight, The Godfather: Part II, The Shawshank Redemption imdb_score >= 9 के लिए सत्य हैं, जबकि Inception release_year = 2010 के लिए सत्य है, और इसलिए ये OR शर्त पर खरी उतरती हैं।
Q6: वे फ़िल्में कौन-सी हैं जिनका रिलीज़ वर्ष 2010 के अलावा है?
सिंटैक्स: SELECT column1, column2, … FROM table_name WHERE NOT condition1;
SQL क्वेरी: SELECT title, release_year FROM films WHERE NOT release_year = 2010;
परिणाम:
|
title |
release_year |
|
|
1 |
The Godfather |
1972 |
|
2 |
The Dark Knight |
2008 |
|
3 |
The Godfather: Part II |
1974 |
|
4 |
Schindler's List |
1993 |
|
5 |
Pulp Fiction |
1994 |
|
6 |
The Lord of the Rings: The Return of the King |
2003 |
|
7 |
Fight Club |
1999 |
|
8 |
Star Wars: Episode V - The Empire Strikes Back |
1980 |
|
9 |
The Shawshank Redemption |
1994 |
आप यह भी लिख सकते हैं: SELECT title, release_year FROM films WHERE release_year != 2010;
यह भी ऊपर जैसा ही परिणाम देगा। SQL में एक ही परिणाम पाने के कई तरीके हो सकते हैं। हालाँकि, कुछ क्वेरियाँ अन्य की तुलना में अधिक परफॉर्मेंट हो सकती हैं। प्रदर्शन कई कारकों पर निर्भर कर सकता है — डेटा की मात्रा, क्वेरी में उपयोग किए गए कमांड्स, डेटाबेस की संरचना, डेटा टाइप, आदि। यह थोड़ा अधिक जटिल और उन्नत विषय है जिसे हम इस SQL क्वेरी ट्यूटोरियल में कवर नहीं करेंगे।
लेकिन यदि आप रुचि रखते हैं, तो DataCamp का Database Design course इन विषयों में गहराई से जाता है।
ORDER BY कीवर्ड का उपयोग परिणाम को आरोही (ASC कीवर्ड का उपयोग करके) या अवरोही क्रम (DESC कीवर्ड का उपयोग करके) में क्रमबद्ध करने के लिए किया जाता है। डिफ़ॉल्ट रूप से क्रमबद्धता आरोही क्रम में होती है।
Q7: टेबल में संग्रहीत फ़िल्में कौन-सी हैं? उन्हें release_year के अवरोही क्रम में सॉर्ट करें।
सिंटैक्स: SELECT column1, column2, … FROM table_name ORDER BY column1, column2, ... ASC|DESC;
SQL क्वेरी: SELECT title, release_year FROM films ORDER BY release_year DESC;
परिणाम:
|
title |
release_year |
|
|
1 |
Inception |
2010 |
|
2 |
The Dark Knight |
2008 |
|
3 |
The Lord of the Rings: The Return of the King |
2003 |
|
4 |
Fight Club |
1999 |
|
5 |
Pulp Fiction |
1994 |
|
6 |
The Shawshank Redemption |
1994 |
|
7 |
Schindler's List |
1993 |
|
8 |
Star Wars: Episode V - The Empire Strikes Back |
1980 |
|
9 |
The Godfather: Part II |
1974 |
|
10 |
The Godfather |
1972 |
कभी-कभी आपका क्वेरी चलाने में डेटाबेस को बहुत समय लग सकता है; खासकर तब जब डेटाबेस में संग्रहीत डेटा की मात्रा बहुत अधिक हो।
किसी क्वेरी को जल्दी परखने या यह सैंपल देखने का आसान और तेज़ तरीका कि आपको कैसा परिणाम मिलता है, LIMIT फ़ंक्शन का उपयोग करना है। LIMIT आपको प्राप्त परिणामों की संख्या सीमित करने देता है।
Q8: टेबल में संग्रहीत नवीनतम 5 फ़िल्में कौन-सी हैं?
संकेत: परिणाम सेट को release_year के संबंध में अवरोही क्रम में सॉर्ट करें और फिर LIMIT का उपयोग करें।
सिंटैक्स: SELECT column1, column2, … FROM table_name LIMIT x;
SQL क्वेरी: SELECT title, release_year FROM films ORDER BY release_year DESC LIMIT 5;
परिणाम:
|
title |
release_year |
|
|
1 |
Inception |
2010 |
|
2 |
The Dark Knight |
2008 |
|
3 |
The Lord of the Rings: The Return of the King |
2003 |
|
4 |
Fight Club |
1999 |
|
5 |
Pulp Fiction |
1994 |
INSERT INTO का उपयोग किसी डेटाबेस टेबल में नए रिकॉर्ड्स जोड़ने के लिए किया जाता है। आप INSERT INTO स्टेटमेंट दो तरीकों से लिख सकते हैं:
सिंटैक्स: INSERT INTO table_name (column1, column2, column3, ...) VALUES (value1, value2, value3, ...);
सिंटैक्स: INSERT INTO table_name VALUES (value1, value2, value3, ...);
Q9: ‘The Godfather: Part III’ के लिए टेबल में यह प्रविष्टि जोड़ें: (‘The Godfather: Part III’, 1990, 54000000, 136900000, 7.6)
सिंटैक्स: SELECT column1, column2, … FROM table_name ORDER BY column1, column2,... ASC|DESC;
SQL क्वेरी: INSERT INTO films (title, release_year, budget, gross, imdb_score)
VALUES (‘The Godfather: Part III’, 1970, 54000000, 136900000, 7.6);
परिणामी टेबल:
|
title |
release_year |
budget |
gross |
imdb_score |
|
|
1 |
The Godfather |
1972 |
6000000 |
134821952 |
9.2 |
|
2 |
The Dark Knight |
2008 |
185000000 |
533316061 |
9 |
|
3 |
The Godfather: Part II |
1974 |
13000000 |
57300000 |
9 |
|
4 |
Schindler's List |
1993 |
22000000 |
96067179 |
8.9 |
|
5 |
Pulp Fiction |
1994 |
8000000 |
107930000 |
8.9 |
|
6 |
The Lord of the Rings: The Return of the King |
2003 |
94000000 |
377019252 |
8.9 |
|
7 |
Fight Club |
1999 |
63000000 |
37023395 |
8.8 |
|
8 |
Inception |
2010 |
160000000 |
292568851 |
8.8 |
|
9 |
Star Wars: Episode V - The Empire Strikes Back |
1980 |
18000000 |
290158751 |
8.8 |
|
10 |
The Shawshank Redemption |
1994 |
25000000 |
28341469 |
9.3 |
|
11 |
The Godfather: Part III |
1970 |
54000000 |
136900000 |
7.6 |
हम किसी तालिका में मौजूदा रिकॉर्ड संशोधित करने के लिए UPDATE स्टेटमेंट का उपयोग करते हैं।
Q10: ‘The Godfather: Part III’ के लिए release_year को 1970 के बजाय 1990 कर दें
सिंटैक्स: UPDATE table_name SET column1 = value1, column2 = value2, ...WHERE condition;
SQL क्वेरी: UPDATE films SET release_year = 1990 WHERE title = ‘The Godfather: Part III’;
परिणामी तालिका:
|
title |
release_year |
budget |
gross |
imdb_score |
|
|
1 |
The Godfather |
1972 |
6000000 |
134821952 |
9.2 |
|
2 |
The Dark Knight |
2008 |
185000000 |
533316061 |
9 |
|
3 |
The Godfather: Part II |
1974 |
13000000 |
57300000 |
9 |
|
4 |
Schindler's List |
1993 |
22000000 |
96067179 |
8.9 |
|
5 |
Pulp Fiction |
1994 |
8000000 |
107930000 |
8.9 |
|
6 |
The Lord of the Rings: The Return of the King |
2003 |
94000000 |
377019252 |
8.9 |
|
7 |
Fight Club |
1999 |
63000000 |
37023395 |
8.8 |
|
8 |
Inception |
2010 |
160000000 |
292568851 |
8.8 |
|
9 |
Star Wars: Episode V - The Empire Strikes Back |
1980 |
18000000 |
290158751 |
8.8 |
|
10 |
The Shawshank Redemption |
1994 |
25000000 |
28341469 |
9.3 |
|
11 |
The Godfather: Part III |
1990 |
54000000 |
136900000 |
7.6 |
DELETE स्टेटमेंट किसी तालिका में मौजूदा रिकॉर्ड को हटाने के लिए उपयोग होता है।
Q11: ‘films’ तालिका से ‘The Godfather: Part III’ की एंट्री हटा दें।
सिंटैक्स: DELETE FROM table_name WHERE condition;
SQL क्वेरी: DELETE FROM films WHERE title = ‘The Godfather: Part III’;
परिणामी तालिका: वही मूल तालिका जिससे हमने शुरुआत की थी, कुल 10 रिकॉर्ड्स के साथ।
याद है हमने Q1 के अंत में ‘*’ को बाद की चर्चा के लिए छोड़ा था? यह * एक asterisk है। यह एक व्यापक चिन्ह है जिसे हम ‘सभी’ के रूप में पढ़ सकते हैं।
Q1 पर लौटते हैं: तालिका में कौन-कौन सी फ़िल्में सहेजी गई हैं?
हमने SELECT - FROM का उपयोग किया था, सिंटैक्स: SELECT column1, column2, … FROM table_name;
हमने क्वेरी इस्तेमाल की: SELECT title FROM films;
लेकिन अगर आपको पता ही न हो कि ‘films’ तालिका में ‘title’ नाम का फ़ील्ड है? या किसी भी फ़ील्ड का नाम? या आप बस तालिका के सभी फ़ील्ड्स देखना चाहते हों ताकि डेटा का अंदाज़ा लग सके? यहीं पर * काम आता है।
हम क्वेरी को इस तरह लिख सकते हैं: SELECT * FROM films;
यह हमें तालिका में उपलब्ध सभी फ़ील्ड्स दे देगा।
LIKE ऑपरेटर का उपयोग WHERE क्लॉज़ में किसी कॉलम में निर्दिष्ट पैटर्न खोजने के लिए किया जाता है।
Q12: उन सभी फ़िल्मों के नाम निकालें जो ‘The’ से शुरू होती हैं
सिंटैक्स: SELECT column1, column2, … FROM table_name WHERE column1 LIKE patternToMatch;
SQL क्वेरी: Select * FROM films WHERE title LIKE ‘The%’;
परिणामी तालिका:
|
title |
release_year |
budget |
gross |
imdb_score |
|
|
1 |
The Godfather |
1972 |
6000000 |
134821952 |
9.2 |
|
2 |
The Dark Knight |
2008 |
185000000 |
533316061 |
9 |
|
3 |
The Godfather: Part II |
1974 |
13000000 |
57300000 |
9 |
|
4 |
The Lord of the Rings: The Return of the King |
2003 |
94000000 |
377019252 |
8.9 |
|
5 |
The Shawshank Redemption |
1994 |
25000000 |
28341469 |
9.3 |
|
वाइल्डकार्ड कैरेक्टर |
विवरण |
उपयोग: उदाहरण |
|
% (प्रतिशत) |
शून्य या अधिक अक्षरों का प्रतिनिधित्व करता है |
The%: The, The Godfather, Theodore |
|
_ (अंडरस्कोर) |
एक एकल अक्षर का प्रतिनिधित्व करता है |
T_e: The, Tie |
|
[ ] (स्क्वायर ब्रैकेट) |
ब्रैकेट के भीतर किसी भी एकल अक्षर का प्रतिनिधित्व करता है |
C[ao]t: Cat, Cot लेकिन Coat नहीं |
|
^ (वेज) |
ब्रैकेट में न होने वाले किसी भी अक्षर का प्रतिनिधित्व करता है |
Ca[^r]: Cat, Cab, Can लेकिन Car नहीं |
|
- (डैश) |
निर्दिष्ट रेंज के भीतर किसी भी एकल अक्षर का प्रतिनिधित्व करता है |
C[a-o]: Can, Cab लेकिन Car, Cat नहीं |
अच्छी बात यह है कि हम वाइल्डकार्ड्स को संयोजन में उपयोग कर सकते हैं! तो आप LIKE के साथ वाइल्डकार्ड कैरेक्टर्स का उपयोग करके काफी जटिल मिलान कथन बना सकते हैं।
SQL डेटा को इस तरह एग्रीगेट करने में उत्कृष्ट है जैसे आप Excel में पिवट टेबल में करते हैं। एग्रीगेट फ़ंक्शंस दो कॉलमों के बीच नहीं, बल्कि एक कॉलम के भीतर गणना करते हैं, यानी उसी कॉलम की सभी या कुछ पंक्तियों पर काम करते हैं।
SQL में ये एग्रीगेट फ़ंक्शंस होते हैं:
|
फ़ंक्शन |
विवरण |
|
COUNT |
किसी विशेष कॉलम में रिकॉर्ड्स की संख्या गिनता है |
|
SUM |
किसी विशेष कॉलम के सभी मानों को जोड़ता है |
|
MIN |
किसी विशेष कॉलम में सबसे छोटा मान लौटाता है |
|
MAX |
किसी विशेष कॉलम में सबसे बड़ा मान लौटाता है |
|
AVG |
चयनित समूह के लिए औसत मान देता है |
Q13: तालिका में सबसे नई (नवीनतम) फ़िल्म कौन सी है?
SQL क्वेरी: SELECT title AS latest_movie, MAX(release_year) AS released_in FROM films;
परिणाम:
|
latest_movie |
released_in |
|
|
1 |
Inception |
2010 |
SQL एग्रीगेट फ़ंक्शंस पूरे कॉलम पर एग्रीगेट करते हैं। लेकिन अगर आप किसी कॉलम के केवल एक हिस्से पर एग्रीगेट करना चाहें तो? उदाहरण के लिए, आप एक वर्ष में रिलीज़ हुई फ़िल्मों की संख्या गिनना चाह सकते हैं।
यहीं आपको GROUP BY क्लॉज़ की आवश्यकता होती है। GROUP BY आपको डेटा को समूहों में विभाजित करने देता है, जिन्हें फिर एक-दूसरे से स्वतंत्र रूप से एग्रीगेट किया जा सकता है।
Q13: एक वर्ष में रिलीज़ हुई फ़िल्मों की संख्या गिनें।
SQL क्वेरी: SELECT release_year, COUNT(*) AS number_of_movies FROM films GROUP BY release_year;
परिणाम:
|
release_year |
number_of_movies |
|
|
1 |
1972 |
1 |
|
2 |
2008 |
1 |
|
3 |
1974 |
1 |
|
4 |
1993 |
1 |
|
5 |
1994 |
2 |
|
6 |
2003 |
1 |
|
7 |
1999 |
1 |
|
8 |
2010 |
1 |
|
9 |
1980 |
1 |
अब तक, हम एक समय में केवल एक तालिका के साथ काम कर रहे थे। लेकिन डेटाबेस और SQL की असली ताकत कई तालिकाओं के डेटा के साथ काम करने की क्षमता से आती है।
RDBMS में "relational database" शब्द इसलिए आता है क्योंकि डेटाबेस के भीतर तालिकाएँ एक-दूसरे से संबंधित होती हैं। उनके पास सामान्य पहचानकर्ता होते हैं जो कई तालिकाओं के डेटा को आसानी से संयोजित करने की अनुमति देते हैं। यहीं हम SQL तालिका JOINS का उपयोग करते हैं।
आइए एक सरल उदाहरण देखते हैं ताकि हम JOIN सिंटैक्स से परिचित हों और साथ ही विभिन्न प्रकार के JOINS के बारे में थोड़ा सीखें।
मान लीजिए एक और तालिका ‘movieDirectors’ है जो ‘films’ तालिका में मौजूद कुछ फ़िल्मों के लिए निर्देशक का नाम रखती है।
|
title |
director |
|
|
1 |
The Godfather |
Francis Ford Coppola |
|
2 |
The Godfather: Part II |
Francis Ford Coppola |
|
3 |
The Godfather: Part III |
Francis Ford Coppola |
|
4 |
Schindler's List |
Steven Spielberg |
|
5 |
The Dark Knight Rises |
Christopher Nolan |
हम इन दोनों तालिकाओं के डेटा को एक सामान्य पहचानकर्ता: ‘title’ का उपयोग करके संयोजित कर सकते हैं।
Q14: ‘movieDirectors’ तालिका से निर्देशक का नाम लेकर ‘films’ तालिका में एक कॉलम जोड़ें और उसे भरें।
सिंटैक्स: SELECT leftTable.column1, rightTable.column1, leftTable.column2…. FROM leftTable INNER JOIN rightTable ON leftTable.commonIdentifier = rightTable.commonIdentifier;
SQL क्वेरी: Select films.title, films.release_year, movieDirectors.director FROM films INNER JOIN movieDirectors ON films.title = movieDirectors.title
परिणाम:
|
title |
release_year |
director |
|
|
1 |
The Godfather |
1972 |
Francis Ford Coppola |
|
2 |
The Godfather: Part II |
1974 |
Francis Ford Coppola |
|
3 |
Schindler's List |
1993 |
Steven Spielberg |
|
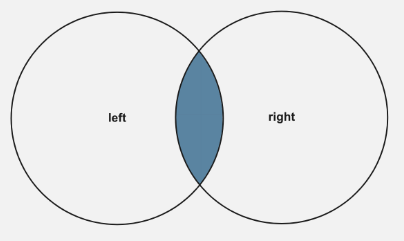
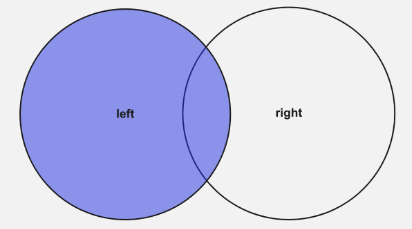
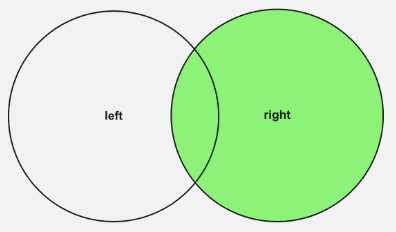
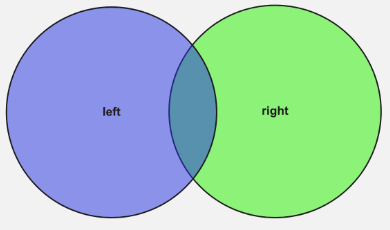
JOIN |
विवरण |
आरेख |
|
Inner Join |
केवल वे रिकॉर्ड लौटाता है जिनके मान दोनों तालिकाओं में मेल खाते हैं |
|
|
Left (Outer) Join |
लेफ्ट तालिका के सभी रिकॉर्ड्स और राइट तालिका से मेल खाते रिकॉर्ड्स लौटाता है |
|
|
Right (Outer) Join |
राइट तालिका के सभी रिकॉर्ड्स और लेफ्ट तालिका से मेल खाते रिकॉर्ड्स लौटाता है |
|
|
Full (Outer) Join |
जब लेफ्ट या राइट किसी भी तालिका में मेल हो, तब सभी रिकॉर्ड्स लौटाता है |
|
ऊपर की उदाहरण क्वेरी में, ‘films’ लेफ्ट तालिका है और ‘movieDirectors’ राइट तालिका। इसलिए INNER JOIN के साथ हमें केवल वे फ़िल्में मिलीं जो दोनों तालिकाओं में मौजूद थीं। परिणाम सेट दोनों तालिकाओं का इंटरसेक्शन था।
SQL JOINS आपको दो डाटासेट्स को बगल-बगल मिलाने देते हैं। लेकिन SQL UNION के साथ आप एक डाटासेट को दूसरे के ऊपर स्टैक कर सकते हैं। UNION ऑपरेटर का उपयोग दो या अधिक SELECT स्टेटमेंट्स के परिणाम-सेट को संयोजित करने के लिए किया जाता है, जब निम्नलिखित “नियम” पूरे हों:
सिंटैक्स: SELECT column_name(s) FROM table1 UNION ALL SELECT column_name(s) FROM table2;
मान लीजिए ‘movies_2000s’ नाम की तालिका है:
|
title |
release_year |
budget |
gross |
imdb_score |
|
|
1 |
Inception |
2010 |
160000000 |
292568851 |
8.8 |
|
2 |
The Trial of the Chicago 7 |
2020 |
35000000 |
7.7 |
अब यदि हम दोनों तालिकाओं को संयोजित करें…
SQL क्वेरी: SELECT title FROM films UNION SELECT title FROM movies_2000s;
परिणाम:
|
title |
|
|
1 |
The Godfather |
|
2 |
The Dark Knight |
|
3 |
The Godfather: Part II |
|
4 |
Schindler's List |
|
5 |
Pulp Fiction |
|
6 |
The Lord of the Rings: The Return of the King |
|
7 |
Fight Club |
|
8 |
Inception |
|
9 |
Star Wars: Episode V - The Empire Strikes Back |
|
10 |
The Shawshank Redemption |
|
12 |
The Trial of the Chicago 7 |
आपने गौर किया होगा कि ‘Inception’ परिणाम सेट में केवल एक बार आया। ऐसा इसलिए है क्योंकि UNION केवल भिन्न (distinct) मान चुनता है; यदि आप सभी मान चाहते हैं, तो UNION ALL का उपयोग करें।
SQL डेटा के साथ कमाल करने में सक्षम है। नेस्टेड क्वेरीज़ SQL में एक और टूल हैं जो इसे जानने लायक भाषा बनाते हैं। एक नेस्टेड क्वेरी दरअसल एक क्वेरी के भीतर दूसरी क्वेरी होती है (कुछ वैसा ही जैसे Inception में सपनों के भीतर सपने!)
नेस्टेड क्वेरीज़ के साथ, आप बहुत जटिल कार्य कर सकते हैं, लेकिन कई चरणों में, जिससे कोड की पठनीयता और समझ बनाए रहती है।
Q15: ‘films’ तालिका में फ़िल्मों की औसत लाभप्रदता निर्धारित करें।
संकेत: आपने पहले Q3 में लाभप्रदता की गणना की थी। अब आपको उस क्वेरी के परिणाम पर AVG फ़ंक्शन लागू करना है।
SQL नेस्टेड क्वेरी:
SELECT AVG(*) AS average_profit FROM
(SELECT title, (gross - budget) AS movie_profit FROM films where gross > budget);
हमने आंतरिक SQL क्वेरी में gross > budget जोड़कर गणना से ‘Fight Club’ का नकारात्मक मान हटा दिया।
ऊपर की नेस्टेड क्वेरी में, पहले आंतरिक क्वेरी चलती है और फिर इस परिणाम सेट को बाहरी क्वेरी के लिए एक अस्थायी तालिका के रूप में उपयोग किया जाता है, जिससे डेटा लिया जाता है।
हम नेस्टेड SQL क्वेरी विषय में बहुत गहराई में नहीं जाएंगे। लेकिन हम आपको दृढ़ता से सलाह देते हैं कि SQL क्वेरीज़ में निपुण होने के लिए DataCamp का Intermediate SQL कोर्स करें। आप नेस्टेड क्वेरीज़ के बारे में और सीखते हुए European Soccer Database के साथ काम करेंगे। आप CASE स्टेटमेंट्स और विंडो फ़ंक्शंस के बारे में भी सीखेंगे — विषय जिन्हें हम इस SQL क्वेरी ट्यूटोरियल में कवर नहीं कर सके।
आपने SQL क्वेरीज़ के बारे में बहुत कुछ सीखा है और अब आप SQL का उपयोग करके वास्तविक दुनिया की समस्याओं को सुलझाने की अपनी यात्रा शुरू करने की अच्छी स्थिति में हैं। इस SQL क्वेरी ट्यूटोरियल में, आपने सीखा कि SQL क्वेरी क्या होती है और SQL क्वेरीज़ कैसे लिखी जाती हैं।
आपने क्वेरी सिंटैक्स देखा और रास्ते में कुछ प्रश्नों के उत्तर दिए। हमने SELECT - FROM - WHERE स्टेटमेंट्स का उपयोग करते हुए सरल SQL क्वेरी उदाहरणों से शुरुआत की और जॉइन्स, यूनियन और नेस्टेड क्वेरीज़ का उपयोग करते हुए थोड़ी अधिक जटिल SQL क्वेरीज़ तक पहुँचे।
हमने ट्यूटोरियल में बहुत कुछ कवर किया, फिर भी यह सभी संभावित सरल और उन्नत SQL क्वेरीज़ की संपूर्ण सूची नहीं है — और भी हैं। और हम आपको SQL की गहरी और व्यापक समझ के लिए DataCamp के SQL Fundamentals ट्रैक को फॉलो करने की दृढ़ता से सलाह देते हैं।
याद रखें, किसी भी कौशल में निपुण होने की कुंजी अभ्यास है और SQL भी अपवाद नहीं! अभ्यास आपके SQL कौशल को शुरुआती से उन्नत स्तर तक ले जाएगा।
तो, शुरुआत कीजिए और क्वेरी करने का आनंद लीजिए!
SQL के लिए कोर्स
कोर्स
कोर्स