
{count, plural, one {Kursus} other {Kursus}}
Dasar-dasar Probabilitas di R
{hours} jam
43K
Berapa banyak wawancara kerja yang mungkin Anda jalani sebelum mendapatkan posisi impian? Berapa banyak upaya yang dibutuhkan sebelum sebuah kampanye pemasaran menghasilkan penjualan pertama? Distribusi geometrik menjawab pertanyaan waktu tunggu ini dengan memodelkan jumlah percobaan yang dibutuhkan hingga terjadi keberhasilan pertama.
Panduan ini membahas dasar matematis distribusi geometrik, sifat-sifat khasnya, dan penerapan praktis yang membuatnya berharga bagi siapa pun yang bekerja dengan skenario percobaan berurutan. Untuk penyegaran mengenai distribusi probabilitas, pertimbangkan untuk mengikuti kursus Introduction to Statistics kami.
Distribusi geometrik adalah distribusi probabilitas diskret yang memodelkan jumlah percobaan Bernoulli yang independen yang diperlukan untuk mencapai keberhasilan pertama. Setiap percobaan memiliki probabilitas keberhasilan yang sama, dan setiap percobaan saling bebas.
Distribusi ini hadir dalam dua bentuk umum: satu yang menghitung total jumlah percobaan hingga keberhasilan pertama (termasuk keberhasilan), dan satu lagi yang hanya menghitung jumlah kegagalan sebelum keberhasilan pertama. Keduanya banyak digunakan tergantung konteks penerapannya. Sepanjang panduan ini, kita akan menggunakan bentuk pertama, yakni menghitung total jumlah percobaan hingga keberhasilan pertama, di mana X dapat bernilai 1, 2, 3, dan seterusnya.
Mari kita tinjau struktur matematis dan karakteristik yang mendefinisikan distribusi ini.
Distribusi geometrik membutuhkan tiga syarat kunci: percobaan yang independen, probabilitas keberhasilan yang identik pada semua percobaan, dan probabilitas tetap p dengan 0 < p ≤ 1. Notasi standar menggunakan p untuk probabilitas keberhasilan dan q = 1-p untuk probabilitas kegagalan.
Fungsi massa probabilitas (PMF) untuk jumlah percobaan X hingga keberhasilan pertama adalah:
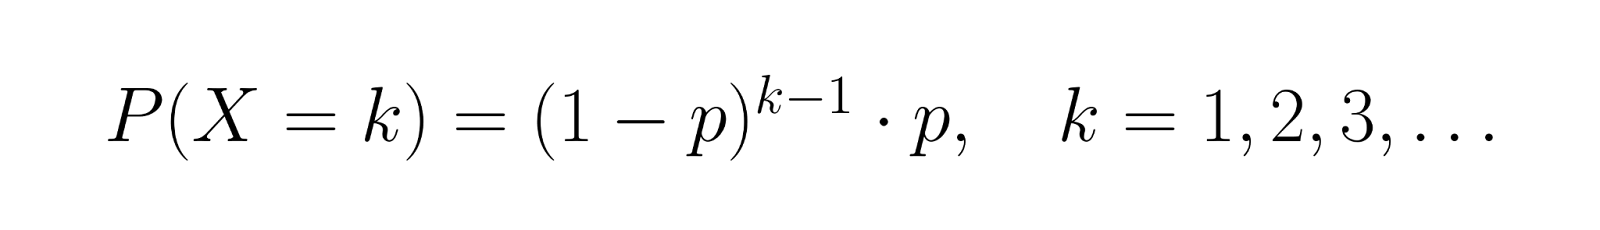
Formula ini menghitung probabilitas mengalami tepat k-1 kegagalan yang diikuti satu keberhasilan. Misalnya, jika p = 0,3, probabilitas keberhasilan pada percobaan ketiga adalah P(X = 3) = (0,7)² × 0,3 = 0,147.
Fungsi distribusi kumulatif (CDF) memberikan:
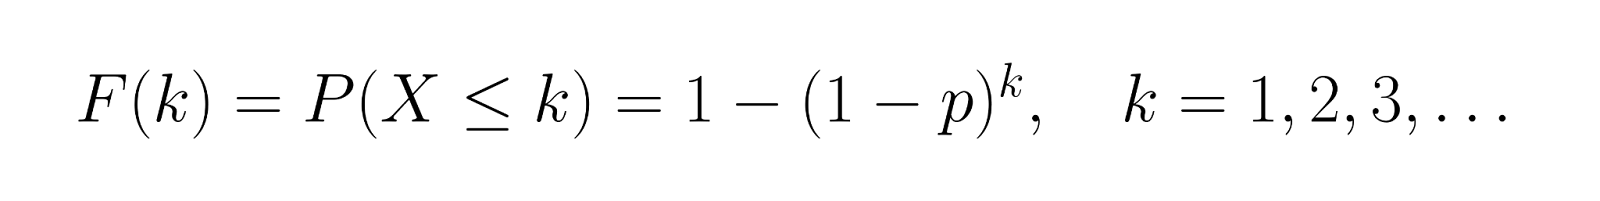
Ini merepresentasikan probabilitas mencapai keberhasilan dalam k percobaan. Menggunakan contoh p = 0,3, mari hitung CDF untuk beberapa nilai awal:
Ini menunjukkan ada peluang 30% untuk berhasil pada percobaan pertama, 51% untuk berhasil dalam dua percobaan pertama, dan 65,7% untuk berhasil dalam tiga percobaan pertama.
Pola visual distribusi geometrik menampilkan wawasan kunci tentang skenario waktu tunggu. Grafik-grafik ini menunjukkan bagaimana probabilitas terkonsentrasi pada percobaan awal dan menurun secara eksponensial, sehingga distribusi ini berguna untuk memodelkan situasi di mana keberhasilan lebih mungkin terjadi lebih cepat daripada kemudian.
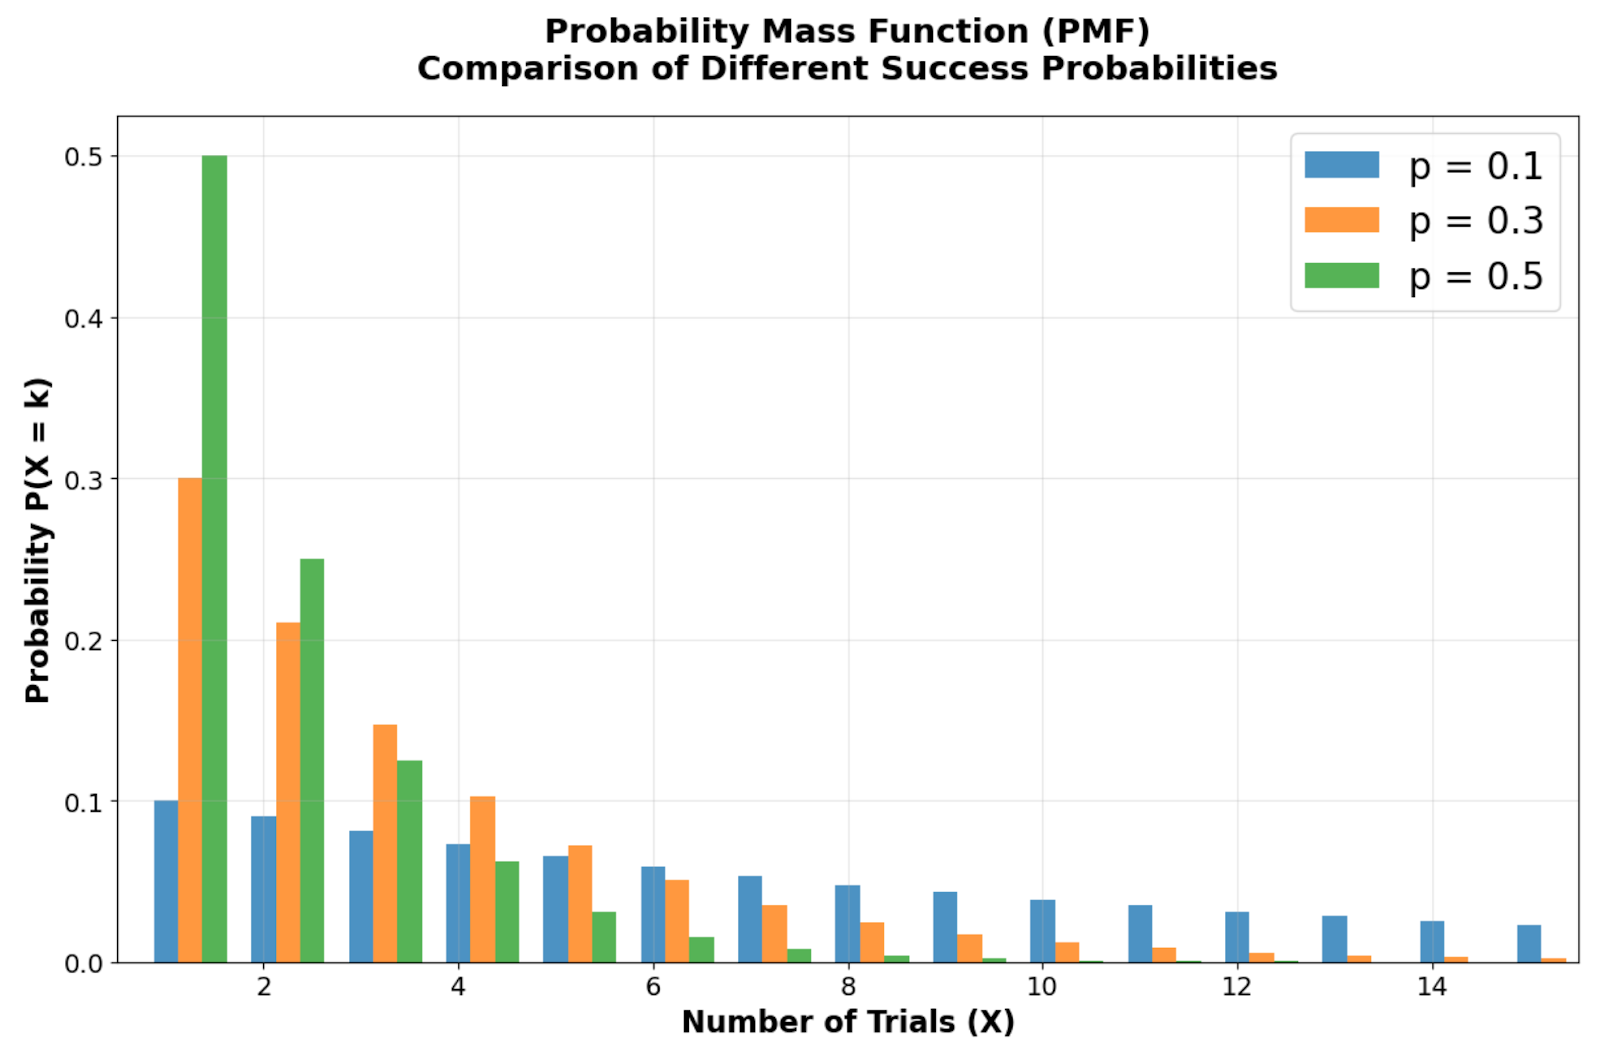
Perbandingan Probability Mass Function yang menunjukkan bagaimana probabilitas keberhasilan berbeda (p = 0,1, 0,3, 0,5) memengaruhi bentuk distribusi. Gambar oleh Penulis
Melihat perbandingan fungsi massa probabilitas untuk berbagai probabilitas keberhasilan, Anda dapat melihat bentuk kemiringan ke kanan yang khas dari distribusi geometrik dengan modus selalu pada X = 1 (percobaan pertama). Perhatikan bagaimana batang probabilitas tertinggi pada percobaan pertama dan menurun secara geometrik pada setiap percobaan berikutnya. Saat probabilitas keberhasilan p menurun, distribusi menjadi lebih menyebar, mencerminkan waktu tunggu yang diharapkan lebih lama. Misalnya, dengan p = 0,1, hanya ada peluang 10% untuk berhasil seketika, menciptakan ekor kanan yang lebih panjang dibandingkan p = 0,5.
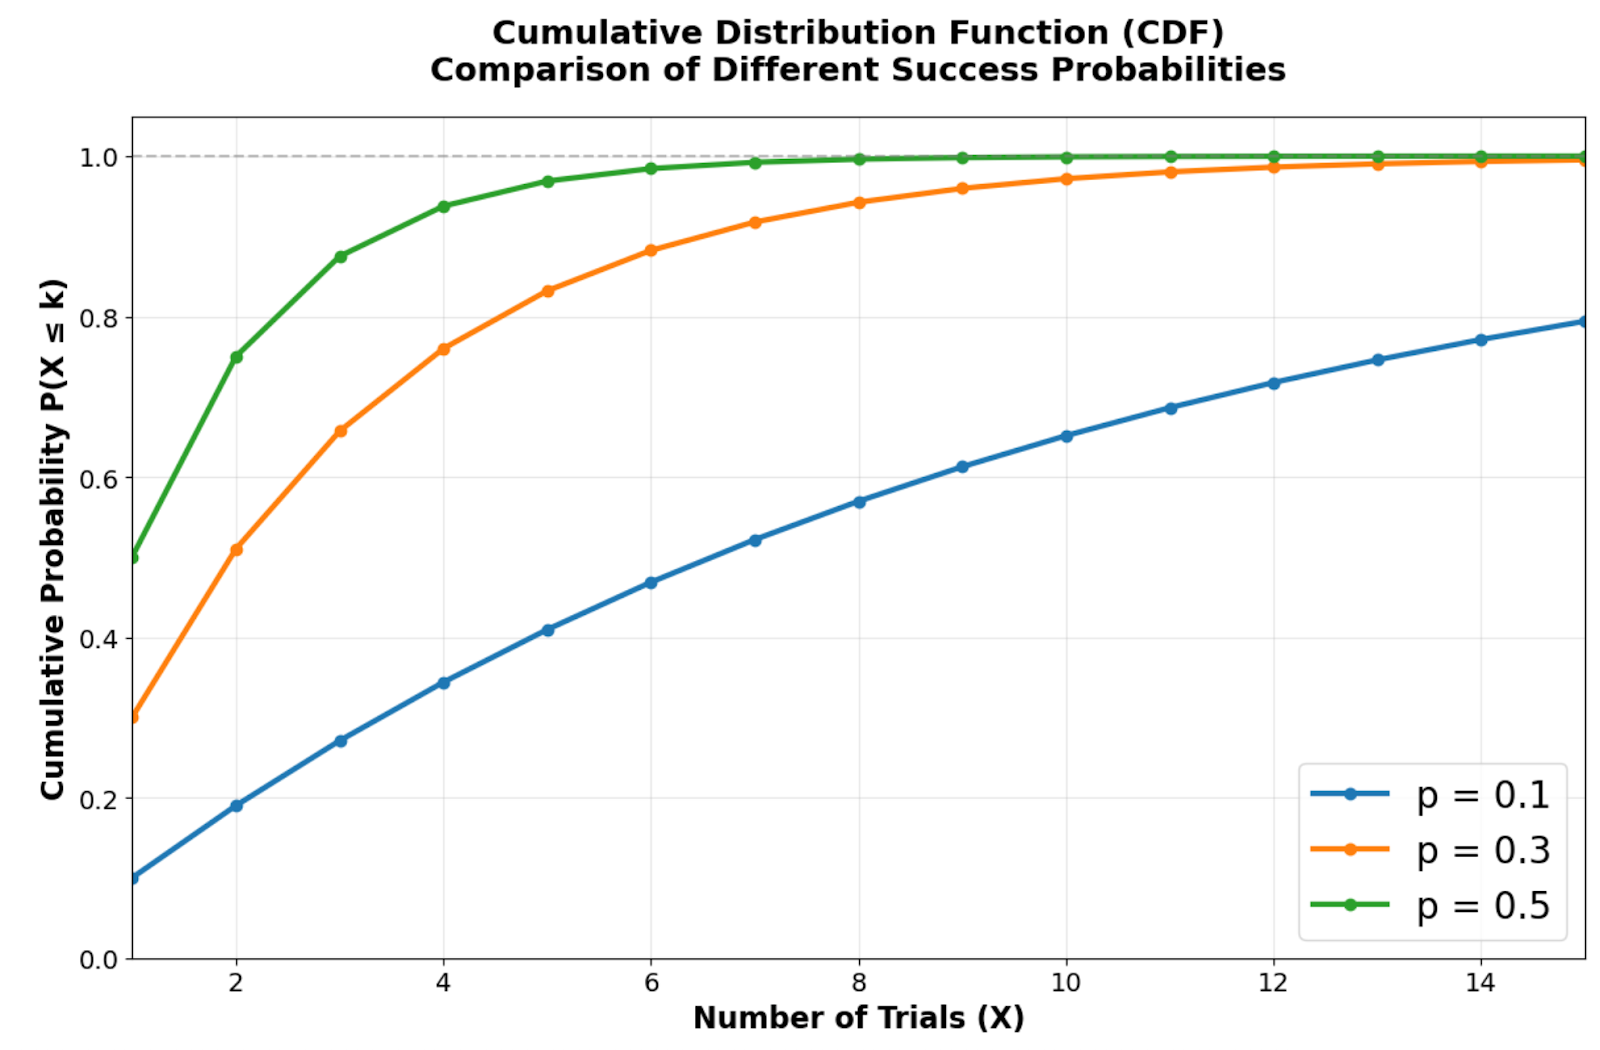
Fungsi Distribusi Kumulatif yang menunjukkan seberapa cepat berbagai probabilitas keberhasilan mendekati kepastian. Gambar oleh Penulis.
Fungsi distribusi kumulatif menunjukkan seberapa cepat distribusi geometrik mendekati kepastian. Probabilitas keberhasilan yang lebih tinggi menghasilkan kurva yang lebih curam dan mencapai probabilitas kumulatif tinggi hanya dalam beberapa percobaan. Sebagai contoh, dengan p = 0,5, ada kira-kira 75% peluang keberhasilan dalam dua percobaan pertama, sedangkan p = 0,1 membutuhkan jauh lebih banyak percobaan untuk mencapai tingkat kepastian yang sama.

Perbandingan berdampingan yang menyoroti pola peluruhan eksponensial pada PMF dan pendekatan cepat menuju kepastian pada CDF. Gambar oleh Penulis.
Pola peluruhan eksponensial ini menjelaskan mengapa distribusi geometrik bekerja baik untuk memodelkan skenario di mana keberhasilan dini lebih mungkin daripada periode menunggu yang berkepanjangan. Kenaikan CDF yang cepat menuju 1 menunjukkan mengapa distribusi ini efektif untuk memodelkan proses dengan waktu tunggu singkat, sehingga berharga untuk skenario pengendalian mutu, analisis konversi pelanggan, dan pengujian keandalan.
Anda dapat membuat ulang visualisasi ini dan mengeksplorasi berbagai nilai parameter menggunakan pustaka scipy dan matplotlib di Python. Berikut cara menghasilkan wawasan visual utama yang menonjolkan karakteristik terpenting dari distribusi geometrik:
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

# Create side-by-side plots for PMF and CDF
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(16, 6))
fig.suptitle('Geometric Distribution: Key Visual Insights', fontsize=24, fontweight='bold')

# Simple PMF showing exponential decay (using p = 0.3)
x_simple = np.arange(1, 11)
pmf_simple = stats.geom.pmf(x_simple, 0.3)

ax1.bar(x_simple, pmf_simple, alpha=0.8, color='steelblue', edgecolor='black', linewidth=1)
ax1.set_title('PMF: Exponential Decay Pattern', fontsize=18, fontweight='bold', pad=15)
ax1.set_xlabel('Number of Trials (X)', fontsize=17, fontweight='bold')
ax1.set_ylabel('Probability', fontsize=14, fontweight='bold')
ax1.grid(True, alpha=0.3)
ax1.tick_params(axis='both', which='major', labelsize=14)

# Simple CDF showing approach to 1
cdf_simple = stats.geom.cdf(x_simple, 0.3)

ax2.plot(x_simple, cdf_simple, 'o-', linewidth=4, markersize=8, color='darkgreen')
ax2.set_title('CDF: Rapid Approach to Certainty', fontsize=18, fontweight='bold', pad=15)
ax2.set_xlabel('Number of Trials (X)', fontsize=17, fontweight='bold')
ax2.set_ylabel('Cumulative Probability', fontsize=14, fontweight='bold')
ax2.grid(True, alpha=0.3)
ax2.set_ylim(0, 1.05)
ax2.tick_params(axis='both', which='major', labelsize=14)

plt.tight_layout()
plt.show()
Kode ini membuat visualisasi terfokus yang menekankan dua karakteristik visual terpenting dari distribusi geometrik. Panel kiri menunjukkan bagaimana probabilitas meluruh secara eksponensial sejak percobaan pertama, sedangkan panel kanan menunjukkan akumulasi massa probabilitas yang cepat pada CDF.
Cobalah mengubah probabilitas keberhasilan dari 0,3 ke nilai lain seperti 0,1 atau 0,7 untuk melihat bagaimana bentuk distribusi berubah. Probabilitas yang lebih rendah menghasilkan kurva PMF yang lebih datar dan CDF yang naik lebih lambat, sementara probabilitas yang lebih tinggi menghasilkan penurunan yang lebih curam dan pendekatan menuju kepastian yang lebih cepat.
Distribusi geometrik memiliki karakteristik unik yang membedakannya dari sebagian besar distribusi diskret lainnya.
Sifat tanpa ingatan menyatakan bahwa P(X > s + t | X > s) = P(X > t) untuk setiap bilangan bulat positif s dan t. Artinya, probabilitas membutuhkan percobaan tambahan tidak bergantung pada berapa banyak percobaan yang gagal yang telah terjadi.
Secara matematis, sifat ini muncul karena P(X > k) = (1-p)k, sehingga perhitungan probabilitas bersyarat menjadi mudah. Dalam praktik, jika Anda sudah mengalami lima wawancara kerja yang gagal, distribusi probabilitas untuk wawancara berikutnya tetap sama seperti saat Anda memulai—kegagalan masa lalu tidak memengaruhi probabilitas di masa depan.
Setiap percobaan dalam eksperimen geometrik merepresentasikan percobaan Bernoulli yang independen dengan probabilitas keberhasilan konstan p. Distribusi geometrik memodelkan rangkaian percobaan ini hingga keberhasilan pertama, menjadikannya analog diskret untuk masalah waktu tunggu.
Keterkaitan ini menjelaskan mengapa distribusi geometrik sering muncul dalam pengendalian mutu, di mana setiap item yang diuji merupakan percobaan Bernoulli, dan kita tertarik mendeteksi item cacat pertama. Asumsi independensi memastikan bahwa menemukan item cacat pada pengujian awal tidak mengubah probabilitas menemukan cacat pada pengujian berikutnya.
Distribusi eksponensial merupakan padanan kontinu dari distribusi geometrik, keduanya berbagi sifat tanpa ingatan. Jika distribusi geometrik memodelkan waktu tunggu diskret (jumlah percobaan), distribusi eksponensial memodelkan waktu tunggu kontinu (waktu hingga sebuah peristiwa).
Keduanya digunakan dalam analisis keandalan dan teori antrian. Misalnya, distribusi geometrik dapat memodelkan jumlah permintaan server hingga terjadi kegagalan pertama, sementara distribusi eksponensial memodelkan waktu hingga kegagalan server berikutnya terjadi.
Dengan konsep dasar dan sifat unik telah dibahas, mari jelajahi perangkat matematis yang memungkinkan perhitungan probabilitas yang presisi dan pengambilan keputusan yang tepat. Rumus dan keterkaitan ini akan sangat penting saat menerapkan distribusi geometrik pada masalah dunia nyata.
Nilai harapan (rata-rata) dari distribusi geometrik adalah:
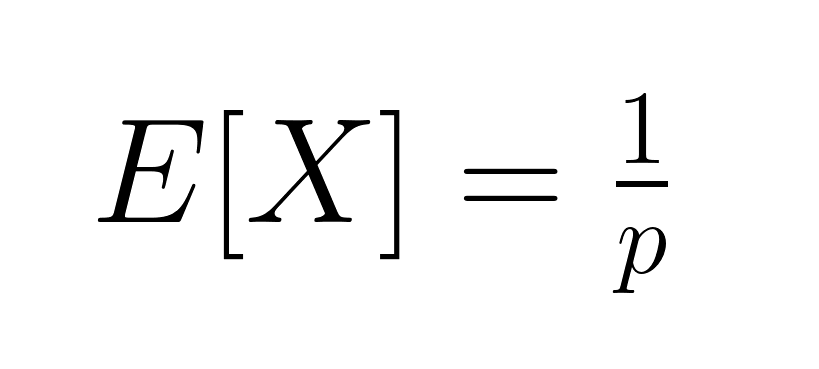
Ini merepresentasikan rata-rata jumlah percobaan yang dibutuhkan untuk berhasil. Variansnya sama dengan:
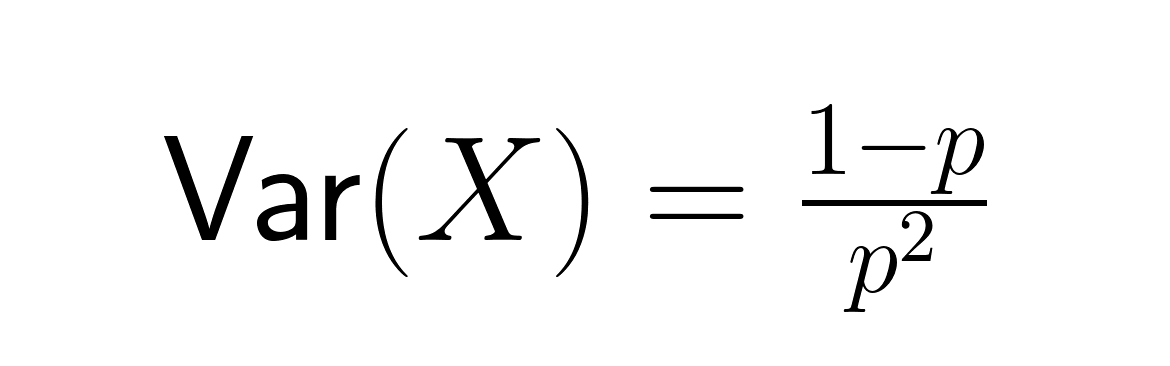
Simpangan bakunya adalah:
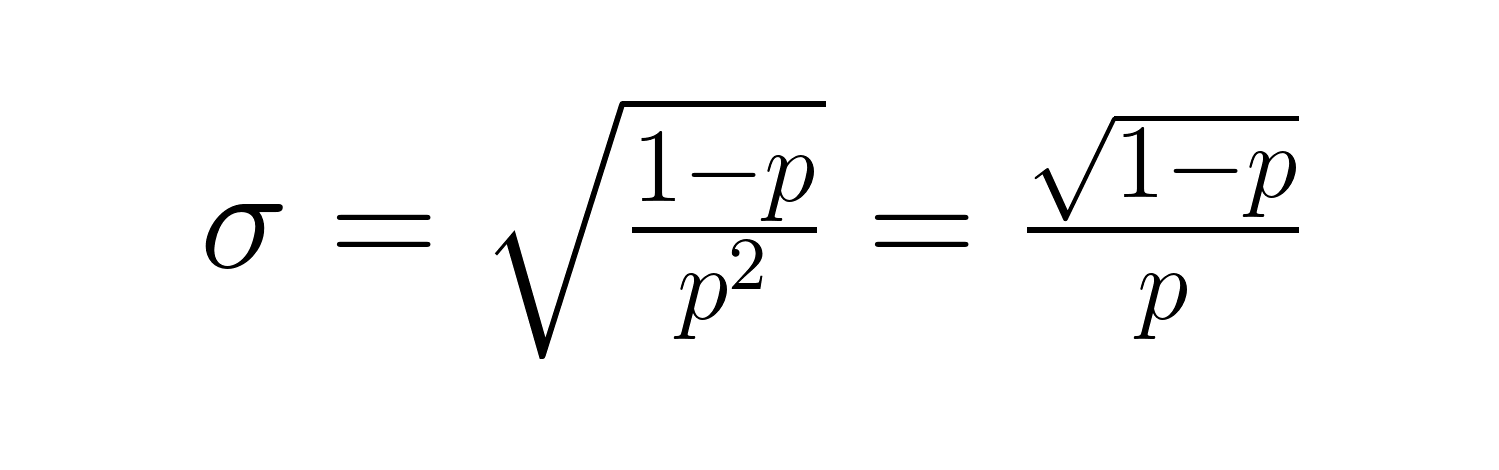
Rumus-rumus ini mengungkap keterkaitan penting: saat p menurun, baik waktu tunggu yang diharapkan maupun variabilitas meningkat secara signifikan. Sebagai contoh, dengan p = 0,2, jumlah percobaan yang diharapkan adalah 5, tetapi dengan p = 0,05, meningkat menjadi 20 percobaan. Varians meningkat jauh lebih drastis, dari 20 menjadi 380.
Untuk analisis lanjutan, moment generating function (MGF) untuk distribusi geometrik adalah:
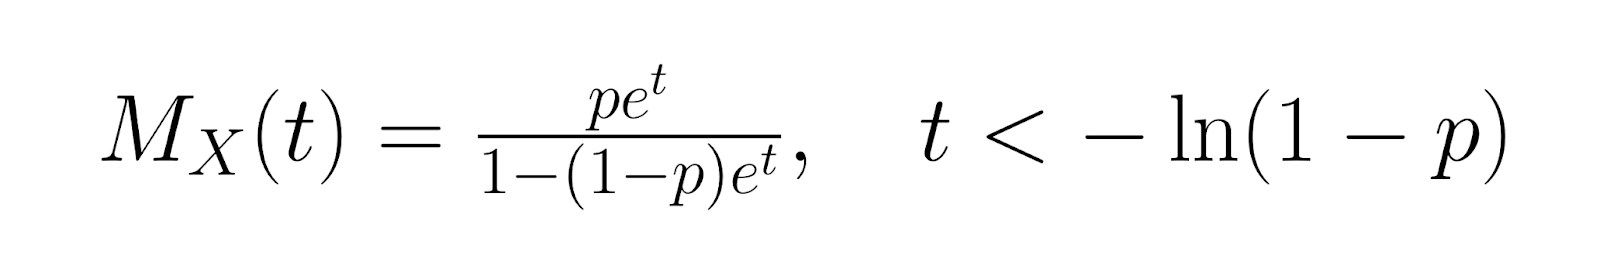 Fungsi pembangkit probabilitas (PGF) adalah:
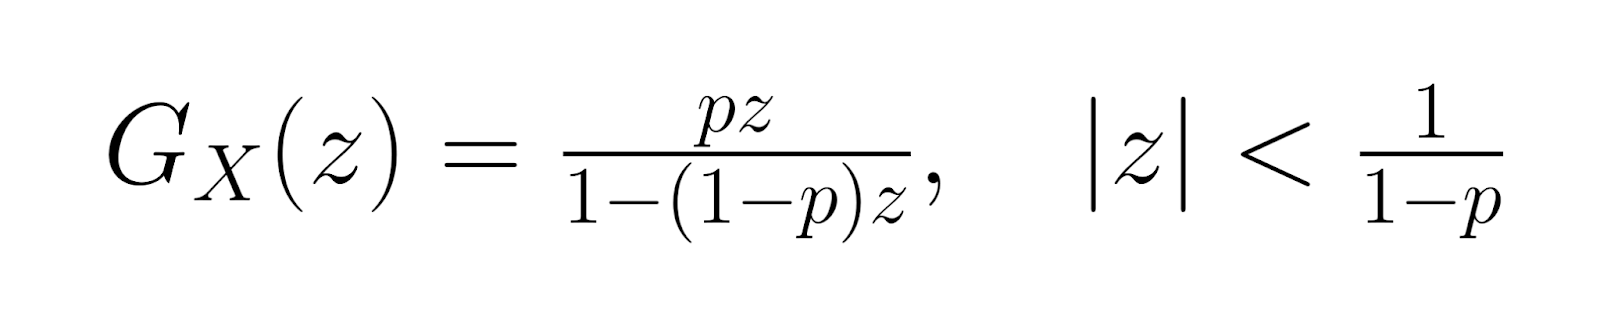
Fungsi-fungsi pembangkit ini membantu analisis statistik tingkat lanjut dan menyediakan metode alternatif untuk menurunkan sifat-sifat distribusi. Momen orde lebih tinggi dapat dihitung menggunakan turunan dari fungsi-fungsi ini, sehingga memungkinkan karakterisasi komprehensif terhadap bentuk dan perilaku distribusi.
Memasuki ranah yang lebih khusus, entropi dari distribusi geometrik bernilai:
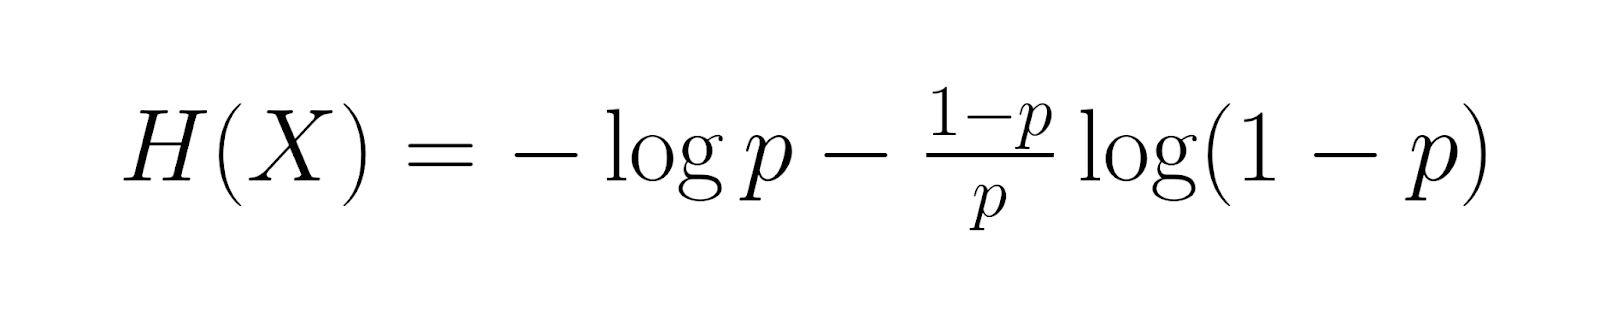
Ini mengukur rata-rata kandungan informasi. Fisher information, yang diberikan oleh:
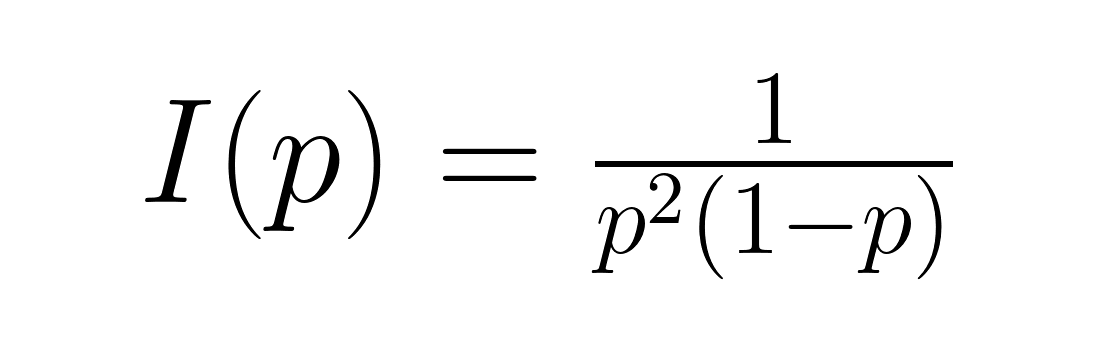
Ini mengkuantifikasi jumlah informasi tentang parameter p yang terkandung dalam data. Ukuran-ukuran ini bermanfaat dalam teori informasi dan perancangan eksperimen optimal, di mana pemahaman kandungan informasi membantu menentukan ukuran sampel dan prosedur estimasi yang tepat.
Mengestimasi probabilitas keberhasilan p dari data observasi memerlukan pemahaman berbagai pendekatan statistik dan komprominya.
Pendekatan maximum likelihood estimation bekerja dengan mencari probabilitas keberhasilan yang membuat data Anda yang teramati paling mungkin terjadi. Untuk menghitung estimasi ini, Anda membagi jumlah kejadian keberhasilan dengan jumlah seluruh percobaan di semua observasi Anda. Estimator ini tidak bias dan bekerja efisien saat menggunakan ukuran sampel besar.
Begini cara kerjanya dalam praktik: jika Anda mengamati keberhasilan setelah masing-masing 3, 7, 2, dan 8 percobaan, Anda akan menghitung MLE dengan mengambil 4 observasi Anda dan membaginya dengan total 20 percobaan (3+7+2+8), sehingga memberikan estimasi probabilitas keberhasilan sebesar 0,2 atau 20%. Pendekatan MLE memaksimalkan kemungkinan mengamati data aktual yang Anda kumpulkan, menjadikannya metode yang paling efisien secara statistik dalam kondisi standar.
Sebagai pendekatan alternatif, estimator metode momen bekerja dengan menyamakan rata-rata sampel Anda dengan rata-rata teoretis distribusi geometrik. Karena rata-rata teoretis sama dengan satu dibagi probabilitas keberhasilan, Anda dapat mengestimasi probabilitas keberhasilan dengan mengambil satu dibagi rata-rata sampel Anda. Meskipun metode ini menawarkan kesederhanaan komputasi dibandingkan MLE, secara statistik bisa kurang efisien dan sesekali dapat menghasilkan estimasi di luar rentang probabilitas yang valid, yakni antara nol hingga satu.
Kedua metode menghasilkan hasil yang serupa saat bekerja dengan sampel besar, tetapi MLE umumnya menawarkan sifat statistik yang lebih unggul. Pilihan di antara metode sering bergantung pada kendala komputasi dan kebutuhan spesifik analisis Anda.
Saat Anda memiliki informasi awal tentang probabilitas keberhasilan, estimasi Bayesian memungkinkan Anda memasukkan pengetahuan ini melalui distribusi probabilitas prior. Distribusi Beta lazim digunakan sebagai prior karena secara matematis cocok dengan data distribusi geometrik. Pendekatan Bayesian menggabungkan keyakinan awal Anda dengan data observasi untuk menghasilkan estimasi parameter yang diperbarui melalui apa yang disebut distribusi posterior.
Keterkaitan matematisnya menghasilkan distribusi Beta yang diperbarui yang menggabungkan baik pengetahuan awal Anda maupun observasi baru. Pendekatan ini sangat efektif saat Anda memiliki data terbatas atau ketika Anda ingin memasukkan pengetahuan pakar tentang proses yang dimodelkan. Misalnya, jika Anda tahu dari pengalaman industri bahwa tingkat keberhasilan biasanya berada dalam rentang tertentu, Anda dapat memasukkan pengetahuan ini untuk meningkatkan estimasi bahkan dengan ukuran sampel kecil.
Distribusi geometrik banyak digunakan di berbagai industri dan konteks analitis di mana pemodelan peristiwa keberhasilan pertama memberikan wawasan.
Proses manufaktur sering menggunakan distribusi geometrik untuk memodelkan deteksi cacat dan analisis kegagalan komponen. Inspektur pengendalian mutu dapat memperkirakan jumlah item yang diinspeksi sebelum menemukan unit cacat pertama, membantu mengoptimalkan prosedur inspeksi dan alokasi sumber daya.
Sebagai contoh, jika data historis menunjukkan tingkat cacat 2%, distribusi geometrik memprediksi rata-rata 50 item diinspeksi sebelum menemukan cacat pertama. Informasi ini membantu menentukan ukuran batch dan frekuensi inspeksi yang tepat untuk menjaga standar kualitas sekaligus meminimalkan biaya.
Tim pemasaran menerapkan distribusi geometrik untuk memodelkan proses konversi pelanggan, memperkirakan berapa banyak kontak atau iklan yang dibutuhkan hingga terjadi penjualan. Analisis ini menginformasikan alokasi anggaran dan keputusan strategi kampanye.
Dalam telekomunikasi, insinyur jaringan menggunakan distribusi geometrik untuk memodelkan tingkat keberhasilan transmisi paket dan mengoptimalkan mekanisme pengulangan. Memahami jumlah percobaan transmisi yang diharapkan membantu merancang protokol yang efisien dan meningkatkan kinerja jaringan secara keseluruhan.
Analis olahraga menggunakan distribusi geometrik untuk memodelkan peristiwa pencetakan skor, seperti jumlah percobaan yang dibutuhkan seorang pemain basket untuk memasukkan tembakan tiga angka pertamanya dalam sebuah pertandingan. Analisis ini berkontribusi pada pengambilan keputusan strategis dan evaluasi kinerja.
Aplikasi gim mencakup pemodelan jumlah upaya yang diperlukan untuk mencapai peristiwa langka atau menyelesaikan level yang menantang. Platform daring menggunakan wawasan ini untuk menyeimbangkan tingkat kesulitan gim dan menjaga keterlibatan pemain melalui struktur hadiah yang tepat.
Pertimbangkan skenario di mana sebuah kampanye pemasaran memiliki tingkat konversi 15%. Untuk mencari probabilitas mendapatkan konversi pertama pada kontak ke-5: P(X = 5) = (0,85)⁴ × 0,15 = 0,0783 atau sekitar 7,83%.
Untuk latihan, hitung probabilitas bahwa seorang inspektur pengendalian mutu menemukan item cacat pertama dalam 10 inspeksi pertama, dengan tingkat cacat 8%. Gunakan rumus CDF: P(X ≤ 10) = 1 - (0,92)¹⁰ = 0,5656 atau sekitar 56,56%.
Memahami kapan distribusi geometrik diterapkan dengan tepat memerlukan pengenalan terhadap asumsi-asumsi dasarnya dan potensi keterbatasannya.
Distribusi geometrik mengasumsikan percobaan yang independen dengan probabilitas keberhasilan konstan, yang mungkin tidak terpenuhi dalam banyak skenario dunia nyata. Misalnya, perilaku pelanggan sering menunjukkan ketergantungan—interaksi sebelumnya dapat memengaruhi probabilitas konversi di masa depan. Demikian pula, sistem mekanis dapat mengalami keausan yang mengubah laju kegagalan dari waktu ke waktu.
Pelanggaran terhadap asumsi-asumsi ini dapat menyebabkan prediksi yang tidak akurat dan pengambilan keputusan yang buruk. Praktisi data harus memvalidasi asumsi independensi melalui pengujian statistik dan mempertimbangkan model alternatif saat ketergantungan terdeteksi. Alternatif umum mencakup distribusi binomial negatif untuk data yang mengalami overdispersi atau model rantai Markov untuk percobaan yang saling bergantung.
Memahami distribusi geometrik melampaui pengetahuan teoretis—ini memungkinkan Anda membuat keputusan yang tepat tentang alokasi sumber daya, optimalisasi proses, dan penilaian risiko. Baik Anda merancang prosedur pengendalian mutu maupun mengoptimalkan kampanye pemasaran, distribusi ini menawarkan wawasan kuantitatif yang mendorong hasil yang lebih baik.
Untuk pembelajaran lanjutan, jelajahi kursus Multivariate Probability Distributions in R kami untuk memahami bagaimana distribusi geometrik berhubungan dengan model probabilitas lainnya, atau dalami teknik estimasi dengan kursus Generalized Linear Models in R untuk aplikasi pemodelan tingkat lanjut.
Belajar bersama DataCamp
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt



