
Kurs
R ile Olasılığın Temelleri
4 sa
42.9K
Hayalinizdeki pozisyonu kapmadan önce kaç iş görüşmesine girmeniz gerekebilir? Bir pazarlama kampanyasının ilk satışını gerçekleştirmesi kaç deneme alır? Geometrik dağılım, ilk başarının gerçekleşmesine kadar gereken deneme sayısını modelleyerek bu "bekleme süresi" sorularını yanıtlar.
Bu rehber, geometrik dağılımın matematiksel temelini, ayırt edici özelliklerini ve ardışık deneme senaryolarıyla çalışanlar için değerli kılan pratik uygulamalarını kapsar. Olasılık dağılımlarıyla ilgili kısa bir hatırlatma için Introduction to Statistics kursumuzu gözden geçirebilirsiniz.
Geometrik dağılım, ilk başarıya ulaşmak için gereken bağımsız Bernoulli denemelerinin sayısını modelleyen ayrık bir olasılık dağılımıdır. Her denemenin başarı olasılığı aynıdır ve denemeler birbirinden bağımsızdır.
Bu dağılımın iki yaygın biçimi vardır: biri ilk başarıya kadar (başarı dahil) toplam deneme sayısını sayar, diğeri ise ilk başarıdan önceki başarısızlık sayısını sayar. Her iki biçim de uygulama bağlamına göre yaygın şekilde kullanılır. Bu rehber boyunca, ilk başarıya kadar toplam deneme sayısını sayan ilk biçimi kullanacağız; burada X, 1, 2, 3, vb. değerler alabilir.
Bu dağılımı tanımlayan matematiksel yapıyı ve özellikleri inceleyelim.
Geometrik dağılım üç temel koşul gerektirir: bağımsız denemeler, tüm denemelerde özdeş başarı olasılığı ve 0 < p ≤ 1 olacak şekilde sabit bir p olasılığı. Standart gösterimde, başarı olasılığı için p ve başarısızlık olasılığı için q = 1-p kullanılır.
İlk başarıya kadar deneme sayısı X için olasılık kütle fonksiyonu (PMF) şöyledir:
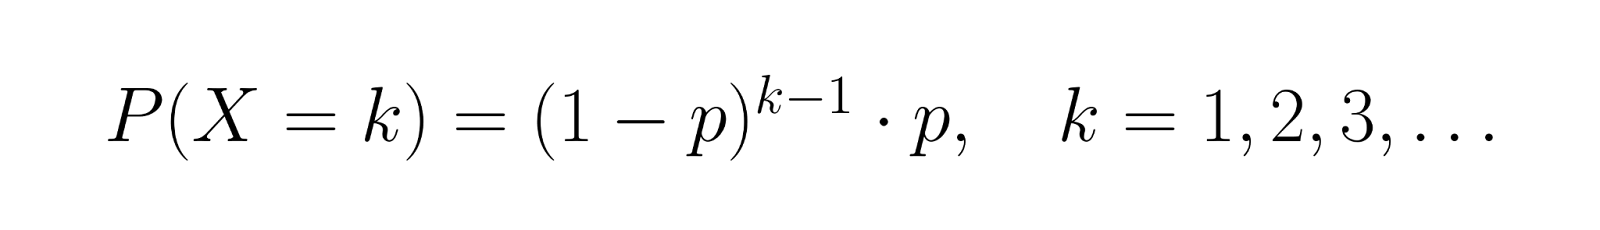
Bu formül, tam olarak k-1 başarısızlık yaşandıktan sonra bir başarı elde edilmesi olasılığını hesaplar. Örneğin, p = 0.3 ise, üçüncü denemede başarı olasılığı P(X = 3) = (0.7)² × 0.3 = 0.147'dir.
Kümülatif dağılım fonksiyonu (CDF) bize şunu verir:
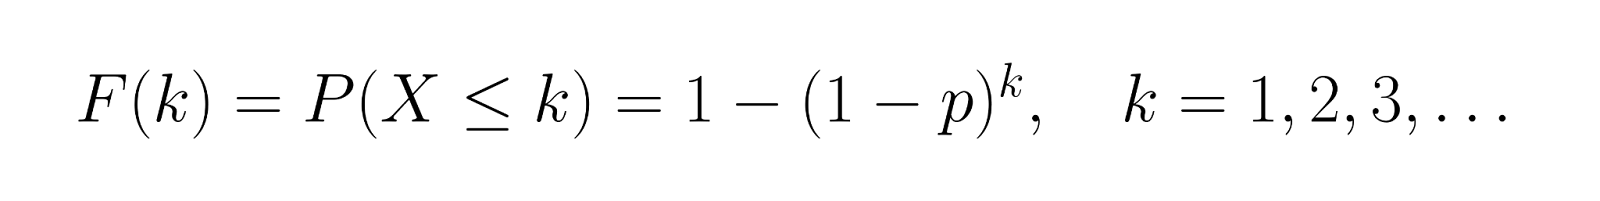
Bu, k deneme içinde başarı elde etme olasılığını temsil eder. p = 0.3 olan örneğimizde, ilk birkaç değer için CDF'yi hesaplayalım:
Bu, ilk denemede başarı şansının %30, ilk iki deneme içinde başarı şansının %51 ve ilk üç deneme içinde başarı şansının %65,7 olduğunu gösterir.
Geometrik dağılımın görsel desenleri, "bekleme süresi" senaryoları hakkında kilit içgörüler sunar. Bu grafikler, olasılığın nasıl erken denemelerde yoğunlaştığını ve üstel olarak azaldığını gösterir; bu da dağılımı, başarının daha çok erken gerçekleştiği durumları modellemek için kullanışlı kılar.
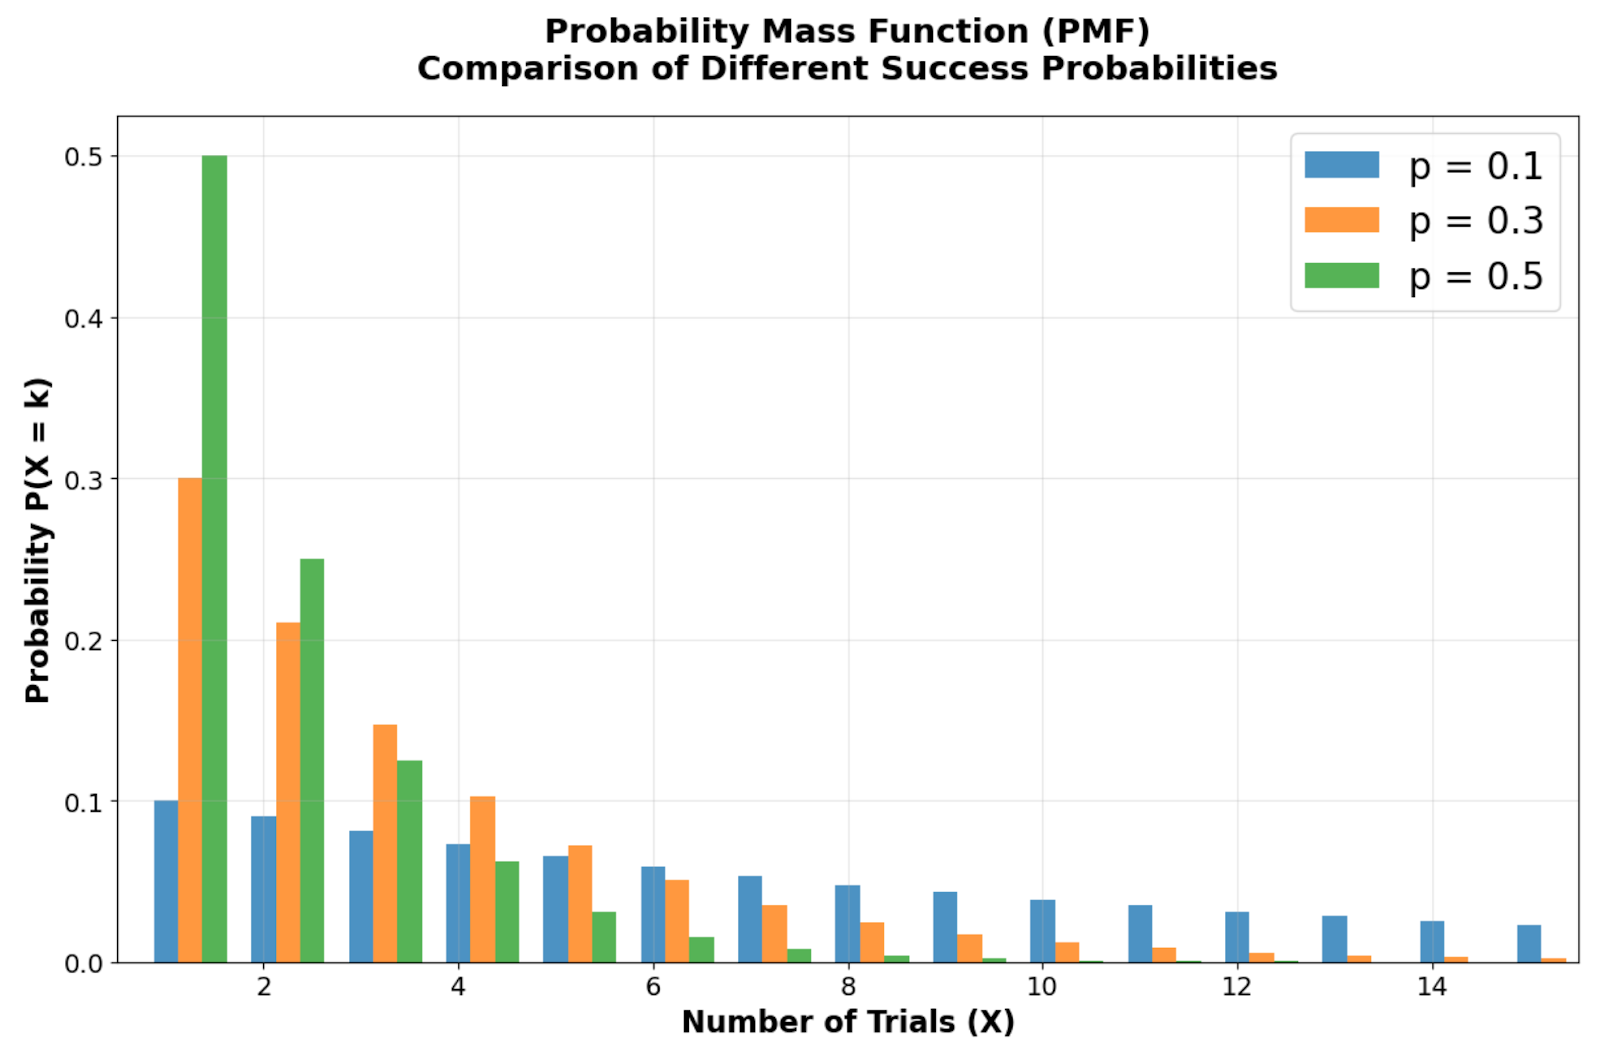
Farklı başarı olasılıklarının (p = 0.1, 0.3, 0.5) dağılım şeklini nasıl etkilediğini gösteren Olasılık Kütle Fonksiyonu karşılaştırması. Görsel: Yazar
Farklı başarı olasılıkları boyunca olasılık kütle fonksiyonu karşılaştırmasına bakıldığında, geometrik dağılımın modu her zaman X = 1'de (ilk deneme) olan kendine özgü sağa çarpık şeklini görebilirsiniz. Olasılık çubuklarının ilk denemede en yüksekten başladığına ve sonraki her deneme için geometrik olarak azaldığına dikkat edin. Başarı olasılığı p azaldıkça dağılım daha fazla yayılır; bu da daha uzun bekleme sürelerini yansıtır. Örneğin, p = 0.1 ile anında başarı şansı yalnızca %10'dur ve bu, p = 0.5'e kıyasla daha belirgin bir sağ kuyruğa yol açar.
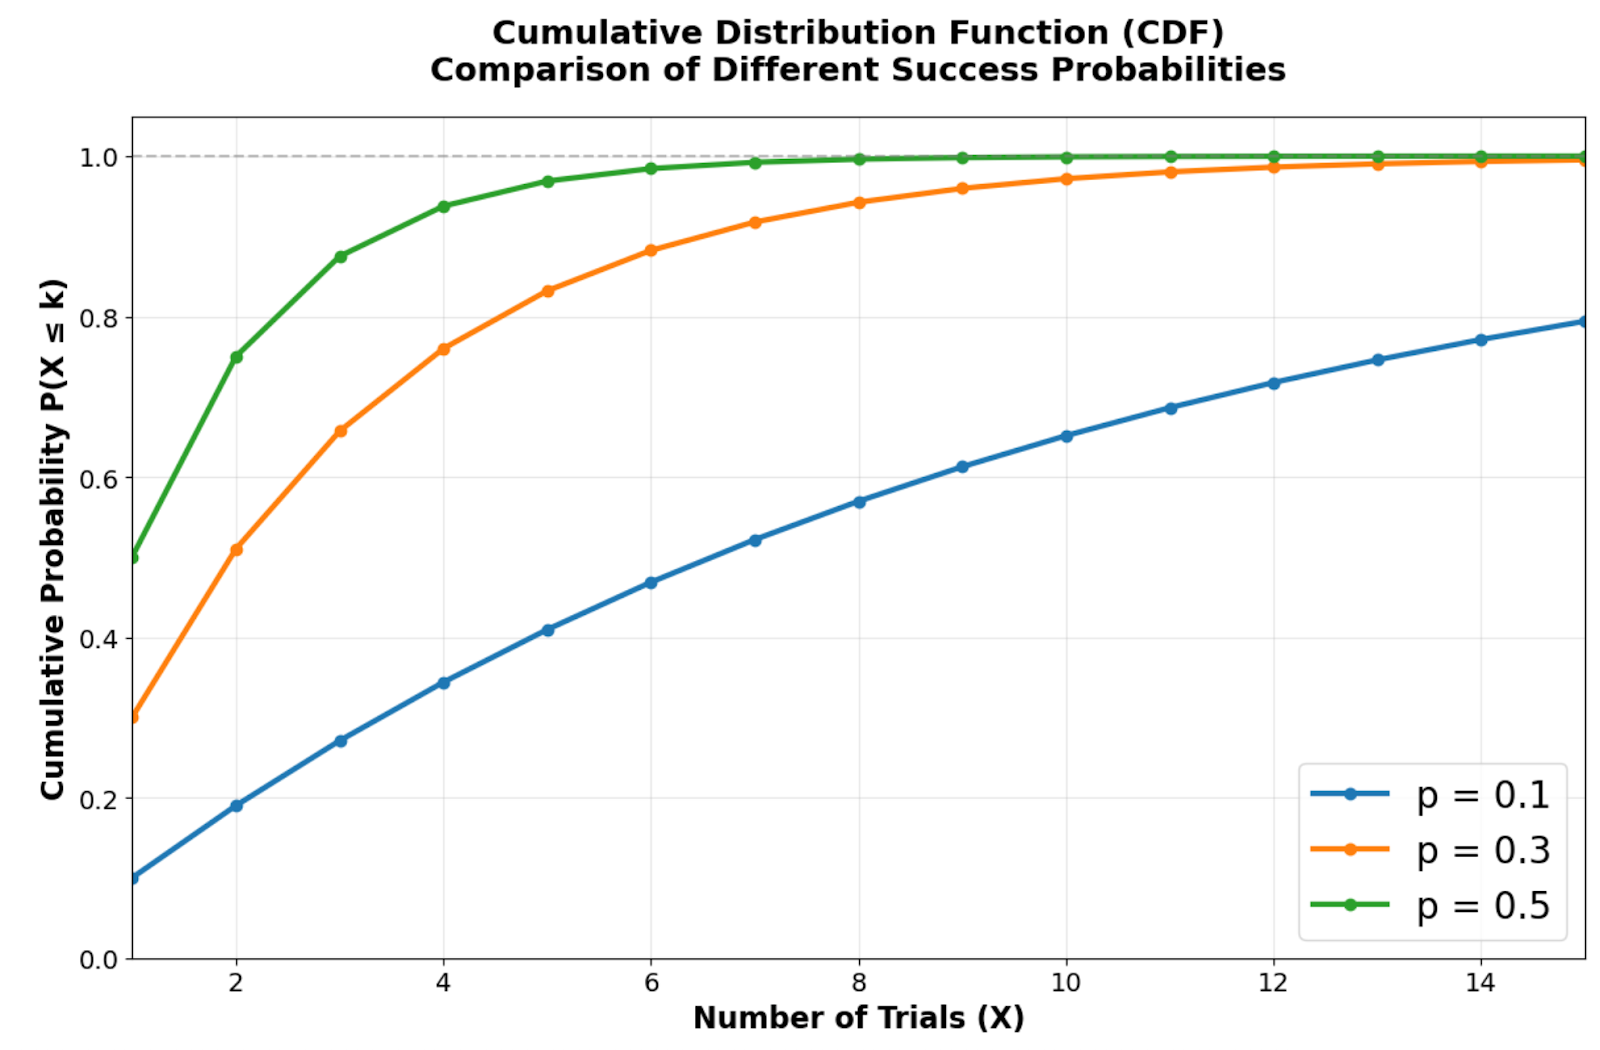
Farklı başarı olasılıklarının kesinliğe ne kadar hızlı yaklaştığını gösteren Kümülatif Dağılım Fonksiyonu. Görsel: Yazar.
Kümülatif dağılım fonksiyonu, geometrik dağılımın kesinliğe ne kadar hızlı yaklaştığını gösterir. Daha yüksek başarı olasılıkları, yalnızca birkaç deneme içinde yüksek kümülatif olasılıklara ulaşan daha dik eğriler oluşturur. Örneğin, p = 0.5 ile ilk iki deneme içinde başarı şansı yaklaşık %75'tir; oysa p = 0.1 aynı kesinlik düzeyine ulaşmak için önemli ölçüde daha fazla deneme gerektirir.

PMF'deki üstel azalma desenini ve CDF'de kesinliğe hızlı yaklaşımı vurgulayan yan yana karşılaştırma. Görsel: Yazar.
Bu üstel azalma deseni, geometrik dağılımın, erken başarının uzun bekleme dönemlerine göre daha olası olduğu senaryoları modellemede neden iyi çalıştığını açıklar. CDF'nin 1'e doğru hızla yükselmesi, bekleme sürelerinin kısa olduğu süreçleri modellemede neden etkili olduğunu gösterir; bu da kalite kontrolü, müşteri dönüşüm analizi ve güvenilirlik testi senaryoları için değerli kılar.
Bu görselleştirmeleri Python'un scipy ve matplotlib kütüphanelerini kullanarak yeniden oluşturabilir ve farklı parametre değerlerini keşfedebilirsiniz. Geometrik dağılımın en önemli özelliklerini vurgulayan temel görsel içgörüleri şöyle üretebilirsiniz:
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

# Create side-by-side plots for PMF and CDF
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(16, 6))
fig.suptitle('Geometric Distribution: Key Visual Insights', fontsize=24, fontweight='bold')

# Simple PMF showing exponential decay (using p = 0.3)
x_simple = np.arange(1, 11)
pmf_simple = stats.geom.pmf(x_simple, 0.3)

ax1.bar(x_simple, pmf_simple, alpha=0.8, color='steelblue', edgecolor='black', linewidth=1)
ax1.set_title('PMF: Exponential Decay Pattern', fontsize=18, fontweight='bold', pad=15)
ax1.set_xlabel('Number of Trials (X)', fontsize=17, fontweight='bold')
ax1.set_ylabel('Probability', fontsize=14, fontweight='bold')
ax1.grid(True, alpha=0.3)
ax1.tick_params(axis='both', which='major', labelsize=14)

# Simple CDF showing approach to 1
cdf_simple = stats.geom.cdf(x_simple, 0.3)

ax2.plot(x_simple, cdf_simple, 'o-', linewidth=4, markersize=8, color='darkgreen')
ax2.set_title('CDF: Rapid Approach to Certainty', fontsize=18, fontweight='bold', pad=15)
ax2.set_xlabel('Number of Trials (X)', fontsize=17, fontweight='bold')
ax2.set_ylabel('Cumulative Probability', fontsize=14, fontweight='bold')
ax2.grid(True, alpha=0.3)
ax2.set_ylim(0, 1.05)
ax2.tick_params(axis='both', which='major', labelsize=14)

plt.tight_layout()
plt.show()
Bu kod, geometrik dağılımın iki en önemli görsel özelliğini vurgulayan odaklı bir görselleştirme oluşturur. Sol panel, olasılıkların ilk denemeden itibaren üstel olarak nasıl azaldığını, sağ panel ise CDF'de olasılık kütlesinin nasıl hızla biriktiğini gösterir.
Başarı olasılığını 0.3'ten 0.1 veya 0.7 gibi farklı değerlere değiştirerek dağılım şeklinin nasıl değiştiğini görün. Daha düşük olasılıklar daha düz PMF eğrileri ve daha yavaş yükselen CDF'ler oluştururken, daha yüksek olasılıklar daha dik düşüşler ve kesinliğe daha hızlı yaklaşım üretir.
Geometrik dağılımı, çoğu diğer ayrık dağılımdan ayıran benzersiz bir özelliği vardır.
Belleksizlik özelliği, herhangi bir pozitif tamsayı s ve t için P(X > s + t | X > s) = P(X > t) olduğunu söyler. Bu, ek denemelere ihtiyaç duyma olasılığının, halihazırda gerçekleşmiş başarısız deneme sayısına bağlı olmadığı anlamına gelir.
Matematiksel olarak, bu özellik P(X > k) = (1-p)k olduğundan ortaya çıkar ve koşullu olasılık hesabını kolaylaştırır. Pratikte, diyelim ki beş başarısız iş görüşmesi yaptınız; gelecekteki görüşmeler için olasılık dağılımı, başladığınız zamankiyle aynıdır—geçmiş başarısızlıklar gelecekteki olasılıkları etkilemez.
Geometrik bir deneydeki her deneme, sabit başarı olasılığı p olan bağımsız bir Bernoulli denemesini temsil eder. Geometrik dağılım, ilk başarıya kadar bu denemelerin dizisini modelleyerek "bekleme süresi" problemlerinin ayrık karşılığı olur.
Bu ilişki, geometrik dağılımın kalite kontrolde neden sıkça karşımıza çıktığını açıklar; burada test edilen her birim bir Bernoulli denemesini temsil eder ve biz ilk kusurlu ürünü tespit etmekle ilgileniriz. Bağımsızlık varsayımı, erken testlerde kusurlu ürün bulunmasının sonraki testlerde kusur bulma olasılığını değiştirmemesini sağlar.
Eüstel dağılım, belleksizlik özelliğini paylaşan geometrik dağılımın sürekli karşılığıdır. Geometrik dağılım ayrık bekleme sürelerini (deneme sayısı) modellediği halde, üstel dağılım sürekli bekleme sürelerini (bir olaya kadar geçen zaman) modeller.
Her iki dağılım da güvenilirlik analizi ve kuyruk kuramında uygulama bulur. Örneğin, geometrik dağılım ilk arızaya kadar geçen istek sayısını modelleyebilirken, üstel dağılım bir sonrakı sunucu arızasına kadar geçen zamanı modeller.
Temel kavramlar ve benzersiz özellikler yerli yerine oturduğuna göre, kesin olasılık hesaplamalarını ve bilinçli karar almayı mümkün kılan matematiksel araçları inceleyelim. Bu formüller ve ilişkiler, geometrik dağılımı gerçek dünya problemlerine uygularken vazgeçilmezdir.
Geometrik dağılımın beklenen değeri (ortalaması) şöyledir:
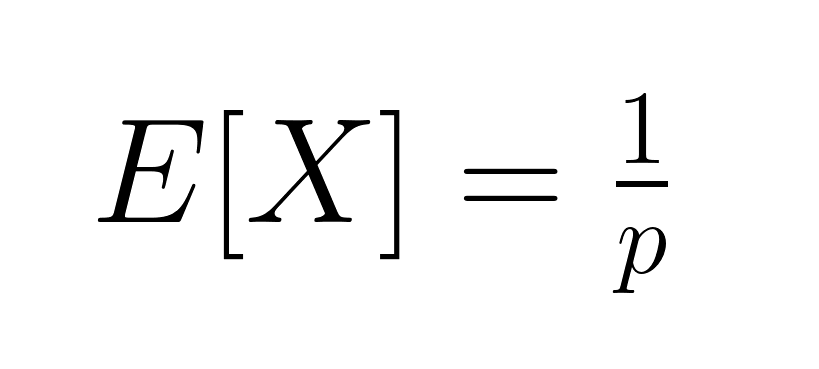
Bu, başarı için gereken ortalama deneme sayısını temsil eder. Varyans ise şöyledir:
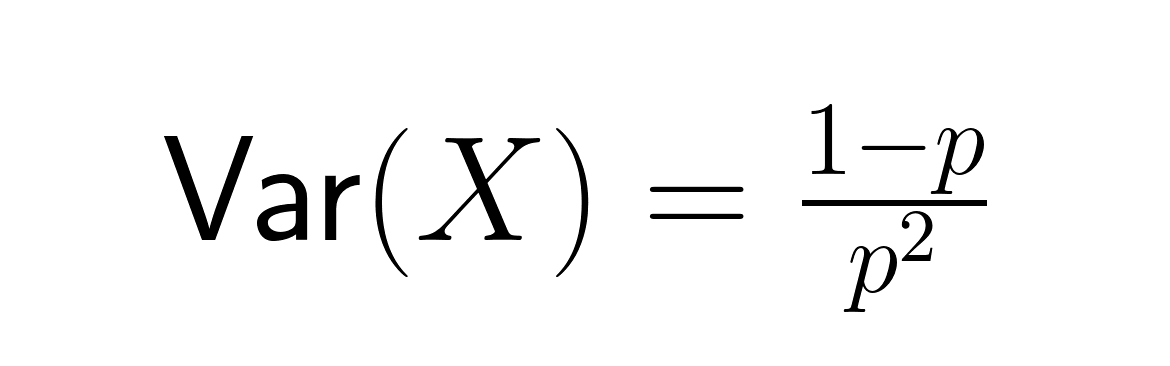
Standart sapma ise şöyledir:
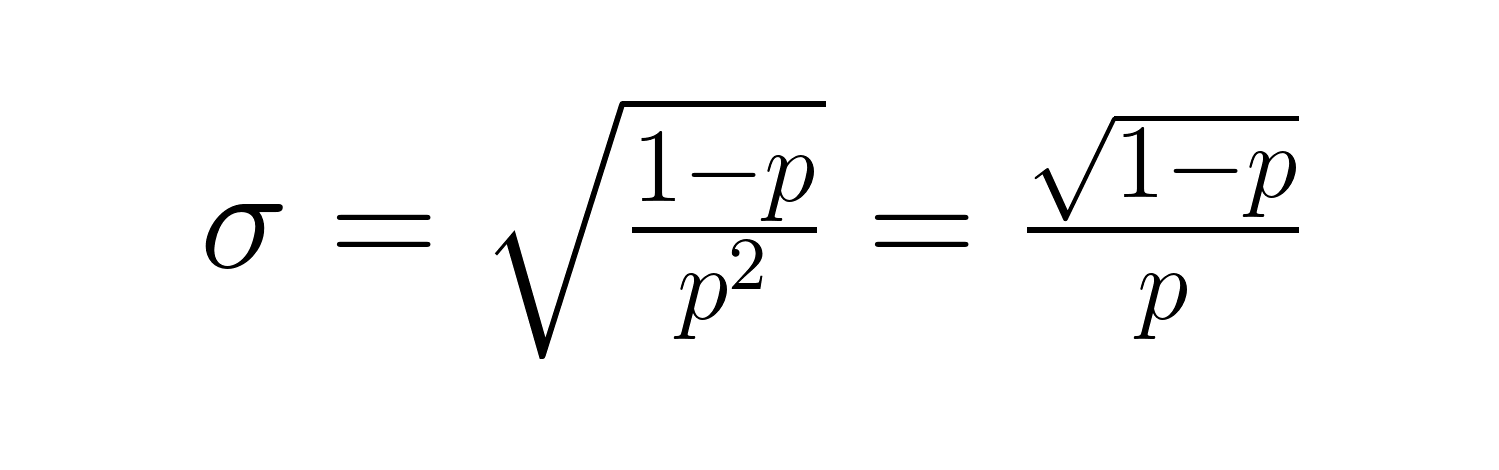
Bu formüller önemli ilişkileri ortaya koyar: p azaldıkça hem beklenen bekleme süresi hem de değişkenlik kayda değer biçimde artar. Örneğin, p = 0.2 iken beklenen deneme sayısı 5'tir; p = 0.05 olduğunda ise 20 denemeye çıkar. Varyans ise daha da dramatik biçimde 20'den 380'e yükselir.
Daha ileri analiz için, geometrik dağılımın moment üreten fonksiyonu (MGF) şöyledir:
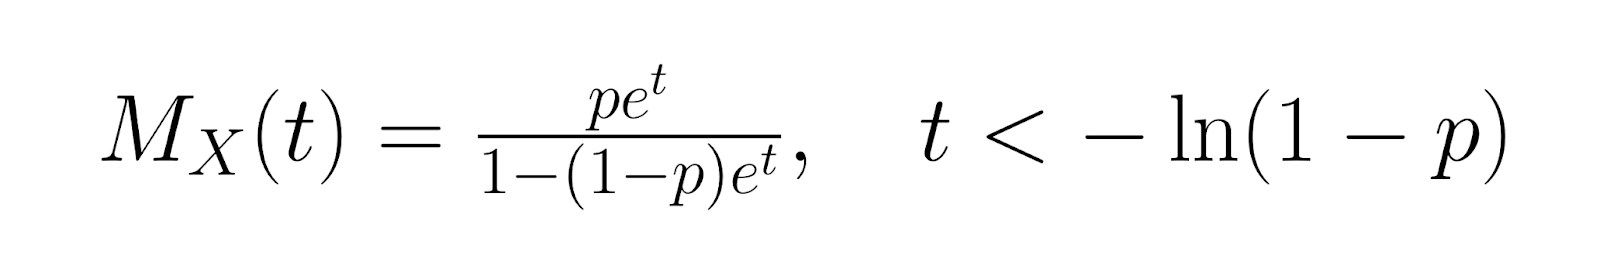 Olasılık üreten fonksiyon (PGF) ise şöyledir:
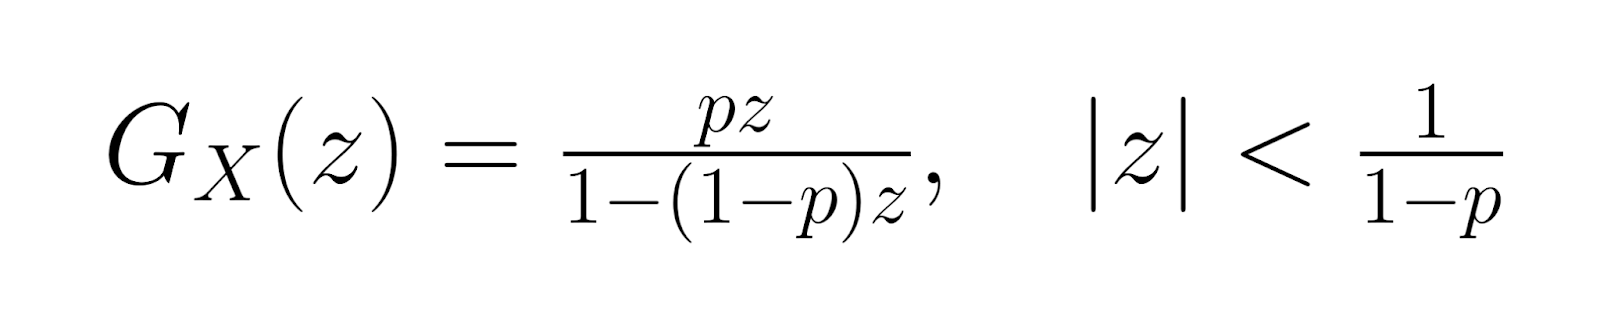
Bu üreten fonksiyonlar, gelişmiş istatistiksel analizlerde yardımcı olur ve dağılım özelliklerini türetmek için alternatif yöntemler sunar. Daha yüksek dereceden momentler bu fonksiyonların türevleri kullanılarak hesaplanabilir; bu da dağılımın şeklinin ve davranışının kapsamlı şekilde karakterize edilmesini sağlar.
Daha uzmanlaşmış bir alana geçersek, geometrik dağılımın entropisi şöyledir:
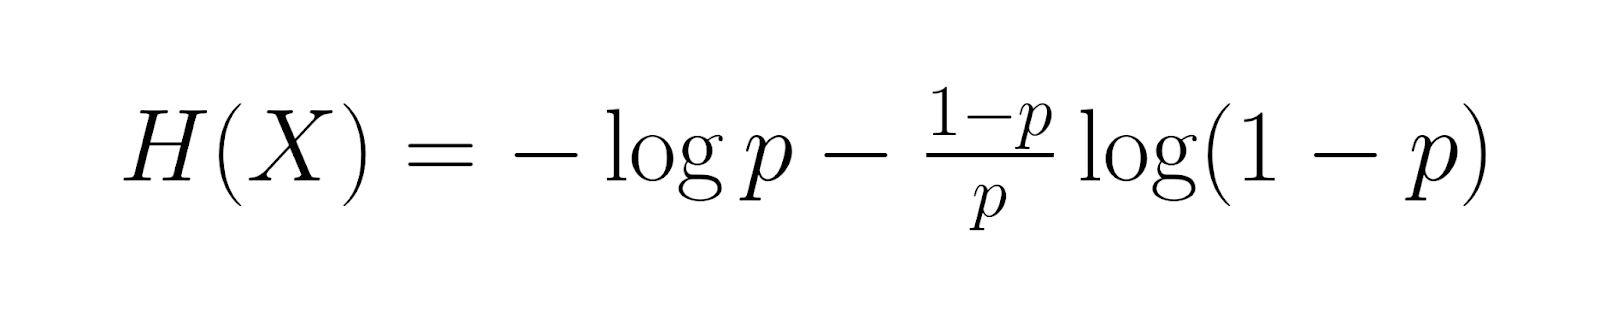
Bu, ortalama bilgi içeriğini ölçer. Fisher bilgisi ise şöyledir:
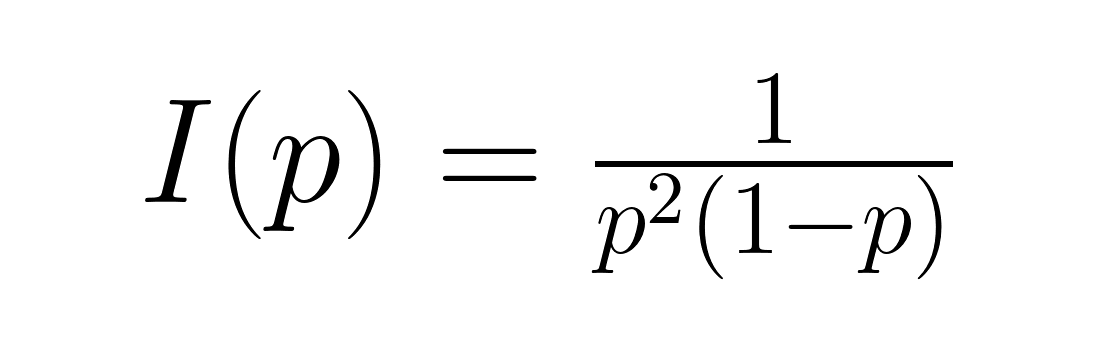
Bu, veride parametre p hakkında bulunan bilgi miktarını niceler. Bu ölçüler, bilgi kuramı uygulamalarında ve örneklem büyüklüklerinin ve tahmin prosedürlerinin belirlenmesine yardımcı olan en uygun deneysel tasarım çalışmalarında değer taşır.
Gözlemlenen verilerden başarı olasılığı p'yi tahmin etmek, farklı istatistiksel yaklaşımları ve bunların ödünleşimlerini anlamayı gerektirir.
En çok olabilirlik tahmini yaklaşımı, gözlemlediğiniz verileri en olası kılan başarı olasılığını bularak çalışır. Bu tahmini hesaplamak için, başarı olaylarının toplam sayısını gözlemlerinizdeki tüm denemelerin toplamına bölersiniz. Bu tahmin edici, önyargısız sonuçlar verir ve büyük örneklemlerle çalışırken verimli performans sergiler.
Bu uygulamada şöyle işler: sırasıyla 3, 7, 2 ve 8 denemeden sonra başarı gözlerseniz, 4 gözleminizi 20 denemenin toplamına (3+7+2+8) bölerek MLE'yi hesaplarsınız; bu da 0.2 veya %20'lik bir başarı olasılığı tahmini verir. MLE yaklaşımı, topladığınız gerçek verileri gözlemleme olasılığını en üst düzeye çıkarır ve standart koşullar altında en istatistiksel olarak verimli yöntemdir.
Alternatif bir yaklaşım olarak, momentler yöntemi tahmin edicisi, örnek ortalamanızı geometrik dağılımın teorik ortalamasına eşitleyerek çalışır. Teorik ortalama başarı olasılığının bire bölümü olduğundan, başarı olasılığını, bire örnek ortalamanızın bölümünü alarak tahmin edebilirsiniz. Bu yöntem, MLE'ye kıyasla hesaplama sadeliği sunsa da istatistiksel olarak daha az verimli olabilir ve zaman zaman sıfır ile bir arasındaki geçerli olasılık aralığının dışında tahminler üretebilir.
Her iki yöntem de büyük örneklemlerle çalışırken benzer sonuçlar üretir; ancak MLE genellikle üstün istatistiksel özellikler sunar. Yöntemler arasındaki seçim çoğu zaman hesaplama kısıtlarına ve analizinizin özel gereksinimlerine bağlıdır.
Elinizde başarı olasılığı hakkında öncül bilgi olduğunda, Bayesçi tahmin bu bilgiyi bir öncül olasılık dağılımı aracılığıyla dahil etmenize olanak tanır. Beta dağılımı, geometrik dağılım verileriyle matematiksel olarak iyi çalıştığı için yaygın olarak bu öncül olarak kullanılır. Bayes yaklaşımı, öncül inançlarınızı ve gözlemlenen verileri, artık dağılım (posterior) denilen şey aracılığıyla güncellenmiş parametre tahminleri üretmek üzere birleştirir.
Bu matematiksel ilişki, hem öncül bilginizi hem de yeni gözlemlerinizi içeren güncellenmiş bir Beta dağılımı oluşturur. Bu yaklaşım, verinizin sınırlı olduğu durumlarda veya modellenen süreçle ilgili uzman bilgisini dahil etmek istediğinizde özellikle iyi çalışır. Örneğin, sektör deneyiminden başarı oranlarının tipik olarak belirli bir aralıkta olduğunu biliyorsanız, bu bilgiyi küçük örneklemlerde bile tahminlerinizi iyileştirmek için kullanabilirsiniz.
Geometrik dağılım, ilk başarı olaylarını modellemenin içgörü sunduğu çeşitli sektörlerde ve analitik bağlamlarda yaygın şekilde kullanılır.
Üretim süreçleri, kusur tespiti ve bileşen arıza analizini modellemek için sıklıkla geometrik dağılımı kullanır. Kalite kontrol müfettişleri, kusurlu bir birim bulmadan önce incelenmesi beklenen ürün sayısını tahmin ederek denetim prosedürlerini ve kaynak tahsisini optimize edebilir.
Örneğin, tarihsel veriler %2'lik bir kusur oranı gösteriyorsa, geometrik dağılım ilk kusuru bulmadan önce ortalama 50 ürün inceleneceğini öngörür. Bu bilgi, kalite standartlarını korurken maliyetleri en aza indirmek için uygun parti boyutlarının ve denetim sıklıklarının belirlenmesine yardımcı olur.
Pazarlama ekipleri, müşteri dönüşüm süreçlerini modellemek için geometrik dağılımı uygular; bir satış elde edilmeden önce kaç temas veya reklam gerektiğini tahmin eder. Bu analiz, bütçe tahsisi ve kampanya stratejisi kararlarını bilgilendirir.
Telekomünikasyonda ise ağ mühendisleri, paket iletim başarı oranlarını modellemek ve yeniden deneme mekanizmalarını optimize etmek için geometrik dağılımı kullanır. Beklenen iletim denemesi sayısını anlamak, verimli protokoller tasarlamaya ve genel ağ performansını iyileştirmeye yardımcı olur.
Spor analistleri, örneğin bir basketbol oyuncusunun bir maçta ilk üç sayılık isabetini bulması için gereken deneme sayısı gibi skor olaylarını modellemek için geometrik dağılımı kullanır. Bu analiz, stratejik karar almaya ve performans değerlendirmesine katkı sağlar.
Oyun uygulamaları arasında, nadir olaylara ulaşmak veya zorlu seviyeleri tamamlamak için gereken deneme sayısının modellenmesi bulunur. Çevrimiçi platformlar, bu içgörüleri oyun zorluğunu dengelemek ve uygun ödül yapılarıyla oyuncu etkileşimini sürdürmek için kullanır.
Bir pazarlama kampanyasının %15'lik bir dönüşüm oranına sahip olduğu bir senaryoyu düşünün. İlk dönüşümü 5. temasta elde etme olasılığını bulmak için: P(X = 5) = (0.85)⁴ × 0.15 = 0.0783 veya yaklaşık %7.83.
Alıştırma için, kusur oranının %8 olduğu durumda, bir kalite kontrol müfettişinin ilk 10 inceleme içinde ilk kusurlu ürünü bulma olasılığını hesaplayın. CDF formülünü kullanın: P(X ≤ 10) = 1 - (0.92)¹⁰ = 0.5656 veya yaklaşık %56.56.
Geometrik dağılımın ne zaman uygun şekilde uygulanacağını anlamak, altta yatan varsayımları ve potansiyel sınırlamaları tanımayı gerektirir.
Geometrik dağılım, sabit başarı olasılığına sahip bağımsız denemeleri varsayar; bu, birçok gerçek dünya senaryosunda geçerli olmayabilir. Örneğin, müşteri davranışı sıklıkla bağımlılık gösterir—önceki etkileşimler gelecekteki dönüşüm olasılıklarını etkileyebilir. Benzer şekilde, mekanik sistemler zamanla arıza oranlarını değiştiren aşınma yaşayabilir.
Bu varsayımların ihlali, yanlış öngörülered ve kötü karar almaya yol açabilir. Veri uygulayıcıları, bağımsızlık varsayımlarını istatistiksel testlerle doğrulamalı ve bağımlılıklar tespit edildiğinde alternatif modelleri düşünmelidir. Yaygın alternatifler arasında aşırı saçılım gösteren veriler için negatif binom dağılımı veya bağımlı denemeler için Markov zinciri modelleri bulunur.
Geometrik dağılımı anlamak, teorik bilginin ötesine geçer—kaynak tahsisi, süreç optimizasyonu ve risk değerlendirmesi hakkında bilinçli kararlar almanızı sağlar. İster kalite kontrol prosedürleri tasarlıyor olun ister pazarlama kampanyalarını optimize ediyor olun, bu dağılım daha iyi sonuçları tetikleyen nicel içgörüler sunar.
Öğrenmeye devam etmek için, geometrik dağılımın diğer olasılık modelleriyle nasıl ilişkili olduğunu anlamak üzere Multivariate Probability Distributions in R kursumuzu keşfedin veya ileri düzey modelleme uygulamaları için tahmin tekniklerine daha derinlemesine girmek üzere Generalized Linear Models in R kursumuza dalın.
DataCamp ile öğrenin
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



