
Cursus
Basis van kansrekening in R
4 uur
42.9K
Hoeveel sollicitatiegesprekken heb je nodig voordat je je droombaan binnensleept? Hoeveel pogingen zijn er nodig voordat een marketingcampagne de eerste verkoop oplevert? De geometrische verdeling beantwoordt dit soort vragen over "wachttijd" door het aantal pogingen te modelleren dat nodig is tot het eerste succes plaatsvindt.
Deze gids behandelt de wiskundige basis van de geometrische verdeling, de onderscheidende eigenschappen en praktische toepassingen die haar waardevol maken voor iedereen die met scenario's van opeenvolgende pogingen werkt. Heb je een opfrisser nodig over kansverdelingen? Volg dan onze cursus Introduction to Statistics.
De geometrische verdeling is een discrete kansverdeling die het aantal onafhankelijke Bernoulli-pogingen modelleert dat nodig is om het eerste succes te behalen. Elke poging heeft dezelfde kans op succes, en pogingen zijn onafhankelijk van elkaar.
Deze verdeling komt in twee gangbare vormen: één die het totale aantal pogingen telt tot het eerste succes (inclusief het succes), en één die alleen het aantal mislukkingen telt vóór het eerste succes. Beide vormen worden veel gebruikt, afhankelijk van de toepassingscontext. In deze gids gebruiken we de eerste vorm, waarin we het totale aantal pogingen tellen tot het eerste succes, waarbij X de waarden 1, 2, 3, enzovoort kan aannemen.
Laten we de wiskundige structuur en kenmerken bekijken die deze verdeling definiëren.
De geometrische verdeling vereist drie kernvoorwaarden: onafhankelijke pogingen, identieke succeskans voor alle pogingen, en een vaste kans p waarbij 0 < p ≤ 1. In de standaardnotatie staat p voor de succeskans en q = 1-p voor de kans op mislukking.
De kansmassafunctie (PMF) voor het aantal pogingen X tot het eerste succes is:
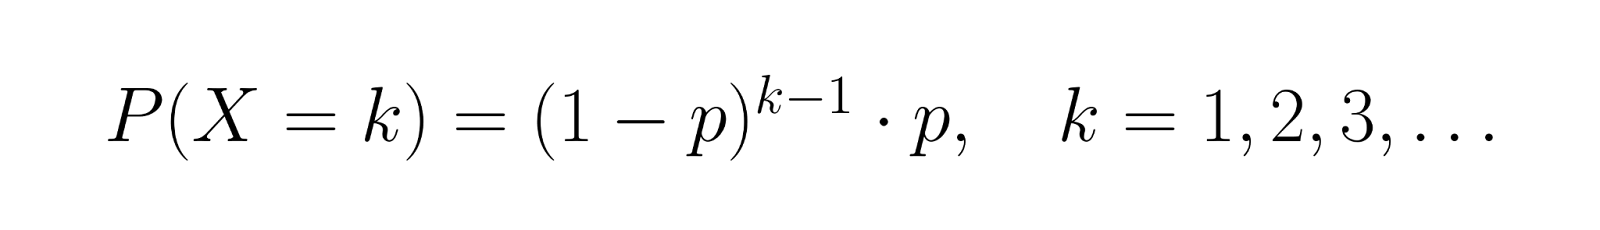
Deze formule berekent de kans op precies k-1 mislukkingen gevolgd door één succes. Bijvoorbeeld, als p = 0.3, dan is de kans op succes bij de derde poging P(X = 3) = (0,7)² × 0,3 = 0,147.
De cumulatieve verdelingsfunctie (CDF) geeft ons:
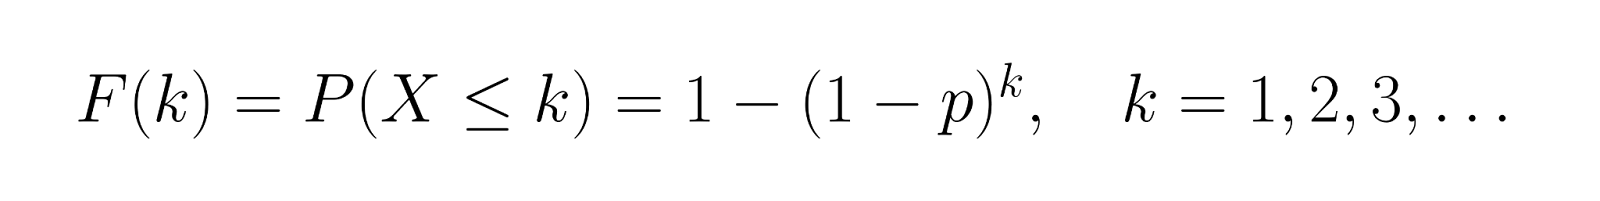
Dit vertegenwoordigt de kans om binnen k pogingen succes te behalen. Gebruikmakend van ons voorbeeld waar p = 0.3, berekenen we de CDF voor de eerste paar waarden:
Dit laat zien dat er 30% kans is op succes bij de eerste poging, 51% kans op succes binnen de eerste twee pogingen en 65,7% kans op succes binnen de eerste drie pogingen.
De visuele patronen van de geometrische verdeling tonen belangrijke inzichten over scenario's met "wachttijd". Deze grafieken laten zien hoe de kans zich concentreert in vroege pogingen en exponentieel afneemt, waardoor de verdeling nuttig is voor situaties waarin succes eerder waarschijnlijker is dan later.
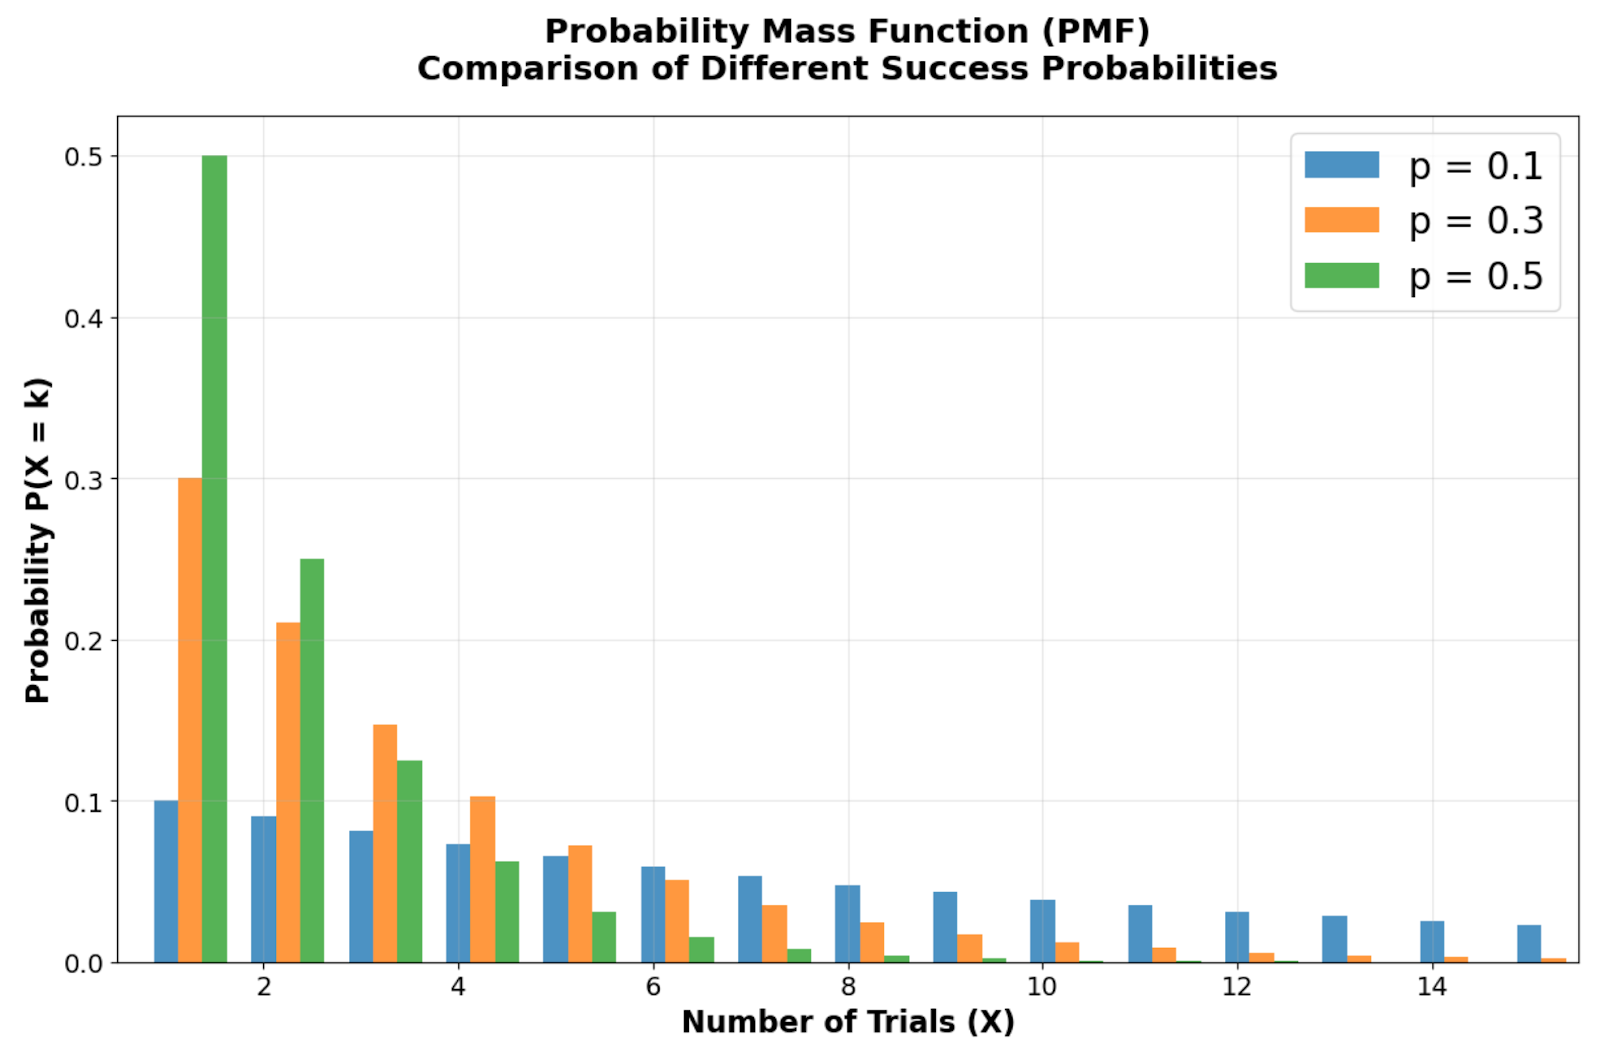
Vergelijking van de Probability Mass Function die laat zien hoe verschillende succeskansen (p = 0,1, 0,3, 0,5) de vorm van de verdeling beïnvloeden. Afbeelding door de auteur
Als je de probability mass function bij verschillende succeskansen bekijkt, zie je de kenmerkende rechts-scheve vorm van de geometrische verdeling, met de modus altijd bij X = 1 (de eerste poging). Let op hoe de staven bij de eerste poging het hoogst zijn en vervolgens geometrisch afnemen bij elke volgende poging. Naarmate de succeskans p kleiner wordt, spreidt de verdeling zich meer uit, wat langere verwachte wachttijden weerspiegelt. Met p = 0,1 is er bijvoorbeeld maar 10% kans op direct succes, wat een meer uitgesproken rechterstaart oplevert dan bij p = 0,5.
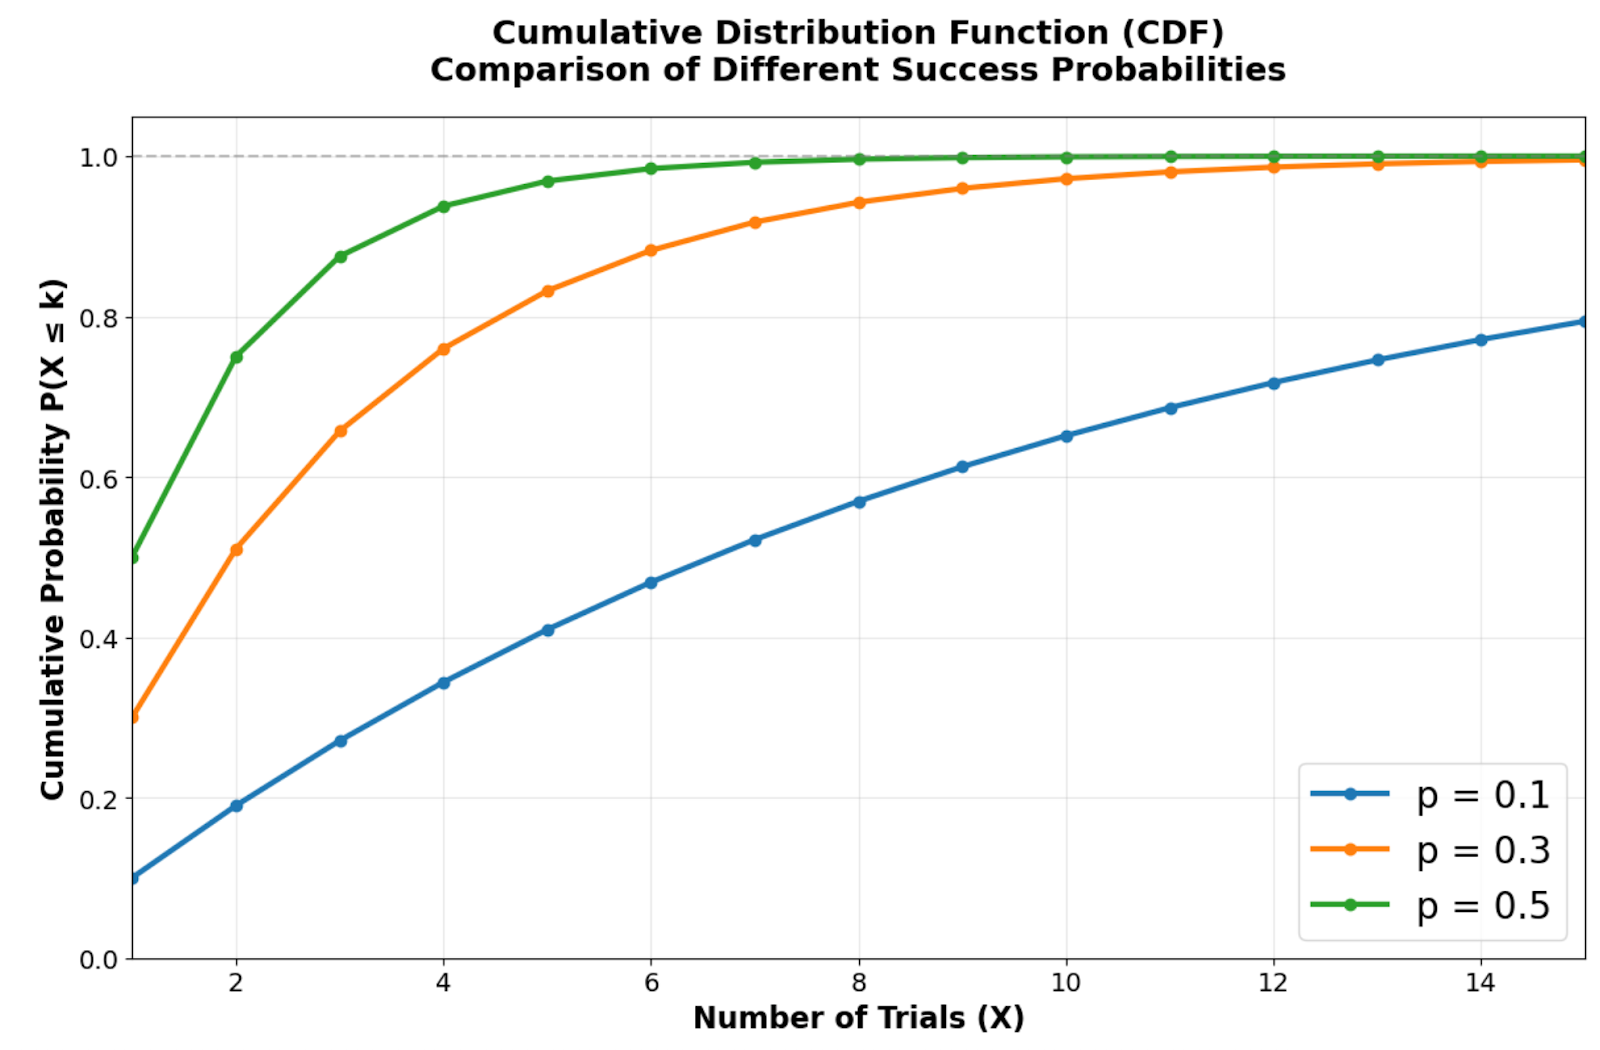
Cumulatieve verdelingsfunctie die laat zien hoe snel verschillende succeskansen naar zekerheid tenderen. Afbeelding door de auteur.
De cumulatieve verdelingsfunctie toont hoe snel de geometrische verdeling naar zekerheid toeloopt. Hogere succeskansen zorgen voor steilere curves die binnen slechts enkele pogingen hoge cumulatieve kansen bereiken. Met p = 0,5 is er bijvoorbeeld ongeveer 75% kans op succes binnen de eerste twee pogingen, terwijl p = 0,1 aanzienlijk meer pogingen vereist om hetzelfde zekerheidsniveau te halen.

Vergelijking naast elkaar die het patroon van exponentiële afname in de PMF en de snelle nadering van zekerheid in de CDF benadrukt. Afbeelding door de auteur.
Dit patroon van exponentiële afname verklaart waarom de geometrische verdeling goed werkt voor scenario's waarin vroeg succes waarschijnlijker is dan lange wachttijden. De snelle stijging van de CDF richting 1 laat zien waarom deze verdeling effectief is voor processen met korte wachttijden, wat haar waardevol maakt voor kwaliteitscontrole, analyse van klantconversie en betrouwbaarheidstests.
Je kunt deze visualisaties namaken en verschillende parameterwaarden verkennen met de Python-bibliotheken scipy en matplotlib. Zo genereer je de belangrijkste visuele inzichten die de meest wezenlijke kenmerken van de geometrische verdeling benadrukken:
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

# Create side-by-side plots for PMF and CDF
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(16, 6))
fig.suptitle('Geometric Distribution: Key Visual Insights', fontsize=24, fontweight='bold')

# Simple PMF showing exponential decay (using p = 0.3)
x_simple = np.arange(1, 11)
pmf_simple = stats.geom.pmf(x_simple, 0.3)

ax1.bar(x_simple, pmf_simple, alpha=0.8, color='steelblue', edgecolor='black', linewidth=1)
ax1.set_title('PMF: Exponential Decay Pattern', fontsize=18, fontweight='bold', pad=15)
ax1.set_xlabel('Number of Trials (X)', fontsize=17, fontweight='bold')
ax1.set_ylabel('Probability', fontsize=14, fontweight='bold')
ax1.grid(True, alpha=0.3)
ax1.tick_params(axis='both', which='major', labelsize=14)

# Simple CDF showing approach to 1
cdf_simple = stats.geom.cdf(x_simple, 0.3)

ax2.plot(x_simple, cdf_simple, 'o-', linewidth=4, markersize=8, color='darkgreen')
ax2.set_title('CDF: Rapid Approach to Certainty', fontsize=18, fontweight='bold', pad=15)
ax2.set_xlabel('Number of Trials (X)', fontsize=17, fontweight='bold')
ax2.set_ylabel('Cumulative Probability', fontsize=14, fontweight='bold')
ax2.grid(True, alpha=0.3)
ax2.set_ylim(0, 1.05)
ax2.tick_params(axis='both', which='major', labelsize=14)

plt.tight_layout()
plt.show()
Deze code maakt een gerichte visualisatie die de twee belangrijkste visuele kenmerken van de geometrische verdeling benadrukt. Het linkerpaneel laat zien hoe de kansen exponentieel afnemen vanaf de eerste poging, terwijl het rechterpaneel de snelle ophoping van kansmassa in de CDF toont.
Probeer de succeskans te wijzigen van 0,3 naar waarden als 0,1 of 0,7 om te zien hoe de vorm van de verdeling verandert. Lagere kansen zorgen voor vlakkere PMF-curves en langzamer stijgende CDF's, terwijl hogere kansen voor steilere dalingen en een snellere nadering van zekerheid zorgen.
De geometrische verdeling heeft een uniek kenmerk dat haar onderscheidt van de meeste andere discrete verdelingen.
De geheugenloze eigenschap stelt dat P(X > s + t | X > s) = P(X > t) voor alle positieve gehele getallen s en t. Dit betekent dat de kans op extra pogingen niet afhangt van hoeveel mislukte pogingen al hebben plaatsgevonden.
Wiskundig volgt dit omdat P(X > k) = (1-p)k, waardoor de voorwaardelijke kansberekening eenvoudig wordt. In praktische termen: als je al vijf mislukte sollicitatiegesprekken hebt gehad, blijft de kansverdeling voor toekomstige gesprekken identiek aan die bij de start—verleden mislukkingen beïnvloeden de toekomstige kansen niet.
Elke poging in een geometrisch experiment is een onafhankelijke Bernoulli-poging met een constante succeskans p. De geometrische verdeling modelleert de reeks van deze pogingen tot het eerste succes en is zo het discrete equivalent van "wachttijd"-problemen.
Deze relatie verklaart waarom de geometrische verdeling vaak voorkomt in kwaliteitscontrole, waar elk getest item een Bernoulli-poging vertegenwoordigt en we geïnteresseerd zijn in het detecteren van het eerste defecte item. De onafhankelijkheidsaanname zorgt ervoor dat het vinden van defecten in vroege tests de kans op defecten in latere tests niet verandert.
De exponentiële verdeling fungeert als de continue tegenhanger van de geometrische verdeling; beide delen de geheugenloze eigenschap. Terwijl de geometrische verdeling discrete wachttijden modelleert (aantal pogingen), modelleert de exponentiële verdeling continue wachttijden (tijd tot een gebeurtenis).
Beide verdelingen vinden toepassingen in betrouwbaarheidsonderzoek en wachtrijtheorie. Zo kan de geometrische verdeling het aantal serververzoeken tot de eerste fout modelleren, terwijl de exponentiële verdeling de tijd tot de volgende serverfout modelleert.
Met de basisconcepten en unieke eigenschappen op hun plek, bekijken we nu de wiskundige hulpmiddelen voor nauwkeurige kansberekeningen en onderbouwde beslissingen. Deze formules en relaties zijn essentieel wanneer je de geometrische verdeling toepast op problemen uit de praktijk.
De verwachtingswaarde (het gemiddelde) van de geometrische verdeling is:
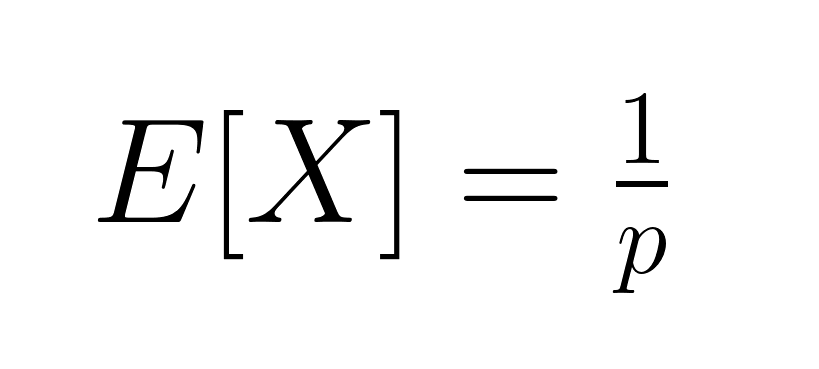
Dit stelt het gemiddelde aantal pogingen voor dat nodig is voor succes. De variantie is gelijk aan:
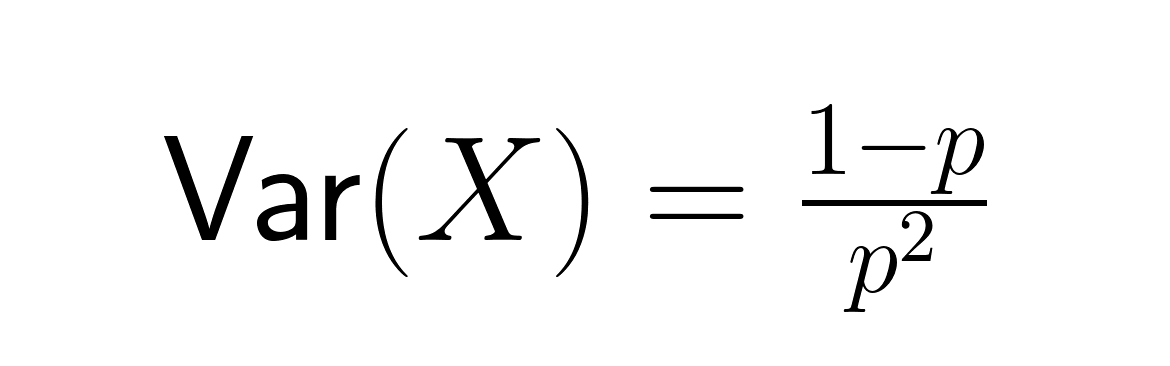
De standaardafwijking is:
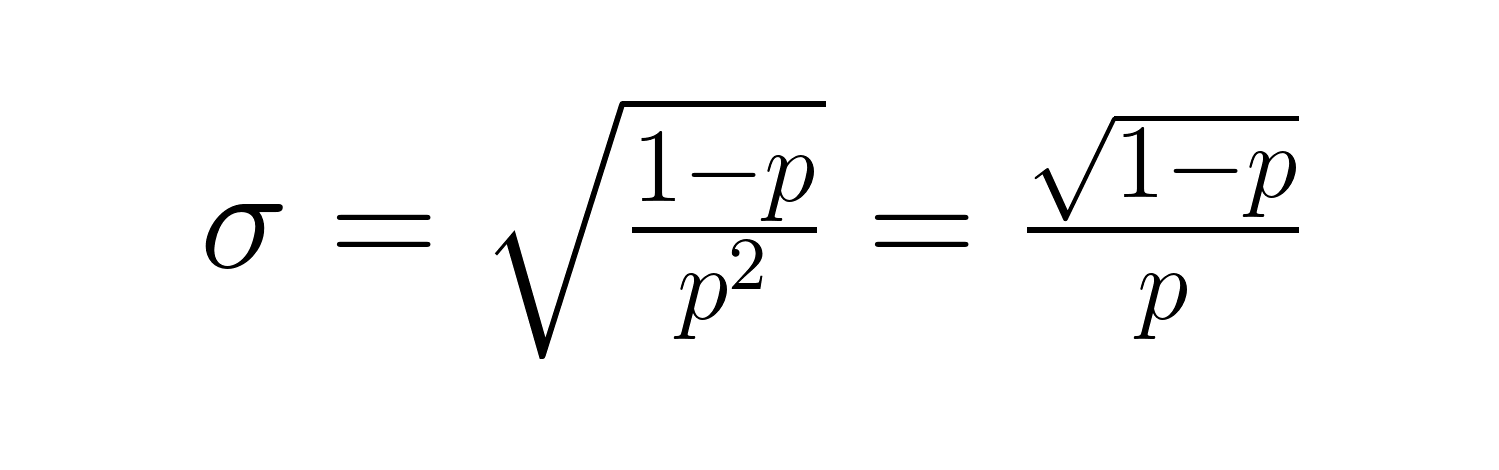
Deze formules onthullen belangrijke relaties: als p kleiner wordt, nemen zowel de verwachte wachttijd als de variabiliteit sterk toe. Bijvoorbeeld, met p = 0,2 is het verwachte aantal pogingen 5, maar met p = 0,05 stijgt dat naar 20 pogingen. De variantie neemt nog sterker toe, van 20 naar 380.
Voor geavanceerdere analyses is de momentgenererende functie (MGF) voor de geometrische verdeling:
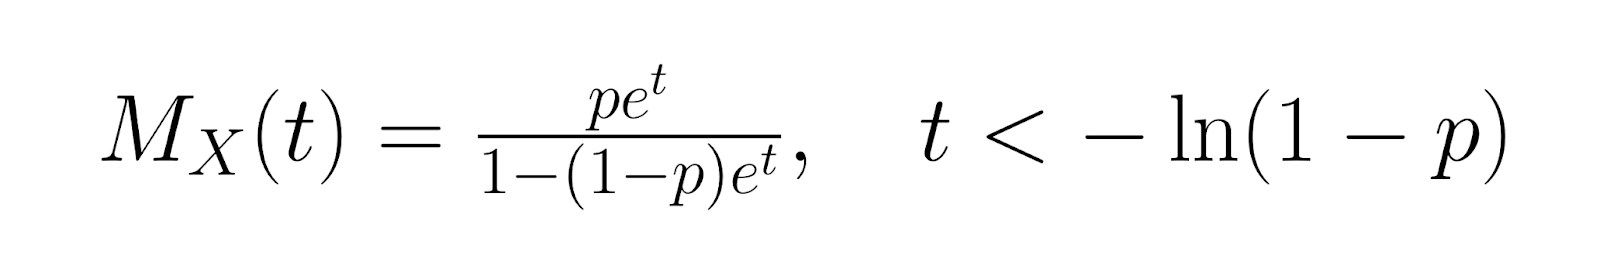 De kansgenererende functie (PGF) is:
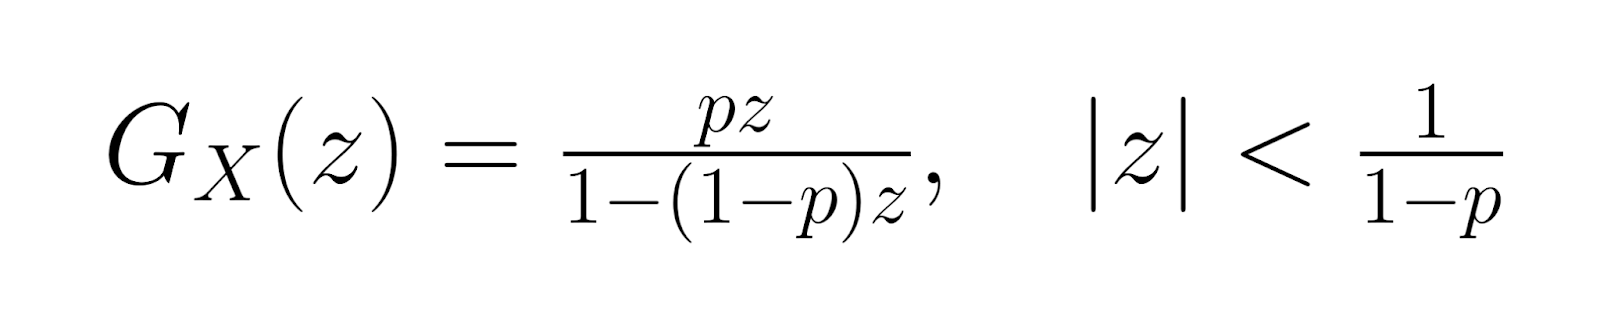
Deze genererende functies helpen bij geavanceerde statistische analyses en bieden alternatieve methoden om verdelingseigenschappen af te leiden. Momenten van hogere orde kunnen worden berekend via afgeleiden van deze functies, waardoor je de vorm en het gedrag van de verdeling volledig kunt karakteriseren.
In meer gespecialiseerd terrein is de entropie van de geometrische verdeling gelijk aan:
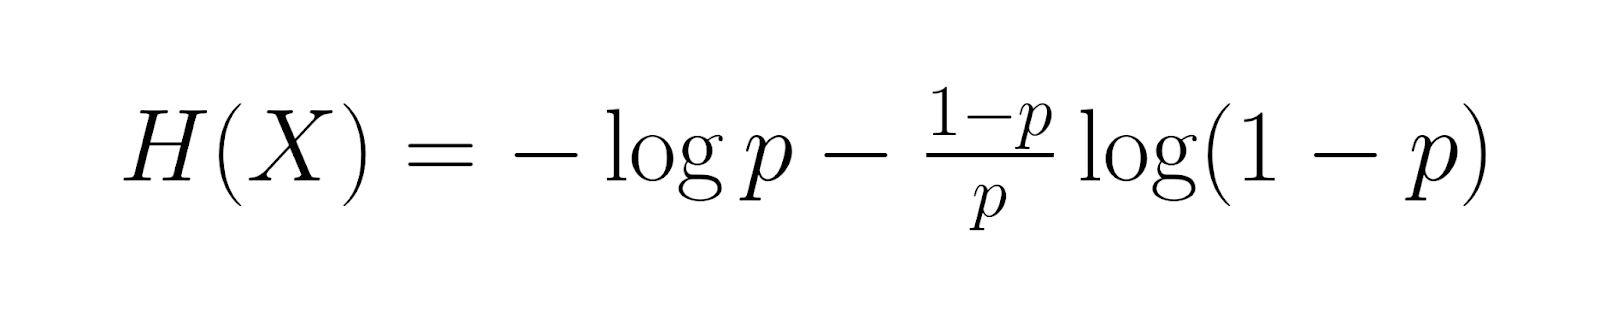
Dit meet de gemiddelde informatie-inhoud. Fisher-informatie, gegeven door:
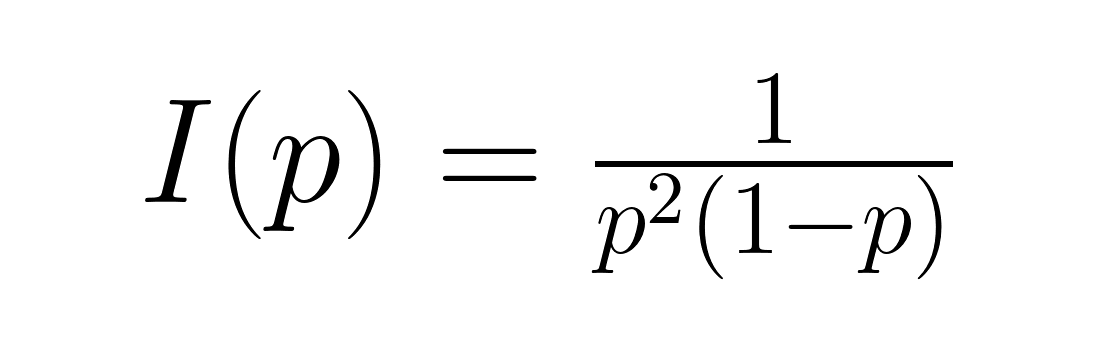
Deze kwantificeert de hoeveelheid informatie over parameter p die in de data zit. Deze maten zijn waardevol in informatietheorie en optimaal experimenteel ontwerp, waar inzicht in de informatie-inhoud helpt bij het bepalen van geschikte steekproefgroottes en schattingsprocedures.
Het schatten van de succeskans p uit geobserveerde data vereist inzicht in verschillende statistische benaderingen en hun afwegingen.
De maximum likelihood-benadering werkt door de succeskans te vinden die jouw geobserveerde data het meest waarschijnlijk maakt. Om deze schatter te berekenen, deel je het totaal aantal succesgebeurtenissen door de som van alle pogingen over je observaties heen. Deze schatter is onbevooroordeeld en presteert efficiënt bij grote steekproeven.
Zo werkt dit in de praktijk: als je respectievelijk na 3, 7, 2 en 8 pogingen succes observeert, bereken je de MLE door je 4 observaties te delen door het totaal van 20 pogingen (3+7+2+8), wat een geschatte succeskans van 0,2 of 20% oplevert. De MLE-benadering maximaliseert de kans om precies de data te observeren die je verzameld hebt, en is onder standaardcondities de statistisch meest efficiënte methode.
Als alternatief werkt de schatter via de methode van momenten door je steekproefgemiddelde gelijk te stellen aan het theoretische gemiddelde van de geometrische verdeling. Omdat het theoretische gemiddelde gelijk is aan één gedeeld door de succeskans, kun je de succeskans schatten door één te delen door je steekproefgemiddelde. Hoewel deze methode rekenkundig eenvoudiger is dan MLE, kan ze statistisch minder efficiënt zijn en soms schattingen opleveren buiten het geldige bereik van nul tot één.
Beide methoden leveren vergelijkbare resultaten op bij grote steekproeven, maar MLE biedt over het algemeen betere statistische eigenschappen. De keuze hangt vaak af van rekentechnische beperkingen en de specifieke eisen van je analyse.
Wanneer je voorafgaande informatie hebt over de succeskans, kun je met Bayesiaanse schatting deze kennis verwerken via een prior-kansverdeling. De bètaverdeling wordt vaak als prior gebruikt omdat ze wiskundig goed samenwerkt met data uit een geometrische verdeling. De Bayesiaanse aanpak combineert je voorafgaande overtuigingen met geobserveerde data om bijgewerkte parameterschattingen te produceren via de zogenaamde posterior-verdeling.
De wiskundige relatie levert een bijgewerkte bètaverdeling op die zowel je voorkennis als nieuwe observaties omvat. Deze aanpak werkt bijzonder goed bij beperkte data of wanneer je expertise over het te modelleren proces wilt meenemen. Als je bijvoorbeeld uit branche-ervaring weet dat succespercentages doorgaans binnen een bepaald bereik vallen, kun je deze kennis meenemen om je schattingen te verbeteren, zelfs met kleine steekproeven.
De geometrische verdeling wordt veel gebruikt in uiteenlopende sectoren en analytische contexten waarin het modelleren van eerste-succesgebeurtenissen inzicht biedt.
Productieprocessen gebruiken de geometrische verdeling vaak voor het modelleren van defectdetectie en analyse van componentstoringen. Kwaliteitscontroleurs kunnen het verwachte aantal te inspecteren items schatten voordat ze een defect exemplaar vinden, wat helpt bij het optimaliseren van inspectieprocedures en de inzet van middelen.
Als historische data bijvoorbeeld een defectpercentage van 2% laat zien, voorspelt de geometrische verdeling gemiddeld 50 inspecties voordat het eerste defect wordt gevonden. Deze informatie helpt bij het bepalen van geschikte batchgroottes en inspectiefrequenties om kwaliteitsnormen te waarborgen en kosten te minimaliseren.
Marketingteams passen de geometrische verdeling toe om klantconversieprocessen te modelleren en te schatten hoeveel contactmomenten of advertenties nodig zijn voor een verkoop. Deze analyse informeert beslissingen over budgetallocatie en campagnestrategie.
In de telecommunicatie gebruiken netwerkengineers de geometrische verdeling om succeskansen bij pakkettransmissie te modelleren en retry-mechanismen te optimaliseren. Inzicht in het verwachte aantal transmissiepogingen helpt efficiënte protocollen te ontwerpen en de algehele netwerkprestaties te verbeteren.
Sportanalisten gebruiken de geometrische verdeling om scoregebeurtenissen te modelleren, zoals het aantal pogingen dat een basketballer nodig heeft om zijn of haar eerste driepunter in een wedstrijd te maken. Deze analyse draagt bij aan strategische besluitvorming en prestatie-evaluatie.
In games wordt het gebruikt om te modelleren hoeveel pogingen nodig zijn om zeldzame gebeurtenissen te bereiken of uitdagende levels te voltooien. Online platforms gebruiken deze inzichten om de spelmoeilijkheid in balans te brengen en spelers betrokken te houden met passende beloningsstructuren.
Stel dat een marketingcampagne een conversieratio van 15% heeft. Om de kans te vinden op de eerste conversie bij het 5e contact: P(X = 5) = (0,85)⁴ × 0,15 = 0,0783 of ongeveer 7,83%.
Als oefening: bereken de kans dat een kwaliteitscontroleur het eerste defecte item binnen de eerste 10 inspecties vindt, gegeven een defectpercentage van 8%. Gebruik de CDF-formule: P(X ≤ 10) = 1 - (0,92)¹⁰ = 0,5656 of circa 56,56%.
Begrijpen wanneer de geometrische verdeling passend is, vereist dat je de onderliggende aannames en mogelijke beperkingen herkent.
De geometrische verdeling gaat uit van onafhankelijke pogingen met constante succeskans, wat in veel praktijksituaties niet opgaat. Klantgedrag vertoont bijvoorbeeld vaak afhankelijkheid—eerdere interacties kunnen toekomstige conversiekansen beïnvloeden. Evenzo kunnen mechanische systemen slijten, waardoor faalkansen in de tijd veranderen.
Schendingen van deze aannames kunnen leiden tot onnauwkeurige voordellingen en slechte beslissingen. Dataprofessionals moeten de onafhankelijkheidsaanname valideren via statistische tests en alternatieve modellen overwegen wanneer afhankelijkheden worden gedetecteerd. Veelvoorkomende alternatieven zijn de negatief-binomiale verdeling voor overdisperse data of Markov-ketenmodellen voor afhankelijke pogingen.
De geometrische verdeling begrijpen gaat verder dan theorie—het stelt je in staat weloverwogen beslissingen te nemen over resource-allocatie, procesoptimalisatie en risico-inschatting. Of je nu kwaliteitscontroleprocedures ontwerpt of marketingcampagnes optimaliseert, deze verdeling biedt kwantitatieve inzichten die tot betere uitkomsten leiden.
Voor verdere verdieping: bekijk onze cursus Multivariate Probability Distributions in R om te begrijpen hoe de geometrische verdeling zich verhoudt tot andere kansmodellen, of verdiep je in schattingstechnieken met onze cursus Generalized Linear Models in R voor geavanceerde modeltoepassingen.
Leer met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

