
课程
R 中的概率基础
4 小时
43K
在拿到理想职位之前,您可能需要参加多少次面试?一次营销活动要尝试多少次才会产生第一笔销售?几何分布通过刻画直到首次成功所需的试验次数,回答这些“等待时间”的问题。
本指南将介绍几何分布的数学基础、其独特性质,以及在处理序列试验场景时的实用应用价值。若需回顾概率分布的基础,建议学习我们的Introduction to Statistics课程。
几何分布是一种离散概率分布,用于刻画为实现首次成功所需的相互独立的伯努利试验的次数。每次试验的成功概率相同,且各次试验相互独立。
该分布常见有两种形式:一种统计直到首次成功为止的试验总次数(包含这次成功),另一种仅统计首次成功之前的失败次数。两种形式在不同应用情境下都很常用。本文全程采用第一种形式,即统计直到首次成功为止的总试验次数,此时 X 可取 1、2、3 等值。
让我们来看看定义该分布的数学结构和特征。
几何分布需要满足三个关键条件:试验相互独立,所有试验的成功概率相同,且存在固定的概率 p,满足 0 < p ≤ 1。标准记号中用 p 表示成功概率,用 q = 1-p 表示失败概率。
直到首次成功所需试验次数 X 的概率质量函数(PMF)为:
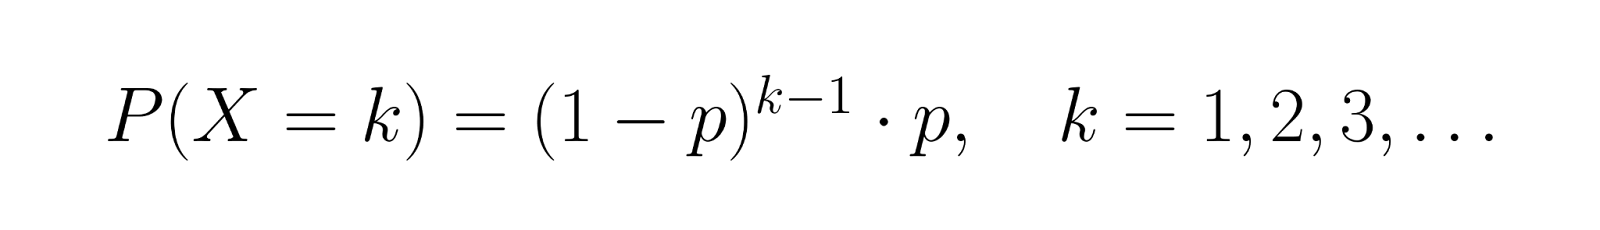
该公式给出恰好经历 k-1 次失败后紧跟一次成功的概率。比如,若 p = 0.3,则第三次试验成功的概率为 P(X = 3) = (0.7)² × 0.3 = 0.147。
累积分布函数(CDF)为:
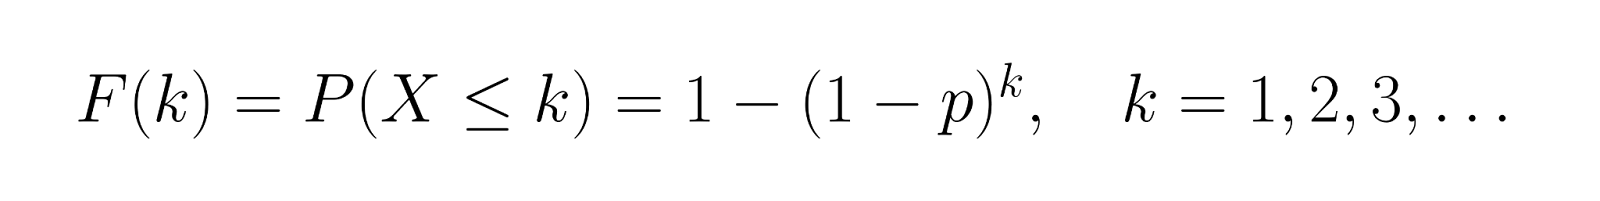
这表示在 k 次试验内获得成功的概率。继续用 p = 0.3 的例子,计算前几个值的 CDF:
这表明:第一次试验成功的概率为 30%,前两次内成功的概率为 51%,前三次内成功的概率为 65.7%。
几何分布的可视化模式揭示了“等待时间”场景中的关键信息。这些图表展示了概率如何集中在早期试验并按指数衰减,因此适合模拟更可能较早发生成功的情形。
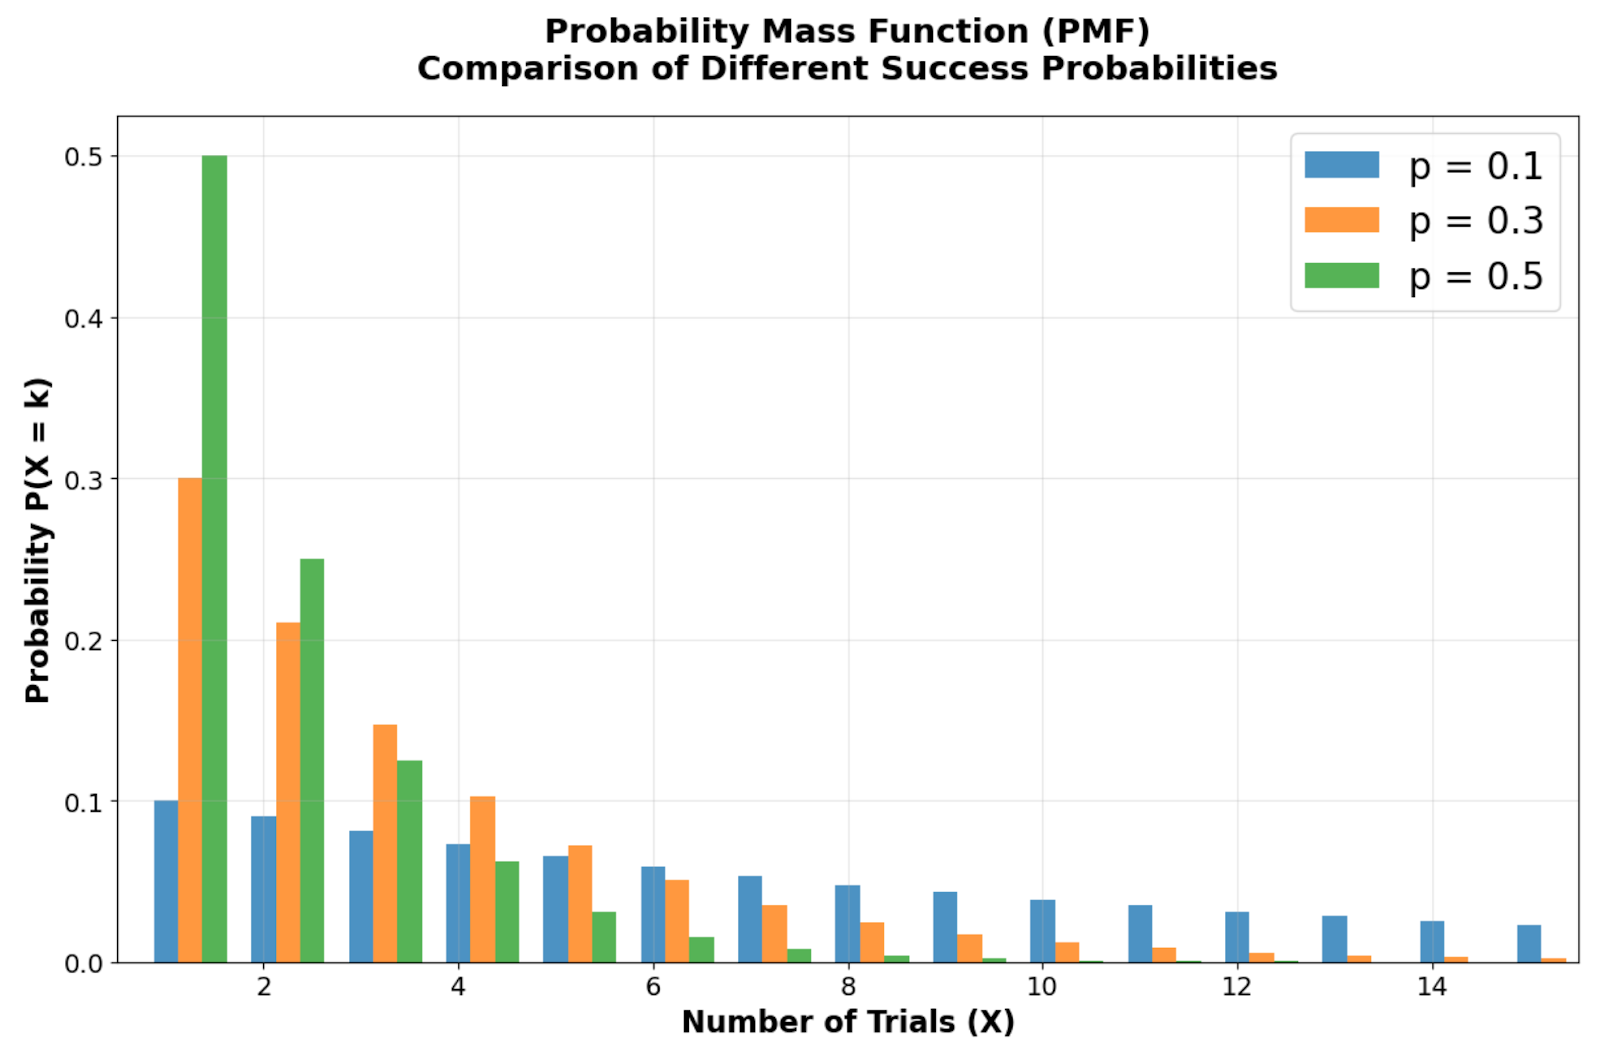
概率质量函数对比,展示不同成功概率(p = 0.1、0.3、0.5)如何影响分布形状。图片作者自制
从不同成功概率下的概率质量函数对比可以看到,几何分布具有明显的右偏形状,众数始终在 X = 1(第一次试验)。注意概率柱在第一次试验处最高,随后各次按几何级数递减。随着成功概率 p 减小,分布越分散,反映出更长的期望等待时间。比如 p = 0.1 时,即时成功的概率仅为 10%,相比 p = 0.5 右尾更突出。
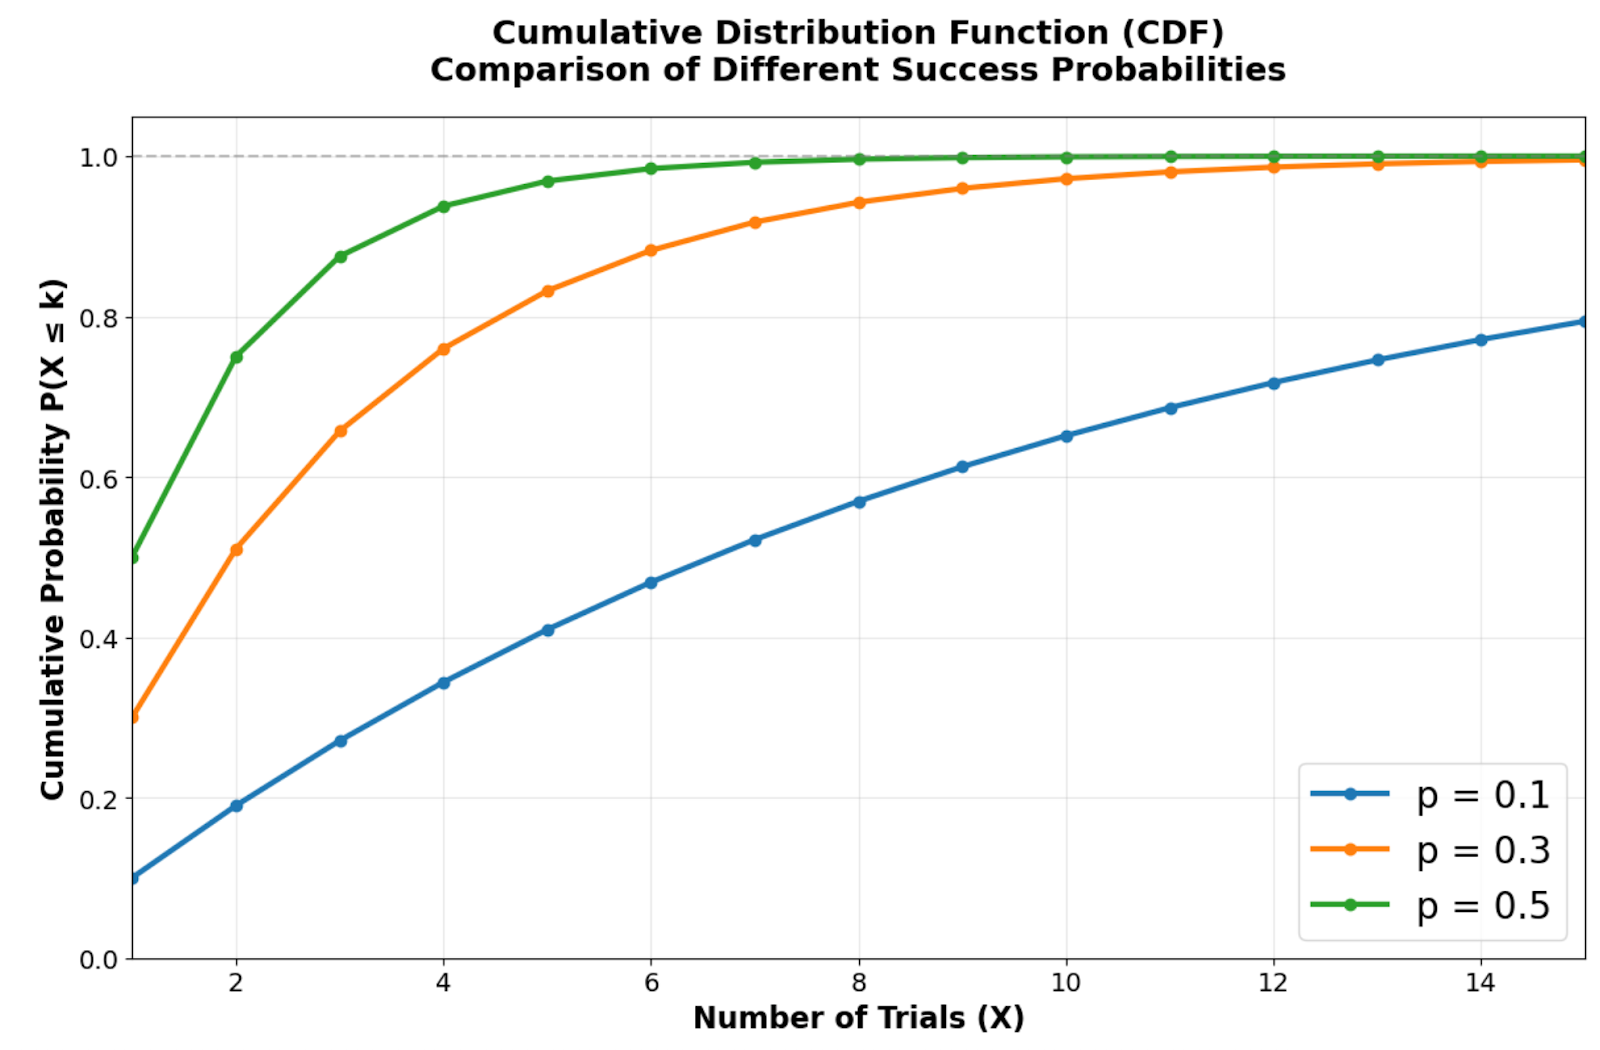
累积分布函数展示不同成功概率接近确定性的速度。图片作者自制。
累积分布函数体现了几何分布接近“必然”的速度。更高的成功概率会形成更陡峭的曲线,仅用少数几次试验就能达到较高的累积概率。例如 p = 0.5 时,前两次内成功的概率约为 75%;而 p = 0.1 则需要显著更多的试验次数才能达到同等把握。

并排对比突出 PMF 的指数衰减模式与 CDF 快速趋近于确定性的特征。图片作者自制。
这种指数衰减模式解释了为何几何分布适合刻画“更可能早成而非久等”的情境。CDF 快速上升至 1 也显示了其在等待时间较短的过程建模中的有效性,因此在质量控制、客户转化分析与可靠性测试等场景颇具价值。
您可以使用 Python 的 scipy 与 matplotlib 库重现这些可视化,并探索不同参数取值。以下示例演示如何生成突出几何分布关键特性的可视化:
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

# Create side-by-side plots for PMF and CDF
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(16, 6))
fig.suptitle('Geometric Distribution: Key Visual Insights', fontsize=24, fontweight='bold')

# Simple PMF showing exponential decay (using p = 0.3)
x_simple = np.arange(1, 11)
pmf_simple = stats.geom.pmf(x_simple, 0.3)

ax1.bar(x_simple, pmf_simple, alpha=0.8, color='steelblue', edgecolor='black', linewidth=1)
ax1.set_title('PMF: Exponential Decay Pattern', fontsize=18, fontweight='bold', pad=15)
ax1.set_xlabel('Number of Trials (X)', fontsize=17, fontweight='bold')
ax1.set_ylabel('Probability', fontsize=14, fontweight='bold')
ax1.grid(True, alpha=0.3)
ax1.tick_params(axis='both', which='major', labelsize=14)

# Simple CDF showing approach to 1
cdf_simple = stats.geom.cdf(x_simple, 0.3)

ax2.plot(x_simple, cdf_simple, 'o-', linewidth=4, markersize=8, color='darkgreen')
ax2.set_title('CDF: Rapid Approach to Certainty', fontsize=18, fontweight='bold', pad=15)
ax2.set_xlabel('Number of Trials (X)', fontsize=17, fontweight='bold')
ax2.set_ylabel('Cumulative Probability', fontsize=14, fontweight='bold')
ax2.grid(True, alpha=0.3)
ax2.set_ylim(0, 1.05)
ax2.tick_params(axis='both', which='major', labelsize=14)

plt.tight_layout()
plt.show()
该代码生成一组聚焦的可视化,强调几何分布两个最重要的视觉特征。左图显示概率如何从第一次试验开始呈指数衰减,右图展示 CDF 中概率质量如何快速累积。
尝试将成功概率从 0.3 改为 0.1 或 0.7,观察分布形状的变化。较低的概率会产生更平缓的 PMF 曲线与上升更慢的 CDF;较高的概率则对应更陡峭的下降与更快的趋近于确定性。
几何分布具有一种独特特性,使其区别于大多数其他离散分布。
无记忆性指:对任意正整数 s 与 t,P(X > s + t | X > s) = P(X > t)。这意味着,所需额外试验次数的概率与此前已经经历了多少次未成功无关。
从数学上看,该性质源于 P(X > k) = (1-p)k,使条件概率计算变得直接。就实践而言,即使您已经经历了五次未成功的面试,后续面试的概率分布与一开始时相同——过去的失败不会影响未来的概率。
几何实验中的每次试验都是一次成功概率恒定为 p 的独立伯努利试验。几何分布刻画这些试验直至首次成功的序列,是离散“等待时间”问题的对应模型。
这种关系解释了为何几何分布在质量控制中频繁出现:每个被检产品都是一次伯努利试验,而我们关心的是首次检出不合格品。独立性假设确保在早期检出不合格并不会改变后续检出不合格的概率。
“指数分布”是几何分布的连续对应分布,二者都具有无记忆性。几何分布刻画离散等待时间(试验次数),指数分布则刻画连续等待时间(直到事件发生的时间)。
两者均用于可靠性分析与排队论。例如,几何分布可用于建模服务器请求中直到首次失败所需的请求次数,而指数分布可用于建模到下一次服务器故障发生的时间。
在掌握基础概念与独特性质之后,我们来探讨实现精确概率计算与辅助决策的数学工具。这些公式与关系式在将几何分布应用于现实问题时至关重要。
几何分布的期望(均值)为:
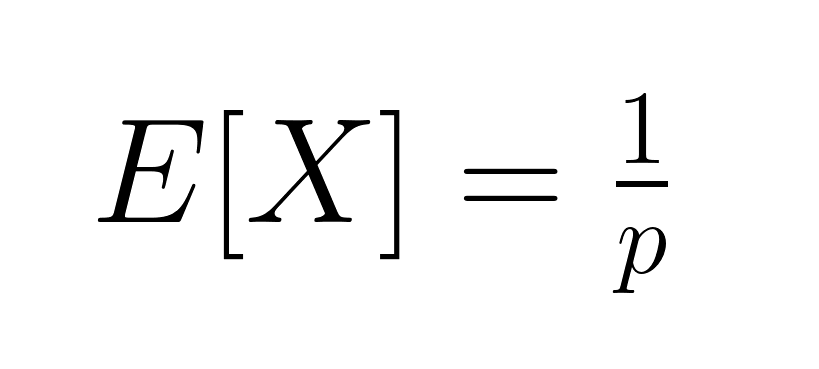
表示获得成功所需试验次数的平均值。方差等于:
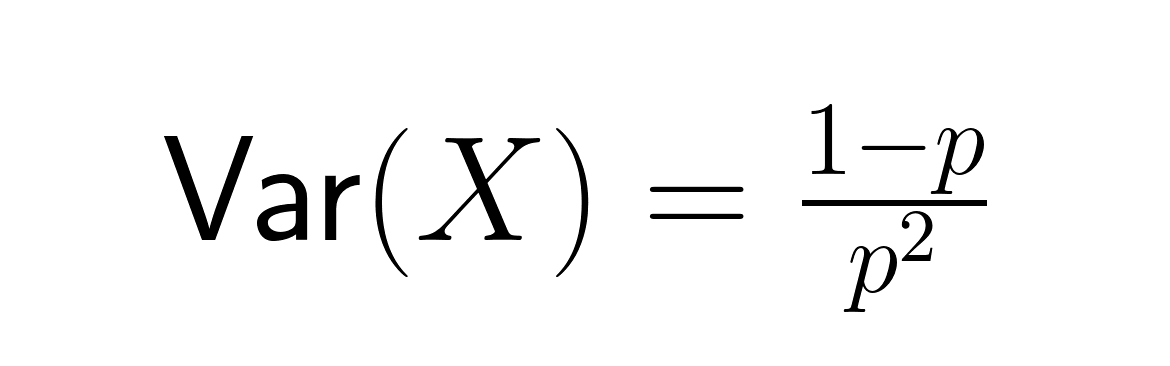
标准差为:
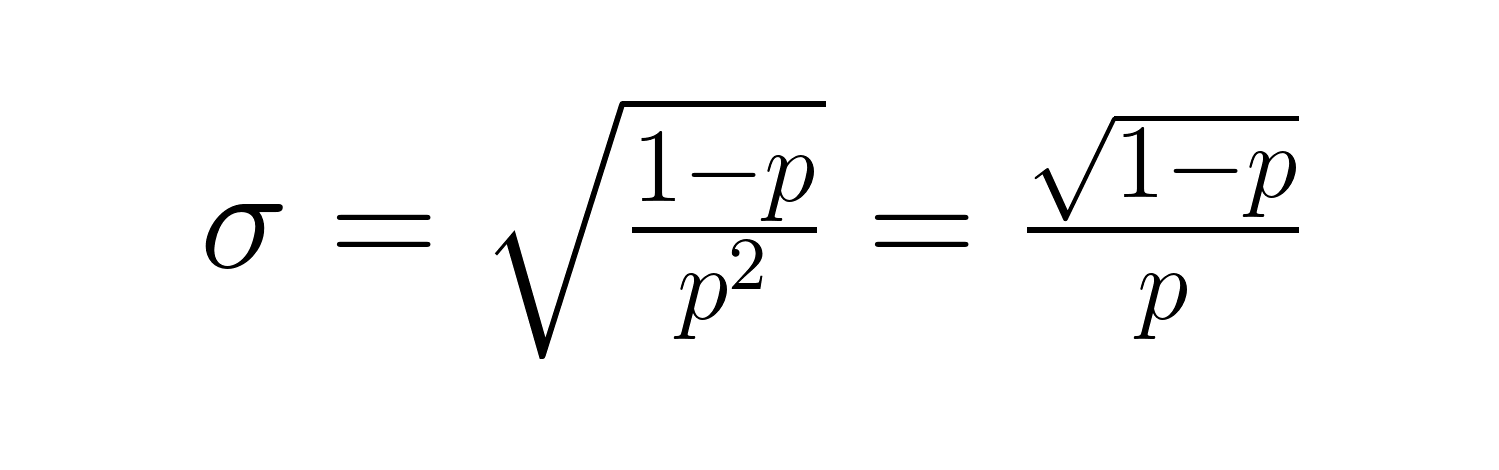
这些公式揭示了重要关系:随着 p 减小,期望等待时间与波动性都会显著上升。比如 p = 0.2 时,期望试验次数为 5;而 p = 0.05 时,期望次数跃升至 20。方差增长更为显著,从 20 增至 380。
在更高级的分析中,几何分布的矩母函数(MGF)为:
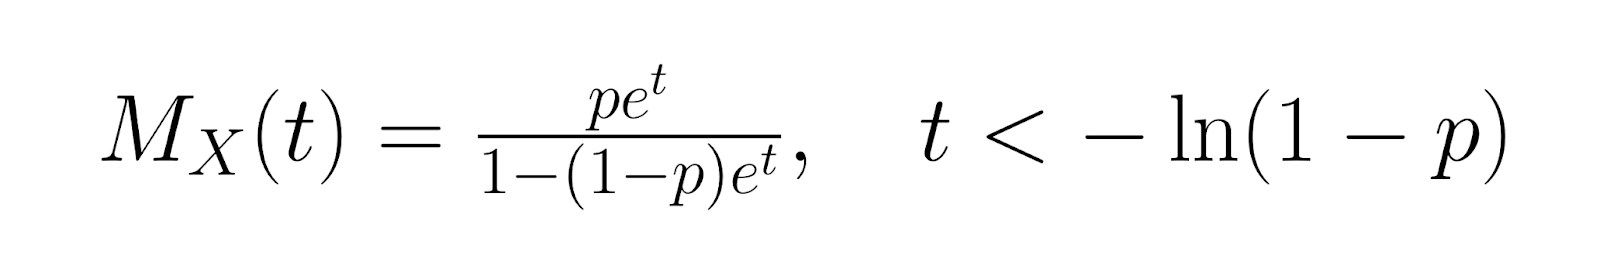 概率母函数(PGF)为:
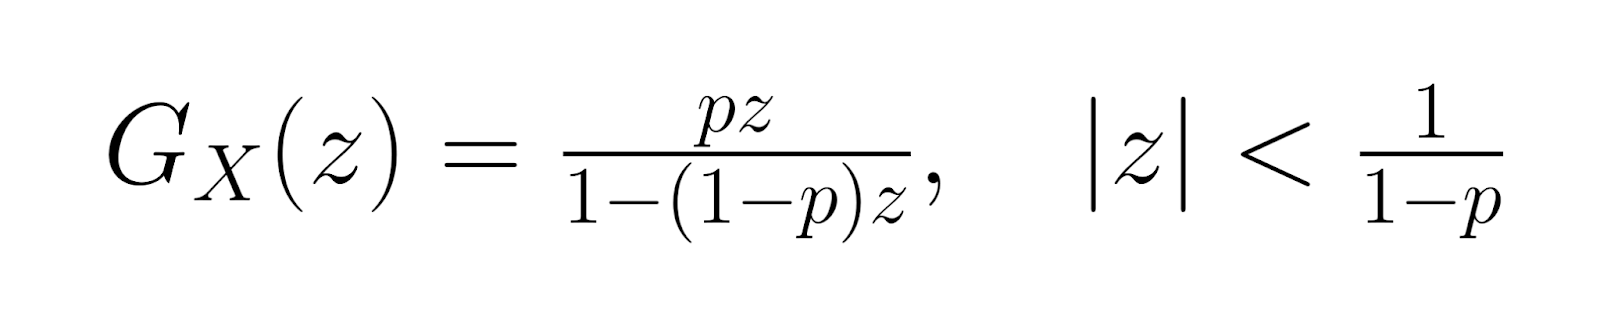
这些母函数有助于高级统计分析,并提供推导分布性质的替代方法。高阶矩可通过对这些函数求导得到,从而全面刻画分布的形状与行为。
进一步而言,几何分布的熵为:
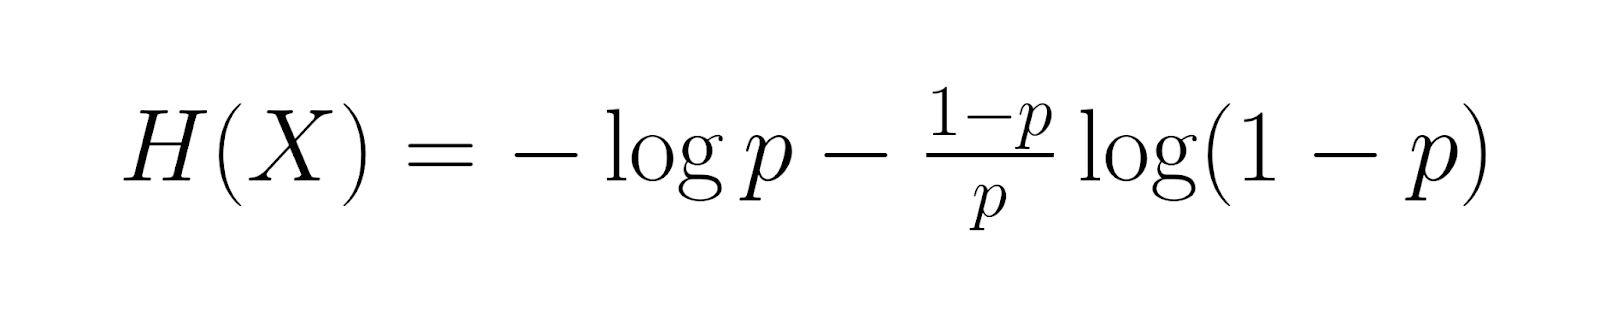
这衡量了平均信息量。Fisher 信息为:
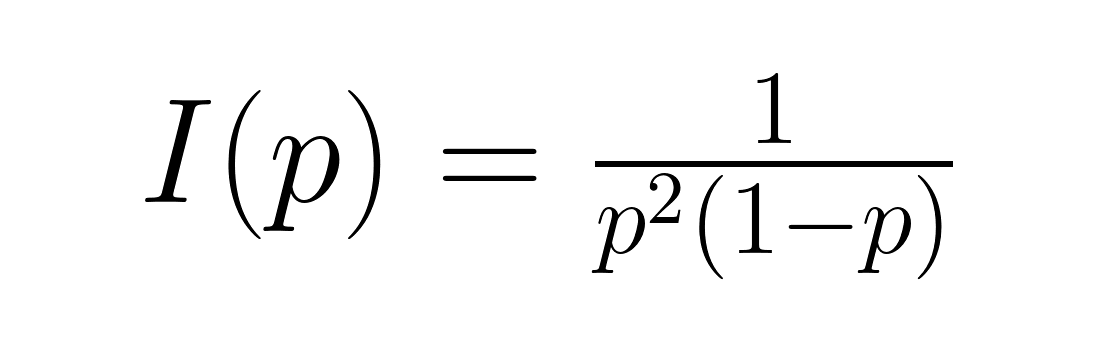
它量化了数据中关于参数 p 的信息量。这些度量在信息论应用与最优试验设计中很有价值,有助于基于信息量确定合适的样本量与估计方案。
从观测数据估计成功概率 p 需要理解不同统计方法及其权衡。
极大似然估计通过寻找最可能生成您观测数据的成功概率来进行估计。具体做法是,将成功事件的总数除以所有观测中试验次数的总和。该估计量在大样本下具有无偏且高效的性质。
例如,若您分别在第 3、7、2、8 次试验后成功,则用 4 次观测除以总试验 20 次(3+7+2+8),得到成功概率的 MLE 为 0.2,即 20%。MLE 使得您实际观测数据的似然最大化,在标准条件下通常是统计效率最高的方法。
另一种方法是矩估计法,将样本平均数与几何分布的理论均值相等。由于理论均值等于成功概率的倒数,您可以用样本均值的倒数来估计成功概率。相比 MLE,此法计算更为简便,但统计效率可能较低,且个别情况下会给出超出 0 到 1 有效范围的估计值。
在大样本下,两种方法通常会得到相近的结果,但 MLE 一般具有更优的统计性质。具体选择往往取决于计算约束与分析需求。
当您对成功概率具备先验信息时,贝叶斯估计可通过先验分布将这些知识纳入。Beta 分布常用作先验,因为它与几何分布数据在数学上相容。贝叶斯方法将先验与观测数据结合,得到所谓“后验分布”下更新的参数估计。
这种数学关系会得到更新后的 Beta 分布,综合了先验知识和新观测。当数据量有限,或希望纳入领域专家对过程的了解时,此方法尤为有效。比如,若行业经验显示成功率通常落在某一范围内,即便样本较小,也可借助该知识改进估计。
几何分布在各行各业和多种分析语境中广泛使用,尤其在建模“首次成功”事件时能提供洞见。
制造流程常用几何分布来建模缺陷检出与部件失效分析。质量检验人员可估计在发现首件不合格品前需要检查的平均数量,从而优化检验流程与资源配置。
例如,若历史数据显示缺陷率为 2%,几何分布预测平均需检查 50 件才能发现第一件不合格品。该信息有助于在维持质量标准的同时,确定合适的批量大小与检验频率,以降低成本。
市场团队用几何分布建模客户转化过程,估计在达成一笔销售前所需的触达或广告次数。该分析为预算分配与活动策略提供依据。
在电信领域,网络工程师用几何分布建模数据包传输的成功率并优化重试机制。掌握预期的传输尝试次数,有助于设计高效协议并提升整体网络性能。
体育分析中,几何分布可用于建模得分事件,例如一名篮球运动员在比赛中命中第一记三分所需的出手次数。该分析有助于战略决策与绩效评估。
在游戏应用中,可用来建模达成稀有事件或通过高难关卡所需的尝试次数。在线平台借此平衡游戏难度,并通过适当的奖励机制保持玩家参与度。
设某营销活动的转化率为 15%。求第 5 次触达才获得首次转化的概率:P(X = 5) = (0.85)⁴ × 0.15 = 0.0783,约为 7.83%。
练习:若缺陷率为 8%,计算质量检验员在前 10 次检查内发现首件不合格品的概率。使用 CDF 公式:P(X ≤ 10) = 1 - (0.92)¹⁰ = 0.5656,约为 56.56%。
要恰当应用几何分布,需要识别其潜在假设与可能的局限。
几何分布假设试验独立且成功概率恒定,但在许多现实情境中可能不成立。例如,客户行为往往存在依赖性——先前互动会影响后续转化概率。类似地,机械系统会随时间磨损,导致失效率变化。
违反这些假设可能导致预测不准与决策失误。数据从业者应通过统计检验验证独立性,并在发现依赖时考虑替代模型。常见替代方案包括用于过度离散数据的负二项分布或用于相关试验的 Markov 链模型。
理解几何分布不仅是理论层面的掌握——它还能帮助您在资源配置、流程优化与风险评估上做出明智决策。无论是设计质量控制流程,还是优化营销活动,该分布都能提供驱动更好结果的量化洞见。
若想继续深入学习,请探索我们的Multivariate Probability Distributions in R课程,了解几何分布与其他概率模型的关系;或通过Generalized Linear Models in R课程进一步钻研估计技术,应用于高级建模场景。