
Corso
Fondamenti di probabilità in R
4 ore
42.8K
Quanti colloqui potresti dover sostenere prima di ottenere il lavoro dei tuoi sogni? Quanti tentativi servono prima che una campagna di marketing generi la sua prima vendita? La distribuzione geometrica risponde a queste domande sui "tempi di attesa" modellando il numero di prove necessarie fino al primo successo.
Questa guida copre le basi matematiche della distribuzione geometrica, le sue proprietà distintive e le applicazioni pratiche che la rendono utile per chi lavora con scenari di prove sequenziali. Per un ripasso sulle distribuzioni di probabilità, valuta il nostro corso Introduction to Statistics.
La distribuzione geometrica è una distribuzione di probabilità discreta che modella il numero di prove di Bernoulli indipendenti necessarie per ottenere il primo successo. Ogni prova ha la stessa probabilità di successo e le prove sono indipendenti tra loro.
Questa distribuzione ha due forme comuni: una che conta il numero totale di prove fino al primo successo (incluso il successo), e un'altra che conta solo il numero di fallimenti prima del primo successo. Entrambe le forme sono ampiamente utilizzate a seconda del contesto applicativo specifico. In tutta questa guida useremo la prima forma, contando il numero totale di prove fino al primo successo, dove X può assumere i valori 1, 2, 3 e così via.
Esaminiamo la struttura matematica e le caratteristiche che definiscono questa distribuzione.
La distribuzione geometrica richiede tre condizioni chiave: prove indipendenti, probabilità di successo identica per tutte le prove e una probabilità fissa p dove 0 < p ≤ 1. La notazione standard usa p per la probabilità di successo e q = 1-p per la probabilità di fallimento.
La funzione di massa di probabilità (PMF) per il numero di prove X fino al primo successo è:
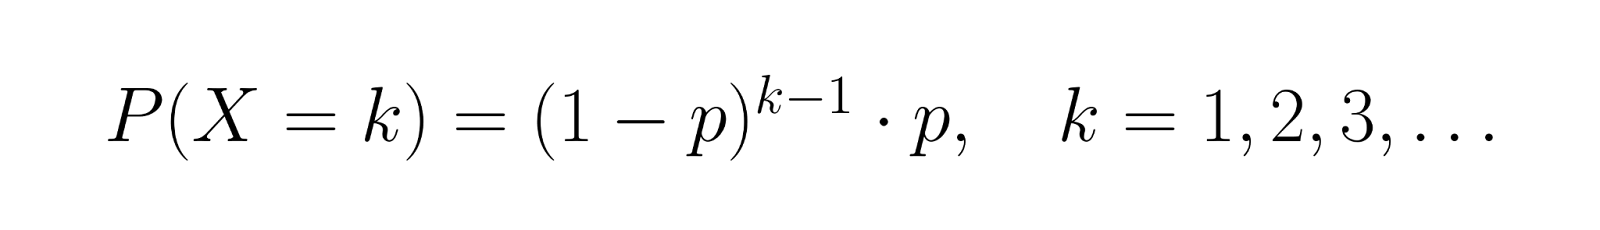
Questa formula calcola la probabilità di sperimentare esattamente k-1 fallimenti seguiti da un successo. Ad esempio, se p = 0,3, la probabilità di successo alla terza prova è P(X = 3) = (0,7)² × 0,3 = 0,147.
La funzione di distribuzione cumulativa (CDF) ci dà:
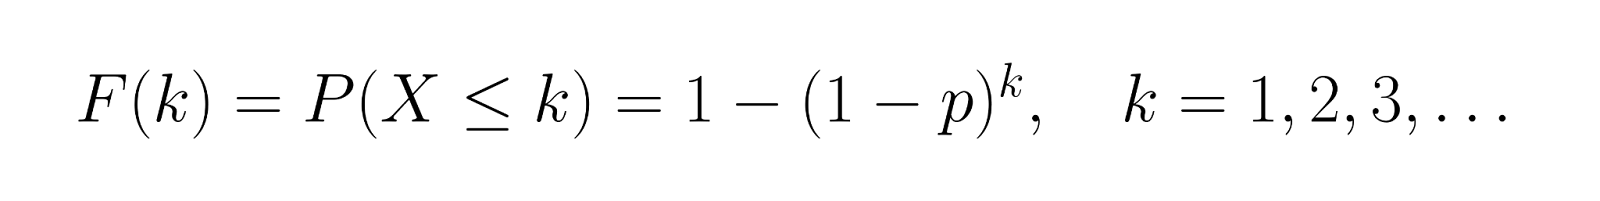
Questa rappresenta la probabilità di ottenere un successo entro k prove. Usando il nostro esempio con p = 0,3, calcoliamo la CDF per i primi valori:
Questo mostra che c'è il 30% di probabilità di successo alla prima prova, il 51% di probabilità di successo entro le prime due prove e il 65,7% entro le prime tre.
I pattern visivi della distribuzione geometrica mostrano intuizioni chiave sui scenari di "tempo di attesa". Questi grafici dimostrano come la probabilità si concentri nelle prime prove e diminuisca esponenzialmente, rendendo la distribuzione utile per modellare situazioni in cui il successo è più probabile prima che dopo.
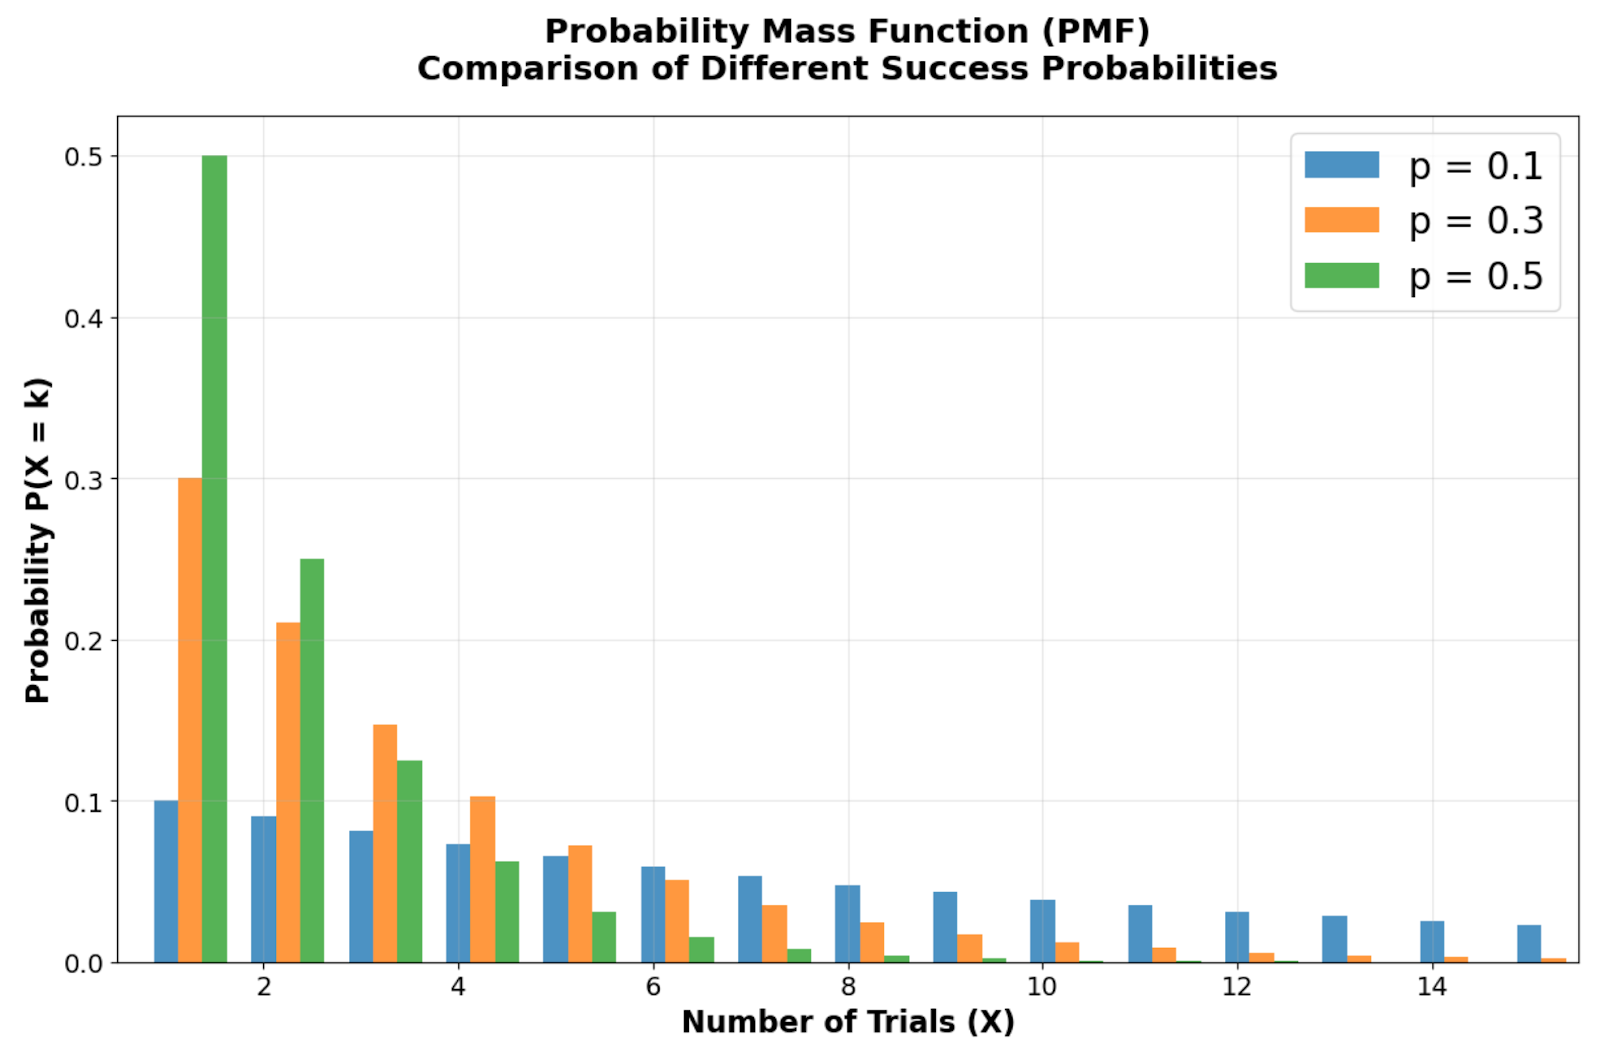
Confronto della funzione di massa di probabilità che mostra come diverse probabilità di successo (p = 0,1, 0,3, 0,5) influenzano la forma della distribuzione. Immagine dell'autore
Osservando il confronto della funzione di massa di probabilità al variare delle probabilità di successo, puoi vedere la caratteristica asimmetria a destra della distribuzione geometrica con la sua moda sempre in X = 1 (la prima prova). Nota come le barre di probabilità partano più alte alla prima prova e decrescano geometricamente per ciascuna prova successiva. Man mano che la probabilità di successo p diminuisce, la distribuzione si allarga, riflettendo tempi di attesa attesi più lunghi. Per esempio, con p = 0,1, c'è solo il 10% di probabilità di successo immediato, creando una coda destra più pronunciata rispetto a p = 0,5.
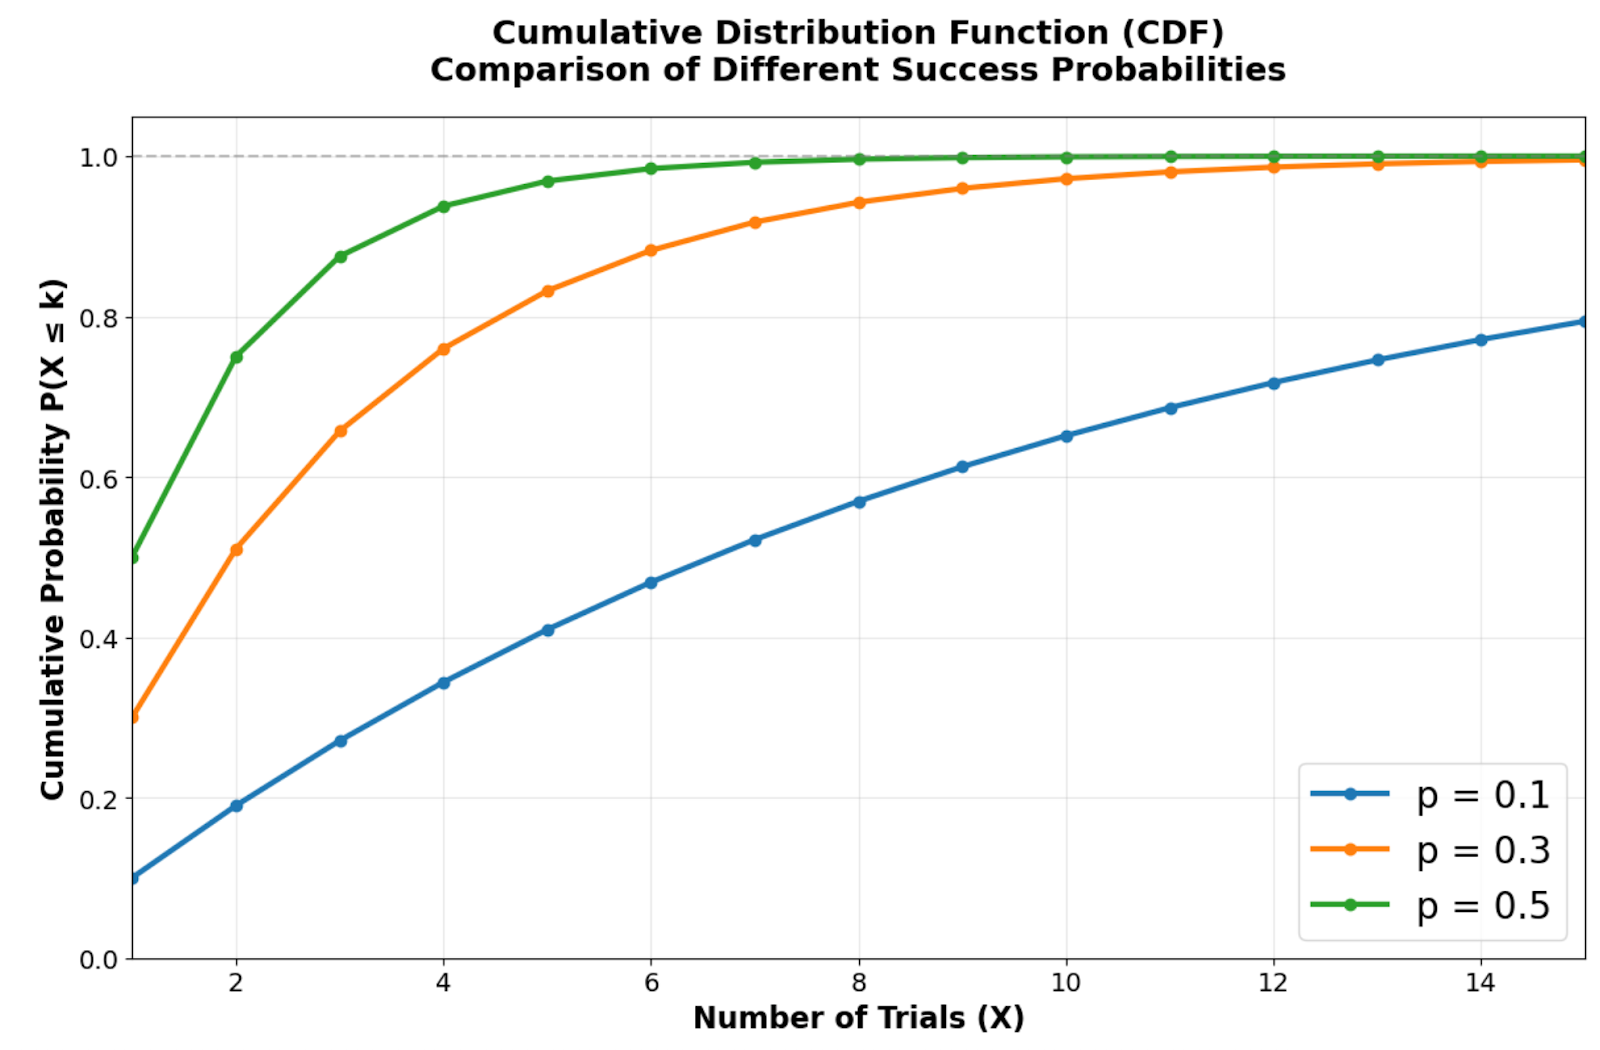
Funzione di distribuzione cumulativa che mostra quanto rapidamente diverse probabilità di successo si avvicinano alla certezza. Immagine dell'autore.
La funzione di distribuzione cumulativa dimostra con quale rapidità la distribuzione geometrica si avvicina alla certezza. Probabilità di successo più alte creano curve più ripide che raggiungono elevate probabilità cumulative in poche prove. Ad esempio, con p = 0,5, c'è circa il 75% di probabilità di successo entro le prime due prove, mentre p = 0,1 richiede molte più prove per raggiungere lo stesso livello di certezza.

Confronto affiancato che evidenzia il decadimento esponenziale nella PMF e l'approccio rapido alla certezza nella CDF. Immagine dell'autore.
Questo pattern di decadimento esponenziale spiega perché la distribuzione geometrica funziona bene per modellare scenari in cui il successo iniziale è più probabile di periodi di attesa prolungati. L'ascesa rapida della CDF verso 1 mostra perché questa distribuzione è efficace per modellare processi con tempi di attesa brevi, rendendola preziosa per il controllo qualità, l'analisi delle conversioni dei clienti e i test di affidabilità.
Puoi ricreare queste visualizzazioni ed esplorare diversi valori dei parametri usando le librerie scipy e matplotlib di Python. Ecco come generare le intuizioni visive chiave che evidenziano le caratteristiche più importanti della distribuzione geometrica:
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

# Create side-by-side plots for PMF and CDF
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(16, 6))
fig.suptitle('Geometric Distribution: Key Visual Insights', fontsize=24, fontweight='bold')

# Simple PMF showing exponential decay (using p = 0.3)
x_simple = np.arange(1, 11)
pmf_simple = stats.geom.pmf(x_simple, 0.3)

ax1.bar(x_simple, pmf_simple, alpha=0.8, color='steelblue', edgecolor='black', linewidth=1)
ax1.set_title('PMF: Exponential Decay Pattern', fontsize=18, fontweight='bold', pad=15)
ax1.set_xlabel('Number of Trials (X)', fontsize=17, fontweight='bold')
ax1.set_ylabel('Probability', fontsize=14, fontweight='bold')
ax1.grid(True, alpha=0.3)
ax1.tick_params(axis='both', which='major', labelsize=14)

# Simple CDF showing approach to 1
cdf_simple = stats.geom.cdf(x_simple, 0.3)

ax2.plot(x_simple, cdf_simple, 'o-', linewidth=4, markersize=8, color='darkgreen')
ax2.set_title('CDF: Rapid Approach to Certainty', fontsize=18, fontweight='bold', pad=15)
ax2.set_xlabel('Number of Trials (X)', fontsize=17, fontweight='bold')
ax2.set_ylabel('Cumulative Probability', fontsize=14, fontweight='bold')
ax2.grid(True, alpha=0.3)
ax2.set_ylim(0, 1.05)
ax2.tick_params(axis='both', which='major', labelsize=14)

plt.tight_layout()
plt.show()
Questo codice crea una visualizzazione mirata che enfatizza le due caratteristiche visive più importanti della distribuzione geometrica. Il pannello di sinistra mostra come le probabilità decadano esponenzialmente dalla prima prova, mentre quello di destra evidenzia l'accumulo rapido di massa di probabilità nella CDF.
Prova a cambiare la probabilità di successo da 0,3 a valori come 0,1 o 0,7 per vedere come cambia la forma della distribuzione. Probabilità più basse creano curve PMF più piatte e CDF che crescono più lentamente, mentre probabilità più alte portano a cali più ripidi e a un avvicinamento più rapido alla certezza.
La distribuzione geometrica ha una caratteristica unica che la distingue dalla maggior parte delle altre distribuzioni discrete.
La proprietà di assenza di memoria afferma che P(X > s + t | X > s) = P(X > t) per qualsiasi intero positivo s e t. Ciò significa che la probabilità di necessitare ulteriori prove non dipende da quante prove senza successo si sono già verificate.
Matematicamente, questa proprietà emerge perché P(X > k) = (1-p)k, rendendo il calcolo della probabilità condizionata lineare. In termini pratici, se hai già avuto cinque colloqui senza successo, la distribuzione di probabilità per i colloqui futuri resta identica a quando hai iniziato: i fallimenti passati non influenzano le probabilità future.
Ogni prova in un esperimento geometrico rappresenta una prova di Bernoulli indipendente con probabilità di successo costante p. La distribuzione geometrica modella la sequenza di queste prove fino al primo successo, diventando l'analogo discreto dei problemi di "tempo di attesa".
Questa relazione spiega perché la distribuzione geometrica compare spesso nel controllo qualità, dove ogni elemento testato rappresenta una prova di Bernoulli e si è interessati a rilevare il primo elemento difettoso. L'assunzione di indipendenza garantisce che trovare elementi difettosi nelle prime prove non cambi la probabilità di trovarne in quelle successive.
La distribuzione esponenziale è l'analogo continuo della distribuzione geometrica, e condividono entrambe la proprietà di assenza di memoria. Mentre la distribuzione geometrica modella tempi di attesa discreti (numero di prove), la distribuzione esponenziale modella tempi di attesa continui (tempo fino a un evento).
Entrambe le distribuzioni trovano applicazioni nell'analisi dell'affidabilità e nella teoria delle code. Ad esempio, la distribuzione geometrica può modellare il numero di richieste al server fino al primo guasto, mentre la distribuzione esponenziale modella il tempo fino al successivo guasto del server.
Con i concetti fondamentali e le proprietà uniche in mente, esploriamo gli strumenti matematici che consentono calcoli di probabilità precisi e decisioni informate. Queste formule e relazioni saranno essenziali quando applicherai la distribuzione geometrica a problemi reali.
Il valore atteso (media) della distribuzione geometrica è:
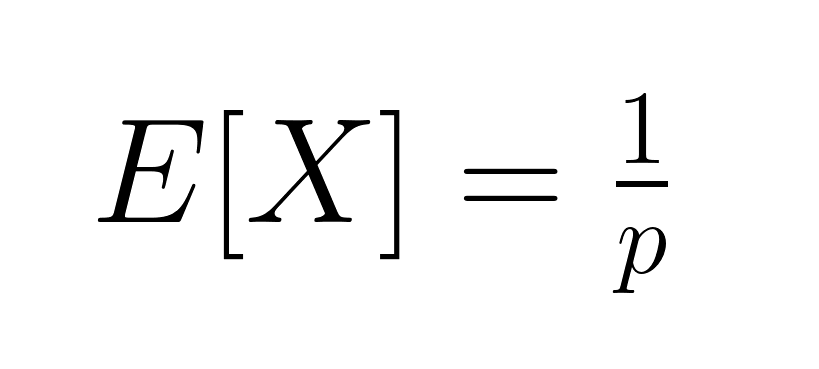
Questo rappresenta il numero medio di prove necessarie per il successo. La varianza è pari a:
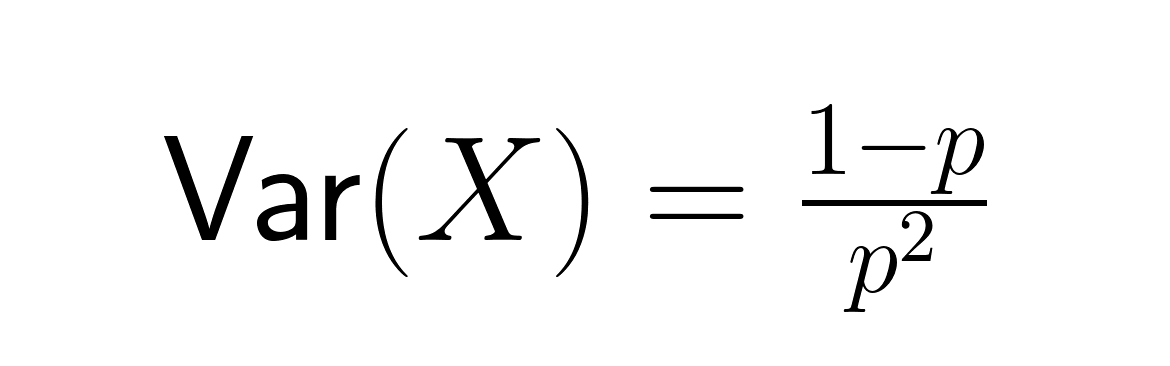
La deviazione standard è:
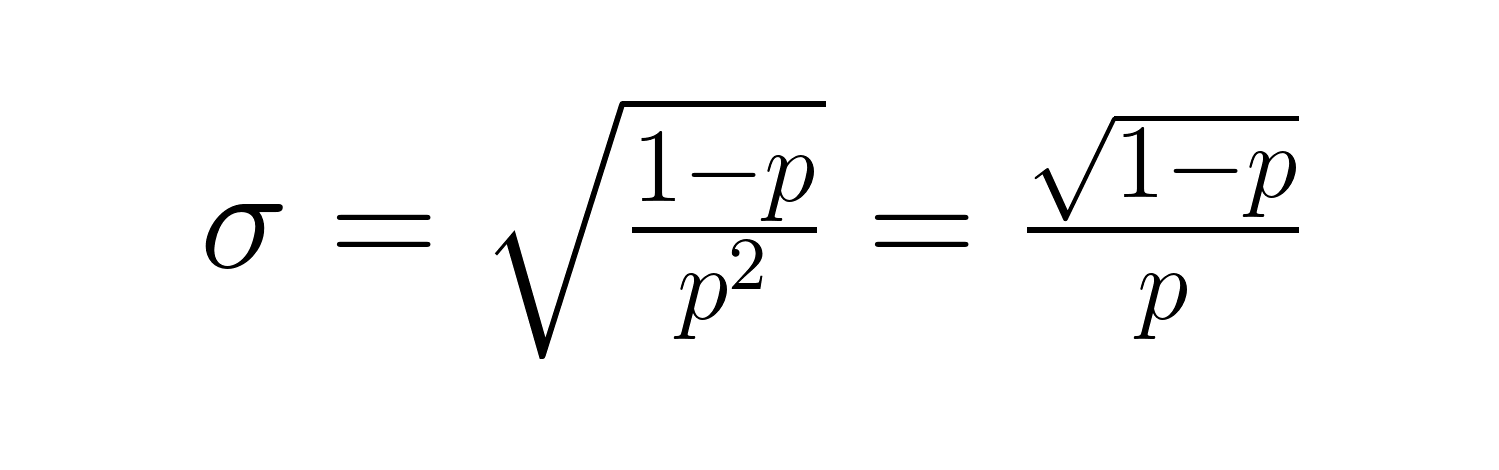
Queste formule rivelano relazioni importanti: al diminuire di p, aumentano significativamente sia il tempo di attesa atteso sia la variabilità. Ad esempio, con p = 0,2, il numero atteso di prove è 5, ma con p = 0,05, salta a 20 prove. La varianza cresce ancora più drasticamente, da 20 a 380.
Per analisi più avanzate, la funzione generatrice dei momenti (MGF) per la distribuzione geometrica è:
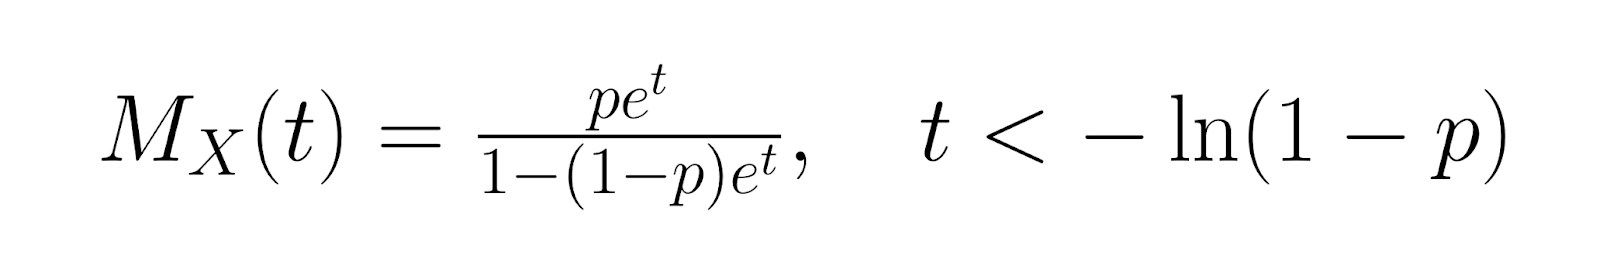 La funzione generatrice di probabilità (PGF) è:
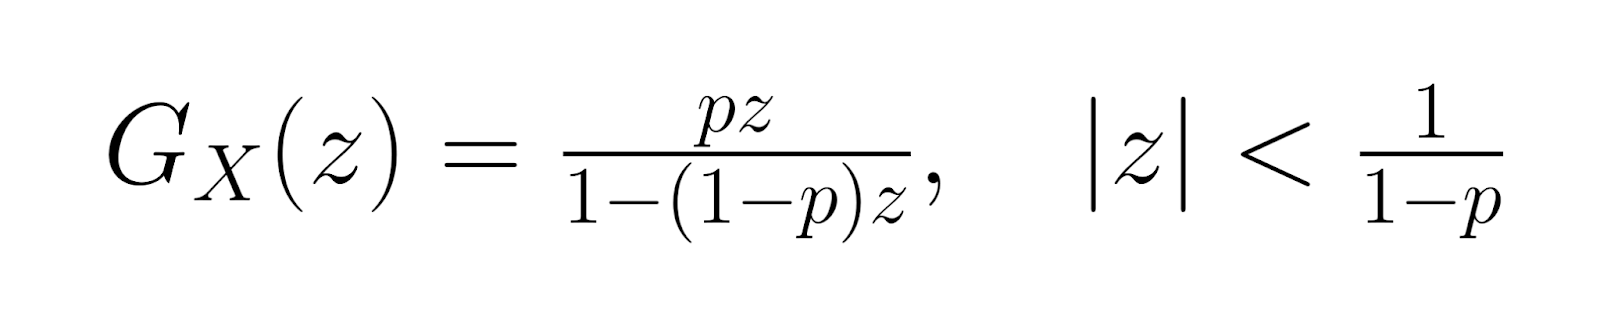
Queste funzioni generatrici aiutano nell'analisi statistica avanzata e forniscono metodi alternativi per derivare le proprietà della distribuzione. I momenti di ordine superiore possono essere calcolati usando le derivate di queste funzioni, consentendo una caratterizzazione completa della forma e del comportamento della distribuzione.
Entrando in un ambito più specialistico, l'entropia della distribuzione geometrica è pari a:
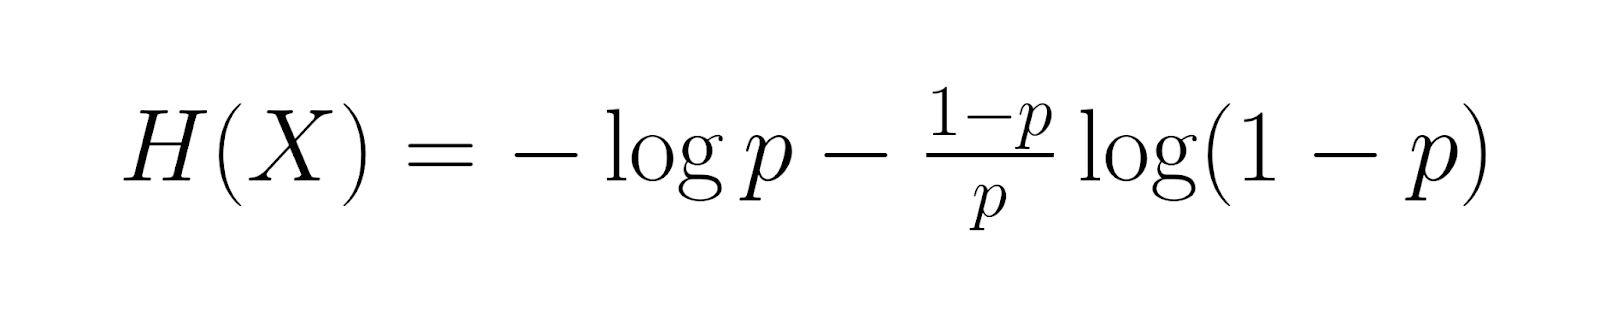
Questo misura il contenuto informativo medio. L'informazione di Fisher, data da:
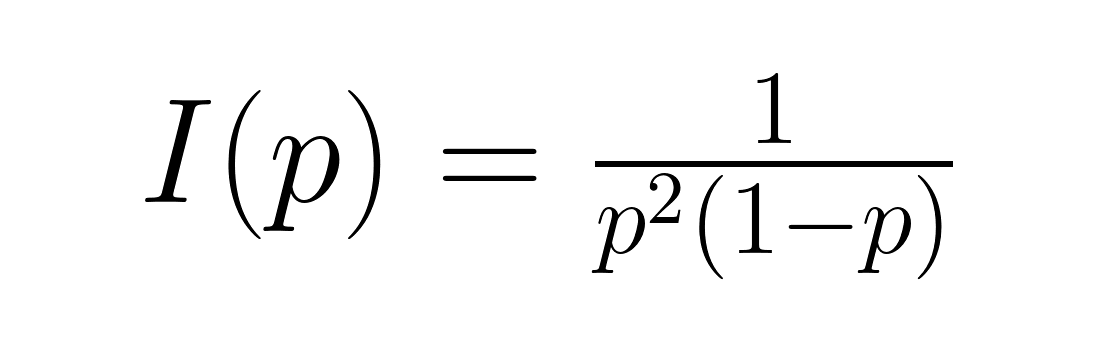
Quantifica la quantità di informazione sul parametro p contenuta nei dati. Queste misure sono preziose nelle applicazioni della teoria dell'informazione e nel design sperimentale ottimale, dove comprendere il contenuto informativo aiuta a determinare dimensioni campionarie adeguate e procedure di stima.
Stimare la probabilità di successo p a partire dai dati osservati richiede di comprendere diversi approcci statistici e i loro compromessi.
L'approccio della massima verosimiglianza individua la probabilità di successo che rende i tuoi dati osservati i più probabili. Per calcolare questa stima, dividi il numero totale di eventi di successo per la somma di tutte le prove nelle tue osservazioni. Questo stimatore fornisce risultati non distorti ed è efficiente con campioni di grandi dimensioni.
Ecco come funziona in pratica: se osservi il successo dopo 3, 7, 2 e 8 prove rispettivamente, calcoli la MLE prendendo le tue 4 osservazioni e dividendole per il totale di 20 prove (3+7+2+8), ottenendo una probabilità di successo stimata di 0,2 ovvero il 20%. L'approccio MLE massimizza la verosimiglianza di osservare i dati effettivi raccolti, rendendolo il metodo statisticamente più efficiente in condizioni standard.
Come approccio alternativo, lo stimatore del metodo dei momenti funziona eguagliando la tua media campionaria alla media teorica della distribuzione geometrica. Poiché la media teorica è pari a uno diviso la probabilità di successo, puoi stimare la probabilità di successo prendendo uno diviso la tua media campionaria. Sebbene questo metodo offra semplicità computazionale rispetto alla MLE, può essere meno efficiente dal punto di vista statistico e talvolta produrre stime al di fuori dell'intervallo valido di probabilità tra zero e uno.
Entrambi i metodi producono risultati simili con campioni grandi, ma la MLE offre generalmente proprietà statistiche superiori. La scelta tra i metodi spesso dipende da vincoli computazionali e dai requisiti specifici dell'analisi.
Quando disponi di informazioni a priori sulla probabilità di successo, la stima bayesiana ti permette di incorporare questa conoscenza tramite una distribuzione a priori. La distribuzione Beta è comunemente usata come prior perché si combina bene matematicamente con i dati di distribuzione geometrica. L'approccio bayesiano unisce le tue convinzioni a priori con i dati osservati per produrre stime aggiornate del parametro tramite la cosiddetta distribuzione a posteriori.
La relazione matematica crea una distribuzione Beta aggiornata che incorpora sia le tue conoscenze pregresse sia le nuove osservazioni. Questo approccio funziona particolarmente bene quando hai pochi dati disponibili o quando vuoi incorporare conoscenze esperte sul processo modellato. Ad esempio, se sai per esperienza nel settore che i tassi di successo rientrano tipicamente in un certo intervallo, puoi incorporare questa conoscenza per migliorare le stime anche con campioni piccoli.
La distribuzione geometrica trova ampio utilizzo in vari settori e contesti analitici in cui la modellazione degli eventi di primo successo offre insight.
I processi manifatturieri usano spesso la distribuzione geometrica per modellare il rilevamento dei difetti e l'analisi dei guasti dei componenti. Gli ispettori di controllo qualità possono stimare il numero atteso di articoli da ispezionare prima di trovare un'unità difettosa, aiutando a ottimizzare le procedure di ispezione e l'allocazione delle risorse.
Per esempio, se i dati storici mostrano un tasso di difetti del 2%, la distribuzione geometrica prevede in media 50 articoli ispezionati prima di trovare il primo difetto. Queste informazioni aiutano a determinare dimensioni dei lotti e frequenze di ispezione appropriate per mantenere gli standard di qualità riducendo al minimo i costi.
I team marketing applicano la distribuzione geometrica per modellare i processi di conversione dei clienti, stimando quanti contatti o annunci sono necessari prima di ottenere una vendita. Questa analisi informa le decisioni sull'allocazione del budget e sulle strategie di campagna.
Nelle telecomunicazioni, gli ingegneri di rete usano la distribuzione geometrica per modellare i tassi di successo della trasmissione dei pacchetti e ottimizzare i meccanismi di ritrasmissione. Comprendere il numero atteso di tentativi di trasmissione aiuta a progettare protocolli efficienti e a migliorare le prestazioni complessive della rete.
Gli analisti sportivi usano la distribuzione geometrica per modellare eventi di punteggio, come il numero di tentativi necessari a un giocatore di basket per realizzare la sua prima tripla in una partita. Questa analisi contribuisce alle decisioni strategiche e alla valutazione delle prestazioni.
Le applicazioni nel gaming includono il modellare il numero di tentativi necessari per ottenere eventi rari o completare livelli impegnativi. Le piattaforme online usano queste intuizioni per bilanciare la difficoltà del gioco e mantenere il coinvolgimento dei giocatori attraverso strutture di ricompensa adeguate.
Considera uno scenario in cui una campagna di marketing ha un tasso di conversione del 15%. Per trovare la probabilità di ottenere la prima conversione al 5º contatto: P(X = 5) = (0,85)⁴ × 0,15 = 0,0783, circa il 7,83%.
Per esercizio, calcola la probabilità che un ispettore di controllo qualità trovi il primo articolo difettoso entro le prime 10 ispezioni, dato un tasso di difetti dell'8%. Usa la formula della CDF: P(X ≤ 10) = 1 - (0,92)¹⁰ = 0,5656, ovvero circa il 56,56%.
Comprendere quando la distribuzione geometrica si applica correttamente richiede di riconoscerne le assunzioni sottostanti e le potenziali limitazioni.
La distribuzione geometrica assume prove indipendenti con probabilità di successo costante, cosa che può non valere in molti scenari reali. Ad esempio, il comportamento dei clienti spesso mostra dipendenza: le interazioni precedenti possono influenzare le probabilità di conversione future. Allo stesso modo, i sistemi meccanici possono subire usura che modifica i tassi di guasto nel tempo.
Le violazioni di queste assunzioni possono portare a predizioni inaccurate e a decisioni errate. Chi lavora con i dati dovrebbe validare le assunzioni di indipendenza tramite test statistici e considerare modelli alternativi quando vengono rilevate dipendenze. Alternative comuni includono la distribuzione binomiale negativa per dati sovradispersi o modelli a catena di Markov per prove dipendenti.
Capire la distribuzione geometrica va oltre la teoria: ti permette di prendere decisioni informate su allocazione delle risorse, ottimizzazione dei processi e valutazione dei rischi. Che tu stia progettando procedure di controllo qualità o ottimizzando campagne marketing, questa distribuzione offre insight quantitativi che portano a risultati migliori.
Per continuare ad apprendere, esplora il nostro corso Multivariate Probability Distributions in R per capire come la distribuzione geometrica si relazioni ad altri modelli di probabilità, oppure approfondisci le tecniche di stima con il corso Generalized Linear Models in R per applicazioni di modellazione avanzata.
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min



