
Last chance! 50% off DataCamp Premium
Sale ends in
अपने सपनों की नौकरी पाने से पहले आपको कितने जॉब इंटरव्यू देने पड़ सकते हैं? किसी मार्केटिंग अभियान को पहली बिक्री देने में कितने प्रयास लगते हैं? ज्यामितीय वितरण ऐसे "प्रतीक्षा समय" वाले प्रश्नों के उत्तर देता है—यह पहली सफलता होने तक आवश्यक परीक्षणों की संख्या का मॉडल बनाता है।
यह मार्गदर्शिका ज्यामितीय वितरण की गणितीय नींव, इसकी विशिष्ट विशेषताओं, और व्यावहारिक अनुप्रयोगों को कवर करती है, जो क्रमिक परीक्षण परिदृश्यों में काम करने वालों के लिए इसे मूल्यवान बनाती हैं। प्रायिकता वितरणों का पुनर्स्मरण चाहिए तो हमारा Introduction to Statistics पाठ्यक्रम देखें।
ज्यामितीय वितरण एक विविक्त प्रायिकता वितरण है जो पहली सफलता प्राप्त करने के लिए आवश्यक स्वतंत्र बर्नौली परीक्षणों की संख्या का मॉडल बनाता है। प्रत्येक परीक्षण में सफलता की समान प्रायिकता होती है, और सभी परीक्षण एक-दूसरे से स्वतंत्र होते हैं।
यह वितरण दो सामान्य रूपों में आता है: एक जो पहली सफलता तक कुल परीक्षणों की संख्या गिनता है (सफलता सहित), और दूसरा जो पहली सफलता से पहले केवल विफलताओं की संख्या गिनता है। विशिष्ट अनुप्रयोग के अनुसार दोनों रूपों का व्यापक उपयोग होता है। इस मार्गदर्शिका में हम पहले रूप का प्रयोग करेंगे, यानी पहली सफलता तक कुल परीक्षणों की संख्या गिनना, जहाँ X के मान 1, 2, 3, इत्यादि हो सकते हैं।
आइए इस वितरण की गणितीय संरचना और विशेषताओं की जाँच करें जो इसे परिभाषित करती हैं।
ज्यामितीय वितरण के लिए तीन मुख्य शर्तें आवश्यक हैं: स्वतंत्र परीक्षण, सभी परीक्षणों में सफलता की समान प्रायिकता, और एक नियत प्रायिकता p जहाँ 0 < p ≤ 1। मानक संकेतन में सफलता की प्रायिकता के लिए p और विफलता की प्रायिकता के लिए q = 1-p का उपयोग होता है।
पहली सफलता तक परीक्षणों की संख्या X के लिए प्रायिकता द्रव्यमान फलन (PMF) है:
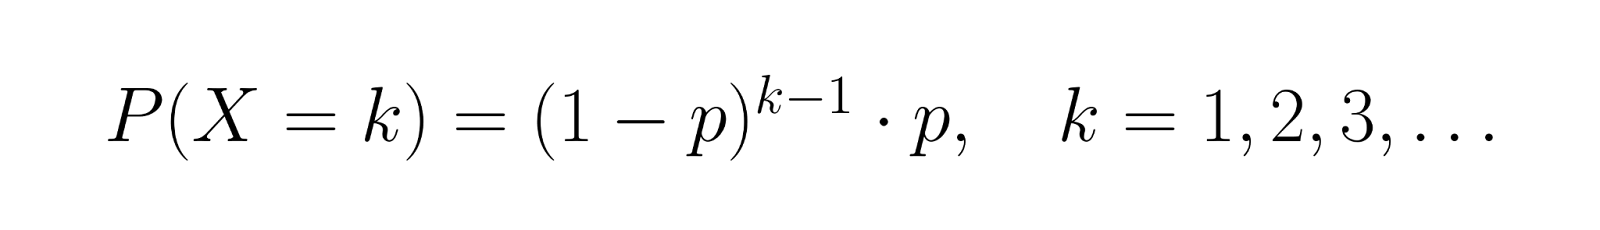
यह सूत्र ठीक k-1 विफलताओं के बाद एक सफलता होने की प्रायिकता की गणना करता है। उदाहरण के लिए, यदि p = 0.3 है, तो तीसरे परीक्षण में सफलता की प्रायिकता है P(X = 3) = (0.7)² × 0.3 = 0.147।
संचयी वितरण फलन (CDF) हमें देता है:
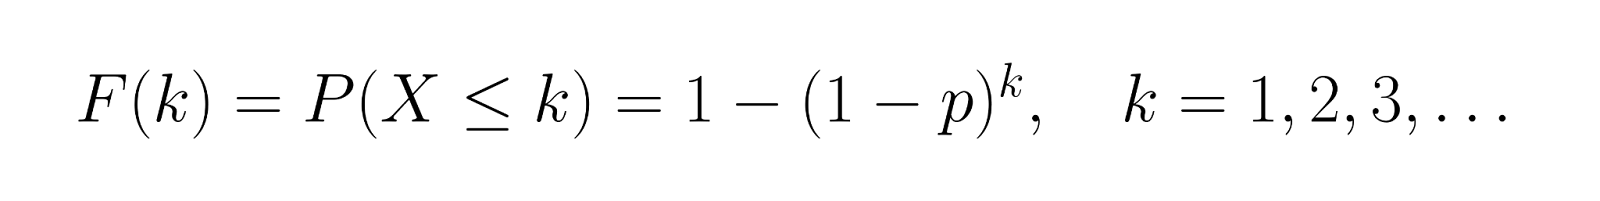
यह k परीक्षणों के भीतर सफलता प्राप्त करने की प्रायिकता दर्शाता है। हमारे उदाहरण p = 0.3 का उपयोग करते हुए, पहले कुछ मानों के लिए CDF गणना करें:
यह दर्शाता है कि पहले परीक्षण में सफलता की 30% संभावना है, पहले दो परीक्षणों के भीतर सफलता की 51% संभावना है, और पहले तीन परीक्षणों के भीतर सफलता की 65.7% संभावना है।
ज्यामितीय वितरण के दृश्य पैटर्न "प्रतीक्षा समय" परिदृश्यों के बारे में प्रमुख अंतर्दृष्टियाँ दिखाते हैं। ये ग्राफ बताते हैं कि प्रायिकता शुरुआती परीक्षणों में केंद्रित होती है और घातीय रूप से घटती है, जिससे यह वितरण उन स्थितियों को मॉडल करने में उपयोगी बनता है जहाँ जल्दी सफलता मिलने की संभावना अधिक होती है।
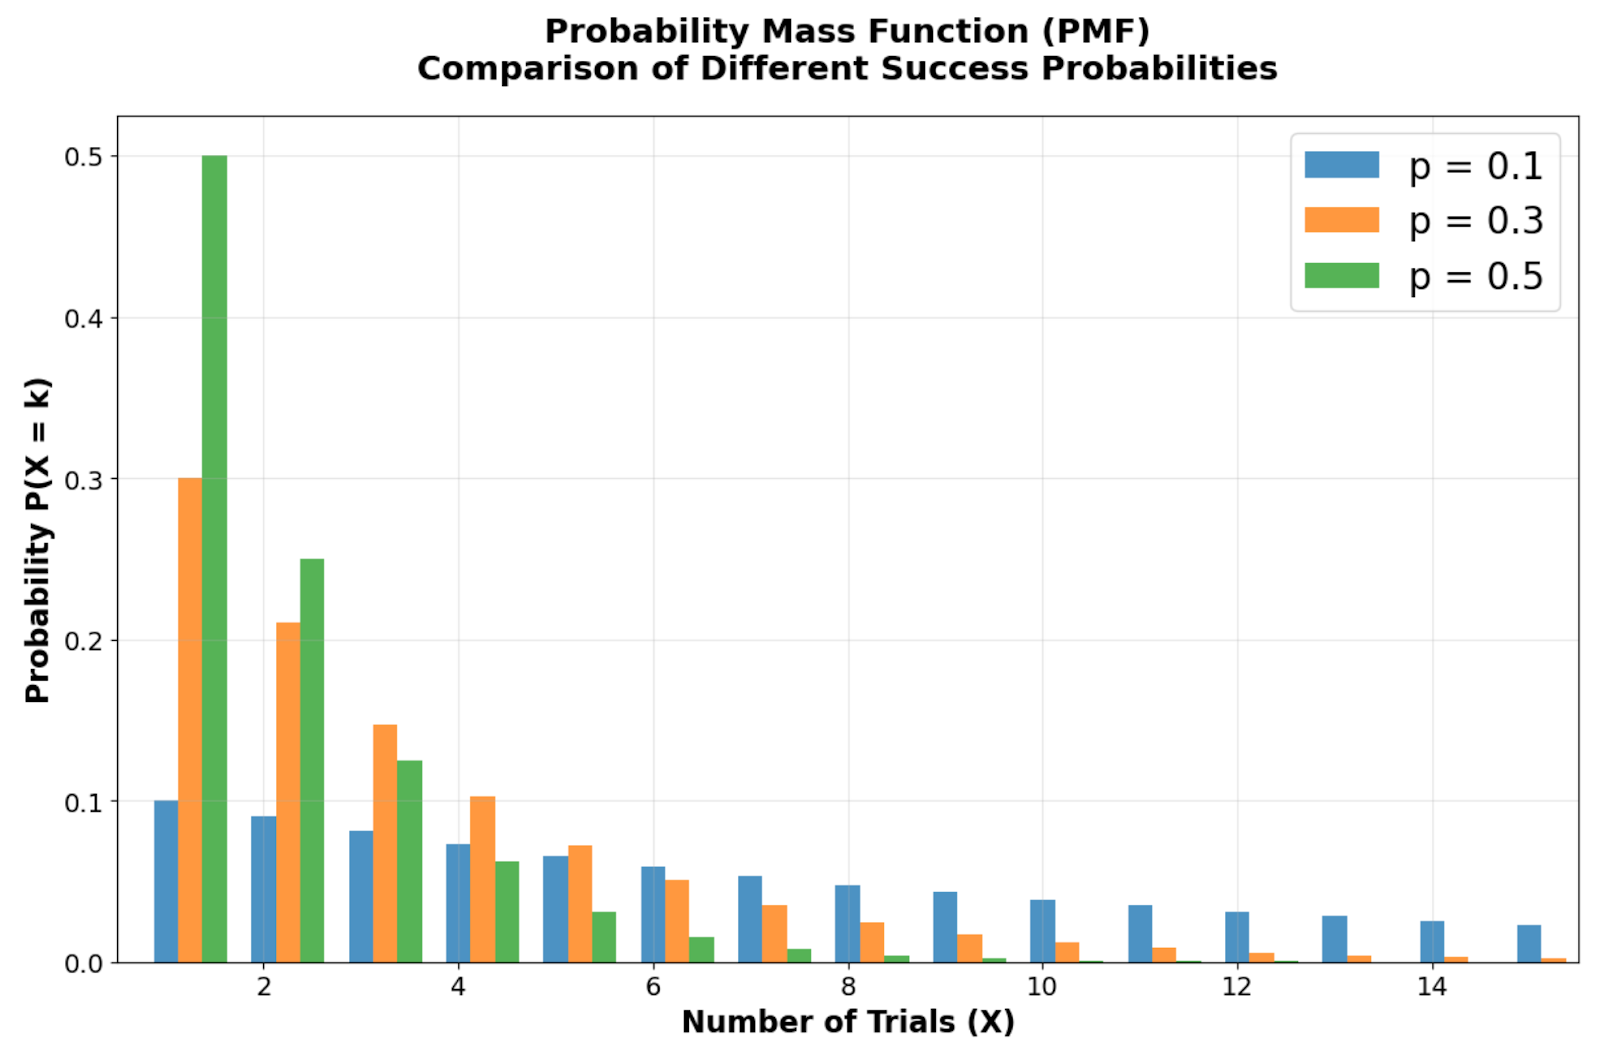
प्रायिकता द्रव्यमान फलन की तुलना, यह दर्शाते हुए कि अलग-अलग सफलता प्रायिकताएँ (p = 0.1, 0.3, 0.5) वितरण के आकार को कैसे प्रभावित करती हैं। चित्र: लेखक
विभिन्न सफलता प्रायिकताओं के पार PMF की तुलना देखते हुए, आप ज्यामितीय वितरण का विशिष्ट दाएँ-पुच्छला आकार देख सकते हैं, जिसका मोड हमेशा X = 1 (पहला परीक्षण) पर होता है। ध्यान दें कि पहले परीक्षण पर प्रायिकता स्तंभ सबसे ऊँचा होता है और प्रत्येक अगले परीक्षण के लिए ज्यामितीय रूप से घटता है। जैसे-जैसे सफलता प्रायिकता p कम होती है, वितरण अधिक फैल जाता है, जो लंबी अपेक्षित प्रतीक्षा समय को दर्शाता है। उदाहरण के लिए, p = 0.1 पर तत्काल सफलता की केवल 10% संभावना होती है, जिससे p = 0.5 की तुलना में अधिक स्पष्ट दायाँ पुच्छ बनता है।
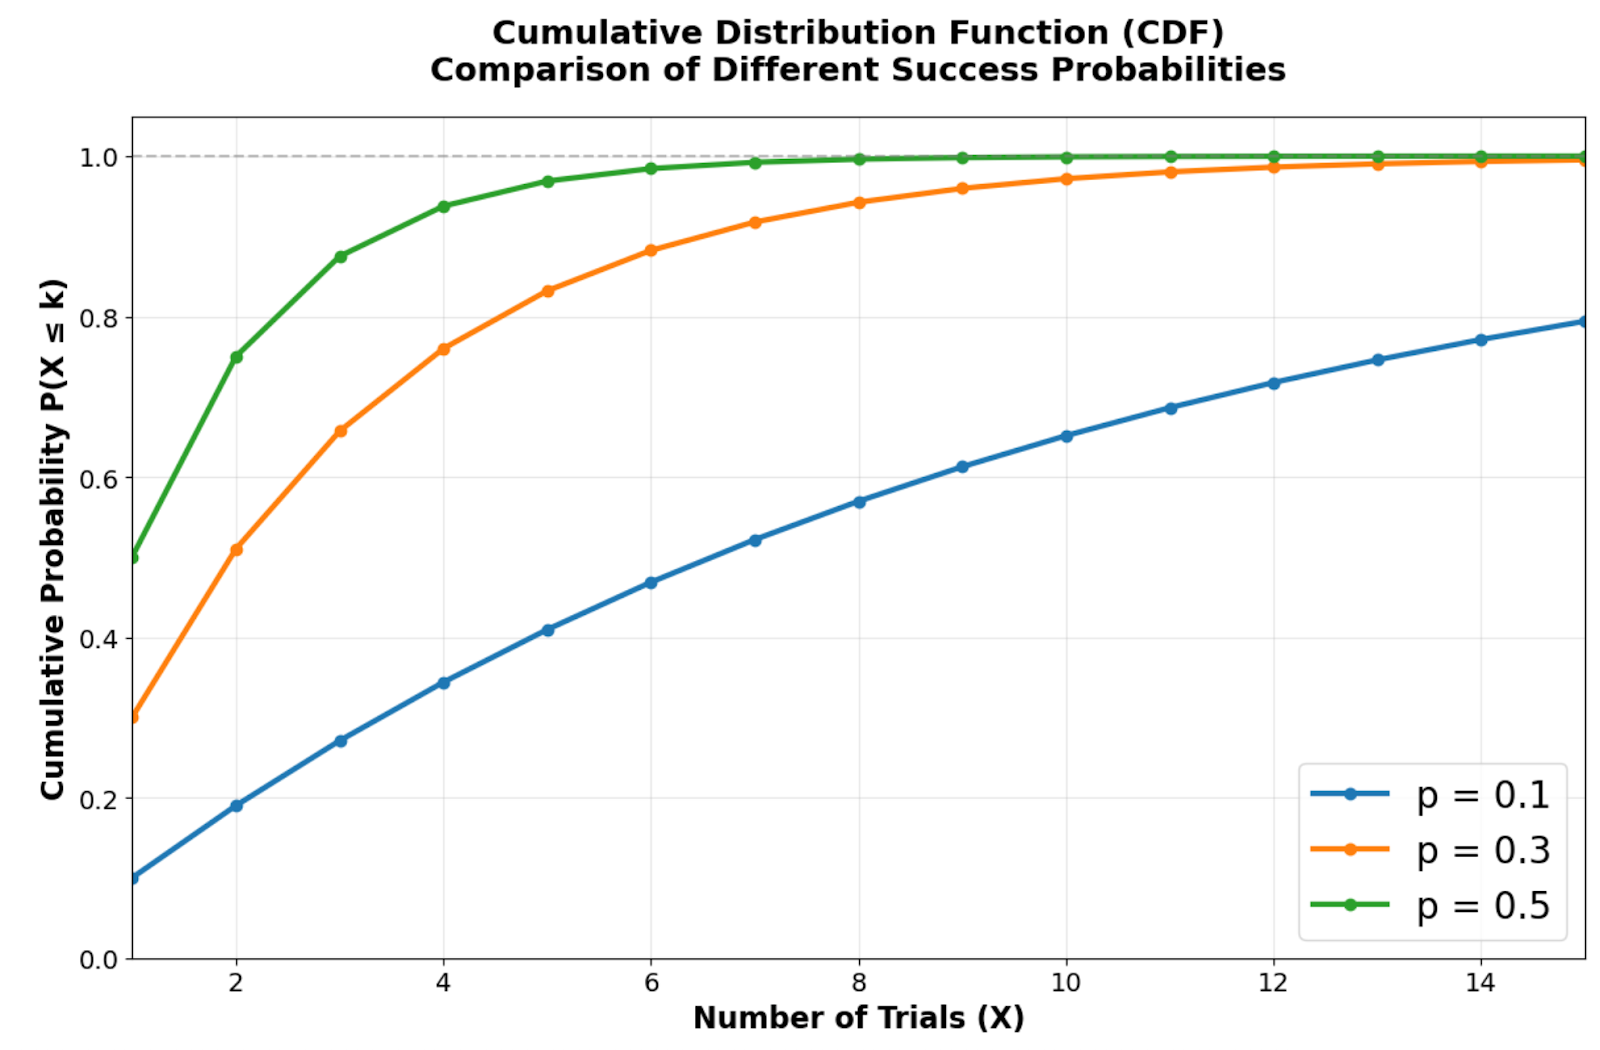
संचयी वितरण फलन, यह दिखाते हुए कि अलग-अलग सफलता प्रायिकताएँ कितनी तेजी से निश्चितता तक पहुँचती हैं। चित्र: लेखक।
संचयी वितरण फलन दर्शाता है कि ज्यामितीय वितरण कितनी जल्दी निश्चितता के करीब आता है। अधिक सफलता प्रायिकताएँ तेज ढलान वाली वक्र बनाती हैं जो कुछ ही परीक्षणों में उच्च संचयी प्रायिकता तक पहुँच जाती हैं। उदाहरण के लिए, p = 0.5 पर पहले दो परीक्षणों के भीतर लगभग 75% सफलता की संभावना होती है, जबकि p = 0.1 पर उसी स्तर की निश्चितता तक पहुँचने के लिए काफी अधिक परीक्षणों की आवश्यकता होती है।

साथ-साथ तुलना जो PMF में घातीय क्षय पैटर्न और CDF में निश्चितता की ओर तेज़ी से बढ़ने को रेखांकित करती है। चित्र: लेखक।
यह घातीय क्षय पैटर्न बताता है कि ज्यामितीय वितरण उन परिदृश्यों के मॉडलिंग में क्यों अच्छा काम करता है जहाँ लंबी प्रतीक्षा अवधि की तुलना में शुरुआती सफलता अधिक संभावित होती है। CDF का 1 की ओर तेज़ आरोह दिखाता है कि यह वितरण उन प्रक्रियाओं के लिए प्रभावी है जहाँ प्रतीक्षा समय कम होता है—जिससे यह गुणवत्ता नियंत्रण, ग्राहक रूपांतरण विश्लेषण, और विश्वसनीयता परीक्षण परिदृश्यों के लिए मूल्यवान बनता है।
आप Python की scipy और matplotlib लाइब्रेरी का उपयोग करके इन दृश्यावलोकनों को पुनः बना सकते हैं और विभिन्न पैरामीटर मानों का अन्वेषण कर सकते हैं। यहाँ बताया गया है कि ज्यामितीय वितरण की सबसे महत्वपूर्ण विशेषताओं को उजागर करने वाली प्रमुख दृश्य अंतर्दृष्टियाँ कैसे उत्पन्न करें:
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

# Create side-by-side plots for PMF and CDF
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(16, 6))
fig.suptitle('Geometric Distribution: Key Visual Insights', fontsize=24, fontweight='bold')

# Simple PMF showing exponential decay (using p = 0.3)
x_simple = np.arange(1, 11)
pmf_simple = stats.geom.pmf(x_simple, 0.3)

ax1.bar(x_simple, pmf_simple, alpha=0.8, color='steelblue', edgecolor='black', linewidth=1)
ax1.set_title('PMF: Exponential Decay Pattern', fontsize=18, fontweight='bold', pad=15)
ax1.set_xlabel('Number of Trials (X)', fontsize=17, fontweight='bold')
ax1.set_ylabel('Probability', fontsize=14, fontweight='bold')
ax1.grid(True, alpha=0.3)
ax1.tick_params(axis='both', which='major', labelsize=14)

# Simple CDF showing approach to 1
cdf_simple = stats.geom.cdf(x_simple, 0.3)

ax2.plot(x_simple, cdf_simple, 'o-', linewidth=4, markersize=8, color='darkgreen')
ax2.set_title('CDF: Rapid Approach to Certainty', fontsize=18, fontweight='bold', pad=15)
ax2.set_xlabel('Number of Trials (X)', fontsize=17, fontweight='bold')
ax2.set_ylabel('Cumulative Probability', fontsize=14, fontweight='bold')
ax2.grid(True, alpha=0.3)
ax2.set_ylim(0, 1.05)
ax2.tick_params(axis='both', which='major', labelsize=14)

plt.tight_layout()
plt.show()
यह कोड एक केंद्रित दृश्यावलोकन बनाता है जो ज्यामितीय वितरण की दो सबसे महत्वपूर्ण दृश्य विशेषताओं पर जोर देता है। बायाँ पैनल दिखाता है कि प्रायिकताएँ पहले परीक्षण से कैसे घातीय रूप से घटती हैं, जबकि दायाँ पैनल CDF में प्रायिकता द्रव्यमान के त्वरित संचय को दर्शाता है।
सफलता प्रायिकता को 0.3 से बदलकर 0.1 या 0.7 जैसे मानों पर आज़माएँ और देखें कि वितरण का आकार कैसे बदलता है। कम प्रायिकताएँ सपाट PMF वक्र और धीरे-धीरे उठने वाले CDF बनाती हैं, जबकि अधिक प्रायिकताएँ तेज़ी से गिरावट और निश्चितता की ओर तीव्र गति दिखाती हैं।
ज्यामितीय वितरण की एक अनोखी विशेषता है जो इसे अधिकांश अन्य विविक्त वितरणों से अलग करती है।
स्मृतिहीनता का गुण बताता है कि किसी भी धन पूर्णांकों s और t के लिए P(X > s + t | X > s) = P(X > t)। इसका अर्थ है कि अतिरिक्त परीक्षणों की आवश्यकता की प्रायिकता इस पर निर्भर नहीं करती कि अब तक कितने असफल परीक्षण हो चुके हैं।
गणितीय रूप से, यह गुण इसलिए आता है क्योंकि P(X > k) = (1-p)k होता है, जिससे सशर्त प्रायिकता की गणना सीधी हो जाती है। व्यावहारिक रूप से, यदि आपने पहले ही पाँच असफल जॉब इंटरव्यू दे दिए हैं, तो भविष्य के इंटरव्यू के लिए प्रायिकता वितरण वही रहता है जो शुरुआत में था—बीती विफलताएँ भविष्य की प्रायिकताओं को प्रभावित नहीं करतीं।
ज्यामितीय प्रयोग में प्रत्येक परीक्षण एक स्वतंत्र बर्नौली परीक्षण का प्रतिनिधित्व करता है जिसमें सफलता की नियत प्रायिकता p होती है। ज्यामितीय वितरण इन परीक्षणों के क्रम को पहली सफलता तक मॉडल करता है, जिससे यह "प्रतीक्षा समय" समस्याओं का विविक्त समकक्ष बनता है।
यह संबंध बताता है कि गुणवत्ता नियंत्रण में ज्यामितीय वितरण बार-बार क्यों दिखता है, जहाँ प्रत्येक जाँची गई वस्तु एक बर्नौली परीक्षण होती है और हमें पहली दोषपूर्ण वस्तु का पता लगाने में रुचि होती है। स्वतंत्रता की धारणा सुनिश्चित करती है कि शुरुआती परीक्षणों में दोष मिलना बाद के परीक्षणों में दोष मिलने की प्रायिकता को नहीं बदलता।
द घातीय वितरण ज्यामितीय वितरण का सतत समकक्ष है—दोनों में स्मृतिहीनता का गुण साझा होता है। जहाँ ज्यामितीय वितरण विविक्त प्रतीक्षा समय (परीक्षणों की संख्या) को मॉडल करता है, वहीं घातीय वितरण सतत प्रतीक्षा समय (किसी घटना तक का समय) को मॉडल करता है।
दोनों वितरण विश्वसनीयता विश्लेषण और कतार सिद्धांत में प्रयुक्त होते हैं। उदाहरणस्वरूप, ज्यामितीय वितरण सर्वर अनुरोधों की संख्या का मॉडल कर सकता है जब तक पहली विफलता होती है, जबकि घातीय वितरण अगली सर्वर विफलता तक के समय का मॉडल करता है।
मौलिक अवधारणाएँ और विशिष्ट गुण समझने के बाद, आइए उन गणितीय औज़ारों का अन्वेषण करें जो सटीक प्रायिकता गणना और सूचित निर्णय लेने में सक्षम बनाते हैं। ये सूत्र और संबंध वास्तविक दुनिया की समस्याओं में ज्यामितीय वितरण लागू करते समय आवश्यक सिद्ध होंगे।
ज्यामितीय वितरण का अपेक्षित मान (औसत) है:
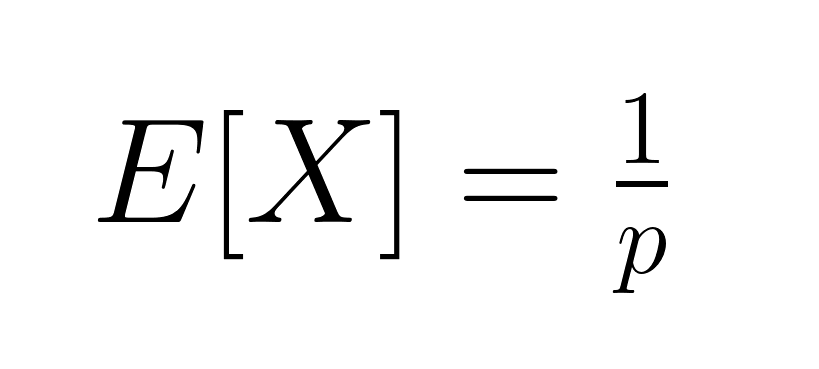
यह सफलता के लिए आवश्यक परीक्षणों की औसत संख्या दर्शाता है। प्रसरण (वैरिएंस) होता है:
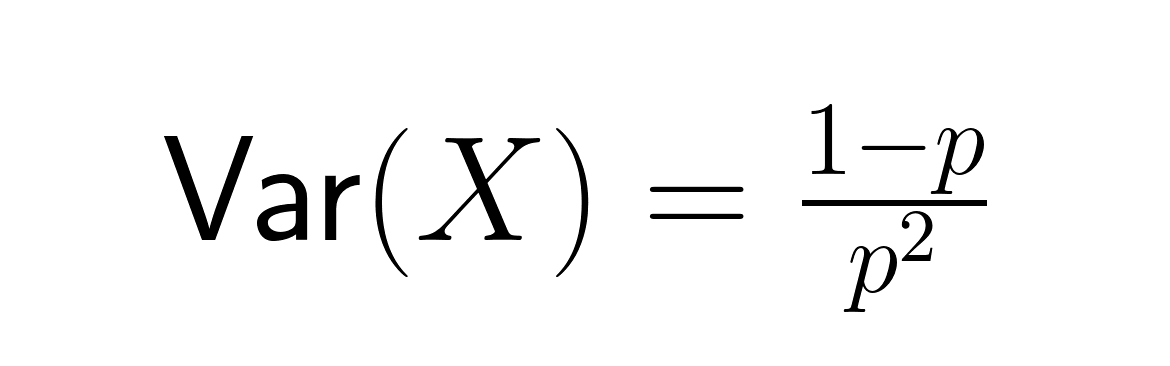
मानक विचलन है:
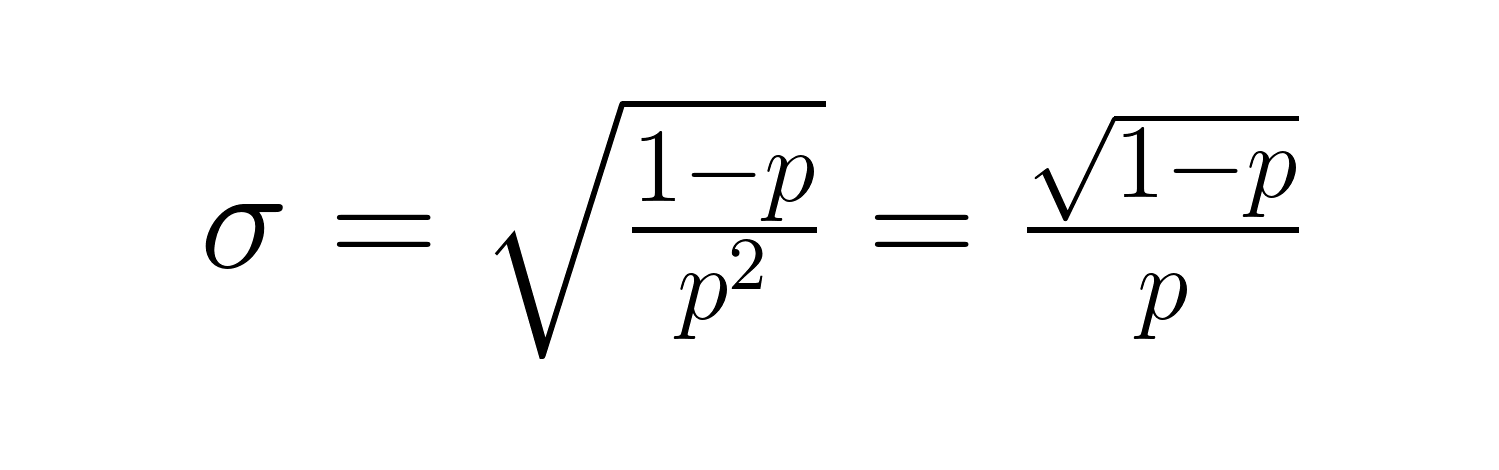
ये सूत्र महत्वपूर्ण संबंध प्रकट करते हैं: जैसे-जैसे p घटता है, अपेक्षित प्रतीक्षा समय और परिवर्तनशीलता दोनों उल्लेखनीय रूप से बढ़ते हैं। उदाहरण के लिए, p = 0.2 पर अपेक्षित परीक्षणों की संख्या 5 है, परंतु p = 0.05 होने पर यह 20 परीक्षणों तक बढ़ जाती है। प्रसरण और भी अधिक नाटकीय रूप से बढ़ता है—20 से 380 तक।
उन्नत विश्लेषण के लिए, ज्यामितीय वितरण का मोमेंट जनरेटिंग फंक्शन (MGF) है:
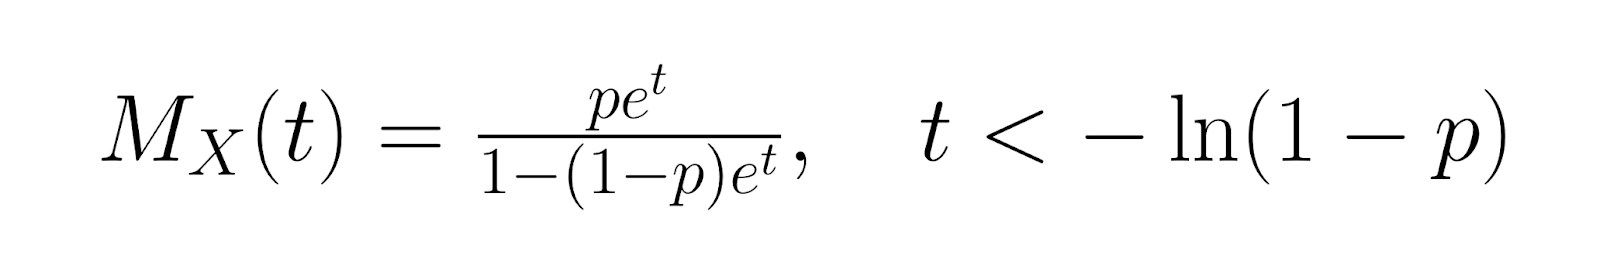 प्रायिकता जनरेटिंग फंक्शन (PGF) है:
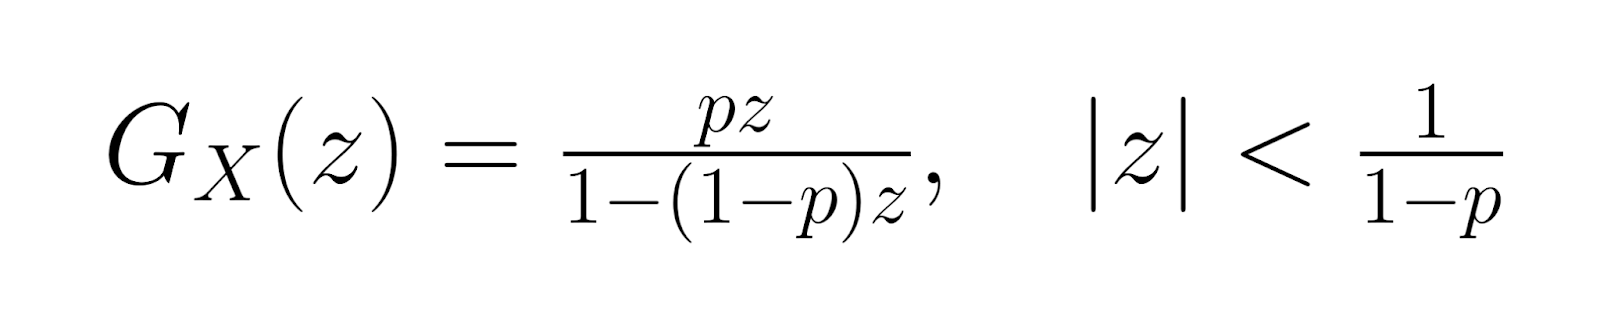
ये जनरेटिंग फंक्शंस उन्नत सांख्यिकीय विश्लेषण में सहायक हैं और वितरण के गुण निकालने के वैकल्पिक तरीके प्रदान करते हैं। उच्च-क्रम के मॉमेंट्स इन फंक्शंस के अवकलजों से निकाले जा सकते हैं, जिससे वितरण के आकार और व्यवहार का व्यापक वर्णन संभव होता है।
और अधिक विशिष्ट क्षेत्र में जाते हुए, ज्यामितीय वितरण की एंट्रोपी होती है:
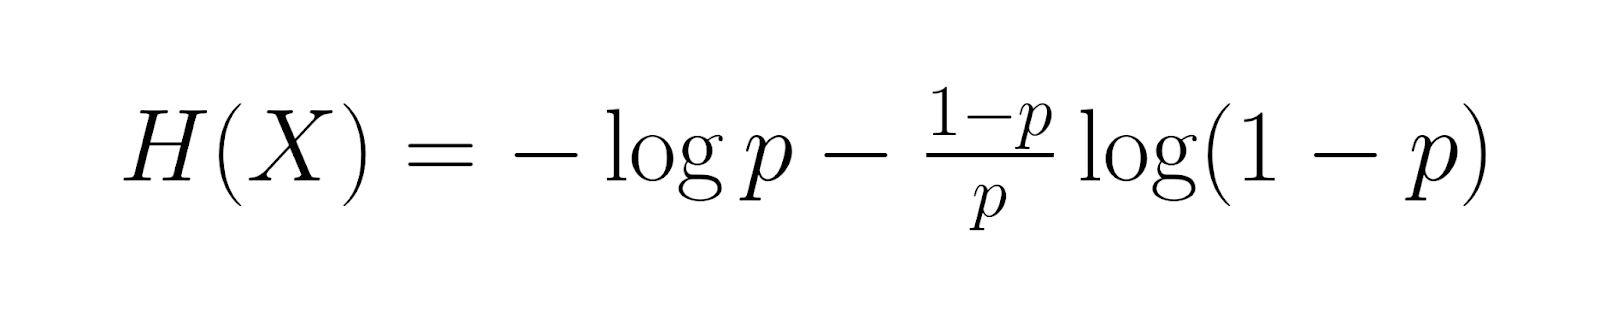
यह औसत सूचना सामग्री को मापती है। फिशर सूचना, जो इस प्रकार दी जाती है:
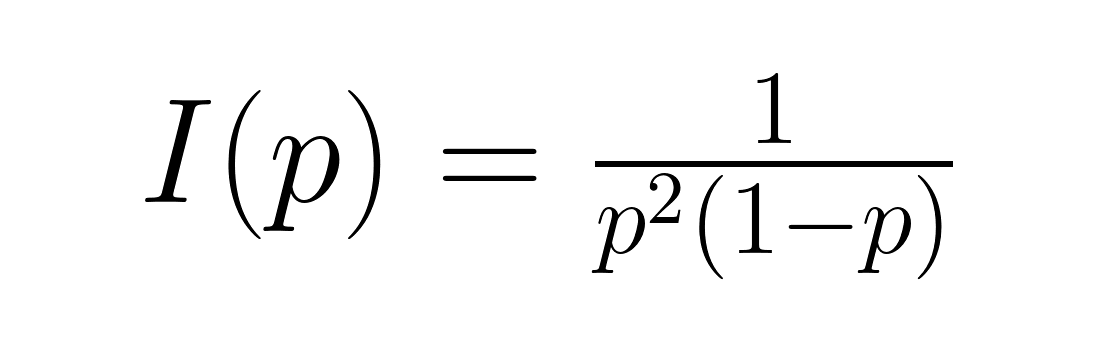
यह डेटा में पैरामीटर p के बारे में निहित सूचना की मात्रा को मात्रित करती है। ये माप सूचना सिद्धांत के अनुप्रयोगों और इष्टतम प्रायोगिक डिज़ाइन में मूल्यवान हैं, जहाँ सूचना सामग्री की समझ उपयुक्त नमूना आकार और आकलन प्रक्रियाएँ तय करने में मदद करती है।
अवलोकित डेटा से सफलता प्रायिकता p का आकलन करने के लिए विभिन्न सांख्यिकीय दृष्टिकोणों और उनके समझौतों को समझना आवश्यक है।
अधिकतम संभाव्यता आकलन वह p ढूँढ़ता है जो आपके अवलोकित डेटा को सबसे अधिक संभाव्य बनाता है। इस अनुमान को निकालने के लिए, आप अपनी सभी प्रेक्षणों में सफलता घटनाओं की कुल संख्या को किए गए कुल परीक्षणों की संख्या से विभाजित करते हैं। यह आकलक निष्पक्ष परिणाम देता है और बड़े नमूनों के साथ कुशलता से कार्य करता है।
व्यवहार में यह ऐसे काम करता है: यदि आपको क्रमशः 3, 7, 2, और 8 परीक्षणों के बाद सफलता मिलती है, तो आप 4 प्रेक्षणों को कुल 20 परीक्षणों (3+7+2+8) से विभाजित करेंगे, जिससे अनुमानित सफलता प्रायिकता 0.2 या 20% मिलती है। MLE वह दृष्टिकोण है जो आपके द्वारा संकलित वास्तविक डेटा के अवलोकन की संभाव्यता को अधिकतम करता है, और मानक परिस्थितियों में सांख्यिकीय रूप से सबसे कुशल विधि होता है।
एक वैकल्पिक दृष्टिकोण के रूप में, मोमेंट्स की विधि का आकलक आपके नमूना औसत को ज्यामितीय वितरण के सैद्धांतिक औसत के बराबर रखकर काम करता है। चूँकि सैद्धांतिक औसत सफलता प्रायिकता के व्युत्क्रम के बराबर होता है, आप सफलता प्रायिकता का अनुमान अपने नमूना औसत के व्युत्क्रम से लगा सकते हैं। यद्यपि यह विधि MLE की तुलना में गणनात्मक सरलता देती है, लेकिन सांख्यिकीय रूप से कम कुशल हो सकती है और कभी-कभी शून्य से एक की मान्य सीमा के बाहर अनुमान दे सकती है।
बड़े नमूनों के साथ काम करते समय दोनों विधियाँ समान परिणाम देती हैं, लेकिन सामान्यतः MLE के सांख्यिकीय गुण श्रेष्ठ होते हैं। विधि का चयन प्रायः गणनात्मक बाधाओं और आपके विश्लेषण की विशिष्ट आवश्यकताओं पर निर्भर करता है।
जब आपके पास सफलता प्रायिकता के बारे में पूर्व जानकारी हो, तो बेयज़ियन आकलन आपको इसे पूर्व प्रायिकता वितरण के माध्यम से शामिल करने देता है। Beta वितरण प्रायः इस पूर्व के रूप में काम करता है क्योंकि यह ज्यामितीय वितरण के डेटा के साथ गणितीय रूप से अनुकूल है। बेयज़ियन दृष्टिकोण आपकी पूर्व धारणाओं और अवलोकित डेटा को मिलाकर पश्च वितरण के माध्यम से अद्यतन पैरामीटर अनुमान प्रदान करता है।
यह गणितीय संबंध एक अद्यतन Beta वितरण बनाता है जो आपकी पूर्व जानकारी और नए अवलोकनों दोनों को समाहित करता है। यह दृष्टिकोण विशेष रूप से तब अच्छा काम करता है जब आपके पास सीमित डेटा हो या जब आप मॉडल किए जा रहे प्रक्रिया के बारे में विशेषज्ञ ज्ञान को सम्मिलित करना चाहते हों। उदाहरण के लिए, यदि आपको औद्योगिक अनुभव से पता है कि सफलता दर सामान्यतः एक निश्चित दायरे में रहती है, तो आप इस ज्ञान को छोटे नमूनों के साथ भी अपने अनुमानों को बेहतर बनाने के लिए शामिल कर सकते हैं।
ज्यामितीय वितरण का व्यापक उपयोग विभिन्न उद्योगों और विश्लेषणात्मक संदर्भों में होता है जहाँ पहली सफलता की घटनाओं का मॉडल बनाना अंतर्दृष्टियाँ प्रदान करता है।
निर्माण प्रक्रियाएँ अक्सर दोष पहचान और अवयव विफलता विश्लेषण का मॉडल बनाने के लिए ज्यामितीय वितरण का उपयोग करती हैं। गुणवत्ता नियंत्रण निरीक्षक पहली दोषपूर्ण इकाई मिलने से पहले जाँचने वाली वस्तुओं की अपेक्षित संख्या का अनुमान लगा सकते हैं, जिससे निरीक्षण प्रक्रियाओं और संसाधन आवंटन का अनुकूलन होता है।
उदाहरण के लिए, यदि ऐतिहासिक डेटा 2% दोष दर दर्शाता है, तो ज्यामितीय वितरण औसतन 50 वस्तुओं की जाँच के बाद पहला दोष मिलने की भविष्यवाणी करता है। यह जानकारी बैच आकार और निरीक्षण आवृत्तियाँ निर्धारित करने में मदद करती है, जिससे गुणवत्ता मानकों को बनाए रखते हुए लागतें न्यूनतम रहती हैं।
मार्केटिंग टीमें ग्राहक रूपांतरण प्रक्रियाओं का मॉडल बनाने के लिए ज्यामितीय वितरण लागू करती हैं—यह आँकती हैं कि बिक्री प्राप्त करने से पहले कितने संपर्क या विज्ञापन आवश्यक हैं। यह विश्लेषण बजट आवंटन और अभियान रणनीति संबंधी निर्णयों को सूचित करता है।
दूरसंचार में, नेटवर्क इंजीनियर पैकेट प्रसारण की सफलता दरों का मॉडल बनाने और पुन:प्रयास तंत्रों का अनुकूलन करने के लिए ज्यामितीय वितरण का उपयोग करते हैं। अपेक्षित प्रसारण प्रयासों की संख्या को समझना कुशल प्रोटोकॉल डिज़ाइन करने और समग्र नेटवर्क प्रदर्शन में सुधार करने में मदद करता है।
स्पोर्ट्स विश्लेषक स्कोरिंग घटनाओं का मॉडल बनाने के लिए ज्यामितीय वितरण का उपयोग करते हैं, जैसे किसी बास्केटबॉल खिलाड़ी को खेल में पहली तीन-अंक की शॉट लगाने के लिए आवश्यक प्रयासों की संख्या। यह विश्लेषण रणनीतिक निर्णय-निर्माण और प्रदर्शन मूल्यांकन में योगदान देता है।
गेमिंग अनुप्रयोगों में दुर्लभ घटनाएँ हासिल करने या चुनौतीपूर्ण स्तर पूरे करने के लिए आवश्यक प्रयासों की संख्या का मॉडल बनाना शामिल है। ऑनलाइन प्लेटफ़ॉर्म इन अंतर्दृष्टियों का उपयोग गेम की कठिनाई को संतुलित करने और उपयुक्त इनाम संरचनाओं के माध्यम से खिलाड़ी की भागीदारी बनाए रखने के लिए करते हैं।
मान लीजिए किसी मार्केटिंग अभियान की रूपांतरण दर 15% है। पाँचवें संपर्क पर पहली रूपांतरण मिलने की प्रायिकता निकालने के लिए: P(X = 5) = (0.85)⁴ × 0.15 = 0.0783, यानी लगभग 7.83%।
अभ्यास के लिए, यह प्रायिकता निकालें कि गुणवत्ता नियंत्रण निरीक्षक पहले 10 निरीक्षणों के भीतर पहली दोषपूर्ण वस्तु ढूँढ़ लेता है, जब दोष दर 8% है। CDF सूत्र का उपयोग करें: P(X ≤ 10) = 1 - (0.92)¹⁰ = 0.5656, यानी लगभग 56.56%।
यह समझना कि ज्यामितीय वितरण कब उपयुक्त रूप से लागू होता है, इसकी अंतर्निहित मान्यताओं और संभावित सीमाओं को पहचानने पर निर्भर करता है।
ज्यामितीय वितरण स्वतंत्र परीक्षणों और स्थिर सफलता प्रायिकता को मानता है, जो कई वास्तविक-world परिदृश्यों में सही नहीं हो सकता। उदाहरण के लिए, ग्राहक व्यवहार अक्सर पराश्रित होता है—पिछली अंत:क्रियाएँ भविष्य की रूपांतरण प्रायिकताओं को प्रभावित कर सकती हैं। इसी प्रकार, यांत्रिक प्रणालियाँ घिसावट का अनुभव कर सकती हैं जिससे समय के साथ विफलता दर बदलती है।
इन मान्यताओं का उल्लंघन गलत पुर्वानुमानों और कमजोर निर्णय-निर्माण की ओर ले जा सकता है। डेटा प्रैक्टिशनरों को स्वतंत्रता की मान्यता का सांख्यिकीय परीक्षणों से सत्यापन करना चाहिए और निर्भरताएँ मिलने पर वैकल्पिक मॉडलों पर विचार करना चाहिए। सामान्य विकल्पों में अतिविक्षेपित डेटा के लिए निगेटिव बायनोमियल वितरण या पराश्रित परीक्षणों के लिए मार्कोव शृंखला मॉडल शामिल हैं।
ज्यामितीय वितरण को समझना केवल सैद्धांतिक ज्ञान नहीं है—यह आपको संसाधन आवंटन, प्रक्रिया अनुकूलन, और जोखिम आकलन पर सूचित निर्णय लेने में सक्षम बनाता है। चाहे आप गुणवत्ता नियंत्रण प्रक्रियाएँ डिज़ाइन कर रहे हों या मार्केटिंग अभियानों का अनुकूलन कर रहे हों, यह वितरण मात्रात्मक अंतर्दृष्टियाँ प्रदान करता है जो बेहतर परिणामों को प्रेरित करती हैं।
निरंतर सीखने के लिए, हमारा Multivariate Probability Distributions in R पाठ्यक्रम देखें ताकि समझ सकें कि ज्यामितीय वितरण अन्य प्रायिकता मॉडलों से कैसे संबंधित है; या उन्नत मॉडलिंग अनुप्रयोगों के लिए हमारे Generalized Linear Models in R पाठ्यक्रम के साथ आकलन तकनीकों में गहराई से जाएँ।
DataCamp के साथ सीखें
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
