
Khóa học
Nền tảng Xác suất với R
4 giờ
42.9K
Bạn có thể cần bao nhiêu buổi phỏng vấn trước khi có được vị trí mơ ước? Cần bao nhiêu lần thử trước khi một chiến dịch marketing tạo ra đơn hàng đầu tiên? Phân phối hình học trả lời những câu hỏi “thời gian chờ” này bằng cách mô hình hóa số lần thử cần thiết cho đến khi xuất hiện thành công đầu tiên.
Hướng dẫn này bao quát nền tảng toán học của phân phối hình học, các tính chất đặc trưng và những ứng dụng thực tế khiến nó hữu ích cho những người làm việc với các kịch bản thử nghiệm tuần tự. Để ôn lại về các phân phối xác suất, hãy cân nhắc tham gia khóa học Giới thiệu về Thống kê của chúng tôi.
Phân phối hình học là một phân phối xác suất rời rạc mô hình hóa số lần thử Bernoulli độc lập cần để đạt được thành công đầu tiên. Mỗi lần thử có cùng xác suất thành công, và các lần thử độc lập với nhau.
Phân phối này có hai dạng phổ biến: một dạng đếm tổng số lần thử cho đến thành công đầu tiên (bao gồm lần thành công), và dạng khác chỉ đếm số lần thất bại trước thành công đầu tiên. Cả hai đều được dùng rộng rãi tùy theo bối cảnh ứng dụng cụ thể. Xuyên suốt hướng dẫn này, chúng tôi dùng dạng thứ nhất, đếm tổng số lần thử đến thành công đầu tiên, trong đó X có thể nhận các giá trị 1, 2, 3, v.v.
Hãy xem xét cấu trúc toán học và các đặc điểm xác định phân phối này.
Phân phối hình học cần ba điều kiện chính: các lần thử độc lập, xác suất thành công giống nhau cho mọi lần thử, và một xác suất cố định p với 0 < p ≤ 1. Ký hiệu chuẩn dùng p cho xác suất thành công và q = 1-p cho xác suất thất bại.
Hàm khối xác suất (PMF) cho số lần thử X cho đến khi xuất hiện thành công đầu tiên là:
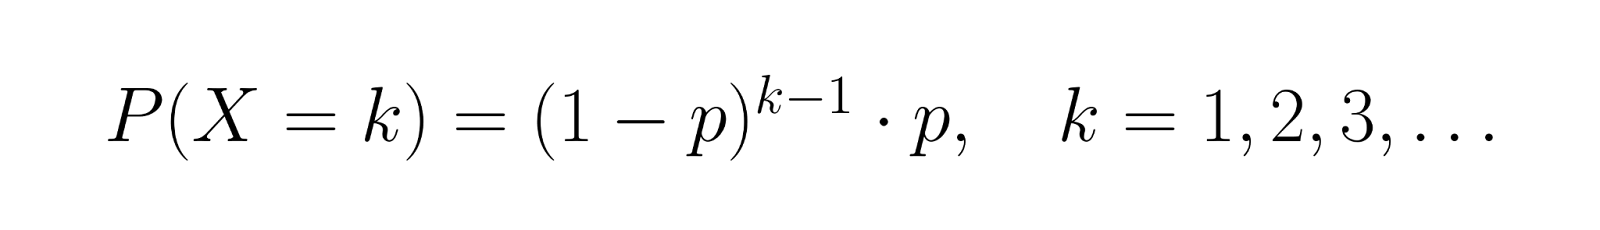
Công thức này tính xác suất trải qua đúng k-1 lần thất bại rồi đến một lần thành công. Ví dụ, nếu p = 0.3, xác suất thành công ở lần thử thứ ba là P(X = 3) = (0.7)² × 0.3 = 0.147.
Hàm phân phối tích lũy (CDF) cho chúng ta:
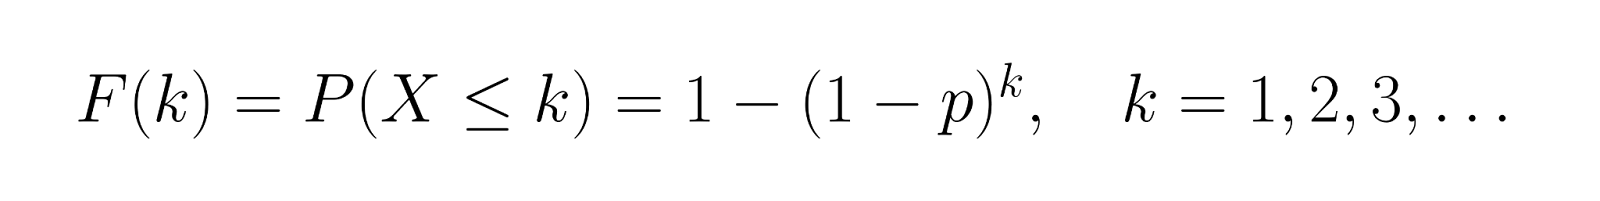
Điều này biểu diễn xác suất đạt được thành công trong vòng k lần thử. Dùng ví dụ p = 0.3, hãy tính CDF cho vài giá trị đầu:
Điều này cho thấy có 30% khả năng thành công ở lần thử đầu tiên, 51% khả năng thành công trong hai lần thử đầu, và 65,7% khả năng thành công trong ba lần thử đầu.
Các mẫu hình trực quan của phân phối hình học cho thấy những hiểu biết chính về các kịch bản “thời gian chờ”. Các đồ thị này minh họa cách xác suất tập trung ở những lần thử đầu và giảm theo hàm mũ, khiến phân phối này hữu ích để mô hình hóa các tình huống mà thành công có khả năng xảy ra sớm hơn là chờ đợi kéo dài.
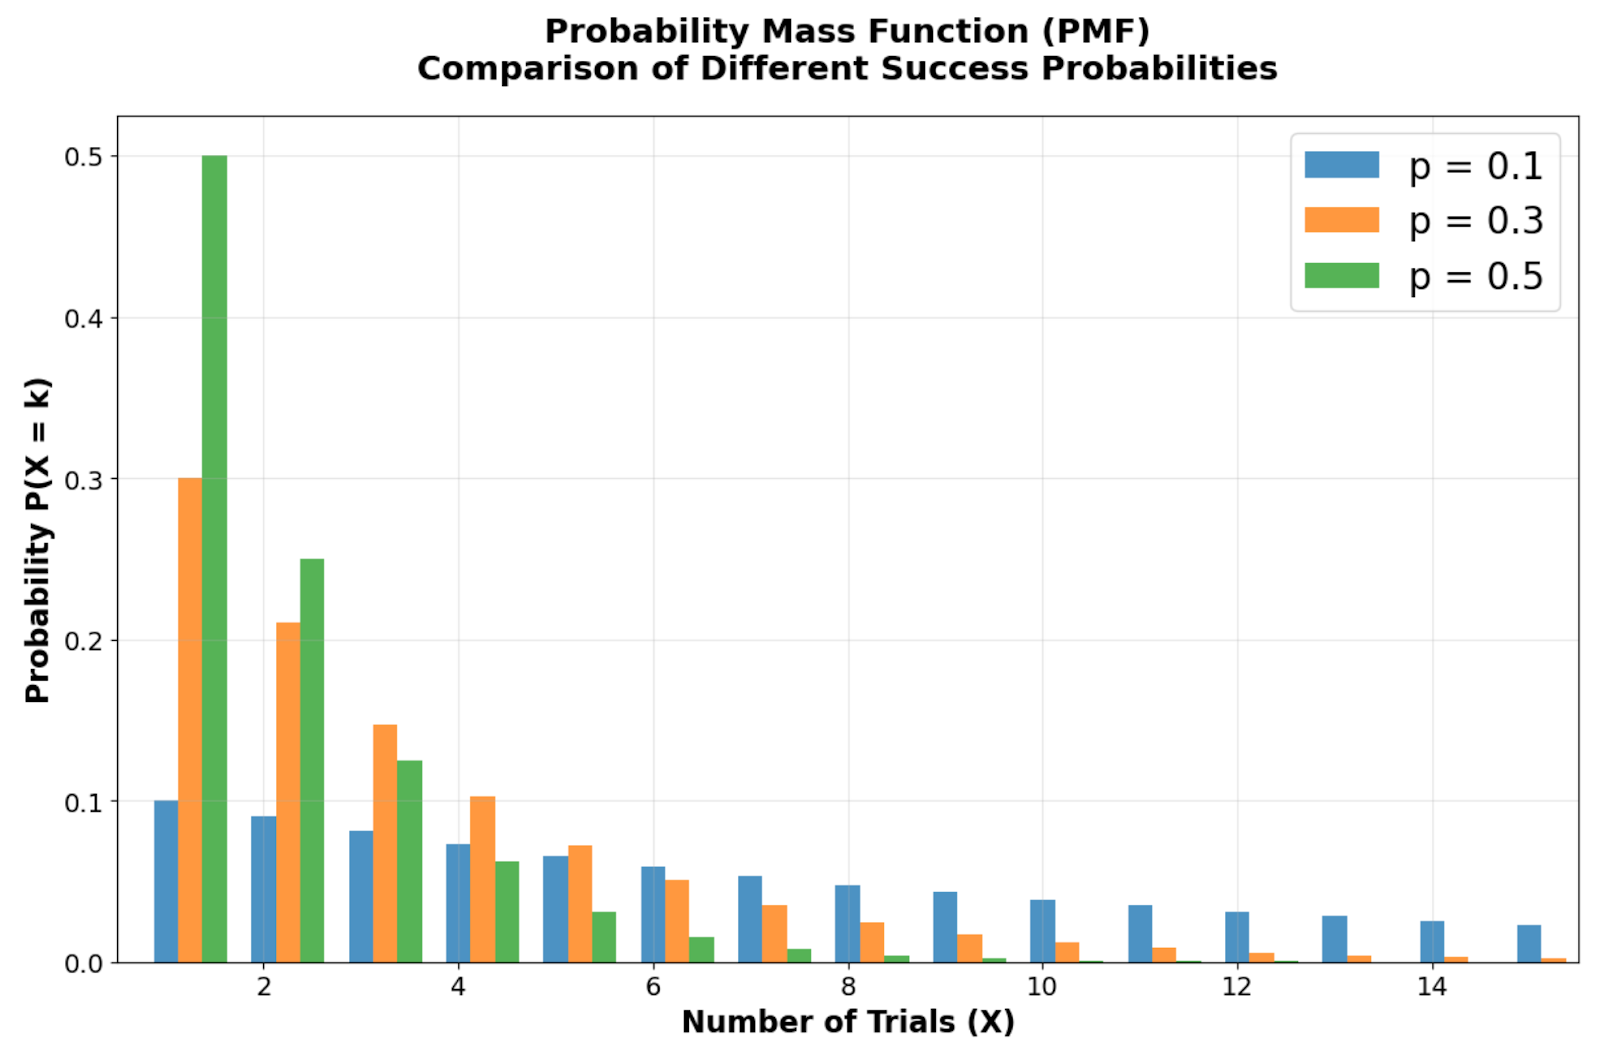
So sánh Hàm khối Xác suất cho thấy cách các xác suất thành công khác nhau (p = 0.1, 0.3, 0.5) ảnh hưởng đến dạng phân phối. Ảnh: Tác giả
Nhìn vào so sánh hàm khối xác suất với các xác suất thành công khác nhau, bạn sẽ thấy dạng lệch phải đặc trưng của phân phối hình học với mô-đun luôn ở X = 1 (lần thử đầu tiên). Hãy để ý các cột xác suất bắt đầu cao nhất ở lần đầu và giảm theo cấp số nhân ở mỗi lần thử sau đó. Khi xác suất thành công p giảm, phân phối dàn rộng hơn, phản ánh thời gian chờ kỳ vọng dài hơn. Chẳng hạn, với p = 0.1, chỉ có 10% khả năng thành công ngay lập tức, tạo ra đuôi phải rõ rệt hơn so với p = 0.5.
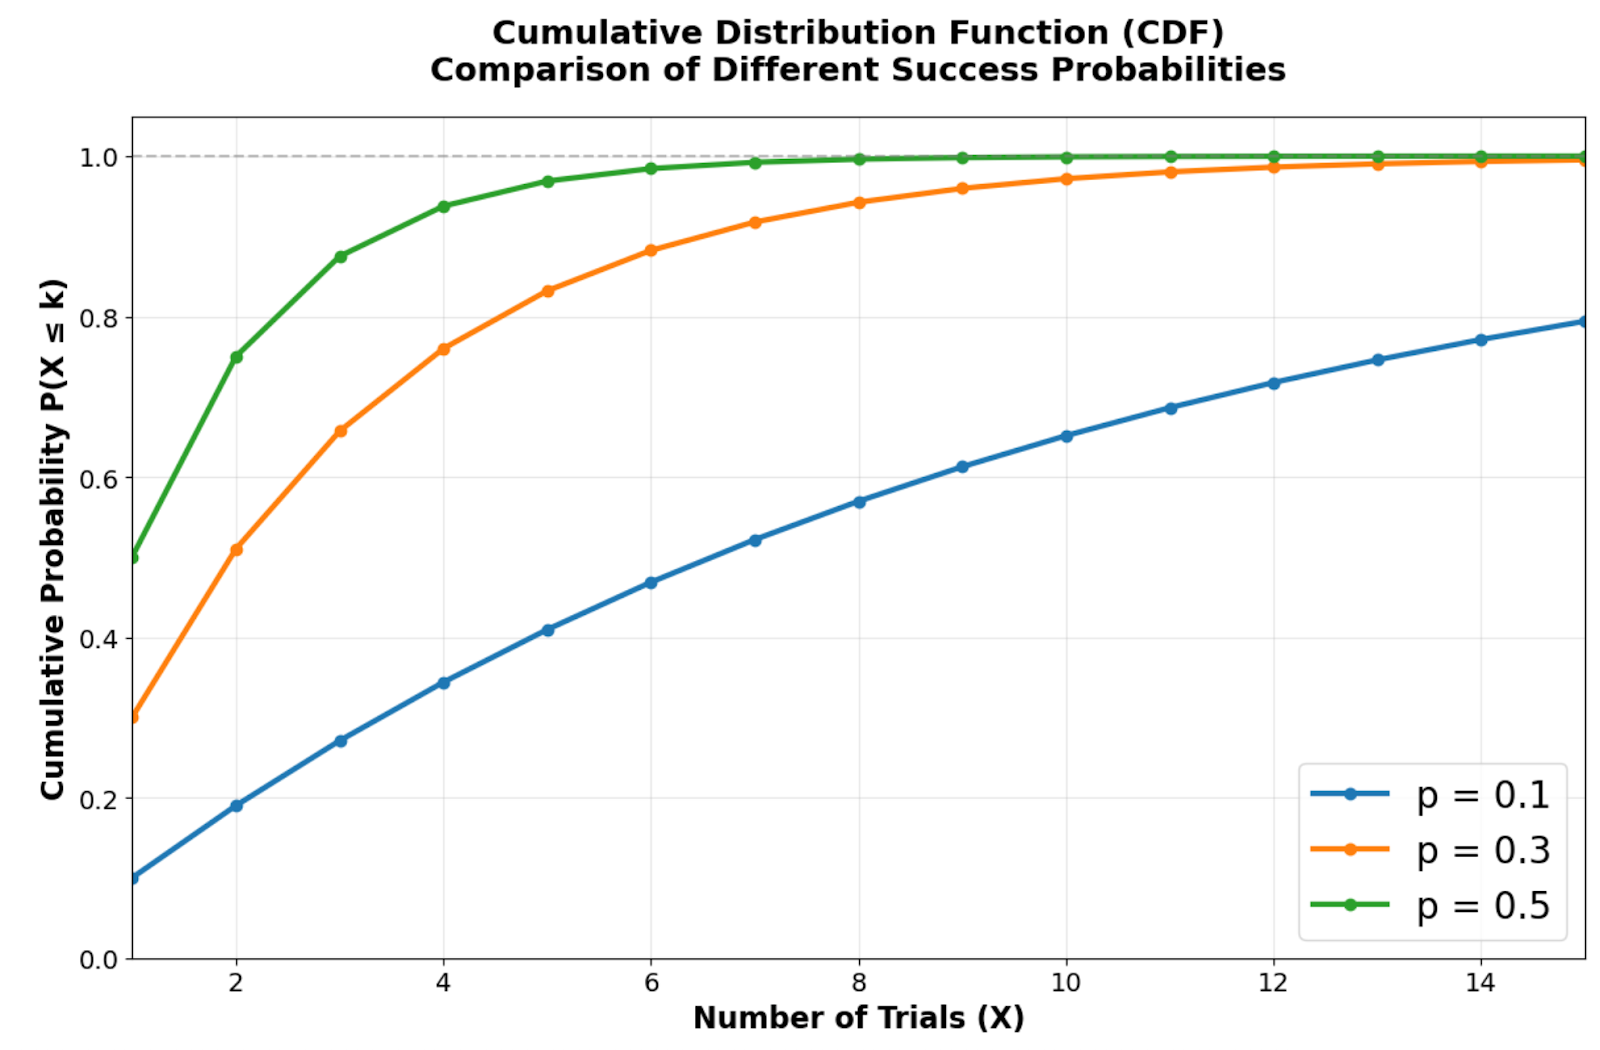
Hàm phân phối tích lũy thể hiện tốc độ tiến gần đến chắc chắn với các xác suất thành công khác nhau. Ảnh: Tác giả.
Hàm phân phối tích lũy cho thấy tốc độ phân phối hình học tiến gần đến độ chắc chắn. Xác suất thành công cao hơn tạo ra các đường cong dốc hơn, đạt xác suất tích lũy lớn chỉ trong vài lần thử. Ví dụ, với p = 0.5, có khoảng 75% khả năng thành công trong hai lần thử đầu, trong khi p = 0.1 cần nhiều lần thử hơn đáng kể để đạt cùng mức chắc chắn.

So sánh cạnh nhau làm nổi bật mẫu suy giảm theo hàm mũ trong PMF và tiến gần nhanh đến chắc chắn trong CDF. Ảnh: Tác giả.
Mẫu suy giảm theo hàm mũ này giải thích vì sao phân phối hình học hoạt động tốt khi mô hình hóa các kịch bản mà thành công sớm có khả năng hơn so với chờ đợi kéo dài. Đường CDF tăng nhanh hướng đến 1 cho thấy phân phối này hiệu quả trong việc mô hình hóa các quá trình có thời gian chờ ngắn, nhờ đó hữu ích cho kiểm soát chất lượng, phân tích chuyển đổi khách hàng và kiểm thử độ tin cậy.
Bạn có thể tái tạo các trực quan hóa này và khám phá các giá trị tham số khác nhau bằng thư viện scipy và matplotlib của Python. Sau đây là cách tạo ra những trực quan then chốt làm nổi bật các đặc điểm quan trọng nhất của phân phối hình học:
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

# Create side-by-side plots for PMF and CDF
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(16, 6))
fig.suptitle('Geometric Distribution: Key Visual Insights', fontsize=24, fontweight='bold')

# Simple PMF showing exponential decay (using p = 0.3)
x_simple = np.arange(1, 11)
pmf_simple = stats.geom.pmf(x_simple, 0.3)

ax1.bar(x_simple, pmf_simple, alpha=0.8, color='steelblue', edgecolor='black', linewidth=1)
ax1.set_title('PMF: Exponential Decay Pattern', fontsize=18, fontweight='bold', pad=15)
ax1.set_xlabel('Number of Trials (X)', fontsize=17, fontweight='bold')
ax1.set_ylabel('Probability', fontsize=14, fontweight='bold')
ax1.grid(True, alpha=0.3)
ax1.tick_params(axis='both', which='major', labelsize=14)

# Simple CDF showing approach to 1
cdf_simple = stats.geom.cdf(x_simple, 0.3)

ax2.plot(x_simple, cdf_simple, 'o-', linewidth=4, markersize=8, color='darkgreen')
ax2.set_title('CDF: Rapid Approach to Certainty', fontsize=18, fontweight='bold', pad=15)
ax2.set_xlabel('Number of Trials (X)', fontsize=17, fontweight='bold')
ax2.set_ylabel('Cumulative Probability', fontsize=14, fontweight='bold')
ax2.grid(True, alpha=0.3)
ax2.set_ylim(0, 1.05)
ax2.tick_params(axis='both', which='major', labelsize=14)

plt.tight_layout()
plt.show()
Đoạn mã này tạo một trực quan hóa tập trung nhấn mạnh hai đặc trưng trực quan quan trọng nhất của phân phối hình học. Bảng bên trái cho thấy xác suất giảm theo hàm mũ từ lần thử đầu, trong khi bảng bên phải thể hiện sự tích lũy khối xác suất nhanh trong CDF.
Hãy thử thay đổi xác suất thành công từ 0.3 sang các giá trị như 0.1 hoặc 0.7 để xem hình dạng phân phối thay đổi thế nào. Xác suất thấp hơn tạo ra các đường PMF phẳng hơn và CDF tăng chậm hơn, trong khi xác suất cao hơn tạo ra sự suy giảm dốc hơn và tiến gần đến chắc chắn nhanh hơn.
Phân phối hình học có một đặc tính độc đáo khiến nó khác biệt so với hầu hết các phân phối rời rạc khác.
Thuộc tính không nhớ phát biểu rằng P(X > s + t | X > s) = P(X > t) với mọi số nguyên dương s và t. Điều này có nghĩa là xác suất cần thêm các lần thử không phụ thuộc vào số lần thử thất bại đã xảy ra trước đó.
Về mặt toán học, thuộc tính này xuất hiện vì P(X > k) = (1-p)k, khiến việc tính xác suất có điều kiện trở nên trực tiếp. Trong thực tế, nếu bạn đã có năm buổi phỏng vấn không thành công, phân phối xác suất cho các buổi phỏng vấn tiếp theo vẫn giống hệt như khi bạn bắt đầu—những thất bại trước đó không ảnh hưởng đến xác suất trong tương lai.
Mỗi lần thử trong một thí nghiệm hình học đại diện cho một lần thử Bernoulli độc lập với xác suất thành công p không đổi. Phân phối hình học mô hình hóa chuỗi các lần thử này cho đến thành công đầu tiên, khiến nó trở thành bản tương tự rời rạc của các bài toán “thời gian chờ”.
Mối quan hệ này giải thích vì sao phân phối hình học xuất hiện thường xuyên trong kiểm soát chất lượng, nơi mỗi mục được kiểm tra là một lần thử Bernoulli, và chúng ta quan tâm đến việc phát hiện mục lỗi đầu tiên. Giả định độc lập đảm bảo việc tìm thấy sản phẩm lỗi ở các lần kiểm tra sớm không làm thay đổi xác suất tìm thấy lỗi ở các lần kiểm tra sau.
Phân phối mũ đóng vai trò bản tương tự liên tục của phân phối hình học, cả hai đều có tính không nhớ. Trong khi phân phối hình học mô hình hóa thời gian chờ rời rạc (số lần thử), phân phối mũ mô hình hóa thời gian chờ liên tục (thời gian đến khi một sự kiện xảy ra).
Cả hai phân phối đều được ứng dụng trong phân tích độ tin cậy và lý thuyết hàng đợi. Ví dụ, phân phối hình học có thể mô hình số yêu cầu máy chủ cho đến khi xảy ra lỗi đầu tiên, trong khi phân phối mũ mô hình thời gian cho đến khi lỗi tiếp theo của máy chủ xảy ra.
Với các khái niệm nền tảng và đặc tính độc đáo đã có, hãy khám phá các công cụ toán học cho phép tính xác suất chính xác và ra quyết định có cơ sở. Các công thức và mối quan hệ này sẽ thiết yếu khi áp dụng phân phối hình học vào các bài toán thực tế.
Giá trị kỳ vọng (trung bình) của phân phối hình học là:
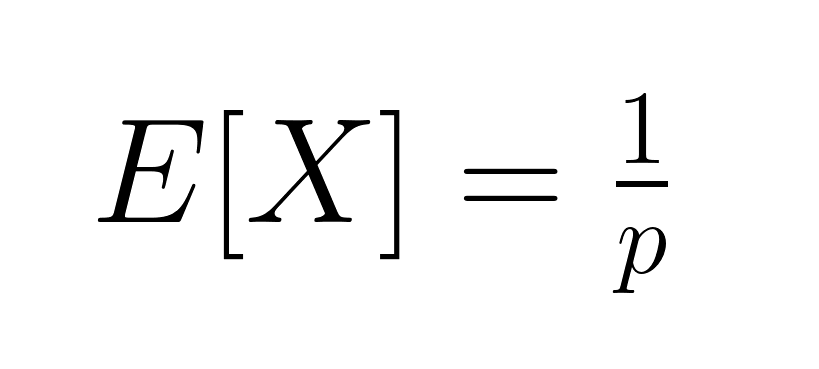
Điều này biểu thị số lần thử trung bình cần để thành công. Phương sai bằng:
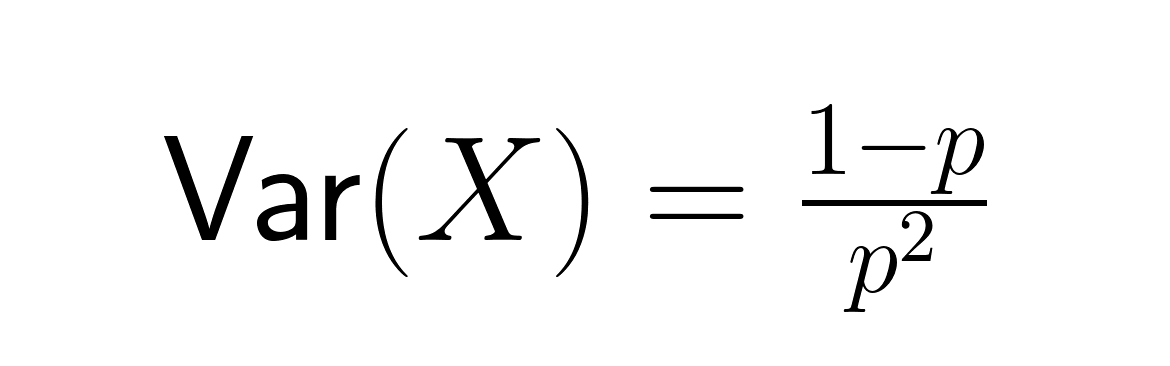
Độ lệch chuẩn là:
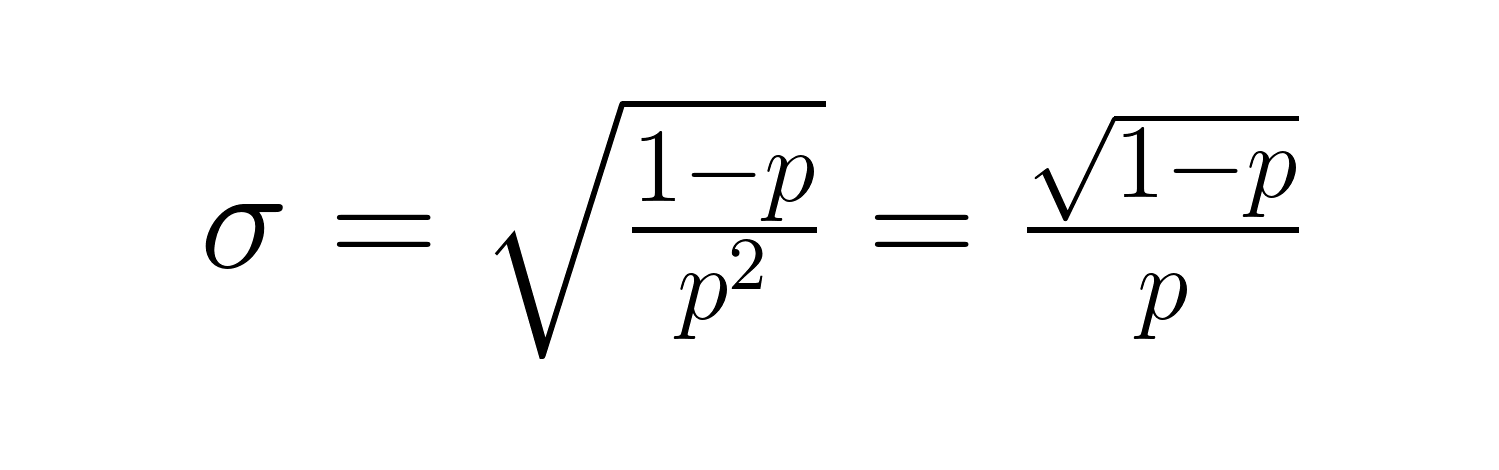
Các công thức này cho thấy mối quan hệ quan trọng: khi p giảm, cả thời gian chờ kỳ vọng và độ biến thiên đều tăng đáng kể. Ví dụ, với p = 0.2, số lần thử kỳ vọng là 5, nhưng với p = 0.05, con số này tăng vọt lên 20 lần thử. Phương sai còn tăng mạnh hơn, từ 20 lên 380.
Đối với phân tích nâng cao, hàm sinh mômen (MGF) của phân phối hình học là:
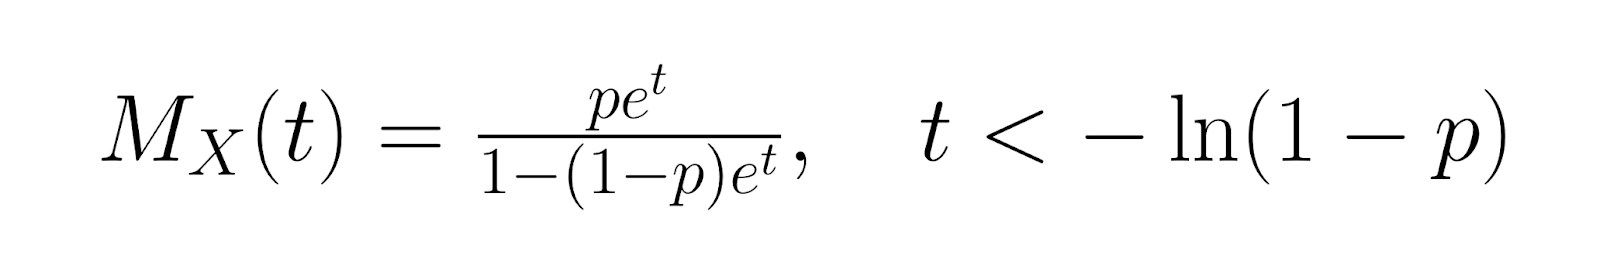 Hàm sinh xác suất (PGF) là:
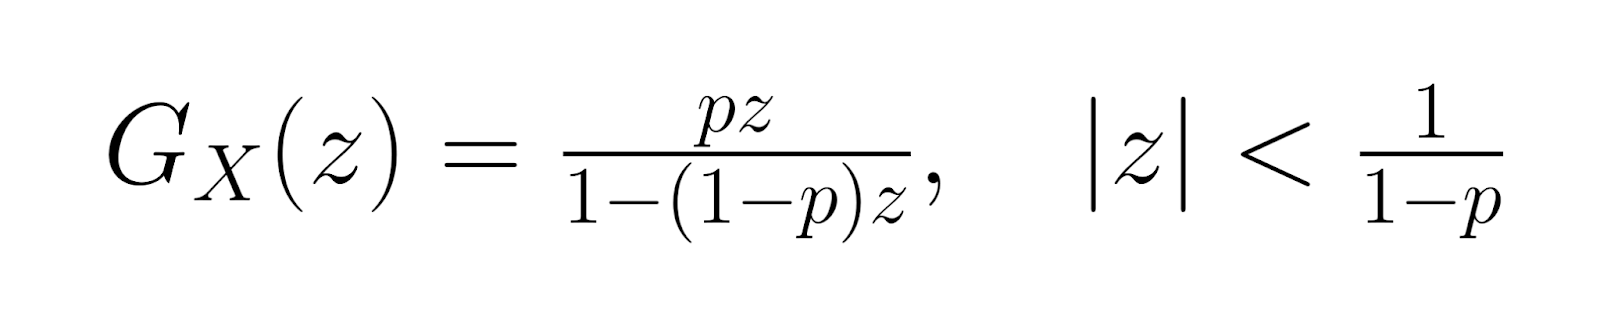
Các hàm sinh này hỗ trợ phân tích thống kê nâng cao và cung cấp phương pháp thay thế để suy ra các tính chất của phân phối. Các mômen bậc cao có thể được tính bằng đạo hàm của các hàm này, cho phép mô tả toàn diện dạng và hành vi của phân phối.
Chuyển sang lĩnh vực chuyên sâu hơn, entropy của phân phối hình học bằng:
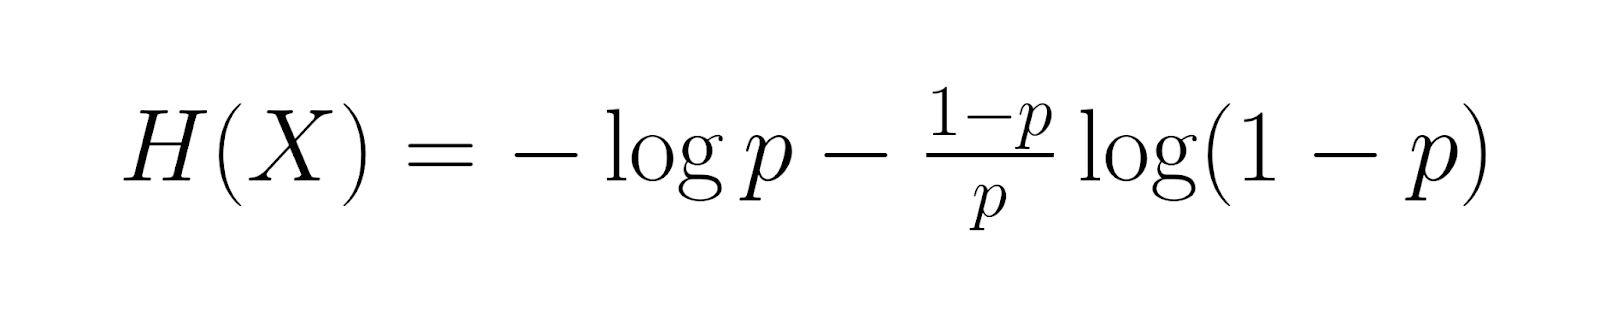
Điều này đo lường lượng thông tin trung bình. Thông tin Fisher, được cho bởi:
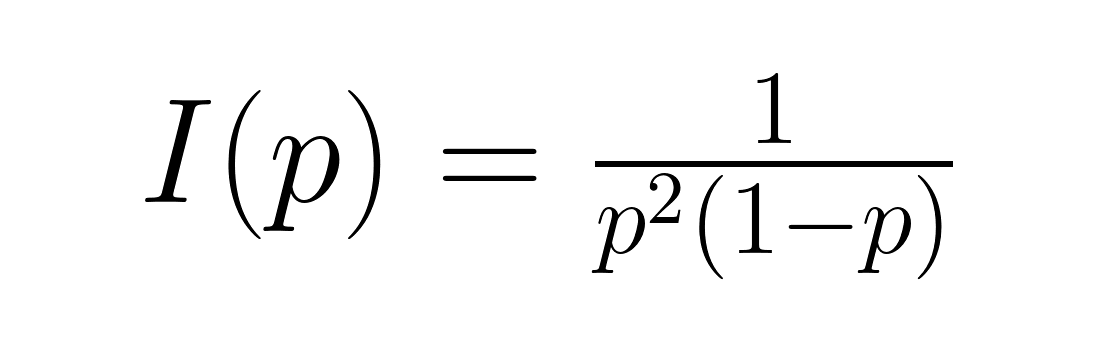
Điều này định lượng lượng thông tin về tham số p chứa trong dữ liệu. Các thước đo này hữu ích trong lý thuyết thông tin và thiết kế thí nghiệm tối ưu, nơi hiểu biết về lượng thông tin giúp xác định kích thước mẫu phù hợp và quy trình ước lượng.
Ước lượng xác suất thành công p từ dữ liệu quan sát đòi hỏi hiểu các cách tiếp cận thống kê khác nhau và đánh đổi của chúng.
Cách tiếp cận MLE hoạt động bằng việc tìm xác suất thành công khiến dữ liệu quan sát của bạn có khả năng xảy ra cao nhất. Để tính ước lượng này, bạn chia tổng số sự kiện thành công cho tổng số lần thử trên tất cả quan sát. Bộ ước lượng này cho kết quả không chệch và hoạt động hiệu quả khi làm việc với cỡ mẫu lớn.
Cách thức này trong thực tế: nếu bạn quan sát thấy thành công sau lần thứ 3, 7, 2 và 8 tương ứng, bạn sẽ tính MLE bằng cách lấy 4 quan sát chia cho tổng 20 lần thử (3+7+2+8), cho ước lượng xác suất thành công là 0.2 hay 20%. Cách MLE tối đa hóa khả năng quan sát được chính dữ liệu bạn thu thập, khiến nó là phương pháp hiệu quả nhất về mặt thống kê trong các điều kiện chuẩn.
Như một cách tiếp cận thay thế, bộ ước lượng theo phương pháp mômen hoạt động bằng cách đặt trung bình mẫu của bạn bằng trung bình lý thuyết của phân phối hình học. Vì trung bình lý thuyết bằng một chia cho xác suất thành công, bạn có thể ước lượng xác suất thành công bằng cách lấy một chia cho trung bình mẫu. Dù phương pháp này đơn giản hơn về tính toán so với MLE, nó có thể kém hiệu quả hơn về mặt thống kê và đôi khi cho ra ước lượng nằm ngoài khoảng xác suất hợp lệ từ 0 đến 1.
Cả hai phương pháp cho kết quả tương tự khi làm việc với mẫu lớn, nhưng MLE thường có các tính chất thống kê vượt trội. Lựa chọn giữa các phương pháp thường phụ thuộc vào ràng buộc tính toán và yêu cầu cụ thể của phân tích.
Khi bạn có thông tin tiên nghiệm về xác suất thành công, ước lượng Bayes cho phép bạn kết hợp kiến thức này thông qua một phân phối tiên nghiệm. Phân phối Beta thường được dùng làm tiên nghiệm vì nó tương thích tốt về mặt toán học với dữ liệu phân phối hình học. Cách tiếp cận Bayes kết hợp niềm tin tiên nghiệm với dữ liệu quan sát để tạo ra ước lượng tham số cập nhật gọi là phân phối hậu nghiệm.
Mối quan hệ toán học tạo ra một phân phối Beta cập nhật tích hợp cả kiến thức tiên nghiệm và quan sát mới. Cách tiếp cận này đặc biệt hiệu quả khi bạn có dữ liệu hạn chế hoặc muốn tích hợp kiến thức chuyên gia về quy trình đang được mô hình hóa. Ví dụ, nếu bạn biết từ kinh nghiệm ngành rằng tỷ lệ thành công thường nằm trong một khoảng nhất định, bạn có thể đưa kiến thức này vào để cải thiện ước lượng ngay cả với cỡ mẫu nhỏ.
Phân phối hình học được dùng rộng rãi trong nhiều ngành và bối cảnh phân tích, nơi việc mô hình hóa các sự kiện thành công đầu tiên mang lại hiểu biết.
Các quy trình sản xuất thường dùng phân phối hình học để mô hình phát hiện lỗi và phân tích hỏng hóc linh kiện. Nhân viên kiểm soát chất lượng có thể ước lượng số mục cần kiểm tra trung bình trước khi tìm thấy một đơn vị lỗi, giúp tối ưu thủ tục kiểm tra và phân bổ nguồn lực.
Chẳng hạn, nếu dữ liệu lịch sử cho thấy tỷ lệ lỗi là 2%, phân phối hình học dự đoán trung bình 50 sản phẩm được kiểm tra trước khi tìm thấy lỗi đầu tiên. Thông tin này giúp xác định kích thước lô và tần suất kiểm tra phù hợp để duy trì tiêu chuẩn chất lượng trong khi giảm thiểu chi phí.
Các đội marketing áp dụng phân phối hình học để mô hình quy trình chuyển đổi khách hàng, ước lượng cần bao nhiêu lượt tiếp cận hoặc quảng cáo trước khi có một đơn hàng. Phân tích này giúp định hướng phân bổ ngân sách và quyết định chiến lược chiến dịch.
Trong viễn thông, kỹ sư mạng dùng phân phối hình học để mô hình tỷ lệ truyền gói tin thành công và tối ưu cơ chế thử lại. Hiểu số lần thử truyền dự kiến giúp thiết kế giao thức hiệu quả và cải thiện hiệu năng mạng tổng thể.
Các nhà phân tích thể thao dùng phân phối hình học để mô hình các sự kiện ghi điểm, như số lần ném cần thiết để một cầu thủ bóng rổ ghi cú ném ba điểm đầu tiên trong một trận. Phân tích này đóng góp vào quyết định chiến lược và đánh giá hiệu suất.
Ứng dụng trong trò chơi bao gồm mô hình số lần thử cần để đạt các sự kiện hiếm hoặc hoàn thành các màn khó. Nền tảng trực tuyến sử dụng những hiểu biết này để cân bằng độ khó và duy trì sự gắn kết của người chơi thông qua cơ chế thưởng phù hợp.
Xét một kịch bản trong đó một chiến dịch marketing có tỷ lệ chuyển đổi 15%. Để tìm xác suất có chuyển đổi đầu tiên ở lần tiếp cận thứ 5: P(X = 5) = (0.85)⁴ × 0.15 = 0.0783 hay khoảng 7,83%.
Để luyện tập, hãy tính xác suất rằng một nhân viên kiểm soát chất lượng tìm thấy mục lỗi đầu tiên trong 10 lần kiểm tra đầu, với tỷ lệ lỗi 8%. Dùng công thức CDF: P(X ≤ 10) = 1 - (0.92)¹⁰ = 0.5656 hay xấp xỉ 56,56%.
Hiểu khi nào phân phối hình học áp dụng phù hợp đòi hỏi nhận diện các giả định nền tảng và những hạn chế tiềm ẩn của nó.
Phân phối hình học giả định các lần thử độc lập với xác suất thành công không đổi, điều này có thể không đúng trong nhiều kịch bản thực tế. Ví dụ, hành vi khách hàng thường có phụ thuộc—tương tác trước đó có thể ảnh hưởng xác suất chuyển đổi trong tương lai. Tương tự, hệ thống cơ khí có thể bị mài mòn làm thay đổi tỷ lệ hỏng theo thời gian.
Việc vi phạm các giả định này có thể dẫn đến dự đoán không chính xác và quyết định kém. Người làm dữ liệu nên kiểm định giả định độc lập bằng kiểm tra thống kê và cân nhắc các mô hình thay thế khi phát hiện phụ thuộc. Các lựa chọn phổ biến gồm phân phối nhị thức âm cho dữ liệu quá phân tán hoặc mô hình chuỗi Markov cho các lần thử phụ thuộc.
Hiểu về phân phối hình học không chỉ là kiến thức lý thuyết—nó giúp bạn đưa ra quyết định sáng suốt về phân bổ nguồn lực, tối ưu quy trình và đánh giá rủi ro. Dù bạn đang thiết kế quy trình kiểm soát chất lượng hay tối ưu chiến dịch marketing, phân phối này mang lại các hiểu biết định lượng thúc đẩy kết quả tốt hơn.
Để tiếp tục học, hãy khám phá khóa học Phân phối Xác suất Đa biến trong R để hiểu phân phối hình học liên hệ với các mô hình xác suất khác như thế nào, hoặc đào sâu các kỹ thuật ước lượng với khóa học Mô hình Tuyến tính Tổng quát trong R cho các ứng dụng mô hình hóa nâng cao.
Học cùng DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
