
Last chance! 50% off DataCamp Premium
Sale ends in
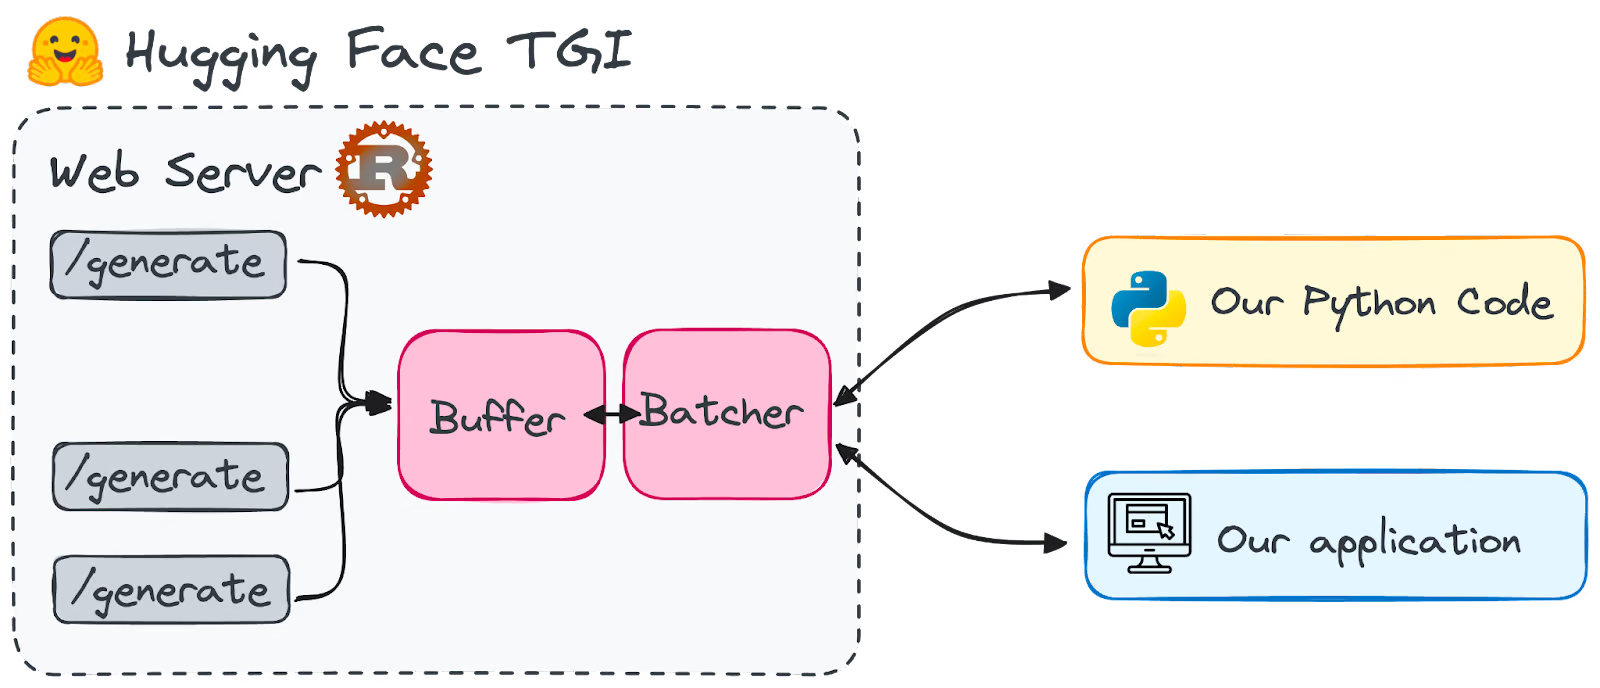
Gambar oleh Penulis
Di bidang kecerdasan buatan yang berkembang pesat, Model Bahasa Besar telah muncul sebagai tokoh utama dari terobosan terbaru di bidang ini.
Generasi teks telah menjadi kemampuan terobosan, mengubah cara mesin memahami dan menghasilkan teks yang mirip manusia. Popularitas inilah yang mendorong peluncuran berbagai alat untuk memperlancar dan memudahkan proses bekerja dengan LLM.
Proliferasi cepat Model Bahasa Besar (LLM), dengan model baru bermunculan hampir setiap minggu, telah memicu pertumbuhan paralel dalam opsi hosting untuk mengakomodasi teknologi ini. Di antara beragam alat yang tersedia untuk tujuan ini, Text Generation Inference (TGI) dari Hugging Face sangat patut diperhatikan, karena memungkinkan kita menjalankan LLM sebagai layanan di mesin lokal kita.
Sederhananya, TGI memungkinkan kita memiliki end-point untuk memanggil model kita.
Panduan ini akan membahas mengapa Hugging Face TGI menjadi pengubah permainan dan bagaimana Anda dapat memanfaatkannya untuk membuat model AI canggih yang mampu menghasilkan teks yang semakin sulit dibedakan dari teks buatan manusia.
Hugging Face Text Generation Inference, dikenal juga sebagai TGI, adalah kerangka kerja yang ditulis dalam Rust dan Python untuk men-deploy dan menyajikan Model Bahasa Besar. Ini adalah toolkit siap produksi untuk men-deploy dan menyajikan LLM.
Hugging Face mengembangkan dan mendistribusikannya di bawah lisensi HFOILv1.0, yang mengizinkan penggunaan komersial asalkan berfungsi sebagai alat bantu dalam produk atau layanan yang ditawarkan, bukan menjadi fokus utama. Tantangan utama yang ditanganinya adalah:
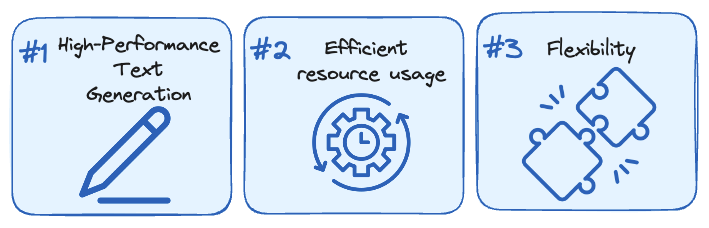
Gambar oleh Penulis.
Hugging Face mengoptimalkan beberapa arsitektur LLM agar berjalan lebih cepat dengan TGI. Ini mencakup model populer seperti LLaMA, Falcon7B, dan Mistral. Daftar lengkapnya dapat ditemukan di dokumentasinya.
Hugging Face telah menjadi tujuan utama untuk mengembangkan AI dengan kemampuan bahasa alami. Ini adalah pusat tempat model-model open-source kelas berat berkumpul, menjadikannya kekuatan pendorong inovasi NLP. Hingga sekarang, sebagian besar model ini terlalu berat untuk digunakan langsung secara lokal; selalu ada ketergantungan pada layanan berbasis cloud.
Namun, dengan mempertimbangkan kemajuan terbaru dengan trik kuantisasi seperti QLoRa dan GPTQ, beberapa LLM kini menjadi lebih mudah dijalankan di perangkat sehari-hari kita—seperti komputer lokal.
Hugging Face TGI dirancang khusus untuk menyediakan LLM sebagai layanan di mesin lokal kita. Alasan utamanya adalah repotnya proses mem-boot LLM.
Untuk menghindari waktu henti, lebih cerdas menjaga model tetap siap di latar belakang, siap memberikan respons cepat. Jika tidak, Anda akan selalu menunggu lama setiap kali memberi prompt. Bayangkan memiliki endpoint dengan kumpulan model bahasa terbaik yang siap Anda panggil kapan saja.
Yang menarik bagi saya dari TGI adalah pendekatannya yang tanpa ribet. Saat ini, TGI sudah siap bekerja dengan beragam arsitektur model yang ramping, sehingga sangat mudah untuk men-deploy-nya dengan cepat.
Dan ini bukan sekadar wacana; TGI sudah menjadi mesin di balik beberapa proyek yang berjalan langsung. Contohnya:
Gambar oleh Penulis. Logo Hugging Chat (Kiri) dan OpenAssistant (Kanan)
Namun, ada satu catatan penting. TGI belum kompatibel dengan Mac GPU berbasis ARM, termasuk seri M1 dan model yang lebih baru.
Pertama, kita perlu menyiapkan end-point Hugging Face TGI.
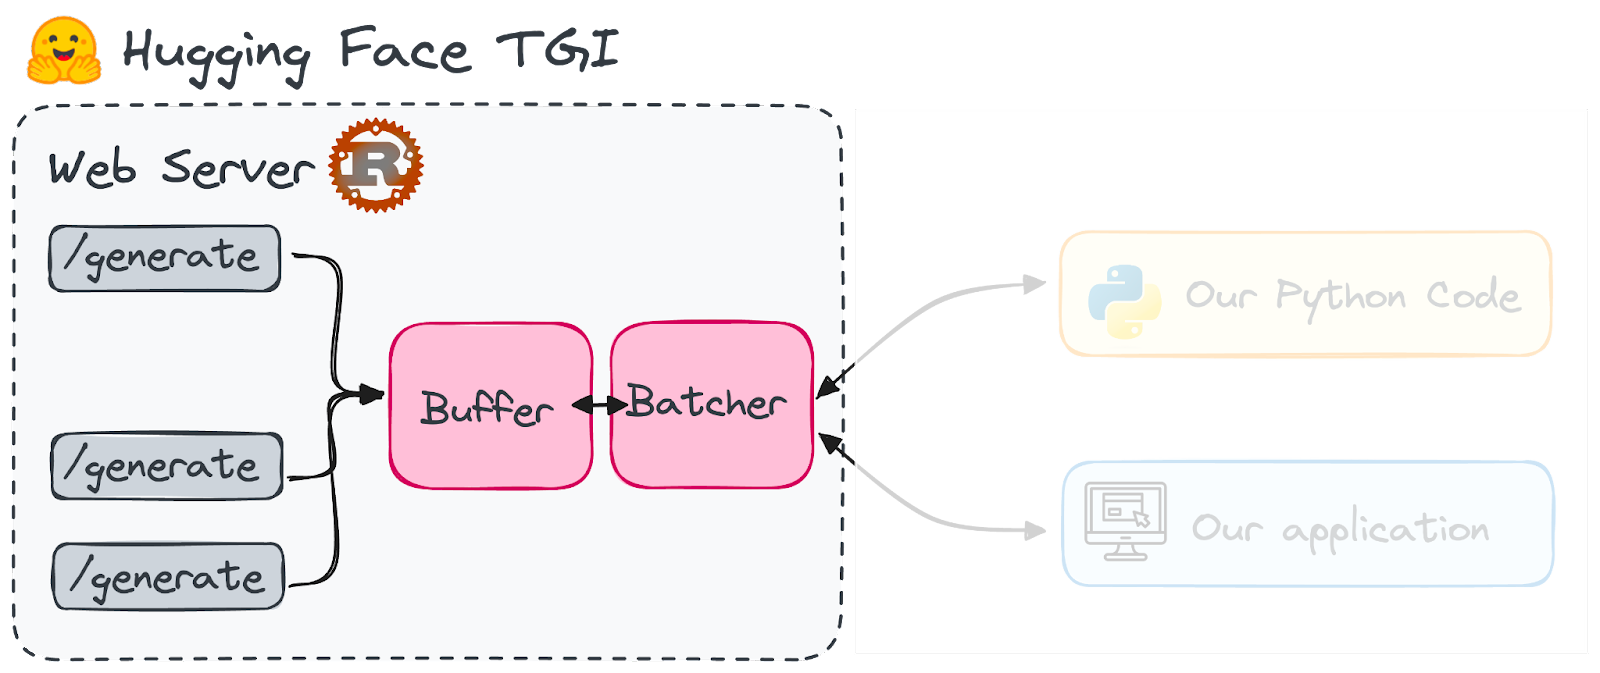
Gambar oleh Penulis.
Untuk menginstal dan menjalankan Hugging Face TGI secara lokal, pertama Anda perlu menginstal Rust lalu membuat lingkungan virtual Python dengan minimal Python 3.9, misalnya menggunakan conda:
#Installing Rust
curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sh


#Creating a python virtual environment
conda create -n text-generation-inference python=3.9
conda activate text-generation-inference
Selain itu, instalasi Protoc diperlukan. Hugging Face menyarankan menggunakan versi 21.12 untuk kompatibilitas optimal. Perlu dicatat bahwa Anda memerlukan hak sudo untuk melanjutkan instalasi ini.
PROTOC_ZIP=protoc-21.12-linux-x86_64.zip
curl -OL https://github.com/protocolbuffers/protobuf/releases/download/v21.12/$PROTOC_ZIP
sudo unzip -o $PROTOC_ZIP -d /usr/local bin/protoc
sudo unzip -o $PROTOC_ZIP -d /usr/local 'include/*'
rm -f $PROTOC_ZIP
Saya akan terlebih dahulu menunjukkan cara menginstalnya dari nol, yang menurut saya tidaklah langsung. Jika Anda mengalami masalah selama prosesnya, Anda dapat melewati bagian pertama ini dan langsung menjalankan image Docker, yang lebih sederhana. Kedua skenario akan dibahas.
Dengan semua prasyarat siap, kita siap menyiapkan TGI. Mulailah dengan meng-clone repositori GitHub:
git clone https://github.com/huggingface/text-generation-inference.gitKemudian, pindah ke lokasi TGI di komputer lokal Anda dan instal dengan perintah berikut:
cd text-generation-inference/
BUILD_EXTENSIONS=False make install
Sekarang mari kita lihat cara menggunakan TGI, dengan dan tanpa Docker. Saya akan menggunakan model Falcon-7B, yang tersedia di bawah lisensi Apache 2.0.
Instalasi membuat perintah baru, “text-generation-launcher” yang akan memulai server TGI. Untuk mengaktifkan end-point dengan model Falcon-7B, kita hanya perlu menjalankan perintah berikut:
text-generation-launcher --model-id tiiuae/falcon-7b-instruct --num-shard 1 --port 8080 --quantize bitsandbytesMakna setiap parameter masukan adalah:
Pastikan Docker terpasang di komputer Anda dan sudah berjalan. Jika Anda belum berpengalaman dengan Docker, Anda bisa mengikuti Tutorial Docker untuk Data Science yang akan memberi Anda pemahaman dasar.
Ingat, TGI tidak kompatibel dengan model Mac berprosesor MX. Anda dapat memeriksa semua image TGI yang tersedia di repositori paket TGI di GitHub. Jika perangkat Anda kompatibel, Docker akan menemukan image yang sesuai untuk Anda.
Parameternya sangat mirip dengan yang digunakan pada text-generation-launcher. Jika Anda hanya menggunakan satu GPU, ganti "all" dengan "0".
volume=$PWD/data
sudo docker run --gpus all --shm-size 1g -p 8080:80 -v $volume:/data ghcr.io/huggingface/text-generation-inference:0.9 --model-id tiiuae/falcon-7b-instruct --num-shard 1  --quantize bitsandbytes
Pastikan image Docker tetap aktif selama Anda berniat menggunakan server.
Anda memiliki beberapa opsi untuk mengintegrasikan server Text Generation Inference (TGI) ke dalam aplikasi Anda. Setelah berjalan, Anda dapat berinteraksi dengan membuat permintaan POST ke endpoint /generate untuk mengambil hasil.
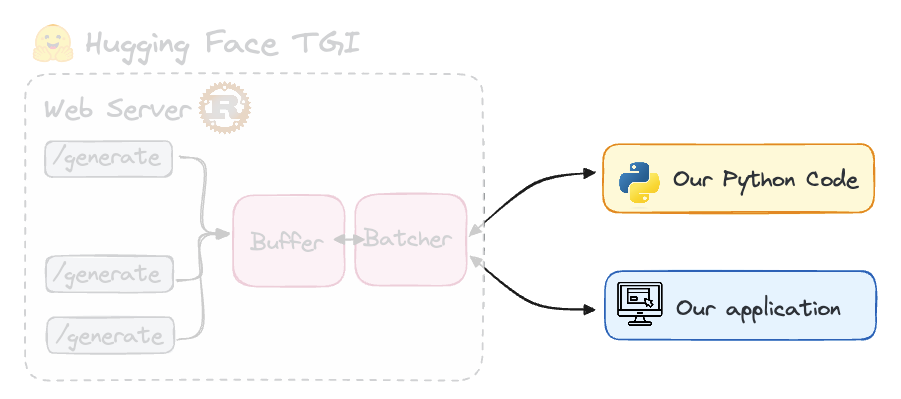
Gambar oleh Penulis.
Jika Anda lebih suka TGI melakukan streaming token secara terus-menerus, gunakan endpoint khusus streaming seperti yang akan kita lihat pada bagian berikutnya. Permintaan ini dapat dibuat menggunakan alat pilihan Anda, termasuk curl, Python, atau TypeScript. Untuk mengajukan kueri ke model yang disajikan oleh TGI dengan skrip Python, Anda harus memasang pustaka text-generation berikut. Cukup jalankan perintah pip berikut:
pip install text-generationSetelah Anda memulai server TGI, instansiasikan InferenceClient() dengan URL ke endpoint yang menyajikan model. Anda kemudian dapat memanggil text_generation() untuk mengakses endpoint melalui Python.
from text_generation import Client
client = Client("http://127.0.0.1:8080")
client.text_generation(prompt="Your prompt here!")
Untuk mengaktifkan streaming dengan InferenceClient, Anda hanya perlu menyetel stream=True. Ini memungkinkan Anda menerima token secara waktu nyata saat dihasilkan di server. Berikut cara menggunakan streaming:
for token in client.text_generation("Your prompt here!", max_new_tokens=12, stream=True):
print(token)Ingat bahwa Anda akan bekerja dengan model yang Anda deploy di endpoint, dalam kasus kita, Falcon-7B. Dengan menggunakan TGI, kita membuat endpoint langsung yang memungkinkan kita mengambil respons dari LLM pilihan kita.
Karenanya, saat menggunakan Python, kita dapat langsung mengirim prompt ke LLM melalui client yang di-host di perangkat lokal kita, dapat diakses melalui port 8080. Jadi skrip Python yang sesuai akan terlihat seperti ini:
from text_generation import Client
client = Client("http://127.0.0.1:8080")
print(client.generate("Translate the following sentence into spanish: 'What does Large Language Model mean?'", max_new_tokens=500).generated_text)
Dan kita akan memperoleh respons dari model tanpa perlu memasangnya di lingkungan kita. Alih-alih menggunakan Python, kita bisa mengajukan kueri ke LLM dengan CURL, seperti pada contoh berikut:
curl 127.0.0.1:8080/generate \
    -X POST \
    -d '{"inputs":"Code in Javascript a function to remove all spaces in a string and then print the string twice.","parameters":{"max_new_tokens":500}}' \
    -H 'Content-Type: application/json'
Setelah mencoba TGI, kecepatannya sangat mengesankan. Menggunakan Falcon-7B (dengan batas 500 token) hanya butuh beberapa detik. Namun, ketika menggunakan pendekatan inferensi biasa (menggunakan pustaka transformers) memerlukan sekitar 30 detik.
Mulai versi 1.4.0, TGI memperkenalkan API yang kompatibel dengan OpenAI Chat Completion API. Messages API baru ini memungkinkan transisi mulus bagi pelanggan dan pengguna dari model OpenAI ke LLM open-source. API ini dirancang untuk integrasi langsung dengan pustaka klien OpenAI atau dengan alat pihak ketiga seperti LangChain atau LlamaIndex.
Dukungan TGI untuk Messages memastikan bahwa Inference Endpoints-nya sepenuhnya kompatibel dengan OpenAI Chat Completion API. Kompatibilitas ini memungkinkan pengguna dengan mudah mengganti skrip yang menggunakan model OpenAI dengan LLM terbuka yang di-host di endpoint TGI tanpa hambatan.
Peningkatan ini mempermudah peralihan, memberikan akses langsung ke berbagai manfaat model open-source, termasuk:
Contoh cara mengintegrasikan TGI dalam protokol OpenAI chat completion dilampirkan sebagai berikut:
from openai import OpenAI

# initialize the client but point it to TGI
client = OpenAI(
    base_url="<ENDPOINT_URL>" + "/v1/",  # replace with your endpoint url
    api_key="<HF_API_TOKEN>",  # replace with your token
)
chat_completion = client.chat.completions.create(
    model="tgi",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "Why is open-source software important?"},
    ],
    stream=True,
    max_tokens=500
)

# iterate and print stream
for message in chat_completion:
    print(message.choices[0].delta.content, end="")
Seperti yang dapat Anda lihat, pustaka openai dapat digunakan untuk mengarahkan ke ENDPOINT kita dan kata sandi Hugging Face kita. Untuk memahami integrasi ini lebih lanjut, Anda dapat melihat dokumentasi Hugging Face TGI.
Sebelum terjun ke HuggingFace TGI, Anda sebaiknya sudah familiar dengan Model Bahasa Besar. Kenali konsep kunci seperti tokenisasi, mekanisme atensi, dan arsitektur Transformer. Landasan ini krusial untuk menyesuaikan model dan menyempurnakan keluaran generasi teks.
Pelajari cara menyiapkan dan mengoptimalkan model untuk kebutuhan spesifik Anda. Ini mencakup memilih model yang tepat, menyesuaikan tokenizer, dan menerapkan teknik untuk meningkatkan kinerja tanpa mengorbankan kualitas.
Pastikan Anda memahami cara kerja HuggingFace dan cara menggunakan HuggingFace Hub untuk pengembangan NLP. Tutorial pengantar yang baik adalah Pengantar Menggunakan Transformers dan Hugging Face.
Fine-tuning juga merupakan konsep yang perlu Anda pahami, karena sering kali model perlu dioptimalkan untuk tujuan tertentu. Anda dapat mempelajari cara fine-tuning model melalui Panduan Pengantar Fine-Tuning LLM
Jelajahi berbagai strategi generasi teks, seperti greedy search, beam search, dan top-k sampling. Masing-masing memiliki kelebihan dan kekurangan, yang memengaruhi koherensi, kreativitas, dan relevansi teks yang dihasilkan.
Toolkit TGI dari Hugging Face memberdayakan siapa pun untuk mengeksplorasi generasi teks AI. Ini menawarkan toolkit yang mudah digunakan untuk men-deploy dan meng-host LLM bagi aplikasi NLP lanjutan yang memerlukan teks mirip manusia.
Walau self-hosting model bahasa besar menawarkan privasi data dan kontrol biaya, hal ini memerlukan perangkat keras yang bertenaga. Namun, kemajuan terbaru di bidang ini memungkinkan model kecil digunakan langsung di mesin lokal kita.
Jika Anda ingin terus meningkatkan kemampuan di bidang LLM, saya sangat menganjurkan Anda mengikuti tutorial yang lebih lanjut. Anda bisa mulai dengan kursus LLM Concepts dari DataCamp, yang membahas banyak metodologi pelatihan kunci dan riset terbaru.
Sumber lain yang baik untuk diikuti antara lain:
Mulai Perjalanan AI Anda Hari Ini!
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Program} other {Program}}
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt




