
Last chance! 50% off DataCamp Premium
Sale ends in
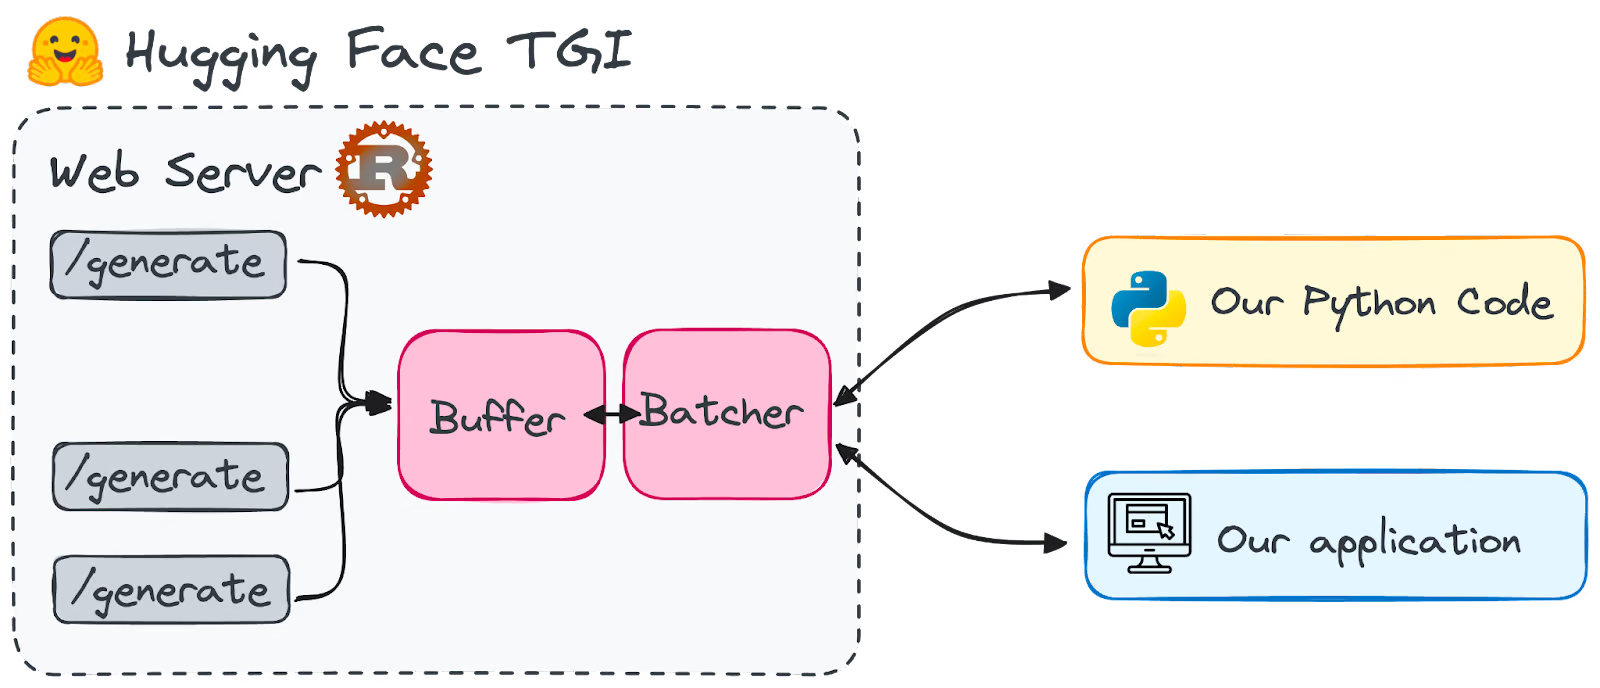
Immagine dell'autore
Nel campo in rapida crescita dell'intelligenza artificiale, i Large Language Model sono diventati i protagonisti delle ultime scoperte.
La generazione di testo è diventata una capacità rivoluzionaria, trasformando il modo in cui le macchine comprendono e producono testo simile a quello umano. Questa popolarità spiega perché sono stati lanciati numerosi strumenti per semplificare e agevolare il lavoro con gli LLM.
La rapida proliferazione dei Large Language Model (LLM), con nuovi modelli che emergono quasi ogni settimana, ha stimolato una crescita parallela nelle opzioni di hosting per supportare questa tecnologia. Nel vasto universo di strumenti disponibili a tale scopo, il Text Generation Inference (TGI) di Hugging Face spicca in particolare, perché ci permette di eseguire un LLM come servizio sulla nostra macchina locale.
In parole povere, ci consente di avere un endpoint per chiamare il nostro modello.
Questa guida esplorerà perché Hugging Face TGI è una svolta e come puoi sfruttarlo per creare modelli di IA sofisticati, in grado di generare testo sempre più indistinguibile da quello prodotto dagli esseri umani.
Hugging Face Text Generation Inference, noto anche come TGI, è un framework scritto in Rust e Python per il deployment e il serving di Large Language Model. È un toolkit pronto per la produzione per distribuire e servire LLM.
Hugging Face lo sviluppa e distribuisce con licenza HFOILv1.0, che ne consente l'uso commerciale a patto che serva come strumento ausiliario all'interno del prodotto o servizio offerto e non come focus principale. Le principali sfide che affronta sono:
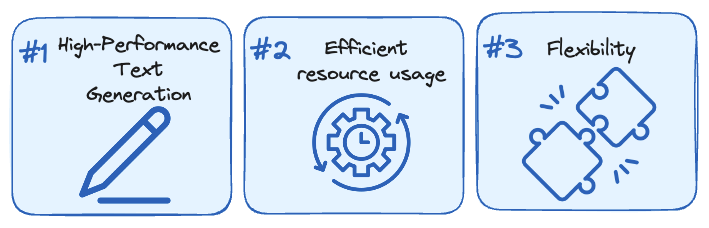
Immagine dell'autore.
Hugging Face ha ottimizzato alcune architetture di LLM in modo che girino più velocemente con TGI. Ciò include modelli popolari come LLaMA, Falcon7B e Mistral. L'elenco completo è disponibile nella loro documentazione.
Hugging Face è diventato il punto di riferimento per creare IA con capacità di linguaggio naturale. È un hub dove si trovano tutti i modelli open source più potenti, che lo rende un motore di innovazione nell'NLP. Finora, la maggior parte di questi modelli era troppo pesante per essere usata direttamente in locale; c'era sempre una dipendenza da servizi cloud.
Tuttavia, considerando i più recenti progressi con tecniche di quantizzazione come QLoRa e GPTQ, alcuni LLM sono diventati gestibili sui nostri dispositivi di tutti i giorni — come i nostri computer locali.
Hugging Face TGI è progettato specificamente per offrirci LLM come servizio sulle nostre macchine locali. Il motivo principale è la fatica di avviare un LLM.
Per evitare i tempi morti, è più intelligente mantenere il modello pronto in background, predisposto per risposte rapide. Altrimenti, resti bloccato in un ciclo di attese lunghe ogni volta che lo interroghi. Immagina di avere un endpoint con una collezione dei migliori modelli linguistici a tua disposizione, pronti a tessere parole a comando.
Ciò che mi ha colpito di TGI è il suo approccio senza fronzoli. Al momento, TGI è pronto a lavorare con un bel po' di architetture di modelli snellite, rendendo semplicissimo distribuirle al volo.
E non sono solo parole; TGI è già il motore dietro diversi progetti in produzione. Alcuni esempi sono:
Immagine dell'autore. Loghi di Hugging Chat (a sinistra) e OpenAssistant (a destra)
C'è però un limite importante. TGI non è ancora compatibile con i Mac con GPU basate su ARM, inclusa la serie M1 e modelli successivi.
Per prima cosa, dobbiamo configurare il nostro endpoint TGI di Hugging Face.
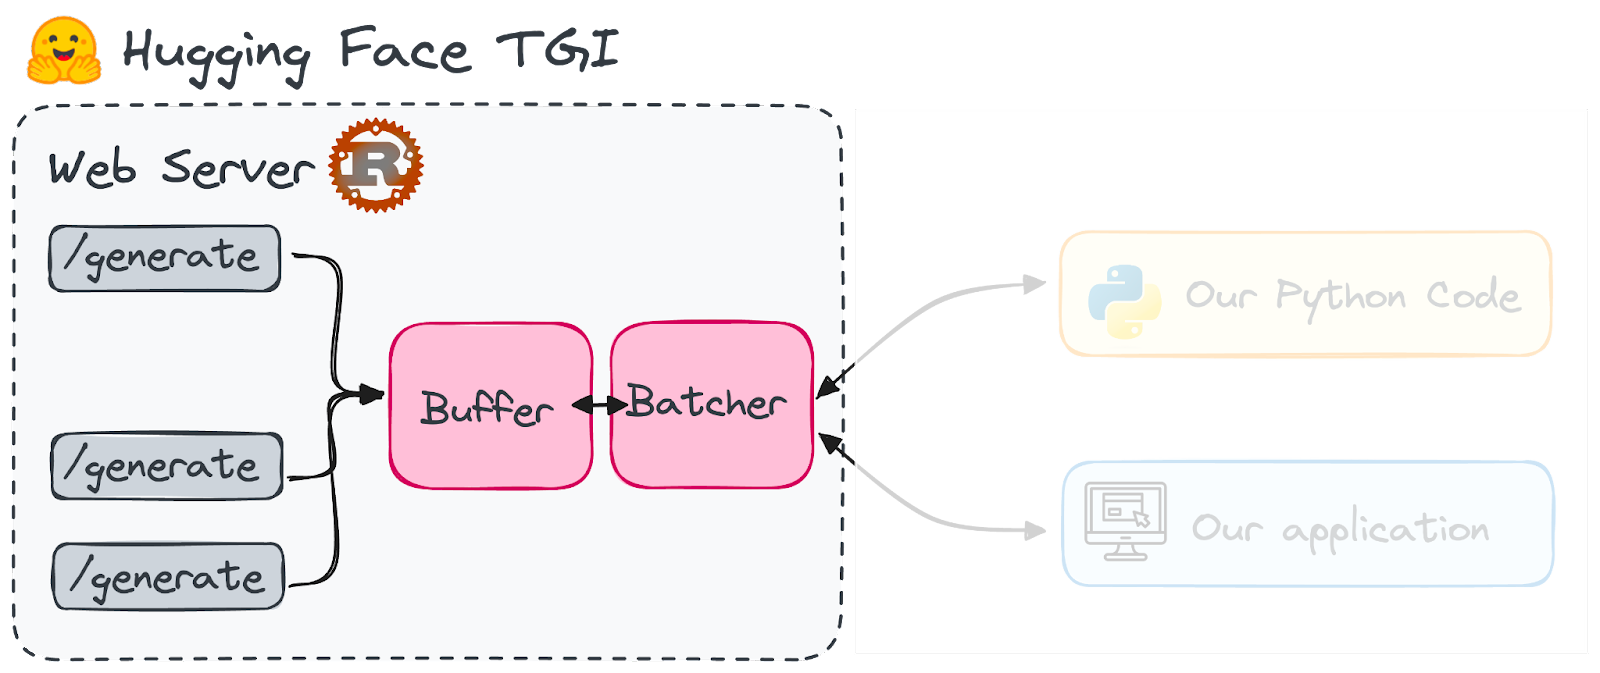
Immagine dell'autore.
Per installare ed eseguire in locale Hugging Face TGI, per prima cosa devi installare Rust e poi creare un ambiente virtuale Python con almeno Python 3.9, ad esempio usando conda:
#Installing Rust
curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sh


#Creating a python virtual environment
conda create -n text-generation-inference python=3.9
conda activate text-generation-inference
Inoltre, è necessaria l'installazione di Protoc. Hugging Face suggerisce la versione 21.12 per una compatibilità ottimale. Nota che avrai bisogno dei privilegi sudo per procedere con questa installazione.
PROTOC_ZIP=protoc-21.12-linux-x86_64.zip
curl -OL https://github.com/protocolbuffers/protobuf/releases/download/v21.12/$PROTOC_ZIP
sudo unzip -o $PROTOC_ZIP -d /usr/local bin/protoc
sudo unzip -o $PROTOC_ZIP -d /usr/local 'include/*'
rm -f $PROTOC_ZIP
Per prima cosa mostrerò come installarlo da zero, cosa che secondo me non è immediata. Se riscontri problemi durante il processo, puoi saltare questa prima parte ed eseguire direttamente un'immagine Docker, che è più semplice. Entrambi gli scenari verranno affrontati.
Con tutti i prerequisiti a posto, siamo pronti a configurare TGI. Inizia clonando il repository GitHub:
git clone https://github.com/huggingface/text-generation-inference.gitPoi, spostati nella cartella di TGI sul tuo computer locale e installalo con i seguenti comandi:
cd text-generation-inference/
BUILD_EXTENSIONS=False make install
Ora vediamo come usare TGI, sia con che senza Docker. Userò il modello Falcon-7B, disponibile sotto licenza Apache 2.0.
L'installazione ha creato un nuovo comando, "text-generation-launcher", che avvierà il server TGI. Per attivare un endpoint con il modello Falcon-7B, ci basta eseguire il seguente comando:
text-generation-launcher --model-id tiiuae/falcon-7b-instruct --num-shard 1 --port 8080 --quantize bitsandbytesDove ciascun parametro è:
Assicurati di avere Docker installato sul tuo computer e che sia in esecuzione. Se non hai esperienza con Docker, puoi seguire questo tutorial Docker per la Data Science che ti darà le nozioni più basilari.
Ricorda, TGI non è compatibile con i modelli Mac con processore MX. Puoi controllare tutte le immagini TGI disponibili nel relativo repository GitHub dei pacchetti TGI. Se il tuo dispositivo è compatibile, Docker dovrebbe trovare l'immagine corrispondente per te.
I parametri rispecchiano da vicino quelli usati con text-generation-launcher. Se stai operando con una sola GPU, sostituisci "all" con "0".
volume=$PWD/data
sudo docker run --gpus all --shm-size 1g -p 8080:80 -v $volume:/data ghcr.io/huggingface/text-generation-inference:0.9 --model-id tiiuae/falcon-7b-instruct --num-shard 1  --quantize bitsandbytes
Assicurati che l'immagine Docker resti attiva per tutto il tempo in cui intendi usare il server.
Hai più opzioni per integrare il server Text Generation Inference (TGI) nelle tue applicazioni. Una volta attivo, puoi interagirci effettuando una richiesta POST all'endpoint /generate per recuperare i risultati.
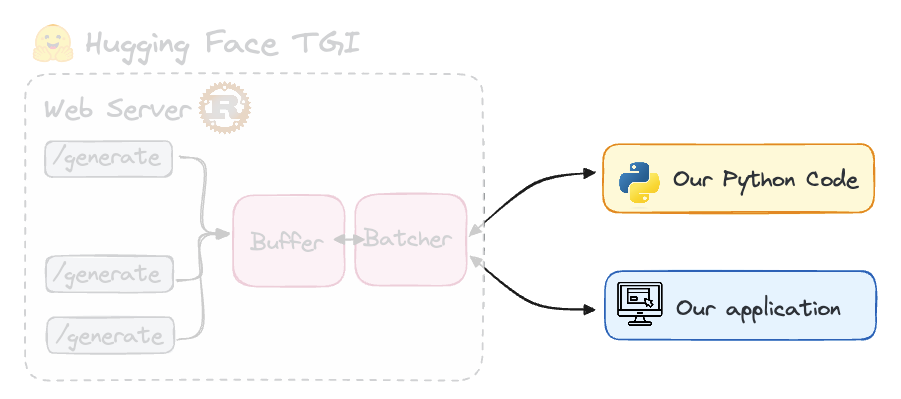
Immagine dell'autore.
Se preferisci che TGI trasmetta i token in modo continuo, usa invece l'endpoint di streaming, come vedremo nella prossima sezione. Queste richieste possono essere effettuate con lo strumento che preferisci, inclusi curl, Python o TypeScript. Per interrogare il modello servito da TGI con uno script Python, dovrai installare la seguente libreria text-generation. È sufficiente eseguire il seguente comando pip:
pip install text-generationUna volta avviato il server TGI, istanzia InferenceClient() con l'URL dell'endpoint che serve il modello. Puoi poi chiamare text_generation() per colpire l'endpoint tramite Python.
from text_generation import Client
client = Client("http://127.0.0.1:8080")
client.text_generation(prompt="Your prompt here!")
Per abilitare lo streaming con InferenceClient, ti basta impostare stream=True. Questo ti permetterà di ricevere i token in tempo reale man mano che vengono generati sul server. Ecco come usare lo streaming:
for token in client.text_generation("Your prompt here!", max_new_tokens=12, stream=True):
print(token)Ricorda che lavorerai con il modello che hai distribuito nel tuo endpoint, nel nostro caso Falcon-7B. Usando TGI, creiamo un endpoint live che ci consente di ottenere risposte dall'LLM che scegliamo.
Di conseguenza, usando Python possiamo inviare direttamente prompt all'LLM tramite il client ospitato sul nostro dispositivo locale, accessibile attraverso la porta 8080. Quindi lo script Python corrispondente sarà qualcosa di simile:
from text_generation import Client
client = Client("http://127.0.0.1:8080")
print(client.generate("Translate the following sentence into spanish: 'What does Large Language Model mean?'", max_new_tokens=500).generated_text)
E otterremo una risposta dal modello senza bisogno di installarlo nel nostro ambiente. In alternativa a Python, possiamo interrogare l'LLM con CURL, come puoi vedere nel seguente esempio:
curl 127.0.0.1:8080/generate \
    -X POST \
    -d '{"inputs":"Code in Javascript a function to remove all spaces in a string and then print the string twice.","parameters":{"max_new_tokens":500}}' \
    -H 'Content-Type: application/json'
Dopo aver provato un po' TGI, mostra una velocità notevole. Usando Falcon-7B (con un limite di 500 token) impiega pochi secondi. Tuttavia, quando si utilizza l'approccio di inferenza tipico (usando la libreria transformers) ci vogliono circa 30 secondi.
Dalla versione 1.4.0 in poi, TGI ha introdotto un'API compatibile con la Chat Completion API di OpenAI. Questa nuova Messages API consente una transizione fluida per clienti e utenti dai modelli OpenAI agli LLM open source. L'API è progettata per l'integrazione diretta con le librerie client di OpenAI o con strumenti di terze parti come LangChain o LlamaIndex.
Il supporto di TGI per Messages garantisce che i suoi Inference Endpoint siano pienamente compatibili con la Chat Completion API di OpenAI. Questa compatibilità consente agli utenti di sostituire facilmente qualsiasi script esistente che usa modelli OpenAI con LLM aperti ospitati su endpoint TGI senza alcuno sforzo.
Questo aggiornamento facilita un passaggio senza attriti, garantendo accesso immediato ai vasti vantaggi dei modelli open source, tra cui:
Un esempio di come integrare TGI nel protocollo OpenAI chat completion è il seguente:
from openai import OpenAI

# initialize the client but point it to TGI
client = OpenAI(
    base_url="<ENDPOINT_URL>" + "/v1/",  # replace with your endpoint url
    api_key="<HF_API_TOKEN>",  # replace with your token
)
chat_completion = client.chat.completions.create(
    model="tgi",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "Why is open-source software important?"},
    ],
    stream=True,
    max_tokens=500
)

# iterate and print stream
for message in chat_completion:
    print(message.choices[0].delta.content, end="")
Come puoi vedere, la libreria openai può essere usata per indicare il nostro ENDPOINT e la nostra password di Hugging Face. Per approfondire questa integrazione, puoi consultare la documentazione di Hugging Face TGI.
Prima di lanciarti su HuggingFace TGI, dovresti avere già familiarità con i Large Language Model. Familiarizza con concetti chiave come tokenizzazione, meccanismi di attenzione e l'architettura Transformer. Queste basi sono cruciali per personalizzare i modelli e migliorare gli output di generazione del testo.
Impara a preparare e ottimizzare i modelli per le tue esigenze specifiche. Ciò include la scelta del modello giusto, la personalizzazione dei tokenizer e l'impiego di tecniche per migliorare le prestazioni senza sacrificare la qualità.
Assicurati di capire come funziona HuggingFace e come usare l'HuggingFace Hub per lo sviluppo NLP. Un buon tutorial introduttivo è Introduzione all'uso dei Transformer e di Hugging Face.
Anche il fine-tuning è un concetto che dovresti conoscere, perché il più delle volte i modelli vanno ottimizzati per obiettivi specifici. Puoi imparare come effettuare il fine-tuning di un modello con la Guida introduttiva al fine-tuning degli LLM
Esplora varie strategie per la generazione di testo, come greedy search, beam search e top-k sampling. Ogni strategia ha pro e contro, che influiscono su coerenza, creatività e pertinenza del testo generato.
Il toolkit TGI di Hugging Face permette a chiunque di esplorare la generazione di testo con l'IA. Offre un toolkit facile da usare per distribuire e ospitare LLM per applicazioni NLP avanzate che richiedono testo simile a quello umano.
Sebbene l'auto-hosting dei large language model offra privacy dei dati e controllo dei costi, richiede hardware potente. Tuttavia, i più recenti progressi nel campo consentono di usare direttamente in locale modelli più piccoli.
Se vuoi continuare a migliorare nel campo degli LLM, ti incoraggio vivamente a seguire tutorial più avanzati. Puoi iniziare con il corso sui concetti degli LLM di DataCamp, che copre molte delle principali metodologie di training e le ricerche più recenti.
Altre buone risorse da seguire sono:
Inizia oggi il tuo percorso nell'AI!
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min




