Khóa học
Các khái niệm về Large Language Models (LLMs)
2 giờ
113.4K
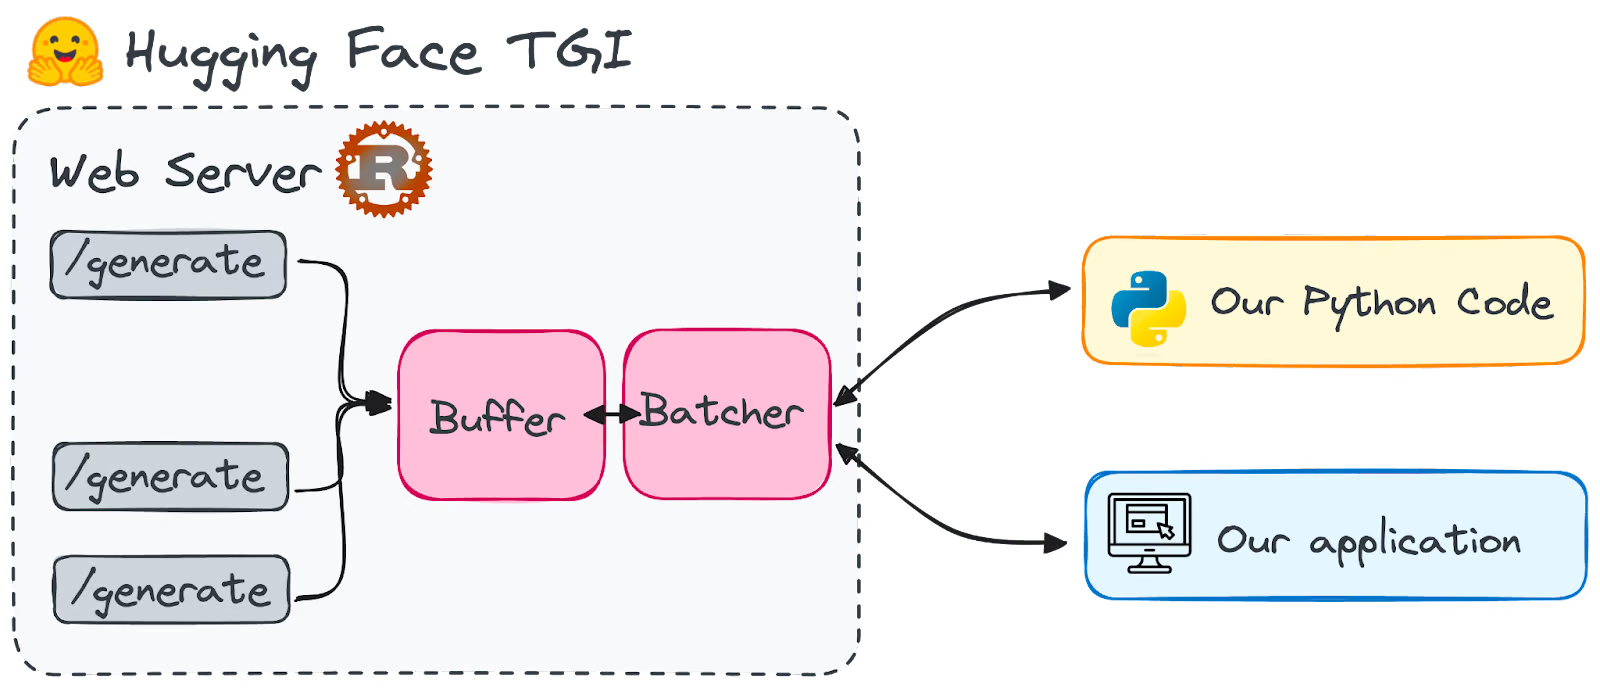
Hình do tác giả cung cấp
Trong lĩnh vực trí tuệ nhân tạo phát triển nhanh chóng, các Mô hình Ngôn ngữ Lớn đã trở thành nhân vật chính của những đột phá gần đây.
Sinh văn bản đã trở thành một năng lực mang tính đột phá, thay đổi cách máy móc hiểu và tạo ra văn bản giống con người. Chính vì sức hút này mà nhiều công cụ đã ra đời để làm mượt và đơn giản hóa quy trình làm việc với LLM.
Sự bùng nổ nhanh chóng của các Mô hình Ngôn ngữ Lớn (LLM), với những mô hình mới xuất hiện gần như hàng tuần, đã kéo theo sự phát triển song song của các lựa chọn lưu trữ để đáp ứng công nghệ này. Trong hệ sinh thái công cụ rộng lớn phục vụ mục đích đó, Text Generation Inference (TGI) của Hugging Face đặc biệt đáng chú ý, vì nó cho phép chúng ta chạy LLM như một dịch vụ ngay trên máy cục bộ.
Nói đơn giản, nó cho phép chúng ta có một end-point để gọi mô hình của mình.
Hướng dẫn này sẽ khám phá lý do vì sao Hugging Face TGI là một bước ngoặt, và cách bạn có thể tận dụng nó để tạo ra các mô hình AI tinh vi có khả năng sinh văn bản ngày càng khó phân biệt với văn bản do con người tạo ra.
Hugging Face Text Generation Inference, còn gọi là TGI, là một framework viết bằng Rust và Python để triển khai và phục vụ Mô hình Ngôn ngữ Lớn. Đây là bộ công cụ sẵn sàng cho sản xuất để triển khai và phục vụ LLM.
Hugging Face phát triển và phân phối nó theo giấy phép HFOILv1.0, cho phép sử dụng thương mại với điều kiện nó đóng vai trò công cụ hỗ trợ trong sản phẩm hoặc dịch vụ được cung cấp thay vì là trọng tâm chính. Những thách thức chính mà nó giải quyết gồm:
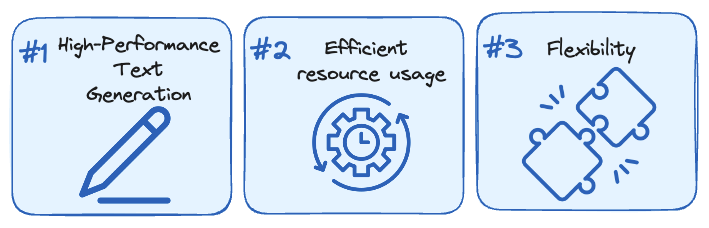
Hình do tác giả cung cấp.
Hugging Face đã tối ưu một số kiến trúc LLM để chúng chạy nhanh hơn với TGI. Bao gồm các mô hình phổ biến như LLaMA, Falcon7B và Mistral. Danh sách đầy đủ có thể xem trong tài liệu của họ.
Hugging Face đã trở thành điểm đến hàng đầu để xây dựng AI có khả năng ngôn ngữ tự nhiên. Đây là nơi hội tụ của các mô hình mã nguồn mở hạng nặng, biến nó thành trung tâm cho đổi mới NLP. Trước đây, hầu hết các mô hình này quá nặng để chạy trực tiếp cục bộ; luôn phải phụ thuộc vào dịch vụ đám mây.
Tuy nhiên, với những tiến bộ gần đây như lượng tử hóa bằng QLoRa và GPTQ, một số LLM đã trở nên vừa sức với các thiết bị hằng ngày của chúng ta - như máy tính cá nhân.
Hugging Face TGI được thiết kế riêng để cung cấp LLM như một dịch vụ trên máy cục bộ. Lý do chính là việc khởi động một LLM khá tốn công.
Để tránh thời gian chết, tốt hơn nên giữ mô hình luôn sẵn sàng chạy nền, sẵn sàng phản hồi nhanh. Nếu không, bạn sẽ phải chờ lâu mỗi lần gửi prompt. Hãy tưởng tượng bạn có một endpoint với bộ sưu tập các mô hình ngôn ngữ hàng đầu, sẵn sàng dệt nên câu chữ theo ý bạn.
Điều khiến tôi chú ý ở TGI là cách tiếp cận gọn nhẹ, không rườm rà. Hiện tại, TGI đã sẵn sàng làm việc với một loạt kiến trúc mô hình tinh gọn, giúp triển khai trở nên rất nhanh chóng.
Và đây không chỉ là lý thuyết; TGI đã là động cơ đứng sau nhiều dự án đang chạy thực tế. Một vài ví dụ:
Hình do tác giả cung cấp. Logo của Hugging Chat (trái) và OpenAssistant (phải)
Tuy nhiên, có một hạn chế đáng kể: TGI hiện chưa tương thích với các máy Mac GPU kiến trúc ARM, bao gồm dòng M1 trở về sau.
Đầu tiên, chúng ta cần thiết lập endpoint của Hugging Face TGI.
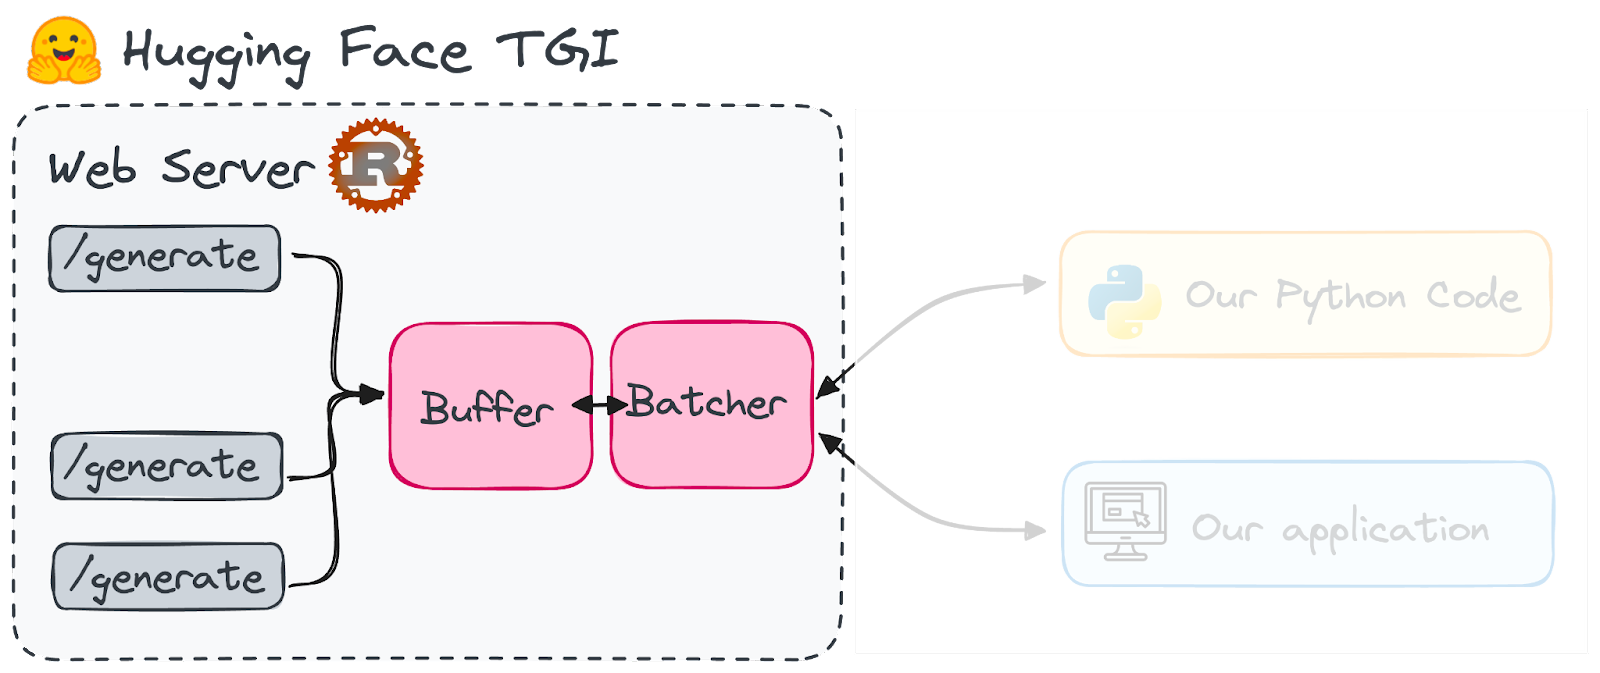
Hình do tác giả cung cấp.
Để cài đặt và chạy Hugging Face TGI cục bộ, trước tiên bạn cần cài Rust và sau đó tạo môi trường ảo Python với ít nhất Python 3.9, ví dụ dùng conda:
#Installing Rust
curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sh


#Creating a python virtual environment
conda create -n text-generation-inference python=3.9
conda activate text-generation-inference
Ngoài ra, cần cài Protoc. Hugging Face đề xuất dùng phiên bản 21.12 để tương thích tối ưu. Lưu ý bạn sẽ cần quyền sudo để tiếp tục cài đặt này.
PROTOC_ZIP=protoc-21.12-linux-x86_64.zip
curl -OL https://github.com/protocolbuffers/protobuf/releases/download/v21.12/$PROTOC_ZIP
sudo unzip -o $PROTOC_ZIP -d /usr/local bin/protoc
sudo unzip -o $PROTOC_ZIP -d /usr/local 'include/*'
rm -f $PROTOC_ZIP
Trước hết tôi sẽ trình bày cách cài đặt từ đầu, vốn không hẳn đơn giản. Nếu gặp trục trặc trong quá trình, bạn có thể bỏ qua phần đầu này và chạy trực tiếp bằng Docker image, cách này dễ hơn. Cả hai kịch bản sẽ được đề cập.
Khi đã đáp ứng đủ các điều kiện tiên quyết, chúng ta sẵn sàng thiết lập TGI. Bắt đầu bằng cách cloning kho GitHub:
git clone https://github.com/huggingface/text-generation-inference.gitSau đó chuyển vào thư mục TGI trên máy bạn và cài đặt bằng các lệnh sau:
cd text-generation-inference/
BUILD_EXTENSIONS=False make install
Giờ hãy xem cách dùng TGI, cả có và không dùng Docker. Tôi sẽ dùng mô hình Falcon-7B, được phát hành theo giấy phép Apache 2.0.
Việc cài đặt đã tạo một lệnh mới, “text-generation-launcher”, để khởi động máy chủ TGI. Để kích hoạt một endpoint với mô hình Falcon-7B, ta chỉ cần chạy lệnh sau:
text-generation-launcher --model-id tiiuae/falcon-7b-instruct --num-shard 1 --port 8080 --quantize bitsandbytesTrong đó mỗi tham số là:
Đảm bảo bạn đã cài Docker trên máy và đang chạy. Nếu chưa có kinh nghiệm với Docker, bạn có thể theo dõi hướng dẫn Docker cho Khoa học Dữ liệu để nắm các khái niệm cơ bản.
Lưu ý, TGI không tương thích với các mẫu Mac dùng vi xử lý MX. Bạn có thể kiểm tra tất cả image TGI có sẵn trong kho gói TGI trên GitHub. Nếu thiết bị tương thích, Docker sẽ tìm image phù hợp cho bạn.
Các tham số gần như giống với text-generation-launcher. Nếu bạn chỉ có một GPU, thay "all" bằng "0".
volume=$PWD/data
sudo docker run --gpus all --shm-size 1g -p 8080:80 -v $volume:/data ghcr.io/huggingface/text-generation-inference:0.9 --model-id tiiuae/falcon-7b-instruct --num-shard 1  --quantize bitsandbytes
Đảm bảo Docker image vẫn hoạt động trong suốt thời gian bạn muốn dùng máy chủ.
Bạn có nhiều lựa chọn để tích hợp máy chủ Text Generation Inference (TGI) vào ứng dụng. Khi máy chủ đã chạy, bạn có thể tương tác bằng cách gửi yêu cầu POST tới endpoint /generate để lấy kết quả.
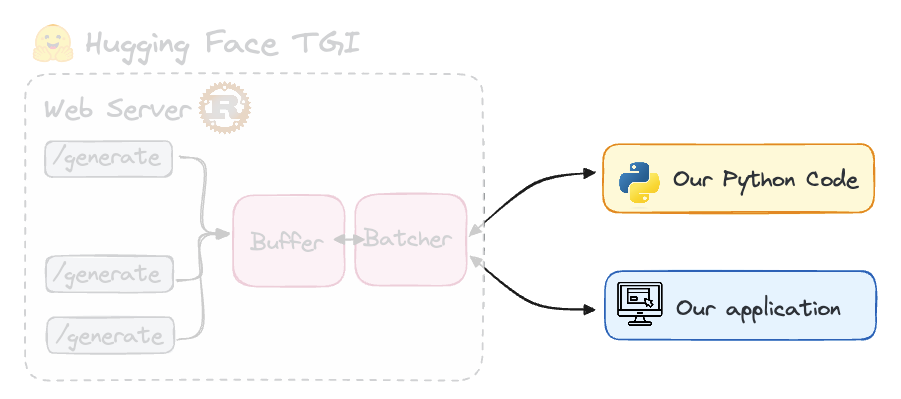
Hình do tác giả cung cấp.
Nếu bạn muốn TGI stream token liên tục, hãy dùng endpoint tương ứng như phần tiếp theo. Bạn có thể gửi yêu cầu bằng công cụ tùy chọn, bao gồm curl, Python hoặc TypeScript. Để truy vấn mô hình do TGI phục vụ bằng Python, bạn cần cài thư viện text-generation sau. Chỉ cần chạy lệnh pip sau:
pip install text-generationKhi đã khởi động máy chủ TGI, khởi tạo InferenceClient() với URL tới endpoint đang phục vụ mô hình. Sau đó, bạn có thể gọi text_generation() để truy cập endpoint qua Python.
from text_generation import Client
client = Client("http://127.0.0.1:8080")
client.text_generation(prompt="Your prompt here!")
Để bật streaming với InferenceClient, bạn chỉ cần đặt stream=True. Điều này cho phép nhận token theo thời gian thực khi chúng được sinh ra trên máy chủ. Cách dùng streaming như sau:
for token in client.text_generation("Your prompt here!", max_new_tokens=12, stream=True):
print(token)Hãy nhớ bạn sẽ làm việc với mô hình bạn đã triển khai trên endpoint, trong trường hợp này là Falcon-7B. Khi dùng TGI, ta tạo một endpoint trực tuyến cho phép lấy phản hồi từ LLM tùy chọn.
Do đó, khi dùng Python, ta có thể gửi prompt trực tiếp tới LLM thông qua client chạy trên thiết bị cục bộ, truy cập qua cổng 8080. Script Python tương ứng sẽ như sau:
from text_generation import Client
client = Client("http://127.0.0.1:8080")
print(client.generate("Translate the following sentence into spanish: 'What does Large Language Model mean?'", max_new_tokens=500).generated_text)
Và chúng ta sẽ nhận được phản hồi từ mô hình mà không cần cài đặt mô hình vào môi trường của mình. Thay vì dùng Python, ta có thể truy vấn LLM bằng CURL, như ví dụ sau:
curl 127.0.0.1:8080/generate \
    -X POST \
    -d '{"inputs":"Code in Javascript a function to remove all spaces in a string and then print the string twice.","parameters":{"max_new_tokens":500}}' \
    -H 'Content-Type: application/json'
Sau khi thử nghiệm một chút với TGI, có thể thấy tốc độ rất ấn tượng. Dùng Falcon-7B (giới hạn 500 token) chỉ mất vài giây. Trong khi đó, với cách suy luận thông thường (dùng thư viện transformers) mất khoảng 30 giây.
Từ phiên bản 1.4.0 trở đi, TGI đã giới thiệu một API tương thích với OpenAI Chat Completion API. Messages API mới này cho phép khách hàng và người dùng chuyển đổi mượt mà từ các mô hình OpenAI sang LLM mã nguồn mở. API được thiết kế để tích hợp trực tiếp với thư viện khách hàng của OpenAI hoặc với công cụ bên thứ ba như LangChain hay LlamaIndex.
Việc TGI hỗ trợ Messages đảm bảo các Inference Endpoint của nó hoàn toàn tương thích với OpenAI Chat Completion API. Nhờ đó, người dùng có thể dễ dàng thay thế các script đang dùng mô hình OpenAI bằng các LLM mở được lưu trữ trên endpoint TGI mà không gặp rắc rối.
Bản nâng cấp này giúp chuyển đổi nhẹ nhàng, cho phép truy cập ngay vào những lợi thế phong phú của mô hình mã nguồn mở, bao gồm:
Ví dụ về cách tích hợp TGI theo giao thức OpenAI chat completion như sau:
from openai import OpenAI

# initialize the client but point it to TGI
client = OpenAI(
    base_url="<ENDPOINT_URL>" + "/v1/",  # replace with your endpoint url
    api_key="<HF_API_TOKEN>",  # replace with your token
)
chat_completion = client.chat.completions.create(
    model="tgi",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "Why is open-source software important?"},
    ],
    stream=True,
    max_tokens=500
)

# iterate and print stream
for message in chat_completion:
    print(message.choices[0].delta.content, end="")
Như bạn thấy, thư viện openai có thể được dùng để trỏ tới ENDPOINT và mật khẩu Hugging Face của chúng ta. Để hiểu sâu hơn về tích hợp này, bạn có thể xem tài liệu Hugging Face TGI.
Trước khi “lao” vào HuggingFace TGI, bạn nên quen thuộc với các Mô hình Ngôn ngữ Lớn. Hãy làm quen với các khái niệm như tokenization, cơ chế attention và kiến trúc Transformer. Đây là nền tảng quan trọng để tùy biến mô hình và tinh chỉnh đầu ra sinh văn bản.
Học cách chuẩn bị và tối ưu mô hình cho nhu cầu cụ thể của bạn. Bao gồm chọn mô hình phù hợp, tùy biến tokenizer và áp dụng các kỹ thuật nâng cao hiệu năng mà không đánh đổi chất lượng.
Đảm bảo bạn hiểu cách HuggingFace vận hành và cách dùng HuggingFace Hub cho phát triển NLP. Một hướng dẫn nhập môn tốt là Giới thiệu về dùng Transformers và Hugging Face.
Fine-tuning cũng là khái niệm bạn nên nắm, vì đa phần mô hình cần được tối ưu cho mục tiêu cụ thể. Bạn có thể học cách fine-tune mô hình với Hướng dẫn nhập môn về Fine-Tuning LLM
Khám phá các chiến lược sinh văn bản khác nhau, như greedy search, beam search và top-k sampling. Mỗi chiến lược có ưu nhược điểm riêng, ảnh hưởng đến độ mạch lạc, tính sáng tạo và mức độ liên quan của văn bản sinh ra.
Bộ công cụ TGI của Hugging Face giúp bất kỳ ai cũng có thể khám phá sinh văn bản bằng AI. Nó cung cấp bộ công cụ dễ dùng để triển khai và lưu trữ LLM cho các ứng dụng NLP nâng cao đòi hỏi văn bản giống con người.
Dù tự lưu trữ mô hình ngôn ngữ lớn mang lại quyền riêng tư dữ liệu và kiểm soát chi phí, nó đòi hỏi phần cứng mạnh. Tuy nhiên, các tiến bộ mới nhất cho phép dùng trực tiếp các mô hình nhỏ trên máy cục bộ của chúng ta.
Nếu bạn muốn tiếp tục nâng cao kỹ năng trong lĩnh vực LLM, tôi khuyến khích bạn thực hiện các hướng dẫn nâng cao hơn. Bạn có thể bắt đầu với khóa học LLM Concepts của DataCamp, bao quát nhiều phương pháp huấn luyện chủ chốt và nghiên cứu mới nhất.
Một vài tài nguyên hay khác nên theo dõi:
Bắt đầu hành trình AI của bạn ngay hôm nay!
Khóa học
Khóa học
Lộ trình
blog
Matt Crabtree
10 phút
