
Kurs
Konzepte großer Sprachmodelle (LLMs)
2 Std.
109.8K
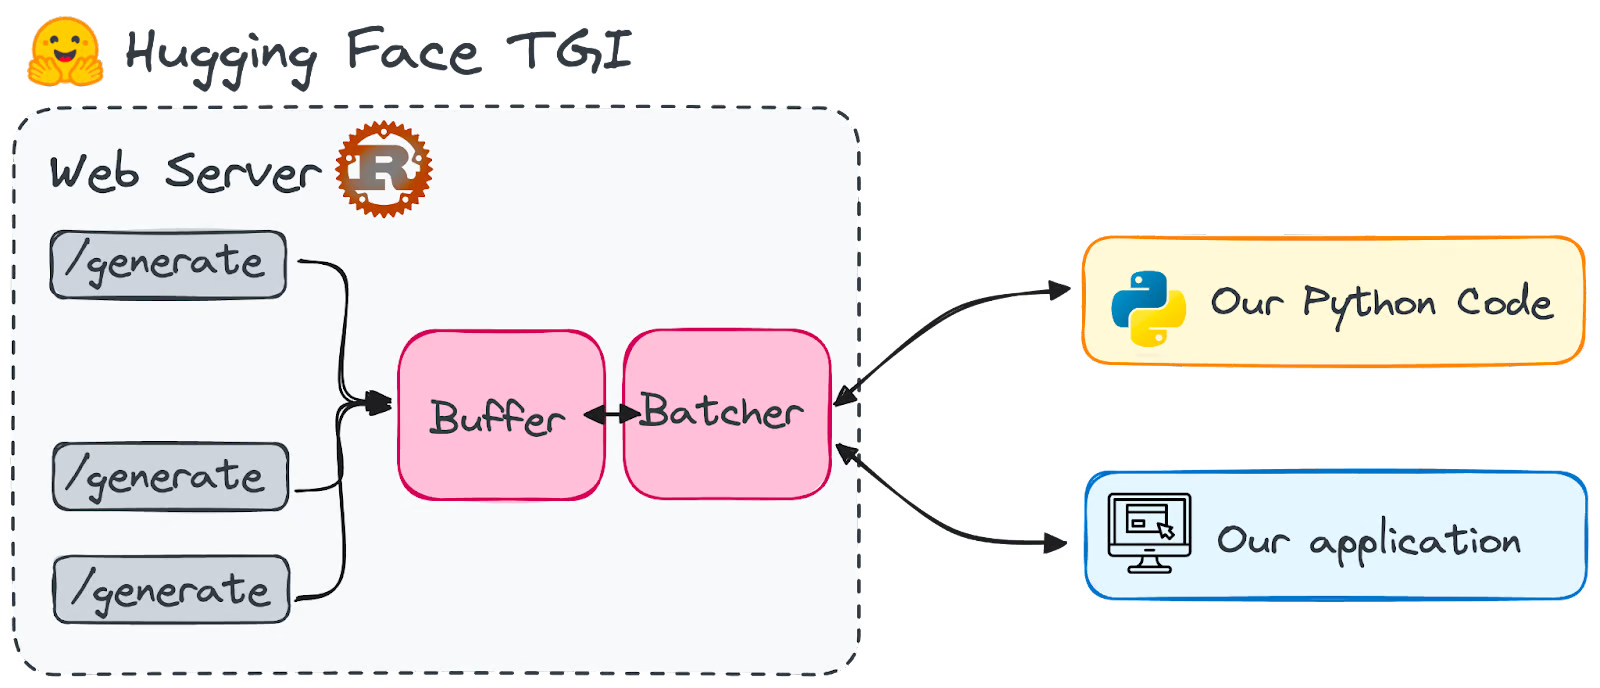
Bild von der Autorin/vom Autor
Im rasant wachsenden Feld der Künstlichen Intelligenz sind Large Language Models zu den Hauptakteuren der jüngsten Durchbrüche avanciert.
Die Textgenerierung hat sich zu einer bahnbrechenden Fähigkeit entwickelt, die verändert, wie Maschinen menschenähnlichen Text verstehen und erzeugen. Entsprechend sind zahlreiche Tools entstanden, die die Arbeit mit LLMs vereinfachen und beschleunigen.
Die schnelle Verbreitung von Large Language Models (LLMs), von denen fast wöchentlich neue erscheinen, hat parallel zu einem Boom an Hosting-Optionen geführt. In diesem Tool-Universum ist Hugging Faces Text Generation Inference (TGI) besonders bemerkenswert, denn damit lässt sich ein LLM als Service direkt auf dem eigenen Rechner betreiben.
Kurz gesagt: Du bekommst einen Endpoint, über den du dein Modell ansprechen kannst.
In diesem Guide erfährst du, warum Hugging Face TGI ein Gamechanger ist und wie du es nutzt, um leistungsfähige KI-Modelle bereitzustellen, die Texte erzeugen, die kaum noch von menschlichem Schreiben zu unterscheiden sind.
Hugging Face Text Generation Inference, kurz TGI, ist ein in Rust und Python geschriebenes Framework zum Bereitstellen und Serven großer Sprachmodelle. Es ist ein produktionsreifes Toolkit für Deployment und Serving von LLMs.
Hugging Face entwickelt und vertreibt es unter der HFOILv1.0-Lizenz, die kommerzielle Nutzung erlaubt, sofern TGI als unterstützendes Werkzeug innerhalb des Produkts bzw. Services dient und nicht im Mittelpunkt steht. Die Hauptprobleme, die es adressiert, sind:
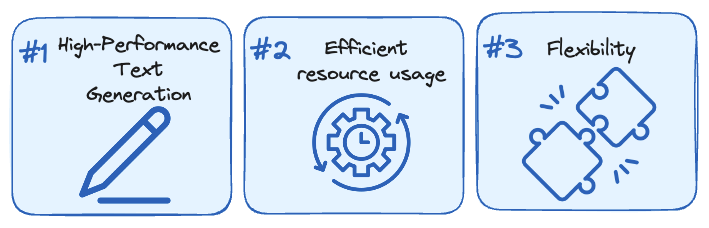
Bild von der Autorin/vom Autor.
Hugging Face hat die Architektur einiger LLMs so optimiert, dass sie mit TGI schneller laufen. Dazu zählen beliebte Modelle wie LLaMA, Falcon7B und Mistral. Die vollständige Liste findest du in der Dokumentation.
Hugging Face ist zur zentralen Anlaufstelle für KI mit natürlichen Sprachfähigkeiten geworden – ein Hub, in dem die Schwergewichte der Open-Source-Modelle versammelt sind und der Innovation in der NLP-Welt antreibt. Bis vor Kurzem waren viele dieser Modelle zu groß für den lokalen Einsatz und erforderten Cloud-Dienste.
Dank aktueller Fortschritte bei Quantisierungsmethoden wie QLoRa und GPTQ lassen sich einige LLMs inzwischen auch auf Alltagsrechnern betreiben – also lokal.
Hugging Face TGI ist speziell dafür gemacht, LLMs als Service auf dem eigenen Rechner bereitzustellen. Hintergrund ist der Aufwand, ein LLM zu starten.
Um Wartezeiten zu vermeiden, hältst du das Modell im Hintergrund startklar – so sind Antworten sofort parat. Andernfalls wartest du bei jedem Prompt lange. Stell dir einfach einen Endpoint mit einer Auswahl erstklassiger Sprachmodelle vor, die auf Abruf losschreiben.
Was mich an TGI überzeugt, ist der unkomplizierte Ansatz. TGI unterstützt bereits mehrere verschlankte Modellarchitekturen, die sich im Handumdrehen deployen lassen.
Und das ist nicht nur Theorie: TGI treibt bereits mehrere Live-Projekte an. Beispiele sind:
Bild von der Autorin/vom Autor. Logos von Hugging Chat (links) und OpenAssistant (rechts)
Es gibt allerdings einen wichtigen Haken: TGI ist derzeit nicht mit ARM-basierten GPU-Macs kompatibel, also auch nicht mit der M1-Serie und neueren.
Zuerst richten wir unseren Hugging Face TGI-Endpoint ein.
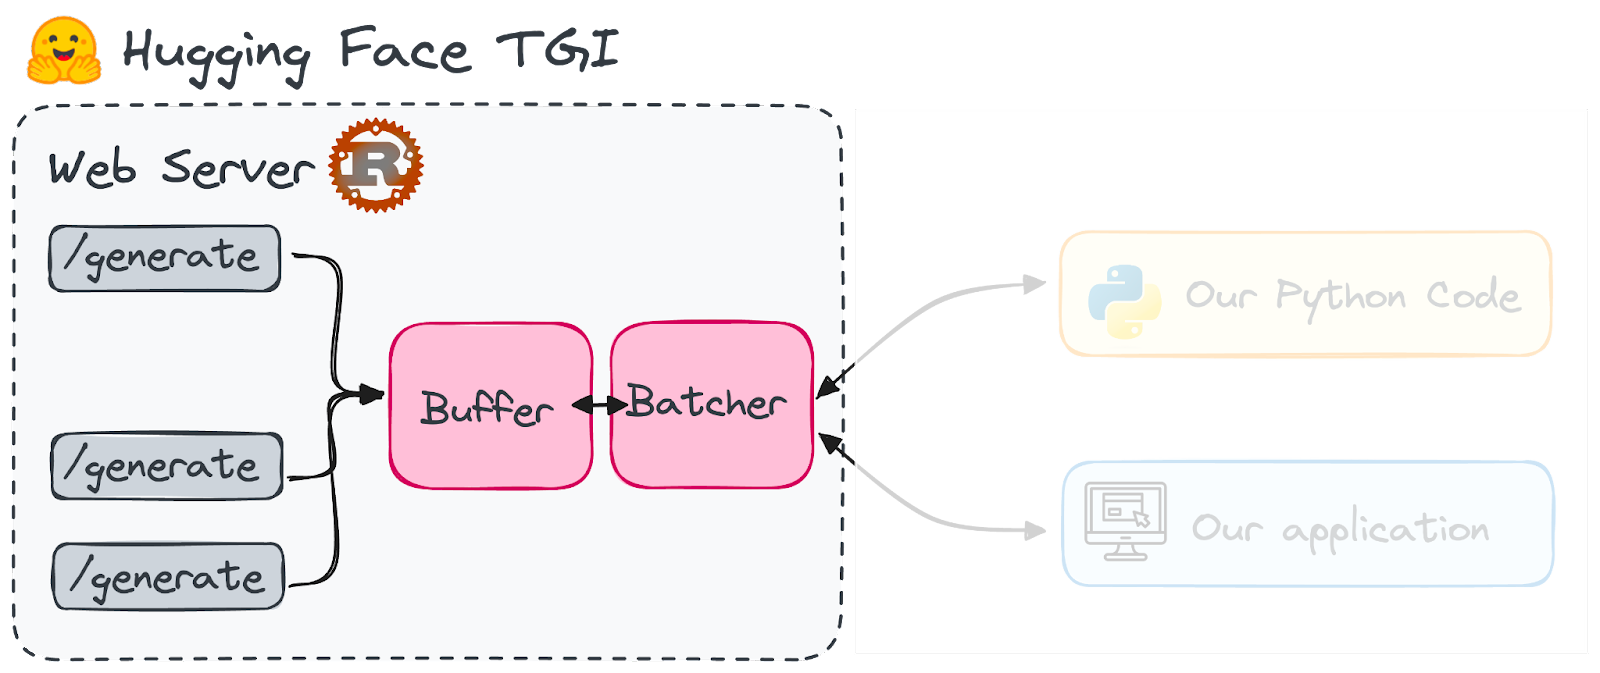
Bild von der Autorin/vom Autor.
Um Hugging Face TGI lokal zu installieren und zu starten, musst du zuerst Rust installieren und anschließend eine Python-Umgebung mit mindestens Python 3.9 anlegen, z. B. mit conda:
#Installing Rust
curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sh


#Creating a python virtual environment
conda create -n text-generation-inference python=3.9
conda activate text-generation-inference
Zusätzlich ist die Installation von Protoc erforderlich. Hugging Face empfiehlt Version 21.12 für optimale Kompatibilität. Beachte, dass du für die Installation sudo-Rechte benötigst.
PROTOC_ZIP=protoc-21.12-linux-x86_64.zip
curl -OL https://github.com/protocolbuffers/protobuf/releases/download/v21.12/$PROTOC_ZIP
sudo unzip -o $PROTOC_ZIP -d /usr/local bin/protoc
sudo unzip -o $PROTOC_ZIP -d /usr/local 'include/*'
rm -f $PROTOC_ZIP
Ich zeige zunächst die Installation from scratch, die nicht ganz trivial ist. Wenn dabei Probleme auftreten, kannst du diesen Teil überspringen und stattdessen direkt ein Docker-Image starten – das ist oft einfacher. Beide Varianten werden beschrieben.
Sind alle Voraussetzungen erfüllt, richten wir TGI ein. Starte damit, das GitHub-Repository zu klonen:
git clone https://github.com/huggingface/text-generation-inference.gitWechsle dann in das TGI-Verzeichnis auf deinem Rechner und installiere es mit folgenden Befehlen:
cd text-generation-inference/
BUILD_EXTENSIONS=False make install
Nun schauen wir uns die Nutzung mit und ohne Docker an. Ich verwende das Falcon-7B-Modell, das unter der Apache-2.0-Lizenz verfügbar ist.
Die Installation hat einen neuen Befehl angelegt: „text-generation-launcher“. Damit startest du den TGI-Server. Um einen Endpoint mit dem Falcon-7B-Modell zu aktivieren, führst du Folgendes aus:
text-generation-launcher --model-id tiiuae/falcon-7b-instruct --num-shard 1 --port 8080 --quantize bitsandbytesDie Parameter bedeuten:
Stelle sicher, dass Docker installiert und gestartet ist. Wenn du noch keine Docker-Erfahrung hast, hilft dir dieses Docker-Tutorial für Data Science mit den Grundlagen.
Denk daran: TGI ist nicht mit MX-Prozessor-Macs kompatibel. Alle verfügbaren TGI-Images findest du im entsprechenden GitHub-Paket-Repository für TGI. Ist dein Gerät kompatibel, findet Docker das passende Image automatisch.
Die Parameter entsprechen weitgehend denen des text-generation-launcher. Wenn du nur eine einzelne GPU nutzt, ersetze „all“ durch „0“.
volume=$PWD/data
sudo docker run --gpus all --shm-size 1g -p 8080:80 -v $volume:/data ghcr.io/huggingface/text-generation-inference:0.9 --model-id tiiuae/falcon-7b-instruct --num-shard 1  --quantize bitsandbytes
Achte darauf, dass das Docker-Image so lange aktiv bleibt, wie du den Server nutzen willst.
Du hast mehrere Möglichkeiten, den Text Generation Inference (TGI)-Server in deine Anwendungen zu integrieren. Läuft der Server, kannst du per POST-Request an den Endpoint /generate Ergebnisse abrufen.
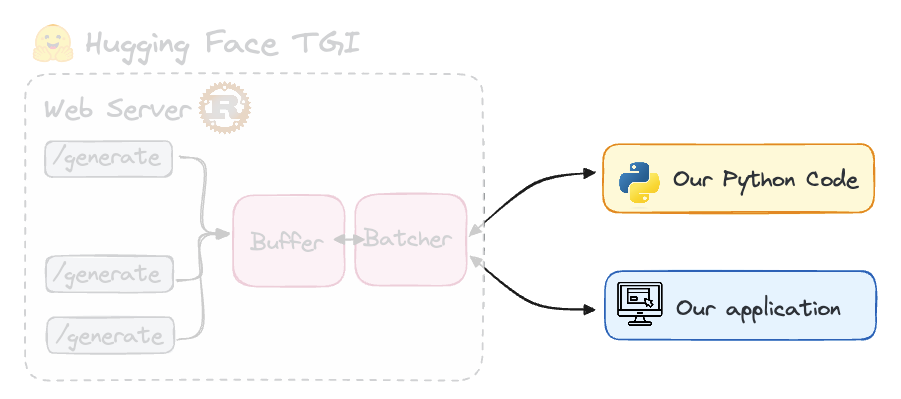
Bild von der Autorin/vom Autor.
Wenn du möchtest, dass TGI Tokens kontinuierlich streamt, nutze stattdessen den Streaming-Endpoint, wie im nächsten Abschnitt. Die Requests kannst du mit deinem bevorzugten Tool senden – etwa mit curl, Python oder TypeScript. Um das von TGI bereitgestellte Modell per Python-Skript abzufragen, installierst du zunächst die folgende text-generation-Bibliothek. Das geht ganz einfach mit pip:
pip install text-generationSobald der TGI-Server läuft, initialisierst du InferenceClient() mit der URL deines Endpoints. Anschließend rufst du text_generation() auf, um den Endpoint aus Python anzusprechen.
from text_generation import Client
client = Client("http://127.0.0.1:8080")
client.text_generation(prompt="Your prompt here!")
Um Streaming mit dem InferenceClient zu aktivieren, setzt du einfach stream=True. Dadurch erhältst du Tokens in Echtzeit, sobald der Server sie generiert. So nutzt du Streaming:
for token in client.text_generation("Your prompt here!", max_new_tokens=12, stream=True):
print(token)Denk daran: Du arbeitest mit dem Modell, das du auf deinem Endpoint bereitgestellt hast – in unserem Fall Falcon-7B. Mit TGI erzeugst du einen Live-Endpoint, über den du Antworten vom LLM deiner Wahl abrufen kannst.
In Python kannst du Prompts also direkt über den lokal gehosteten Client auf Port 8080 senden. Ein entsprechendes Python-Skript sieht so aus:
from text_generation import Client
client = Client("http://127.0.0.1:8080")
print(client.generate("Translate the following sentence into spanish: 'What does Large Language Model mean?'", max_new_tokens=500).generated_text)
So erhältst du eine Modellantwort, ohne es in deiner Umgebung zu installieren. Alternativ kannst du das LLM auch mit CURL abfragen, wie im folgenden Beispiel:
curl 127.0.0.1:8080/generate \
    -X POST \
    -d '{"inputs":"Code in Javascript a function to remove all spaces in a string and then print the string twice.","parameters":{"max_new_tokens":500}}' \
    -H 'Content-Type: application/json'
Nach einigen Tests zeigt TGI beeindruckende Geschwindigkeit. Mit Falcon-7B (Token-Limit 500) dauert es nur wenige Sekunden. Mit dem üblichen Inference-Ansatz (über die transformers-Bibliothek) sind es rund 30 Sekunden.
Ab Version 1.4.0 bietet TGI eine API, die mit OpenAIs Chat Completion API kompatibel ist. Diese neue Messages API ermöglicht einen nahtlosen Wechsel von OpenAI-Modellen zu Open-Source-LLMs. Die API ist für die direkte Integration mit OpenAIs Client-Bibliotheken oder Dritttools wie LangChain oder LlamaIndex ausgelegt.
Dank der Unterstützung für Messages sind TGI Inference Endpoints vollständig kompatibel mit der OpenAI Chat Completion API. So kannst du Skripte, die bisher OpenAI-Modelle nutzten, ohne Aufwand durch offene LLMs auf TGI-Endpoints ersetzen.
Dieses Upgrade erleichtert den Umstieg und eröffnet sofort die Vorteile von Open-Source-Modellen, darunter:
Ein Beispiel für die Integration von TGI in das OpenAI-Chat-Completion-Protokoll sieht so aus:
from openai import OpenAI

# initialize the client but point it to TGI
client = OpenAI(
    base_url="<ENDPOINT_URL>" + "/v1/",  # replace with your endpoint url
    api_key="<HF_API_TOKEN>",  # replace with your token
)
chat_completion = client.chat.completions.create(
    model="tgi",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "Why is open-source software important?"},
    ],
    stream=True,
    max_tokens=500
)

# iterate and print stream
for message in chat_completion:
    print(message.choices[0].delta.content, end="")
Wie du siehst, lässt sich die openai-Bibliothek verwenden, um unseren ENDPOINT und das Hugging Face-Passwort zu hinterlegen. Mehr Details findest du in der Hugging Face TGI-Dokumentation.
Bevor du in Hugging Face TGI einsteigst, solltest du mit Large Language Models vertraut sein. Mach dich mit Schlüsselkonzepten wie Tokenisierung, Aufmerksamkeitsmechanismen und der Transformer-Architektur vertraut. Diese Grundlagen sind entscheidend, um Modelle anzupassen und die Textgenerierung zu verfeinern.
Lerne, Modelle für deine Anforderungen vorzubereiten und zu optimieren. Dazu gehören die richtige Modellauswahl, das Anpassen von Tokenizern und Techniken zur Leistungssteigerung ohne Qualitätsverlust.
Verstehe, wie Hugging Face funktioniert und wie du den Hugging Face Hub für NLP-Entwicklung nutzt. Ein guter Einstieg ist An Introduction to Using Transformers and Hugging Face.
Auch Fine-Tuning solltest du kennen, da Modelle häufig auf spezifische Ziele optimiert werden müssen. Wie das geht, erfährst du in An Introductory Guide to Fine-Tuning LLMs.
Erkunde verschiedene Strategien der Textgenerierung wie Greedy Search, Beam Search und Top-k-Sampling. Jede Methode hat Vor- und Nachteile und beeinflusst Kohärenz, Kreativität und Relevanz der Ausgaben.
Hugging Faces TGI-Toolkit macht KI-Textgenerierung für alle greifbar. Es bietet ein leicht zu nutzendes Toolkit, um LLMs für fortgeschrittene NLP-Anwendungen mit menschenähnlichen Texten bereitzustellen und zu hosten.
Self-Hosting großer Sprachmodelle bietet Datensouveränität und Kostentransparenz, erfordert jedoch leistungsfähige Hardware. Dank jüngster Fortschritte lassen sich kleinere Modelle inzwischen direkt auf lokalen Maschinen nutzen.
Wenn du in Sachen LLMs weiter vorankommen willst, empfehle ich dir weiterführende Tutorials. Starte mit DataCamps LLM Concepts-Kurs, der viele wichtige Trainingsmethoden und aktuelle Forschung abdeckt.
Weitere empfehlenswerte Ressourcen:
Starte heute deine KI-Reise!
Kurs
Kurs
Lernpfad