Cursus
Concepten van Large Language Models (LLMs)
2 uur
113.4K
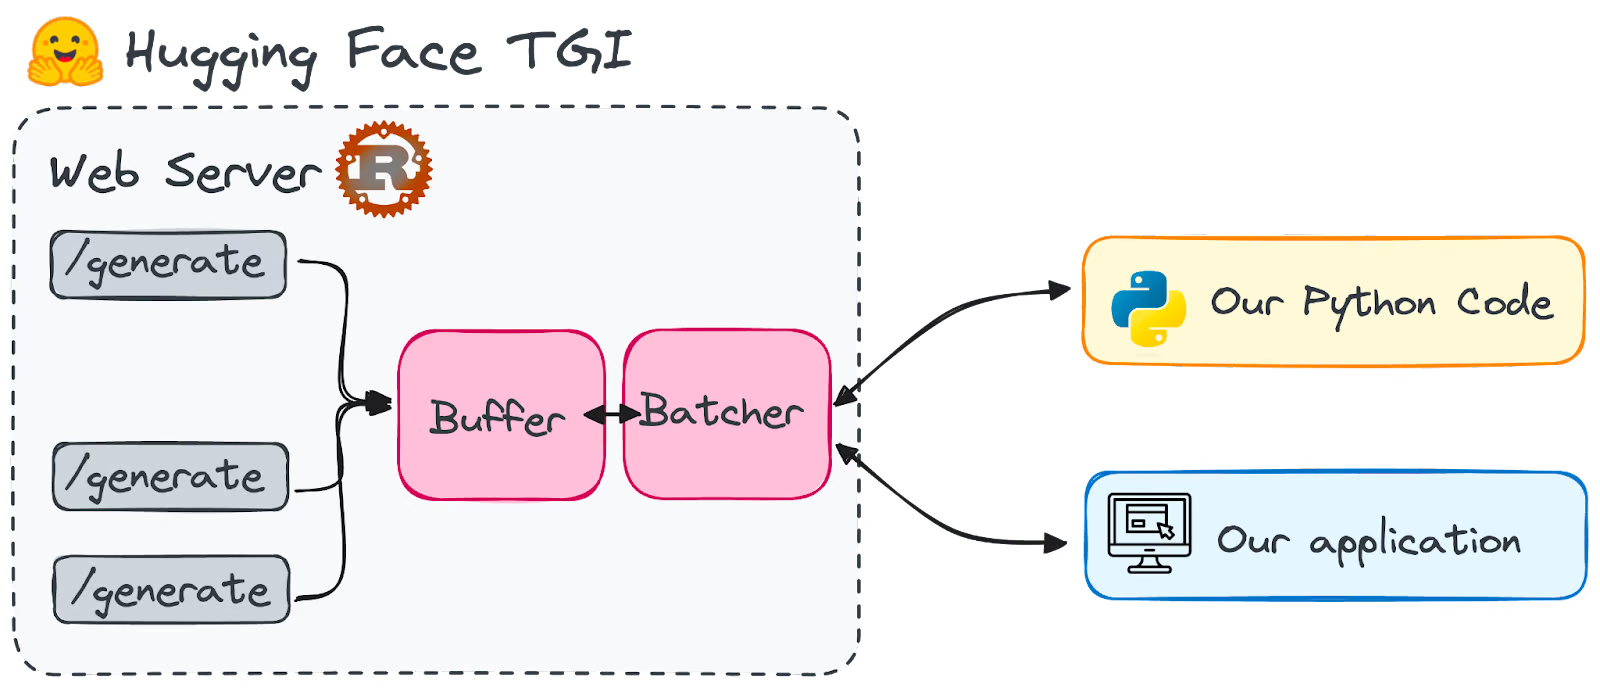
Afbeelding door de auteur
In het snelgroeiende veld van kunstmatige intelligentie zijn Large Language Models uitgegroeid tot de hoofdrolspelers achter de nieuwste doorbraken.
Tekstgeneratie is een baanbrekende mogelijkheid geworden, die verandert hoe machines mensachtige tekst begrijpen en produceren. Door die populariteit zijn er meerdere tools gelanceerd om het werken met LLM's te stroomlijnen en te vergemakkelijken.
De snelle toename van Large Language Models (LLM's), met bijna wekelijks nieuwe varianten, heeft parallel geleid tot meer hostingopties om deze technologie te ondersteunen. Binnen het brede universum aan tools valt Hugging Face's Text Generation Inference (TGI) in het bijzonder op, omdat het ons toelaat een LLM als service op onze lokale machine te draaien.
Kort gezegd: het geeft ons een endpoint om ons model aan te roepen.
In deze gids lees je waarom Hugging Face TGI een gamechanger is en hoe je het kunt inzetten om geavanceerde AI-modellen te maken die tekst genereren die steeds moeilijker van menselijke tekst te onderscheiden is.
Hugging Face Text Generation Inference, ook wel TGI, is een framework in Rust en Python voor het deployen en serven van Large Language Models. Het is een production-ready toolkit voor het uitrollen en aanbieden van LLM's.
Hugging Face ontwikkelt en distribueert het onder de HFOILv1.0-licentie, die commercieel gebruik toestaat mits het als hulpmiddel binnen het aangeboden product of de dienst fungeert en niet de hoofdfunctie is. De belangrijkste uitdagingen die het aanpakt zijn:
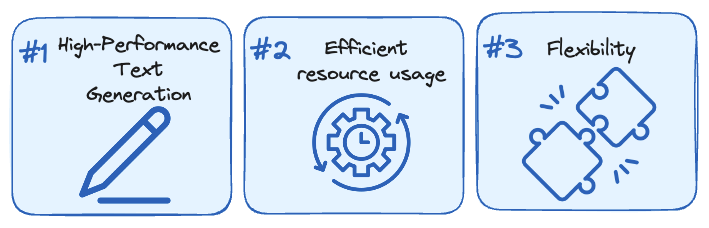
Afbeelding door de auteur.
Hugging Face heeft sommige LLM-architecturen geoptimaliseerd zodat ze sneller draaien met TGI. Dit omvat populaire modellen zoals LLaMA, Falcon7B en Mistral. De volledige lijst vind je in hun documentatie.
Hugging Face is uitgegroeid tot dé plek om AI met natuurlijke taalcapaciteiten te bouwen. Het is een hub waar alle open-source zwaargewichten samenkomen, en daarmee een motor voor NLP-innovatie. Tot nu toe waren de meeste van deze modellen te zwaar om direct lokaal te draaien; er was altijd een afhankelijkheid van cloudservices.
Maar dankzij recente ontwikkelingen met quantization-trucs zoals QLoRa en GPTQ zijn sommige LLM's behapbaar geworden op alledaagse apparaten — zoals onze lokale computers.
Hugging Face TGI is specifiek ontworpen om ons LLM's als service op onze lokale machines te bieden. De hoofdreden is de rompslomp van het opstarten van een LLM.
Om wachttijd te vermijden is het slimmer om het model op de achtergrond paraat te houden, klaar voor snelle reacties. Anders zit je vast aan lange wachttijden bij elke prompt. Stel je een endpoint voor met een collectie van de beste taalmodellen, klaar om tekst voor je te genereren wanneer je wilt.
Wat me opviel aan TGI is de no-nonsense aanpak. TGI is momenteel klaar voor een reeks gestroomlijnde modelarchitecturen, wat uitrollen eenvoudig maakt.
En het blijft niet bij woorden; TGI is al de motor achter verschillende liveprojecten. Enkele voorbeelden zijn:
Afbeelding door de auteur. Logo's van Hugging Chat (links) en OpenAssistant (rechts)
Er is echter een belangrijk minpunt: TGI is nog niet compatibel met ARM-gebaseerde GPU-Macs, waaronder de M1-serie en latere modellen.
Eerst moeten we ons Hugging Face TGI-endpoint opzetten.
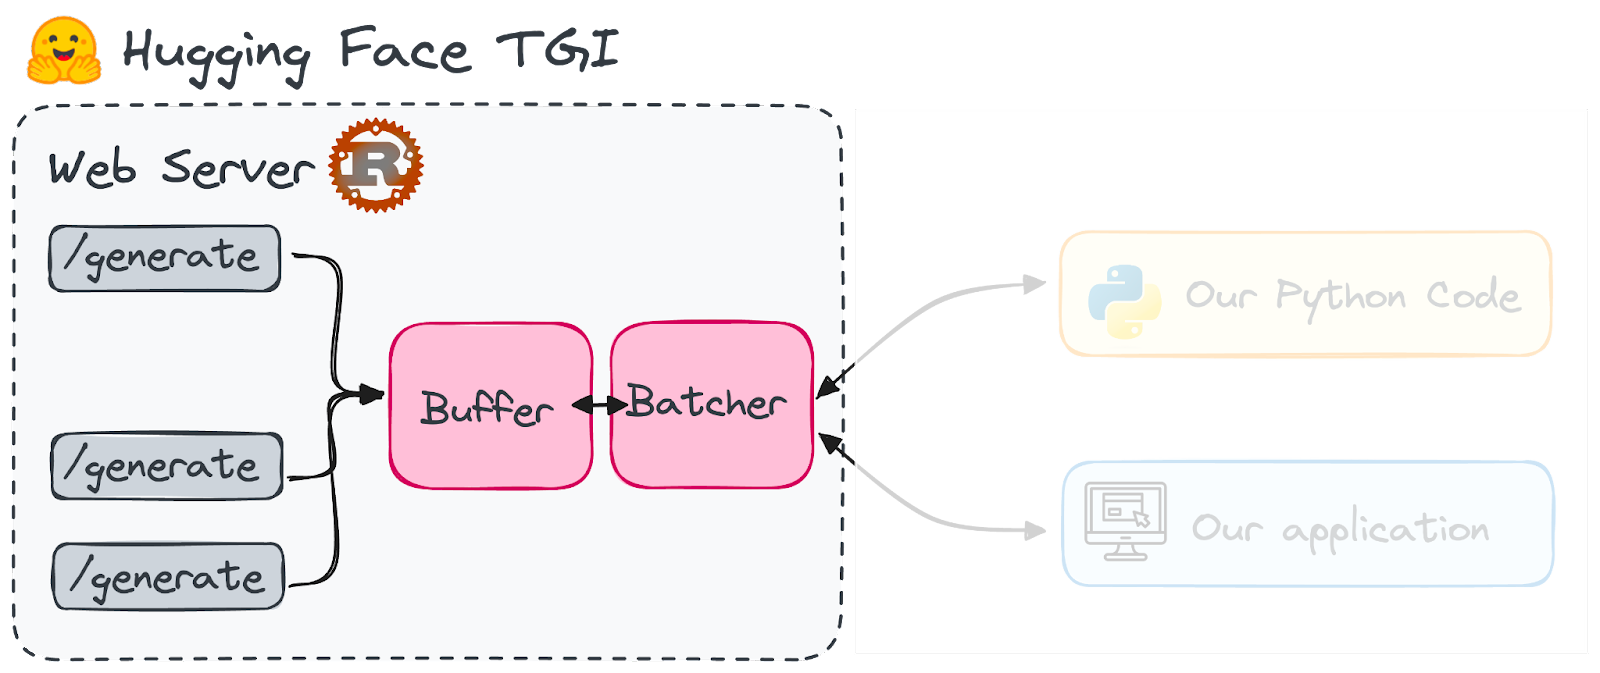
Afbeelding door de auteur.
Om Hugging Face TGI lokaal te installeren en te starten, moet je eerst Rust installeren en vervolgens een Python-virtuele omgeving met minimaal Python 3.9 aanmaken, bijvoorbeeld met conda:
#Installing Rust
curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sh


#Creating a python virtual environment
conda create -n text-generation-inference python=3.9
conda activate text-generation-inference
Daarnaast is Protoc-installatie nodig. Hugging Face raadt versie 21.12 aan voor optimale compatibiliteit. Let op: je hebt sudo-rechten nodig om deze installatie uit te voeren.
PROTOC_ZIP=protoc-21.12-linux-x86_64.zip
curl -OL https://github.com/protocolbuffers/protobuf/releases/download/v21.12/$PROTOC_ZIP
sudo unzip -o $PROTOC_ZIP -d /usr/local bin/protoc
sudo unzip -o $PROTOC_ZIP -d /usr/local 'include/*'
rm -f $PROTOC_ZIP
Ik laat eerst zien hoe je het vanaf nul installeert, wat volgens mij niet heel rechttoe rechtaan is. Als je tijdens het proces problemen tegenkomt, kun je dit eerste deel overslaan en in plaats daarvan direct een Docker-image draaien, wat eenvoudiger is. Beide scenario's komen aan bod.
Met alle vereisten op orde, kunnen we TGI instellen. Begin met het clonen van de GitHub-repository:
git clone https://github.com/huggingface/text-generation-inference.gitGa daarna naar de TGI-locatie op je lokale computer en installeer het met de volgende commando's:
cd text-generation-inference/
BUILD_EXTENSIONS=False make install
Laten we nu bekijken hoe je TGI gebruikt, met en zonder Docker. Ik gebruik het Falcon-7B-model, dat beschikbaar is onder de Apache 2.0-licentie.
De installatie heeft een nieuw commando aangemaakt, “text-generation-launcher”, dat de TGI-server start. Om een endpoint met het Falcon-7B-model te activeren, hoeven we alleen het volgende commando uit te voeren:
text-generation-launcher --model-id tiiuae/falcon-7b-instruct --num-shard 1 --port 8080 --quantize bitsandbytesWaarbij elke invoerparameter het volgende betekent:
Zorg dat Docker op je computer is geïnstalleerd en al draait. Als je geen ervaring hebt met Docker, kun je deze Docker voor Data Science-tutorial volgen voor de basis.
Onthoud: TGI is niet compatibel met MX-processor Mac-modellen. Je kunt alle beschikbare TGI-images bekijken in de bijbehorende GitHub-repository met TGI-packages. Als je apparaat compatibel is, zal Docker de juiste image voor je vinden.
De parameters lijken sterk op die van de text-generation-launcher. Als je met slechts één GPU werkt, vervang dan "all" door "0".
volume=$PWD/data
sudo docker run --gpus all --shm-size 1g -p 8080:80 -v $volume:/data ghcr.io/huggingface/text-generation-inference:0.9 --model-id tiiuae/falcon-7b-instruct --num-shard 1  --quantize bitsandbytes
Zorg ervoor dat de Docker-image actief blijft zolang je de server wilt gebruiken.
Je hebt meerdere opties om de Text Generation Inference (TGI)-server in je applicaties te integreren. Zodra deze actief is, kun je ermee communiceren door een POST-verzoek naar de /generate-endpoint te sturen om resultaten op te halen.
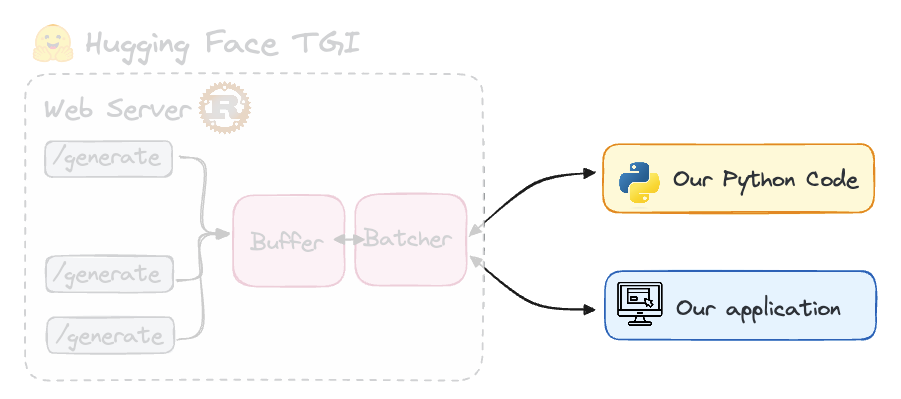
Afbeelding door de auteur.
Als je wilt dat TGI continu tokens streamt, gebruik dan in plaats daarvan de endpoint, zoals we in de volgende sectie zullen zien. Deze verzoeken kun je doen met de tool van je keuze, waaronder curl, Python of TypeScript. Om het door TGI geserveerde model via een Python-script te bevragen, moet je de volgende text-generation-bibliotheek installeren. Dat is zo simpel als het uitvoeren van deze pip-opdracht:
pip install text-generationZodra je de TGI-server hebt gestart, instantieer je InferenceClient() met de URL naar het endpoint dat het model serveert. Je kunt vervolgens text_generation() aanroepen om via Python het endpoint te benaderen.
from text_generation import Client
client = Client("http://127.0.0.1:8080")
client.text_generation(prompt="Your prompt here!")
Om streaming met de InferenceClient in te schakelen, hoef je alleen stream=True te zetten. Hiermee ontvang je tokens in realtime zodra ze op de server worden gegenereerd. Zo gebruik je streaming:
for token in client.text_generation("Your prompt here!", max_new_tokens=12, stream=True):
print(token)Onthoud dat je werkt met het model dat je op je endpoint hebt gedeployed, in ons geval Falcon-7B. Met TGI maken we een live endpoint dat ons in staat stelt om respons op te halen van de LLM van onze keuze.
Daardoor kunnen we in Python rechtstreeks prompts naar de LLM sturen via de client die op ons lokale apparaat draait, toegankelijk via poort 8080. Het bijbehorende Python-script ziet er dan ongeveer zo uit:
from text_generation import Client
client = Client("http://127.0.0.1:8080")
print(client.generate("Translate the following sentence into spanish: 'What does Large Language Model mean?'", max_new_tokens=500).generated_text)
En we krijgen een reactie van het model zonder het in onze omgeving te hoeven installeren. In plaats van Python kunnen we de LLM ook met CURL bevragen, zoals je in het volgende voorbeeld ziet:
curl 127.0.0.1:8080/generate \
    -X POST \
    -d '{"inputs":"Code in Javascript a function to remove all spaces in a string and then print the string twice.","parameters":{"max_new_tokens":500}}' \
    -H 'Content-Type: application/json'
Na wat spelen met TGI valt de indrukwekkende snelheid op. Met Falcon-7B (met een tokenlimiet van 500) duurt het enkele seconden. Met de typische inferentieaanpak (met de transformers-bibliotheek) duurt het echter zo'n 30 seconden.
Vanaf versie 1.4.0 heeft TGI een API geïntroduceerd die compatibel is met de Chat Completion API van OpenAI. Deze nieuwe Messages API maakt een soepele overgang mogelijk voor klanten en gebruikers van OpenAI-modellen naar open-source LLM's. De API is ontworpen voor directe integratie met de clientbibliotheken van OpenAI of met tools van derden zoals LangChain of LlamaIndex.
Dankzij TGI's ondersteuning voor Messages zijn de Inference Endpoints volledig compatibel met de OpenAI Chat Completion API. Hierdoor kunnen gebruikers eenvoudig bestaande scripts die OpenAI-modellen gebruiken vervangen door open LLM's die worden gehost op TGI-endpoints, zonder gedoe.
Deze upgrade maakt een moeiteloze overstap mogelijk en geeft direct toegang tot de uitgebreide voordelen van open-sourcemodellen, waaronder:
Een voorbeeld van hoe je TGI integreert in het OpenAI chat completion-protocol vind je hieronder:
from openai import OpenAI

# initialize the client but point it to TGI
client = OpenAI(
    base_url="<ENDPOINT_URL>" + "/v1/",  # replace with your endpoint url
    api_key="<HF_API_TOKEN>",  # replace with your token
)
chat_completion = client.chat.completions.create(
    model="tgi",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "Why is open-source software important?"},
    ],
    stream=True,
    max_tokens=500
)

# iterate and print stream
for message in chat_completion:
    print(message.choices[0].delta.content, end="")
Zoals je ziet kun je met de openai-bibliotheek ons ENDPOINT en ons Hugging Face-wachtwoord instellen. Voor meer informatie over deze integratie kun je de Hugging Face TGI-documentatie raadplegen.
Voordat je in HuggingFace TGI duikt, is het goed als je al bekend bent met Large Language Models. Maak je vertrouwd met kernconcepten zoals tokenization, attention-mechanismen en de Transformer-architectuur. Deze basis is cruciaal om modellen aan te passen en de output van tekstgeneratie te verfijnen.
Leer modellen voor te bereiden en te optimaliseren voor jouw specifieke behoeften. Dit omvat het kiezen van het juiste model, het aanpassen van tokenizers en technieken toepassen om prestaties te verbeteren zonder kwaliteit op te offeren.
Zorg dat je begrijpt hoe HuggingFace werkt en hoe je de HuggingFace Hub gebruikt voor NLP-ontwikkeling. Een goede introductietutorial hiervoor is An Introduction to Using Transformers and Hugging Face.
Fijnslijpen (fine-tuning) is ook een concept om te kennen, omdat modellen vaak geoptimaliseerd moeten worden voor specifieke doelen. Je kunt leren hoe je een model fine-tunet met de Introductiegids voor het fine-tunen van LLM's
Verken verschillende strategieën voor tekstgeneratie, zoals greedy search, beam search en top-k sampling. Elke strategie heeft voor- en nadelen en beïnvloedt de samenhang, creativiteit en relevantie van de gegenereerde tekst.
Hugging Face's TGI-toolkit geeft iedereen de mogelijkheid om AI-tekstgeneratie te verkennen. Het biedt een gebruiksvriendelijke toolkit om LLM's te deployen en te hosten voor geavanceerde NLP-toepassingen die mensachtige tekst vereisen.
Hoewel zelfhosting van grote taalmodellen voordelen biedt zoals dataprivacy en kostenbeheersing, vraagt het om krachtige hardware. De laatste ontwikkelingen maken het echter mogelijk om kleinere modellen direct op onze lokale machines te gebruiken.
Wil je je blijven verbeteren op LLM-gebied, dan raad ik je aan om meer geavanceerde tutorials te volgen. Je kunt starten met DataCamp's LLM Concepts-cursus, die veel van de belangrijkste trainingsmethodologieën en het nieuwste onderzoek behandelt.
Andere goede bronnen om te volgen zijn:
Begin vandaag nog met je AI-reis!
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min

