Kurs
Large Language Models (LLMs) Kavramları
2 sa
113.4K
Görsel: Yazar
Yapay zekânın hızla gelişen alanında, Büyük Dil Modelleri son dönemdeki atılımların başrol oyuncuları olarak öne çıktı.
Metin üretimi, makinelerin insan benzeri metni anlama ve üretme biçimini dönüştüren çığır açıcı bir yetenek hâline geldi. Bu popülerlik, LLM’lerle çalışmayı kolaylaştırmak ve akıcı hâle getirmek için birden çok aracın ortaya çıkmasının başlıca nedeni.
Büyük Dil Modellerinin (LLM) hızla çoğalması ve neredeyse her hafta yenilerinin çıkması, bu teknolojiyi barındırmaya yönelik seçeneklerin de paralel biçimde artmasına yol açtı. Bu amaçla sunulan geniş araç yelpazesi içinde, Hugging Face’in Text Generation Inference (TGI) aracı özellikle dikkat çekiyor; çünkü yerel makinemizde bir LLM’i servis olarak çalıştırmamıza imkân tanıyor.
Basitçe söylemek gerekirse, modelimizi çağırmak için bir uç nokta (endpoint) sunuyor.
Bu rehberde, Hugging Face TGI’nin neden bir oyun değiştirici olduğunu ve giderek insan üretimiyle ayırt edilmesi zor metinler üretebilen sofistike yapay zekâ modelleri oluşturmak için onu nasıl kullanabileceğinizi inceleyeceğiz.
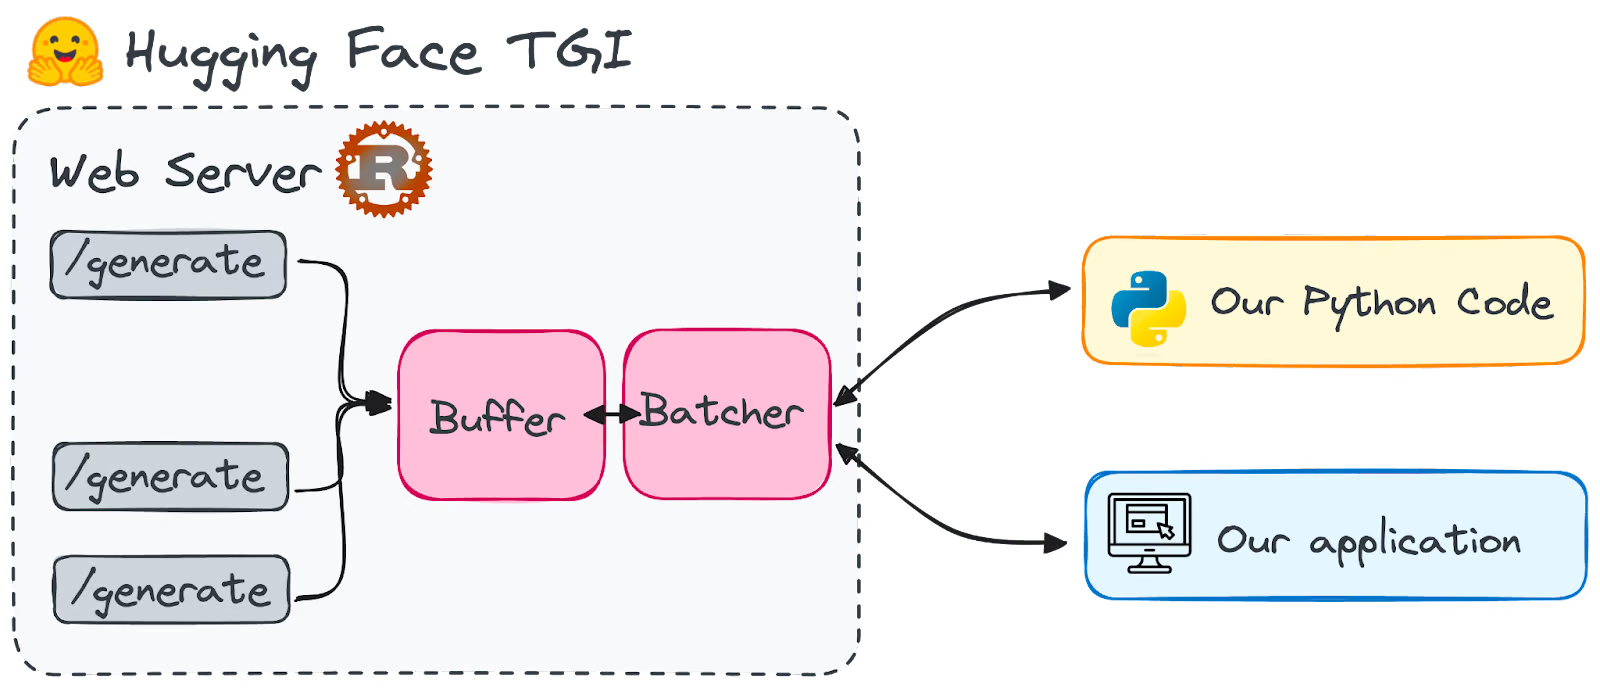
Hugging Face Text Generation Inference, kısaca TGI, Büyük Dil Modellerini dağıtmak ve servis etmek için Rust ve Python ile yazılmış bir çerçevedir. LLM’leri dağıtıp sunmak için üretime hazır bir araç setidir.
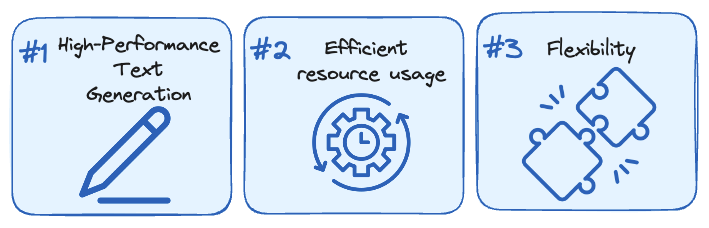
Hugging Face bunu HFOILv1.0 lisansı altında geliştirir ve dağıtır; bu lisans, ürün veya hizmetinizin ana odağından ziyade yardımcı bir araç olarak kullanılması koşuluyla ticari kullanıma izin verir. Ele aldığı başlıca zorluklar şunlardır:
Görsel: Yazar.
Hugging Face, bazı LLM mimarilerini TGI ile daha hızlı çalışacak şekilde optimize etti. Buna LLaMA, Falcon7B ve Mistral gibi popüler modeller de dahil. Tam listeyi dokümantasyonlarında bulabilirsiniz.
Hugging Face, doğal dil yeteneklerine sahip yapay zekâ geliştirmek için başvurulan bir merkez hâline geldi. Açık kaynaklı ağır siklet modellerin buluştuğu bir merkez olarak, NLP inovasyonu için güçlü bir platform sunuyor. Şimdiye dek bu modellerin çoğu doğrudan yerelde kullanılamayacak kadar ağırdı; daima bulut tabanlı hizmetlere bağımlılık vardı.
Ancak QLoRa ve GPTQ gibi niceleme hilelerindeki son gelişmelerle birlikte, bazı LLM’ler artık günlük cihazlarımızda —örneğin yerel bilgisayarlarımızda— yönetilebilir hâle geldi.
Hugging Face TGI, özellikle yerel makinelerimizde LLM’leri bir hizmet olarak sunmak üzere tasarlanmıştır. Bunun temel nedeni, bir LLM’i başlatmanın zahmetidir.
Bekleme süresini atlamak için modeli arka planda hazır tutmak, anında yanıt verecek şekilde hazırlamak daha akıllıcadır. Aksi takdirde, her istem gönderdiğinizde uzun bekleyişlere takılırsınız. En iyi dil modellerinden oluşan bir koleksiyona sahip bir uç noktanın emrinizde olduğunu ve dilediğinizde metin ürettiğini hayal edin.
TGI’de ilgimi çeken ise sorunsuz yaklaşımı oldu. Şu anda TGI, yalınlaştırılmış bir dizi model mimarisiyle çalışmaya hazır; bu da dağıtımı son derece kolaylaştırıyor.
Üstelik bu sadece söylem değil; TGI hâlihazırda çeşitli canlı projelerin motoru konumunda. Bazı örnekler:
Görsel: Yazar. Hugging Chat (Sol) ve OpenAssistant (Sağ) logoları
Ancak önemli bir nokta var: TGI henüz ARM tabanlı GPU’lu Mac’lerle, M1 serisi ve sonraki modeller dâhil, uyumlu değil.
Öncelikle Hugging Face TGI uç noktamızı kurmamız gerekiyor.
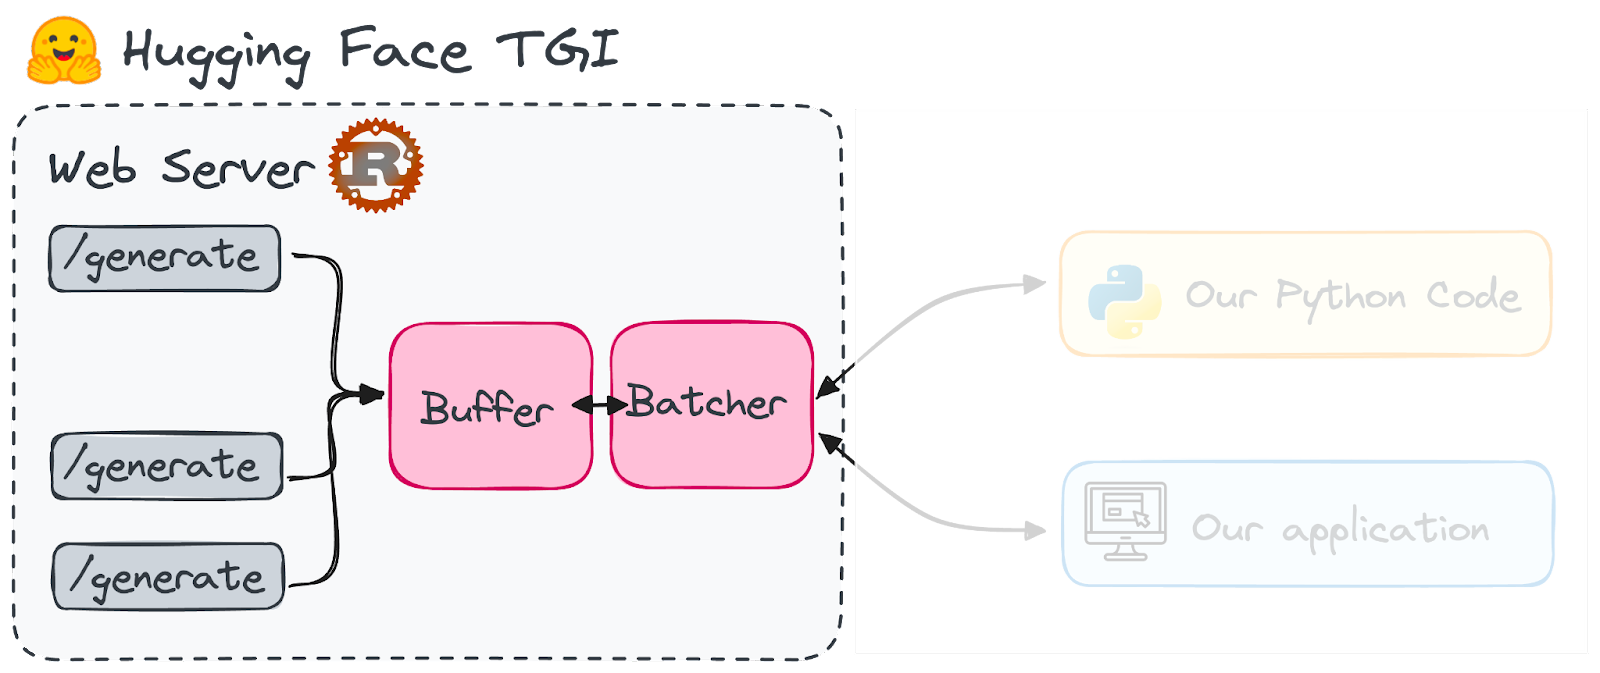
Görsel: Yazar.
Hugging Face TGI’yi yerelde kurup başlatmak için önce Rust’ı kurmanız, ardından en az Python 3.9 içeren bir Python sanal ortamı oluşturmanız gerekir; örneğin conda ile:
#Installing Rust
curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sh


#Creating a python virtual environment
conda create -n text-generation-inference python=3.9
conda activate text-generation-inference
Ayrıca Protoc kurulumu gereklidir. Hugging Face, en iyi uyumluluk için 21.12 sürümünü önerir. Bu kurulum için sudo ayrıcalıklarına ihtiyaç duyacağınızı unutmayın.
PROTOC_ZIP=protoc-21.12-linux-x86_64.zip
curl -OL https://github.com/protocolbuffers/protobuf/releases/download/v21.12/$PROTOC_ZIP
sudo unzip -o $PROTOC_ZIP -d /usr/local bin/protoc
sudo unzip -o $PROTOC_ZIP -d /usr/local 'include/*'
rm -f $PROTOC_ZIP
Önce sıfırdan nasıl kurulacağını göstereceğim; bunun çok da sezgisel olmadığını düşünüyorum. Süreçte sorun yaşarsanız bu ilk kısmı atlayıp doğrudan Docker imajını çalıştırabilirsiniz; bu daha pratiktir. Her iki senaryoya da değineceğim.
Tüm önkoşullar hazır olduğunda, TGI’yi kurmaya hazırız. Öncelikle GitHub deposunu klonlayın:
git clone https://github.com/huggingface/text-generation-inference.gitArdından yerel bilgisayarınızdaki TGI konumuna geçip aşağıdaki komutlarla kurun:
cd text-generation-inference/
BUILD_EXTENSIONS=False make install
Şimdi TGI’yi Docker ile ve Docker olmadan nasıl kullanacağımıza bakalım. Apache 2.0 lisansına sahip Falcon-7B modelini kullanacağım.
Kurulum, TGI sunucusunu başlatacak “text-generation-launcher” adlı yeni bir komut oluşturdu. Falcon-7B modeliyle bir uç nokta etkinleştirmek için aşağıdaki komutu çalıştırmamız yeterli:
text-generation-launcher --model-id tiiuae/falcon-7b-instruct --num-shard 1 --port 8080 --quantize bitsandbytesBuradaki her giriş parametresi şunları ifade eder:
Bilgisayarınızda Docker’ın kurulu ve çalışır durumda olduğundan emin olun. Docker deneyiminiz yoksa, temel kavramları edinebileceğiniz Veri Bilimi için Docker eğitimini takip edebilirsiniz.
Unutmayın, TGI MX işlemcili Mac modelleriyle uyumlu değildir. Mevcut tüm TGI imajlarını ilgili TGI paketleri GitHub deposunda görebilirsiniz. Cihazınız uyumluysa Docker sizin için uygun imajı bulacaktır.
Parametreler, text-generation-launcher ile kullandıklarınıza oldukça benzer. Yalnızca tek bir GPU ile çalışıyorsanız, "all" yerine "0" kullanın.
volume=$PWD/data
sudo docker run --gpus all --shm-size 1g -p 8080:80 -v $volume:/data ghcr.io/huggingface/text-generation-inference:0.9 --model-id tiiuae/falcon-7b-instruct --num-shard 1  --quantize bitsandbytes
Sunucuyu kullanmayı planladığınız süre boyunca Docker imajının aktif kaldığından emin olun.
Text Generation Inference (TGI) sunucusunu uygulamalarınıza entegre etmek için birden fazla seçeneğiniz var. Sunucu çalıştıktan sonra, sonuç almak için /generate uç noktasına bir POST isteği göndererek onunla etkileşime geçebilirsiniz.
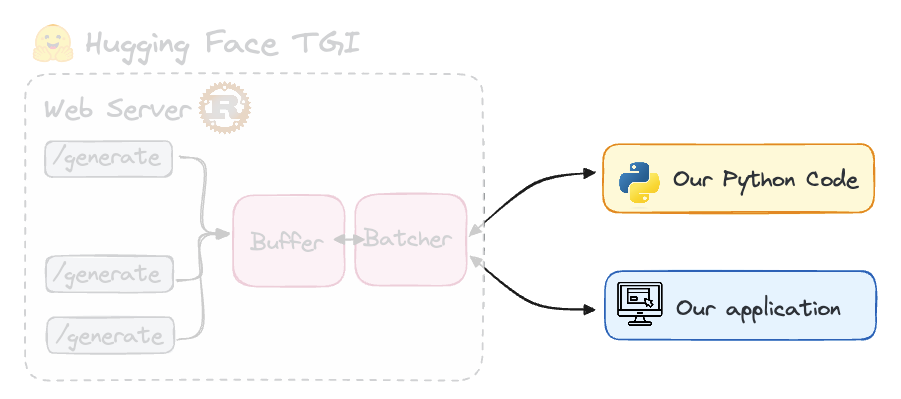
Görsel: Yazar.
Eğer TGI’nin belirteçleri kesintisiz olarak akış hâlinde göndermesini isterseniz, bunun yerine ilgili uç noktayı kullanın; bunu bir sonraki bölümde göreceğiz. Bu istekleri curl, Python veya TypeScript dâhil, tercih ettiğiniz araçla yapabilirsiniz. TGI tarafından sunulan modeli bir Python betiğiyle sorgulamak için aşağıdaki text-generation kütüphanesini kurmanız gerekir. Aşağıdaki pip komutunu çalıştırmanız yeterlidir:
pip install text-generationTGI sunucusunu başlattıktan sonra, modeli sunan uç noktanın URL’siyle InferenceClient() örneği oluşturun. Ardından uç noktayı Python üzerinden çağırmak için text_generation() fonksiyonunu kullanabilirsiniz.
from text_generation import Client
client = Client("http://127.0.0.1:8080")
client.text_generation(prompt="Your prompt here!")
InferenceClient ile akışı etkinleştirmek için stream=True ayarlamanız yeterlidir. Bu sayede sunucuda üretildikçe belirteçleri gerçek zamanlı alabilirsiniz. Akışı şu şekilde kullanabilirsiniz:
for token in client.text_generation("Your prompt here!", max_new_tokens=12, stream=True):
print(token)Uç noktanızda dağıttığınız modelle çalışacağınızı unutmayın; bizim durumumuzda Falcon-7B. TGI kullanarak, seçtiğimiz LLM’den yanıt almamızı sağlayan canlı bir uç nokta oluşturuyoruz.
Dolayısıyla Python kullanırken, 8080 portu üzerinden erişilebilen yerel cihazımızda barındırılan istemci aracılığıyla LLM’ye doğrudan istem gönderebiliriz. Buna karşılık gelen Python betiği kabaca şöyle görünür:
from text_generation import Client
client = Client("http://127.0.0.1:8080")
print(client.generate("Translate the following sentence into spanish: 'What does Large Language Model mean?'", max_new_tokens=500).generated_text)
Ve modeli ortamımıza kurmaya gerek kalmadan bir yanıt elde ederiz. Python yerine, aşağıdaki örnekte görüldüğü gibi CURL ile de LLM’yi sorgulayabiliriz:
curl 127.0.0.1:8080/generate \
    -X POST \
    -d '{"inputs":"Code in Javascript a function to remove all spaces in a string and then print the string twice.","parameters":{"max_new_tokens":500}}' \
    -H 'Content-Type: application/json'
TGI ile biraz deneme yaptıktan sonra etkileyici bir hız sergilediğini gördüm. Falcon-7B kullanırken (500 belirteç sınırıyla) birkaç saniye sürüyor. Oysa tipik çıkarım yaklaşımını (transformers kütüphanesini kullanarak) uyguladığınızda yaklaşık 30 saniye alıyor.
Sürüm 1.4.0’dan itibaren TGI, OpenAI’nin Chat Completion API’siyle uyumlu bir API sundu. Bu yeni Messages API, müşterilerin ve kullanıcıların OpenAI modellerinden açık kaynak LLM’lere sorunsuz geçiş yapmasını sağlıyor. API, OpenAI’nin istemci kütüphaneleriyle doğrudan veya LangChain ya da LlamaIndex gibi üçüncü taraf araçlarla entegre olacak şekilde tasarlandı.
TGI’nin Messages desteği, Çıkarım Uç Noktalarının OpenAI Chat Completion API ile tam uyumlu olmasını güvence altına alır. Bu uyumluluk, kullanıcıların OpenAI modellerini kullanan mevcut betikleri, TGI uç noktalarında barındırılan açık LLM’lerle zahmetsizce değiştirmesine imkân tanır.
Bu yükseltme, açık kaynak modellerinin sunduğu geniş avantajlara anında erişim sağlayan zahmetsiz bir geçişi kolaylaştırır; örneğin:
TGI’yi OpenAI sohbet tamamlama protokolüne entegre etmenin bir örneği aşağıda verilmiştir:
from openai import OpenAI

# initialize the client but point it to TGI
client = OpenAI(
    base_url="<ENDPOINT_URL>" + "/v1/",  # replace with your endpoint url
    api_key="<HF_API_TOKEN>",  # replace with your token
)
chat_completion = client.chat.completions.create(
    model="tgi",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "Why is open-source software important?"},
    ],
    stream=True,
    max_tokens=500
)

# iterate and print stream
for message in chat_completion:
    print(message.choices[0].delta.content, end="")
Gördüğünüz gibi, ENDPOINT’imizi ve Hugging Face parolamızı belirtmek için openai kütüphanesini kullanabiliriz. Bu entegrasyonu daha iyi anlamak için Hugging Face TGI dokümantasyonuna bakabilirsiniz.
HuggingFace TGI’ye geçmeden önce Büyük Dil Modellerine aşina olmalısınız. Belirteçleştirme (tokenization), dikkat mekanizmaları ve Transformer mimarisi gibi temel kavramlara hâkim olun. Bu temeller, modelleri özelleştirmek ve metin üretimi çıktısını iyileştirmek için kritik öneme sahiptir.
İhtiyaçlarınıza uygun şekilde modelleri hazırlamayı ve optimize etmeyi öğrenin. Buna doğru modeli seçmek, belirteçleyicileri (tokenizer) özelleştirmek ve kaliteyi feda etmeden performansı artıracak teknikleri kullanmak dahildir.
HuggingFace’in nasıl çalıştığını ve NLP geliştirme için HuggingFace Hub’ın nasıl kullanılacağını anladığınızdan emin olun. Bunun için iyi bir başlangıç eğitimi Transformers ve Hugging Face Kullanımına Giriş yazısıdır.
İnce ayar (fine-tuning) da farkında olmanız gereken bir kavramdır; zira çoğu zaman modellerin belirli hedefler için optimize edilmesi gerekir. Bir modeli nasıl ince ayarlarla optimize edeceğinizi LLM’lerde İnce Ayara Giriş Rehberi ile öğrenebilirsiniz
Açgözlü arama (greedy search), kiriş araması (beam search) ve top-k örnekleme gibi çeşitli metin üretim stratejilerini keşfedin. Her stratejinin tutarlılık, yaratıcılık ve üretilen metnin ilgililiği üzerinde artıları ve eksileri vardır.
Hugging Face’in TGI aracı, herkesin yapay zekâ metin üretimini keşfetmesine olanak tanır. İnsan benzeri metin gerektiren gelişmiş NLP uygulamaları için LLM’leri dağıtıp barındırmayı kolaylaştıran kullanımı basit bir araç seti sunar.
Büyük dil modellerini kendi sunucunuzda barındırmak veri gizliliği ve maliyet kontrolü sağlar; ancak güçlü donanım gerektirir. Yine de alandaki son gelişmeler, küçük modellerin doğrudan yerel makinelerimizde kullanılmasına imkân tanıyor.
LLM alanında kendinizi geliştirmeye devam etmek istiyorsanız, daha ileri seviye eğitimleri uygulamanızı öneririm. DataCamp’in pek çok temel eğitim metodolojisini ve en güncel araştırmaları kapsayan LLM Kavramları kursuyla başlayabilirsiniz.
Takip edilebilecek diğer bazı iyi kaynaklar:
Yapay Zekâ Yolculuğunuza Bugün Başlayın!
Kurs
Kurs
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



