Curso
Conceptos de grandes modelos lingüísticos (LLM)
2 h
109.8K
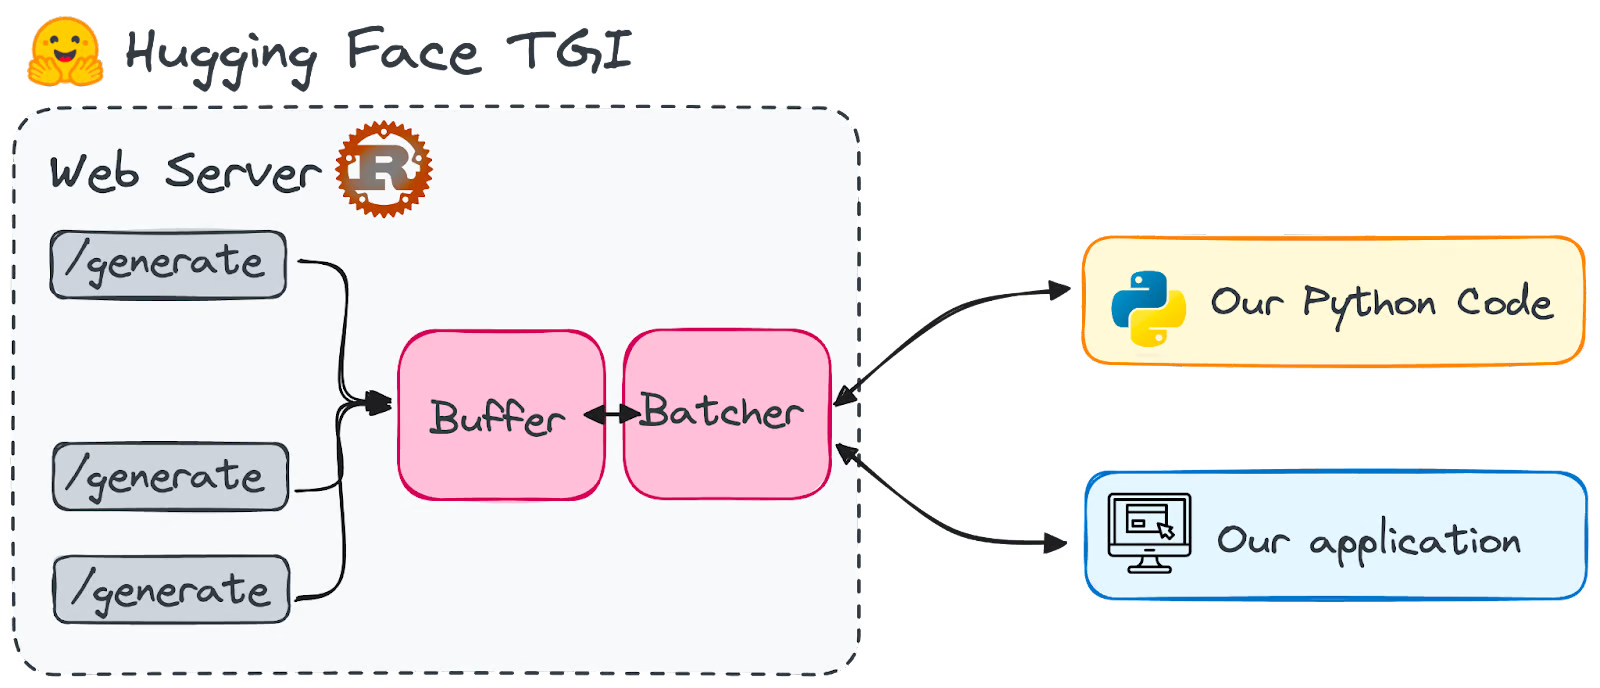
Imagen del autor
En el vertiginoso campo de la inteligencia artificial, los modelos de lenguaje grandes se han convertido en los protagonistas de los últimos avances.
La generación de texto se ha vuelto una capacidad decisiva, transformando cómo las máquinas entienden y producen texto similar al humano. Esta popularidad explica por qué han surgido múltiples herramientas para agilizar y facilitar el trabajo con LLMs.
La rápida proliferación de Large Language Models (LLMs), con nuevos modelos casi cada semana, ha impulsado en paralelo el crecimiento de opciones de alojamiento para esta tecnología. Dentro del amplio universo de herramientas con este fin, destaca especialmente Text Generation Inference (TGI) de Hugging Face, ya que nos permite ejecutar un LLM como servicio en nuestra propia máquina.
Dicho de forma sencilla, nos ofrece un endpoint para llamar a nuestro modelo.
En esta guía verás por qué Hugging Face TGI marca la diferencia y cómo puedes sacarle partido para crear modelos de IA capaces de generar texto cada vez más indistinguible del escrito por personas.
Hugging Face Text Generation Inference, o TGI, es un framework escrito en Rust y Python para desplegar y servir modelos de lenguaje grandes. Es un kit listo para producción para el despliegue y servicio de LLMs.
Hugging Face lo desarrolla y distribuye bajo la licencia HFOILv1.0, que permite el uso comercial siempre que actúe como herramienta auxiliar dentro del producto o servicio ofrecido, y no como el foco principal. Los principales retos que aborda son:
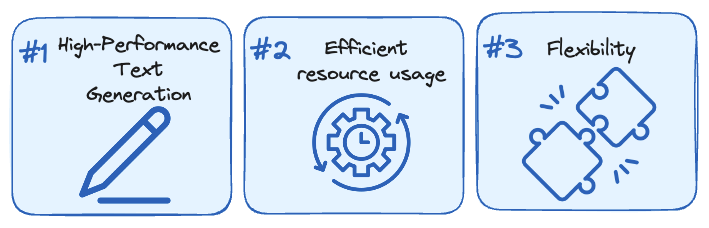
Imagen del autor.
Hugging Face ha optimizado parte de las arquitecturas de los LLMs para que se ejecuten más rápido con TGI. Esto incluye modelos muy populares como LLaMA, Falcon7B y Mistral. Puedes consultar la lista completa en su documentación.
Hugging Face se ha convertido en el lugar de referencia para crear IA con capacidades de lenguaje natural. Es el punto de encuentro de los grandes modelos open source, lo que lo convierte en un motor de innovación en PLN. Hasta ahora, la mayoría de estos modelos eran demasiado pesados para ejecutarse directamente en local; siempre dependíamos de servicios en la nube.
Sin embargo, gracias a los últimos avances con técnicas de cuantización como QLoRa y GPTQ, algunos LLMs ya son manejables en dispositivos cotidianos, como nuestros ordenadores personales.
Hugging Face TGI está diseñado específicamente para ofrecernos LLMs como servicio en nuestras máquinas locales. La razón principal es el engorro de arrancar un LLM.
Para evitar tiempos muertos, es mejor mantener el modelo en segundo plano, listo para responder al instante. De lo contrario, acabarás esperando largos ratos cada vez que lo invoques. Imagina tener un endpoint con una colección de los mejores modelos de lenguaje a tu disposición, listos para generar texto cuando lo necesites.
Lo que más me llamó la atención de TGI fue su enfoque sin complicaciones. Hoy en día, TGI está preparado para trabajar con varias arquitecturas de modelos optimizadas, lo que facilita mucho desplegarlos en un momento.
Y no es teoría: TGI ya impulsa varios proyectos en producción. Algunos ejemplos son:
Imagen del autor. Logos de Hugging Chat (izq.) y OpenAssistant (dcha.)
Hay, eso sí, un límite importante: TGI aún no es compatible con Macs con GPU basadas en ARM, incluidos los modelos M1 y posteriores.
Primero, tenemos que preparar nuestro endpoint de Hugging Face TGI.
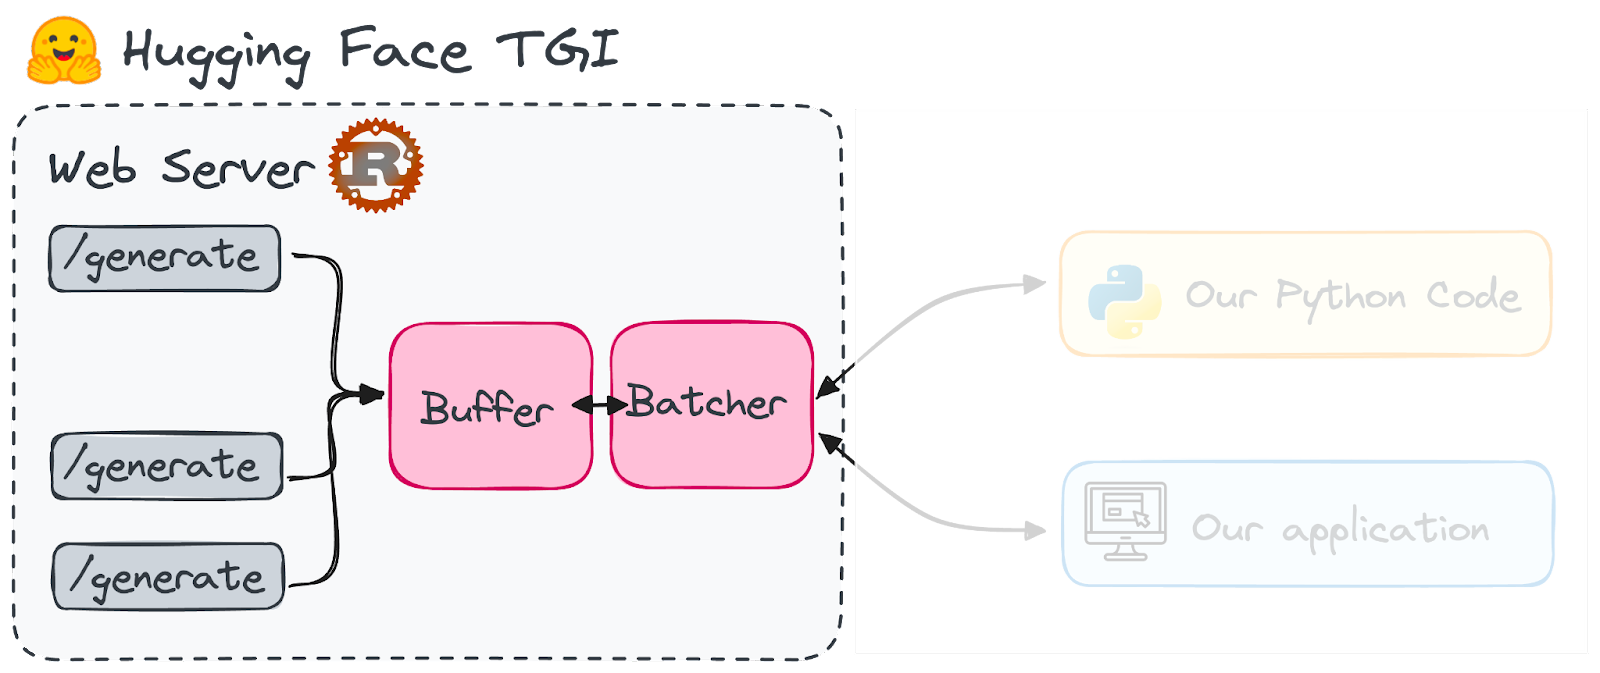
Imagen del autor.
Para instalar y ejecutar Hugging Face TGI en local, primero necesitas instalar Rust y luego crear un entorno virtual de Python con al menos Python 3.9, por ejemplo con conda:
#Installing Rust
curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sh


#Creating a python virtual environment
conda create -n text-generation-inference python=3.9
conda activate text-generation-inference
Además, es necesario instalar Protoc. Hugging Face recomienda la versión 21.12 para una compatibilidad óptima. Ten en cuenta que necesitarás privilegios de sudo para completar esta instalación.
PROTOC_ZIP=protoc-21.12-linux-x86_64.zip
curl -OL https://github.com/protocolbuffers/protobuf/releases/download/v21.12/$PROTOC_ZIP
sudo unzip -o $PROTOC_ZIP -d /usr/local bin/protoc
sudo unzip -o $PROTOC_ZIP -d /usr/local 'include/*'
rm -f $PROTOC_ZIP
Primero te mostraré cómo instalarlo desde cero, que no es del todo trivial. Si te encuentras con problemas durante el proceso, puedes saltarte esta parte y ejecutar directamente una imagen de Docker, que es más sencillo. Abordaremos ambos escenarios.
Con todos los prerrequisitos listos, ya podemos configurar TGI. Empieza por clonar el repositorio de GitHub:
git clone https://github.com/huggingface/text-generation-inference.gitLuego, ve a la carpeta de TGI en tu equipo local e instálalo con los siguientes comandos:
cd text-generation-inference/
BUILD_EXTENSIONS=False make install
Ahora veamos cómo usar TGI, con y sin Docker. Utilizaré el modelo Falcon-7B, disponible bajo la licencia Apache 2.0.
La instalación crea un nuevo comando, "text-generation-launcher", que inicia el servidor de TGI. Para activar un endpoint con el modelo Falcon-7B, basta con ejecutar:
text-generation-launcher --model-id tiiuae/falcon-7b-instruct --num-shard 1 --port 8080 --quantize bitsandbytesDonde cada parámetro es:
Asegúrate de tener Docker instalado y en ejecución. Si no tienes experiencia con Docker, puedes seguir este tutorial de Docker para ciencia de datos con las nociones básicas.
Recuerda: TGI no es compatible con Macs con procesador MX. Puedes consultar todas las imágenes disponibles de TGI en el repositorio de paquetes de TGI en GitHub. Si tu dispositivo es compatible, Docker debería encontrar la imagen correspondiente por ti.
Los parámetros son muy similares a los usados con text-generation-launcher. Si operas con una sola GPU, sustituye "all" por "0".
volume=$PWD/data
sudo docker run --gpus all --shm-size 1g -p 8080:80 -v $volume:/data ghcr.io/huggingface/text-generation-inference:0.9 --model-id tiiuae/falcon-7b-instruct --num-shard 1  --quantize bitsandbytes
Asegúrate de que la imagen de Docker permanezca activa mientras quieras usar el servidor.
Tienes varias opciones para integrar el servidor de Text Generation Inference (TGI) en tus aplicaciones. Una vez esté en marcha, puedes interactuar con él mediante una solicitud POST al endpoint /generate para obtener resultados.
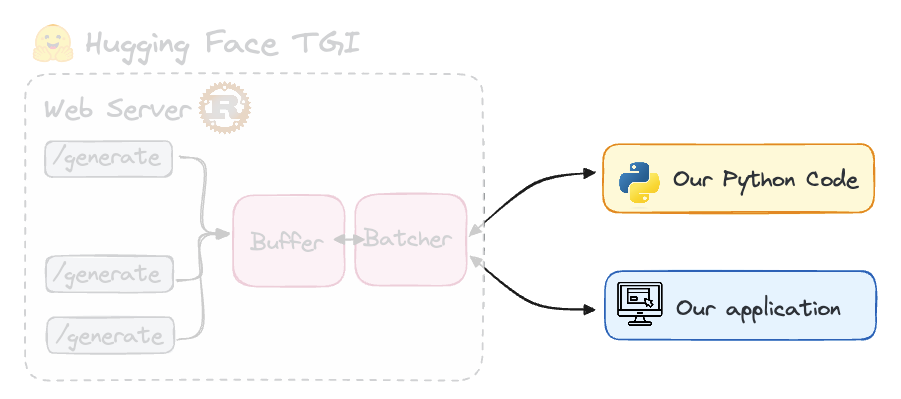
Imagen del autor.
Si prefieres que TGI emita tokens de forma continua, utiliza el endpoint de streaming, como veremos enseguida. Puedes hacer estas solicitudes con la herramienta que prefieras: curl, Python o TypeScript. Para consultar el modelo servido por TGI con un script en Python, tendrás que instalar la siguiente librería text-generation. Es tan sencillo como ejecutar este comando de pip:
pip install text-generationCuando arranques el servidor TGI, instancia InferenceClient() con la URL del endpoint que sirve el modelo. Luego puedes llamar a text_generation() para invocar el endpoint desde Python.
from text_generation import Client
client = Client("http://127.0.0.1:8080")
client.text_generation(prompt="Your prompt here!")
Para habilitar el streaming con InferenceClient, solo tienes que establecer stream=True. Así recibirás los tokens en tiempo real conforme los va generando el servidor. Aquí tienes un ejemplo:
for token in client.text_generation("Your prompt here!", max_new_tokens=12, stream=True):
print(token)Recuerda que trabajarás con el modelo que hayas desplegado en tu endpoint, en nuestro caso, Falcon-7B. Con TGI creamos un endpoint activo que nos permite recuperar respuestas del LLM que elijamos.
Por tanto, desde Python podemos enviar prompts directamente al LLM mediante el cliente alojado en nuestro dispositivo local, accesible a través del puerto 8080. El script de Python correspondiente sería algo así:
from text_generation import Client
client = Client("http://127.0.0.1:8080")
print(client.generate("Translate the following sentence into spanish: 'What does Large Language Model mean?'", max_new_tokens=500).generated_text)
Y obtendremos una respuesta del modelo sin necesidad de instalarlo en nuestro entorno. En lugar de Python, también podemos consultar el LLM con CURL, como ves en el siguiente ejemplo:
curl 127.0.0.1:8080/generate \
    -X POST \
    -d '{"inputs":"Code in Javascript a function to remove all spaces in a string and then print the string twice.","parameters":{"max_new_tokens":500}}' \
    -H 'Content-Type: application/json'
Tras trastear un poco con TGI, la velocidad impresiona. Usando Falcon-7B (con un límite de 500 tokens) tarda unos pocos segundos. En cambio, con el enfoque de inferencia típico (usando la librería transformers) ronda los 30 segundos.
Desde la versión 1.4.0, TGI incorpora una API compatible con la Chat Completion API de OpenAI. Esta nueva Messages API facilita una transición fluida de clientes y usuarios desde los modelos de OpenAI a LLMs de código abierto. La API está pensada para integrarse directamente con las librerías cliente de OpenAI o con herramientas de terceros como LangChain o LlamaIndex.
El soporte de Messages en TGI garantiza que sus Inference Endpoints sean totalmente compatibles con la Chat Completion API de OpenAI. Esto permite sustituir fácilmente cualquier script que use modelos de OpenAI por LLMs abiertos alojados en endpoints de TGI sin complicaciones.
Esta mejora facilita un cambio sin fricciones, dando acceso inmediato a las ventajas del open source, entre ellas:
Un ejemplo de cómo integrar TGI en el protocolo de chat completion de OpenAI sería el siguiente:
from openai import OpenAI

# initialize the client but point it to TGI
client = OpenAI(
    base_url="<ENDPOINT_URL>" + "/v1/",  # replace with your endpoint url
    api_key="<HF_API_TOKEN>",  # replace with your token
)
chat_completion = client.chat.completions.create(
    model="tgi",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "Why is open-source software important?"},
    ],
    stream=True,
    max_tokens=500
)

# iterate and print stream
for message in chat_completion:
    print(message.choices[0].delta.content, end="")
Como ves, la librería openai puede apuntar a nuestro ENDPOINT y a nuestra contraseña de Hugging Face. Para profundizar en esta integración, consulta la documentación de Hugging Face TGI.
Antes de lanzarte a Hugging Face TGI, deberías estar familiarizado con los modelos de lenguaje grandes. Repasa conceptos como la tokenización, los mecanismos de atención y la arquitectura Transformer. Estas bases son clave para personalizar modelos y afinar las salidas de texto.
Aprende a preparar y optimizar modelos para tus necesidades. Esto incluye elegir el modelo adecuado, personalizar tokenizers y aplicar técnicas para mejorar el rendimiento sin sacrificar calidad.
Asegúrate de entender cómo funciona Hugging Face y cómo usar su Hugging Face Hub para desarrollo en PLN. Un buen tutorial introductorio es An Introduction to Using Transformers and Hugging Face.
El fine-tuning es otro concepto que debes conocer, ya que a menudo hay que ajustar los modelos a objetivos concretos. Puedes aprender a hacer fine-tuning con An Introductory Guide to Fine-Tuning LLMs
Explora distintas estrategias de generación de texto, como greedy search, beam search y top-k sampling. Cada una tiene sus pros y contras, y afecta a la coherencia, creatividad y relevancia del texto generado.
El kit TGI de Hugging Face permite a cualquiera adentrarse en la generación de texto con IA. Ofrece una solución sencilla para desplegar y alojar LLMs en aplicaciones de PLN avanzadas que requieren texto con calidad humana.
Aunque autoalojar modelos de lenguaje grandes aporta privacidad de datos y control de costes, requiere hardware potente. No obstante, los últimos avances permiten utilizar modelos más pequeños directamente en nuestras máquinas locales.
Si quieres seguir creciendo en el mundo de los LLMs, te animo a realizar tutoriales más avanzados. Puedes empezar con el curso LLM Concepts de DataCamp, que cubre muchas de las metodologías de entrenamiento clave y la investigación más reciente.
Otros buenos recursos son:
¡Empieza hoy tu camino en IA!
Curso
Curso
programa
blog
Abid Ali Awan
10 min
Tutorial
Josep Ferrer
11 min
Tutorial
Zoumana Keita
7 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Zoumana Keita
8 min
Tutorial
Moez Ali
11 min