Curso
Conceitos de Grandes Modelos de Linguagem (LLMs)
2 h
109.8K
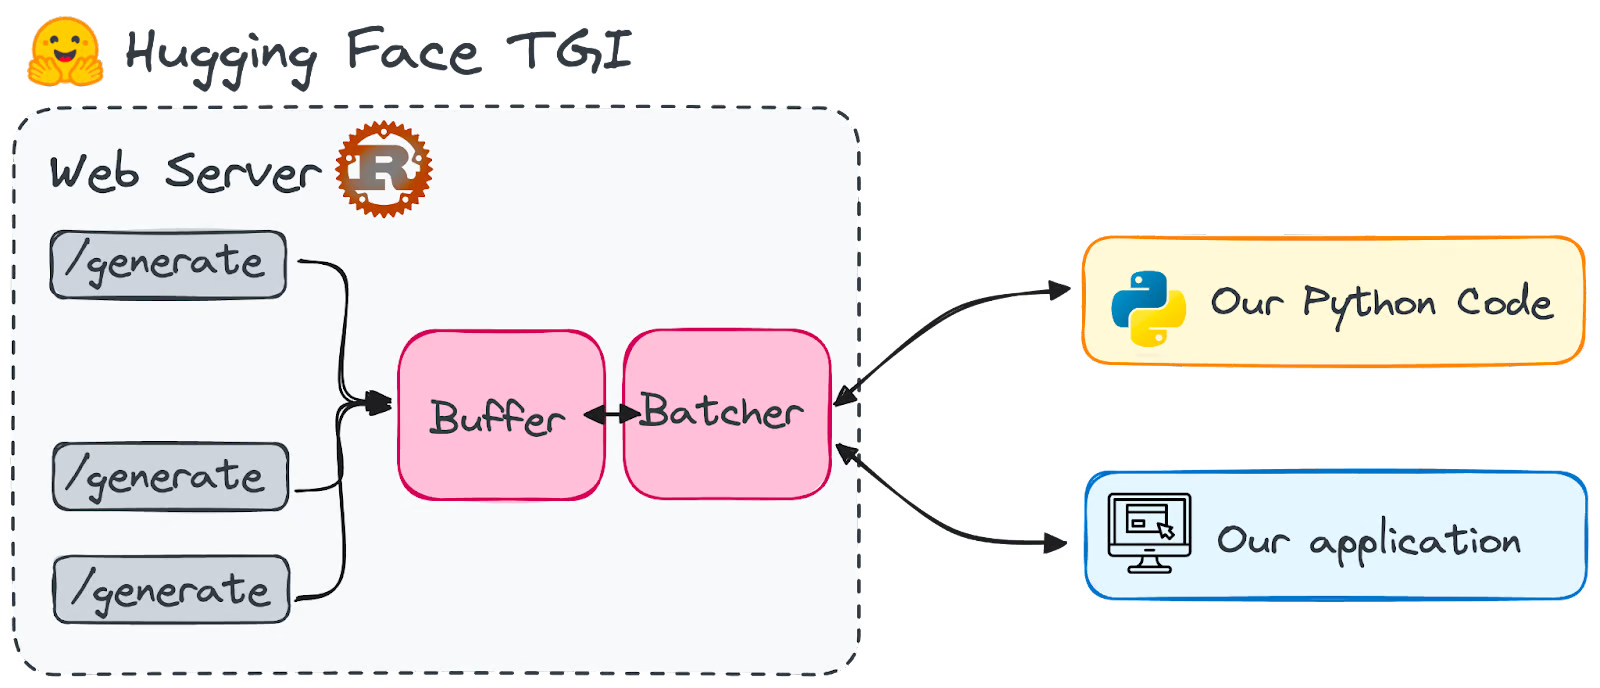
Imagem do autor
No campo de crescimento acelerado da inteligência artificial, os Large Language Models surgiram como os protagonistas dos avanços mais recentes na área.
A geração de texto se tornou uma capacidade revolucionária, transformando a forma como máquinas entendem e produzem texto com aparência humana. Essa popularidade explica por que várias ferramentas foram lançadas para facilitar o trabalho com LLMs.
A rápida proliferação de Large Language Models (LLMs), com novidades surgindo quase toda semana, impulsionou em paralelo o crescimento de opções de hospedagem para essa tecnologia. Dentro do vasto universo de ferramentas disponíveis para esse fim, o Text Generation Inference (TGI) da Hugging Face merece destaque, pois permite executar um LLM como serviço na sua máquina local.
Em poucas palavras, ele nos dá um endpoint para chamar nosso modelo.
Este guia explora por que o Hugging Face TGI muda o jogo e como você pode aproveitá-lo para criar modelos de IA sofisticados, capazes de gerar textos cada vez mais indistinguíveis daqueles produzidos por humanos.
O Hugging Face Text Generation Inference, também conhecido como TGI, é um framework escrito em Rust e Python para implantar e servir Large Language Models. É um kit pronto para produção para deploy e serviço de LLMs.
A Hugging Face o desenvolve e distribui sob a licença HFOILv1.0, permitindo uso comercial desde que ele atue como ferramenta auxiliar dentro do produto ou serviço oferecido, e não como foco principal. Os principais desafios que ele resolve são:
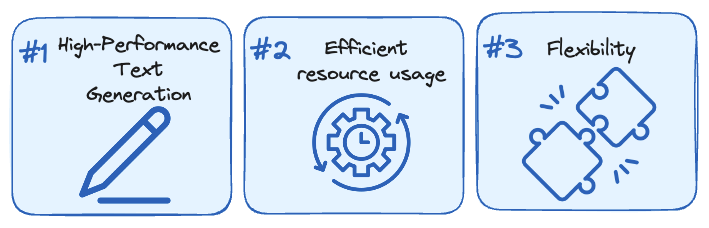
Imagem do autor.
A Hugging Face otimizou algumas arquiteturas de LLMs para que rodem mais rápido com o TGI. Isso inclui modelos populares como LLaMA, Falcon7B e Mistral. A lista completa está na documentação.
A Hugging Face virou o ponto de encontro para criar IA com habilidades de linguagem natural. É um hub onde os grandes modelos open source estão reunidos, impulsionando a inovação em PLN. Até pouco tempo, a maioria desses modelos era pesada demais para uso direto localmente — havia sempre dependência de serviços em nuvem.
Mas, com os avanços recentes de quantização como QLoRa e GPTQ, alguns LLMs ficaram viáveis em dispositivos do dia a dia — como nossos computadores locais.
O Hugging Face TGI foi feito especificamente para fornecer LLMs como serviço nas máquinas locais. O motivo principal é a dor de cabeça de inicializar um LLM.
Para evitar tempo ocioso, é mais inteligente manter o modelo ativo em background, pronto para responder rápido. Caso contrário, você entra num ciclo de espera longa a cada prompt. Imagine ter um endpoint com uma coleção de ótimos modelos de linguagem à sua disposição, prontos para gerar texto sob demanda.
O que me chamou atenção no TGI foi a simplicidade. Hoje, o TGI já está preparado para várias arquiteturas de modelos otimizadas, facilitando um deploy ágil.
E não é só discurso: o TGI já é o motor por trás de vários projetos em produção. Alguns exemplos:
Imagem do autor. Logos do Hugging Chat (esquerda) e OpenAssistant (direita)
Há, no entanto, uma limitação importante: o TGI ainda não é compatível com Macs com GPU baseada em ARM, incluindo a série M1 e posteriores.
Primeiro, precisamos configurar nosso endpoint do Hugging Face TGI.
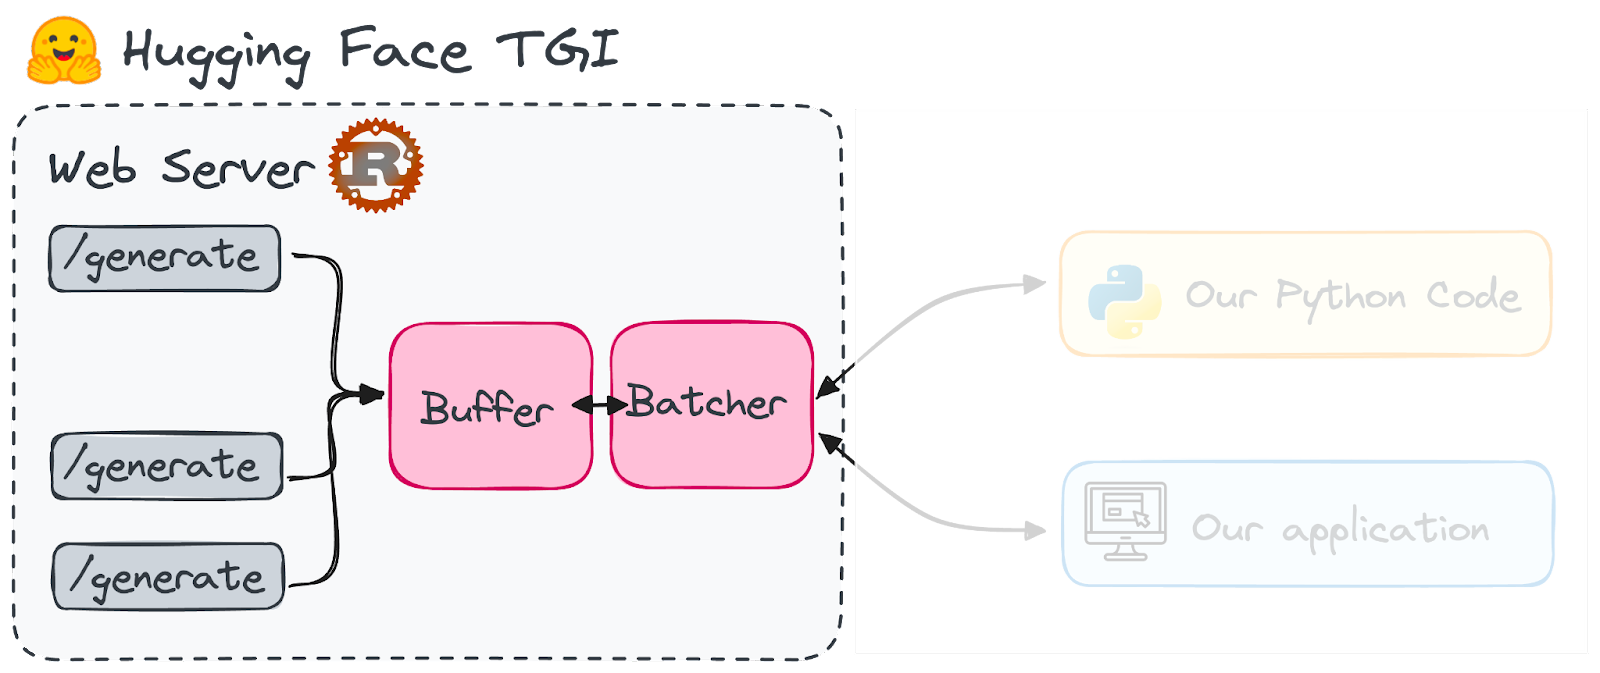
Imagem do autor.
Para instalar e iniciar o Hugging Face TGI localmente, primeiro você precisa instalar o Rust e depois criar um ambiente virtual Python com pelo menos Python 3.9, por exemplo usando conda:
#Installing Rust
curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sh


#Creating a python virtual environment
conda create -n text-generation-inference python=3.9
conda activate text-generation-inference
Além disso, é necessário instalar o Protoc. A Hugging Face sugere a versão 21.12 para melhor compatibilidade. Observe que você precisará de privilégios de sudo para continuar com essa instalação.
PROTOC_ZIP=protoc-21.12-linux-x86_64.zip
curl -OL https://github.com/protocolbuffers/protobuf/releases/download/v21.12/$PROTOC_ZIP
sudo unzip -o $PROTOC_ZIP -d /usr/local bin/protoc
sudo unzip -o $PROTOC_ZIP -d /usr/local 'include/*'
rm -f $PROTOC_ZIP
Primeiro vou mostrar como instalar do zero, o que não é tão trivial. Se você tiver problemas no processo, pode pular esta parte inicial e rodar diretamente uma imagem Docker, que é mais simples. Vou cobrir os dois cenários.
Com todos os pré-requisitos prontos, vamos configurar o TGI. Comece clonando o repositório do GitHub:
git clone https://github.com/huggingface/text-generation-inference.gitDepois, acesse a pasta do TGI no seu computador local e instale com os comandos abaixo:
cd text-generation-inference/
BUILD_EXTENSIONS=False make install
Agora vamos ver como usar o TGI, com e sem Docker. Vou usar o modelo Falcon-7B, disponível sob a licença Apache 2.0.
A instalação criou um novo comando, "text-generation-launcher", que inicia o servidor TGI. Para ativar um endpoint com o modelo Falcon-7B, basta executar:
text-generation-launcher --model-id tiiuae/falcon-7b-instruct --num-shard 1 --port 8080 --quantize bitsandbytesOnde cada parâmetro é:
Garanta que você tenha o Docker instalado e em execução. Se você não tem experiência com Docker, siga este tutorial de Docker para Data Science para aprender o básico.
Lembre-se: o TGI não é compatível com Macs com processador MX. Você pode conferir todas as imagens disponíveis do TGI no repositório de pacotes do TGI no GitHub. Se o seu dispositivo for compatível, o Docker deve encontrar a imagem correspondente para você.
Os parâmetros são bem parecidos com os usados no text-generation-launcher. Se você estiver com apenas uma GPU, troque "all" por "0".
volume=$PWD/data
sudo docker run --gpus all --shm-size 1g -p 8080:80 -v $volume:/data ghcr.io/huggingface/text-generation-inference:0.9 --model-id tiiuae/falcon-7b-instruct --num-shard 1  --quantize bitsandbytes
Deixe a imagem do Docker ativa enquanto você quiser usar o servidor.
Você tem várias opções para integrar o servidor Text Generation Inference (TGI) às suas aplicações. Depois de rodando, dá para interagir fazendo uma requisição POST ao endpoint /generate para obter os resultados.
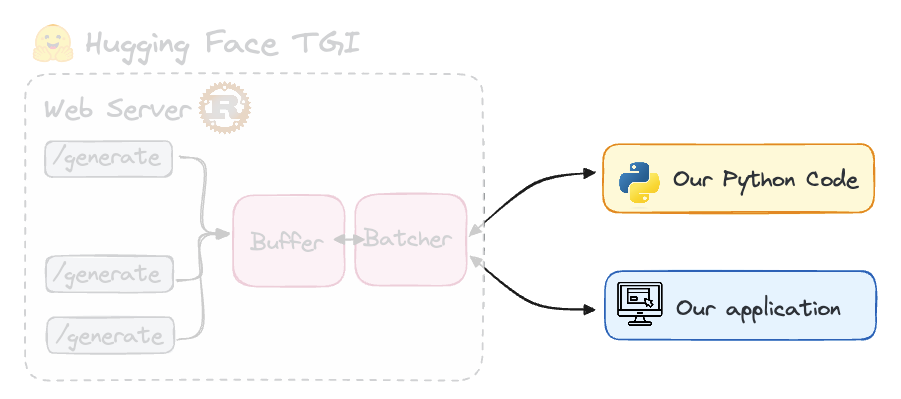
Imagem do autor.
Se você preferir que o TGI transmita tokens continuamente, use o endpoint de streaming, como veremos a seguir. Essas requisições podem ser feitas com a ferramenta que você preferir, incluindo curl, Python ou TypeScript. Para consultar o modelo servido pelo TGI com um script em Python, instale a biblioteca text-generation. É só executar o pip:
pip install text-generationDepois de iniciar o servidor TGI, instancie InferenceClient() com a URL do endpoint que serve o modelo. Em seguida, chame text_generation() para atingir o endpoint via Python.
from text_generation import Client
client = Client("http://127.0.0.1:8080")
client.text_generation(prompt="Your prompt here!")
Para habilitar streaming com o InferenceClient, basta definir stream=True. Assim você recebe tokens em tempo real, conforme são gerados no servidor. Veja como usar streaming:
for token in client.text_generation("Your prompt here!", max_new_tokens=12, stream=True):
print(token)Lembre que você estará trabalhando com o modelo que implantou no seu endpoint — no nosso caso, o Falcon-7B. Usando o TGI, criamos um endpoint ativo que permite obter respostas do LLM que escolhermos.
Assim, em Python, podemos enviar prompts diretamente ao LLM via o cliente hospedado no dispositivo local, acessível pela porta 8080. O script Python correspondente ficaria assim:
from text_generation import Client
client = Client("http://127.0.0.1:8080")
print(client.generate("Translate the following sentence into spanish: 'What does Large Language Model mean?'", max_new_tokens=500).generated_text)
E obteremos uma resposta do modelo sem precisar instalá-lo no ambiente. Em vez de Python, também podemos consultar o LLM com CURL, como no exemplo:
curl 127.0.0.1:8080/generate \
    -X POST \
    -d '{"inputs":"Code in Javascript a function to remove all spaces in a string and then print the string twice.","parameters":{"max_new_tokens":500}}' \
    -H 'Content-Type: application/json'
Depois de brincar um pouco com o TGI, a velocidade impressiona. Usando o Falcon-7B (com limite de 500 tokens) leva alguns segundos. Já na inferência tradicional (com a biblioteca transformers) leva cerca de 30 segundos.
A partir da versão 1.4.0, o TGI introduziu uma API compatível com a Chat Completion API da OpenAI. Essa nova Messages API permite uma transição suave de clientes e usuários dos modelos da OpenAI para LLMs open source. A API foi desenhada para integração direta com as bibliotecas cliente da OpenAI ou com ferramentas de terceiros como LangChain ou LlamaIndex.
O suporte do TGI a Messages garante que seus Inference Endpoints sejam totalmente compatíveis com a Chat Completion API da OpenAI. Isso permite substituir facilmente scripts existentes que usam modelos da OpenAI por LLMs abertos hospedados em endpoints TGI, sem complicação.
Essa atualização facilita a migração e dá acesso imediato às grandes vantagens dos modelos open source, incluindo:
Um exemplo de como integrar o TGI no protocolo de chat completion da OpenAI segue abaixo:
from openai import OpenAI

# initialize the client but point it to TGI
client = OpenAI(
    base_url="<ENDPOINT_URL>" + "/v1/",  # replace with your endpoint url
    api_key="<HF_API_TOKEN>",  # replace with your token
)
chat_completion = client.chat.completions.create(
    model="tgi",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "Why is open-source software important?"},
    ],
    stream=True,
    max_tokens=500
)

# iterate and print stream
for message in chat_completion:
    print(message.choices[0].delta.content, end="")
Como você pode ver, a biblioteca openai pode ser usada apontando para o nosso ENDPOINT e nossa senha da Hugging Face. Para entender melhor essa integração, consulte a documentação do Hugging Face TGI.
Antes de mergulhar no Hugging Face TGI, vale conhecer bem os Large Language Models. Familiarize-se com conceitos como tokenização, mecanismos de atenção e a arquitetura Transformer. Esses fundamentos são cruciais para customizar modelos e refinar saídas de geração de texto.
Aprenda a preparar e otimizar modelos para suas necessidades. Isso inclui escolher o modelo certo, customizar tokenizers e aplicar técnicas para melhorar desempenho sem sacrificar qualidade.
Entenda como funciona a Hugging Face e como usar o Hugging Face Hub para desenvolvimento em PLN. Um bom tutorial introdutório é An Introduction to Using Transformers and Hugging Face.
Fine-tuning é outro conceito essencial, já que, na maioria das vezes, os modelos precisam ser ajustados para objetivos específicos. Você pode aprender a fazer fine-tuning com o An Introductory Guide to Fine-Tuning LLMs
Explore diferentes estratégias de geração de texto, como greedy search, beam search e top-k sampling. Cada uma tem prós e contras que impactam a coerência, criatividade e relevância do texto gerado.
O TGI da Hugging Face capacita qualquer pessoa a explorar geração de texto com IA. Ele oferece um toolkit fácil de usar para fazer deploy e hospedar LLMs em aplicações avançadas de PLN que exigem texto com aparência humana.
Embora auto-hospedar modelos de linguagem grandes ofereça privacidade de dados e controle de custos, isso exige hardware potente. No entanto, os avanços mais recentes permitem usar modelos menores diretamente nas nossas máquinas locais.
Se você quer continuar evoluindo no universo de LLMs, recomendo fortemente fazer tutoriais mais avançados. Você pode começar pelo curso LLM Concepts da DataCamp, que cobre muitas das principais metodologias de treinamento e as pesquisas mais recentes.
Outros bons recursos para acompanhar:
Comece sua jornada em IA hoje!
Curso
Curso
Programa
blog
Nisha Arya Ahmed
12 min
Tutorial
Josep Ferrer
11 min
Tutorial
Zoumana Keita
7 min
Tutorial
Zoumana Keita
8 min
Tutorial
Kurtis Pykes
12 min
Tutorial
Abid Ali Awan
13 min