

SAM2 Nedir?
SAM2, Meta tarafından görüntü ve videolarda isteğe dayalı görsel bölütleme için geliştirilmiş bir temel modeldir. Önceki sürümü olan SAM esas olarak statik görüntülere odaklanırken, SAM2 video bölütlemenin karmaşıklıklarını da ele alacak şekilde tasarlanmıştır.
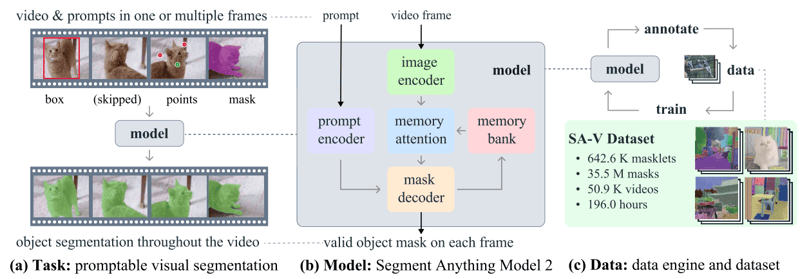
SAM2 - Görev, Model ve Veri (Kaynak: Ravi ve diğ., 2024)
Akış belleğine sahip bir dönüştürücü (transformer) mimarisi kullanır ve bu sayede gerçek zamanlı video işleme yapar. SAM 2'nin eğitimi, 51.000 videoya yayılan 600.000'den fazla masklet açıklaması içeren yeni SA-V veri kümesini de barındıran, geniş ve çeşitli bir veri kümesiyle gerçekleştirilmiştir.
Etkileşimli veri toplama ve model iyileştirmeyi mümkün kılan veri motoru, modele mümkün olan her şeyi bölütleme kabiliyeti kazandırır. Bu motor, SAM 2'nin sürekli öğrenip uyum sağlamasına imkân tanır ve yeni ile zorlu verileri ele almada daha verimli olmasını sağlar. Ancak, alanına özgü görevler veya nadir nesneler için en iyi performansa ulaşmak adına ince ayar şarttır.
Neden SAM2'ye İnce Ayar Yapmalı?
SAM 2 bağlamında ince ayar, önceden eğitilmiş SAM 2 modelinin belirli bir görev veya alan için performansını artırmak amacıyla özel bir veri kümesi üzerinde ek olarak eğitilmesi sürecidir. Geniş ve çeşitli bir veri kümesi üzerinde eğitilmiş güçlü bir araç olmasına rağmen, genel amaçlı yapısı uzmanlaşmış veya nadir görevlerde her zaman en iyi sonuçları vermeyebilir.
Örneğin, belirli tümör türlerinin tespitini gerektiren bir tıbbi görüntüleme projesi üzerinde çalışıyorsanız, modelin genelleştirilmiş eğitimi nedeniyle performansı yetersiz kalabilir.
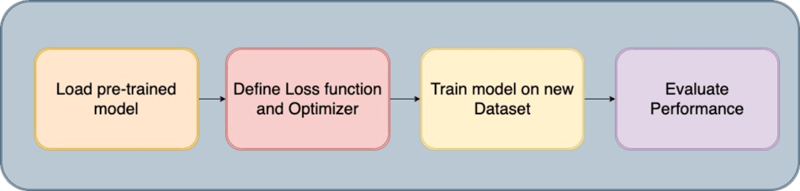
İnce ayar süreci
SAM 2'ye ince ayar yapmak, modeli özel veri kümenize uyarlamanıza olanak tanıyarak bu sınırlamayı giderir. Bu süreç, modelin doğruluğunu artırır ve benzersiz kullanım senaryonuz için daha etkili hale getirir.
SAM 2'ye ince ayar yapmanın başlıca faydaları şunlardır:
- Artırılmış doğruluk: Modeli özel veri kümeniz üzerinde ince ayar yaparak doğruluğunu önemli ölçüde artırabilir, hedef uygulamanızda daha iyi performans sağlayabilirsiniz.
- Uzmanlaşmış bölütleme: İnce ayar, modeli projenizle ilgili belirli nesne türleri, görsel stiller veya ortamları bölütlemede yetkin hale getirir; bu da genel amaçlı bir modelin başaramayabileceği, ihtiyaca özel sonuçlar sunar.
- Verimlilik: İnce ayar, sıfırdan model eğitmekten genellikle daha verimlidir. Daha az veri ve zaman gerektirir; bu da modeli yeni veya niş görevlere hızlıca uyarlamak için pratik bir çözüm sunar.
SAM 2'ye İnce Ayar: Önkoşullar
SAM 2'ye ince ayar yapmaya başlamak için aşağıdaki önkoşullara ihtiyacınız olacaktır:
- SAM 2 modeline ve kod tabanına erişim: SAM 2 modeline ve kod tabanına erişiminiz olmalı. Önceden eğitilmiş SAM 2 modelini Meta'nın GitHub deposundan indirebilirsiniz.
- Uygun bir veri kümesi: Gerçek (ground truth) bölütleme maskeleri içeren bir veri kümesine ihtiyacınız olacak. Bu eğitimde Chest CT Segmentation veri kümesini kullanacağız; bunu indirip eğitime hazırlayabilirsiniz.
- Hesaplama kaynakları: SAM 2'ye ince ayar yapmak için yeterli hesaplama gücüne sahip donanım gerekir. Özellikle büyük veri kümeleri veya karmaşık modellerle çalışırken sürecin verimli ve yönetilebilir olması için GPU'lar şiddetle tavsiye edilir. Bu örnekte Google Colab üzerinde bir A100 GPU kullanılmıştır.
Yazılım ve diğer gereksinimler:
- Python 3.11 veya üzeri
- PyTorch
- OpenCV: !pip install opencv-python komutuyla kurun
SAM 2'ye İnce Ayar İçin Veri Kümesini Hazırlama
Veri kümenizin kalitesi, SAM 2 modeline ince ayar yaparken kritiktir. Doğru bölütleme maskelerine sahip, yüksek kaliteli açıklamalı görüntüler veya videolar, en iyi performansa ulaşmak için zorunludur. Hassas açıklamalar, modelin doğru özellikleri öğrenmesini sağlar ve gerçek dünyadaki uygulamalarda daha iyi bölütleme doğruluğu ve sağlamlık sunar.
1. Veri edinimi
İlk adım, eğitim sürecinin belkemiğini oluşturan veri kümesini edinmektir. Verilerimizi, geniş yelpazede veri kümeleri sunan güvenilir bir platform olan Kaggle üzerinden temin ettik. Kaggle API'sini kullanarak verileri gerekli biçimde indirdik; böylece görüntüler ve bunlara karşılık gelen bölütleme maskeleri, ileri işlemler için hazır hale geldi.
2. Verinin çıkarılması ve temizlenmesi
Veri kümelerini indirdikten sonra şu adımları uyguladık:
- Sıkıştırmayı açma ve temizleme: İndirilen zip dosyalarından verileri çıkarın ve disk alanından tasarruf etmek için gereksiz dosyaları silin.
- ID çıkarımı: Eğitim sırasında görüntüler ve maskeler arasında doğru eşleşmeyi sağlamak için görüntü ve maskelere ait benzersiz tanımlayıcılar (ID'ler) çıkarılır.
- Gereksiz dosyaların kaldırılması: Veri kümesinin bütünlüğünü korumak için, bilinen sorunları olan bazı görüntüler gibi gürültülü veya alakasız dosyaları kaldırın.
3. Kullanılabilir biçimlere dönüştürme
SAM2 modeli belirli giriş biçimlerine ihtiyaç duyduğundan, verileri şu şekilde dönüştürdük:
- DICOM'dan NumPy'a: DICOM görüntüleri okunup NumPy dizileri olarak kaydedildi ve ardından 512x512 piksel standart boyuta yeniden ölçeklendirildi.
- Maskeler için NRRD'den NumPy'a: Benzer şekilde, akciğer, kalp ve trakeaya ait maskeleri içeren NRRD dosyaları işlendi ve NumPy dizileri olarak kaydedildi. Bu maskeler, karşılık gelen görüntülerle eşleşecek şekilde yeniden şekillendirildi.
- JPG/PNG'ye dönüştürme: Daha iyi görselleştirme ve uyumluluk için NumPy dizileri JPG/PNG biçimlerine dönüştürüldü. Bu adım, görüntü yoğunluk değerlerinin normalleştirilmesini ve maskelerin doğru şekilde yönlendirilmesini içeriyordu.
4. Veriyi kaydetme ve düzenleme
İşlenen görüntüler ve maskeler, ince ayar sırasında kolay erişim için ilgili klasörlere düzenlenir. Ayrıca bu görüntü ve maskelerin yolları, eğitim sırasında veri yüklemeyi kolaylaştırmak amacıyla bir CSV dosyasına (train.csv) yazılır.
5. Görselleştirme ve doğrulama
Son adım, veri kümesinin doğruluğunu sağlamak için doğrulamadır:
- Görselleştirme: Maskeleri görüntülerin üzerine bindirerek görüntü-maske çiftlerini görselleştirdik. Bu, maskelerin hizalamasını ve doğruluğunu kontrol etmemize yardımcı oldu.
- İnceleme: Birkaç örneği inceleyerek veri kümesinin doğru şekilde hazırlandığını ve ince ayar için kullanımına hazır olduğunu teyit ettik.
Burada veri kümesi oluşturma koduna hızlıca göz atabileceğiniz bir not defteri yer alıyor. Bu veri oluşturma yolunu izleyebilir veya önkoşullarda belirtilenle aynı biçimde çevrimiçi mevcut herhangi bir veri kümesini doğrudan kullanabilirsiniz.
SAM2'ye İnce Ayar
Segment Anything Model 2 birkaç bileşen içerir; ancak daha hızlı ince ayar için püf noktası, tüm modeli değil maske çözücü ve istem kodlayıcı gibi hafif bileşenleri eğitmektir. Bu model için ince ayar adımları şunlardır:
Adım 1: SAM-2'yi kurun
İnce ayar sürecine başlamak için, Segment Anything Model (SAM2) için kritik önemde olan SAM-2 kitaplığını kurmamız gerekir. Bu model, çeşitli bölütleme görevlerini etkili biçimde ele almak üzere tasarlanmıştır. Kurulum, SAM-2 deposunun GitHub'dan klonlanmasını ve gerekli bağımlılıkların yüklenmesini içerir.
!git clone https://github.com/facebookresearch/segment-anything-2
%cd /content/segment-anything-2
!pip install -q -e .Bu kod parçacığı, SAM2 kitaplığının doğru şekilde kurulmasını ve ince ayar iş akışımızda kullanıma hazır olmasını sağlar.
Adım 2: Veri kümesini indirin
SAM-2 kitaplığı kurulduktan sonra bir sonraki adım, ince ayarda kullanacağımız veri kümesini edinmektir. Akciğer, kalp ve trakeaya ait görüntü ve maskeleri içeren, Kaggle'da bulunan bir göğüs BT bölütleme veri kümesini kullanıyoruz.
Veri kümesi şunları içerir:
- images.zip: RGB biçiminde görüntüler
- masks.zip: RGB biçiminde bölütleme maskeleri
- train.csv: Görüntü adlarını içeren CSV dosyası
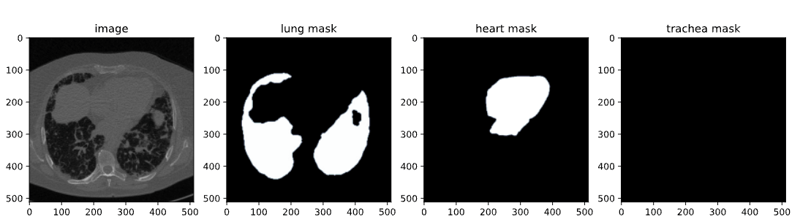
BT Taraması Veri Kümesinden Görüntü
Bu blogda, bölütleme için yalnızca akciğerlere ait görüntü ve maskeleri kullanacağız. Kaggle API'si veri kümelerini doğrudan ortamımıza indirmemize imkân tanır. Herhangi bir veri kümesine kolayca erişmek için önce Kaggle'dan kaggle.json dosyasını yüklüyoruz.
kaggle.json dosyasını almak için kullanıcı profilinizdeki Settings sekmesine gidin ve Create New Token'ı seçin. Bu işlem, API kimlik bilgilerinizin bulunduğu Kaggle download. json dosyasının indirilmesini tetikler.
# get dataset from Kaggle
from google.colab import files
files.upload() # This will prompt you to upload the kaggle.json file
!mkdir -p ~/.kaggle
!mv kaggle.json ~/.kaggle/
!chmod 600 ~/.kaggle/kaggle.json
!kaggle datasets download -d polomarco/chest-ct-segmentationVerilerin sıkıştırmasını açın:
!unzip chest-ct-segmentation.zip -d chest-ct-segmentationVeri kümesi hazır olduğuna göre ince ayar sürecine başlayalım. Daha önce belirttiğim gibi, burada önemli olan, tüm model yerine maske çözücü ve istem kodlayıcı gibi SAM2'nin hafif bileşenlerine ince ayar yapmaktır. Bu yaklaşım daha verimlidir ve daha az kaynak gerektirir.
Adım 3: SAM-2 kontrol noktalarını indirin
İnce ayar süreci için, önceden eğitilmiş SAM2 model ağırlıklarıyla başlamamız gerekir. "Kontrol noktaları" olarak adlandırılan bu ağırlıklar, daha ileri eğitim için başlangıç noktasıdır. Kontrol noktaları, geniş bir görüntü yelpazesinde eğitilmiştir; bunlara özel veri kümemiz üzerinde ince ayar yaparak hedef görevlerimizde daha iyi performans elde edebiliriz.
!wget -O sam2_hiera_tiny.pt "https://dl.fbaipublicfiles.com/segment_anything_2/072824/sam2_hiera_tiny.pt"
!wget -O sam2_hiera_small.pt "https://dl.fbaipublicfiles.com/segment_anything_2/072824/sam2_hiera_small.pt"
!wget -O sam2_hiera_base_plus.pt "https://dl.fbaipublicfiles.com/segment_anything_2/072824/sam2_hiera_base_plus.pt"
!wget -O sam2_hiera_large.pt "https://dl.fbaipublicfiles.com/segment_anything_2/072824/sam2_hiera_large.pt"Bu adımda, farklı model boyutlarına (ör. tiny, small, base_plus, large) karşılık gelen çeşitli SAM-2 kontrol noktalarını indiriyoruz. Hangi kontrol noktasının seçileceği, mevcut hesaplama kaynaklarına ve eldeki özel göreve göre ayarlanabilir.
Adım 4: Veri hazırlama
Veri kümesi indirildikten sonra sıradaki adım, eğitime hazırlamaktır. Bu, veri kümesini eğitim ve test setlerine ayırmayı ve ince ayar sırasında SAM 2 modeline beslenebilecek veri yapıları oluşturmayı içerir.
%cd /content/segment-anything-2
import os
import pandas as pd
import cv2
import torch
import torch.nn.utils
import numpy as np
import matplotlib.pyplot as plt
import matplotlib.colors as mcolors
from sklearn.model_selection import train_test_split
from sam2.build_sam import build_sam2
from sam2.sam2_image_predictor import SAM2ImagePredictor
# Path to the chest-ct-segmentation dataset folder
data_dir = "/content/segment-anything-2/chest-ct-segmentation"
images_dir = os.path.join(data_dir, "images/images")
masks_dir = os.path.join(data_dir, "masks/masks")
# Load the train.csv file
train_df = pd.read_csv(os.path.join(data_dir, "train.csv"))
# Split the data into two halves: one for training and one for testing
train_df, test_df = train_test_split(train_df, test_size=0.2, random_state=42)
# Prepare the training data list
train_data = []
for index, row in train_df.iterrows():
image_name = row['ImageId']
mask_name = row['MaskId']
# Append image and corresponding mask paths
train_data.append({
"image": os.path.join(images_dir, image_name),
"annotation": os.path.join(masks_dir, mask_name)
})
# Prepare the testing data list (if needed for inference or evaluation later)
test_data = []
for index, row in test_df.iterrows():
image_name = row['ImageId']
mask_name = row['MaskId']
# Append image and corresponding mask paths
test_data.append({
"image": os.path.join(images_dir, image_name),
"annotation": os.path.join(masks_dir, mask_name)
})
Modeli eğittikten sonra performansını değerlendirebilmek için veri kümesini eğitim (%80) ve test (%20) olarak ayırıyoruz. Eğitim verileri SAM 2 modeline ince ayar yapmak için kullanılırken, test verileri çıkarım ve değerlendirme için kullanılacaktır.
Veri kümenizi eğitim ve test setlerine ayırdıktan sonra sıradaki adım, ikili maskeler oluşturmayı, bu maskeler içinde kilit noktaları seçmeyi ve verilerin doğru işlendiğini doğrulamak için bu öğeleri görselleştirmeyi içerir.
1. Görüntüleri okuma ve yeniden boyutlandırma: Süreç, veri kümesinden rastgele bir görüntü ve karşılık gelen maskesinin seçilmesiyle başlar. Görüntü, çoğu derin öğrenme modelinin standart renk biçimi olan BGR'den RGB'ye dönüştürülür. Karşılık gelen açıklama (maske) gri tonlamalı modda okunur. Ardından hem görüntü hem de açıklama maskesi, en uzun kenarı 1024 piksel olacak şekilde, en-boy oranı korunarak yeniden boyutlandırılır; böylece modelin giriş gereksinimlerine uyum sağlanır ve hesaplama yükü azaltılır.
def read_batch(data, visualize_data=False):
# Select a random entry
ent = data[np.random.randint(len(data))]
# Get full paths
Img = cv2.imread(ent["image"])[..., ::-1] # Convert BGR to RGB
ann_map = cv2.imread(ent["annotation"], cv2.IMREAD_GRAYSCALE) # Read annotation as grayscale
if Img is None or ann_map is None:
print(f"Error: Could not read image or mask from path {ent['image']} or {ent['annotation']}")
return None, None, None, 0
# Resize image and mask
r = np.min([1024 / Img.shape[1], 1024 / Img.shape[0]]) # Scaling factor
Img = cv2.resize(Img, (int(Img.shape[1] * r), int(Img.shape[0] * r)))
ann_map = cv2.resize(ann_map, (int(ann_map.shape[1] * r), int(ann_map.shape[0] * r)), interpolation=cv2.INTER_NEAREST)
2. Bölütleme maskelerinin ikilileştirilmesi: Çok sınıflı açıklama maskesi (farklı piksel değerleriyle birden fazla nesne sınıfı etiketlenmiş olabilir) ikili bir maske haline getirilir. Bu maske, görüntüdeki tüm ilgi bölgelerini vurgular ve bölütleme görevini nesneye karşı arka plan olacak şekilde ikili bir sınıflandırma problemine indirger. Ardından ikili maske 5x5 çekirdek kullanılarak aşındırılır.
Aşındırma işlemi maskenin boyutunu biraz küçültür; bu da nokta seçerken sınır etkilerinden kaçınmaya yardımcı olur. Böylece seçilen noktalar, gürültülü veya belirsiz olabilecek kenarlara yakın olmak yerine nesnenin iç kısımlarında yer alır.
Erozyona uğratılmış maskenin içinden kilit noktalar seçilir. Bu noktalar, ince ayar süreci sırasında modelin dikkatini nereye yönlendireceğine dair ipuçları olarak hizmet eder. Noktalar, sınır gürültüsünden etkilenmemeleri için nesnelerin içinden rastgele seçilir.
### Continuation of read_batch() ###
# Initialize a single binary mask
binary_mask = np.zeros_like(ann_map, dtype=np.uint8)
points = []
# Get binary masks and combine them into a single mask
inds = np.unique(ann_map)[1:] # Skip the background (index 0)
for ind in inds:
mask = (ann_map == ind).astype(np.uint8) # Create binary mask for each unique index
binary_mask = np.maximum(binary_mask, mask) # Combine with the existing binary mask
# Erode the combined binary mask to avoid boundary points
eroded_mask = cv2.erode(binary_mask, np.ones((5, 5), np.uint8), iterations=1)
# Get all coordinates inside the eroded mask and choose a random point
coords = np.argwhere(eroded_mask > 0)
if len(coords) > 0:
for _ in inds: # Select as many points as there are unique labels
yx = np.array(coords[np.random.randint(len(coords))])
points.append([yx[1], yx[0]])
points = np.array(points)
3. Görselleştirme: Bu adım, ön işleme adımlarının doğru şekilde uygulandığını doğrulamak için kritik önemdedir. Noktaları ikilileştirilmiş maske üzerinde görsel olarak inceleyerek, modelin eğitim sırasında uygun girdi alacağından emin olabilirsiniz. Son olarak ikili maske doğru biçimde yeniden şekillendirilir (modele uygun boyutlarla) ve noktalar da eğitim sürecinde kullanılmak üzere yeniden şekillendirilir. Fonksiyon, işlenmiş görüntüyü, ikili maskeyi, seçilen noktaları ve bulunan maske sayısını döndürür.
### Continuation of read_batch() ###
if visualize_data:
# Plotting the images and points
plt.figure(figsize=(15, 5))
# Original Image
plt.subplot(1, 3, 1)
plt.title('Original Image')
plt.imshow(img)
plt.axis('off')
# Segmentation Mask (binary_mask)
plt.subplot(1, 3, 2)
plt.title('Binarized Mask')
plt.imshow(binary_mask, cmap='gray')
plt.axis('off')
# Mask with Points in Different Colors
plt.subplot(1, 3, 3)
plt.title('Binarized Mask with Points')
plt.imshow(binary_mask, cmap='gray')
# Plot points in different colors
colors = list(mcolors.TABLEAU_COLORS.values())
for i, point in enumerate(points):
plt.scatter(point[0], point[1], c=colors[i % len(colors)], s=100, label=f'Point {i+1}') # Corrected to plot y, x order
# plt.legend()
plt.axis('off')
plt.tight_layout()
plt.show()
binary_mask = np.expand_dims(binary_mask, axis=-1) # Now shape is (1024, 1024, 1)
binary_mask = binary_mask.transpose((2, 0, 1))
points = np.expand_dims(points, axis=1)
# Return the image, binarized mask, points, and number of masks
return img, binary_mask, points, len(inds)
# Visualize the data
Img1, masks1, points1, num_masks = read_batch(train_data, visualize_data=True)
Yukarıdaki kod, veri kümesinden orijinal görüntüyü, ikilileştirilmiş maskeyi ve noktalı ikilileştirilmiş maskeyi içeren aşağıdaki çıktıyı üretir.
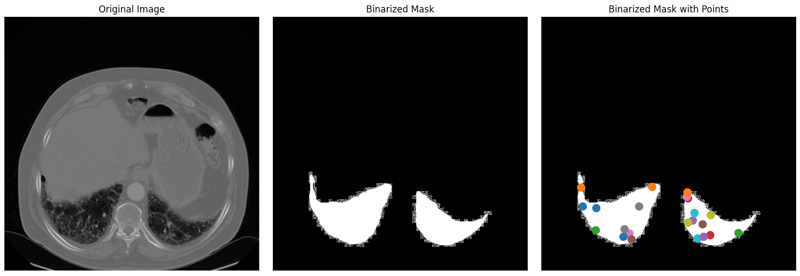
Veri kümesi için orijinal görüntü, ikilileştirilmiş maske ve noktalı ikilileştirilmiş maske.
Adım 5: SAM2 modeline ince ayar
SAM2 modeline ince ayar yapmak; modeli yüklemeyi, eniyileyiciyi ve zamanlayıcıyı kurmayı ve eğitim verilerine dayalı olarak model ağırlıklarını yinelemeli olarak güncellemeyi içerir.
Model kontrol noktalarını yükleyin:
sam2_checkpoint = "sam2_hiera_small.pt" # @param ["sam2_hiera_tiny.pt", "sam2_hiera_small.pt", "sam2_hiera_base_plus.pt", "sam2_hiera_large.pt"]
model_cfg = "sam2_hiera_s.yaml" # @param ["sam2_hiera_t.yaml", "sam2_hiera_s.yaml", "sam2_hiera_b+.yaml", "sam2_hiera_l.yaml"]
sam2_model = build_sam2(model_cfg, sam2_checkpoint, device="cuda")
predictor = SAM2ImagePredictor(sam2_model)
Eğitimli kontrol noktalarını kullanarak SAM2 modelini oluşturarak başlıyoruz. Model daha sonra, görüntüleri ayarlamayı, istemleri kodlamayı ve maskeleri çözmeyi basitleştiren bir tahminci sınıfına sarılır.
Hiperparametreleri yapılandırın
Modelin etkili bir şekilde öğrenmesini sağlamak için öğrenme oranı, ağırlık çürümesi ve gradyan biriktirme adımları gibi çeşitli hiperparametreleri yapılandırıyoruz. Bu hiperparametreler, modelin ağırlıkları ne hızla güncellediğini ve aşırı uyumdan nasıl kaçındığını da içeren öğrenme sürecini kontrol eder. Bunlarla oynamaktan çekinmeyin.
# Train mask decoder.
predictor.model.sam_mask_decoder.train(True)
# Train prompt encoder.
predictor.model.sam_prompt_encoder.train(True)
# Configure optimizer.
optimizer=torch.optim.AdamW(params=predictor.model.parameters(),lr=0.0001,weight_decay=1e-4) #1e-5, weight_decay = 4e-5
# Mix precision.
scaler = torch.cuda.amp.GradScaler()
# No. of steps to train the model.
NO_OF_STEPS = 3000 # @param
# Fine-tuned model name.
FINE_TUNED_MODEL_NAME = "fine_tuned_sam2"
Eniyileyici, model ağırlıklarını güncellemekten sorumludur; zamanlayıcı ise eğitim sırasında öğrenme oranını ayarlayarak yakınsamayı iyileştirir. Bu parametreleri dikkatlice ayarlayarak daha iyi bölütleme doğruluğu elde edebiliriz.
Eğitimi başlatın
Gerçek ince ayar süreci yinelemelidir; her adımda yalnızca akciğerlere ait bir görüntü ve maske yığını modelden geçirilir, kayıp hesaplanır ve model ağırlıklarını güncellemek için kullanılır.
# Initialize scheduler
scheduler = torch.optim.lr_scheduler.StepLR(optimizer, step_size=500, gamma=0.2) # 500 , 250, gamma = 0.1
accumulation_steps = 4 # Number of steps to accumulate gradients before updating
for step in range(1, NO_OF_STEPS + 1):
with torch.cuda.amp.autocast():
image, mask, input_point, num_masks = read_batch(train_data, visualize_data=False)
if image is None or mask is None or num_masks == 0:
continue
input_label = np.ones((num_masks, 1))
if not isinstance(input_point, np.ndarray) or not isinstance(input_label, np.ndarray):
continue
if input_point.size == 0 or input_label.size == 0:
continue
predictor.set_image(image)
mask_input, unnorm_coords, labels, unnorm_box = predictor._prep_prompts(input_point, input_label, box=None, mask_logits=None, normalize_coords=True)
if unnorm_coords is None or labels is None or unnorm_coords.shape[0] == 0 or labels.shape[0] == 0:
continue
sparse_embeddings, dense_embeddings = predictor.model.sam_prompt_encoder(
points=(unnorm_coords, labels), boxes=None, masks=None,
)
batched_mode = unnorm_coords.shape[0] > 1
high_res_features = [feat_level[-1].unsqueeze(0) for feat_level in predictor._features["high_res_feats"]]
low_res_masks, prd_scores, _, _ = predictor.model.sam_mask_decoder(
image_embeddings=predictor._features["image_embed"][-1].unsqueeze(0),
image_pe=predictor.model.sam_prompt_encoder.get_dense_pe(),
sparse_prompt_embeddings=sparse_embeddings,
dense_prompt_embeddings=dense_embeddings,
multimask_output=True,
repeat_image=batched_mode,
high_res_features=high_res_features,
)
prd_masks = predictor._transforms.postprocess_masks(low_res_masks, predictor._orig_hw[-1])
gt_mask = torch.tensor(mask.astype(np.float32)).cuda()
prd_mask = torch.sigmoid(prd_masks[:, 0])
seg_loss = (-gt_mask * torch.log(prd_mask + 0.000001) - (1 - gt_mask) * torch.log((1 - prd_mask) + 0.00001)).mean()
inter = (gt_mask * (prd_mask > 0.5)).sum(1).sum(1)
iou = inter / (gt_mask.sum(1).sum(1) + (prd_mask > 0.5).sum(1).sum(1) - inter)
score_loss = torch.abs(prd_scores[:, 0] - iou).mean()
loss = seg_loss + score_loss * 0.05
# Apply gradient accumulation
loss = loss / accumulation_steps
scaler.scale(loss).backward()
# Clip gradients
torch.nn.utils.clip_grad_norm_(predictor.model.parameters(), max_norm=1.0)
if step % accumulation_steps == 0:
scaler.step(optimizer)
scaler.update()
predictor.model.zero_grad()
# Update scheduler
scheduler.step()
if step % 500 == 0:
FINE_TUNED_MODEL = FINE_TUNED_MODEL_NAME + "_" + str(step) + ".torch"
torch.save(predictor.model.state_dict(), FINE_TUNED_MODEL)
if step == 1:
mean_iou = 0
mean_iou = mean_iou * 0.99 + 0.01 * np.mean(iou.cpu().detach().numpy())
if step % 100 == 0:
print("Step " + str(step) + ":\t", "Accuracy (IoU) = ", mean_iou)
Her yinelemede model bir görüntü yığınını işler, bölütleme maskelerini üretir ve kaybı hesaplamak için bunları gerçek değerle karşılaştırır. Bu kayıp, model ağırlıklarını ayarlamak için kullanılır ve modelin performansı kademeli olarak iyileşir. Yaklaşık 3000 epoch eğitimden sonra yaklaşık %72 doğruluk (IoU - Kesişim/Birleşim) elde edilir.
Adım 6: İnce ayarlı modelle çıkarım
Model daha sonra, yeni ve görülmemiş görüntüler üzerinde bölütleme maskeleri tahmin etmek için çıkarımda kullanılabilir. Çıkarım görüntüsünü ve anahtar noktalarıyla birlikte maskesini almak için read_images ve get_points yardımcı işlevleriyle başlayın.
def read_image(image_path, mask_path): # read and resize image and mask
img = cv2.imread(image_path)[..., ::-1] # Convert BGR to RGB
mask = cv2.imread(mask_path, 0)
r = np.min([1024 / img.shape[1], 1024 / img.shape[0]])
img = cv2.resize(img, (int(img.shape[1] * r), int(img.shape[0] * r)))
mask = cv2.resize(mask, (int(mask.shape[1] * r), int(mask.shape[0] * r)), interpolation=cv2.INTER_NEAREST)
return img, mask
def get_points(mask, num_points): # Sample points inside the input mask
points = []
coords = np.argwhere(mask > 0)
for i in range(num_points):
yx = np.array(coords[np.random.randint(len(coords))])
points.append([[yx[1], yx[0]]])
return np.array(points)Ardından, çıkarım için örnek görüntüleri ve yeni ince ayarlı ağırlıkları yükleyin; çıkarım yaparken torch.no_grad() kullanın.
# Randomly select a test image from the test_data
selected_entry = random.choice(test_data)
image_path = selected_entry['image']
mask_path = selected_entry['annotation']
# Load the selected image and mask
image, mask = read_image(image_path, mask_path)
# Generate random points for the input
num_samples = 30 # Number of points per segment to sample
input_points = get_points(mask, num_samples)
# Load the fine-tuned model
FINE_TUNED_MODEL_WEIGHTS = "fine_tuned_sam2_1000.torch"
sam2_model = build_sam2(model_cfg, sam2_checkpoint, device="cuda")
# Build net and load weights
predictor = SAM2ImagePredictor(sam2_model)
predictor.model.load_state_dict(torch.load(FINE_TUNED_MODEL_WEIGHTS))
# Perform inference and predict masks
with torch.no_grad():
predictor.set_image(image)
masks, scores, logits = predictor.predict(
point_coords=input_points,
point_labels=np.ones([input_points.shape[0], 1])
)
# Process the predicted masks and sort by scores
np_masks = np.array(masks[:, 0])
np_scores = scores[:, 0]
sorted_masks = np_masks[np.argsort(np_scores)][::-1]
# Initialize segmentation map and occupancy mask
seg_map = np.zeros_like(sorted_masks[0], dtype=np.uint8)
occupancy_mask = np.zeros_like(sorted_masks[0], dtype=bool)
# Combine masks to create the final segmentation map
for i in range(sorted_masks.shape[0]):
mask = sorted_masks[i]
if (mask * occupancy_mask).sum() / mask.sum() > 0.15:
continue
mask_bool = mask.astype(bool)
mask_bool[occupancy_mask] = False # Set overlapping areas to False in the mask
seg_map[mask_bool] = i + 1 # Use boolean mask to index seg_map
occupancy_mask[mask_bool] = True # Update occupancy_mask
# Visualization: Show the original image, mask, and final segmentation side by side
plt.figure(figsize=(18, 6))
plt.subplot(1, 3, 1)
plt.title('Test Image')
plt.imshow(image)
plt.axis('off')
plt.subplot(1, 3, 2)
plt.title('Original Mask')
plt.imshow(mask, cmap='gray')
plt.axis('off')
plt.subplot(1, 3, 3)
plt.title('Final Segmentation')
plt.imshow(seg_map, cmap='jet')
plt.axis('off')
plt.tight_layout()
plt.show()Bu adımda, test görüntüleri için bölütleme maskeleri üretmek üzere ince ayarlı modeli kullanıyoruz. Tahmin edilen maskeler, modelin performansını değerlendirmek için orijinal görüntüler ve gerçek maskelerle yan yana görselleştirilir.
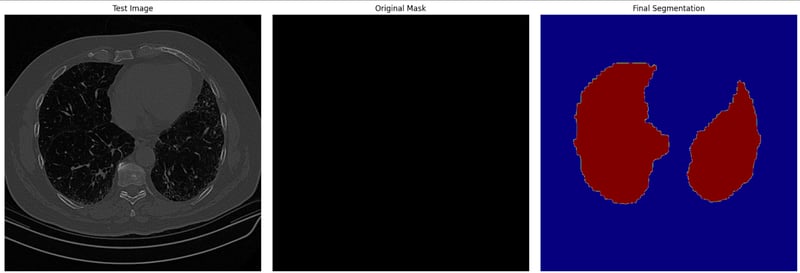
Test verisinde nihai bölütleme görüntüsü
Sonuç
SAM2'ye ince ayar yapmak, belirli görevlerde yeteneklerini artırmanın pratik bir yolunu sunar. İster tıbbi görüntüleme, ister otonom araçlar ya da video düzenleme üzerinde çalışın, ince ayar SAM2'yi benzersiz ihtiyaçlarınıza göre kullanmanıza olanak tanır. Bu rehberi izleyerek SAM2'yi projelerinize uyarlayabilir ve son teknoloji bölütleme sonuçlarına ulaşabilirsiniz.
Daha gelişmiş kullanım durumları için, görüntü kodlayıcı gibi SAM2'nin ek bileşenlerine de ince ayar yapmayı düşünebilirsiniz. Daha fazla kaynak gerektirse de bu, daha büyük esneklik ve performans iyileştirmeleri sunar.

ML (Üretken Yapay Zekâ) alanında Google Developers Uzmanıyım, Kaggle 3x Expert unvanına sahibim ve 3+ yıllık teknoloji deneyimiyle Women Techmakers Elçisiyim. 2020'de bir sağlık teknolojileri girişiminin kurucu ortağı oldum ve Georgia Tech'te makine öğrenmesi alanında uzmanlaşarak bilgisayar bilimleri yüksek lisansı yapıyorum.



Meta'nın Segment Anything Model 2 (SAM 2), gerçek zamanlı olarak hem görüntülerde hem de videolarda nesneleri bölütleyebilen ilk birleşik modeliydi. O zamandan beri yerini SAM3 aldı; bununla ilgili bilgileri SAM3 eğitimimizde bulabilirsiniz.
Peki, eğer SAM 2 zaten her şeyi bölütleyebiliyorsa neden ince ayar yapalım?
SAM 2, kutudan çıktığı haliyle güçlü olsa da, nadir veya alanına özgü görevlerde performansı her zaman beklentileri karşılamayabilir. İnce ayar, SAM2'yi özel ihtiyaçlarınıza uyarlamanıza olanak tanır ve belirli kullanım senaryonuz için doğruluğunu ve verimliliğini artırır.
Bu yazıda, SAM 2'nin ince ayar sürecini adım adım anlatacağım.