注意力机制是Transformer 模型的核心。几乎所有流行的模型架构,如GPT、LLaMA和Mixture of Experts(MoE),都依赖它来连接 token 并构建语义。
但注意力的代价很高。它的计算涉及大型矩阵乘法,更重要的是在 GPU 内存与计算单元之间的大规模数据搬运。随着序列长度增长,内存带宽就会成为真正的瓶颈。
因此,优化注意力机制会对LLM 性能产生远超比例的影响,而这正是 Flash Attention 大显身手之处。本文将带您了解什么是 Flash Attention、它的工作原理,以及如何在 PyTorch 与 Hugging Face Transformers 中使用它。
如果您想入门大语言模型,推荐先学习我们的LLM 概念入门课程。
什么是 Flash Attention?
Flash Attention 是一种经过优化的 Transformer注意力机制,使其在 GPU 上显著更快、更省内存。
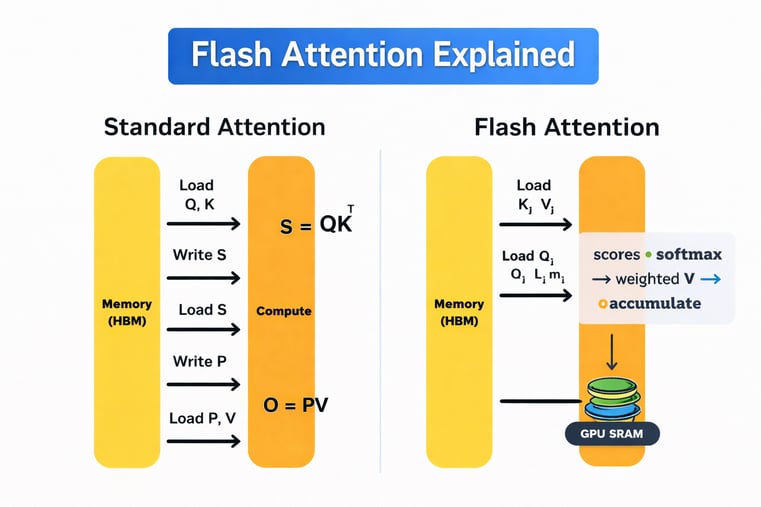
标准注意力 vs Flash Attention
GPU 主要有两类内存。高带宽内存(HBM)容量大但相对较慢;芯片上的 SRAM 极快但容量非常有限。
标准自注意力在二者之间不断搬运数据。这种往返代价高昂,且序列越长成本越显著。
Flash Attention 通过以适配快速 SRAM 的小分块来计算注意力,从而避免这一点。每个分块都会端到端处理,并以增量方式应用 softmax,因此无需将中间结果写回 HBM。也就是说,完整的注意力矩阵从未被存入内存。
与稀疏或线性注意力方法不同,Flash Attention 不是近似法。它与标准自注意力在数学上产出完全一致,只是以更高的内存效率来执行。
Flash Attention 的工作原理
Flash Attention 通过重新设计 GPU 上的注意力计算方式来实现高效。其机制很简单:尽可能在快速的片上内存中完成更多工作,并避免不必要地访问慢速内存。
一个形象的比喻是厨房。GPU 的片上 SRAM 就像一个小而快的料理台,真正在上面备料与烹饪;GPU 的高带宽内存(HBM)更像街角的大超市,能存放一切所需,但来回奔波很费时间。
简单说,标准注意力就像每做一步都要跑去超市;而 Flash Attention 则把烹饪计划好,让所有东西在烹饪时都能摆在料理台上。我们来详细看看:
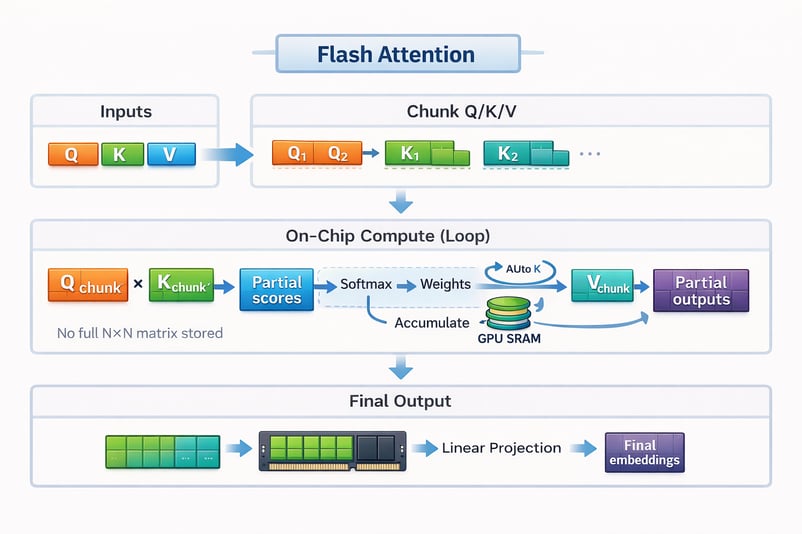
Flash Attention 的工作机制
Flash Attention 依赖两个关键思想:分块(tiling)与重计算(recomputation)。
分块(Tiling)
延续厨房的比喻,分块就是 Flash Attention 如何把注意力计算装进小料理台的方法。
Flash Attention 不会一次性载入整个序列并构建完整的注意力矩阵,而是把输入拆分成小块(tile)。每个分块都能完全放进 GPU 的快速 SRAM 内。Flash Attention 按分块逐一计算注意力,从头到尾处理完一个分块再进入下一个。
对应到厨房,您无法把整场宴席的食材都堆在小料理台上,于是就分批准备与烹饪:先切一批菜,炒好,清理台面,再处理下一批。这样就不必总是往返超市。
这种按块执行的方式让 Flash Attention 保持数据局部、快速且高效,而无需在慢速内存中物化完整注意力矩阵。
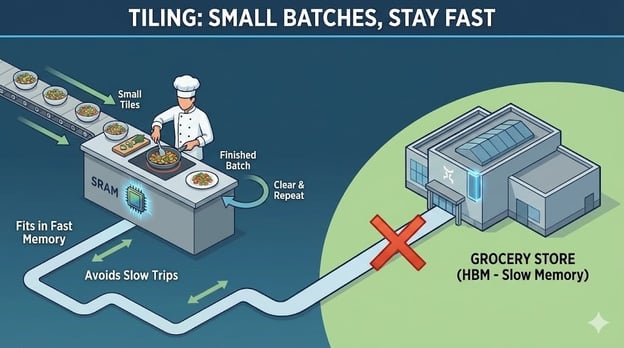
Flash Attention 中的分块
重计算(Recomputation)
在训练中,标准注意力会存储大量中间结果,以便在反向传播时复用,但这会带来很高的内存成本。Flash Attention 采取不同做法:不存这些中间量,而是在需要时对注意力分数的小部分进行重算。
回到厨房,比方说切洋葱。您可以把切好的洋葱带到超市去存着,等用时再取回来;或者直接扔掉,用到时再现切一个。令人意外的是,后者更快,因为避免了频繁且更久的往返。
在现代 GPU 上,重计算也遵循相同逻辑:相比内存搬运,额外计算更便宜。通过重算小量数值而非存取它们,Flash Attention 大幅减少了内存流量,同时保持训练效率。
分块与重计算相结合,让 Flash Attention 能把注意力计算留在“料理台”上,尽量少“跑超市”,并充分发挥现代 GPU 硬件的优势。
Flash Attention 2
Flash Attention 2(FA2)于 2023 年发布,相较第一代是一次重大升级。它延续了“IO 感知、精确注意力”的核心理念,但在多项与真实工作负载相关的维度上提升了效率。
跨序列长度的并行
第一版 Flash Attention 主要在批大小与注意力头上做并行,这对大批量训练很有效,但对推理就不那么理想,因为推理往往批量小、序列长。
FA2 新增了沿序列长度维度本身的并行。即便批量很小,也能让更多注意力计算的部分同时运行。通过把工作分摊到序列中的各个 token,v2 能让更多 GPU 计算单元同时保持忙碌。
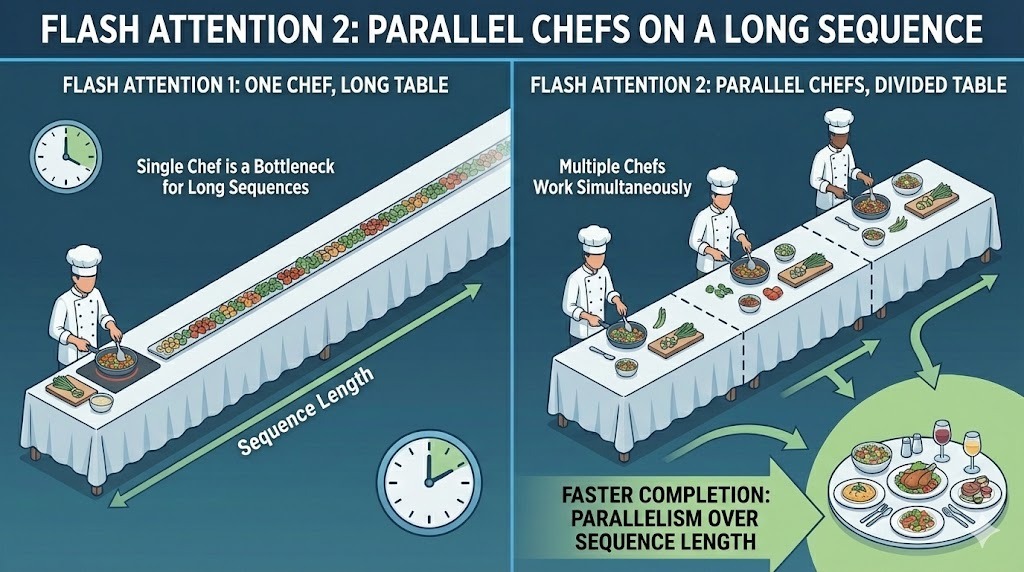
Flash Attention 2 中跨批处理的并行
在常见的推理场景中(长提示、小批量),其实际收益是更高的吞吐与更好的硬件利用率。
减少非矩阵运算
GPU 非常擅长矩阵乘法。称为 Tensor Cores 的专用硬件可以以极高速度执行通用矩阵乘法(GEMM)。
问题在于,注意力不只是矩阵乘法:它包含缩放、掩码与 softmax 等操作,这些运行在标准 GPU 核心上,相比之下要慢得多。
FA2 降低了这种失衡。它重构计算流程,尽量减少非矩阵浮点运算,尤其是与注意力分数重缩放相关的部分。多数运行时间都花在大型、高效、可由 Tensor Cores 加速的矩阵运算中。
支持更大的头维度
Flash Attention v1 主要针对 64 或 128 的头维度优化,这与 BERT、GPT-3 等模型相匹配。随着架构演进,头维度变大以支持更大的嵌入尺寸和更高的模型容量。
FA2 将支持扩展到最高 256 的头维度,从而兼容依赖更宽注意力头的新架构。
Flash Attention 3
Flash Attention 3(FA3)是当前业界标准,为GPT-5.2等最前沿模型提供动力。它延续前代“IO 感知、精确注意力”的基础,但专为 NVIDIA H100(Hopper)GPU 构建。
关键变化在于,FA3 旨在充分利用 Hopper 的新型异步硬件特性,使内存搬运与计算的重叠远比以往更激进。
Warp 专用化(Warp Specialization)
早期版本中,所有 GPU 线程(称为 warp)都遵循相同的执行路径。FA3 通过 warp 专用化改变了这一模式:为每个 warp 指定两种不同角色之一:
- 生产者:从内存加载数据
- 消费者:执行实际的注意力计算
这种分工使数据传输与计算能够同时进行。当生产者 warp 抓取下一块数据时,消费者 warp 持续对当前分块进行计算,显著降低延迟。
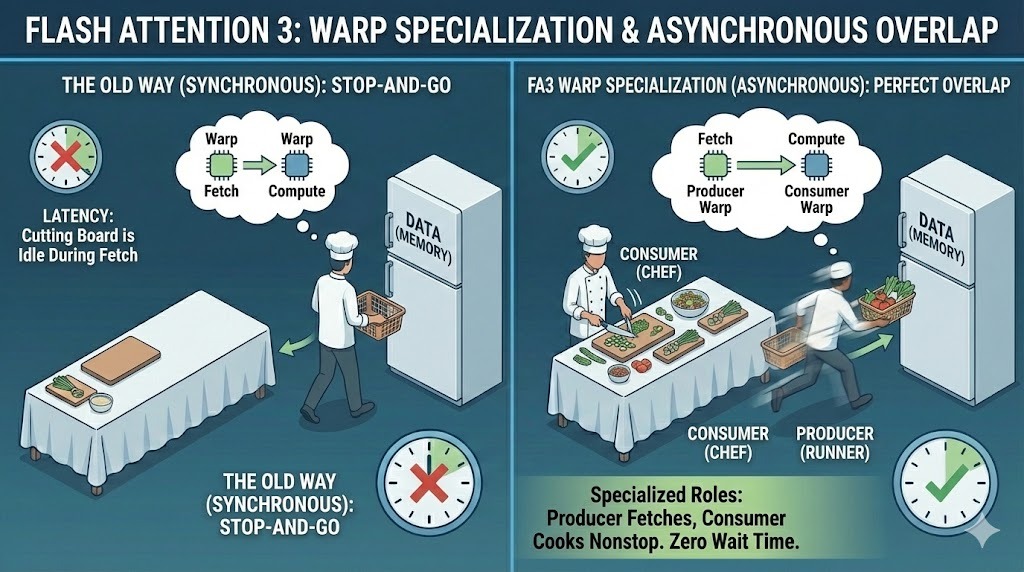
Flash Attention 3 中的 Warp 专用化
原生 FP8 精度
Flash Attention 3 还引入了对 FP8(8 位浮点精度)的原生支持。此前版本主要依赖 FP16 或 BF16,相比 FP32 已经降低了内存使用,但带宽消耗仍不小。
FP8 进一步将内存占用约减半。这种缩减直接转化为更高吞吐与更低内存压力。在 Hopper GPU 上,FP8 由硬件加速,这意味着 FA3 能在不牺牲模型层面精度的情况下,每秒处理更多注意力运算。
这一能力是大型模型(例如Gemini 3)能够在高效服务数百万用户的同时处理超大上下文窗口的主要原因之一。
硬件加速的重叠
FA3 设计的最后一环是利用 H100 的 Tensor Memory Accelerator(TMA)。TMA 是专门负责内存拷贝的硬件,能以异步方式工作,而不占用主要计算核心。
Flash Attention 3 使用 TMA 在后台搬运数据分块,同时不中断前台计算。通过紧密重叠内存搬运与数学计算,FA3 能接近发挥硬件理论峰值性能的约 75%。
Flash Attention 4 及未来
Flash Attention 4(FA4)代表注意力优化的下一步探索。它面向 NVIDIA 即将推出的 Blackwell B200 GPU,探究当注意力内核为全新硬件类别而生时能实现什么。
随着模型规模持续增长、训练迈向万亿参数级别,即便是 Flash Attention 3 终将触及极限。FA4 早期尝试通过将硬件利用率推至前所未有的高度,来打破这些限制。
目前,Flash Attention 4 仍处于研究与预生产阶段,展现出强大潜力,但尚未用于已部署或生产级模型。
突破 PetaFLOPS 门槛
Flash Attention 4 的一大里程碑是性能:它是首个旨在在单块 GPU 上超过 1 PFLOPS(每秒一千万亿次浮点运算)的注意力内核。
它面向的未来是:训练万亿参数模型需要不切实际的时间。在那一规模下,哪怕小小的低效也会累积为巨大的延迟。FA4 旨在从单芯片中榨取极致性能,使这类未来训练成为可能。
大规模异步
为实现该性能,FA4 将异步推进到远超先前版本的程度。它把生产者-消费者模型扩展为高度复杂的多阶段流水线,使数据搬运、计算与同步都能各自独立运行。
FA4 不再只是简单地让加载与计算重叠,而是管理跨多阶段的深度异步执行。内核的不同部分以不同速度推进,由硬件级调度协调,而非单一的同步流程。
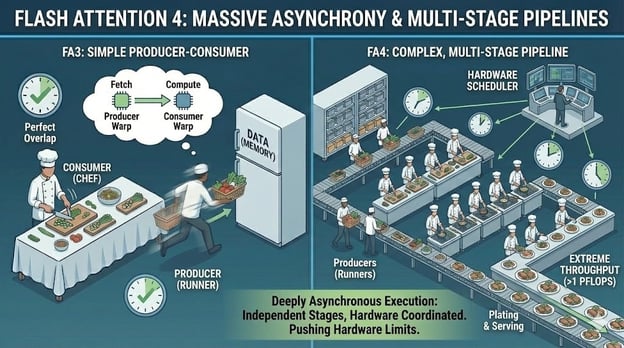
Flash Attention 4 中的大规模异步
这也正是 FA4 仍属实验性的原因:在这种复杂度下保障准确性、稳定性与集成性充满挑战。社区仍需更多工作,才能让团队把它可靠地用于大型生产模型。
Flash Attention 与标准注意力的对比
我们从几个关键方面对比 Flash Attention 与标准注意力机制。
速度
基准测试一致显示,所有版本的 Flash Attention 都优于标准自注意力,且序列越长,收益越大。
根据最初的 Flash Attention 论文报告,较优化后的标准注意力可获得约 2–4× 的加速;Flash Attention 2 通过提升并行度与更好地“喂满”GPU,实践中往往还能再带来约 ~2× 的提升。
在 Hopper GPU 上,尤其结合 FP8,Flash Attention 3 将性能推得更高,硬件利用率远超标准注意力所能达到的水平。
内存
标准注意力会显式物化完整的 N × N 注意力矩阵,导致内存随序列长度呈平方增长。随着 N 增长,内存使用暴涨,很快就会压垮 GPU 内存;Flash Attention 则完全避免存储该矩阵。
通过以分块计算注意力并将中间结果保存在快速片上内存中,它把内存使用在固定头维度下降为与序列长度线性相关。这种从平方到线性的转变,移除了标准注意力中最大的结构性瓶颈。
上下文长度
内存的缩减直接让更长的上下文窗口成为可能。使用标准注意力时,序列达到几千 token 往往就会 OOM。
Flash Attention 让单卡上 4k、8k token 的上下文变得切实可行,结合其他省内存技术,甚至可以把窗口拓展到 16k 或 32k。
需要注意:部分前沿模型(如Gemini 3)实现的百万 token 级窗口,是通过在大规模 GPU 集群间切分序列来完成的,远超任一单卡的内存容量。
如何使用 Flash Attention
如今使用 Flash Attention 比过去简单得多。多数情况下,您无需编写自定义 CUDA 内核或更改模型架构,这些支持已内置于流行工具之中。
PyTorch 集成
自PyTorch 2.0 起,可直接通过 torch.nn.functional.scaled_dot_product_attention 使用 Flash Attention。调用该函数时,PyTorch 会根据您的硬件自动选择最快的注意力后端。
在受支持的 GPU 上,这一后端就是 Flash Attention。对用户而言,代码看起来与标准注意力类似,但底层由 PyTorch 派发到优化过的 Flash Attention 内核。
如果您使用Hugging Face Transformers,启用 Flash Attention 通常只需一行配置。在模型配置中设置 attn_implementation="flash_attention_2",即可在可用处使用 Flash Attention 2。
对许多 Transformer 模型而言,仅此即可在无需改动其余训练或推理代码的情况下获得速度与内存的双重收益。
硬件要求
Flash Attention 2 面向现代 NVIDIA GPU,在 Ampere、Ada 与 Hopper 架构(包括 A100、RTX 3090、RTX 4090 与 H100)上表现最佳。这些 GPU 提供了充分的内存带宽与架构特性,能充分受益于 FA2 的分块与并行。
同样值得一提的是,最初的 Flash Attention v1 也支持更老的 GPU。像基于 Turing 的 T4、RTX 2080 仍可使用 v1,尽管解锁新版本的全部性能提升需要更近代的硬件。
实践中,如果您已在现代 NVIDIA GPU 上使用 PyTorch 2.x 或 Hugging Face Transformers,启用 Flash Attention 往往只是一个配置开关的事。
结语
标准注意力受制于内存平方增长,对长序列变得缓慢、昂贵,甚至因 OOM 而无法运行。Flash Attention 通过重构注意力的执行方式改变了这一点。
把内存使用从随序列长度平方增长降到线性增长后,Flash Attention 让长上下文建模变得切实可行。过去在几千 token 上就压垮 GPU 的上下文,如今在同样硬件上可扩展到 4k、8k,甚至 32k+ token。
如果您在大规模使用 Transformer 却还未采用 Flash Attention,几乎可以肯定是在“把性能留在桌面上”。
想亲手构建能使用 Flash Attention 的模型吗?来参加我们的PyTorch Transformer 模型课程!


注意力机制是Transformer 模型的核心。几乎所有流行的模型架构,如GPT、LLaMA和Mixture of Experts(MoE),都依赖它来连接 token 并构建语义。
但注意力的代价很高。它的计算涉及大型矩阵乘法,更重要的是在 GPU 内存与计算单元之间的大规模数据搬运。随着序列长度增长,内存带宽就会成为真正的瓶颈。
因此,优化注意力机制会对LLM 性能产生远超比例的影响,而这正是 Flash Attention 大显身手之处。本文将带您了解什么是 Flash Attention、它的工作原理,以及如何在 PyTorch 与 Hugging Face Transformers 中使用它。
如果您想入门大语言模型,推荐先学习我们的LLM 概念入门课程。
什么是 Flash Attention?
Flash Attention 是一种经过优化的 Transformer注意力机制,使其在 GPU 上显著更快、更省内存。
标准注意力 vs Flash Attention
GPU 主要有两类内存。高带宽内存(HBM)容量大但相对较慢;芯片上的 SRAM 极快但容量非常有限。
标准自注意力在二者之间不断搬运数据。这种往返代价高昂,且序列越长成本越显著。
Flash Attention 通过以适配快速 SRAM 的小分块来计算注意力,从而避免这一点。每个分块都会端到端处理,并以增量方式应用 softmax,因此无需将中间结果写回 HBM。也就是说,完整的注意力矩阵从未被存入内存。
与稀疏或线性注意力方法不同,Flash Attention 不是近似法。它与标准自注意力在数学上产出完全一致,只是以更高的内存效率来执行。
Flash Attention 的工作原理
Flash Attention 通过重新设计 GPU 上的注意力计算方式来实现高效。其机制很简单:尽可能在快速的片上内存中完成更多工作,并避免不必要地访问慢速内存。
一个形象的比喻是厨房。GPU 的片上 SRAM 就像一个小而快的料理台,真正在上面备料与烹饪;GPU 的高带宽内存(HBM)更像街角的大超市,能存放一切所需,但来回奔波很费时间。
简单说,标准注意力就像每做一步都要跑去超市;而 Flash Attention 则把烹饪计划好,让所有东西在烹饪时都能摆在料理台上。我们来详细看看:
Flash Attention 的工作机制
Flash Attention 依赖两个关键思想:分块(tiling)与重计算(recomputation)。
分块(Tiling)
延续厨房的比喻,分块就是 Flash Attention 如何把注意力计算装进小料理台的方法。
Flash Attention 不会一次性载入整个序列并构建完整的注意力矩阵,而是把输入拆分成小块(tile)。每个分块都能完全放进 GPU 的快速 SRAM 内。Flash Attention 按分块逐一计算注意力,从头到尾处理完一个分块再进入下一个。
对应到厨房,您无法把整场宴席的食材都堆在小料理台上,于是就分批准备与烹饪:先切一批菜,炒好,清理台面,再处理下一批。这样就不必总是往返超市。
这种按块执行的方式让 Flash Attention 保持数据局部、快速且高效,而无需在慢速内存中物化完整注意力矩阵。
Flash Attention 中的分块
重计算(Recomputation)
在训练中,标准注意力会存储大量中间结果,以便在反向传播时复用,但这会带来很高的内存成本。Flash Attention 采取不同做法:不存这些中间量,而是在需要时对注意力分数的小部分进行重算。
回到厨房,比方说切洋葱。您可以把切好的洋葱带到超市去存着,等用时再取回来;或者直接扔掉,用到时再现切一个。令人意外的是,后者更快,因为避免了频繁且更久的往返。
在现代 GPU 上,重计算也遵循相同逻辑:相比内存搬运,额外计算更便宜。通过重算小量数值而非存取它们,Flash Attention 大幅减少了内存流量,同时保持训练效率。
分块与重计算相结合,让 Flash Attention 能把注意力计算留在“料理台”上,尽量少“跑超市”,并充分发挥现代 GPU 硬件的优势。
Flash Attention 2
Flash Attention 2(FA2)于 2023 年发布,相较第一代是一次重大升级。它延续了“IO 感知、精确注意力”的核心理念,但在多项与真实工作负载相关的维度上提升了效率。
跨序列长度的并行
第一版 Flash Attention 主要在批大小与注意力头上做并行,这对大批量训练很有效,但对推理就不那么理想,因为推理往往批量小、序列长。
FA2 新增了沿序列长度维度本身的并行。即便批量很小,也能让更多注意力计算的部分同时运行。通过把工作分摊到序列中的各个 token,v2 能让更多 GPU 计算单元同时保持忙碌。
Flash Attention 2 中跨批处理的并行
在常见的推理场景中(长提示、小批量),其实际收益是更高的吞吐与更好的硬件利用率。
减少非矩阵运算
GPU 非常擅长矩阵乘法。称为 Tensor Cores 的专用硬件可以以极高速度执行通用矩阵乘法(GEMM)。
问题在于,注意力不只是矩阵乘法:它包含缩放、掩码与 softmax 等操作,这些运行在标准 GPU 核心上,相比之下要慢得多。
FA2 降低了这种失衡。它重构计算流程,尽量减少非矩阵浮点运算,尤其是与注意力分数重缩放相关的部分。多数运行时间都花在大型、高效、可由 Tensor Cores 加速的矩阵运算中。
支持更大的头维度
Flash Attention v1 主要针对 64 或 128 的头维度优化,这与 BERT、GPT-3 等模型相匹配。随着架构演进,头维度变大以支持更大的嵌入尺寸和更高的模型容量。
FA2 将支持扩展到最高 256 的头维度,从而兼容依赖更宽注意力头的新架构。
Flash Attention 3
Flash Attention 3(FA3)是当前业界标准,为GPT-5.2等最前沿模型提供动力。它延续前代“IO 感知、精确注意力”的基础,但专为 NVIDIA H100(Hopper)GPU 构建。
关键变化在于,FA3 旨在充分利用 Hopper 的新型异步硬件特性,使内存搬运与计算的重叠远比以往更激进。
Warp 专用化(Warp Specialization)
早期版本中,所有 GPU 线程(称为 warp)都遵循相同的执行路径。FA3 通过 warp 专用化改变了这一模式:为每个 warp 指定两种不同角色之一:
这种分工使数据传输与计算能够同时进行。当生产者 warp 抓取下一块数据时,消费者 warp 持续对当前分块进行计算,显著降低延迟。
Flash Attention 3 中的 Warp 专用化
原生 FP8 精度
Flash Attention 3 还引入了对 FP8(8 位浮点精度)的原生支持。此前版本主要依赖 FP16 或 BF16,相比 FP32 已经降低了内存使用,但带宽消耗仍不小。
FP8 进一步将内存占用约减半。这种缩减直接转化为更高吞吐与更低内存压力。在 Hopper GPU 上,FP8 由硬件加速,这意味着 FA3 能在不牺牲模型层面精度的情况下,每秒处理更多注意力运算。
这一能力是大型模型(例如Gemini 3)能够在高效服务数百万用户的同时处理超大上下文窗口的主要原因之一。
硬件加速的重叠
FA3 设计的最后一环是利用 H100 的 Tensor Memory Accelerator(TMA)。TMA 是专门负责内存拷贝的硬件,能以异步方式工作,而不占用主要计算核心。
Flash Attention 3 使用 TMA 在后台搬运数据分块,同时不中断前台计算。通过紧密重叠内存搬运与数学计算,FA3 能接近发挥硬件理论峰值性能的约 75%。
Flash Attention 4 及未来
Flash Attention 4(FA4)代表注意力优化的下一步探索。它面向 NVIDIA 即将推出的 Blackwell B200 GPU,探究当注意力内核为全新硬件类别而生时能实现什么。
随着模型规模持续增长、训练迈向万亿参数级别,即便是 Flash Attention 3 终将触及极限。FA4 早期尝试通过将硬件利用率推至前所未有的高度,来打破这些限制。
目前,Flash Attention 4 仍处于研究与预生产阶段,展现出强大潜力,但尚未用于已部署或生产级模型。
突破 PetaFLOPS 门槛
Flash Attention 4 的一大里程碑是性能:它是首个旨在在单块 GPU 上超过 1 PFLOPS(每秒一千万亿次浮点运算)的注意力内核。
它面向的未来是:训练万亿参数模型需要不切实际的时间。在那一规模下,哪怕小小的低效也会累积为巨大的延迟。FA4 旨在从单芯片中榨取极致性能,使这类未来训练成为可能。
大规模异步
为实现该性能,FA4 将异步推进到远超先前版本的程度。它把生产者-消费者模型扩展为高度复杂的多阶段流水线,使数据搬运、计算与同步都能各自独立运行。
FA4 不再只是简单地让加载与计算重叠,而是管理跨多阶段的深度异步执行。内核的不同部分以不同速度推进,由硬件级调度协调,而非单一的同步流程。
Flash Attention 4 中的大规模异步
这也正是 FA4 仍属实验性的原因:在这种复杂度下保障准确性、稳定性与集成性充满挑战。社区仍需更多工作,才能让团队把它可靠地用于大型生产模型。
Flash Attention 与标准注意力的对比
我们从几个关键方面对比 Flash Attention 与标准注意力机制。
速度
基准测试一致显示,所有版本的 Flash Attention 都优于标准自注意力,且序列越长,收益越大。
根据最初的 Flash Attention 论文报告,较优化后的标准注意力可获得约 2–4× 的加速;Flash Attention 2 通过提升并行度与更好地“喂满”GPU,实践中往往还能再带来约 ~2× 的提升。
在 Hopper GPU 上,尤其结合 FP8,Flash Attention 3 将性能推得更高,硬件利用率远超标准注意力所能达到的水平。
内存
标准注意力会显式物化完整的 N × N 注意力矩阵,导致内存随序列长度呈平方增长。随着 N 增长,内存使用暴涨,很快就会压垮 GPU 内存;Flash Attention 则完全避免存储该矩阵。
通过以分块计算注意力并将中间结果保存在快速片上内存中,它把内存使用在固定头维度下降为与序列长度线性相关。这种从平方到线性的转变,移除了标准注意力中最大的结构性瓶颈。
上下文长度
内存的缩减直接让更长的上下文窗口成为可能。使用标准注意力时,序列达到几千 token 往往就会 OOM。
Flash Attention 让单卡上 4k、8k token 的上下文变得切实可行,结合其他省内存技术,甚至可以把窗口拓展到 16k 或 32k。
需要注意:部分前沿模型(如Gemini 3)实现的百万 token 级窗口,是通过在大规模 GPU 集群间切分序列来完成的,远超任一单卡的内存容量。
如何使用 Flash Attention
如今使用 Flash Attention 比过去简单得多。多数情况下,您无需编写自定义 CUDA 内核或更改模型架构,这些支持已内置于流行工具之中。
PyTorch 集成
自PyTorch 2.0 起,可直接通过
torch.nn.functional.scaled_dot_product_attention使用 Flash Attention。调用该函数时,PyTorch 会根据您的硬件自动选择最快的注意力后端。在受支持的 GPU 上,这一后端就是 Flash Attention。对用户而言,代码看起来与标准注意力类似,但底层由 PyTorch 派发到优化过的 Flash Attention 内核。
Hugging Face Transformers
如果您使用Hugging Face Transformers,启用 Flash Attention 通常只需一行配置。在模型配置中设置
attn_implementation="flash_attention_2",即可在可用处使用 Flash Attention 2。对许多 Transformer 模型而言,仅此即可在无需改动其余训练或推理代码的情况下获得速度与内存的双重收益。
硬件要求
Flash Attention 2 面向现代 NVIDIA GPU,在 Ampere、Ada 与 Hopper 架构(包括 A100、RTX 3090、RTX 4090 与 H100)上表现最佳。这些 GPU 提供了充分的内存带宽与架构特性,能充分受益于 FA2 的分块与并行。
同样值得一提的是,最初的 Flash Attention v1 也支持更老的 GPU。像基于 Turing 的 T4、RTX 2080 仍可使用 v1,尽管解锁新版本的全部性能提升需要更近代的硬件。
实践中,如果您已在现代 NVIDIA GPU 上使用 PyTorch 2.x 或 Hugging Face Transformers,启用 Flash Attention 往往只是一个配置开关的事。
结语
标准注意力受制于内存平方增长,对长序列变得缓慢、昂贵,甚至因 OOM 而无法运行。Flash Attention 通过重构注意力的执行方式改变了这一点。
把内存使用从随序列长度平方增长降到线性增长后,Flash Attention 让长上下文建模变得切实可行。过去在几千 token 上就压垮 GPU 的上下文,如今在同样硬件上可扩展到 4k、8k,甚至 32k+ token。
如果您在大规模使用 Transformer 却还未采用 Flash Attention,几乎可以肯定是在“把性能留在桌面上”。
想亲手构建能使用 Flash Attention 的模型吗?来参加我们的PyTorch Transformer 模型课程!