Dikkat (attention) mekanizması dönüştürücü (transformer) modellerin kalbinde yer alır. GPT, LLaMA ve Uzman Karışımı (MoE) gibi tüm popüler mimariler, belirteçleri (token) ilişkilendirip anlam kurmak için buna dayanır.
Ancak attention pahalıdır. Hesaplama, büyük matris çarpımlarını ve daha da önemlisi GPU belleği ile hesaplama birimleri arasında büyük veri hareketlerini içerir. Dizi (sequence) uzunlukları arttıkça gerçek darboğaz bellek bant genişliği olur.
Bu nedenle attention’ı optimize etmek, LLM performansı üzerinde orantısız bir etkiye sahiptir ve Flash Attention tam da burada devreye girer. Bu yazıda, Flash Attention’ın ne olduğunu, nasıl çalıştığını ve PyTorch ile Hugging Face Transformers’ta nasıl kullanacağınızı anlatacağım.
LLM’lere başlamanın bir yolunu arıyorsanız, LLM kavramları konulu giriş kursumuzu öneririm.
Flash Attention Nedir?
Flash Attention, GPU’larda dramatik biçimde daha hızlı ve daha bellek verimli çalışan, optimize edilmiş bir dönüştürücü attention mekanizmasıdır.
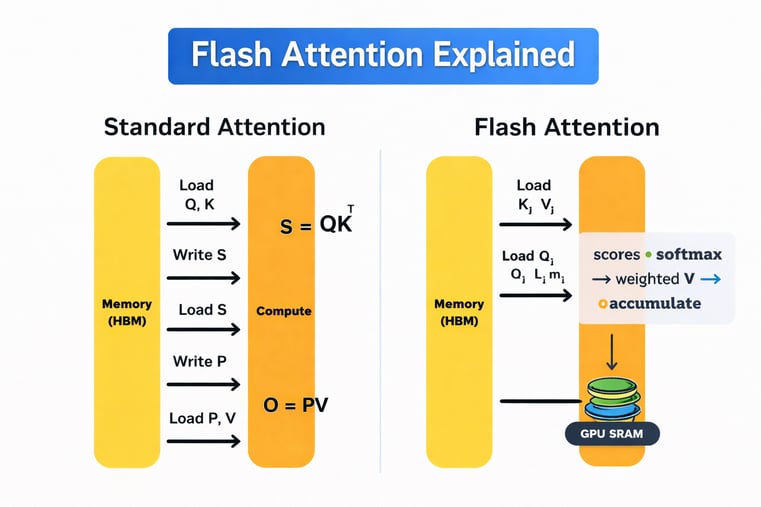
Standart attention ve Flash attention
GPU’larda iki ana bellek türü vardır. Yüksek bant genişlikli bellek (HBM) büyük ama nispeten yavaştır. Yonga üzerindeki SRAM son derece hızlıdır ancak boyut olarak çok sınırlıdır.
Standart öz-dikkat (self-attention) veriyi sürekli bu ikisi arasında taşır. Bu gidiş geliş maliyetlidir ve dizi uzunluğu arttıkça önemli bir maliyete dönüşür.
Flash Attention bunu, tamamen hızlı SRAM’e sığan küçük döşemeler (tile) halinde attention hesaplayarak önler. Her döşeme uçtan uca işlenir; softmax artımlı olarak uygulanır, böylece ara sonuçların HBM’ye geri yazılmasına gerek kalmaz. Bu nedenle, tam attention matrisi hiçbir zaman bellekte tutulmaz.
Seyrek (sparse) veya doğrusal attention yöntemlerinden farklı olarak Flash Attention bir yaklaşım (approximation) değildir. Standart öz-dikkat ile aynı matematiksel çıktıyı üretir; sadece daha bellek verimli bir şekilde yürütülür.
Flash Attention Nasıl Çalışır?
Flash Attention, GPU üzerinde attention’ı nasıl hesapladığını yeniden tasarlayarak verimliliğe ulaşır. Basit bir ilkeyi izler: mümkün olduğunca çok işi hızlı yonga içi bellekte yap ve yavaş belleğe gereksiz hareketlerden kaçın.
Bunu düşünmenin yararlı bir yolu mutfak benzetmesidir. GPU’nun yonga içi SRAM’i küçük, hızlı bir mutfak tezgâhı gibidir. Aslında hazırlık ve pişirme orada olur. GPU yüksek bant genişlikli bellek (HBM) ise sokağın aşağısındaki büyük bir market gibidir. İhtiyacınız olan her şeyi depolayabilir, ancak gidip gelmek zaman alır.
Kısacası, standart attention her adımdan sonra markete koşar. Buna karşılık Flash Attention, pişirme sırasında her şey tezgâha sığacak şekilde planlar. Bunu daha ayrıntılı anlayalım:
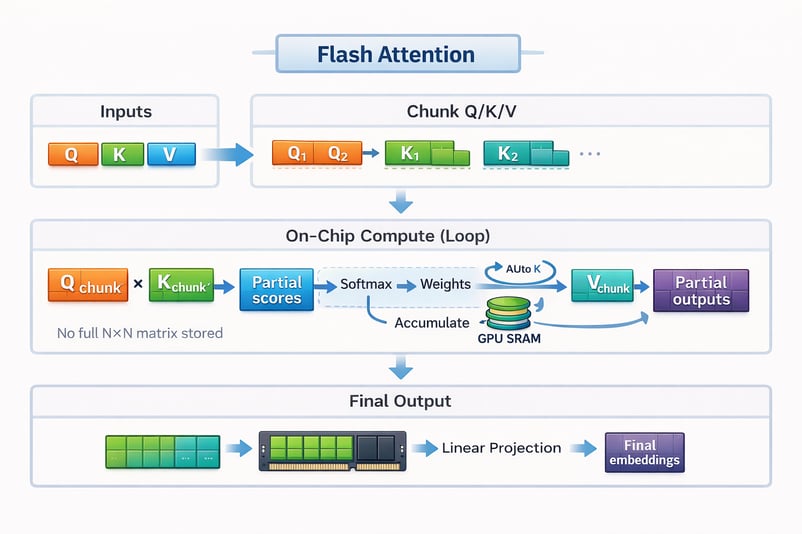
Flash Attention çalışma mekanizması
Flash Attention iki temel fikre dayanır: döşeme (tiling) ve yeniden hesaplama (recomputation).
Döşeme (Tiling)
Mutfak örneğimizde kalırsak, döşeme Flash Attention’ın attention hesaplamasını küçük tezgâha sığdırma yoludur.
Tüm diziyi yükleyip tam bir attention matrisi oluşturmak yerine Flash Attention girdileri küçük bloklara, yani döşemelere böler. Her döşeme tamamen GPU’nun hızlı SRAM’ine sığar. Flash Attention attention’ı her seferinde bir döşeme için, baştan sona hesaplar; ardından bir sonrakine geçer.
Mutfak benzetmesinde, küçük bir tezgâha tüm bir ziyafetin malzemelerini sığdıramazsınız. Bu yüzden küçük partiler halinde hazırlayıp pişirirsiniz. Biraz sebze doğrarsınız, pişirirsiniz, alanı temizler ve sonra bir sonraki partiye geçersiniz. Bu şekilde çalışarak sürekli markete gidip gelmekten kaçınırsınız.
Bu blok blok yürütme, Flash Attention’ın veriyi yerel, hızlı ve verimli tutmasını sağlar; tam attention matrisini yavaş bellekte hiçbir zaman malzemelemeden (materialize etmeden).
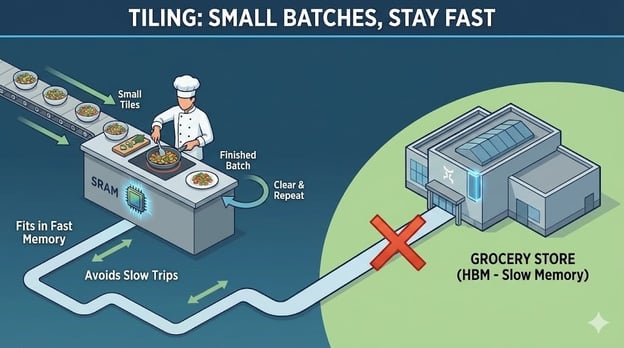
Flash Attention’da döşeme
Yeniden hesaplama (Recomputation)
Eğitim sırasında, standart attention geri yayılımda kullanılmak üzere büyük ara sonuçları saklar. Bu saklama yüksek bir bellek maliyeti getirir. Flash Attention farklı bir yaklaşım benimser. Bu ara değerleri saklamak yerine, gerektiğinde attention skorlarının küçük kısımlarını yeniden hesaplar.
Mutfakta bu, soğan doğramaya benzer. Doğradığınız soğanları saklamak için markete yürüyüp sonra geri gelip almak yerine, onları atıp pişirme zamanı geldiğinde taze bir soğanı yeniden doğrayabilirsiniz. Şaşırtıcı biçimde ikinci seçenek daha hızlıdır çünkü sık/uzun hareketleri önler.
Modern GPU’larda yeniden hesaplama aynı mantığı izler; ekstra hesaplama, bellek hareketlerine kıyasla ucuzdur. Küçük değerleri saklayıp yüklemek yerine yeniden hesaplayarak Flash Attention, eğitim verimliliğini korurken bellek trafiğini önemli ölçüde azaltır.
Birlikte ele alındığında, döşeme ve yeniden hesaplama Flash Attention’ın işlemleri tezgâhta tutmasına, markete gidişleri en aza indirmesine ve modern GPU donanımının güçlü yönlerinden tam olarak yararlanmasına olanak tanır.
Flash Attention 2
2023’te yayımlanan Flash Attention 2 (FA2), ilk nesle göre büyük bir yükseltmedir. IO-farkındalıklı, tam attention fikrini korur ancak gerçek iş yüklerinde önemli olan çeşitli boyutlarda verimliliği artırır.
Dizi uzunluğu boyunca paralellik
İlk sürüm, hesaplamayı yığın (batch) boyutu ve attention başlıkları (head) arasında paralelleştirdi. Bu, büyük yığınlı eğitim kurulumlarında iyi çalıştı. Ancak, yığın boyutlarının genellikle küçük ve dizi uzunluklarının uzun olduğu çıkarım (inference) için daha az idealdi.
FA2, paralelliği bizzat dizi uzunluğu boyutuna ekler. Bu, yığın boyutu küçük olduğunda bile attention hesaplamasının daha fazla bölümünün eşzamanlı çalışmasına olanak tanır. İş yükünü dizideki belirteçlere yayarak v2, GPU’nun daha fazla hesaplama birimini aynı anda meşgul tutar.
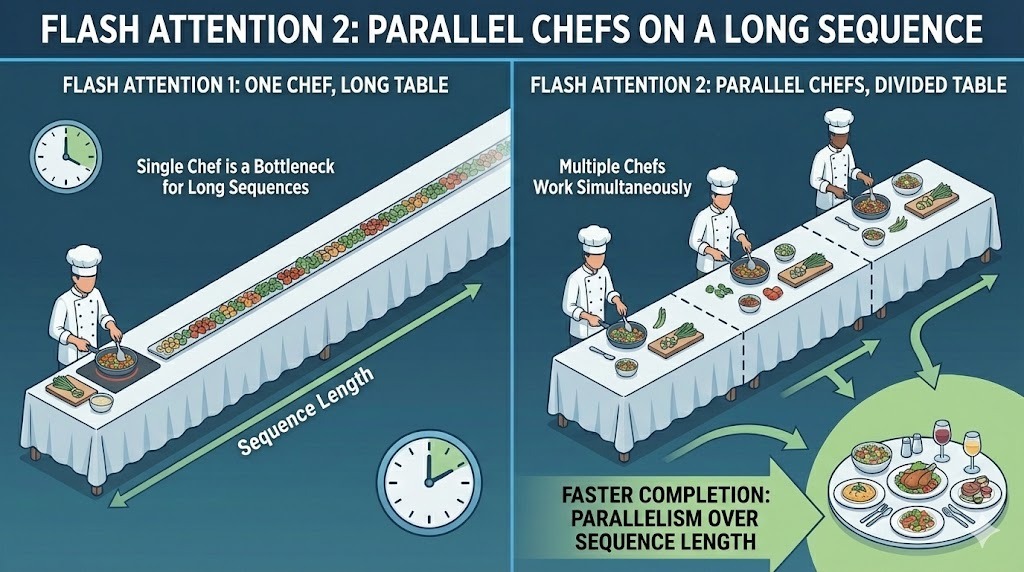
Flash Attention 2’de yığınlar arasında paralellik
Pratikte faydası, uzun istemlerin ve küçük yığınların norm olduğu yaygın çıkarım senaryolarında daha yüksek verim ve daha iyi donanım kullanım oranıdır.
Matris dışı işlemleri azaltma
GPU’lar matris çarpımında son derece iyidir. Tensor Core’lar olarak adlandırılan özel donanım, genel matris çarpımı (GEMM) işlemlerini çok yüksek hızda gerçekleştirebilir.
Sorun şu ki attention yalnızca matris çarpımından ibaret değildir: ölçekleme, maskeleme ve softmax gibi işlemleri içerir; bunlar standart GPU çekirdeklerinde çalışır ve kıyasla çok daha yavaştır.
FA2 bu dengesizliği azalttı. Hesaplamayı, özellikle attention skorlarının yeniden ölçeklenmesine dâhil olan matris dışı kayan nokta işlemlerini en aza indirecek şekilde yeniden yapılandırır. Çalışma süresinin çoğu, Tensor Core’ların hızlandırabildiği büyük ve verimli matris işlemleri içinde geçirilir.
Daha büyük başlık boyutları için destek
Flash Attention v1, BERT ve GPT-3 gibi modellere uyan 64 veya 128’lik başlık boyutları etrafında optimize edilmişti. Model mimarileri geliştikçe, daha büyük gömme (embedding) boyutlarını ve daha yüksek model kapasitesini desteklemek için başlık boyutları büyüdü.
FA2, desteği 256’ya kadar başlık boyutlarına genişletti. Bu, daha geniş attention başlıklarına dayanan yeni mimarilerle uyumlu hâle getirdi.
Flash Attention 3
Flash Attention 3 (FA3), GPT-5.2 gibi en son modelere güç veren mevcut endüstri standardıdır. Önceki sürümlerle aynı IO-farkındalıklı, tam attention temeli üzerine inşa edilmiştir; ancak özel olarak NVIDIA H100 (Hopper) GPU’ları için tasarlanmıştır.
Temel değişim, FA3’ün Hopper’ın yeni eşzamansız donanım özelliklerinden yararlanacak şekilde tasarlanmış olmasıdır; bu da bellek hareketi ve hesaplamanın eskisinden çok daha agresif biçimde üst üste bindirilmesini sağlar.
Warp uzmanlaşması
Önceki sürümlerde warp olarak bilinen tüm GPU iş parçacıkları aynı yürütme yolunu izliyordu. FA3, warp uzmanlaşmasıyla bu modeli değiştirir. Her warp’a iki farklı rolden birini atar:
- Üreticiler: bellekten veri yükler
- Tüketiciler: asıl attention matematiğini gerçekleştirir
Bu ayrım, veri aktarımı ve hesaplamanın aynı anda gerçekleşmesine olanak tanır. Üretici warp’lar bir sonraki veri döşemelerini getirirken, tüketici warp’lar mevcut döşemeler üzerinde hesap yapmaya devam eder ve gecikmeyi önemli ölçüde iyileştirir
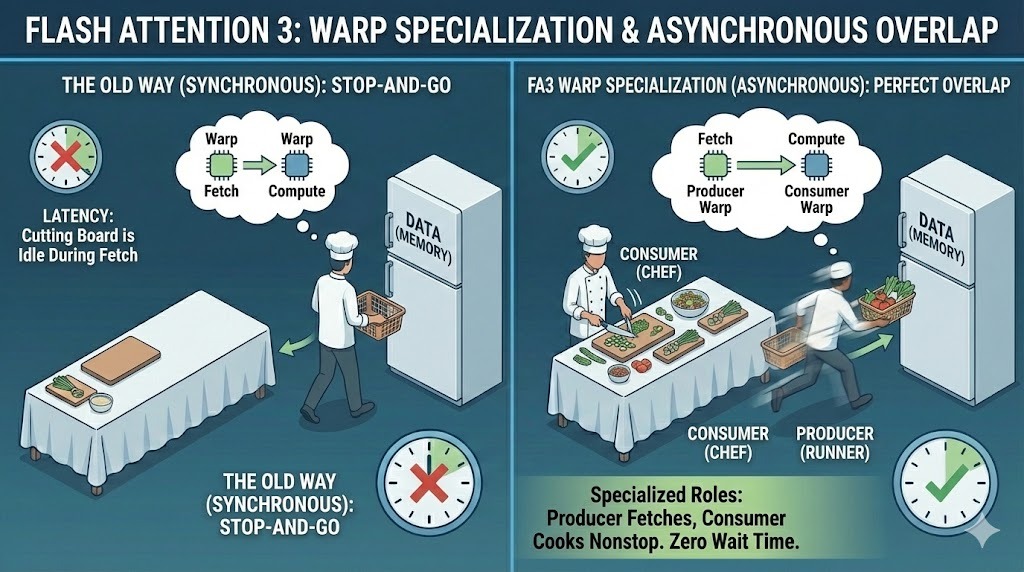
Flash Attention 3’te warp uzmanlaşması
Yerel FP8 hassasiyeti
Flash Attention 3 ayrıca FP8, yani 8 bit kayan nokta hassasiyeti için yerel destek sunar. Önceki sürümler çoğunlukla FP16 veya BF16’ya dayanıyordu; bunlar FP32’ye kıyasla bellek kullanımını azaltıyordu, ancak yine de önemli bant genişliği tüketiyordu.
FP8 bellek ayak izini kabaca bir kez daha yarıya indirir. Bu azalma doğrudan daha yüksek verime ve daha düşük bellek baskısına dönüşür. Hopper GPU’larda FP8 donanım hızlandırmalıdır; bu da FA3’ün, model düzeyinde doğruluktan ödün vermeden saniyede daha fazla attention işlemi gerçekleştirebilmesini sağlar.
Bu yetenek, Gemini 3 gibi büyük modellerin bağlam pencerelerini devasa boyutlarda tutarken milyonlarca kullanıcıya verimli hizmet verebilmesinin başlıca nedenidir.
Donanım hızlandırmalı örtüşme
FA3 tasarımının son parçası H100’ün Tensor Memory Accelerator’ını (TMA) kullanmasıdır. TMA, bellek kopyalarını ana hesaplama çekirdeklerini meşgul etmeden eşzamansız olarak gerçekleştiren özel bir donanımdır.
Flash Attention 3, hesaplama kesintisiz devam ederken veri döşemelerini arka planda taşımak için TMA’yı kullanır. Bellek hareketi ile matematiği sıkı biçimde üst üste bindirerek FA3, donanımın teorik tepe performansının yüzde 75’ine yakınını çıkarabilir.
Flash Attention 4 ve Ötesi
Flash Attention 4 (FA4), attention optimizasyonunda bir sonraki deneysel adımdır. NVIDIA’nın yaklaşan Blackwell B200 GPU’ları için tasarlanmıştır ve attention çekirdekleri tamamen yeni bir donanım sınıfı için oluşturulduğunda nelerin mümkün olacağını keşfeder.
Model boyutları büyümeye ve eğitimler trilyon parametre ölçeğine doğru ilerlemeye devam ettikçe, Flash Attention 3 bile sonunda sınırlara çarpacaktır. FA4, donanım kullanımını önceki herhangi bir attention çekirdeğinden daha ileriye taşıyarak bu sınırları kaldırmaya yönelik erken bir girişimdir.
Bu aşamada Flash Attention 4 bir araştırma ve üretim öncesi teknolojidir. Güçlü bir vaat gösterir, ancak henüz devreye alınmış veya üretim sınıfı modellerde kullanılmamaktadır.
Petaflop bariyerini aşmak
Flash Attention 4’ün büyük kilometre taşlarından biri performanstır. Tek bir GPU üzerinde 1 PFLOPS’u, yani saniyede bir katrilyon kayan nokta işlemini aşmak üzere tasarlanmış ilk attention çekirdeğidir.
Hedefi, trilyon parametreli modellerin eğitiminin tamamlanmasının pratik dışı süreler alacağı bir gelecektir. Bu ölçekte, küçük verimsizlikler bile büyük gecikmelere yol açar. FA4, tek bir çipten aşırı performans çıkararak bu gelecekteki eğitimleri mümkün kılmayı amaçlar.
Devasa eşzamanlılık (asynchrony)
Bu performansa ulaşmak için FA4, eşzamanlılığı önceki sürümlerden çok daha ileri iter. Üretici-tüketici modelini, veri hareketi, hesaplama ve senkronizasyonun tümünün bağımsız çalıştığı, son derece karmaşık çok aşamalı boruhatlarına genişletir.
Yükleme ile hesaplama arasında nispeten basit bir örtüşme yerine, FA4 çoklu aşamalar boyunca derinlemesine eşzamansız yürütmeyi yönetir. Çekirdeğin farklı bölümleri farklı hızlarda ilerler; tek bir senkronize akış yerine donanım düzeyinde zamanlamayla koordine edilir.
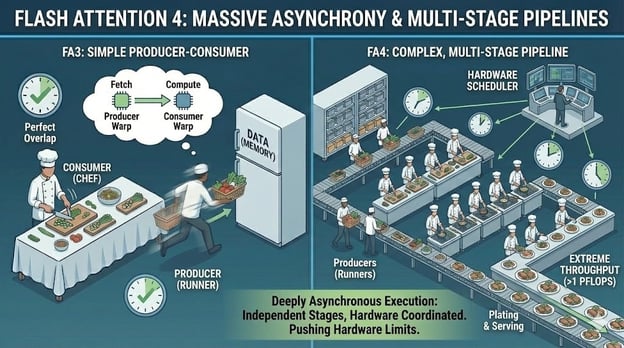
Flash Attention 4’te devasa eşzamanlılık
Bu karmaşıklık aynı zamanda FA4’ün deneysel kalmasının nedenidir. Bu düzeyde doğruluk, kararlılık ve entegrasyonu yönetmek zorludur. Topluluk, büyük üretim modellerinde güvenle kullanılmadan önce daha fazla çalışma gerektirmektedir.
Flash Attention ve Standart Attention Karşılaştırması
Flash Attention’ın birkaç kilit alanda standart attention mekanizmasıyla nasıl karşılaştırıldığını görelim.
Hız
Kıyaslamalar, tüm Flash Attention sürümlerinin standart öz-dikkati geride bıraktığını ve kazançların dizi uzunluğu arttıkça büyüdüğünü sürekli göstermektedir.
Orijinal Flash Attention makalesi, optimize edilmiş standart attention’a göre yaklaşık 2 ila 4× hızlanma bildirir. Flash Attention 2, paralelliği artırıp GPU’yu daha iyi doyurarak bunu daha da geliştirir ve pratikte sıklıkla ~2× ek iyileştirme sağlar.
Flash Attention 3, özellikle FP8 ile Hopper GPU’larında performansı daha da ileri taşır; standart attention’ın ulaşabildiğinden çok daha yüksek donanım kullanımına erişir.
Bellek
Standart attention, tam N × N attention matrisini açıkça malzemeler; bu da dizi uzunluğuna göre karesel bellek büyümesine yol açar. N büyüdükçe bellek kullanımı patlar ve GPU belleğini hızla aşar. Flash Attention bu matrisi tamamen saklamaktan kaçınır.
Attention’ı döşemeler hâlinde hesaplayıp ara sonuçları hızlı yonga içi bellekte tutarak, sabit başlık boyutları için bellek kullanımını dizi uzunluğunda doğrusal hâle getirir. Kareselden doğrusal bellek ölçeklemeye geçiş, standart attention’daki en büyük yapısal darboğazı ortadan kaldırır.
Bağlam uzunluğu
Bu bellek azalması, daha uzun bağlam pencerelerini doğrudan mümkün kılar. Standart attention ile, diziler birkaç bin belirtece ulaştığında modeller genellikle bellek yetersizliği hataları verir.
Flash Attention, tek bir GPU’da 4k ve 8k belirteçlik bağlamları pratik kılar ve diğer bellek tasarrufu teknikleriyle birleştirildiğinde aynı cihazda 16k veya 32k gibi çok daha uzun pencerelerin kilidini açar.
Burada karıştırmayın: Gemini 3 gibi güncel öncü modellerde elde edilen milyon belirteçlik devasa pencereler, diziyi büyük GPU kümelerine bölerek sağlanır; zira bunlar herhangi bir tekil cihazın bellek kapasitesini çok aşar.
Flash Attention Nasıl Kullanılır
Bugün Flash Attention kullanmak eskisine göre çok daha basittir. Çoğu durumda özel CUDA çekirdekleri yazmanız veya model mimarinizi değiştirmeniz gerekmez. Destek, günümüzde popüler araçlara zaten yerleşiktir.
PyTorch entegrasyonu
PyTorch 2.0’dan beri, Flash Attention doğrudan torch.nn.functional.scaled_dot_product_attention üzerinden kullanılabilir. Bu fonksiyonu çağırdığınızda, PyTorch donanımınız için mevcut en hızlı attention arka ucunu otomatik olarak seçer.
Desteklenen GPU’larda bu arka uç Flash Attention’dır. Kullanıcı açısından bu, çoğu zaman standart attention kodu gibi görünür; ancak perde arkasında PyTorch optimize edilmiş bir Flash Attention çekirdeğine yönlendirir.
Hugging Face Transformers kullanıyorsanız Flash Attention’ı etkinleştirmek genellikle tek satırlık bir değişikliktir. Model yapılandırmasında attn_implementation="flash_attention_2" ayarını yapmak, mümkün olan her yerde kitaplığa Flash Attention 2’yi kullanmasını söyler.
Birçok dönüştürücü model için bu, eğitim veya çıkarım kodunun geri kalanına dokunmadan hem hız hem bellek iyileştirmeleri elde etmek için yeterlidir.
Donanım gereksinimleri
Flash Attention 2, modern NVIDIA GPU’ları hedefler ve A100, RTX 3090, RTX 4090 ve H100 dâhil olmak üzere Ampere, Ada ve Hopper mimarilerinde en iyi şekilde çalışır. Bu GPU’lar, FA2’deki döşeme ve paralellikten tam olarak faydalanmak için gereken bellek bant genişliği ve mimari özellikleri sağlar.
Ayrıca, orijinal Flash Attention v1’in daha eski GPU’ları da desteklediğini belirtmek gerekir. T4 ve RTX 2080 gibi Turing tabanlı kartlar hâlâ Flash Attention v1’i kullanabilir; ancak daha yeni sürümlerin tam performans kazançlarını açığa çıkarmak için daha güncel donanım gerekir.
Pratikte, zaten modern bir NVIDIA GPU üzerinde PyTorch 2.x veya Hugging Face Transformers kullanıyorsanız, Flash Attention çoğu zaman yalnızca bir yapılandırma anahtarına bakar.
Sonuç
Standart attention, karesel bellek büyümesi nedeniyle uzun dizileri yavaş, pahalı veya bellek yetersizliği hataları yüzünden imkânsız kıldığı için sert bir duvara tosladı. Flash Attention, attention’ın nasıl yürütüldüğünü yeniden tasarlayarak bunu değiştirdi.
Bellek kullanımını dizi uzunluğu açısından kareselden doğrusala indirerek Flash Attention, uzun bağlamlı modellemeyi pratik hâle getirir. Birkaç bin belirteçte GPU’ları altüst eden bağlam pencereleri artık aynı donanımda 4k, 8k ve hatta 32k+ belirtece ölçeklenir.
Eğer büyük ölçekte dönüştürücülerle çalışıyor ve Flash Attention kullanmıyorsanız, neredeyse kesinlikle performans kaybediyorsunuz.
Flash Attention kullanabilen kendi modellerinizi oluşturmaya hevesli misiniz? PyTorch ile dönüştürücü modeller kursumuzu alın!





Dikkat (attention) mekanizması dönüştürücü (transformer) modellerin kalbinde yer alır. GPT, LLaMA ve Uzman Karışımı (MoE) gibi tüm popüler mimariler, belirteçleri (token) ilişkilendirip anlam kurmak için buna dayanır.
Ancak attention pahalıdır. Hesaplama, büyük matris çarpımlarını ve daha da önemlisi GPU belleği ile hesaplama birimleri arasında büyük veri hareketlerini içerir. Dizi (sequence) uzunlukları arttıkça gerçek darboğaz bellek bant genişliği olur.
Bu nedenle attention’ı optimize etmek, LLM performansı üzerinde orantısız bir etkiye sahiptir ve Flash Attention tam da burada devreye girer. Bu yazıda, Flash Attention’ın ne olduğunu, nasıl çalıştığını ve PyTorch ile Hugging Face Transformers’ta nasıl kullanacağınızı anlatacağım.
LLM’lere başlamanın bir yolunu arıyorsanız, LLM kavramları konulu giriş kursumuzu öneririm.
Flash Attention Nedir?
Flash Attention, GPU’larda dramatik biçimde daha hızlı ve daha bellek verimli çalışan, optimize edilmiş bir dönüştürücü attention mekanizmasıdır.
Standart attention ve Flash attention
GPU’larda iki ana bellek türü vardır. Yüksek bant genişlikli bellek (HBM) büyük ama nispeten yavaştır. Yonga üzerindeki SRAM son derece hızlıdır ancak boyut olarak çok sınırlıdır.
Standart öz-dikkat (self-attention) veriyi sürekli bu ikisi arasında taşır. Bu gidiş geliş maliyetlidir ve dizi uzunluğu arttıkça önemli bir maliyete dönüşür.
Flash Attention bunu, tamamen hızlı SRAM’e sığan küçük döşemeler (tile) halinde attention hesaplayarak önler. Her döşeme uçtan uca işlenir; softmax artımlı olarak uygulanır, böylece ara sonuçların HBM’ye geri yazılmasına gerek kalmaz. Bu nedenle, tam attention matrisi hiçbir zaman bellekte tutulmaz.
Seyrek (sparse) veya doğrusal attention yöntemlerinden farklı olarak Flash Attention bir yaklaşım (approximation) değildir. Standart öz-dikkat ile aynı matematiksel çıktıyı üretir; sadece daha bellek verimli bir şekilde yürütülür.
Flash Attention Nasıl Çalışır?
Flash Attention, GPU üzerinde attention’ı nasıl hesapladığını yeniden tasarlayarak verimliliğe ulaşır. Basit bir ilkeyi izler: mümkün olduğunca çok işi hızlı yonga içi bellekte yap ve yavaş belleğe gereksiz hareketlerden kaçın.
Bunu düşünmenin yararlı bir yolu mutfak benzetmesidir. GPU’nun yonga içi SRAM’i küçük, hızlı bir mutfak tezgâhı gibidir. Aslında hazırlık ve pişirme orada olur. GPU yüksek bant genişlikli bellek (HBM) ise sokağın aşağısındaki büyük bir market gibidir. İhtiyacınız olan her şeyi depolayabilir, ancak gidip gelmek zaman alır.
Kısacası, standart attention her adımdan sonra markete koşar. Buna karşılık Flash Attention, pişirme sırasında her şey tezgâha sığacak şekilde planlar. Bunu daha ayrıntılı anlayalım:
Flash Attention çalışma mekanizması
Flash Attention iki temel fikre dayanır: döşeme (tiling) ve yeniden hesaplama (recomputation).
Döşeme (Tiling)
Mutfak örneğimizde kalırsak, döşeme Flash Attention’ın attention hesaplamasını küçük tezgâha sığdırma yoludur.
Tüm diziyi yükleyip tam bir attention matrisi oluşturmak yerine Flash Attention girdileri küçük bloklara, yani döşemelere böler. Her döşeme tamamen GPU’nun hızlı SRAM’ine sığar. Flash Attention attention’ı her seferinde bir döşeme için, baştan sona hesaplar; ardından bir sonrakine geçer.
Mutfak benzetmesinde, küçük bir tezgâha tüm bir ziyafetin malzemelerini sığdıramazsınız. Bu yüzden küçük partiler halinde hazırlayıp pişirirsiniz. Biraz sebze doğrarsınız, pişirirsiniz, alanı temizler ve sonra bir sonraki partiye geçersiniz. Bu şekilde çalışarak sürekli markete gidip gelmekten kaçınırsınız.
Bu blok blok yürütme, Flash Attention’ın veriyi yerel, hızlı ve verimli tutmasını sağlar; tam attention matrisini yavaş bellekte hiçbir zaman malzemelemeden (materialize etmeden).
Flash Attention’da döşeme
Yeniden hesaplama (Recomputation)
Eğitim sırasında, standart attention geri yayılımda kullanılmak üzere büyük ara sonuçları saklar. Bu saklama yüksek bir bellek maliyeti getirir. Flash Attention farklı bir yaklaşım benimser. Bu ara değerleri saklamak yerine, gerektiğinde attention skorlarının küçük kısımlarını yeniden hesaplar.
Mutfakta bu, soğan doğramaya benzer. Doğradığınız soğanları saklamak için markete yürüyüp sonra geri gelip almak yerine, onları atıp pişirme zamanı geldiğinde taze bir soğanı yeniden doğrayabilirsiniz. Şaşırtıcı biçimde ikinci seçenek daha hızlıdır çünkü sık/uzun hareketleri önler.
Modern GPU’larda yeniden hesaplama aynı mantığı izler; ekstra hesaplama, bellek hareketlerine kıyasla ucuzdur. Küçük değerleri saklayıp yüklemek yerine yeniden hesaplayarak Flash Attention, eğitim verimliliğini korurken bellek trafiğini önemli ölçüde azaltır.
Birlikte ele alındığında, döşeme ve yeniden hesaplama Flash Attention’ın işlemleri tezgâhta tutmasına, markete gidişleri en aza indirmesine ve modern GPU donanımının güçlü yönlerinden tam olarak yararlanmasına olanak tanır.
Flash Attention 2
2023’te yayımlanan Flash Attention 2 (FA2), ilk nesle göre büyük bir yükseltmedir. IO-farkındalıklı, tam attention fikrini korur ancak gerçek iş yüklerinde önemli olan çeşitli boyutlarda verimliliği artırır.
Dizi uzunluğu boyunca paralellik
İlk sürüm, hesaplamayı yığın (batch) boyutu ve attention başlıkları (head) arasında paralelleştirdi. Bu, büyük yığınlı eğitim kurulumlarında iyi çalıştı. Ancak, yığın boyutlarının genellikle küçük ve dizi uzunluklarının uzun olduğu çıkarım (inference) için daha az idealdi.
FA2, paralelliği bizzat dizi uzunluğu boyutuna ekler. Bu, yığın boyutu küçük olduğunda bile attention hesaplamasının daha fazla bölümünün eşzamanlı çalışmasına olanak tanır. İş yükünü dizideki belirteçlere yayarak v2, GPU’nun daha fazla hesaplama birimini aynı anda meşgul tutar.
Flash Attention 2’de yığınlar arasında paralellik
Pratikte faydası, uzun istemlerin ve küçük yığınların norm olduğu yaygın çıkarım senaryolarında daha yüksek verim ve daha iyi donanım kullanım oranıdır.
Matris dışı işlemleri azaltma
GPU’lar matris çarpımında son derece iyidir. Tensor Core’lar olarak adlandırılan özel donanım, genel matris çarpımı (GEMM) işlemlerini çok yüksek hızda gerçekleştirebilir.
Sorun şu ki attention yalnızca matris çarpımından ibaret değildir: ölçekleme, maskeleme ve softmax gibi işlemleri içerir; bunlar standart GPU çekirdeklerinde çalışır ve kıyasla çok daha yavaştır.
FA2 bu dengesizliği azalttı. Hesaplamayı, özellikle attention skorlarının yeniden ölçeklenmesine dâhil olan matris dışı kayan nokta işlemlerini en aza indirecek şekilde yeniden yapılandırır. Çalışma süresinin çoğu, Tensor Core’ların hızlandırabildiği büyük ve verimli matris işlemleri içinde geçirilir.
Daha büyük başlık boyutları için destek
Flash Attention v1, BERT ve GPT-3 gibi modellere uyan 64 veya 128’lik başlık boyutları etrafında optimize edilmişti. Model mimarileri geliştikçe, daha büyük gömme (embedding) boyutlarını ve daha yüksek model kapasitesini desteklemek için başlık boyutları büyüdü.
FA2, desteği 256’ya kadar başlık boyutlarına genişletti. Bu, daha geniş attention başlıklarına dayanan yeni mimarilerle uyumlu hâle getirdi.
Flash Attention 3
Flash Attention 3 (FA3), GPT-5.2 gibi en son modelere güç veren mevcut endüstri standardıdır. Önceki sürümlerle aynı IO-farkındalıklı, tam attention temeli üzerine inşa edilmiştir; ancak özel olarak NVIDIA H100 (Hopper) GPU’ları için tasarlanmıştır.
Temel değişim, FA3’ün Hopper’ın yeni eşzamansız donanım özelliklerinden yararlanacak şekilde tasarlanmış olmasıdır; bu da bellek hareketi ve hesaplamanın eskisinden çok daha agresif biçimde üst üste bindirilmesini sağlar.
Warp uzmanlaşması
Önceki sürümlerde warp olarak bilinen tüm GPU iş parçacıkları aynı yürütme yolunu izliyordu. FA3, warp uzmanlaşmasıyla bu modeli değiştirir. Her warp’a iki farklı rolden birini atar:
Bu ayrım, veri aktarımı ve hesaplamanın aynı anda gerçekleşmesine olanak tanır. Üretici warp’lar bir sonraki veri döşemelerini getirirken, tüketici warp’lar mevcut döşemeler üzerinde hesap yapmaya devam eder ve gecikmeyi önemli ölçüde iyileştirir
Flash Attention 3’te warp uzmanlaşması
Yerel FP8 hassasiyeti
Flash Attention 3 ayrıca FP8, yani 8 bit kayan nokta hassasiyeti için yerel destek sunar. Önceki sürümler çoğunlukla FP16 veya BF16’ya dayanıyordu; bunlar FP32’ye kıyasla bellek kullanımını azaltıyordu, ancak yine de önemli bant genişliği tüketiyordu.
FP8 bellek ayak izini kabaca bir kez daha yarıya indirir. Bu azalma doğrudan daha yüksek verime ve daha düşük bellek baskısına dönüşür. Hopper GPU’larda FP8 donanım hızlandırmalıdır; bu da FA3’ün, model düzeyinde doğruluktan ödün vermeden saniyede daha fazla attention işlemi gerçekleştirebilmesini sağlar.
Bu yetenek, Gemini 3 gibi büyük modellerin bağlam pencerelerini devasa boyutlarda tutarken milyonlarca kullanıcıya verimli hizmet verebilmesinin başlıca nedenidir.
Donanım hızlandırmalı örtüşme
FA3 tasarımının son parçası H100’ün Tensor Memory Accelerator’ını (TMA) kullanmasıdır. TMA, bellek kopyalarını ana hesaplama çekirdeklerini meşgul etmeden eşzamansız olarak gerçekleştiren özel bir donanımdır.
Flash Attention 3, hesaplama kesintisiz devam ederken veri döşemelerini arka planda taşımak için TMA’yı kullanır. Bellek hareketi ile matematiği sıkı biçimde üst üste bindirerek FA3, donanımın teorik tepe performansının yüzde 75’ine yakınını çıkarabilir.
Flash Attention 4 ve Ötesi
Flash Attention 4 (FA4), attention optimizasyonunda bir sonraki deneysel adımdır. NVIDIA’nın yaklaşan Blackwell B200 GPU’ları için tasarlanmıştır ve attention çekirdekleri tamamen yeni bir donanım sınıfı için oluşturulduğunda nelerin mümkün olacağını keşfeder.
Model boyutları büyümeye ve eğitimler trilyon parametre ölçeğine doğru ilerlemeye devam ettikçe, Flash Attention 3 bile sonunda sınırlara çarpacaktır. FA4, donanım kullanımını önceki herhangi bir attention çekirdeğinden daha ileriye taşıyarak bu sınırları kaldırmaya yönelik erken bir girişimdir.
Bu aşamada Flash Attention 4 bir araştırma ve üretim öncesi teknolojidir. Güçlü bir vaat gösterir, ancak henüz devreye alınmış veya üretim sınıfı modellerde kullanılmamaktadır.
Petaflop bariyerini aşmak
Flash Attention 4’ün büyük kilometre taşlarından biri performanstır. Tek bir GPU üzerinde 1 PFLOPS’u, yani saniyede bir katrilyon kayan nokta işlemini aşmak üzere tasarlanmış ilk attention çekirdeğidir.
Hedefi, trilyon parametreli modellerin eğitiminin tamamlanmasının pratik dışı süreler alacağı bir gelecektir. Bu ölçekte, küçük verimsizlikler bile büyük gecikmelere yol açar. FA4, tek bir çipten aşırı performans çıkararak bu gelecekteki eğitimleri mümkün kılmayı amaçlar.
Devasa eşzamanlılık (asynchrony)
Bu performansa ulaşmak için FA4, eşzamanlılığı önceki sürümlerden çok daha ileri iter. Üretici-tüketici modelini, veri hareketi, hesaplama ve senkronizasyonun tümünün bağımsız çalıştığı, son derece karmaşık çok aşamalı boruhatlarına genişletir.
Yükleme ile hesaplama arasında nispeten basit bir örtüşme yerine, FA4 çoklu aşamalar boyunca derinlemesine eşzamansız yürütmeyi yönetir. Çekirdeğin farklı bölümleri farklı hızlarda ilerler; tek bir senkronize akış yerine donanım düzeyinde zamanlamayla koordine edilir.
Flash Attention 4’te devasa eşzamanlılık
Bu karmaşıklık aynı zamanda FA4’ün deneysel kalmasının nedenidir. Bu düzeyde doğruluk, kararlılık ve entegrasyonu yönetmek zorludur. Topluluk, büyük üretim modellerinde güvenle kullanılmadan önce daha fazla çalışma gerektirmektedir.
Flash Attention ve Standart Attention Karşılaştırması
Flash Attention’ın birkaç kilit alanda standart attention mekanizmasıyla nasıl karşılaştırıldığını görelim.
Hız
Kıyaslamalar, tüm Flash Attention sürümlerinin standart öz-dikkati geride bıraktığını ve kazançların dizi uzunluğu arttıkça büyüdüğünü sürekli göstermektedir.
Orijinal Flash Attention makalesi, optimize edilmiş standart attention’a göre yaklaşık 2 ila 4× hızlanma bildirir. Flash Attention 2, paralelliği artırıp GPU’yu daha iyi doyurarak bunu daha da geliştirir ve pratikte sıklıkla ~2× ek iyileştirme sağlar.
Flash Attention 3, özellikle FP8 ile Hopper GPU’larında performansı daha da ileri taşır; standart attention’ın ulaşabildiğinden çok daha yüksek donanım kullanımına erişir.
Bellek
Standart attention, tam N × N attention matrisini açıkça malzemeler; bu da dizi uzunluğuna göre karesel bellek büyümesine yol açar. N büyüdükçe bellek kullanımı patlar ve GPU belleğini hızla aşar. Flash Attention bu matrisi tamamen saklamaktan kaçınır.
Attention’ı döşemeler hâlinde hesaplayıp ara sonuçları hızlı yonga içi bellekte tutarak, sabit başlık boyutları için bellek kullanımını dizi uzunluğunda doğrusal hâle getirir. Kareselden doğrusal bellek ölçeklemeye geçiş, standart attention’daki en büyük yapısal darboğazı ortadan kaldırır.
Bağlam uzunluğu
Bu bellek azalması, daha uzun bağlam pencerelerini doğrudan mümkün kılar. Standart attention ile, diziler birkaç bin belirtece ulaştığında modeller genellikle bellek yetersizliği hataları verir.
Flash Attention, tek bir GPU’da 4k ve 8k belirteçlik bağlamları pratik kılar ve diğer bellek tasarrufu teknikleriyle birleştirildiğinde aynı cihazda 16k veya 32k gibi çok daha uzun pencerelerin kilidini açar.
Burada karıştırmayın: Gemini 3 gibi güncel öncü modellerde elde edilen milyon belirteçlik devasa pencereler, diziyi büyük GPU kümelerine bölerek sağlanır; zira bunlar herhangi bir tekil cihazın bellek kapasitesini çok aşar.
Flash Attention Nasıl Kullanılır
Bugün Flash Attention kullanmak eskisine göre çok daha basittir. Çoğu durumda özel CUDA çekirdekleri yazmanız veya model mimarinizi değiştirmeniz gerekmez. Destek, günümüzde popüler araçlara zaten yerleşiktir.
PyTorch entegrasyonu
PyTorch 2.0’dan beri, Flash Attention doğrudan
torch.nn.functional.scaled_dot_product_attentionüzerinden kullanılabilir. Bu fonksiyonu çağırdığınızda, PyTorch donanımınız için mevcut en hızlı attention arka ucunu otomatik olarak seçer.Desteklenen GPU’larda bu arka uç Flash Attention’dır. Kullanıcı açısından bu, çoğu zaman standart attention kodu gibi görünür; ancak perde arkasında PyTorch optimize edilmiş bir Flash Attention çekirdeğine yönlendirir.
Hugging Face Transformers
Hugging Face Transformers kullanıyorsanız Flash Attention’ı etkinleştirmek genellikle tek satırlık bir değişikliktir. Model yapılandırmasında
attn_implementation="flash_attention_2"ayarını yapmak, mümkün olan her yerde kitaplığa Flash Attention 2’yi kullanmasını söyler.Birçok dönüştürücü model için bu, eğitim veya çıkarım kodunun geri kalanına dokunmadan hem hız hem bellek iyileştirmeleri elde etmek için yeterlidir.
Donanım gereksinimleri
Flash Attention 2, modern NVIDIA GPU’ları hedefler ve A100, RTX 3090, RTX 4090 ve H100 dâhil olmak üzere Ampere, Ada ve Hopper mimarilerinde en iyi şekilde çalışır. Bu GPU’lar, FA2’deki döşeme ve paralellikten tam olarak faydalanmak için gereken bellek bant genişliği ve mimari özellikleri sağlar.
Ayrıca, orijinal Flash Attention v1’in daha eski GPU’ları da desteklediğini belirtmek gerekir. T4 ve RTX 2080 gibi Turing tabanlı kartlar hâlâ Flash Attention v1’i kullanabilir; ancak daha yeni sürümlerin tam performans kazançlarını açığa çıkarmak için daha güncel donanım gerekir.
Pratikte, zaten modern bir NVIDIA GPU üzerinde PyTorch 2.x veya Hugging Face Transformers kullanıyorsanız, Flash Attention çoğu zaman yalnızca bir yapılandırma anahtarına bakar.
Sonuç
Standart attention, karesel bellek büyümesi nedeniyle uzun dizileri yavaş, pahalı veya bellek yetersizliği hataları yüzünden imkânsız kıldığı için sert bir duvara tosladı. Flash Attention, attention’ın nasıl yürütüldüğünü yeniden tasarlayarak bunu değiştirdi.
Bellek kullanımını dizi uzunluğu açısından kareselden doğrusala indirerek Flash Attention, uzun bağlamlı modellemeyi pratik hâle getirir. Birkaç bin belirteçte GPU’ları altüst eden bağlam pencereleri artık aynı donanımda 4k, 8k ve hatta 32k+ belirtece ölçeklenir.
Eğer büyük ölçekte dönüştürücülerle çalışıyor ve Flash Attention kullanmıyorsanız, neredeyse kesinlikle performans kaybediyorsunuz.
Flash Attention kullanabilen kendi modellerinizi oluşturmaya hevesli misiniz? PyTorch ile dönüştürücü modeller kursumuzu alın!