
Programma
AI Engineering with LangChain
21 ore
Quando ho iniziato a usare intensivamente Claude Code, mi sono accorto subito di due cose: la qualità è eccellente e la fattura lo dimostra. Ogni richiesta, che sia una docstring di tre righe o un refactor architetturale completo, colpisce lo stesso endpoint di Anthropic alla stessa tariffa.
Col tempo, quella dipendenza da un unico vendor non crea solo pressione sui costi; crea anche rischio. Significa pure che un rate limit su un modello può bloccare l’intero flusso di lavoro.
Claude Code Router (CCR) affronta direttamente entrambi i problemi. È un proxy open-source che intercetta le richieste di Claude Code prima che raggiungano qualsiasi provider e poi reindirizza ogni richiesta al modello backend più adatto per quel task.
In questo tutorial ti guiderò nell’intera configurazione: installazione del router, setup dell’instradamento multi‑provider e hardening del sistema per l’uso operativo quotidiano. Per seguire, procurati le API key dei provider che vuoi usare (DeepSeek, Gemini, OpenRouter o qualsiasi altro backend supportato) e apri il terminale. Iniziamo.
Per ispirarti sui nuovi LLM e i loro punti di forza, dai un’occhiata alle nostre guide su questi modelli recenti:
Prima di passare al setup, vale la pena capire cos’è davvero CCR e perché funziona così. Se non hai ancora lavorato con Claude Code, assicurati prima di leggere la nostra Guida pratica a Claude Code 2.1.
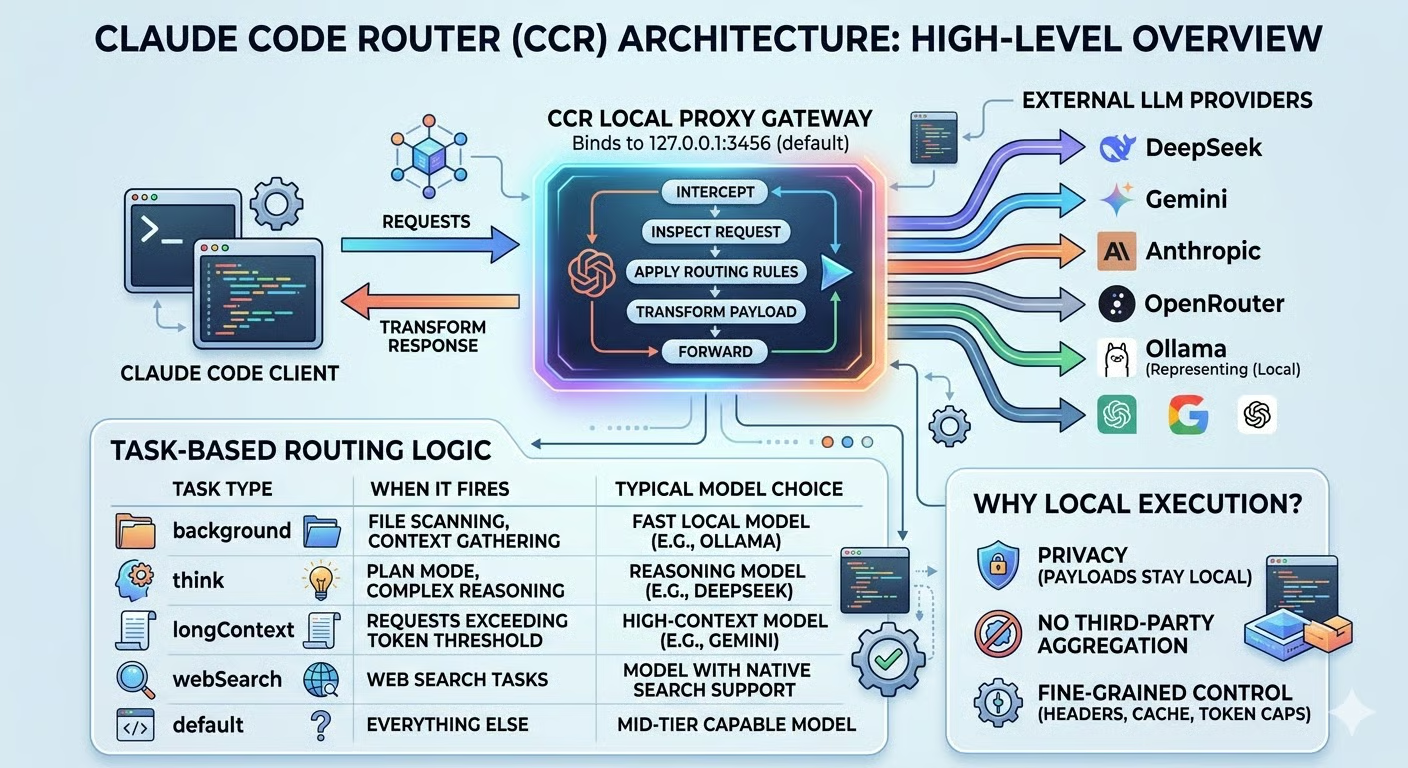
Claude Code Router è un gateway proxy locale. Quando lo avvii, si associa a una porta della tua macchina (127.0.0.1:3456 per impostazione predefinita) e si posiziona tra il client di Claude Code e qualsiasi provider LLM esterno. Dal punto di vista di Claude Code, sta parlando solo con un endpoint locale. Dietro le quinte, CCR decide in tempo reale dove inviare davvero la richiesta.
Il problema principale che risolve è la dipendenza da un unico vendor. Quando tutto passa da un solo provider, ne erediti tutti i vincoli:
CCR elimina questo limite permettendoti di definire regole di instradamento che cambiano automaticamente modello in base al tipo di task, al numero di token o a qualsiasi logica personalizzata tu scriva. Una scansione in background dei file non ha bisogno dello stesso modello di una sessione di ragionamento in Plan Mode e, con CCR, non lo userà.
Ciò che distingue CCR dalle API dirette dei provider o dagli aggregatori cloud è il luogo in cui gira.
Poiché il proxy viene eseguito in locale, i payload delle richieste non passano mai attraverso un servizio di aggregazione di terze parti prima di raggiungere la destinazione. Ottieni anche un controllo granulare sulla trasformazione delle richieste, incluso modificare gli header, rimuovere campi di cache e limitare i token, tramite un sistema di transformer che opera interamente sulla tua macchina.
Per me, questo modello di esecuzione locale è ciò che rende CCR davvero pratico e non solo un espediente ingegnoso: il risultato è una configurazione più economica, più resiliente e più privata rispetto all’instradare tutto tramite un unico vendor cloud.
Chiarito cosa fa CCR, vediamo come funziona sotto il cofano e cosa ti serve prima di installarlo.
Capire l’architettura di CCR rende la configurazione molto più semplice da ragionare e, a mio avviso, il pattern del proxy risulta immediato una volta visto end‑to‑end.
Quando avvii CCR, intercetta tutte le richieste in uscita dal terminale prima che raggiungano l’endpoint predefinito di Anthropic. Per ogni richiesta, esso:
La risposta torna allo stesso modo, trasformata di nuovo nel formato che Claude Code si aspetta, così il client non “si accorge” di alcun cambiamento.
Il meccanismo chiave di questa intercettazione è l’instradamento basato sul task. CCR classifica le richieste in arrivo per tipo e le mappa al modello appropriato. Ecco come si comportano in pratica le principali categorie di task:
|
Tipo di task |
Quando scatta |
Scelta tipica del modello |
|
|
Scansione file, raccolta contesto |
Modello locale veloce (es. Ollama) |
|
|
Plan Mode, ragionamento complesso |
Modello di reasoning (es. DeepSeek) |
|
|
Richieste oltre la soglia di token |
Modello con ampio contesto (es. Gemini) |
|
|
Task di ricerca web |
Modello con supporto nativo alla ricerca |
|
|
Tutto il resto |
Modello di fascia media capace |
Ogni tipo di task ottiene lo strumento giusto e nessuno richiede intervento manuale una volta configurato. Per esperienza, l’instradamento background offre il maggior ritorno immediato: quelle richieste silenziose di scansione file avvengono continuamente durante una sessione di coding e, prima di CCR, non avevo idea di quanto si accumulassero in sordina.
Prima di installare CCR, assicurati di avere:
Node.js v18 o successivo come runtime
npm come package manager
Claude Code installato globalmente (npm install -g @anthropic-ai/claude-code)
Almeno un backend di modello, ovvero una API key di un provider esterno supportato (DeepSeek, Gemini, OpenRouter, Groq, Volcengine, SiliconFlow e altri), oppure un’istanza locale di Ollama con un modello già scaricato, se preferisci evitare del tutto i provider esterni
Non ti servono account per ogni provider fin da subito. Un backend funzionante è sufficiente per completare questo tutorial; potrai aggiungerne altri in seguito.
Per un confronto tra Claude Code e una delle sue alternative più popolari, ti consiglio di leggere il nostro articolo su OpenClaw vs Claude Code.
Ora che concetti e prerequisiti sono chiari, costruiamo la configurazione step by step.
Con i prerequisiti a posto, puoi installare CCR globalmente con npm. Su Linux, però, potresti incontrare un errore di permessi quando installi pacchetti globali perché npm prova a scrivere in /usr/lib/node_modules, che è di proprietà di root. La soluzione consigliata è reindirizzare la directory globale di npm a una cartella di cui il tuo utente è già proprietario, invece di eseguire il comando con sudo:
mkdir -p ~/.npm-global
npm config set prefix '~/.npm-global'
export PATH=~/.npm-global/bin:$PATH
Per rendere permanente quella modifica del PATH, aggiungi la riga di export al tuo ~/.bashrc o ~/.zshrc e ricarica la shell. Poi installa CCR:
npm install -g @musistudio/claude-code-routerQuesto rende la CLI ccr disponibile globalmente nella shell. Ora avvia il servizio del router:
ccr startCCR si associa per default a http://127.0.0.1:3456. Quando vedi nell’output di avvio che il servizio è in ascolto sulla porta, il proxy è pronto ad accettare richieste.
Tutta la configurazione di CCR si trova in ~/.claude-code-router/config.json. Prima di collegare più provider, ti consiglio di partire con un unico provider “affidabile” per isolare le variabili e confermare che la base funzioni.
OpenRouter è un ottimo punto di partenza ed è quello che scelgo per primo quando configuro CCR su una nuova macchina. Ti dà accesso a decine di modelli, inclusi diversi di fascia gratuita, con una sola API key, il che lo rende ideale per far funzionare lo strato di instradamento prima di impegnarti su provider specifici. Puoi registrarti e ottenere una key su OpenRouter.
Ecco una configurazione minima che usa OpenRouter:
{
  "Providers": [
    {
      "name": "openrouter",
      "api_base_url": "https://openrouter.ai/api/v1/chat/completions",
      "api_key": "YOUR_OPENROUTER_API_KEY",
      "models": ["openai/gpt-oss-120b:free"],
      "transformer": {
        "use": ["openrouter"]
      }
    }
  ],
  "Router": {
    "default": "openrouter,openai/gpt-oss-120b:free"
  }
}
Alcune note importanti:
api_base_url deve puntare all’endpoint completo delle chat completions del provider, non solo al dominio base.
transformer specifica quale adapter di payload integrato deve usare CCR, poiché i diversi provider si aspettano formati di richiesta differenti. Il transformer gestisce questa traduzione in modo trasparente.
Router.default imposta il modello di fallback per qualsiasi richiesta che non corrisponda a una regola più specifica, usando la sintassi provider,model.
Per sicurezza, evita di inserire le key direttamente nel file. CCR supporta l’interpolazione di variabili d’ambiente: sostituisci YOUR_OPENROUTER_API_KEY con $OPENROUTER_API_KEY ed esporta la variabile nella tua shell. L’interpolazione funziona ricorsivamente in tutta la config, quindi questo schema scala bene man mano che aggiungi provider.
Con la config pronta, avviare Claude Code tramite il router richiede un solo comando:
ccr codeTutto qui. ccr code avvia il servizio proxy e lancia Claude Code simultaneamente, con l’ambiente preconfigurato in automatico. Non serve eseguire prima ccr start.
Per verificare che l’instradamento sia attivo, controlla la cartella ~/.claude-code-router/logs/. Un file chiamato ccr-*.log conferma che il proxy è avviato e riceve richieste. Puoi fare tail per guardare le richieste in tempo reale:
tail -f ~/.claude-code-router/logs/$(ls -t ~/.claude-code-router/logs/ | head -1)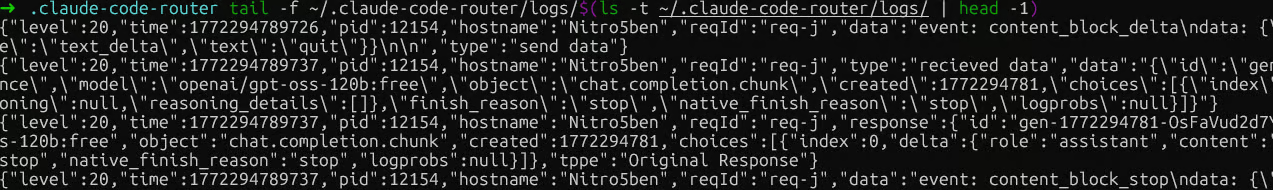
Log di Claude Code Router
Due cose utili da sapere sulla verifica. L’header di Claude Code mostra sempre ilmodello Claude predefinito corrente, a prescindere da quale modello stia usando CCR per l’instradamento, perché riflette la tua sessione dell’account Anthropic, non il backend attivo. Se chiedi al modello “qual è il tuo modello?”, dirà anche “Claude Sonnet 4.6”, perché è così che il client di Claude Code gli dice di identificarsi. Nessuno dei due segnali è affidabile.
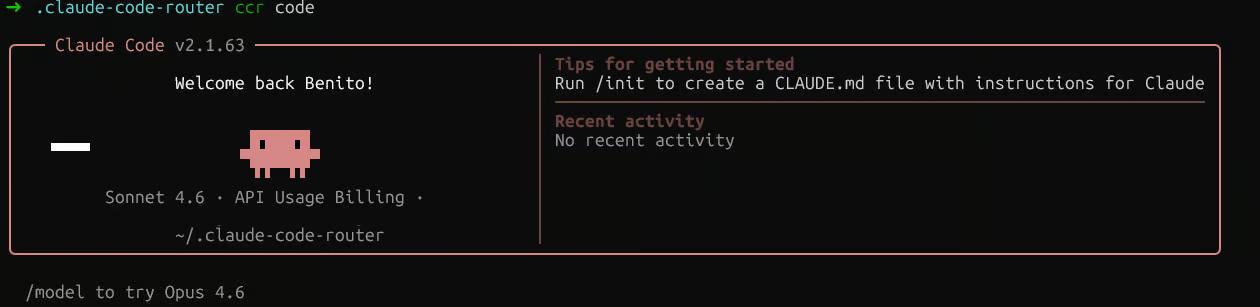
Sessione di Claude Code Router
Il log è l’unica fonte di verità. Cerca il campo "model" nelle voci di risposta. Se vedi il nome del modello configurato, ad esempio "model":"openai/gpt-oss-120b:free", l’instradamento funziona.
Se vuoi rendere CCR persistente così da poter usare il comando claude direttamente senza ccr code, aggiungi questo al tuo ~/.bashrc o ~/.zshrc:
eval "$(ccr activate)"Assicurati solo che prima giri ccr start, perché activate imposta solo le variabili d’ambiente e non avvia il servizio.
Verificata la base, estendiamo la config per instradare tipi di task differenti a provider diversi. Ecco una configurazione Router più completa:
{
  "Router": {
    "default": "deepseek,deepseek-chat",
    "background": "ollama,qwen2.5-coder:latest",
    "think": "deepseek,deepseek-reasoner",
    "longContext": "openrouter,google/gemini-2.5-pro-preview",
    "longContextThreshold": 60000,
    "webSearch": "gemini,gemini-2.5-flash"
  }
}
Ogni chiave mappa una categoria di task a una coppia "provider,model":
La route background gestisce le richieste di scansione file e raccolta del contesto. Possono tranquillamente andare su un modello locale Ollama, mantenendole gratuite, ed è il singolo cambiamento che ha ridotto di più la mia spesa mensile per le API.
La route think cattura Plan Mode e i task di ragionamento complesso, dove un modello come deepseek-reasoner si ripaga da solo.
La route longContext si attiva automaticamente quando una richiesta supera i token della longContextThreshold (predefinita a 60.000), reindirizzando a un modello ad alta capacità senza alcuno switch manuale.
Per webSearch, nota che il modello deve supportare nativamente la ricerca web. Se instradi tramite OpenRouter, devi anche aggiungere il suffisso :online al nome del modello (per esempio, "anthropic/claude-3.5-sonnet:online").
Per la resilienza ai rate limit, la funzione di custom router di CCR ti consente di definire logiche di fallback in JavaScript. Crea un file in un percorso a tua scelta, referenzialo nella config con "CUSTOM_ROUTER_PATH": "/path/to/custom-router.js", quindi esporta una funzione async che restituisce una stringa "provider,model" oppure null per ricadere sulle regole predefinite:
module.exports = async function router(req, config) {
  // Primary logic here. Return null to fall back to config-defined rules.
  return null;
};
Qui puoi implementare, per esempio, un retry in caso di rate limit, rilevando una risposta 429 e reindirizzando automaticamente a un provider secondario. Dopo ogni modifica alla config, ricorda di riavviare il servizio perché abbia effetto:
ccr restartCon l’instradamento funzionante, l’attenzione si sposta sul mantenere il sistema osservabile, sicuro e facile da diagnosticare quando qualcosa va storto.
CCR fornisce due sistemi di logging separati da conoscere:
Log a livello server coprono richieste HTTP, chiamate API ed eventi del server. Sono scritti in ~/.claude-code-router/logs/ in file chiamati ccr-*.log. È il log che userai più spesso.
Log a livello applicativo catturano le decisioni di instradamento e sono scritti in ~/.claude-code-router/claude-code-router.log, anche se questo file potrebbe non essere sempre presente a seconda del setup e del livello di log.
Rivedere regolarmente il log del server ti dà un quadro chiaro di quali route scattano, quali modelli vengono chiamati e se si verificano errori lato provider.
Per la visibilità in tempo reale, CCR include anche uno strumento di statusline (disponibile dalla v1.0.40 in poi) che puoi abilitare con ccr ui. Una volta attivo, mostra lo stato corrente dell’instradamento direttamente nel terminale mentre Claude Code è in esecuzione, indicandoti a colpo d’occhio quale modello gestisce ogni richiesta.
Sul fronte budget, il guardrail più efficace è la tua stessa configurazione di instradamento. Assicurando che le route background e default puntino a modelli economici o locali, eviti che modelli premium vengano invocati per task a basso valore. Riserva think e longContext a modelli che giustificano il costo e mantieni la soglia di token di longContext il più alta possibile per il tuo workflow.
Per esperienza, questa disciplina a livello di configurazione è più affidabile del monitoraggio reattivo, perché previene l’overspend prima che accada, invece di intercettarlo dopo.
La gestione delle credenziali merita attenzione esplicita, soprattutto man mano che cresce l’elenco dei provider. Le regole che seguo sono semplici:
Non fare mai commit di API key in chiaro in config.json se quel file è in version control. Usa sempre l’interpolazione di variabili d’ambiente con la sintassi "$PROVIDER_API_KEY" ed esporta le key dal profilo della shell o da un secrets manager.
Lascia il proxy su localhost per i setup dei singoli sviluppatori. Se non imposti un APIKEY nella config, CCR forza automaticamente il binding del server solo su 127.0.0.1, impedendo accessi esterni su macchine o reti condivise.
Imposta un APIKEY per i deployment di team se devi aprire l’host su 0.0.0.0. Ogni client che si connette al router deve includere quella key nell’header Authorization: Bearer o x-api-key.
Disabilita o riduci il logging se instradi codice sensibile. Il logging è abilitato di default ("LOG": true). Imposta "LOG": false per evitare di scrivere i payload su disco, oppure "LOG_LEVEL": "warn" per sopprimere l’output di debug verboso.
Un modo pratico per farlo è conservare tutte le API key nel profilo della shell e referenziarle tramite la sintassi $VAR_NAME in config.json. In questo modo, il file di configurazione non contiene segreti e può essere condiviso o messo sotto versionamento in sicurezza.
Se non sei sicuro che una key stia finendo nei log, controlla prima l’impostazione del livello di log. Passare a "LOG_LEVEL": "warn" è il modo più rapido per ridurre ciò che viene scritto su disco senza disabilitare del tutto il logging.
Quando qualcosa si rompe, una sequenza diagnostica a strati fa risparmiare molto tempo. Meglio partire dallo strato più esterno e procedere verso l’interno.
Esegui ccr code e cerca la conferma di avvio del servizio. Se la porta è occupata o il servizio non è partito, vedrai errori di connessione rifiutata in Claude Code.
Controlla i log del server in ~/.claude-code-router/logs/ per i dettagli. La maggior parte dei fallimenti in avvio dipende da un conflitto di porta o da un file config.json malformato.
L’errore di config più comune è una discrepanza tra il nome del modello in Providers e quello in Router. Devono essere identici.
Se differiscono, CCR invia una richiesta senza campo model e vedrai un errore Missing model in request body. Dopo aver corretto la config, esegui sempre ccr restart per ricaricarla.
Se il nome del modello è corretto ma le richieste falliscono ancora con un 404, controlla le impostazioni del tuo account presso il provider. OpenRouter, ad esempio, ha una policy sulla privacy predefinita che blocca i modelli gratuiti dall’inviare dati a provider terzi. Vedrai un errore tipo No endpoints found matching your data policy.
La soluzione è visitare le impostazioni sulla privacy di OpenRouter e abilitare l’uso dei modelli gratuiti. Altri provider possono avere toggle simili a livello account da controllare in caso di 4xx inattesi.
Se le richieste raggiungono il provider ma le risposte sono malformate o le tool call falliscono, di solito il problema è un transformer mancante o errato. Incrocia il tuo provider con l’elenco dei transformer integrati e assicurati che quello corretto sia nell’array "use".
Nella maggior parte dei casi, lavorare attraverso questi quattro step in ordine isola rapidamente il problema. Il log del server cattura sia la richiesta in uscita sia la risposta grezza del provider, dandoti tutto il necessario per capire dove si è verificato il guasto.
Ora hai un’infrastruttura di instradamento multi‑provider funzionante sopra Claude Code. I task in background vanno a modelli locali veloci, il lavoro pesante di ragionamento è instradato a modelli specializzati e le richieste a lungo contesto sono gestite da provider ad alta capacità, tutto in automatico in base a regole sotto il tuo controllo.
I vantaggi immediati sono costi API più bassi, assenza di un singolo punto di fallimento nei rate limit e flessibilità nel cambiare provider senza toccare il tuo workflow.
Per mantenere efficiente il setup nel tempo, rivedi periodicamente i log di instradamento. Il log del server mostrerà quali route scattano più spesso e se modelli costosi vengono attivati per task che un’alternativa più economica potrebbe gestire. Regolare longContextThreshold e le regole di fallback in base all’uso reale è molto più efficace che impostarle una volta e dimenticarsene.
Infine, se il tuo lavoro coinvolge codice proprietario, ti consiglierei vivamente di instradare quelle richieste a un LLM locale tramite Ollama. È quello che faccio per qualsiasi lavoro con codice non rilasciato. Aggiungerlo come provider richiede meno di un minuto e le tue query più sensibili non lasciano mai la tua macchina.
Se vuoi fare un salto di qualità nello sviluppo di applicazioni AI, ti consiglio vivamente di iscriverti al nostro percorso di competenze AI Engineering with LangChain. I contenuti didattici sono AI‑native e ti danno accesso a un tutor personale che ti insegna esattamente le competenze necessarie per diventare davvero pro nella progettazione di workflow AI.
Corsi di AI
Programma
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



