Lernpfad
AI Engineering with LangChain
21 Std.
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleAls ich Claude Code intensiver eingesetzt habe, fielen mir schnell zwei Dinge auf: Die Qualität ist erstklassig – und die Rechnung zeigt es. Jede Anfrage, ob dreizeilige Docstring oder kompletter Architektur-Refactor, trifft denselben Anthropic-Endpunkt zum gleichen Tarif.
Mit der Zeit erzeugt diese Abhängigkeit von einem einzigen Anbieter nicht nur Kostendruck, sondern auch Risiko. Außerdem kann ein Rate-Limit bei einem Modell deinen gesamten Workflow ausbremsen.
Claude Code Router (CCR) adressiert beide Probleme direkt. Es ist ein Open-Source-Proxy, der deine Claude-Code-Anfragen abfängt, bevor sie einen Provider erreichen, und sie dann an das Backend-Modell weiterleitet, das für die jeweilige Aufgabe am meisten Sinn ergibt.
In diesem Tutorial zeige ich dir die komplette Einrichtung: Installation des Routers, Konfiguration von Multi-Provider-Routen und Härtung des Systems für den täglichen Einsatz. Um mitzumachen, besorge dir die API-Schlüssel der gewünschten Provider (DeepSeek, Gemini, OpenRouter oder ein anderes unterstütztes Backend) und öffne dein Terminal. Legen wir los.
Für Inspiration zu neuen LLMs und ihren Stärken wirf einen Blick in unsere Guides zu diesen aktuellen Modellen:
Bevor wir in die Einrichtung einsteigen, lohnt sich ein Blick darauf, was CCR genau ist und warum es so funktioniert. Falls du noch nicht mit Claude Code gearbeitet hast, lies zuerst unseren Claude Code 2.1 Praxis-Guide.
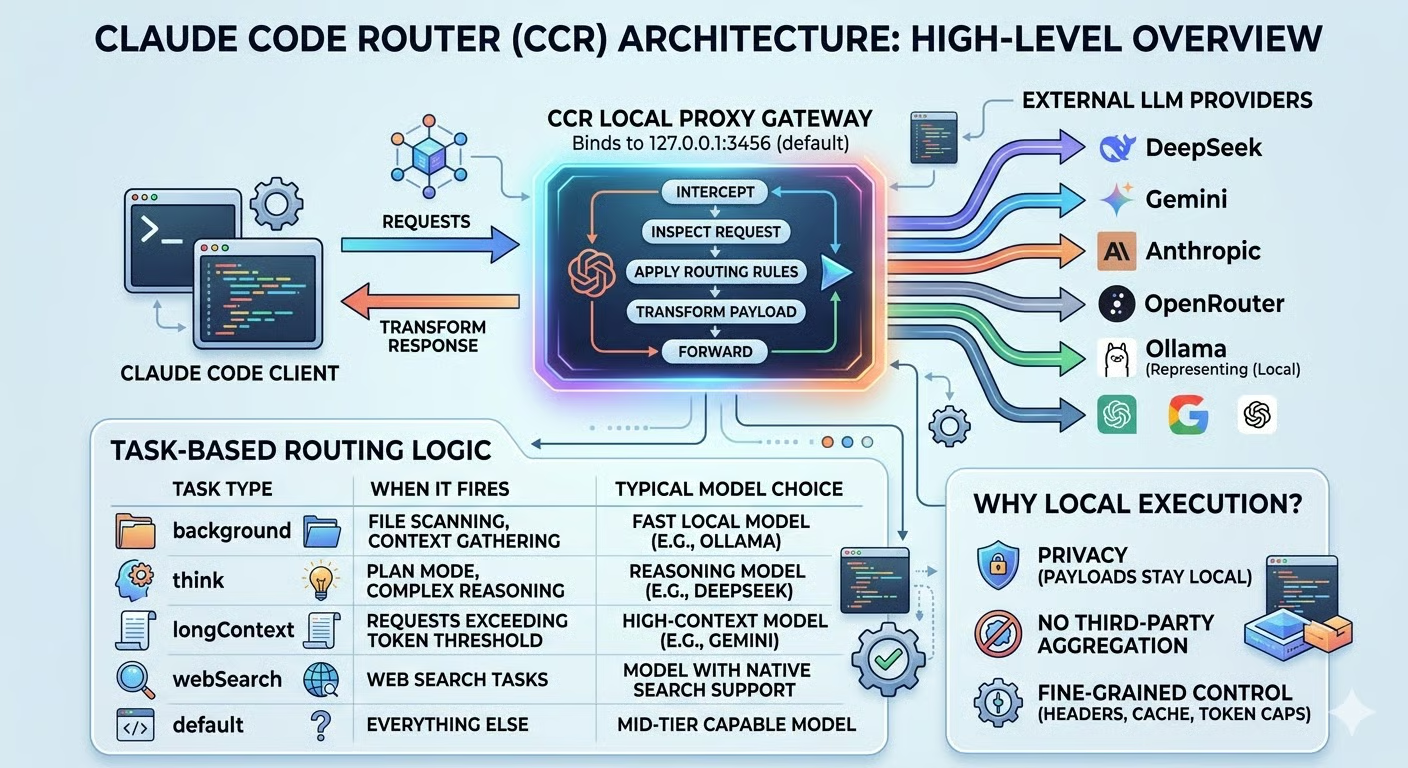
Claude Code Router ist ein lokales Proxy-Gateway. Beim Start bindet es sich an einen Port auf deinem Rechner (standardmäßig 127.0.0.1:3456) und sitzt zwischen deinem Claude-Code-Client und externen LLM-Providern. Aus Sicht von Claude Code spricht es nur mit einem lokalen Endpoint. Unter der Haube entscheidet CCR in Echtzeit, wohin die Anfrage tatsächlich geht.
Das Kernproblem, das es löst, ist die Abhängigkeit von einem einzigen Anbieter. Wenn alles über einen Provider läuft, übernimmst du dessen gesamte Einschränkungen:
CCR eliminiert das, indem du Routingregeln definierst, die Modelle automatisch je nach Aufgabentyp, Tokenanzahl oder eigener Logik wechseln. Ein Hintergrund-Dateiscan braucht nicht dasselbe Modell wie eine Plan Mode-Reasoning-Session – und mit CCR nutzt er auch nicht dasselbe.
Was CCR von direkten Provider-APIs oder Cloud-Aggregatoren unterscheidet, ist der Ausführungsort.
Weil der Proxy lokal läuft, passieren deine Request-Payloads keinen Drittanbieter-Aggregationsdienst, bevor sie ihr Ziel erreichen. Außerdem hast du granulare Kontrolle über die Request-Transformation – inklusive Header-Anpassungen, Entfernen von Cache-Feldern und Begrenzen von Token-Limits – über ein Transformersystem, das vollständig auf deinem Rechner arbeitet.
Für mich macht genau dieses lokale Ausführungsmodell CCR wirklich praxistauglich statt nur pfiffig: Das Ergebnis ist ein Setup, das kosteneffizienter, robuster und privater ist, als alles über einen einzelnen Cloud-Provider zu routen.
Mit einem klaren Bild dessen, was CCR leistet, schauen wir uns an, wie es unter der Haube funktioniert und was du vor der Installation brauchst.
Wenn du die Architektur von CCR verstehst, wird die Konfiguration deutlich einfacher. Das Proxy-Muster klickt schnell, sobald man es Ende-zu-Ende sieht.
Beim Start fängt CCR alle ausgehenden Requests von deinem Terminal ab, bevor sie den standardmäßigen Anthropic-Endpunkt erreichen. Für jede Anfrage:
Die Antwort kommt denselben Weg zurück und wird wieder in das Format transformiert, das Claude Code erwartet – der Client merkt von alledem nichts.
Der Schlüsselmechanismus bei dieser Abfanglogik ist das aufgabenbasierte Routing. CCR klassifiziert eingehende Anfragen nach Typ und mappt sie auf das passende Modell. So verhalten sich die wichtigsten Aufgabenkategorien in der Praxis:
|
Aufgabentyp |
Wann es greift |
Typische Modellauswahl |
|
|
Dateiscans, Kontextaufbau |
Schnelles lokales Modell (z. B. Ollama) |
|
|
Plan Mode, komplexes Reasoning |
Reasoning-Modell (z. B. DeepSeek) |
|
|
Anfragen über dem Token-Schwellenwert |
High-Context-Modell (z. B. Gemini) |
|
|
Websuche-Aufgaben |
Modell mit nativer Suchunterstützung |
|
|
Alles andere |
Leistungsstarkes Mittelklasse-Modell |
Jeder Aufgabentyp bekommt das richtige Werkzeug – ganz ohne manuelles Eingreifen, sobald alles konfiguriert ist. Aus meiner Erfahrung bringt die background-Route den schnellsten spürbaren Effekt: Diese stillen Dateiscans laufen während einer Codingsession ständig, und vor CCR hatte ich keine Ahnung, wie sehr sie sich heimlich summieren.
Bevor du CCR installierst, stelle Folgendes sicher:
Node.js v18 oder neuer als Laufzeitumgebung
npm als Paketmanager
Claude Code global installiert (npm install -g @anthropic-ai/claude-code)
Mindestens ein Modell-Backend – entweder ein API-Schlüssel eines unterstützten externen Providers (DeepSeek, Gemini, OpenRouter, Groq, Volcengine, SiliconFlow u. a.) oder eine lokale Ollama-Instanz mit bereits gezogenem Modell, falls du externe Provider komplett vermeiden möchtest
Du brauchst nicht sofort Accounts bei allen Providern. Ein funktionierendes Backend reicht für dieses Tutorial, weitere kannst du später ergänzen.
Für einen Vergleich von Claude Code mit einer der populärsten Alternativen lies unseren Beitrag OpenClaw vs Claude Code.
Jetzt, da Konzepte und Voraussetzungen klar sind, bauen wir das Setup Schritt für Schritt auf.
Mit den Voraussetzungen kannst du CCR global via npm installieren. Unter Linux kann es bei globalen Installationen zu Berechtigungsfehlern kommen, weil npm nach /usr/lib/node_modules schreibt, das root gehört. Die empfohlene Lösung ist, das globale npm-Verzeichnis in einen Ordner umzuleiten, der deinem Nutzer gehört – nicht sudo zu verwenden:
mkdir -p ~/.npm-global
npm config set prefix '~/.npm-global'
export PATH=~/.npm-global/bin:$PATH
Damit die PATH-Änderung dauerhaft ist, füge die export-Zeile zu deiner ~/.bashrc oder ~/.zshrc hinzu und lade die Shell neu. Dann installiere CCR:
npm install -g @musistudio/claude-code-routerDamit steht das ccr-CLI systemweit in deiner Shell zur Verfügung. Als Nächstes startest du den Routerdienst:
ccr startCCR bindet standardmäßig an http://127.0.0.1:3456. Sobald im Start-Output steht, dass der Dienst am Port lauscht, ist der Proxy bereit.
Die komplette CCR-Konfiguration liegt unter ~/.claude-code-router/config.json. Bevor du mehrere Provider verdrahtest, empfehle ich, mit einem einzelnen, verlässlich funktionierenden Provider zu starten, um Variablen auszuschließen und die Basis zu verifizieren.
OpenRouter ist hier ein guter Startpunkt und meine erste Wahl bei einem neuen Rechner. Du erhältst Zugriff auf Dutzende Modelle, darunter mehrere in der Free-Tier, über einen einzigen API-Schlüssel – ideal, um die Routing-Schicht zum Laufen zu bringen, bevor du dich auf konkrete Provider festlegst. Registriere dich und hole dir einen Key bei OpenRouter.
Hier eine Minimal-Konfiguration mit OpenRouter:
{
  "Providers": [
    {
      "name": "openrouter",
      "api_base_url": "https://openrouter.ai/api/v1/chat/completions",
      "api_key": "YOUR_OPENROUTER_API_KEY",
      "models": ["openai/gpt-oss-120b:free"],
      "transformer": {
        "use": ["openrouter"]
      }
    }
  ],
  "Router": {
    "default": "openrouter,openai/gpt-oss-120b:free"
  }
}
Wichtige Hinweise:
api_base_url muss auf den vollständigen Chat-Completions-Endpoint des Providers zeigen, nicht nur auf die Domain.
transformer legt fest, welchen eingebauten Payload-Adapter CCR nutzen soll, da Provider unterschiedliche Request-Formate erwarten. Die Übersetzung passiert transparent.
Router.default setzt das Fallback-Modell für jede Anfrage, die keiner spezifischeren Regel entspricht – im provider,model-Format.
Aus Sicherheitsgründen solltest du Keys nicht hart im File hinterlegen. CCR unterstützt Environment-Variablen-Interpolation: Ersetze YOUR_OPENROUTER_API_KEY durch $OPENROUTER_API_KEY und exportiere die Variable in deiner Shell. Die Interpolation funktioniert rekursiv durch die gesamte Config und skaliert sauber, wenn du weitere Provider ergänzt.
Mit der Config startest du Claude Code über den Router mit einem einzigen Befehl:
ccr codeDas war's. ccr code startet Proxy und Claude Code gleichzeitig und konfiguriert die Umgebung automatisch vor. Du musst ccr start nicht separat ausführen.
Um zu prüfen, ob das Routing aktiv ist, sieh in den Ordner ~/.claude-code-router/logs/. Eine Datei ccr-*.log bestätigt, dass der Proxy läuft und Anfragen empfängt. Du kannst sie in Echtzeit verfolgen:
tail -f ~/.claude-code-router/logs/$(ls -t ~/.claude-code-router/logs/ | head -1)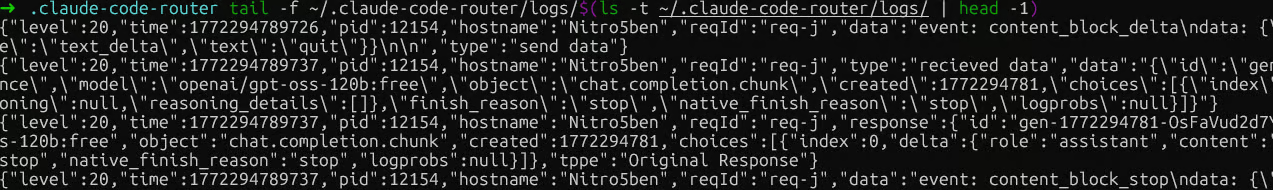
Claude Code Router Logs
Zwei Dinge zur Verifikation. Die Claude-Code-Kopfzeile zeigt immer dasaktuelle Standard-Claude-Modell an – unabhängig davon, wohin CCR tatsächlich routet, denn sie spiegelt deine Anthropic-Session wider, nicht das aktive Backend. Fragst du das Modell „Welches Modell bist du?“, antwortet es ebenfalls „Claude Sonnet 4.6“, weil der Claude-Code-Client diese Identität vorgibt. Beides ist kein verlässliches Signal.
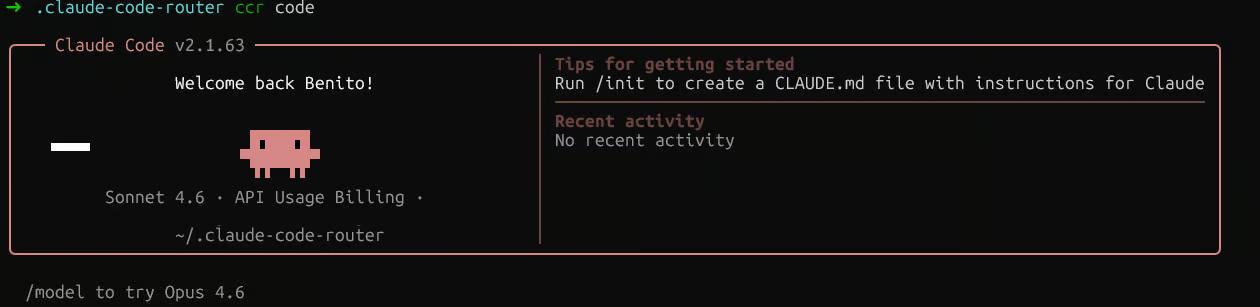
Claude Code Router Session
Das Log ist die einzige Quelle der Wahrheit. Suche im Response-Eintrag nach dem Feld „model“. Wenn dort zum Beispiel "model":"openai/gpt-oss-120b:free" steht, funktioniert das Routing.
Wenn du CCR persistent machen willst, sodass du den claude-Befehl direkt ohne ccr code nutzen kannst, füge Folgendes in ~/.bashrc oder ~/.zshrc ein:
eval "$(ccr activate)"Achte dann nur darauf, dass ccr start vorher läuft, denn activate setzt nur Umgebungsvariablen und startet den Dienst nicht.
Nachdem die Basis steht, erweitern wir die Config, um verschiedene Aufgabentypen an unterschiedliche Provider zu routen. Hier eine umfangreichere Router-Konfiguration:
{
  "Router": {
    "default": "deepseek,deepseek-chat",
    "background": "ollama,qwen2.5-coder:latest",
    "think": "deepseek,deepseek-reasoner",
    "longContext": "openrouter,google/gemini-2.5-pro-preview",
    "longContextThreshold": 60000,
    "webSearch": "gemini,gemini-2.5-flash"
  }
}
Jeder Schlüssel mappt eine Aufgabenkategorie auf ein "provider,model"-Paar:
Die background-Route übernimmt Datei- und Kontextscans. Diese können problemlos an ein lokales Ollama-Modell gehen – kostenfrei –, und genau diese Änderung hat meine monatlichen API-Kosten am stärksten gesenkt.
Die think-Route fängt Plan Mode und komplexes Reasoning ab, wo ein Modell wie deepseek-reasoner seinen Preis wert ist.
longContext greift automatisch, sobald eine Anfrage longContextThreshold Tokens überschreitet (standardmäßig 60.000) und leitet ohne manuelles Umschalten an ein Hochkapazitätsmodell weiter.
Bei webSearch muss das Modell selbst native Websuche unterstützen. Wenn du über OpenRouter routest, hänge zusätzlich den Suffix :online an den Modellnamen (z. B. "anthropic/claude-3.5-sonnet:online").
Für Resilienz gegen Rate-Limits erlaubt dir der benutzerdefinierte Router von CCR, Fallback-Logik in JavaScript zu definieren. Erstelle eine Datei an einem beliebigen Pfad, verweise in der Config mit "CUSTOM_ROUTER_PATH": "/path/to/custom-router.js" darauf und exportiere eine asynchrone Funktion, die einen "provider,model"-String oder null (für Fallback auf die Standardregeln) zurückgibt:
module.exports = async function router(req, config) {
  // Primärlogik hier. Gib null zurück, um auf die in der Config definierten Regeln zurückzufallen.
  return null;
};
Hier implementierst du z. B. Retry-bei-Rate-Limit, indem du einen 429-Response erkennst und automatisch auf einen sekundären Provider umleitest. Denk daran, nach jeder Config-Änderung den Dienst neu zu starten:
ccr restartWenn das Routing läuft, geht es darum, das System beobachtbar, sicher und im Fehlerfall leicht zu debuggen.
CCR bietet zwei separate Loggingsysteme, die du kennen solltest:
Server-Logs erfassen HTTP-Requests, API-Aufrufe und Server-Events. Sie werden unter ~/.claude-code-router/logs/ in Dateien ccr-*.log geschrieben. Dieses Log nutzt du in der Praxis am häufigsten.
Applikations-Logs halten Routingentscheidungen fest und liegen unter ~/.claude-code-router/claude-code-router.log, wobei die Datei je nach Setup und Log-Level nicht immer vorhanden ist.
Ein regelmäßiger Blick ins Server-Log zeigt klar, welche Routen feuern, welche Modelle aufgerufen werden und ob Provider-Fehler auftreten.
Für Echtzeit-Transparenz hat CCR ab v1.0.40 ein Statusline-Tool, das du mit ccr ui aktivierst. Läuft es, siehst du direkt im Terminal, welches Modell gerade welche Anfrage bedient.
Beim Budget sind die effektivsten Leitplanken deine Routingregeln. Wenn background und default auf günstigere oder lokale Modelle zeigen, verhinderst du, dass Premium-Modelle für niedrigwertige Aufgaben anspringen. Reserviere think und longContext für Modelle, die ihren Preis rechtfertigen, und setze den Token-Schwellenwert für longContext so hoch, wie es dein Workflow erlaubt.
Aus meiner Sicht ist diese Konfigurationsdisziplin verlässlicher als reaktives Monitoring – sie verhindert Überausgaben, statt sie nur im Nachhinein zu erkennen.
Credential-Management verdient besondere Aufmerksamkeit, gerade wenn die Providerliste wächst. Meine einfachen Regeln:
Lege keine API-Keys im Klartext in config.json ab, wenn die Datei versioniert ist. Nutze immer Environment-Variablen-Interpolation mit "$PROVIDER_API_KEY" und exportiere Keys aus deinem Shell-Profil oder einem Secrets-Manager.
Belasse den Proxy auf localhost für individuelle Developer-Setups. Wenn du keinen APIKEY in der Config setzt, bindet CCR den Server automatisch nur an 127.0.0.1 und verhindert externen Zugriff auf geteilten Maschinen oder Netzwerken.
Setze einen APIKEY für Team-Deployments, wenn der Host auf 0.0.0.0 öffnen musst. Jeder Client, der sich verbindet, muss den Key im Header Authorization: Bearer oder x-api-key mitsenden.
Logging deaktivieren oder reduzieren, wenn du sensiblen Code routest. Logging ist standardmäßig aktiviert ("LOG": true). Setze "LOG": false, um keine Payloads auf Disk zu schreiben, oder "LOG_LEVEL": "warn", um ausführliche Debug-Ausgaben zu unterdrücken.
Praktisch ist, alle API-Keys im Shell-Profil zu halten und sie in config.json per $VAR_NAME zu referenzieren. So enthält die Config selbst keine Secrets und kann sicher geteilt oder versioniert werden.
Wenn du unsicher bist, ob ein Key in Logs landet, prüfe zuerst das Log-Level. Der schnelle Weg ist "LOG_LEVEL": "warn" – so reduzierst du, was auf Disk geschrieben wird, ohne Logging komplett abzuschalten.
Wenn etwas klemmt, spart eine gestufte Diagnose viel Zeit. Beginne außen und arbeite dich nach innen vor.
Führe ccr code aus und achte auf die Startbestätigung des Dienstes. Ist der Port belegt oder der Dienst startet nicht, zeigt Claude Code Verbindungsfehler an.
Sieh für Details in die Server-Logs unter ~/.claude-code-router/logs/. Die meisten Startfehler sind Portkonflikte oder eine fehlerhafte config.json.
Der häufigste Config-Fehler ist ein Unterschied zwischen dem Modellnamen in Providers und dem in Router. Beide müssen identisch sein.
Wenn sie abweichen, sendet CCR eine Anfrage ohne Modell-Feld und du siehst Missing model in request body. Nach der Korrektur immer ccr restart ausführen.
Wenn der Modellname stimmt, aber Anfragen mit 404 fehlschlagen, prüfe die Account-Einstellungen beim Provider. OpenRouter blockiert z. B. standardmäßig, dass Free-Modelle Daten an Dritte senden. Dann erscheint No endpoints found matching your data policy.
Die Lösung: In den OpenRouter-Privatsphäre-Einstellungen die Nutzung von Free-Modellen erlauben. Andere Provider haben ähnliche Schalter, die du bei unerwarteten 4xx-Fehlern prüfen solltest.
Wenn Anfragen den Provider erreichen, aber Responses fehlerhaft sind oder Tool-Calls scheitern, fehlt meist ein Transformer oder der falsche ist konfiguriert. Prüfe, welcher eingebaute Transformer für deinen Provider vorgesehen ist, und stelle sicher, dass er im "use"-Array steht.
In den meisten Fällen lokalisierst du mit diesen vier Schritten das Problem schnell. Das Server-Log zeigt sowohl den ausgehenden Request als auch die rohe Provider-Response – genug, um jeden Fehlerort nachvollziehen zu können.
Du hast jetzt eine funktionierende Multi-Provider-Routing-Infrastruktur auf Basis von Claude Code. Hintergrundaufgaben gehen an schnelle lokale Modelle, reasoning-lastige Arbeit an spezialisierte Modelle und lange Kontexte an Hochkapazitätsanbieter – alles automatisch nach deinen Regeln.
Die unmittelbaren Vorteile: geringere API-Kosten, keine Single-Point-of-Failure durch Rate-Limits und die Flexibilität, Provider zu wechseln, ohne deinen Workflow anzufassen.
Um das Setup langfristig effizient zu halten, prüfe deine Routing-Logs regelmäßig. Das Server-Log zeigt dir, welche Routen am häufigsten feuern und ob teure Modelle für Aufgaben ausgelöst werden, die günstigere Alternativen erledigen könnten. Das Anpassen von longContextThreshold und Fallback-Regeln anhand der realen Nutzung ist wesentlich wirksamer als eine einmalige Einstellung.
Wenn du mit proprietärem Code arbeitest, empfehle ich außerdem dringend, diese Anfragen an ein lokales LLM über Ollama zu routen. Das mache ich immer bei Client-Arbeit mit unveröffentlichtem Code. Das Hinzufügen als Provider dauert unter einer Minute – und deine sensibelsten Queries verlassen nie deinen Rechner.
Wenn du deine Kompetenzen in der Entwicklung von KI-Anwendungen auf das nächste Level bringen willst, melde dich für unseren Lernpfad AI Engineering with LangChain an. Die Lehrinhalte sind KI-native: Du hast eine persönliche Tutorin bzw. einen persönlichen Tutor an deiner Seite, der dir genau die Kompetenzen vermittelt, die du brauchst, um KI-Workflows professionell zu entwickeln.
KI-Kurse
Lernpfad
Kurs
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleBlog
Tutorial
Derrick Mwiti
10 Min.
Tutorial
Kurtis Pykes
15 Min.
Tutorial
Adel Nehme
6 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Mark Pedigo
10 Min.