Programa
AI Engineering with LangChain
21 h
Cuando empecé a usar intensivamente Claude Code, me di cuenta de dos cosas muy rápido: la calidad es excelente y la factura lo confirma. Cada solicitud, ya sea un docstring de tres líneas o una refactorización arquitectónica completa, golpea el mismo endpoint de Anthropic al mismo precio.
Con el tiempo, esa dependencia de un único proveedor no solo presiona los costes; también introduce riesgo. Además, un límite de tasa en un modelo puede paralizar por completo tu flujo de trabajo.
Claude Code Router (CCR) ataja ambos problemas de frente. Es un proxy de código abierto que intercepta tus solicitudes de Claude Code antes de que lleguen a cualquier proveedor y redirige cada petición al modelo backend que más sentido tenga para esa tarea.
En este tutorial, te guiaré por toda la configuración: instalación del router, definición de rutas multiproveedor y endurecimiento del sistema para uso operativo diario. Para seguirlo, ten a mano las claves de API de los proveedores que quieras usar (DeepSeek, Gemini, OpenRouter u otro backend compatible) y abre tu terminal. Vamos allá.
Si buscas inspiración sobre nuevos LLM y en qué destacan, echa un vistazo a nuestras guías sobre estos modelos recientes:
Antes de entrar en la configuración, conviene entender qué es realmente CCR y por qué funciona como funciona. Si aún no has trabajado con Claude Code, te recomendamos leer primero nuestra guía práctica de Claude Code 2.1.
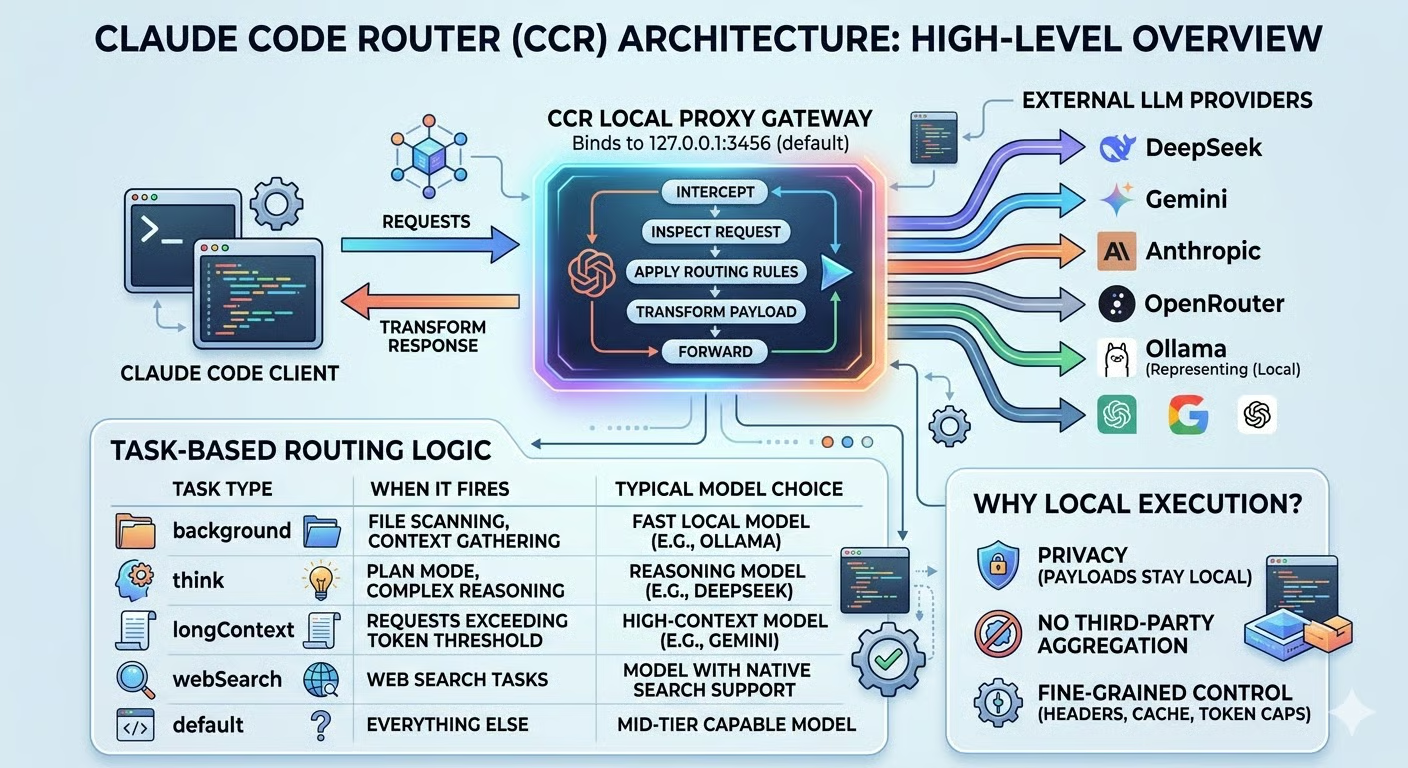
Claude Code Router es una pasarela proxy local. Al iniciarlo, se vincula a un puerto de tu máquina (127.0.0.1:3456 por defecto) y se sitúa entre tu cliente de Claude Code y cualquier proveedor externo de LLM. Desde la perspectiva de Claude Code, solo habla con un endpoint local. Bajo el capó, CCR decide en tiempo real adónde va realmente esa solicitud.
El problema principal que resuelve es la dependencia de un único proveedor. Cuando todo pasa por el mismo proveedor, heredas todas sus limitaciones:
CCR elimina eso permitiéndote definir reglas de enrutamiento que cambian de modelo automáticamente según el tipo de tarea, el recuento de tokens o la lógica personalizada que escribas. Un escaneo de archivos en segundo plano no necesita el mismo modelo que una sesión de razonamiento en Plan Mode, y con CCR, no usará el mismo.
Lo que diferencia a CCR de las APIs directas de proveedores o de los agregadores en la nube es dónde se ejecuta.
Al ejecutarse el proxy de forma local, tus cargas de solicitud no pasan por un servicio de agregación de terceros antes de llegar a su destino. Además, obtienes control granular sobre la transformación de las solicitudes, incluido modificar cabeceras, eliminar campos de caché y limitar tokens, mediante un sistema de transformadores que opera íntegramente en tu máquina.
Para mí, ese modelo de ejecución local es lo que hace que CCR sea realmente práctico y no solo una argucia ingeniosa: el resultado es una configuración más eficiente en costes, más resiliente y más privada que enrutar todo a través de un único proveedor en la nube.
Con una visión clara de lo que hace CCR, veamos cómo funciona por dentro y qué necesitas antes de instalarlo.
Entender la arquitectura de CCR facilita mucho la configuración, y el patrón de proxy encaja rápido cuando lo ves de extremo a extremo.
Cuando inicias CCR, intercepta todas las solicitudes salientes desde tu terminal antes de que lleguen al endpoint por defecto de Anthropic. Para cada solicitud:
La respuesta vuelve del mismo modo, transformada de nuevo al formato que espera Claude Code, por lo que el cliente no percibe ningún cambio.
El mecanismo clave dentro de esa interceptación es el enrutamiento por tipo de tarea. CCR clasifica las solicitudes entrantes por tipo y las asigna al modelo adecuado. Así se comportan en la práctica las categorías principales:
|
Tipo de tarea |
Cuándo se activa |
Modelo habitual |
|
|
Escaneo de archivos, recopilación de contexto |
Modelo local rápido (p. ej., Ollama) |
|
|
Plan Mode, razonamiento complejo |
Modelo de razonamiento (p. ej., DeepSeek) |
|
|
Peticiones que superan el umbral de tokens |
Modelo con gran contexto (p. ej., Gemini) |
|
|
Tareas de búsqueda web |
Modelo con soporte nativo de búsqueda |
|
|
El resto |
Modelo intermedio capaz |
Cada tipo de tarea recibe la herramienta adecuada y ninguna requiere intervención manual una vez configurada. En mi experiencia, la ruta background ofrece el mayor retorno inmediato: esas solicitudes silenciosas de escaneo de archivos ocurren constantemente durante una sesión de programación y, antes de CCR, no tenía ni idea de cuánto sumaban sin hacer ruido.
Antes de instalar CCR, asegúrate de tener lo siguiente:
Node.js v18 o superior como entorno de ejecución
npm como gestor de paquetes
Claude Code instalado globalmente (npm install -g @anthropic-ai/claude-code)
Al menos un backend de modelos, ya sea una clave de API de un proveedor externo compatible (DeepSeek, Gemini, OpenRouter, Groq, Volcengine, SiliconFlow, entre otros), o una instancia local de Ollama con un modelo ya descargado, si prefieres evitar proveedores externos por completo
No necesitas cuentas de todos los proveedores desde el principio. Un backend funcional basta para completar este tutorial, y siempre puedes añadir más después.
Para comparar Claude Code con una de sus alternativas más populares, te recomiendo leer nuestro artículo sobre OpenClaw vs Claude Code.
Ahora que los conceptos y requisitos están claros, construyamos la configuración paso a paso.
Con los requisitos listos, puedes instalar CCR globalmente con npm. En Linux, sin embargo, puede que encuentres un error de permisos al instalar paquetes globales porque npm intenta escribir en /usr/lib/node_modules, que pertenece a root. La solución recomendada es redirigir el directorio global de npm a una carpeta de tu usuario en lugar de ejecutar el comando con sudo:
mkdir -p ~/.npm-global
npm config set prefix '~/.npm-global'
export PATH=~/.npm-global/bin:$PATH
Para hacer permanente ese cambio en PATH, añade la línea export a tu ~/.bashrc o ~/.zshrc y recarga la shell. Luego instala CCR:
npm install -g @musistudio/claude-code-routerEsto habilita el CLI ccr globalmente en tu terminal. A continuación, inicia el servicio del router:
ccr startCCR se vincula a http://127.0.0.1:3456 por defecto. En cuanto veas en la salida de inicio que el servicio está ligado al puerto, el proxy estará listo para aceptar solicitudes.
Toda la configuración de CCR vive en ~/.claude-code-router/config.json. Antes de cablear varios proveedores, te recomiendo empezar con un único proveedor fiable para aislar variables y confirmar que la base funciona.
OpenRouter es un buen punto de partida, y es mi primera opción cuando configuro CCR en una máquina nueva. Te da acceso a decenas de modelos, incluidos varios de nivel gratuito, con una única clave de API, lo que lo hace ideal para poner en marcha la capa de enrutamiento antes de comprometerte con proveedores específicos. Puedes registrarte y conseguir una clave en OpenRouter.
Aquí tienes una configuración mínima con OpenRouter:
{
  "Providers": [
    {
      "name": "openrouter",
      "api_base_url": "https://openrouter.ai/api/v1/chat/completions",
      "api_key": "YOUR_OPENROUTER_API_KEY",
      "models": ["openai/gpt-oss-120b:free"],
      "transformer": {
        "use": ["openrouter"]
      }
    }
  ],
  "Router": {
    "default": "openrouter,openai/gpt-oss-120b:free"
  }
}
Algunos puntos a tener en cuenta:
api_base_url debe apuntar al endpoint completo de chat completions del proveedor, no solo al dominio base.
transformer especifica qué adaptador de payload integrado debe usar CCR, ya que cada proveedor espera formatos distintos. El transformador gestiona esa traducción de forma transparente.
Router.default define el modelo de reserva para cualquier solicitud que no coincida con una regla más específica, usando la sintaxis provider,model.
Por seguridad, evita incrustar claves directamente en el archivo. CCR admite interpolación de variables de entorno: sustituye YOUR_OPENROUTER_API_KEY por $OPENROUTER_API_KEY y exporta la variable en tu shell. La interpolación funciona de forma recursiva por toda la configuración, así que este patrón escala bien cuando añadas más proveedores.
Con la configuración lista, lanzar Claude Code a través del router es un único comando:
ccr codeEso es todo. ccr code inicia el servicio proxy y lanza Claude Code a la vez, con el entorno preconfigurado automáticamente. No necesitas ejecutar ccr start por separado antes.
Para verificar que el enrutamiento está activo, revisa la carpeta ~/.claude-code-router/logs/. Un archivo llamado ccr-*.log confirma que el proxy se ha iniciado y está recibiendo solicitudes. Puedes seguirlo en tiempo real:
tail -f ~/.claude-code-router/logs/$(ls -t ~/.claude-code-router/logs/ | head -1)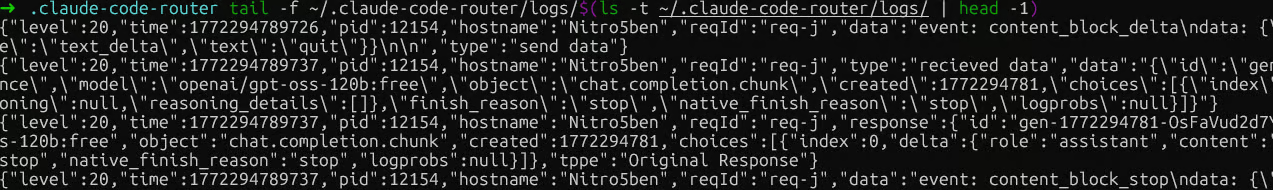
Registros de Claude Code Router
Dos cosas a saber sobre la verificación. El encabezado de Claude Code siempre muestra el modelo predeterminado actual de Claude, independientemente de a qué modelo esté enrutando CCR, porque refleja tu sesión con Anthropic, no el backend activo. Si preguntas al modelo «¿qué modelo eres?», también dirá “Claude Sonnet 4.6”, porque eso es lo que el cliente de Claude Code le indica que diga. Ninguna de las dos es una señal fiable.
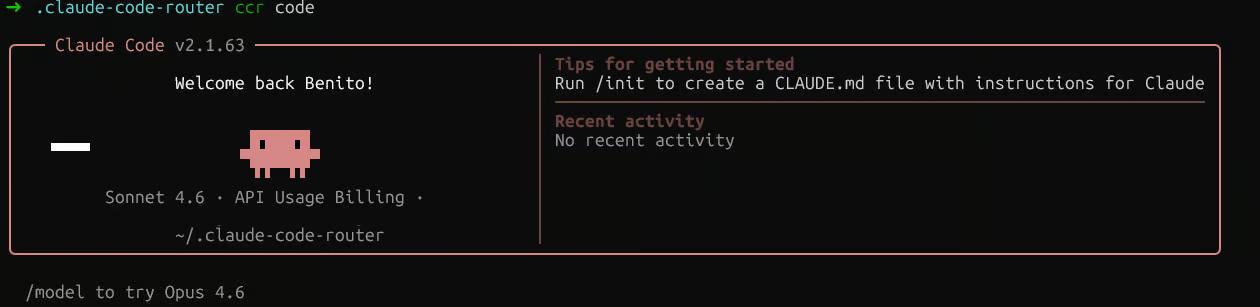
Sesión de Claude Code Router
El log es la única fuente fiable. Busca el campo "model" en las entradas de respuesta. Si ves ahí el nombre del modelo que configuraste, por ejemplo, "model":"openai/gpt-oss-120b:free", el enrutamiento funciona.
Si quieres hacer CCR persistente para poder usar el comando claude directamente sin ccr code, añade esto a tu ~/.bashrc o ~/.zshrc:
eval "$(ccr activate)"Solo asegúrate de ejecutar ccr start antes en ese caso, ya que activate solo establece variables de entorno y no inicia el servicio.
Una vez verificada la base, ampliemos la configuración para enrutar distintos tipos de tareas a diferentes proveedores. Aquí tienes una configuración más completa de Router:
{
  "Router": {
    "default": "deepseek,deepseek-chat",
    "background": "ollama,qwen2.5-coder:latest",
    "think": "deepseek,deepseek-reasoner",
    "longContext": "openrouter,google/gemini-2.5-pro-preview",
    "longContextThreshold": 60000,
    "webSearch": "gemini,gemini-2.5-flash"
  }
}
Cada clave asigna una categoría de tarea a un par "provider,model":
La ruta background gestiona solicitudes de escaneo de archivos y recopilación de contexto. Pueden ir sin problema a un modelo local de Ollama, manteniéndolas gratis, y este único cambio fue el que más redujo mi factura mensual de APIs.
La ruta think captura Plan Mode y tareas de razonamiento complejo, donde un modelo como deepseek-reasoner se amortiza solo.
La ruta longContext se activa automáticamente cuando una solicitud supera el umbral de longContextThreshold tokens (por defecto, 60.000), redirigiendo a un modelo de gran capacidad sin que tengas que cambiar nada manualmente.
Para webSearch, ten en cuenta que el propio modelo debe admitir búsqueda web de forma nativa. Si enrutas a través de OpenRouter, también debes añadir el sufijo :online al nombre del modelo (por ejemplo, "anthropic/claude-3.5-sonnet:online").
Para resistir límites de tasa, la función de router personalizado de CCR te permite definir lógica de reserva en JavaScript. Crea un archivo en la ruta que prefieras, referéncialo en la configuración con "CUSTOM_ROUTER_PATH": "/path/to/custom-router.js" y exporta una función asíncrona que devuelva una cadena "provider,model" o null para recurrir a las reglas por defecto:
module.exports = async function router(req, config) {
  // Lógica principal aquí. Devuelve null para recurrir a las reglas definidas en config.
  return null;
};
Aquí es donde implementarías reintentos ante límites de tasa, por ejemplo detectando una respuesta 429 y reenrutando automáticamente a un proveedor secundario. Tras cualquier cambio en la configuración, recuerda reiniciar el servicio para aplicarlo:
ccr restartCon el enrutamiento funcionando, el foco pasa a mantener el sistema observable, seguro y fácil de depurar cuando algo falla.
CCR ofrece dos sistemas de logging que merece la pena conocer:
Logs a nivel de servidor cubren solicitudes HTTP, llamadas a API y eventos del servidor. Se escriben en ~/.claude-code-router/logs/ con nombre ccr-*.log. Es el log que más usarás en la práctica.
Logs a nivel de aplicación recogen decisiones de enrutamiento y se escriben en ~/.claude-code-router/claude-code-router.log, aunque este archivo puede no existir siempre según tu configuración y nivel de log.
Revisar periódicamente el log de servidor te da una imagen clara de qué rutas se activan, qué modelos se llaman y si hay errores de proveedores.
Para visibilidad en tiempo real, CCR incluye también una barra de estado (disponible desde la v1.0.40) que puedes habilitar con ccr ui. Una vez activa, muestra el estado de enrutamiento directamente en tu terminal mientras se ejecuta Claude Code, indicándote de un vistazo qué modelo atiende cada solicitud.
En cuanto al presupuesto, el mejor cortafuegos es tu propia configuración de enrutamiento. Si te aseguras de que las rutas background y default apunten a modelos más baratos o locales, evitas invocar modelos premium para tareas de poco valor. Reserva think y longContext para modelos cuyo coste esté justificado y mantén el umbral de longContext tan alto como tolere tu flujo de trabajo.
En mi experiencia, esta disciplina a nivel de configuración es más fiable que el monitoreo reactivo porque previene el sobrecoste antes de que ocurra, en lugar de detectarlo a posteriori.
La gestión de credenciales merece atención explícita, especialmente a medida que crece tu lista de proveedores. Las reglas que sigo son sencillas:
No incluyas claves de API en bruto en config.json si ese archivo está bajo control de versiones. Usa siempre interpolación de variables de entorno con la sintaxis "$PROVIDER_API_KEY" y exporta las claves desde tu perfil de shell o un gestor de secretos.
Mantén el proxy en localhost para configuraciones individuales de desarrollo. Si no defines APIKEY en la configuración, CCR obliga automáticamente al servidor a ligarse solo a 127.0.0.1, evitando accesos externos en máquinas o redes compartidas.
Define una APIKEY para despliegues en equipo si necesitas abrir el host a 0.0.0.0. Cada cliente que se conecte al router debe incluir esa clave en la cabecera Authorization: Bearer o x-api-key.
Desactiva o reduce el logging si enrutáis código sensible. El logging está activado por defecto ("LOG": true). Pon "LOG": false para no escribir las solicitudes en disco, o "LOG_LEVEL": "warn" para suprimir la salida de depuración detallada.
Una forma práctica de implementar esto es guardar todas tus claves de API en tu perfil de shell y referenciarlas mediante $VAR_NAME en config.json. Así, el archivo de configuración no contiene secretos y puede compartirse o versionarse con seguridad.
Si alguna vez dudas de si una clave está acabando en los logs, revisa primero el nivel de log. Cambiar a "LOG_LEVEL": "warn" es la forma más rápida de reducir lo que se escribe en disco sin desactivar el logging por completo.
Cuando algo falla, una secuencia de diagnóstico por capas ahorra mucho tiempo. Lo mejor es empezar por la capa más externa e ir hacia dentro.
Ejecuta ccr code y busca la confirmación de arranque del servicio. Si el puerto está ocupado o el servicio no ha podido iniciarse, verás errores de conexión rechazada en Claude Code.
Consulta los logs del servidor en ~/.claude-code-router/logs/ para más detalles. La mayoría de fallos de arranque se deben a un conflicto de puertos o a un config.json mal formado.
El error de configuración más común es una discrepancia entre el nombre del modelo en Providers y el de Router. Ambos deben ser idénticos.
Si difieren, CCR envía una solicitud sin campo de modelo y verás un error Missing model in request body. Tras corregir la configuración, ejecuta siempre ccr restart para recargarla.
Si el nombre del modelo es correcto pero las solicitudes siguen fallando con un 404, revisa la configuración de tu cuenta con el proveedor. OpenRouter, por ejemplo, tiene una política de privacidad por defecto que bloquea que los modelos gratuitos envíen datos a proveedores de terceros. Verás un error como No endpoints found matching your data policy.
La solución es ir a los ajustes de privacidad de OpenRouter y habilitar el uso de modelos gratuitos. Otros proveedores pueden tener conmutadores similares a nivel de cuenta que conviene revisar si te topas con 4xx inesperados.
Si las solicitudes llegan al proveedor pero las respuestas están mal formadas o fallan las llamadas a herramientas, normalmente falta un transformador o es incorrecto. Cruza tu proveedor con la lista de transformadores integrados y asegúrate de que el correcto está en el array "use".
En la mayoría de casos, trabajar estos cuatro pasos en orden aísla rápido el problema. El log de servidor captura tanto la solicitud saliente como la respuesta cruda del proveedor, dándote todo lo necesario para entender dónde ocurrió el fallo.
Ahora tienes una infraestructura de enrutamiento multiproveedor funcionando sobre Claude Code. Las tareas en segundo plano van a modelos locales rápidos, el trabajo con mucho razonamiento se enruta a modelos especializados y las solicitudes de gran contexto las atienden proveedores de alta capacidad, todo automáticamente según reglas que controlas.
Los beneficios inmediatos son menores costes de API, sin punto único de fallo por límites de tasa y la flexibilidad de cambiar de proveedor sin tocar tu flujo de trabajo.
Para mantener la configuración afinada en el tiempo, revisa periódicamente tus logs de enrutamiento. El log de servidor te mostrará qué rutas se activan con más frecuencia y si se están invocando modelos caros para tareas que podría gestionar una alternativa más económica. Ajustar longContextThreshold y las reglas de reserva según el uso real es mucho más eficaz que dejarlas fijas y olvidarse.
Por último, si tu trabajo implica código propietario, te recomendaría encarecidamente enrutar esas solicitudes a un LLM local mediante Ollama. Es lo que hago para cualquier proyecto de cliente con código no publicado. Añadirlo como proveedor lleva menos de un minuto y tus consultas más sensibles no salen de tu máquina.
Si quieres llevar tus habilidades en desarrollo de aplicaciones de IA al siguiente nivel, te recomiendo apuntarte a nuestro itinerario de aprendizaje AI Engineering with LangChain. El contenido es nativo de IA y tendrás un tutor personal que te enseñará exactamente lo que necesitas para convertirte en un auténtico profesional diseñando flujos de trabajo de IA.
Cursos de IA
Programa
Curso
Curso
blog
Abid Ali Awan
10 min
blog
Natassha Selvaraj
15 min
Tutorial
Abid Ali Awan
Tutorial
Moez Ali
12 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Ryan Ong
12 min