
लर्निंग पाथ
LangChain के साथ AI इंजीनियरिंग
21 घंटा
जब मैंने पहली बार Claude Code का अधिक इस्तेमाल शुरू किया, तो मुझे दो बातें जल्दी समझ आ गईं: गुणवत्ता उत्कृष्ट है, और बिल भी वैसा ही दिखता है। हर अनुरोध, चाहे वह तीन पंक्तियों का डॉकस्ट्रिंग हो या पूरा आर्किटेक्चरल रिफैक्टर, एक ही दर पर उसी Anthropic एंडपॉइंट पर जाता है।
समय के साथ, एक ही विक्रेता पर निर्भरता सिर्फ लागत का दबाव ही नहीं बनाती; यह जोखिम भी बढ़ाती है। इसका मतलब यह भी है कि एक मॉडल पर रेट लिमिट आपके पूरे वर्कफ़्लो को रोक सकती है।
Claude Code Router (CCR) इन दोनों समस्याओं को सीधे संबोधित करता है। यह एक ओपन-सोर्स प्रॉक्सी है जो आपके Claude Code अनुरोधों को किसी भी प्रदाता तक पहुँचने से पहले इंटरसेप्ट करता है, फिर हर अनुरोध को उस बैकएंड मॉडल पर री-डायरेक्ट करता है जो उस कार्य के लिए सबसे उपयुक्त हो।
इस ट्यूटोरियल में, मैं आपको पूरा सेटअप दिखाऊँगा: राउटर इंस्टॉल करना, मल्टी-प्रोवाइडर रूटिंग पाथवे कॉन्फ़िगर करना, और सिस्टम को दैनिक उपयोग के लिए मज़बूत बनाना। साथ चलने के लिए, जिन प्रदाताओं का आप उपयोग करना चाहते हैं उनके API कुंजियाँ लें (DeepSeek, Gemini, OpenRouter, या कोई अन्य समर्थित बैकएंड) और अपना टर्मिनल खोलें। शुरू करते हैं।
नए LLMs और उनकी क्षमताओं पर प्रेरणा के लिए, इन नवीनतम मॉडलों पर हमारे गाइड देखें:
सेटअप में उतरने से पहले, यह समझना ज़रूरी है कि CCR वास्तव में है क्या और यह जिस तरह काम करता है, क्यों करता है। यदि आपने अभी तक Claude Code के साथ काम नहीं किया है, तो पहले हमारा Claude Code 2.1 प्रैक्टिकल गाइड ज़रूर देखें।
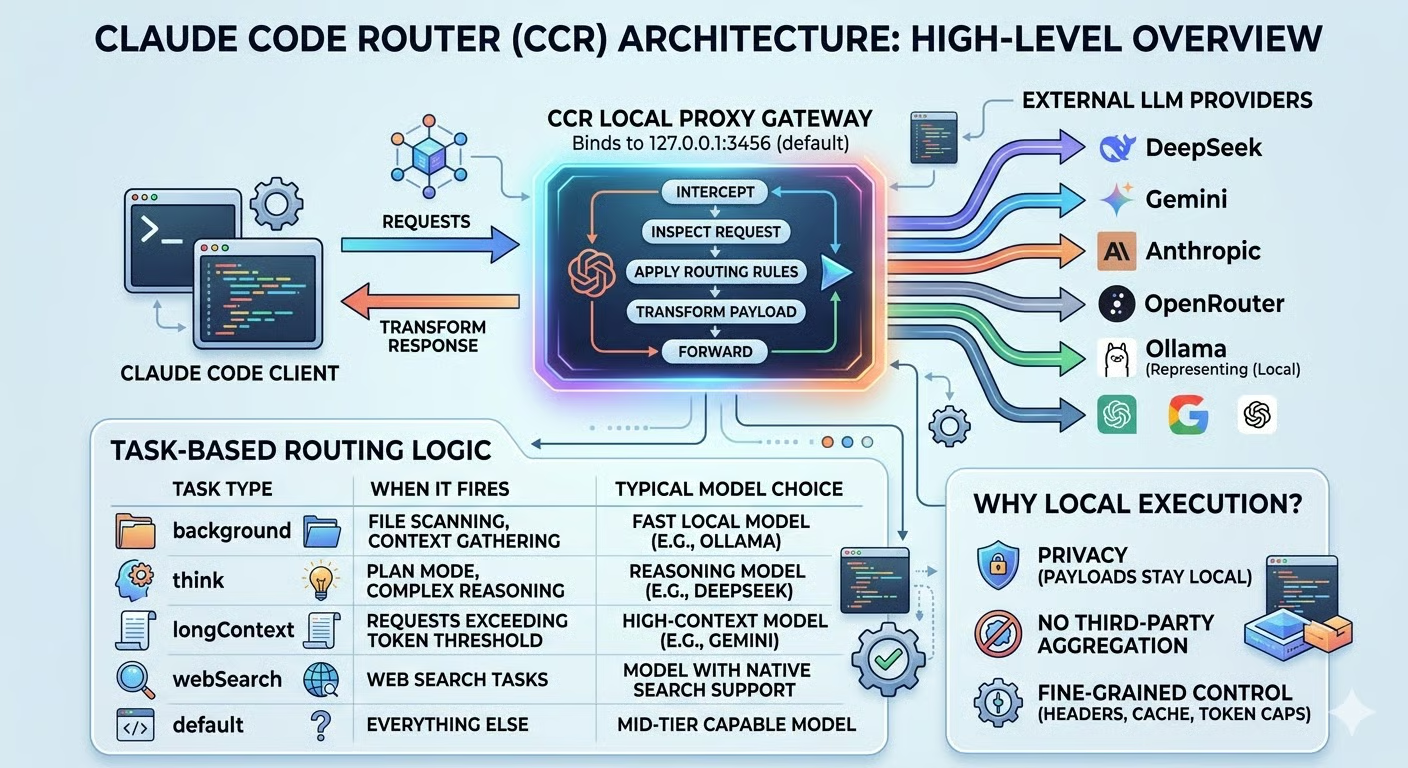
Claude Code Router एक लोकल प्रॉक्सी गेटवे है। जब आप इसे लॉन्च करते हैं, तो यह आपकी मशीन पर एक पोर्ट से बाइंड होता है (डिफ़ॉल्ट रूप से 127.0.0.1:3456) और आपके Claude Code क्लाइंट और किसी भी बाहरी LLM प्रदाता के बीच खुद को रखता है। Claude Code के नज़रिए से, वह बस एक लोकल एंडपॉइंट से बात कर रहा है। पर्दे के पीछे, CCR रियल टाइम में तय करता है कि वह अनुरोध वास्तव में कहाँ जाए।
यह जिस मूल समस्या को हल करता है वह है एकल-विक्रेता पर निर्भरता। जब सब कुछ एक ही प्रदाता से होकर जाता है, तो आप उस प्रदाता की सभी बाधाएँ विरासत में ले लेते हैं:
CCR आपको ऐसी रूटिंग नीतियाँ परिभाषित करने देता है जो कार्य के प्रकार, टोकन काउंट, या आपके लिखे कस्टम लॉजिक के आधार पर मॉडल अपने-आप स्विच कर दें—इस तरह वह समस्या दूर हो जाती है। बैकग्राउंड फ़ाइल स्कैन को Plan Mode की रीजनिंग सत्र जैसा मॉडल नहीं चाहिए, और CCR के साथ, वह ऐसा करेगा भी नहीं।
CCR को सीधे प्रदाता APIs या क्लाउड-आधारित एग्रीगेटर्स से जो चीज अलग करती है, वह है इसका रन होना कहाँ होता है।
क्योंकि प्रॉक्सी लोकल रूप से चलती है, आपके अनुरोध पेलोड किसी थर्ड-पार्टी एग्रीगेशन सेवा से गुज़रे बिना ही अपने गंतव्य तक पहुँचते हैं। आपको अनुरोध ट्रांसफ़ॉर्मेशन पर सूक्ष्म नियंत्रण भी मिलता है—हेडर संशोधित करना, कैश फ़ील्ड हटाना, और टोकन लिमिट कैप करना—एक ऐसे ट्रांसफ़ॉर्मर सिस्टम के ज़रिए जो पूरी तरह आपकी मशीन पर चलता है।
मेरे लिए, यही लोकल एग्ज़ीक्यूशन मॉडल CCR को महज़ एक चतुर वर्कअराउंड के बजाय सचमुच व्यावहारिक बनाता है: नतीजा एक ऐसा सेटअप है जो एकल क्लाउड विक्रेता के माध्यम से सब कुछ रूट करने की तुलना में अधिक किफायती, अधिक लचीला और अधिक निजी है।
CCR क्या करता है, यह स्पष्ट होने के बाद, देखते हैं कि यह अंदर से कैसे काम करता है और इंस्टॉल करने से पहले आपको क्या चाहिए।
CCR की आर्किटेक्चर समझ लेने से कॉन्फ़िगरेशन पर तर्क करना बहुत आसान हो जाता है, और एक बार एंड-टू-एंड पैटर्न देख लें तो प्रॉक्सी पैटर्न जल्दी समझ में आ जाता है।
जब आप CCR शुरू करते हैं, तो यह आपके टर्मिनल से निकलने वाले सभी आउटबाउंड अनुरोधों को डिफ़ॉल्ट Anthropic एंडपॉइंट तक पहुँचने से पहले इंटरसेप्ट करता है। हर अनुरोध के लिए, यह:
रिस्पॉन्स भी उसी तरह वापस आता है, और उसे Claude Code के अपेक्षित फ़ॉर्मेट में पुनः ट्रांसफ़ॉर्म कर दिया जाता है, इसलिए क्लाइंट को पता भी नहीं चलता कि कुछ बदला है।
उस इंटरसेप्शन के भीतर मुख्य तंत्र है टास्क-आधारित रूटिंग। CCR इनकमिंग अनुरोधों को प्रकार के अनुसार वर्गीकृत करता है और उन्हें उपयुक्त मॉडल पर मैप करता है। व्यवहार में मुख्य टास्क श्रेणियाँ कुछ यूँ काम करती हैं:
|
कार्य का प्रकार |
कब ट्रिगर होता है |
आम मॉडल चयन |
|
|
फ़ाइल स्कैनिंग, संदर्भ एकत्र करना |
तेज़ लोकल मॉडल (जैसे, Ollama) |
|
|
Plan Mode, जटिल तर्क |
रीजनिंग मॉडल (जैसे, DeepSeek) |
|
|
टोकन थ्रेशोल्ड से अधिक वाले अनुरोध |
हाई-कॉन्टेक्स्ट मॉडल (जैसे, Gemini) |
|
|
वेब सर्च कार्य |
नेटिव सर्च सपोर्ट वाला मॉडल |
|
|
बाकी सब |
मिड-टियर सक्षम मॉडल |
हर कार्य-प्रकार को उसके काम के मुताबिक सही औज़ार मिलता है, और कॉन्फ़िगर हो जाने के बाद किसी मैन्युअल दखल की ज़रूरत नहीं रहती। मेरे अनुभव में, बैकग्राउंड रूट सबसे बड़ा तात्कालिक लाभ देता है: ये चुपचाप चलने वाले फ़ाइल-स्कैनिंग अनुरोध कोडिंग सत्र के दौरान लगातार होते रहते हैं, और CCR से पहले, मुझे अंदाज़ा नहीं था कि ये कितने चुपके से जुड़ते जा रहे थे।
CCR इंस्टॉल करने से पहले, सुनिश्चित करें कि निम्नलिखित मौजूद हों:
रनटाइम एन्वायरनमेंट के रूप में Node.js v18 या बाद का संस्करण
आपका पैकेज मैनेजर के रूप में npm
Claude Code ग्लोबली इंस्टॉल हो (npm install -g @anthropic-ai/claude-code)
कम-से-कम एक मॉडल बैकएंड—या तो किसी समर्थित बाहरी प्रदाता (DeepSeek, Gemini, OpenRouter, Groq, Volcengine, SiliconFlow, और अन्य) की API कुंजी, या यदि आप पूरी तरह बाहरी प्रदाताओं से बचना चाहते हैं तो पहले से पुल किया हुआ मॉडल वाला लोकल Ollama इंस्टेंस
आपको शुरुआत में हर प्रदाता के अकाउंट की ज़रूरत नहीं है। इस ट्यूटोरियल को पूरा करने के लिए एक काम करता हुआ बैकएंड ही काफ़ी है, बाकी बाद में जोड़ सकते हैं।
Claude Code और उसके एक लोकप्रिय विकल्प की तुलना के लिए, हमारा लेख OpenClaw बनाम Claude Code पढ़ने की मैं सलाह देता हूँ।
अब जब अवधारणाएँ और पूर्वापेक्षाएँ स्पष्ट हैं, तो सेटअप को चरण-दर-चरण बनाते हैं।
पूर्वापेक्षाएँ पूरी होने पर, आप npm से CCR को ग्लोबली इंस्टॉल कर सकते हैं। Linux पर, हालाँकि, ग्लोबल पैकेज इंस्टॉल करते समय आपको परमिशन एरर मिल सकता है क्योंकि npm /usr/lib/node_modules में लिखने की कोशिश करता है, जो root के स्वामित्व में होता है। अनुशंसित उपाय यह है कि npm की ग्लोबल डायरेक्टरी को किसी ऐसी फ़ोल्डर पर रीडायरेक्ट करें जिसका स्वामित्व आपके यूज़र के पास हो, न कि sudo के साथ कमांड चलाएँ:
mkdir -p ~/.npm-global
npm config set prefix '~/.npm-global'
export PATH=~/.npm-global/bin:$PATH
उस PATH बदलाव को स्थायी बनाने के लिए, export वाली पंक्ति अपने ~/.bashrc या ~/.zshrc में जोड़ें और शेल को रीलोड करें। फिर CCR इंस्टॉल करें:
npm install -g @musistudio/claude-code-routerइससे ccr CLI आपके शेल में ग्लोबली उपलब्ध हो जाएगा। अगला कदम, राउटर सर्विस शुरू करें:
ccr startडिफ़ॉल्ट रूप से CCR http://127.0.0.1:3456 पर बाइंड होता है। जैसे ही स्टार्टअप आउटपुट में सर्विस के पोर्ट से बाइंड होने का मैसेज दिखे, प्रॉक्सी अनुरोध स्वीकारने के लिए तैयार है।
सारी CCR कॉन्फ़िगरेशन ~/.claude-code-router/config.json में रहती है। एक से अधिक प्रदाताओं को वायर करने से पहले, मैं सलाह देता हूँ कि एक सिंगल, जानी-पहचानी अच्छी प्रदाता से शुरू करें ताकि वैरिएबल्स अलग हो जाएँ और बेसलाइन काम करने की पुष्टि हो सके।
OpenRouter यहाँ एक अच्छा शुरुआती बिंदु है, और नई मशीन पर CCR सेट करते समय मैं सबसे पहले इसी का सहारा लेता हूँ। यह आपको एक ही API कुंजी से दर्जनों मॉडलों तक पहुँच देता है, जिनमें कई फ्री-टियर वाले भी शामिल हैं, जो रूटिंग लेयर को किसी विशिष्ट प्रदाता पर कमिट करने से पहले चालू कराने के लिए आदर्श है। आप OpenRouter पर साइन अप कर के कुंजी ले सकते हैं।
OpenRouter का यह न्यूनतम कॉन्फ़िगरेशन देखें:
{
  "Providers": [
    {
      "name": "openrouter",
      "api_base_url": "https://openrouter.ai/api/v1/chat/completions",
      "api_key": "YOUR_OPENROUTER_API_KEY",
      "models": ["openai/gpt-oss-120b:free"],
      "transformer": {
        "use": ["openrouter"]
      }
    }
  ],
  "Router": {
    "default": "openrouter,openai/gpt-oss-120b:free"
  }
}
यहाँ कुछ बातों पर ध्यान दें:
api_base_url प्रदाता के पूरे चैट कम्प्लीशन एंडपॉइंट की ओर इशारा करना चाहिए, सिर्फ बेस डोमेन नहीं।
transformer बताता है कि CCR को कौन-सा बिल्ट-इन पेलोड एडेप्टर इस्तेमाल करना चाहिए, क्योंकि अलग-अलग प्रदाता अलग अनुरोध फ़ॉर्मेट अपेक्षित करते हैं। ट्रांसफ़ॉर्मर यह अनुवाद चुपचाप सँभालता है।
Router.default किसी भी ऐसे अनुरोध के लिए फ़ॉलबैक मॉडल सेट करता है जो अधिक विशिष्ट नियम से मेल नहीं खाता, और इसमें provider,model सिंटैक्स का उपयोग होता है।
सुरक्षा के लिए, फ़ाइल में कुंजियाँ हार्डकोड करने से बचें। CCR एन्वायरनमेंट वैरिएबल इंटरपोलेशन सपोर्ट करता है: YOUR_OPENROUTER_API_KEY को $OPENROUTER_API_KEY से बदल दें और वैरिएबल को अपने शेल में एक्सपोर्ट करें। इंटरपोलेशन पूरे कॉन्फ़िग में रिकर्सिवली काम करता है, इसलिए जैसे-जैसे आप अधिक प्रदाता जोड़ेंगे, यह पैटर्न साफ़-सुथरे ढंग से स्केल होगा।
कॉन्फ़िग तैयार होने पर, राउटर के माध्यम से Claude Code लॉन्च करना एक ही कमांड है:
ccr codeबस इतना ही। ccr code प्रॉक्सी सर्विस शुरू करता है और Claude Code को साथ ही लॉन्च कर देता है, एन्वायरनमेंट पहले से स्वतः कॉन्फ़िगर होता है। आपको ccr start अलग से चलाने की ज़रूरत नहीं।
रूटिंग सक्रिय है या नहीं, यह जाँचना हो तो ~/.claude-code-router/logs/ फ़ोल्डर देखें। वहाँ ccr-*.log नाम की फ़ाइल यह पुष्टि करती है कि प्रॉक्सी शुरू हो गई है और अनुरोध प्राप्त हो रहे हैं। इसे रीयल-टाइम में देखने के लिए टेल कर सकते हैं:
tail -f ~/.claude-code-router/logs/$(ls -t ~/.claude-code-router/logs/ | head -1)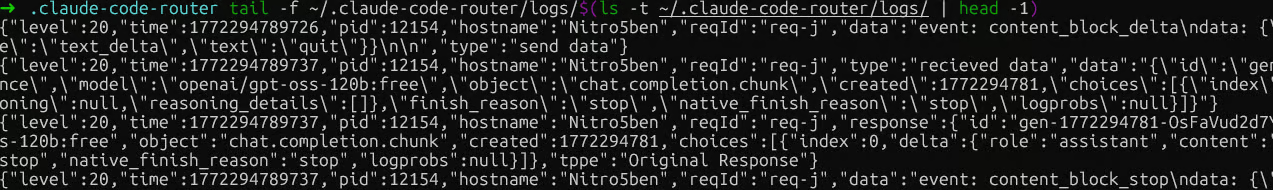
Claude Code Router लॉग्स
सत्यापन के बारे में दो बातें जानना उपयोगी है। Claude Code हेडर हमेशावर्तमान डिफ़ॉल्ट Claude मॉडल ही दिखाता है, चाहे CCR किसी भी मॉडल पर रूट कर रहा हो, क्योंकि वह आपके Anthropic अकाउंट सेशन को दर्शाता है, सक्रिय बैकएंड को नहीं। यदि आप मॉडल से पूछेंगे "आप कौन-सा मॉडल हैं?", तो वह भी “Claude Sonnet 4.6” कहेगा, क्योंकि Claude Code क्लाइंट उसे उसी रूप में पहचान बताने को कहता है। दोनों संकेत भरोसेमंद नहीं हैं।
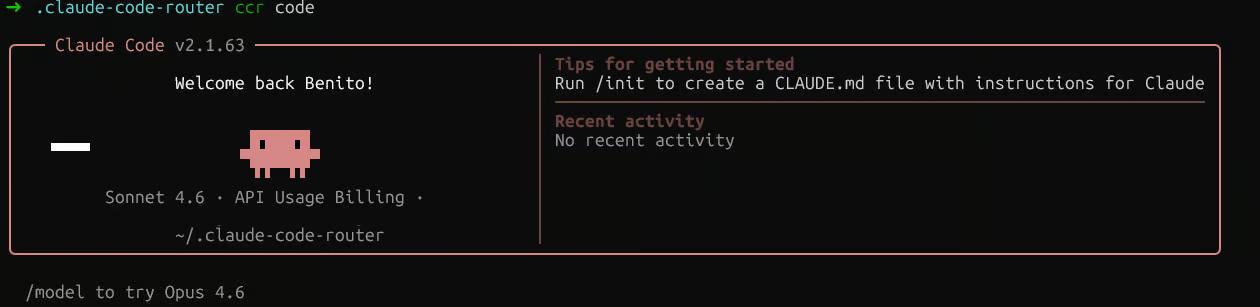
Claude Code Router सत्र
लॉग ही एकमात्र सत्य का स्रोत है। रिस्पॉन्स एंट्रीज़ में "model" फ़ील्ड देखें। यदि वहाँ आपका कॉन्फ़िगर किया हुआ मॉडल नाम दिखे, जैसे "model":"openai/gpt-oss-120b:free", तो रूटिंग काम कर रही है।
यदि आप CCR को स्थायी बनाना चाहते हैं ताकि आप ccr code के बिना सीधे claude कमांड चला सकें, तो अपने ~/.bashrc or ~/.zshrc में यह जोड़ें:
eval "$(ccr activate)"बस यह सुनिश्चित करें कि उस स्थिति में पहले ccr start चले, क्योंकि activate सिर्फ एन्वायरनमेंट वैरिएबल सेट करता है, सर्विस को शुरू नहीं करता।
अब जबकि बेसलाइन सत्यापित हो चुकी है, कॉन्फ़िग को बढ़ाते हैं ताकि अलग-अलग कार्य प्रकार अलग-अलग प्रदाताओं पर रूट हों। यहाँ एक अधिक पूर्ण Router कॉन्फ़िगरेशन है:
{
  "Router": {
    "default": "deepseek,deepseek-chat",
    "background": "ollama,qwen2.5-coder:latest",
    "think": "deepseek,deepseek-reasoner",
    "longContext": "openrouter,google/gemini-2.5-pro-preview",
    "longContextThreshold": 60000,
    "webSearch": "gemini,gemini-2.5-flash"
  }
}
हर कुंजी एक टास्क श्रेणी को "provider,model" जोड़ी से मैप करती है:
background रूट फ़ाइल स्कैनिंग और संदर्भ-संग्रह अनुरोध सँभालता है। इन्हें निःसंकोच लोकल Ollama मॉडल पर भेजा जा सकता है, जिससे ये मुफ़्त रहते हैं—और यही एक बदलाव था जिसने मेरे मासिक API बिल में सबसे बड़ा फर्क डाला।
think रूट Plan Mode और जटिल तर्क कार्यों को कैप्चर करता है, जहाँ deepseek-reasoner जैसा मॉडल अपनी लागत पूरी तरह वसूल करता है।
longContext रूट अपने-आप सक्रिय हो जाता है जब कोई अनुरोध longContextThreshold टोकनों (डिफ़ॉल्ट 60,000) से ऊपर चला जाता है, और बिना किसी मैन्युअल स्विचिंग के हाई-कैपेसिटी मॉडल पर रिडायरेक्ट हो जाता है।
webSearch के लिए ध्यान दें कि मॉडल में वेब सर्च का नेटिव सपोर्ट होना चाहिए। यदि आप OpenRouter के माध्यम से रूट कर रहे हैं, तो मॉडल नाम में :online प्रत्यय जोड़ना भी ज़रूरी है (उदाहरण के लिए, "anthropic/claude-3.5-sonnet:online")।
रेट-लिमिट लचीलापन के लिए, CCR की कस्टम राउटर सुविधा आपको JavaScript में फ़ॉलबैक लॉजिक परिभाषित करने देती है। अपनी पसंद के किसी पथ पर एक फ़ाइल बनाएँ, उसे अपने कॉन्फ़िग में "CUSTOM_ROUTER_PATH": "/path/to/custom-router.js" से संदर्भित करें, फिर एक async फ़ंक्शन एक्सपोर्ट करें जो "provider,model" स्ट्रिंग लौटाए या डिफ़ॉल्ट नियमों पर लौटने के लिए null दे:
module.exports = async function router(req, config) {
  // Primary logic here. Return null to fall back to config-defined rules.
  return null;
};
यही वह जगह है जहाँ आप 429 रिस्पॉन्स पहचान कर स्वतः सेकेंडरी प्रदाता पर रीरूट करने जैसा retry-on-rate-limit लॉजिक लागू करेंगे। किसी भी कॉन्फ़िग बदलाव के बाद, प्रभावी होने के लिए सर्विस को रीस्टार्ट करना याद रखें:
ccr restartरूटिंग चालू हो जाने के बाद ध्यान सिस्टम को ऑब्ज़र्वेबल, सुरक्षित और किसी गड़बड़ी पर आसानी से डिबग करने योग्य रखने पर शिफ्ट होता है।
CCR दो अलग-अलग लॉगिंग सिस्टम देता है जिनके बारे में जानना ज़रूरी है:
सर्वर-स्तरीय लॉग्स HTTP अनुरोधों, API कॉल्स और सर्वर ईवेंट्स को कवर करते हैं। ये ~/.claude-code-router/logs/ में ccr-*.log नामक फ़ाइलों में लिखे जाते हैं। व्यवहार में आप सबसे अधिक इसी लॉग का उपयोग करेंगे।
एप्लिकेशन-स्तरीय लॉग्स रूटिंग निर्णयों को कैप्चर करते हैं और ~/.claude-code-router/claude-code-router.log में लिखे जाते हैं, हालाँकि यह फ़ाइल आपके सेटअप और लॉग लेवल पर निर्भर करते हुए हमेशा मौजूद नहीं भी हो सकती।
सर्वर लॉग की नियमित समीक्षा आपको यह स्पष्ट तस्वीर देती है कि कौन-से रूट ट्रिगर हो रहे हैं, कौन-से मॉडल कॉल हो रहे हैं, और क्या किसी प्रदाता की त्रुटियाँ आ रही हैं।
रीयल-टाइम दृश्यता के लिए, CCR में एक स्टेटसलाइन टूल भी शामिल है (v1.0.40 से उपलब्ध) जिसे आप ccr ui के माध्यम से सक्षम कर सकते हैं। सक्रिय होने पर, यह Claude Code चलते समय सीधे आपके टर्मिनल में वर्तमान रूटिंग स्थिति दिखाता है, ताकि आप एक नज़र में देख सकें कि हर अनुरोध को कौन-सा मॉडल संभाल रहा है।
बजट के मामले में, सबसे प्रभावी सुरक्षा-पटरी आपका रूटिंग कॉन्फ़िग ही है। सुनिश्चित करके कि background और default रूट सस्ते या लोकल मॉडलों की ओर इशारा करें, आप कम-मूल्य वाले कार्यों के लिए प्रीमियम मॉडलों के इन्कोकेशन को रोकते हैं। think और longContext को ऐसे मॉडलों के लिए सुरक्षित रखें जो अपनी लागत को जायज़ ठहराते हों, और longContext का टोकन थ्रेशोल्ड उतना ऊँचा रखें जितना आपका वर्कफ़्लो सह सके।
मेरे अनुभव में, यह कॉन्फ़िग-स्तरीय अनुशासन रिएक्टिव मॉनिटरिंग से अधिक भरोसेमंद है, क्योंकि यह ओवरस्पेंड होने से पहले ही उसे रोक देता है, बाद में पकड़ने के बजाय।
जैसे-जैसे आपके प्रदाताओं की सूची बढ़ती है, क्रेडेंशियल मैनेजमेंट पर विशेष ध्यान देना चाहिए। मैं जो नियम अपनाता हूँ, वे सरल हैं:
कभी भी रॉ API कुंजियाँ config.json में कमिट न करें यदि वह फ़ाइल वर्शन कंट्रोल में ट्रैक होती है। हमेशा "$PROVIDER_API_KEY" सिंटैक्स के साथ एन्वायरनमेंट वैरिएबल इंटरपोलेशन का उपयोग करें, और कुंजियों को अपने शेल प्रोफ़ाइल या सीक्रेट मैनेजर से एक्सपोर्ट करें।
इंडिविजुअल डेवलपर सेटअप के लिए प्रॉक्सी को localhost पर रखें। यदि आप अपने कॉन्फ़िग में APIKEY सेट नहीं करते, तो CCR स्वतः सर्वर को केवल 127.0.0.1 से बाइंड करने के लिए बाध्य करता है, जिससे साझा मशीनों या नेटवर्क पर बाहरी एक्सेस रुकता है।
टीम डिप्लॉयमेंट के लिए APIKEY सेट करें यदि आपको होस्ट को 0.0.0.0 पर खोलना पड़े। राउटर से जुड़ने वाला हर क्लाइंट यह कुंजी Authorization: Bearer या x-api-key हेडर में शामिल करे।
लॉगिंग अक्षम करें या घटाएँ यदि आप संवेदनशील कोड रूट कर रहे हैं। डिफ़ॉल्ट रूप से लॉगिंग सक्षम है ("LOG": true)। रिक्वेस्ट पेलोड डिस्क पर लिखने से रोकने के लिए "LOG": false सेट करें, या विस्तृत डिबग आउटपुट दबाने के लिए "LOG_LEVEL": "warn" रखें।
इसे लागू करने का व्यावहारिक तरीका यह है कि अपनी सारी API कुंजियाँ शेल प्रोफ़ाइल में रखें और config.json में $VAR_NAME सिंटैक्स से उनका संदर्भ दें। इस तरह कॉन्फ़िग फ़ाइल में कोई सीक्रेट नहीं रहता और उसे सुरक्षित रूप से साझा या वर्शन-कंट्रोल किया जा सकता है।
यदि कभी संदेह हो कि कोई कुंजी लॉग में लीक हो रही है, तो पहले अपना लॉग लेवल सेटिंग जाँचें। "LOG_LEVEL": "warn" पर स्विच करना बिना लॉगिंग पूरी तरह अक्षम किए डिस्क पर लिखी जाने वाली चीज़ें घटाने का सबसे तेज़ तरीका है।
जब कुछ टूटता है, तो लेयर्ड डायग्नोस्टिक सीक्वेंस बहुत समय बचाता है। मेरा अनुभव है कि बाहरी परत से अंदर की ओर बढ़ना सबसे बेहतर रहता है।
ccr code चलाएँ और सर्विस स्टार्टअप की पुष्टि देखें। यदि पोर्ट व्यस्त है या सर्विस शुरू होने में विफल रही, तो Claude Code में आपको connection refused जैसी त्रुटियाँ दिखेंगी।
विवरण के लिए ~/.claude-code-router/logs/ में सर्वर लॉग देखें। अधिकांश स्टार्टअप विफलताएँ या तो पोर्ट कॉन्फ्लिक्ट या फिर बिगड़ा हुआ config.json होने से आती हैं।
सबसे आम कॉन्फ़िग गलती है Providers में दिए मॉडल नाम और Router में दिए नाम के बीच असंगति। दोनों एकदम समान होने चाहिए।
यदि वे अलग हैं, तो CCR बिना model फ़ील्ड के अनुरोध भेजता है, और आपको Missing model in request body त्रुटि दिखेगी। कॉन्फ़िग ठीक करने के बाद, ccr restart चलाकर उसे रीलोड करना न भूलें।
यदि मॉडल नाम सही है लेकिन अनुरोध फिर भी 404 के साथ असफल हो रहे हैं, तो अपने प्रदाता अकाउंट सेटिंग्स जाँचें। उदाहरण के लिए, OpenRouter की डिफ़ॉल्ट प्राइवेसी पॉलिसी फ्री मॉडलों को थर्ड-पार्टी प्रदाताओं को डेटा भेजने से रोकती है। आपको No endpoints found matching your data policy जैसा एरर दिखेगा।
उपाय यह है कि अपने OpenRouter प्राइवेसी सेटिंग्स पर जाएँ और फ्री मॉडल उपयोग सक्षम करें। अन्य प्रदाताओं में भी ऐसे ही अकाउंट-स्तरीय टॉगल हो सकते हैं, जिन्हें अनपेक्षित 4xx त्रुटियाँ मिलने पर जाँचना चाहिए।
यदि अनुरोध प्रदाता तक पहुँच रहे हैं लेकिन रिस्पॉन्स बिगड़े हुए हैं या टूल कॉल्स विफल हो रही हैं, तो आमतौर पर समस्या कोई मिसिंग या गलत ट्रांसफ़ॉर्मर होती है। अपने प्रदाता को बिल्ट-इन ट्रांसफ़ॉर्मर सूची से क्रॉस-रेफ़रेंस करें और सुनिश्चित करें कि सही ट्रांसफ़ॉर्मर "use" एरे में है।
अधिकांश मामलों में, इन चार चरणों को क्रम से अपनाना समस्या को जल्दी अलग कर देता है। सर्वर लॉग आउटगोइंग अनुरोध और प्रदाता का रॉ रिस्पॉन्स दोनों कैप्चर करता है, जिससे यह समझने के लिए आपको सब मिल जाता है कि असफलता कहाँ हुई।
अब आपके पास Claude Code के ऊपर बना एक काम करता हुआ मल्टी-प्रोवाइडर रूटिंग इन्फ्रास्ट्रक्चर है। बैकग्राउंड कार्य तेज़ लोकल मॉडलों तक जाते हैं, भारी तर्क वाले कार्य विशिष्ट मॉडलों तक, और लंबे संदर्भ वाले अनुरोध हाई-कैपेसिटी प्रदाताओं द्वारा सँभाले जाते हैं—यह सब आपके नियंत्रण वाली नीतियों के आधार पर स्वतः।
तत्काल लाभ हैं कम API लागत, रेट लिमिट्स में कोई सिंगल पॉइंट ऑफ फेल्योर नहीं, और अपने वर्कफ़्लो को छुए बिना प्रदाताओं को बदलने की लचीलापन।
सेटअप को समय के साथ कुशल बनाए रखने के लिए, अपनी रूटिंग लॉग्स को समय-समय पर समीक्षा करें। सर्वर लॉग दिखाएगा कि कौन-से रूट सबसे ज़्यादा ट्रिगर हो रहे हैं और क्या महंगे मॉडल ऐसे कार्यों के लिए चालू हो रहे हैं जिन्हें सस्ते विकल्प सँभाल सकते थे। वास्तविक उपयोग के आधार पर longContextThreshold और फ़ॉलबैक नियमों को समायोजित करना उन्हें एक बार सेट कर छोड़ देने से कहीं अधिक प्रभावी है।
अंत में, यदि आपका काम स्वामित्व वाले कोड से जुड़ा है, तो मैं उन अनुरोधों को लोकल LLM के माध्यम से Ollama पर रूट करने की कड़ी सलाह दूँगा। मैं ऐसा किसी भी ऐसे क्लाइंट कार्य के लिए करता हूँ जिसमें अनरिलीज़्ड कोड शामिल हो। इसे प्रदाता के रूप में जोड़ने में एक मिनट से भी कम लगता है, और आपके सबसे संवेदनशील क्वेरी आपकी मशीन से बाहर नहीं जातीं।
जो लोग AI एप्लिकेशन डेवलपमेंट में लेवल-अप करना चाहते हैं, उनके लिए मैं हमारे AI Engineering with LangChain स्किल ट्रैक में नामांकन करने की अत्यधिक अनुशंसा करता हूँ। शिक्षण सामग्री AI-नेटिव है, जो आपको एक पर्सनल ट्यूटर देती है जो आपको वही कौशल सिखाती है जिनकी ज़रूरत आपको AI वर्कफ़्लोज़ इंजीनियरिंग में वास्तविक प्रो बनने के लिए है।
AI Courses
लर्निंग पाथ
कोर्स
कोर्स