Programa
AI Engineering with LangChain
21 h
Pratique e programa seu progresso.
Continuar Com O GoogleQuando comecei a usar intensamente o Claude Code, duas coisas ficaram claras bem rápido: a qualidade é excelente — e a fatura acompanha. Toda solicitação, seja um docstring de três linhas ou uma refatoração arquitetural completa, vai para o mesmo endpoint da Anthropic, na mesma taxa.
Com o tempo, essa dependência de um único fornecedor não só pressiona os custos, como também cria risco. Além disso, um rate limit em um modelo pode paralisar todo o seu fluxo de trabalho.
O Claude Code Router (CCR) resolve os dois problemas de forma direta. É um proxy de código aberto que intercepta suas requisições do Claude Code antes de chegarem a qualquer provedor e redireciona cada pedido para o modelo de backend que faz mais sentido para aquela tarefa.
Neste tutorial, vou mostrar o passo a passo completo: instalar o router, configurar rotas com múltiplos provedores e deixar o sistema robusto para uso diário. Para acompanhar, pegue as chaves de API dos provedores que você quer usar (DeepSeek, Gemini, OpenRouter ou outro backend compatível) e abra seu terminal. Vamos lá.
Se quiser se inspirar com LLMs novos e seus pontos fortes, confira nossos guias sobre estes modelos recentes:
Antes de entrar na instalação, vale entender o que o CCR é de fato e por que ele funciona desse jeito. Se você ainda não trabalhou com o Claude Code, dê uma olhada primeiro no nosso guia prático do Claude Code 2.1.
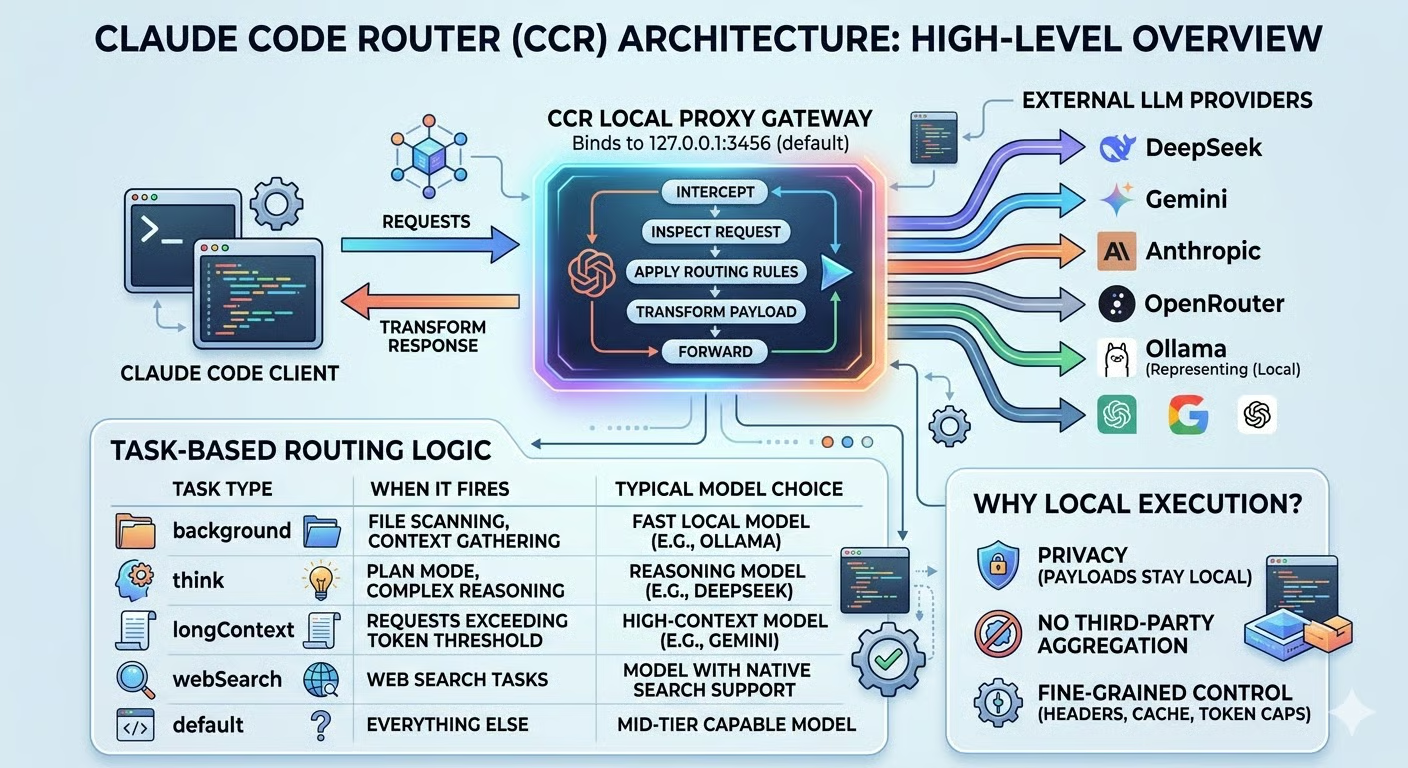
O Claude Code Router é um gateway proxy local. Quando você o inicia, ele faz bind em uma porta da sua máquina (127.0.0.1:3456 por padrão) e fica entre o cliente do Claude Code e qualquer provedor externo de LLM. Do ponto de vista do Claude Code, ele está falando com um endpoint local. Por baixo dos panos, o CCR decide em tempo real para onde a requisição realmente vai.
O principal problema que ele resolve é a dependência de um único fornecedor. Quando tudo passa por um provedor só, você herda todas as limitações dele:
O CCR elimina isso permitindo definir regras de roteamento que trocam automaticamente de modelo com base no tipo de tarefa, contagem de tokens ou qualquer lógica personalizada que você escrever. Uma varredura em segundo plano de arquivos não precisa do mesmo modelo que uma sessão de raciocínio em Plan Mode — e, com o CCR, não vai usar o mesmo.
O que diferencia o CCR de APIs diretas de provedores ou agregadores em nuvem é onde ele roda.
Como o proxy executa localmente, os payloads das suas requisições não passam por um serviço de agregação de terceiros antes de chegar ao destino. Você também ganha controle fino sobre a transformação das requisições — modificar headers, remover campos de cache e limitar tokens — por meio de um sistema de transformadores que roda inteiramente na sua máquina.
Para mim, esse modelo de execução local é o que torna o CCR realmente prático, e não só um truque inteligente: o resultado é uma configuração mais econômica, mais resiliente e mais privada do que rotear tudo por um único fornecedor na nuvem.
Com uma visão clara do que o CCR faz, vamos ver como ele funciona por baixo dos panos e o que você precisa antes de instalar.
Entender a arquitetura do CCR deixa a configuração muito mais simples, e o padrão de proxy costuma fazer sentido rápido quando você vê de ponta a ponta.
Ao iniciar o CCR, ele intercepta todas as requisições de saída do seu terminal antes de chegarem ao endpoint padrão da Anthropic. Para cada requisição, ele:
A resposta volta pelo mesmo caminho, transformada de volta no formato que o Claude Code espera — o cliente nem percebe que algo mudou.
O mecanismo-chave dentro dessa interceptação é o roteamento por tipo de tarefa. O CCR classifica as requisições recebidas por tipo e as mapeia para o modelo apropriado. Veja como as principais categorias se comportam na prática:
|
Tipo de tarefa |
Quando dispara |
Escolha típica de modelo |
|
|
Varredura de arquivos, coleta de contexto |
Modelo local rápido (ex.: Ollama) |
|
|
Plan Mode, raciocínio complexo |
Modelo de raciocínio (ex.: DeepSeek) |
|
|
Requisições que passam do limite de tokens |
Modelo com alto contexto (ex.: Gemini) |
|
|
Tarefas de busca na web |
Modelo com suporte nativo a busca |
|
|
Demais casos |
Modelo intermediário capaz |
Cada tipo de tarefa usa a ferramenta certa, sem precisar de intervenção manual depois de configurado. Na minha experiência, a rota de background dá o maior retorno imediato: essas requisições silenciosas de varredura de arquivos acontecem o tempo todo durante a sessão de código e, antes do CCR, eu não fazia ideia do quanto elas somavam.
Antes de instalar o CCR, garanta o seguinte:
Node.js v18 ou superior como ambiente de execução
npm como seu gerenciador de pacotes
Claude Code instalado globalmente (npm install -g @anthropic-ai/claude-code)
Pelo menos um backend de modelo, seja uma chave de API de um provedor externo compatível (DeepSeek, Gemini, OpenRouter, Groq, Volcengine, SiliconFlow, entre outros) ou uma instância local do Ollama com um modelo já baixado, se você preferir evitar provedores externos
Você não precisa ter conta em todos os provedores de início. Um backend funcionando já é suficiente para concluir este tutorial; depois você pode adicionar mais.
Para comparar o Claude Code com uma das alternativas mais populares, recomendo ler nosso artigo sobre OpenClaw vs Claude Code.
Agora que os conceitos e pré-requisitos estão claros, vamos montar a configuração etapa por etapa.
Com os pré-requisitos prontos, você pode instalar o CCR globalmente com npm. No Linux, porém, pode ocorrer erro de permissão ao instalar pacotes globais porque o npm tenta escrever em /usr/lib/node_modules, que pertence ao root. A correção recomendada é redirecionar o diretório global do npm para uma pasta que já seja sua, em vez de rodar o comando com sudo:
mkdir -p ~/.npm-global
npm config set prefix '~/.npm-global'
export PATH=~/.npm-global/bin:$PATH
Para tornar a alteração no PATH permanente, adicione a linha de export ao seu ~/.bashrc ou ~/.zshrc e recarregue o shell. Depois, instale o CCR:
npm install -g @musistudio/claude-code-routerIsso disponibiliza o CLI ccr globalmente no seu shell. Em seguida, inicie o serviço do router:
ccr startO CCR faz bind por padrão em http://127.0.0.1:3456. Assim que você vir no output de inicialização que o serviço está na porta, o proxy está pronto para receber requisições.
Toda a configuração do CCR fica em ~/.claude-code-router/config.json. Antes de ligar múltiplos provedores, recomendo começar com um único provedor confiável para isolar variáveis e confirmar que a base funciona.
O OpenRouter é um ótimo ponto de partida, e é o que eu uso primeiro sempre que configuro o CCR em uma máquina nova. Ele dá acesso a dezenas de modelos, incluindo vários de camada gratuita, com uma única chave de API — perfeito para colocar a camada de roteamento para rodar antes de se comprometer com provedores específicos. Cadastre-se e pegue uma chave em OpenRouter.
Veja uma configuração mínima usando OpenRouter:
{
  "Providers": [
    {
      "name": "openrouter",
      "api_base_url": "https://openrouter.ai/api/v1/chat/completions",
      "api_key": "YOUR_OPENROUTER_API_KEY",
      "models": ["openai/gpt-oss-120b:free"],
      "transformer": {
        "use": ["openrouter"]
      }
    }
  ],
  "Router": {
    "default": "openrouter,openai/gpt-oss-120b:free"
  }
}
Alguns pontos importantes:
api_base_url deve apontar para o endpoint completo de chat completions do provedor, não apenas para o domínio base.
transformer especifica qual adaptador de payload interno o CCR deve usar, já que cada provedor espera formatos diferentes. O transformer cuida dessa tradução em silêncio.
Router.default define o modelo padrão para qualquer requisição que não combine com uma regra mais específica, usando a sintaxe provider,model.
Por segurança, evite colocar chaves diretamente no arquivo. O CCR suporta interpolação de variáveis de ambiente: troque YOUR_OPENROUTER_API_KEY por $OPENROUTER_API_KEY e exporte a variável no seu shell. A interpolação funciona de forma recursiva em toda a config, então esse padrão escala bem conforme você adiciona mais provedores.
Com a config pronta, iniciar o Claude Code pelo router é um único comando:
ccr codeÉ isso. O ccr code inicia o serviço de proxy e abre o Claude Code ao mesmo tempo, com o ambiente pré-configurado automaticamente. Você não precisa rodar ccr start antes.
Para verificar se o roteamento está ativo, confira a pasta ~/.claude-code-router/logs/. Um arquivo chamado ccr-*.log lá confirma que o proxy iniciou e está recebendo requisições. Você pode acompanhar em tempo real:
tail -f ~/.claude-code-router/logs/$(ls -t ~/.claude-code-router/logs/ | head -1)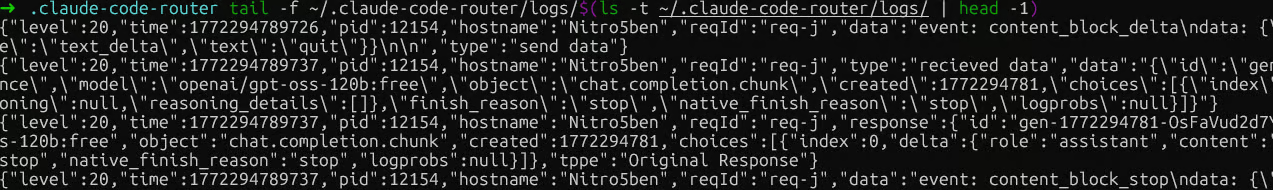
Logs do Claude Code Router
Duas observações úteis sobre verificação. O cabeçalho do Claude Code sempre exibe o modelo padrão atual do Claude, independentemente de qual modelo o CCR esteja usando, porque ele reflete a sua sessão da Anthropic, não o backend ativo. Se você perguntar ao modelo "que modelo você é?", ele também vai dizer “Claude Sonnet 4.6”, porque é isso que o cliente do Claude Code instrui a informar. Nenhum dos dois é sinal confiável.
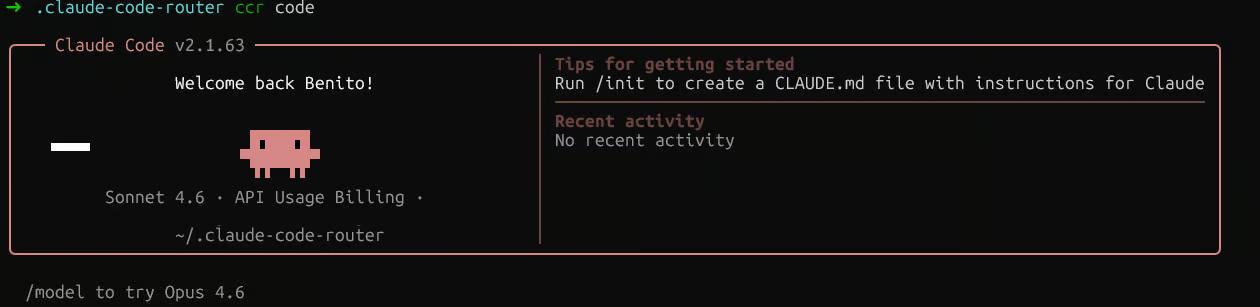
Sessão do Claude Code Router
O log é a única fonte de verdade. Procure o campo "model" nas entradas de resposta. Se você vir ali o nome do modelo configurado, por exemplo, "model":"openai/gpt-oss-120b:free", o roteamento está funcionando.
Se quiser tornar o CCR persistente para poder usar o comando claude diretamente sem ccr code, adicione isto ao seu ~/.bashrc or ~/.zshrc:
eval "$(ccr activate)"Só garanta que o ccr start rode antes, pois o activate apenas define variáveis de ambiente e não inicia o serviço.
Com a base verificada, vamos ampliar a config para rotear tipos de tarefa diferentes para provedores distintos. Aqui vai uma configuração Router mais completa:
{
  "Router": {
    "default": "deepseek,deepseek-chat",
    "background": "ollama,qwen2.5-coder:latest",
    "think": "deepseek,deepseek-reasoner",
    "longContext": "openrouter,google/gemini-2.5-pro-preview",
    "longContextThreshold": 60000,
    "webSearch": "gemini,gemini-2.5-flash"
  }
}
Cada chave mapeia uma categoria para um par "provider,model":
A rota background trata varredura de arquivos e coleta de contexto. Elas podem ir com segurança para um modelo local no Ollama, mantendo custo zero — foi a mudança que mais reduziu minha fatura mensal de API.
A rota think captura o Plan Mode e tarefas de raciocínio complexo, onde um modelo como deepseek-reasoner compensa o investimento.
A rota longContext ativa automaticamente quando a requisição passa de longContextThreshold tokens (padrão de 60.000), redirecionando para um modelo de alta capacidade sem troca manual.
Para webSearch, observe que o próprio modelo precisa ter suporte nativo a busca na web. Se você estiver roteando via OpenRouter, também é necessário adicionar o sufixo :online ao nome do modelo (por exemplo, "anthropic/claude-3.5-sonnet:online").
Para resiliência a rate limit, o recurso de roteador customizado do CCR permite definir lógicas de fallback em JavaScript. Crie um arquivo no caminho de sua escolha, referencie-o na config com "CUSTOM_ROUTER_PATH": "/path/to/custom-router.js" e exporte uma função assíncrona que retorne uma string "provider,model" ou null para voltar às regras padrão:
module.exports = async function router(req, config) {
  // Lógica principal aqui. Retorne null para cair nas regras definidas na config.
  return null;
};
É aqui que você implementaria, por exemplo, retry ao detectar rate limit — percebendo um 429 e redirecionando automaticamente para um provedor secundário. Após qualquer alteração na config, lembre-se de reiniciar o serviço para aplicar:
ccr restartCom o roteamento funcionando, o foco passa a ser manter o sistema observável, seguro e fácil de depurar quando algo der errado.
O CCR oferece dois sistemas de log que valem a pena conhecer:
Logs de servidor cobrem requisições HTTP, chamadas de API e eventos do servidor. São gravados em ~/.claude-code-router/logs/ em arquivos ccr-*.log. É o log que você mais vai usar no dia a dia.
Logs de aplicação registram decisões de roteamento e são gravados em ~/.claude-code-router/claude-code-router.log, embora este arquivo possa não existir dependendo da sua configuração e do nível de log.
Revisar periodicamente o log do servidor dá uma visão clara de quais rotas estão disparando, quais modelos estão sendo chamados e se há erros de provedores.
Para visibilidade em tempo real, o CCR também inclui um statusline (disponível a partir da v1.0.40) que você ativa com ccr ui. Ao ficar ativo, ele mostra o status de roteamento diretamente no terminal enquanto o Claude Code roda, indicando de relance qual modelo atende cada requisição.
No lado do orçamento, o guarda-corpo mais eficaz é a própria configuração de roteamento. Ao garantir que as rotas background e default apontem para modelos mais baratos ou locais, você evita acionar modelos premium para tarefas de baixo valor. Reserve think e longContext para modelos que justifiquem o custo e mantenha o limiar de tokens de longContext o mais alto possível dentro do seu fluxo.
Na minha experiência, essa disciplina na configuração é mais confiável do que monitoramento reativo, porque previne o gasto excessivo antes que aconteça, em vez de identificar depois.
Gerenciar credenciais merece atenção especial, principalmente à medida que sua lista de provedores cresce. As regras que sigo são diretas:
Nunca faça commit de chaves de API em texto puro dentro do config.json se o arquivo estiver sob versionamento. Sempre use interpolação de variáveis de ambiente com a sintaxe "$PROVIDER_API_KEY" e exporte as chaves no seu perfil de shell ou em um gerenciador de segredos.
Mantenha o proxy em localhost para configurações individuais de desenvolvedores. Se você não definir APIKEY na config, o CCR automaticamente força o bind apenas em 127.0.0.1, evitando acesso externo em máquinas ou redes compartilhadas.
Defina um APIKEY para uso em time caso precise abrir o host para 0.0.0.0. Todo cliente que se conectar ao router deve incluir essa chave no header Authorization: Bearer ou x-api-key.
Desative ou reduza os logs se você estiver roteando código sensível. O logging vem ativado por padrão ("LOG": true). Defina "LOG": false para parar de gravar payloads em disco, ou "LOG_LEVEL": "warn" para suprimir debug verboso.
Uma forma prática de implementar isso é manter todas as chaves de API no seu perfil de shell e referenciá-las com $VAR_NAME no config.json. Assim, o arquivo de config não contém segredos e pode ser compartilhado ou versionado com segurança.
Se tiver dúvida se alguma chave está vazando para os logs, verifique primeiro o nível de log. Trocar para "LOG_LEVEL": "warn" é a maneira mais rápida de reduzir o que é gravado em disco sem desativar tudo.
Quando algo quebra, uma sequência de diagnósticos em camadas economiza muito tempo. É melhor começar pela camada mais externa e ir avançando.
Rode ccr code e procure a confirmação de inicialização do serviço. Se a porta estiver ocupada ou o serviço falhar ao iniciar, você verá erros de conexão recusada no Claude Code.
Confira os logs do servidor em ~/.claude-code-router/logs/ para detalhes. A maioria das falhas de startup se resume a conflito de porta ou config.json malformado.
O erro de configuração mais comum é a divergência entre o nome do modelo em Providers e o em Router. Ambos precisam ser idênticos.
Se diferirem, o CCR envia a requisição sem o campo de modelo e você verá o erro Missing model in request body. Depois de corrigir, sempre rode ccr restart para recarregar.
Se o nome do modelo estiver correto, mas as requisições seguirem falhando com 404, verifique as configurações da sua conta no provedor. O OpenRouter, por exemplo, tem uma política de privacidade padrão que bloqueia modelos gratuitos de enviar dados a terceiros. Você verá um erro como No endpoints found matching your data policy.
A correção é ir nas configurações de privacidade do OpenRouter e habilitar o uso de modelos gratuitos. Outros provedores podem ter opções semelhantes a conferir se você topar erros 4xx inesperados.
Se as requisições chegam ao provedor, mas as respostas vêm malformadas ou chamadas de ferramentas falham, o problema geralmente é um transformer ausente ou incorreto. Cruze seu provedor com a lista de transformers embutidos e confirme se o correto está no array "use".
Na maioria dos casos, seguir essas quatro etapas na ordem isola o problema rapidamente. O log do servidor captura tanto a requisição de saída quanto a resposta crua do provedor, dando tudo que você precisa para entender onde ocorreu a falha.
Agora você tem uma infraestrutura de roteamento com múltiplos provedores em cima do Claude Code. Tarefas em segundo plano vão para modelos locais rápidos, trabalhos com muito raciocínio vão para modelos especializados e requisições com contexto longo são tratadas por provedores de alta capacidade — tudo automaticamente com base nas regras que você controla.
Os benefícios imediatos são redução de custos de API, ausência de ponto único de falha por rate limit e flexibilidade para trocar de provedor sem mudar seu fluxo.
Para manter a eficiência ao longo do tempo, revise periodicamente seus logs de roteamento. O log do servidor mostra quais rotas disparam com mais frequência e se modelos caros estão sendo acionados para tarefas que um mais barato daria conta. Ajustar longContextThreshold e regras de fallback com base no uso real é muito mais eficaz do que configurar uma vez e esquecer.
Por fim, se seu trabalho envolve código proprietário, recomendo fortemente rotear essas requisições para um LLM local via Ollama. Eu faço isso para qualquer trabalho de cliente com código inédito. Adicionar como provedor leva menos de um minuto — e suas consultas mais sensíveis nunca saem da sua máquina.
Se você quer levar suas habilidades em desenvolvimento de aplicações de IA para o próximo nível, recomendo muito se inscrever na nossa trilha de habilidades AI Engineering with LangChain. O conteúdo é nativo em IA, com um tutor pessoal que ensina exatamente o que você precisa para se tornar fera em projetar workflows de IA.
Cursos de IA
Programa
Curso
Pratique e programa seu progresso.
Continuar Com O Googleblog
Abid Ali Awan
13 min
blog
Bhavishya Pandit
7 min
Tutorial
Abid Ali Awan
Tutorial
Moez Ali
12 min
Tutorial
Zoumana Keita
8 min
Tutorial
Josep Ferrer
11 min