Che tu sia uno studente, un/una aspirante data scientist o un professionista in cerca di un cambio di carriera, se vuoi diventare un/una data scientist esperto/a devi seguire un percorso. Non è sempre semplice, perché il panorama della data science è diventato piuttosto ampio e, di conseguenza, esistono diversi tipi di professionisti con attività e competenze differenti.
Per abbozzare un percorso di data science, questo articolo offre una panoramica del panorama della disciplina, così che tu possa vedere quali ruoli sono in linea con le tue ambizioni. Inoltre, fornisce indicazioni su come entrare o crescere verso ruoli diversi all'interno di questo panorama, rispondendo a domande come: Quali competenze dovresti sviluppare e quali metodi dovresti conoscere?
Iniziamo con la nostra roadmap di data science.
In breve: una roadmap di Data Science
In questo articolo approfondiamo tutti gli aspetti della roadmap. Tuttavia, se cerchi un riepilogo rapido della traccia, lo trovi qui sotto:
- Comprendere la Data Science: afferrare le basi della data science e il suo ampio panorama.
- Familiarità con il ciclo di vita dei progetti: partire da un problema di business, sviluppare modelli predittivi e distribuirli in produzione, comprendendo il contributo dei diversi ruoli (Data Analyst, Data Scientist, Machine Learning Engineer, Data Engineer, Data Architect).
- Analisi e visualizzazione dei dati: eseguire EDA (exploratory data analysis) e padroneggiare gli strumenti di visualizzazione (ad es. matplotlib di Python, ggplot2 di R, PowerBI, Tableau).
- Basi di statistica e matematica: imparare statistica descrittiva e inferenziale e comprendere i concetti matematici chiave, soprattutto per le applicazioni di machine learning.
- Argomenti avanzati: Machine Learning e AI: addestrare e valutare modelli, approfondire il deep learning e comprendere i feedback loop dell'AI.
- Applicazioni pratiche e progetti: realizzare e presentare progetti usando dataset pubblici o personali, partecipare a hackathon e sviluppare un portfolio per dimostrare la tua esperienza.
- Navigare la carriera: identificare i ruoli in linea con le tue competenze, prepararti alle domande di colloquio rilevanti e restare aggiornato/a su trend e risorse del settore.
Seguendo questa roadmap, potrai orientarti efficacemente nel panorama della data science, costruire competenze essenziali e intraprendere una carriera gratificante nel campo.
1. Comprendere le basi della Data Science
Cos'è la data science?
Per capire il contesto di una roadmap di data science, è fondamentale farsi un'idea di cosa sia la Data Science. Abbiamo una guida completa con definizioni e spiegazioni sulla data science, ma, per gli scopi di questo articolo, considereremo la data science come l'insieme di attività volte a risolvere problemi usando i dati.
Un problema molto frequente è: “Ho una domanda, ma non conosco la risposta”. Quindi, se esegui una query SQL su un database delle vendite per capire quanto fatturato ha realizzato un'organizzazione il mese scorso, stai facendo data science!
Spesso, i problemi/le soluzioni sono più complessi e richiedono un set di competenze più diversificato. Per riuscire a discutere questo ampio ventaglio di ruoli e competenze lungo la nostra roadmap, useremo il ciclo di vita di un progetto di data science come contenitore. Questo ci permetterà di mappare le diverse attività e i ruoli e costituirà la base per esplorare i territori della data science.
2. Familiarizzare con il ciclo di vita dei progetti di Data Science
I progetti di data science iniziano per lo più da una domanda o un problema di business. Il problema innesca una fase di avvio, in cui si definisce un set di soluzioni possibili e si valuta l'iniziale fattibilità. Si esegue una raccolta iniziale di dati o un'analisi esplorativa dei dati disponibili per capire cosa è possibile e cosa no. I dati sono abbastanza ricchi? Contengono abbastanza feature?
Avvio ed esplorazione
Una volta che tutti i semafori sono verdi, si inizia a sviluppare un modello predittivo. Il modello userà input per prevedere gli output. Inizialmente, potrebbe essere un modello one-shot, addestrato, testato e validato su un set di cross-validation k-fold (una tecnica di machine learning per valutare quanto bene un modello potrebbe performare su dati non visti). Questo è il lavoro tipico dei data scientist classici. Quando il modello raggiunge prestazioni sufficienti, è il momento di portarlo in produzione e inserirlo in una pipeline nell'infrastruttura esistente, dove le prestazioni verranno monitorate e il modello verrà riaddestrato quando necessario.
Ciascuna di queste fasi richiede competenze diverse. Durante la fase di avvio, serve avere sensibilità per il business, familiarità con trasformazione e pulizia dei dati, statistica descrittiva e statistica inferenziale di base. È un lavoro che può essere svolto da un data analyst e/o da un data scientist.
Sviluppo del modello e messa in produzione
Nella fase di modellazione vanno costruiti modelli predittivi. Modelli semplici, come le regressioni, possono essere realizzati da un data analyst, ma se la complessità aumenta avrai bisogno di un data scientist per costruire un modello usando un algoritmo esistente o addirittura di un machine learning engineer per modificare algoritmi attuali o crearne di nuovi.
Quando distribuisci e metti in produzione il modello entri nel regno del machine learning engineer o del data engineer. Diversamente dalle fasi precedenti non c'è necessariamente un forte legame con il business, e il compito in questione ruota attorno alla creazione e al monitoraggio di una pipeline intorno al modello predittivo per fornire output affidabili ai sistemi target giusti.
Durante l'intero processo tutti i dati dovrebbero essere disponibili nei posti giusti con le giuste metainformazioni, ed è questo il ruolo del data architect. Man mano che nuovi dati vengono acquisiti o che i dati esistenti vengono trasformati in nuove informazioni, si assicurano allo stesso modo che i dati finiscano nel posto giusto.
Integrazione dei ruoli e collaborazione cross‑funzionale
Il modo in cui i diversi ruoli contribuiscono nelle varie fasi del ciclo di vita è illustrato nell'immagine qui sotto. Poiché ruoli differenti contribuiscono in fasi diverse, richiedono competenze diverse.
I ruoli all'inizio del ciclo di vita richiedono più sensibilità per il business e meno ingegneria, mentre le fasi successive richiedono meno sensibilità per il business e più ingegneria e ottimizzazione degli algoritmi. Per chiarire: come data scientist puoi cavartela con prestazioni computazionali subottimali per mostrare il valore e le performance del modello. Ma appena sei responsabile della messa in produzione dei modelli, devi saper ottimizzare la complessità computazionale per garantire che la pipeline sia (anche in termini di costi) efficiente.
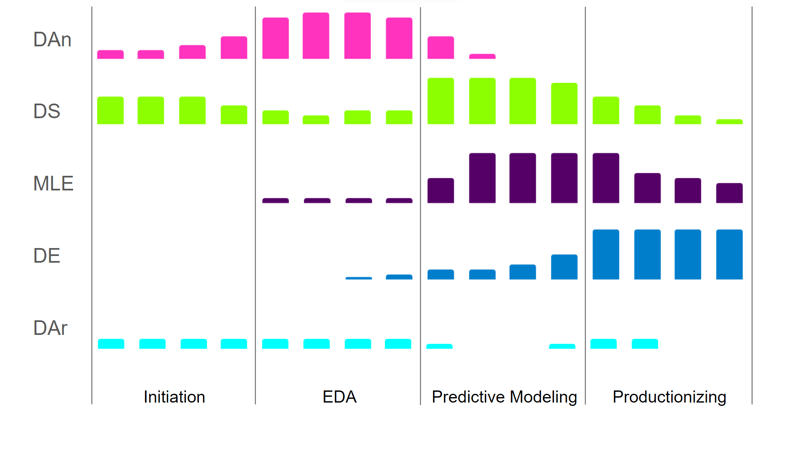
Il livello di contributo dei diversi ruoli di Data Science lungo un progetto di Data Science (DAn - Data Analyst, DS - Data Scientist, MLE - Machine Learning Engineer, DE - Data Engineer, DAr - Data Architect - Immagine dell'autore
È importante sapere che i confini tra i ruoli non sono rigidi. Molti data scientist già pensano ai giusti sistemi sorgente/target e all'efficienza computazionale e li considerano nel loro codice. Un machine learning engineer potrebbe rendersi conto che certi approcci di generazione delle feature potrebbero migliorare le prestazioni del modello. Un data analyst potrebbe dare buoni consigli su dove nel data catalog archiviare le feature generate per il data architect. In altre parole, tutti i ruoli dovrebbero, in una certa misura, essere consapevoli del lavoro degli altri, ma non è necessario che comprendano in profondità le responsabilità reciproche.
Competenze e strumenti essenziali
Per quanto riguarda le competenze e gli strumenti di cui avrai bisogno, esiste una base chiara. Indipendentemente da dove contribuisci nel ciclo di vita di un progetto di data science, ti servirà una comprensione di base di matematica e statistica, sviluppo software collaborativo e manipolazione dei dati. In generale, l'inizio di qualsiasi roadmap di data science consiste in:
- Manipolazione dei dati (pensa al lavoro di Extract-Transform-Load, come insegnato in SQL, Python o R),
- Analisi dei dati (statistica) (come insegnato nella statistica descrittiva e in parte correlazionale),
- Machine Learning (come insegnato nell'apprendimento supervisionato in Python o R), e
- Versioning per lo sviluppo software collaborativo (come insegnato in Git).
Esistono diversi tipi di ruoli di data science con requisiti di competenze differenti: un Data Analyst avrà bisogno di una conoscenza più approfondita di SQL rispetto a un Data Engineer. Un Data Scientist deve conoscere il Machine Learning meglio di un Data Architect. E qui la roadmap si ramifica: a seconda di dove si collocano le tue ambizioni nel panorama, dovrai imparare competenze diverse. Le sezioni seguenti descriveranno i vari rami della roadmap a cui puoi pensare.
3. Approfondire analisi e visualizzazione dei dati
Exploratory Data Analysis (EDA)
Indipendentemente da quanto sei avanti nel tuo percorso, che tu sia un veterano o agli inizi, tutti i progetti di data science iniziano dalla comprensione dei dati.
Comprendere a fondo i tuoi dati è cruciale per valutare la fattibilità del progetto. Si parte da domande di base come “quali variabili ho?” e “quante osservazioni ho?” per arrivare a domande più complesse come “quali sono le relazioni tra le variabili?”
Spesso i risultati di un'EDA possono già essere la risposta alle domande dei tuoi stakeholder. Se visualizzati correttamente e presentati in modo coerente, ad esempio in una dashboard, gli esiti di una semplice analisi dei dati possono servire a rispondere a domande complesse. Questo, tuttavia, si basa sulla competenza in data visualization.
Anche solo mostrando, tramite la tua EDA, che per esempio esistono segmenti diversi di visitatori del sito, hai creato valore in modo da data scientist.
Ci sono molti modi per visualizzare i risultati. O tramite librerie/pacchetti di visualizzazione nel linguaggio che usi (come ggplot2 di R e matplotlib di Python) o con strumenti dedicati alla visualizzazione dei dati (come PowerBI, Tableau o anche Excel)
Padroneggiare la visualizzazione dei dati
In particolare, se ci concentriamo maggiormente sui compiti di un Data Analyst, una comprensione più profonda della visualizzazione dei dati è d'aiuto.
Per la maggior parte dei ruoli di data science, le visualizzazioni possono servire a verificare ipotesi tramite scatter plot e istogrammi, ma quando l'analisi stessa è il deliverable, come per un Data Analyst, ti troverai in situazioni in cui vuoi rendere gli esiti dell'analisi piacevoli da fruire.
Pensa a linee grafiche personalizzate, nuove visualizzazioni o infografiche da usare come input per un'unità decisionale. In queste situazioni, aiuta saper creare una visualizzazione dei dati che sia praticamente un'opera d'arte. Understanding Data Visualization è un corso che aiuta davvero ad approfondire le tue competenze di dataviz.
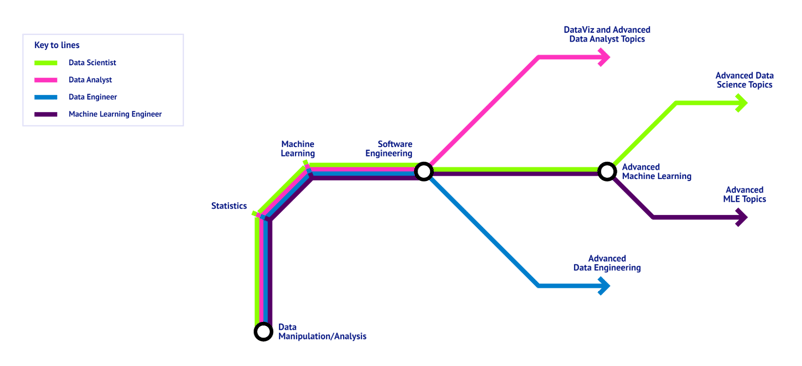
Una roadmap di Data Science, visualizzata come una mappa della metro, che mostra le basi comuni a tutti i ruoli e le competenze specifiche dei diversi ruoli. - Immagine dell'autore
4. Costruire le basi di statistica e matematica
Statistica descrittiva e inferenziale
Un'altra delle prime tappe lungo una roadmap di data science è la statistica. Alcuni concetti statistici di base dovrebbero diventare una seconda natura per qualsiasi tipo di data scientist.
In qualsiasi momento, dovrai essere in grado di descrivere i tuoi dati e i sottogruppi. Qual è il reddito medio nel tuo dataset? Quali sono il minimo e il massimo? Qual è la deviazione standard o quali sono altre misure di dispersione? E se hai valori categoriali, quanti valori unici ci sono? Qual è il più frequente? Tutti i valori si presentano con la stessa frequenza o la distribuzione è meno uniforme?
Rispondere a domande con analitiche descrittive su gruppi/sottogruppi può già fornire insight preziosi, ma spesso occorre guardare alle relazioni tra variabili nel dataset e passare alla statistica inferenziale.
La parte impegnativa e interessante della statistica inferenziale sono i diversi tipi di variabili categoriali e numeriche e le relazioni tra di esse. Alcuni esempi includono:
- Correlazioni; la relazione tra variabili numeriche, come “in che modo età e reddito sono correlati?”.
- La relazione tra categoriche e numeriche per indagare la domanda: “Come si confronta il reddito tra uomini e donne?” (con il genere come input categorico e il reddito come variabile target numerica),
- Oppure il contrario: “Le persone più anziane sono più inclini al divorzio?” (con l'età come input numerico e divorziato come variabile target categorica).
- Relazioni tra variabili categoriali, “Gli uomini sono divorziati più spesso delle donne?”
Per poter rispondere a queste domande, devi conoscere i diversi tipi di test statistici, dai più semplici, come il T-Test, a metodi più complessi come le regressioni lineari multivariate o l'analisi di serie storiche.
Puoi seguire corsi pertinenti per approfondire la statistica in: Python, R e anche indipendenti dallo strumento. Questi corsi forniscono una base adeguata per iniziare a lavorare con il machine learning. Comprendendo statisticamente la relazione tra predittori e variabili target, capisci i principi degli algoritmi usati per creare modelli di apprendimento supervisionato.
Quanto in profondità addentrarti dipende ancora una volta da dove vuoi arrivare lungo la roadmap. Se punti a diventare data analyst, potrebbero bastare le basi di statistica. I data architect potrebbero non aver bisogno di conoscenze statistiche. Ma data scientist e machine learning engineer si imbatteranno sicuramente in situazioni in cui dovranno fare affidamento sulla propria competenza statistica.
Concetti matematici per la data science
La data science ruota intorno a numeri e calcoli e, di conseguenza, la matematica ha un ruolo importante. Anche se una laurea avanzata in matematica non è una tappa necessaria nella roadmap, comprendere algebra e calcolo ti aiuterà a capire concettualmente diversi metodi spesso usati in data science. Molti approcci alla riduzione della dimensionalità (come PCA e Matrix Factorization) si basano sull'algebra lineare e molti algoritmi di ottimizzazione (come il gradient descent) si basano sul calcolo.
E, come per statistica e analisi dei dati, questa conoscenza non è necessariamente rilevante per tutti i ruoli. Se punti a diventare machine learning engineer, la matematica è imprescindibile. Ma per la maggior parte degli altri ruoli — anche per un data scientist — si può talvolta cavarsela senza conoscere a fondo algebra e calcolo.
Per saperne di più e comprendere i concetti algebrici, dai un'occhiata al nostro corso su Linear Algebra for Data Science in R
5. Esplorare argomenti avanzati: Machine Learning e AI
Introduzione al machine learning
Il machine learning è l'arte di creare software che impara dai dati. È davvero il pane quotidiano per data scientist, machine learning engineer e persino data engineer. La parte della tua soluzione che fornisce il fatturato atteso per la tua azienda in base a inventario e prezzi? È costruita con il machine learning!
Il livello minimo di conoscenza richiesto come data scientist è saper addestrare e valutare modelli. In alcune situazioni potresti voler approfondire e imparare a modificare algoritmi esistenti o persino a scriverne di nuovi, entrando nel regno del machine learning engineer.
Hai molta libertà su come fare machine learning. Puoi scrivere tutto il codice da solo/a (in Python, R, C# o Java, con librerie pertinenti), usare pacchetti software locali (come Weka e RapidMiner) o soluzioni cloud (come Databricks e AWS SageMaker). Anche se questo rende difficile decidere cosa imparare, l'expertise che sviluppi si trasferisce piuttosto facilmente. Un buon modo per scegliere con quale toolkit iniziare è partire da un linguaggio che già conosci o verificare quali strumenti si usano nel settore che ti interessa.
Puoi iniziare con il nostro career track Machine Learning Scientist with Python, che copre molte delle basi necessarie per avviare la tua carriera.
Approfondire Deep Learning e AI
La relazione tra machine learning, deep learning e AI è dibattuta.
Quando insegnavo machine learning, aprivo sempre con un vivace dibattito in aula sulla frase: “Il Machine Learning è una forma di AI.” Anche se a volte vengono usati come sinonimi, sono convinto che il machine learning abiliti l'AI, ma non significa che se usi il machine learning hai creato AI.
Perché un'applicazione di dati diventi AI, è essenziale che esista un feedback loop in cui l'applicazione o il modello impara dal proprio output. In questo caso, un algoritmo di apprendimento supervisionato one-shot non è necessariamente AI. Se rimandi l'output del modello al modello stesso (come con il reinforcement learning), ottieni AI, poiché hai un sistema che continua ad apprendere automaticamente dai propri successi ed errori.
Il deep learning non è molto più di reti neurali potenziate. Ciò che rende interessanti le applicazioni è che il Deep Learning consente risultati molto tangibili, dato che questi modelli possono generare testo, immagini e parlato. Se lavori a un progetto in cui è essenziale che i modelli producano qualcosa di percepibile o fruibile da utenti finali umani, comprendere il deep learning può essere un vero vantaggio. Un ottimo corso introduttivo è Introduction to Deep Learning in Python.
6. Applicazioni pratiche e progetti reali
Implementare progetti di data science
Nessun lavoro di data science vive in un vuoto. Man mano che avanzi lungo il tuo percorso, è importante conservare e mostrare gli artefatti che produci. Parte dell'essere data scientist è saper dimostrare ciò che sai fare.
Per me, la parte più entusiasmante della data science è che non serve molto. Ti basta un dataset pubblico e un po' di creatività per formulare una domanda interessante e poi rispondervi usando i dati. Oppure puoi semplicemente andare su DataLab o Kaggle e iniziare a lavorare su esercizi e/o contest, traendo ispirazione da altri invii.
In alternativa, puoi raccogliere e usare i tuoi dati. Io ho analizzato i miei dati di ciclismo scaricati da Strava e ho fatto scraping di dati immobiliari per aiutarmi nella ricerca di una casa.
La parte più importante è documentare ciò che fai. Cerca di rendere il tuo lavoro riproducibile, spiega i passaggi eseguiti, condividi il codice e condividi l'output della tua analisi o del tuo sistema. Chissà? Magari il tuo esercizio di pratica è esattamente la soluzione al problema di qualcuno.
Progetti di esempio
Secondo me i progetti più interessanti sono quelli che nascono dalle tue passioni e dai tuoi interessi. Se usi un dataset di un ambito che conosci bene, è probabile che tu riesca a formulare domande uniche e interessanti. Conosci il dominio e conosci i dati... Ma se parti davvero da zero, ci sono tante cose su cui lavorare: app di dating, trading, sport.
Puoi anche trovare un'ampia gamma di progetti di data science su DataCamp, che ti permettono di familiarizzare con il tipo di lavoro. Che tu parta da alcuni progetti di data analytics o lavori su specifici progetti in Python, puoi arrivare fino al machine learning e persino a progetti di AI. Ci sono molte opzioni per iniziare.
Se, nonostante tutto, non riesci a trovare un modo per partire, un'altra alternativa utile potrebbe essere partecipare agli hackathon. Molti istituti di ricerca e grandi aziende organizzano hackathon periodici.
Questi hackathon hanno spesso l'obiettivo di raccogliere il contributo di team di data scientist su un problema rilevante e offrono quindi un'opportunità per collaborare e imparare da altri professionisti. Ti consentono di costruire una rete e farti notare da potenziali datori di lavoro mentre acquisisci esperienza utile.
Sviluppo del portfolio
Oggi è difficile immaginare un/una data scientist senza GitHub, portfolio DataCamp o una pagina Medium o un blog con del codice. Un portfolio è fondamentale nella data science, come in altre industrie creative.
Saper mostrare progetti passati è un ottimo modo per convincere che hai le carte in regola. Per questo vale la pena iniziare a documentare il tuo lavoro in un portfolio. In alternativa, puoi documentare il tuo lavoro e i tuoi punti di vista con post sul blog o persino con pubblicazioni accademiche. Dai un'occhiata al nostro post su come mostrare la tua esperienza con un portfolio per qualche ispirazione.
Qualunque cosa tu scelga, assicurati di mantenere una panoramica presentabile dei progetti su cui hai lavorato.
7. Navigare il panorama delle carriere in Data Science
Opportunità di carriera nella data science
Questo post ha messo in evidenza le diverse competenze, conoscenze e strumenti a disposizione di un/una data scientist. Ma da dove iniziare quando si decide una carriera?
A mio avviso, dipende davvero da dove sono le tue ambizioni. Finora questo post dovrebbe averti chiarito che non credo esista una roadmap unica valida per tutti.
Certo, ogni ruolo di data science poggia su fondamenta di statistica, manipolazione dei dati, machine learning e ingegneria del software. Ma oltre a questo, dipende.
Un/una data scientist usa algoritmi, mentre un/una machine learning engineer modifica o crea algoritmi. Il/la data scientist può quindi cavarsela conoscendo molti algoritmi e quando applicarli, mentre il/la machine learning engineer deve davvero comprendere i concetti matematici alla base degli algoritmi.
Allo stesso modo, se trai energia dalla condivisione dei risultati dell'analisi, come un/una data scientist o un/una data analyst, probabilmente trarrai più beneficio da una solida conoscenza di data visualization ed EDA che dall'essere molto bravo/a nel data modeling.
Quindi, la roadmap della data science ha diverse diramazioni, e puoi decidere tu quanto in profondità andare nei vari rami.
Prepararsi ai colloqui in data science
Nonostante le differenze tra ruoli, in ogni colloquio verrai testato/a su hard e soft skill. Questi test variano in base al ruolo che stai cercando.
Se non punti a un ruolo come machine learning o data engineer, con ogni probabilità non ti verranno fatte domande come “Come ottimizzeresti l'algoritmo A o B?”. È quindi importante concentrarsi sulle competenze e quindi sulle domande relative a ciò su cui vuoi e ti aspetti di lavorare. Ricevere domande su argomenti che non conosci può essere un segnale che il ruolo non fa per te.
Perché in questo campo relativamente nuovo, soprattutto in aziende dove i dati sono una novità, ci sono molte idee sbagliate su cosa siano i data scientist o cosa facciano.
Mi è capitato di candidarmi per il ruolo di data scientist dove l'intervistatore usava in modo intercambiabile data scientist e machine learning engineer. È quindi possibilissimo che il/la hiring manager abbia sbagliato se ti vengono fatte domande a cui non sai rispondere. Per esempio, raramente a un/una data engineer si dovrebbe chiedere come gestirebbe gli stakeholder in un progetto.
Per fortuna, ci sono diverse risorse per prepararti ai colloqui nel campo, a seconda del ruolo per cui ti candidi:
Restare aggiornati sui trend
Il campo della data science è molto dinamico ed è fondamentale restare aggiornati con gli ultimi trend. Con ChatGPT, la Generative AI è diventata mainstream, ed è ormai difficile immaginare un/una data scientist che non abbia almeno qualche nozione di token embeddings e/o modelli di attenzione. Allo stesso modo, l'introduzione di MLOps rende difficile immaginare un/una data engineer che controlli manualmente le prestazioni dei modelli e il drift.
Con questa crescita dinamica, diventano importanti diversi aspetti dell'AI. Attualmente, molta attenzione è rivolta agli aspetti etici e legali dell'AI, come dimostrato da vari dibattiti accademici e politici che hanno, tra le altre cose, portato a nuove regole e regolamentazioni.
Indipendentemente dalle decisioni dei governi riguardo all'AI, nessuno vuole essere responsabile del prossimo scandalo nella data science. L'unico modo per evitarlo è restare consapevoli dei confini etici e legali. O meglio ancora, come professionista, puoi iniziare a contribuire a questi sviluppi usando il tuo background e formandoti e esprimendo un'opinione.
Ci sono molti modi per restare aggiornati. Certo, c'è DataCamp come piattaforma, ma puoi anche cercare e seguire professionisti ispiranti del tuo settore. Verifica se hanno blog, post su X o Medium, o altro, dove puoi intravedere come vedono il panorama in cambiamento.
Risorse per l'apprendimento avanzato
Come abbiamo evidenziato in tutto l'articolo, ci sono molte risorse per chi vuole iniziare o crescere nel campo. In alternativa, se vuoi essere davvero vicino alla fonte, puoi guardare a conferenze tecniche come NeurIPS, ICML o KDD. Scopri queste e altre nella nostra lista delle Top Data Science Conferences for 2026.
Conclusioni e prossimi passi
Anche se le tappe sulla roadmap sono molte, non esiste un unico percorso di data science. Navigare il panorama richiede 1) un'idea del territorio (che speriamo tu abbia ricavato da questo post) e 2) un'idea dei tuoi punti di forza, debolezze e interessi, così da decidere cosa perseguire.
Se hai questi elementi, puoi fare affidamento su questo articolo per orientarti nella direzione giusta e su quali competenze puntare durante la formazione. Per fortuna, ci sono risorse utili per iniziare, come i career track di DataCamp, che ti forniscono le competenze per iniziare a esplorare diverse professioni:





Che tu sia uno studente, un/una aspirante data scientist o un professionista in cerca di un cambio di carriera, se vuoi diventare un/una data scientist esperto/a devi seguire un percorso. Non è sempre semplice, perché il panorama della data science è diventato piuttosto ampio e, di conseguenza, esistono diversi tipi di professionisti con attività e competenze differenti.
Per abbozzare un percorso di data science, questo articolo offre una panoramica del panorama della disciplina, così che tu possa vedere quali ruoli sono in linea con le tue ambizioni. Inoltre, fornisce indicazioni su come entrare o crescere verso ruoli diversi all'interno di questo panorama, rispondendo a domande come: Quali competenze dovresti sviluppare e quali metodi dovresti conoscere?
Iniziamo con la nostra roadmap di data science.
In breve: una roadmap di Data Science
In questo articolo approfondiamo tutti gli aspetti della roadmap. Tuttavia, se cerchi un riepilogo rapido della traccia, lo trovi qui sotto:
Seguendo questa roadmap, potrai orientarti efficacemente nel panorama della data science, costruire competenze essenziali e intraprendere una carriera gratificante nel campo.
1. Comprendere le basi della Data Science
Cos'è la data science?
Per capire il contesto di una roadmap di data science, è fondamentale farsi un'idea di cosa sia la Data Science. Abbiamo una guida completa con definizioni e spiegazioni sulla data science, ma, per gli scopi di questo articolo, considereremo la data science come l'insieme di attività volte a risolvere problemi usando i dati.
Un problema molto frequente è: “Ho una domanda, ma non conosco la risposta”. Quindi, se esegui una query SQL su un database delle vendite per capire quanto fatturato ha realizzato un'organizzazione il mese scorso, stai facendo data science!
Spesso, i problemi/le soluzioni sono più complessi e richiedono un set di competenze più diversificato. Per riuscire a discutere questo ampio ventaglio di ruoli e competenze lungo la nostra roadmap, useremo il ciclo di vita di un progetto di data science come contenitore. Questo ci permetterà di mappare le diverse attività e i ruoli e costituirà la base per esplorare i territori della data science.
2. Familiarizzare con il ciclo di vita dei progetti di Data Science
I progetti di data science iniziano per lo più da una domanda o un problema di business. Il problema innesca una fase di avvio, in cui si definisce un set di soluzioni possibili e si valuta l'iniziale fattibilità. Si esegue una raccolta iniziale di dati o un'analisi esplorativa dei dati disponibili per capire cosa è possibile e cosa no. I dati sono abbastanza ricchi? Contengono abbastanza feature?
Avvio ed esplorazione
Una volta che tutti i semafori sono verdi, si inizia a sviluppare un modello predittivo. Il modello userà input per prevedere gli output. Inizialmente, potrebbe essere un modello one-shot, addestrato, testato e validato su un set di cross-validation k-fold (una tecnica di machine learning per valutare quanto bene un modello potrebbe performare su dati non visti). Questo è il lavoro tipico dei data scientist classici. Quando il modello raggiunge prestazioni sufficienti, è il momento di portarlo in produzione e inserirlo in una pipeline nell'infrastruttura esistente, dove le prestazioni verranno monitorate e il modello verrà riaddestrato quando necessario.
Ciascuna di queste fasi richiede competenze diverse. Durante la fase di avvio, serve avere sensibilità per il business, familiarità con trasformazione e pulizia dei dati, statistica descrittiva e statistica inferenziale di base. È un lavoro che può essere svolto da un data analyst e/o da un data scientist.
Sviluppo del modello e messa in produzione
Nella fase di modellazione vanno costruiti modelli predittivi. Modelli semplici, come le regressioni, possono essere realizzati da un data analyst, ma se la complessità aumenta avrai bisogno di un data scientist per costruire un modello usando un algoritmo esistente o addirittura di un machine learning engineer per modificare algoritmi attuali o crearne di nuovi.
Quando distribuisci e metti in produzione il modello entri nel regno del machine learning engineer o del data engineer. Diversamente dalle fasi precedenti non c'è necessariamente un forte legame con il business, e il compito in questione ruota attorno alla creazione e al monitoraggio di una pipeline intorno al modello predittivo per fornire output affidabili ai sistemi target giusti.
Durante l'intero processo tutti i dati dovrebbero essere disponibili nei posti giusti con le giuste metainformazioni, ed è questo il ruolo del data architect. Man mano che nuovi dati vengono acquisiti o che i dati esistenti vengono trasformati in nuove informazioni, si assicurano allo stesso modo che i dati finiscano nel posto giusto.
Integrazione dei ruoli e collaborazione cross‑funzionale
Il modo in cui i diversi ruoli contribuiscono nelle varie fasi del ciclo di vita è illustrato nell'immagine qui sotto. Poiché ruoli differenti contribuiscono in fasi diverse, richiedono competenze diverse.
I ruoli all'inizio del ciclo di vita richiedono più sensibilità per il business e meno ingegneria, mentre le fasi successive richiedono meno sensibilità per il business e più ingegneria e ottimizzazione degli algoritmi. Per chiarire: come data scientist puoi cavartela con prestazioni computazionali subottimali per mostrare il valore e le performance del modello. Ma appena sei responsabile della messa in produzione dei modelli, devi saper ottimizzare la complessità computazionale per garantire che la pipeline sia (anche in termini di costi) efficiente.
Il livello di contributo dei diversi ruoli di Data Science lungo un progetto di Data Science (DAn - Data Analyst, DS - Data Scientist, MLE - Machine Learning Engineer, DE - Data Engineer, DAr - Data Architect - Immagine dell'autore
È importante sapere che i confini tra i ruoli non sono rigidi. Molti data scientist già pensano ai giusti sistemi sorgente/target e all'efficienza computazionale e li considerano nel loro codice. Un machine learning engineer potrebbe rendersi conto che certi approcci di generazione delle feature potrebbero migliorare le prestazioni del modello. Un data analyst potrebbe dare buoni consigli su dove nel data catalog archiviare le feature generate per il data architect. In altre parole, tutti i ruoli dovrebbero, in una certa misura, essere consapevoli del lavoro degli altri, ma non è necessario che comprendano in profondità le responsabilità reciproche.
Competenze e strumenti essenziali
Per quanto riguarda le competenze e gli strumenti di cui avrai bisogno, esiste una base chiara. Indipendentemente da dove contribuisci nel ciclo di vita di un progetto di data science, ti servirà una comprensione di base di matematica e statistica, sviluppo software collaborativo e manipolazione dei dati. In generale, l'inizio di qualsiasi roadmap di data science consiste in:
Esistono diversi tipi di ruoli di data science con requisiti di competenze differenti: un Data Analyst avrà bisogno di una conoscenza più approfondita di SQL rispetto a un Data Engineer. Un Data Scientist deve conoscere il Machine Learning meglio di un Data Architect. E qui la roadmap si ramifica: a seconda di dove si collocano le tue ambizioni nel panorama, dovrai imparare competenze diverse. Le sezioni seguenti descriveranno i vari rami della roadmap a cui puoi pensare.
3. Approfondire analisi e visualizzazione dei dati
Exploratory Data Analysis (EDA)
Indipendentemente da quanto sei avanti nel tuo percorso, che tu sia un veterano o agli inizi, tutti i progetti di data science iniziano dalla comprensione dei dati.
Comprendere a fondo i tuoi dati è cruciale per valutare la fattibilità del progetto. Si parte da domande di base come “quali variabili ho?” e “quante osservazioni ho?” per arrivare a domande più complesse come “quali sono le relazioni tra le variabili?”
Spesso i risultati di un'EDA possono già essere la risposta alle domande dei tuoi stakeholder. Se visualizzati correttamente e presentati in modo coerente, ad esempio in una dashboard, gli esiti di una semplice analisi dei dati possono servire a rispondere a domande complesse. Questo, tuttavia, si basa sulla competenza in data visualization.
Anche solo mostrando, tramite la tua EDA, che per esempio esistono segmenti diversi di visitatori del sito, hai creato valore in modo da data scientist.
Ci sono molti modi per visualizzare i risultati. O tramite librerie/pacchetti di visualizzazione nel linguaggio che usi (come ggplot2 di R e matplotlib di Python) o con strumenti dedicati alla visualizzazione dei dati (come PowerBI, Tableau o anche Excel)
Padroneggiare la visualizzazione dei dati
In particolare, se ci concentriamo maggiormente sui compiti di un Data Analyst, una comprensione più profonda della visualizzazione dei dati è d'aiuto.
Per la maggior parte dei ruoli di data science, le visualizzazioni possono servire a verificare ipotesi tramite scatter plot e istogrammi, ma quando l'analisi stessa è il deliverable, come per un Data Analyst, ti troverai in situazioni in cui vuoi rendere gli esiti dell'analisi piacevoli da fruire.
Pensa a linee grafiche personalizzate, nuove visualizzazioni o infografiche da usare come input per un'unità decisionale. In queste situazioni, aiuta saper creare una visualizzazione dei dati che sia praticamente un'opera d'arte. Understanding Data Visualization è un corso che aiuta davvero ad approfondire le tue competenze di dataviz.
Una roadmap di Data Science, visualizzata come una mappa della metro, che mostra le basi comuni a tutti i ruoli e le competenze specifiche dei diversi ruoli. - Immagine dell'autore
4. Costruire le basi di statistica e matematica
Statistica descrittiva e inferenziale
Un'altra delle prime tappe lungo una roadmap di data science è la statistica. Alcuni concetti statistici di base dovrebbero diventare una seconda natura per qualsiasi tipo di data scientist.
In qualsiasi momento, dovrai essere in grado di descrivere i tuoi dati e i sottogruppi. Qual è il reddito medio nel tuo dataset? Quali sono il minimo e il massimo? Qual è la deviazione standard o quali sono altre misure di dispersione? E se hai valori categoriali, quanti valori unici ci sono? Qual è il più frequente? Tutti i valori si presentano con la stessa frequenza o la distribuzione è meno uniforme?
Rispondere a domande con analitiche descrittive su gruppi/sottogruppi può già fornire insight preziosi, ma spesso occorre guardare alle relazioni tra variabili nel dataset e passare alla statistica inferenziale.
La parte impegnativa e interessante della statistica inferenziale sono i diversi tipi di variabili categoriali e numeriche e le relazioni tra di esse. Alcuni esempi includono:
Per poter rispondere a queste domande, devi conoscere i diversi tipi di test statistici, dai più semplici, come il T-Test, a metodi più complessi come le regressioni lineari multivariate o l'analisi di serie storiche.
Puoi seguire corsi pertinenti per approfondire la statistica in: Python, R e anche indipendenti dallo strumento. Questi corsi forniscono una base adeguata per iniziare a lavorare con il machine learning. Comprendendo statisticamente la relazione tra predittori e variabili target, capisci i principi degli algoritmi usati per creare modelli di apprendimento supervisionato.
Quanto in profondità addentrarti dipende ancora una volta da dove vuoi arrivare lungo la roadmap. Se punti a diventare data analyst, potrebbero bastare le basi di statistica. I data architect potrebbero non aver bisogno di conoscenze statistiche. Ma data scientist e machine learning engineer si imbatteranno sicuramente in situazioni in cui dovranno fare affidamento sulla propria competenza statistica.
Concetti matematici per la data science
La data science ruota intorno a numeri e calcoli e, di conseguenza, la matematica ha un ruolo importante. Anche se una laurea avanzata in matematica non è una tappa necessaria nella roadmap, comprendere algebra e calcolo ti aiuterà a capire concettualmente diversi metodi spesso usati in data science. Molti approcci alla riduzione della dimensionalità (come PCA e Matrix Factorization) si basano sull'algebra lineare e molti algoritmi di ottimizzazione (come il gradient descent) si basano sul calcolo.
E, come per statistica e analisi dei dati, questa conoscenza non è necessariamente rilevante per tutti i ruoli. Se punti a diventare machine learning engineer, la matematica è imprescindibile. Ma per la maggior parte degli altri ruoli — anche per un data scientist — si può talvolta cavarsela senza conoscere a fondo algebra e calcolo.
Per saperne di più e comprendere i concetti algebrici, dai un'occhiata al nostro corso su Linear Algebra for Data Science in R
5. Esplorare argomenti avanzati: Machine Learning e AI
Introduzione al machine learning
Il machine learning è l'arte di creare software che impara dai dati. È davvero il pane quotidiano per data scientist, machine learning engineer e persino data engineer. La parte della tua soluzione che fornisce il fatturato atteso per la tua azienda in base a inventario e prezzi? È costruita con il machine learning!
Il livello minimo di conoscenza richiesto come data scientist è saper addestrare e valutare modelli. In alcune situazioni potresti voler approfondire e imparare a modificare algoritmi esistenti o persino a scriverne di nuovi, entrando nel regno del machine learning engineer.
Hai molta libertà su come fare machine learning. Puoi scrivere tutto il codice da solo/a (in Python, R, C# o Java, con librerie pertinenti), usare pacchetti software locali (come Weka e RapidMiner) o soluzioni cloud (come Databricks e AWS SageMaker). Anche se questo rende difficile decidere cosa imparare, l'expertise che sviluppi si trasferisce piuttosto facilmente. Un buon modo per scegliere con quale toolkit iniziare è partire da un linguaggio che già conosci o verificare quali strumenti si usano nel settore che ti interessa.
Puoi iniziare con il nostro career track Machine Learning Scientist with Python, che copre molte delle basi necessarie per avviare la tua carriera.
Approfondire Deep Learning e AI
La relazione tra machine learning, deep learning e AI è dibattuta.
Quando insegnavo machine learning, aprivo sempre con un vivace dibattito in aula sulla frase: “Il Machine Learning è una forma di AI.” Anche se a volte vengono usati come sinonimi, sono convinto che il machine learning abiliti l'AI, ma non significa che se usi il machine learning hai creato AI.
Perché un'applicazione di dati diventi AI, è essenziale che esista un feedback loop in cui l'applicazione o il modello impara dal proprio output. In questo caso, un algoritmo di apprendimento supervisionato one-shot non è necessariamente AI. Se rimandi l'output del modello al modello stesso (come con il reinforcement learning), ottieni AI, poiché hai un sistema che continua ad apprendere automaticamente dai propri successi ed errori.
Il deep learning non è molto più di reti neurali potenziate. Ciò che rende interessanti le applicazioni è che il Deep Learning consente risultati molto tangibili, dato che questi modelli possono generare testo, immagini e parlato. Se lavori a un progetto in cui è essenziale che i modelli producano qualcosa di percepibile o fruibile da utenti finali umani, comprendere il deep learning può essere un vero vantaggio. Un ottimo corso introduttivo è Introduction to Deep Learning in Python.
6. Applicazioni pratiche e progetti reali
Implementare progetti di data science
Nessun lavoro di data science vive in un vuoto. Man mano che avanzi lungo il tuo percorso, è importante conservare e mostrare gli artefatti che produci. Parte dell'essere data scientist è saper dimostrare ciò che sai fare.
Per me, la parte più entusiasmante della data science è che non serve molto. Ti basta un dataset pubblico e un po' di creatività per formulare una domanda interessante e poi rispondervi usando i dati. Oppure puoi semplicemente andare su DataLab o Kaggle e iniziare a lavorare su esercizi e/o contest, traendo ispirazione da altri invii.
In alternativa, puoi raccogliere e usare i tuoi dati. Io ho analizzato i miei dati di ciclismo scaricati da Strava e ho fatto scraping di dati immobiliari per aiutarmi nella ricerca di una casa.
La parte più importante è documentare ciò che fai. Cerca di rendere il tuo lavoro riproducibile, spiega i passaggi eseguiti, condividi il codice e condividi l'output della tua analisi o del tuo sistema. Chissà? Magari il tuo esercizio di pratica è esattamente la soluzione al problema di qualcuno.
Progetti di esempio
Secondo me i progetti più interessanti sono quelli che nascono dalle tue passioni e dai tuoi interessi. Se usi un dataset di un ambito che conosci bene, è probabile che tu riesca a formulare domande uniche e interessanti. Conosci il dominio e conosci i dati... Ma se parti davvero da zero, ci sono tante cose su cui lavorare: app di dating, trading, sport.
Puoi anche trovare un'ampia gamma di progetti di data science su DataCamp, che ti permettono di familiarizzare con il tipo di lavoro. Che tu parta da alcuni progetti di data analytics o lavori su specifici progetti in Python, puoi arrivare fino al machine learning e persino a progetti di AI. Ci sono molte opzioni per iniziare.
Se, nonostante tutto, non riesci a trovare un modo per partire, un'altra alternativa utile potrebbe essere partecipare agli hackathon. Molti istituti di ricerca e grandi aziende organizzano hackathon periodici.
Questi hackathon hanno spesso l'obiettivo di raccogliere il contributo di team di data scientist su un problema rilevante e offrono quindi un'opportunità per collaborare e imparare da altri professionisti. Ti consentono di costruire una rete e farti notare da potenziali datori di lavoro mentre acquisisci esperienza utile.
Sviluppo del portfolio
Oggi è difficile immaginare un/una data scientist senza GitHub, portfolio DataCamp o una pagina Medium o un blog con del codice. Un portfolio è fondamentale nella data science, come in altre industrie creative.
Saper mostrare progetti passati è un ottimo modo per convincere che hai le carte in regola. Per questo vale la pena iniziare a documentare il tuo lavoro in un portfolio. In alternativa, puoi documentare il tuo lavoro e i tuoi punti di vista con post sul blog o persino con pubblicazioni accademiche. Dai un'occhiata al nostro post su come mostrare la tua esperienza con un portfolio per qualche ispirazione.
Qualunque cosa tu scelga, assicurati di mantenere una panoramica presentabile dei progetti su cui hai lavorato.
7. Navigare il panorama delle carriere in Data Science
Opportunità di carriera nella data science
Questo post ha messo in evidenza le diverse competenze, conoscenze e strumenti a disposizione di un/una data scientist. Ma da dove iniziare quando si decide una carriera?
A mio avviso, dipende davvero da dove sono le tue ambizioni. Finora questo post dovrebbe averti chiarito che non credo esista una roadmap unica valida per tutti.
Certo, ogni ruolo di data science poggia su fondamenta di statistica, manipolazione dei dati, machine learning e ingegneria del software. Ma oltre a questo, dipende.
Un/una data scientist usa algoritmi, mentre un/una machine learning engineer modifica o crea algoritmi. Il/la data scientist può quindi cavarsela conoscendo molti algoritmi e quando applicarli, mentre il/la machine learning engineer deve davvero comprendere i concetti matematici alla base degli algoritmi.
Allo stesso modo, se trai energia dalla condivisione dei risultati dell'analisi, come un/una data scientist o un/una data analyst, probabilmente trarrai più beneficio da una solida conoscenza di data visualization ed EDA che dall'essere molto bravo/a nel data modeling.
Quindi, la roadmap della data science ha diverse diramazioni, e puoi decidere tu quanto in profondità andare nei vari rami.
Prepararsi ai colloqui in data science
Nonostante le differenze tra ruoli, in ogni colloquio verrai testato/a su hard e soft skill. Questi test variano in base al ruolo che stai cercando.
Se non punti a un ruolo come machine learning o data engineer, con ogni probabilità non ti verranno fatte domande come “Come ottimizzeresti l'algoritmo A o B?”. È quindi importante concentrarsi sulle competenze e quindi sulle domande relative a ciò su cui vuoi e ti aspetti di lavorare. Ricevere domande su argomenti che non conosci può essere un segnale che il ruolo non fa per te.
Perché in questo campo relativamente nuovo, soprattutto in aziende dove i dati sono una novità, ci sono molte idee sbagliate su cosa siano i data scientist o cosa facciano.
Mi è capitato di candidarmi per il ruolo di data scientist dove l'intervistatore usava in modo intercambiabile data scientist e machine learning engineer. È quindi possibilissimo che il/la hiring manager abbia sbagliato se ti vengono fatte domande a cui non sai rispondere. Per esempio, raramente a un/una data engineer si dovrebbe chiedere come gestirebbe gli stakeholder in un progetto.
Per fortuna, ci sono diverse risorse per prepararti ai colloqui nel campo, a seconda del ruolo per cui ti candidi:
8. Formazione continua e apprendimento permanente
Restare aggiornati sui trend
Il campo della data science è molto dinamico ed è fondamentale restare aggiornati con gli ultimi trend. Con ChatGPT, la Generative AI è diventata mainstream, ed è ormai difficile immaginare un/una data scientist che non abbia almeno qualche nozione di token embeddings e/o modelli di attenzione. Allo stesso modo, l'introduzione di MLOps rende difficile immaginare un/una data engineer che controlli manualmente le prestazioni dei modelli e il drift.
Con questa crescita dinamica, diventano importanti diversi aspetti dell'AI. Attualmente, molta attenzione è rivolta agli aspetti etici e legali dell'AI, come dimostrato da vari dibattiti accademici e politici che hanno, tra le altre cose, portato a nuove regole e regolamentazioni.
Indipendentemente dalle decisioni dei governi riguardo all'AI, nessuno vuole essere responsabile del prossimo scandalo nella data science. L'unico modo per evitarlo è restare consapevoli dei confini etici e legali. O meglio ancora, come professionista, puoi iniziare a contribuire a questi sviluppi usando il tuo background e formandoti e esprimendo un'opinione.
Ci sono molti modi per restare aggiornati. Certo, c'è DataCamp come piattaforma, ma puoi anche cercare e seguire professionisti ispiranti del tuo settore. Verifica se hanno blog, post su X o Medium, o altro, dove puoi intravedere come vedono il panorama in cambiamento.
Risorse per l'apprendimento avanzato
Come abbiamo evidenziato in tutto l'articolo, ci sono molte risorse per chi vuole iniziare o crescere nel campo. In alternativa, se vuoi essere davvero vicino alla fonte, puoi guardare a conferenze tecniche come NeurIPS, ICML o KDD. Scopri queste e altre nella nostra lista delle Top Data Science Conferences for 2026.
Conclusioni e prossimi passi
Anche se le tappe sulla roadmap sono molte, non esiste un unico percorso di data science. Navigare il panorama richiede 1) un'idea del territorio (che speriamo tu abbia ricavato da questo post) e 2) un'idea dei tuoi punti di forza, debolezze e interessi, così da decidere cosa perseguire.
Se hai questi elementi, puoi fare affidamento su questo articolo per orientarti nella direzione giusta e su quali competenze puntare durante la formazione. Per fortuna, ci sono risorse utili per iniziare, come i career track di DataCamp, che ti forniscono le competenze per iniziare a esplorare diverse professioni: