courses
Python에서 데이터 가져오기 입문
3
340.8K
데이터의 양, 다양성, 속도가 증가함에 따라, 양질의 구조화된 데이터세트를 구축하는 일의 중요성은 그 어느 때보다 커졌습니다. 이는 산업 전반에서 인사이트의 정확성과 의사결정의 효과에 직접적인 영향을 미치기 때문입니다.
조직이 부실하거나 결함 있는 데이터를 사용하면 잘못된 결론에 도달해 시간, 비용, 자원을 낭비할 수 있습니다. 이때 데이터 랭글링이 핵심 프로세스로서 역할을 하며, 원시적이고 비구조화된 데이터를 분석에 적합한 깨끗하고 정리된 형식으로 변환합니다.
데이터 랭글링은 데이터가 정확하고 신뢰할 수 있으며 현재의 분석 목적에 맞게 조정되도록 일련의 단계를 포함합니다. 데이터 랭글링을 숙달하면 데이터를 최대한 활용해, 정보에 입각한 의사결정을 이끄는 실행 가능한 인사이트로 전환할 수 있습니다.
데이터 랭글링은 원시 데이터를 더 활용하기 좋은 형식으로 변환하는 과정입니다. 분석에 대비하도록 데이터를 정제하고, 구조화하고, 보강하는 작업을 포함합니다.
방금 방대한 데이터세트를 받았다고 상상해 보세요. 결측값, 불일치, 불필요한 정보로 어지럽습니다. 데이터 랭글링은 이 데이터를 깔끔하게 정리해 일관된 상태로 만드는 도구 상자와 같습니다.
데이터 랭글링은 데이터의 품질과 구조를 높여 정확한 분석을 가능하게 합니다. 깨끗하고 구조화된 데이터는 이후의 모든 데이터 워크플로—머신러닝 모델 구축, 시각화 생성, 통계 분석 수행—의 기반이 됩니다.
고품질 데이터는 분석의 오류와 편향 위험을 줄여 더 신뢰할 수 있는 인사이트를 제공합니다. 데이터 랭글링의 중요성을 이해하는 것은 데이터 기반 의사결정의 타당성에 직접적인 영향을 미치므로 필수적입니다.
데이터 랭글링을 소홀히 하면 실제 응용에서 중대한 결과를 낳을 수 있는 잘못된 결론으로 이어질 수 있습니다. 따라서 데이터 기반 의사결정을 진지하게 추구하는 사람에게 데이터 랭글링은 반드시 익혀야 할 역량입니다.
데이터 랭글링에는 5가지 주요 단계가 있습니다.
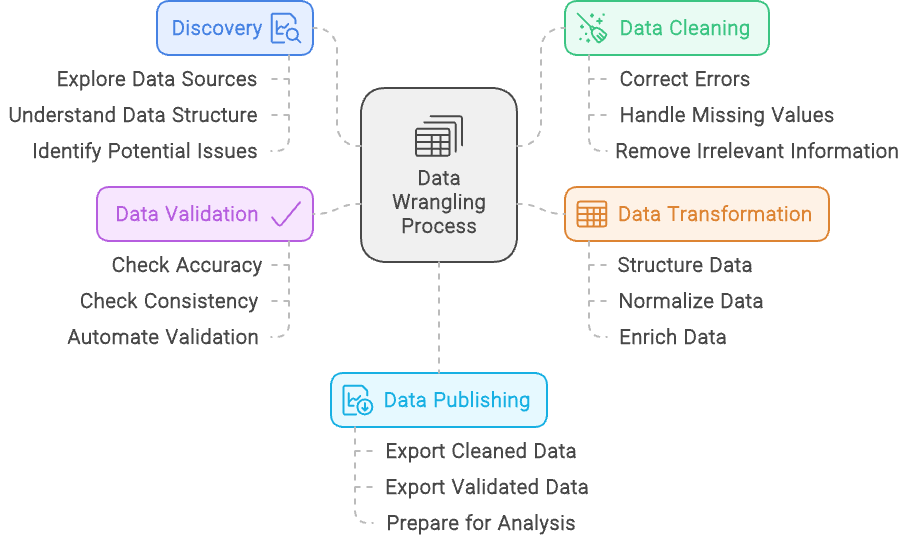
데이터 랭글링 프로세스 - Napkin.ai로 제작
데이터 랭글링의 다섯 단계를 개괄했습니다. 이제 각 단계를 조금 더 자세히 살펴보겠습니다.
데이터 랭글링의 탐색 단계는 퍼즐을 맞추기 전에 전체를 훑어보는 일과 비슷합니다. 데이터 유형, 출처, 구조를 이해하는 등, 다룰 대상에 대한 감을 잡기 위해 데이터세트를 살펴봅니다.
퍼즐 조각을 색이나 모서리 모양으로 분류하듯, 탐색은 데이터를 범주화하고 패턴을 인식하도록 도와 이후 작업의 기반을 마련합니다.
또한 탐색은 잠재적 문제—퍼즐의 누락된 조각이나 맞지 않는 색상과 같은—를 발견하는 과정이기도 합니다.
이 단계에서 불일치, 결측값, 예상치 못한 패턴 등 데이터의 문제를 식별합니다. 문제를 조기에 파악하면 이후 단계에서 어떻게 해결할지 계획할 수 있어, 깨끗하고 활용 가능한 데이터세트로 나아가는 길이 수월해집니다.
데이터 정제는 데이터세트를 다듬어 정확성과 신뢰성을 확보하는 과정입니다.
오류 수정, 결측값 처리, 불일치 해결 등의 이슈를 다룹니다. 예를 들어 동일 인물이나 거래에 대한 중복 엔트리가 있다면, 결과 왜곡을 피하기 위해 이를 제거합니다.
또한 전화번호처럼 서식이 제각각인 항목이 있다면 일관된 형식으로 표준화합니다. 목표는 데이터의 전반적인 품질과 무결성을 높여, 정확하고 의미 있는 분석이 가능하도록 만드는 것입니다.
데이터 변환은 분석 요구에 더 잘 맞도록 데이터세트를 수정·보강하는 과정입니다. 원하는 형식에 맞게 재구성하거나, 여러 출처의 데이터를 결합해 일관된 구조로 만드는 등 구조화를 포함합니다.
정규화도 핵심 요소입니다. 예를 들어 통화 가치를 하나의 통화로 맞추거나, 측정 단위를 표준화하는 등 값을 공통 척도나 형식으로 조정합니다.
또한 기존 데이터로 새로운 변수를 계산하거나 외부 데이터 소스를 통합해 맥락과 인사이트를 보강하는 작업도 포함됩니다. 예컨대 기존 데이터로 새로운 지표를 산출하거나, 다른 데이터베이스의 정보를 추가해 더 완전한 그림을 그릴 수 있습니다.
데이터 변환의 목적은 심층 분석에 필요한 활용성과 적합성을 높이도록 데이터를 준비하는 것입니다.
데이터 검증은 체계적인 점검과 자동화된 절차를 통해 데이터의 정확성과 신뢰성을 보장하는 과정입니다. 데이터가 정확하고 일관된지 확인하는 데 필수적입니다.
이 단계에서는 알려진 기준과 비교하거나, 사전 정의된 규칙·제약에 대한 유효성 검사를 수행해 불일치를 식별합니다. 자동화 프로세스는 이상치나 불일치를 표시하는 스크립트를 실행해, 데이터가 예상 형식과 범위를 준수하도록 합니다.
분석에 사용되기 전에 문제를 찾아내 결과에 오류가 반영되지 않도록 하는 것이 목표입니다. 엄격한 검증을 통해 데이터 기반 인사이트가 신뢰할 수 있는 정보에 근거하도록 합니다.
데이터 게시(Data Publishing)는 데이터 랭글링의 마지막 단계로, 정제되고 구조화된 데이터를 분석과 의사결정에 활용할 수 있도록 제공하는 과정입니다. 이해관계자가 데이터를 쉽게 접근하고 이해할 수 있도록 대시보드, 보고서, 인터랙티브 시각화 등을 제작해 배포 형식을 준비합니다.
이 단계에서는 사용자가 데이터를 질의하고 상호작용할 수 있도록 데이터 파이프라인이나 인터페이스를 구성해, 수요에 맞는 형식으로 전달되도록 합니다.
목표는 데이터에서 명확하고 실행 가능한 인사이트를 제공해 정보에 근거한 의사결정을 지원하고, 조직 전반의 소통을 촉진하는 것입니다. 효과적으로 데이터를 게시하면 랭글링의 노력은 의미 있고 실용적인 성과로 이어집니다.
데이터 랭글링과 데이터 정제는 종종 혼용되지만, 데이터 준비 과정의 서로 다른 측면을 가리킵니다. 둘 다 분석을 위한 준비에 필수지만, 목적과 과업이 다릅니다. 차이를 이해하면 각 역할을 명확히 하고, 데이터 준비의 모든 측면을 효과적으로 처리할 수 있습니다.
데이터 랭글링은 원시 데이터를 분석에 적합한 형식으로 변환하는 포괄적 과정입니다. 데이터 수집, 구조화, 정제, 검증 등 여러 단계를 아우릅니다. 다양한 출처의 데이터를 효과적으로 분석하고 인사이트를 도출할 수 있도록 준비하는 것이 목적입니다. 이를 통해 데이터가 정리되고 정확하며 심층 분석에 대비됩니다.
데이터 정제는 데이터 랭글링의 특정 하위 집합으로, 오류와 불일치를 해결해 데이터 품질을 높이는 데 집중합니다. 중복 기록 제거, 오탈자 교정, 결측값 처리, 형식 표준화 등의 작업을 포함합니다. 데이터 정제는 매우 중요하지만, 더 큰 랭글링 과정의 한 단계일 뿐입니다.
간단히 말해, 데이터 랭글링은 다양한 측면을 다단계로 처리해 데이터를 분석에 대비시키는 전체 프레임워크이고, 데이터 정제는 그 안에서 정확성과 일관성을 높이는 데 전념하는 핵심 구성 요소입니다.
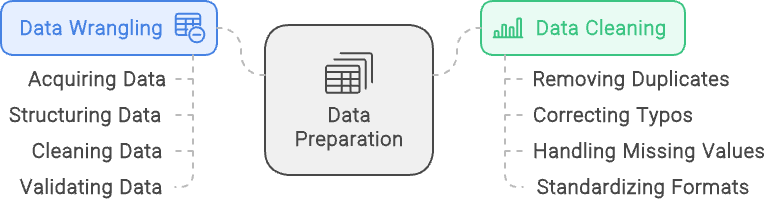
데이터 랭글링 vs 데이터 정제: 데이터 랭글링은 데이터의 구조화와 검증에, 데이터 정제는 깨끗하고 품질 높은 데이터 확보에 초점을 둡니다. 이미지: napkin.ai 제작
데이터 랭글링은 Excel이나 Alteryx 같은 GUI 기반 기초 도구부터 R, Python 같은 언어를 이용한 코딩까지 다양한 방식이 있습니다. 여기서는 몇 가지 옵션을 살펴보겠습니다.
간단한 데이터 랭글링 작업에는 Microsoft Excel과 Google 스프레드시트 같은 스프레드시트 도구가 자주 활용됩니다. 접근성이 높고 인터페이스가 익숙해 정렬, 필터링, 기본 정제 작업에 적합합니다. 특히 소규모 데이터세트나 데이터 랭글링을 막 시작하는 분들에게 유용합니다.
내장 함수와 수식을 통해 고급 기술 지식 없이도 계산과 데이터 조작을 빠르게 수행할 수 있습니다.
더 복잡한 데이터 조작과 자동화에는 Python과 R 같은 프로그래밍 언어가 널리 쓰입니다. Python은 Pandas, NumPy, OpenRefine 같은 강력한 라이브러리를 통해 대규모 데이터세트 처리와 정교한 변환에 탁월합니다.
R은 dplyr 과 tidyr 같은 패키지를 통해 강력한 데이터 분석 역량을 제공하며, 통계·학계에서 특히 선호됩니다. 두 언어 모두 유연성이 높아 커스텀 워크플로를 스크립팅하고 반복 작업을 자동화하기에 적합합니다.
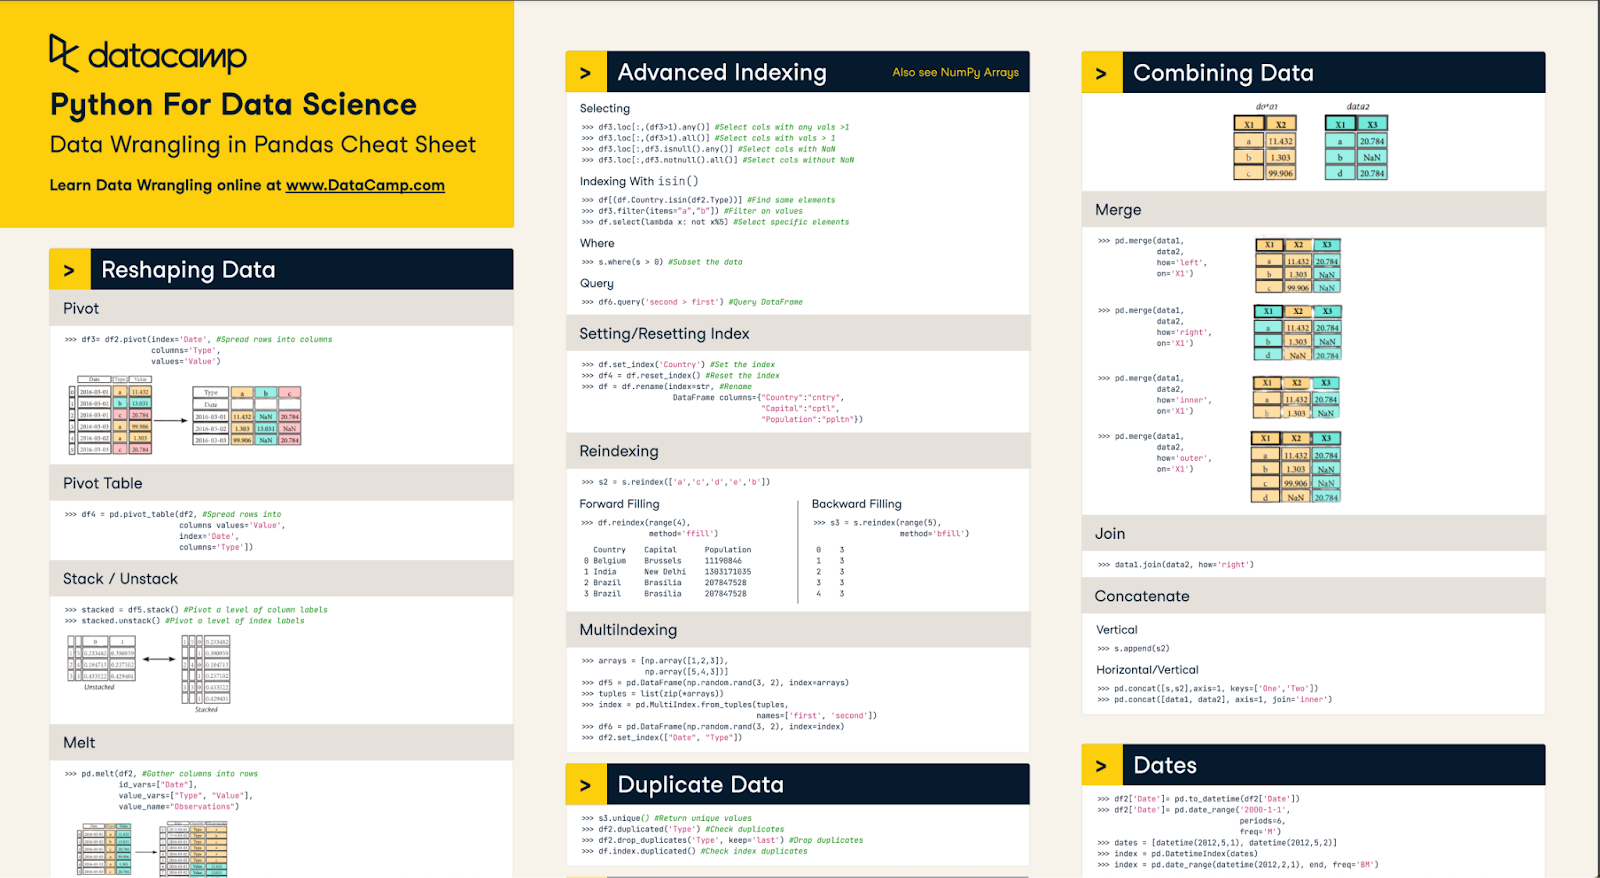
우리의 Pandas 데이터 랭글링 치트시트로 기본기를 빠르게 익히세요
전용 소프트웨어 도구는 복잡한 데이터 작업을 간소화하도록 설계되어, 강력하면서도 손쉬운 기능으로 랭글링을 효율화합니다. 코드 작성 없이도 데이터 정제, 구조화, 준비를 수행해야 하는 사용자에게 적합합니다.
Alteryx 는 이 분야의 선도 도구로, 드래그 앤 드롭 인터페이스를 통해 여러 출처의 데이터를 손쉽게 정제, 블렌딩, 변환할 수 있습니다. 필터링, 조인, 집계 등의 데이터 조작 도구가 내장되어 있어 작업이 수월합니다.
클라우드 기반 Alteryx Designer Cloud는 확장성과 협업 기능을 더해 대규모 데이터와 복잡한 워크플로를 다양한 환경에서 효율적으로 처리하도록 돕습니다. 온프레미스든 클라우드든, Alteryx는 데이터를 정확히 준비해 인사이트 있는 분석이 가능하도록 보장합니다.
엔드 투 엔드 솔루션이 필요한 종합 데이터 프로젝트에는 KNIME, Apache NiFi, Microsoft Power BI 같은 통합 플랫폼이 자주 사용됩니다. 이들 플랫폼은 데이터 랭글링뿐 아니라 단일 환경에서 데이터 통합, 분석, 시각화까지 지원합니다.
예를 들어 KNIME은 모듈형 노드 기반 인터페이스로 복잡한 워크플로를 시각적으로 구축할 수 있습니다. Apache NiFi는 시스템 간 데이터 흐름 관리와 자동화에 강점이 있고, Power BI는 준비 단계와 강력한 시각화를 결합합니다. 데이터의 준비-분석-공유가 매끄럽게 이뤄져야 하는 프로젝트에 최적입니다.
Python으로 데이터 랭글링을 수행하는 방법은 다양합니다. 주로 사용하는 두 패키지는 Pandas와 NumPy입니다. 이들 패키지는 주요 랭글링 기법을 손쉽게 수행할 수 있는 강력한 도구를 제공합니다.
Python에서 데이터 처리가 광범위하게 이루어지므로 이 패키지들을 익히는 것은 데이터 실무자에게 필수입니다. 수많은 기법 중에서도 고수준 정제(예: 결측값 제거), 데이터세트 병합, 결측값 처리 방법은 꼭 알아두세요.
데이터는 활용 전에 Python에서 정제해야 하는 경우가 많습니다. 문자열의 앞뒤 공백 제거, 결측값 삭제, 데이터 타입 교정 등이 해당됩니다.
데이터세트마다 특성이 달라 요구 사항도 다릅니다. 추가 정제가 필요한지 탐색을 통해 파악하세요. 다양한 기법과 코딩을 연습하는 것이 Python으로 데이터를 정제하는 여러 방법을 익히는 지름길입니다.
문자열 정제에서 흔한 문제 중 하나는 앞/뒤 공백입니다. 길이, 위치, 매칭 기준으로 파싱할 때 문제를 일으킬 수 있습니다. 이런 경우 시리즈에 str.strip() 메서드를 사용하는 것이 가장 좋습니다.
# Example utilizes a pandas series
# If working with a dataframe, call the series using df[col] syntax
s = pd.Series(['1. Ant.  ', '2. Bee!\n', '3. Cat?\t', np.nan, 10, True])
# It is important to include the .str or else the method will not work
s.str.strip()
Pandas에서 결측값을 삭제하는 일은 간단합니다. 결측값 채우기는 뒤에서 다루겠습니다. dropna() 메서드를 사용하면 됩니다. 이 메서드에는 행/열 삭제 조건을 세밀하게 지정하는 선택 인자가 있으며, 기본 동작은 결측값이 하나라도 있는 행을 삭제하는 것입니다.
# For any dataframe
df = pd.DataFrame({"name": ['Alfred', 'Batman', 'Catwoman'],
                   "toy": [np.nan, 'Batmobile', 'Bullwhip'],
                   "born": [pd.NaT, pd.Timestamp("1940-04-25"), pd.NaT]}
df.dropna()
.astype() 메서드는 시리즈의 데이터 타입을 변경할 수 있지만, 모든 값이 해당 타입과 일치해야 하므로 타입 교정은 다소 까다롭습니다.
예를 들어 object 타입 시리즈를 정수형으로 변환하려면 모든 값이 정수여야 합니다. 하나라도 정수가 아니면 에러가 납니다. 무효 값을 결측으로 강제(coerce)할 수도 있지만, 왜 특정 값이 변환되지 않는지 조사하는 편이 더 유용할 수 있습니다.
Pandas에서 DataFrame 병합은 SQL의 조인과 유사합니다. 기본 merge() 동작은 내부 조인입니다. 다만 결측도 조인하므로 주의가 필요합니다. 병합에는 키가 필요하며, 여러 열이나 인덱스로도 조인할 수 있습니다.
# Create two dataframes
df1 = pd.DataFrame({'lkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [1, 2, 3, 5]})
df2 = pd.DataFrame({'rkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [5, 6, 7, 8]})
# merge the df1 DataFrame to the df2 DataFrame using the columns key and rkey as keys
df1.merge(df2, left_on='lkey', right_on='rkey')
위 코드는 각 DataFrame의 lkey와 rkey 열에서 키가 일치하는 행을 기준으로 병합합니다. 일치하지 않는 값은 제거되어 일치하는 값만 남습니다. 병합 방식은 좌/우/외부 조인으로 변경할 수 있습니다. 이는 다양한 출처의 서로 다른 데이터세트를 결합하는 데 매우 유용합니다.
결측값 처리 방법은 업무 맥락에 따라 달라질 수 있습니다. 우선 결측의 원인을 고려해야 합니다. 기술적 오류 때문이라면, 분석에 앞서 오류를 수정하고 과거 데이터를 복구할 수 있는지 확인하는 것이 우선일 수 있습니다.
때로는 나머지 데이터만으로 분석이 가능해 결측을 무시해도 됩니다. 과거 데이터가 중요하지만 복구가 불가능하다면, 결측을 채워야 합니다. 결측 채우기 방법을 살펴보겠습니다.
결측 채우기의 기본은 Pandas의 fillna() 메서드입니다. 문자열의 결측이라면 df.fillna(value=’missing’)처럼 간단히 채울 수 있고, 이것만으로도 충분할 때가 있습니다. fillna()는 NumPy의 mean(), median() 같은 함수나 람다와 조합해 수치 결측을 수학적으로 채우는 등 응용 폭이 넓습니다.
또한 정렬된(예: 시계열) 데이터라면 Pandas의 interpolate()로 알고리즘적 보간을 적용할 수도 있습니다. 목표는 실제 데이터를 최대한 반영하도록 정확하게 값을 보완하는 것입니다.
SQL에서 데이터 랭글링을 수행하면 특히 데이터베이스가 클라우드에 있을 때 효율적입니다. 로컬 머신의 처리량과 네트워크 입·출력을 줄일 수 있기 때문입니다.
SQL 랭글링의 핵심은 적절한 추출, 변환, 적재를 통해 파이프라인을 흐르는 데이터의 범위를 최소화하는 것입니다. 이를 위해 데이터 필터링, 기준 테이블과의 조인, 집계를 활용합니다.
SQL에서 테이블을 필터링하는 기본 방법은 WHERE 절입니다. 사용법은 간단하지만 매우 강력합니다. 조건은 단순한 등식부터 유사 문자열 검색, 서브쿼리 활용까지 다양합니다. AND와 OR로 여러 조건을 결합할 수도 있습니다!
특정 열의 값으로 필터링하는 단순한 예시는 다음과 같습니다.
SELECT *
FROM sample_table
WHERE sample_col = 23LIKE나 IN 같은 표현을 사용하면 WHERE 절의 유연성이 커집니다. 예를 들어 다음 쿼리는 % 와일드카드로 이름이 J로 시작하는 사람을 찾고, 성(last_name)이 주어진 목록 IN에 포함된 사람을 찾습니다.
SELECT *
FROM sample_table
WHERE name LIKE ‘J%’ /* looks for people whose name starts with J */
AND last_name IN (‘Smith’, ‘Rockefeller’, ‘Williams’) /* Looks for people whose last name is in this list */
서브쿼리를 활용하면 다른 테이블의 결과에 기반해 필터링할 수 있어 유연성이 더 커집니다. 흔한 예로 특정 시점 이후의 고객 ID 목록을 찾는 경우가 있습니다.
SELECT *
FROM sample_table
WHERE customer_id IN (SELECT id FROM reference_table WHERE date >= ‘2024-01-01’)
이러한 기법을 조합해 입력 데이터를 정확히 원하는 범위로 제한하고, 데이터세트 크기를 최소화할 수 있습니다. 필터를 활용한 강력한 사용례로는 중복 제거가 있습니다. 더 고급 기법으로는 집계를 위한 HAVING 필터, 윈도 함수와 함께 쓰는 QUALIFY 문이 있습니다.
테이블 조인은 데이터세트에 필요한 추가 정보를 결합하는 방법입니다. SQL에는 INNER, OUTER, LEFT, RIGHT 등 다양한 조인이 있습니다. INNER와 OUTER는 어떤 데이터를 유지할지 결정합니다. INNER는 양쪽에 일치가 있을 때만 데이터를 유지하고, OUTER는 조인 방향(LEFT/RIGHT)에 따라 불일치 데이터도 유지합니다.
LEFT 조인은 왼쪽 테이블 데이터를, RIGHT 조인은 오른쪽 테이블 데이터를 유지합니다. LEFT/RIGHT와 INNER/OUTER를 조합할 수 있으며, 두 테이블의 모든 데이터를 결합하는 FULL OUTER JOIN도 있습니다.
조인 예시는 다음과 같습니다.
SELECT *
FROM a
LEFT OUTER JOIN
b
WHERE a.id = b.id
위 쿼리에서 a가 왼쪽, b가 오른쪽 테이블입니다. LEFT OUTER JOIN은 a.id = b.id로 조인하되 일치가 없더라도 왼쪽(a) 테이블의 데이터는 유지합니다. 조인은 필요한 보조 데이터를 가져오는 강력한 도구입니다.
SQL에서 데이터 랭글링에 활용할 수 있는 또 하나의 도구는 GROUP BY를 통한 집계입니다. 데이터를 단순화해 파이프라인으로 넘기기 전에 일부 전처리를 수행할 수 있습니다. 집계는 요약 통계를 계산하는 강력한 방법입니다. 예를 들어 고객 ID별 총 매출을 구하면 다음과 같습니다.
SELECT
Customer_ID,
SUM(sales)
FROM sample_table
GROUP BY Customer_IDSUM, MEAN, MAX, MIN 등 다양한 집계 함수를 통해 데이터를 빠르고 쉽게 파악할 수 있습니다. 집계를 활용하면 파이프라인의 데이터 유입을 단순화할 수 있습니다.
이 섹션에서는 데이터 랭글링 기법의 실용 예시와 활용 사례를 다룹니다. 주요 목표는 데이터 표준화, 데이터 소스 병합, 텍스트 처리입니다.
같은 대상을 다른 단위나 통화로 측정한 데이터를 표준화하는 일은 중요합니다. 그렇지 않으면 분석에 문제가 생길 수 있습니다.
여기서는 서로 다른 통화를 SQL에서 USD로 변환하는 간단한 예를 다룹니다. 테이블 1은 지역별 제품 판매가 담긴 sales, 테이블 2는 날짜별 지역 환율이 담긴 currency_exchange라고 가정합니다. 변환 예시는 다음과 같습니다.
SELECT
a.sale_id,
a.region,
CASE WHEN region <> ‘US’
	THEN a.sale_price * b.exchange_rate
	ELSE a.sale_price
END AS sale_price
FROM sales AS a
LEFT OUTER JOIN
currency_exchange AS b
WHERE a.region = b.regionsales의 sale_id와 region을 가져와, 지역 기준으로 currency_exchange의 환율과 조인해 변환합니다. 실제로는 날짜를 함께 사용해 해당 일자의 환율을 적용하는 경우가 많습니다.
데이터 랭글링의 주요 영역 중 하나는 머신러닝 모델을 위한 데이터 준비입니다. 최근에는 자연어 처리가 각광받으며, 그 전 단계로 텍스트 데이터 기반 감성 분석이 널리 사용됩니다.
이때 중요한 단계가 대소문자 정규화와 구두점 제거입니다. 구두점과 대문자는 모델에 큰 맥락을 주지 않는 경우가 많아 정규화하는 편이 낫습니다.
이를 위해 기본 Python 패키지와 re 패키지를 사용합니다. 아래는 구두점 제거, 소문자 변환, 공백 트리밍의 예시입니다.
# import regex
import re

# input string
test_string = "       Python 3.0, released in 2008, was a major revision of the language that is not completely backward compatible and much Python 2 code does not run unmodified on Python 3. With Python 2's end-of-life, only Python 3.6.x[30] and later are supported, with older versions still supporting e.g. Windows 7 (and old installers not restricted to 64-bit Windows)."
# remove whitespaces
no_space_string = test_string.strip()

# convert to lower case
lower_string = no_space_string .lower()

# remove numbers
no_number_string = re.sub(r'\d+','',lower_string)
print(no_number_string)
위 코드 스니펫은 공백 제거, 전체 소문자 변환, 숫자/비알파벳 문자 제거의 탄탄한 출발점을 제공합니다.
데이터 랭글링은 머신러닝 모델과 분석을 위한 데이터 준비의 핵심 요소입니다. Python의 pandas, numpy 같은 패키지와, SQL의 WHERE, GROUP BY 등 다양한 방법을 활용해 데이터를 준비할 수 있습니다.
이들 기법을 숙달하는 것은 데이터 전문가로 성장하는 데 필수적입니다. 데이터 랭글링을 더 깊이 배우고 싶다면 다음 자료를 참고하세요.
DataCamp 추천 코스
courses
courses
tracks