Cursus
Introductie tot data importeren in Python
3 Hr
340.7K
Nu de hoeveelheid, verscheidenheid en snelheid van data blijft toenemen, is het belangrijker dan ooit om te focussen op het opbouwen van kwalitatieve en goed gestructureerde datasets, omdat die rechtstreeks de nauwkeurigheid van inzichten en de effectiviteit van beslissingen in alle sectoren beïnvloeden.
Slecht georganiseerde of gebrekkige data kunnen tot verkeerde conclusies leiden, met kosten in tijd, geld en middelen tot gevolg. Hier komt data wrangling om de hoek kijken: het essentiële proces waarmee ruwe, ongestructureerde data wordt omgezet in een schoon, georganiseerd formaat dat klaar is voor analyse.
Data wrangling omvat een reeks stappen om te zorgen dat data nauwkeurig, betrouwbaar en afgestemd is op de specifieke behoeften van de analyse. Door data wrangling onder de knie te krijgen, ontgrendel je het volledige potentieel van je data en zet je die om in bruikbare inzichten die weloverwogen beslissingen aandrijven en uiteindelijk tot succes leiden.
Data wrangling is het proces waarbij ruwe data wordt omgevormd tot een bruikbaarder formaat. Dit houdt in: data opschonen, structureren en verrijken zodat die klaar is voor analyse.
Stel, je ontvangt een enorme dataset—rommelig, met ontbrekende waarden, inconsistenties en irrelevante informatie. Data wrangling is als een gereedschapskist die je helpt die data op te ruimen, zodat alles georganiseerd en consistent is.
Data wrangling is belangrijk om te zorgen dat je data van hoge kwaliteit en goed gestructureerd is, wat cruciaal is voor nauwkeurige data-analyse. Schone, gestructureerde data vormt de basis voor alle volgende stappen in de dataworkflow—of je nu een machinelearningmodel bouwt, visualisaties maakt of statistische analyses uitvoert.
Data van hoge kwaliteit verkleint de kans op fouten en bias in je analyse, wat tot betrouwbaardere inzichten leidt. Het belang van data wrangling begrijpen is cruciaal, omdat het rechtstreeks de geldigheid beïnvloedt van de beslissingen die op basis van die data worden genomen.
Slecht uitgevoerde wrangling kan tot foutieve conclusies leiden, met grote gevolgen in toepassingen in de echte wereld. Daarom is data wrangling beheersen essentieel voor iedereen die serieus met data-gedreven beslissingen aan de slag wil.
Er zijn 5 hoofdstappen in data wrangling:
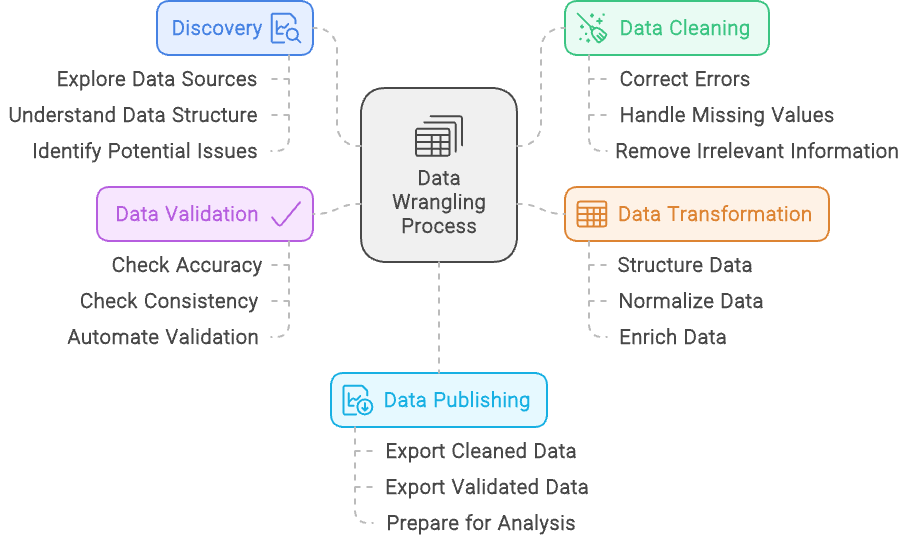
Het data-wranglingproces - gemaakt met Napkin.ai
We hebben de vijf stappen van data wrangling geschetst, maar laten we elk onderdeel in meer detail bekijken:
De ontdekkings-stap in data wrangling is als voor het eerst naar een puzzel kijken voordat je de stukjes in elkaar zet. Je bekijkt de dataset om een duidelijk beeld te krijgen van waar je mee werkt, inclusief de soorten data, de bronnen en hoe alles is gestructureerd.
Net zoals je puzzelstukken op kleur of rand zou sorteren, helpt ontdekking je om patronen in de data te herkennen en te categoriseren, wat de basis legt voor het verdere werk.
Ontdekking draait ook om het opsporen van mogelijke problemen—zoals ontbrekende stukjes of niet-passende kleuren in een puzzel.
In deze stap identificeer je issues in de data, zoals inconsistenties, ontbrekende waarden of onverwachte patronen. Door deze uitdagingen vroeg te ontdekken, kun je plannen hoe je ze in de volgende stappen van data wrangling aanpakt, zodat je soepeler toewerkt naar een schone, bruikbare dataset.
Data opschonen draait om het verfijnen van je dataset om die nauwkeurig en betrouwbaar te maken.
Dit omvat het aanpakken van zaken als het corrigeren van fouten, omgaan met ontbrekende waarden en het herstellen van inconsistenties. Als je dataset bijvoorbeeld dubbele records bevat voor dezelfde persoon of transactie, verwijder je die duplicaten om scheve resultaten te voorkomen.
Daarnaast, als sommige invoeren verkeerd zijn opgemaakt—zoals telefoonnummers met verschillende formaten—dan standaardiseer je ze naar één consistent formaat. Het doel is de algehele kwaliteit en integriteit van de data te verhogen, zodat die klaar is voor een nauwkeurige en betekenisvolle analyse.
Data transformatie is het proces waarbij je je dataset aanpast en verrijkt zodat die beter aansluit bij de eisen van je analyse. Dit houdt in dat je de data structureert, bijvoorbeeld door die te herschikken naar het gewenste formaat of door meerdere bronnen samen te voegen tot een samenhangende structuur.
Data normaliseren is een ander belangrijk aspect: waarden aanpassen naar een gemeenschappelijke schaal of formaat, zoals alle valuta naar één munteenheid omrekenen of eenheden standaardiseren.
Verder omvat data transformatie het verrijken van de dataset door nieuwe variabelen toe te voegen of externe databronnen te integreren voor meer context of inzicht. Je kunt bijvoorbeeld nieuwe metrics berekenen op basis van bestaande data of extra informatie uit andere databases toevoegen voor een completer beeld.
Het doel van data transformatie is de data zo voor te bereiden dat de bruikbaarheid en relevantie voor diepgaande analyse toenemen.
Data validatie houdt in dat je via systematische checks en geautomatiseerde processen de nauwkeurigheid en betrouwbaarheid van je dataset waarborgt. Deze stap is cruciaal om te bevestigen dat de data zowel correct als consistent is.
Tijdens data validatie voer je verschillende controles uit om afwijkingen te identificeren, zoals data vergelijken met bekende referenties of valideren tegen vooraf gedefinieerde regels en constraints. Geautomatiseerde processen kunnen scripts omvatten die anomalieën of inconsistenties markeren, zodat de data voldoet aan verwachte formaten en bereiken.
Het doel van data validatie is problemen te onderscheppen vóórdat de data voor analyse wordt gebruikt, zodat fouten de resultaten niet beïnvloeden. Door de nauwkeurigheid en betrouwbaarheid grondig te verifiëren, zorg je dat de inzichten op betrouwbare informatie zijn gebaseerd.
Data publicatie is de laatste stap in het data-wranglingproces, waarin de opgeschoonde en gestructureerde data beschikbaar wordt gemaakt voor analyse en besluitvorming. Dit houdt in dat je de data voorbereidt voor verspreiding, vaak door dashboards, rapporten of interactieve visualisaties te maken die voor stakeholders toegankelijk en begrijpelijk zijn.
Tijdens data publicatie kun je datapijplijnen of interfaces inrichten waarmee gebruikers de data kunnen opvragen en ermee kunnen werken, zodat die wordt aangeboden in een formaat dat aan hun behoeften voldoet.
Het doel is heldere, actiegerichte inzichten te leveren die weloverwogen beslissingen mogelijk maken en de bevindingen in de hele organisatie helpen communiceren. Door data effectief te publiceren, zorg je dat het harde werk van data wrangling leidt tot betekenisvolle en praktische uitkomsten.
De termen data wrangling en data cleaning worden vaak door elkaar gebruikt, maar ze verwijzen naar verschillende aspecten van het datavoorbereidingsproces. Hoewel beide essentieel zijn om data klaar te maken voor analyse, hebben ze een ander doel en omvatten ze andere taken. Het verschil begrijpen helpt hun rol te verduidelijken en zorgt dat elk onderdeel van de voorbereiding effectief wordt aangepakt.
Data wrangling is een overkoepelend proces waarbij ruwe data wordt omgevormd tot een formaat dat geschikt is voor analyse. Het omvat meerdere fasen, waaronder data verwerven, structureren, opschonen en valideren. Het doel van data wrangling is data uit diverse bronnen voor te bereiden zodat die effectief kan worden geanalyseerd en gebruikt om inzichten te genereren. Dit proces zorgt dat data georganiseerd en accuraat is en klaar voor diepgaande analyse.
Data cleaning is daarentegen een specifieke subset van data wrangling. Het richt zich uitsluitend op het verbeteren van de datakwaliteit door fouten en inconsistenties aan te pakken en te corrigeren. Dit omvat taken zoals dubbele records verwijderen, typefouten herstellen, omgaan met ontbrekende waarden en dataformaten standaardiseren. Hoewel data cleaning een cruciaal onderdeel is van data wrangling, is het slechts één stap in het bredere proces.
Kort gezegd: data wrangling is het overkoepelende raamwerk dat data voorbereidt op analyse, met meerdere stappen voor verschillende aspecten van voorbereiding. Data cleaning is een integraal onderdeel daarvan, specifiek gericht op het verhogen van de nauwkeurigheid en consistentie van de data.
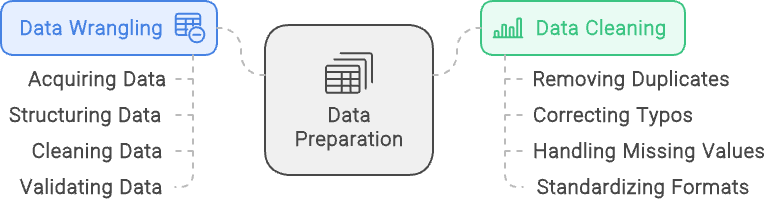
Data wrangling vs data cleaning: data wrangling richt zich op het structureren en valideren van data, terwijl data cleaning zich richt op het zorgen dat schone en kwalitatieve data beschikbaar is. Afbeelding gemaakt met napkin.ai
Er zijn veel manieren om data te wranglen: met fundamentele GUI-gebaseerde tools zoals Excel of Alteryx en via code met talen zoals R en Python. We verkennen hier een paar opties.
Voor eenvoudige data-wranglingtaken zijn spreadsheets zoals Microsoft Excel en Google Spreadsheets vaak de eerste keus. Deze tools zijn zeer toegankelijk en bieden een vertrouwde interface, ideaal voor taken zoals sorteren, filteren en basis-opschoning. Spreadsheets zijn vooral handig voor kleinere datasets of voor wie net begint met data wrangling.
Met ingebouwde functies en formules kun je snel berekeningen uitvoeren en data manipuleren zonder uitgebreide technische kennis.
Voor complexere datamanipulatie en automatisering worden programmeertalen zoals Python en R veel gebruikt. Python, met krachtige bibliotheken zoals Pandas, NumPy en OpenRefine, is uitstekend voor het verwerken van grote datasets en het uitvoeren van complexe transformaties.
R, met pakketten zoals dplyr en tidyr, is een andere sterke optie, vooral geliefd in de statistische en academische wereld vanwege de robuuste analysemogelijkheden. Beide talen bieden veel flexibiliteit: je kunt eigen workflows scripten en repetitieve taken automatiseren—ideaal voor dataprofessionals met geavanceerde wranglingbehoeften.
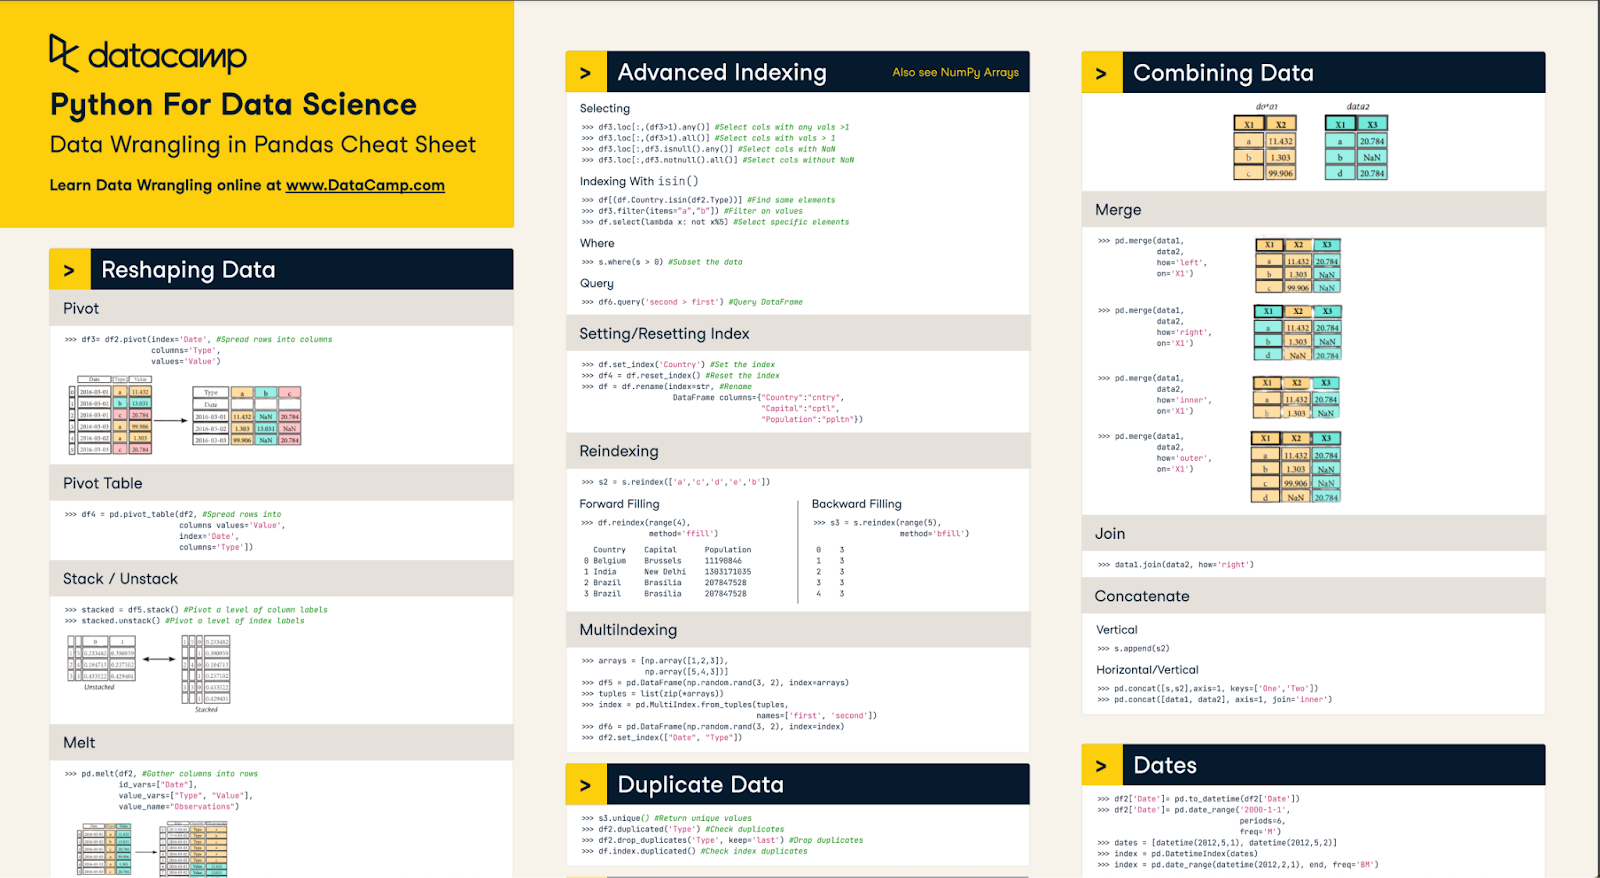
Onze Data Wrangling in Pandas Cheat Sheet helpt je veel van de basis onder de knie te krijgen
Dedicated softwaretools zijn specifiek ontworpen om het data-wranglingproces te stroomlijnen, met geavanceerde functies die complexe datataken vereenvoudigen. Deze tools zijn ideaal voor gebruikers die krachtige maar toegankelijke oplossingen nodig hebben om data op te schonen, te structureren en voor te bereiden op analyse, zonder uitgebreid te hoeven coderen.
Alteryx is een toonaangevende tool in deze categorie, bekend om de intuïtieve drag-and-dropinterface waarmee je eenvoudig data uit meerdere bronnen kunt opschonen, samenvoegen en transformeren. Het bevat tal van ingebouwde tools voor datamanipulatie, waardoor taken als filteren, joinen en aggregeren rechttoe-rechtaan zijn.
De cloudgebaseerde Alteryx Designer Cloud breidt deze mogelijkheden verder uit met een schaalbaar, collaboratief platform voor data wrangling. Teams kunnen hiermee realtime samenwerken en grote datasets en complexe workflows efficiënt afhandelen in verschillende omgevingen. Of het nu on-premises of in de cloud wordt gebruikt, Alteryx zorgt dat data nauwkeurig wordt voorbereid en klaar is voor inzichtelijke analyse.
Voor uitgebreide dataprojecten die end-to-endoplossingen vereisen, worden vaak geïntegreerde platformen zoals KNIME, Apache NiFi en Microsoft Power BI ingezet. Deze platformen ondersteunen niet alleen data wrangling, maar bieden ook tools voor integratie, analyse en visualisatie in één omgeving.
KNIME staat bijvoorbeeld bekend om de modulaire, knooppuntgebaseerde interface waarmee je visueel complexe workflows bouwt. Apache NiFi blinkt uit in het beheren en automatiseren van datastromen tussen systemen, terwijl Power BI datavoorbereiding combineert met krachtige visualisatie. Deze platformen zijn ideaal voor projecten waarin data naadloos moet worden voorbereid, geanalyseerd en gedeeld—een holistische aanpak voor data-gedreven besluitvorming.
Er zijn veel opties voor data wrangling met Python. Twee belangrijke pakketten zijn Pandas en NumPy. Deze pakketten bieden krachtige tools waarmee gebruikers eenvoudig kerntechnieken van data wrangling op hun datasets kunnen toepassen.
Er gebeurt ontzettend veel dataverwerking in Python, dus deze pakketten beheersen is essentieel voor iedere dataprofessional. Hoewel er tal van technieken zijn, is het belangrijk om te weten hoe je op hoog niveau data opschoont (bijv. nulls verwijderen), datasets samenvoegt en ontbrekende waarden afhandelt.
Er zijn veel situaties waarin data in Python moet worden opgeschoond voordat je die kunt gebruiken. Dit kan inhouden: afsluitende spaties uit strings verwijderen, null-waarden droppen, of datatypen corrigeren, om er een paar te noemen.
Elke dataset is anders en heeft eigen behoeften, dus verken je dataset om te begrijpen of extra opschoning nodig is. Oefenen met verschillende technieken en codeervaardigheden is een geweldige manier om alle manieren te leren waarop we data in Python kunnen opschonen.
Bij het opschonen van strings zijn afsluitende/voorafgaande spaties een veelvoorkomend probleem. Dit kan problemen geven bij het parsen op lengte, positie of matching. De beste manier om dit aan te pakken is de methode str.strip() op een Series te gebruiken.
# Example utilizes a pandas series
# If working with a dataframe, call the series using df[col] syntax
s = pd.Series(['1. Ant.  ', '2. Bee!\n', '3. Cat?\t', np.nan, 10, True])
# It is important to include the .str or else the method will not work
s.str.strip()
Null-waarden droppen in Pandas is eenvoudig. We bespreken later in dit artikel hoe je null-waarden kunt vullen. Je kunt simpelweg de methode dropna() gebruiken. Deze methode heeft optionele parameters waarmee je precies kunt kiezen onder welke voorwaarden een rij/kolom wordt gedropt, maar standaard wordt elke rij met een of meer null-waarden verwijderd
# For any dataframe
df = pd.DataFrame({"name": ['Alfred', 'Batman', 'Catwoman'],
                   "toy": [np.nan, 'Batmobile', 'Bullwhip'],
                   "born": [pd.NaT, pd.Timestamp("1940-04-25"), pd.NaT]}
df.dropna()
Met de methode .astype() kunnen gebruikers het datatype van een Series wijzigen, maar datatypen corrigeren is wat lastiger, omdat je ervoor moet zorgen dat elke waarde in je Pandas Series aan dat datatype voldoet.
Als je bijvoorbeeld een Series met type object omzet naar integer, betekent dat dat je weet dat elke waarde een integer is. Als er één waarde is die dat niet is, zal de methode een fout geven. Je kunt ervoor kiezen om te forceren door ongeldige waarden op null te zetten, maar vaak is het zinvoller te onderzoeken waarom bepaalde waarden niet worden geconverteerd.
DataFrames mergen in Pandas lijkt op joinen in SQL. Het standaardgedrag van een Pandas-merge() is een inner join. Let wel: er wordt ook op nulls gejoint, dus wees voorzichtig. Voor een merge heb je een specifieke sleutel nodig. Je kunt joinen op verschillende kolommen of zelfs op de index.
# Create two dataframes
df1 = pd.DataFrame({'lkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [1, 2, 3, 5]})
df2 = pd.DataFrame({'rkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [5, 6, 7, 8]})
# merge the df1 DataFrame to the df2 DataFrame using the columns key and rkey as keys
df1.merge(df2, left_on='lkey', right_on='rkey')
De bovenstaande code voegt de twee DataFrames samen op basis van overeenkomende sleutels in respectievelijk de kolommen lkey en rkey. Waarden zonder match worden gedropt en je houdt alleen de matches over. Je kunt het merge-gedrag ook aanpassen en kiezen voor een left/right/outer merge. Dit is een krachtige manier voor dataspecialisten om verschillende datasets uit diverse bronnen samen te brengen.
Bij ontbrekende waarden kan de aanpak per usecase verschillen. Je moet nagaan waarom een waarde ontbreekt. Als het door technische fouten komt, is het misschien beter eerst het technische probleem op te lossen voordat je de data analyseert, en te kijken of historische data kan worden hersteld.
Soms kun je de rest van de data gebruiken en de ontbrekende waarde negeren. Als historische data belangrijk en niet te herstellen is, moet je de missende data opvullen. Laten we bespreken hoe je ontbrekende informatie kunt invullen.
De belangrijkste methode om data in te vullen is fillna() van Pandas. Voor stringwaarden kun je hiermee nulls invullen, bijvoorbeeld: df.fillna(value='missing')—dat kan al voldoende zijn! Het mooie is dat je creatief kunt zijn: door fillna() te combineren met NumPy-methoden zoals mean(), median() en lambda-functies kun je ontbrekende waarden wiskundig invullen.
Er zijn ook Pandas-methoden zoals interpolate() die algoritmisch gaten kunnen opvullen als je data geordend is (bijv. tijdreeksen). Het doel is de data zo nauwkeurig mogelijk te vullen zodat die de werkelijkheid weerspiegelt.
Data wrangling in SQL kan een effectieve manier zijn om je data te verwerken, zeker als je SQL-database in de cloud staat. Dit beperkt de hoeveelheid data die op je lokale machine wordt verwerkt en de hoeveelheid in- en uitgaand dataverkeer over netwerken.
De kern van data wrangling in SQL is het beperken van de datastroom door goede extractie, transformatie en loading. Dat doen we onder andere door te filteren, te joinen met referentietabellen en te aggregeren.
De primaire manier om tabellen in SQL te filteren is met de WHERE-clausule. Die is vrij rechttoe-rechtaan, maar kan bijzonder krachtig zijn. De voorwaarden kunnen eenvoudige gelijkheidsvergelijkingen zijn, zoeken naar vergelijkbare strings of zelfs subqueries gebruiken. Je kunt meerdere where-clausules combineren met AND- en OR-statements!
Filteren op simpele gevallen, zoals zoeken naar een specifieke kolomwaarde, kan er zo uitzien:
SELECT *
FROM sample_table
WHERE sample_col = 23
Complexere statements zoals LIKE of IN geven je WHERE-clausules meer flexibiliteit. In het volgende voorbeeld zoeken we naar mensen van wie de naam met J begint dankzij het %-wildcard, en van wie de achternaam IN de opgegeven lijst staat.
SELECT *
FROM sample_table
WHERE name LIKE ‘J%’ /* looks for people whose name starts with J */
AND last_name IN (‘Smith’, ‘Rockefeller’, ‘Williams’) /* Looks for people whose last name is in this list */
Tot slot kan het gebruik van subqueries extra flexibiliteit bieden: je kunt filteren op basis van de resultaten van een andere tabel. Een veelvoorkomend voorbeeld is het vinden van een lijst met klant-ID's na een bepaalde datum-tijd.
SELECT *
FROM sample_table
WHERE customer_id IN (SELECT id FROM reference_table WHERE date >= ‘2024-01-01’)
Een combinatie van deze technieken zorgt ervoor dat je input precies is wat je zoekt en dat de dataset zo klein mogelijk blijft. Een krachtige toepassing van filters is het verwijderen van duplicaten om je dataset zo op te schonen. Meer geavanceerde technieken zijn HAVING-filters voor aggregaties en QUALIFY-statements met windowfuncties.
Met joins kun je extra informatie ophalen die je voor je datasets nodig hebt. SQL kent verschillende joins zoals INNER, OUTER, LEFT en RIGHT. Met INNER en OUTER bepalen we welke data behouden blijft: INNER houdt alleen data met een match aan beide kanten, terwijl OUTER ook niet-gematchte data behoudt, afhankelijk van de kant (links of rechts).
De LEFT join behoudt data aan de linkerkant van de join en de RIGHT join data aan de rechterkant. Je kunt LEFT en RIGHT combineren met INNER en OUTER, evenals de speciale FULL OUTER JOIN die simpelweg alle data uit beide tabellen joinet.
Een voorbeeldjoin kan zijn:
SELECT *
FROM a
LEFT OUTER JOIN
b
WHERE a.id = b.id
Bovenstaande statement heeft tabel a links (eerste) en tabel b rechts (tweede). De LEFT OUTER JOIN zegt: join de data uit a en b waar a.id = b.id, maar als er geen match is, behoud dan alle data uit a. Joins zijn krachtige middelen om extra data binnen te halen die nodig kan zijn voor je datainput.
Een laatste tool die we in SQL kunnen gebruiken voor data wrangling is de GROUP BY-clausule om te aggregeren. Dit vereenvoudigt de data en stelt ons in staat om vooraf wat voorbewerking te doen voordat de data verder de pijplijn in gaat. Aggregatie is krachtig om samenvattende statistieken te berekenen. Hier is een voorbeeld waarin we de totale omzet per klant-ID bekijken:
SELECT
Customer_ID,
SUM(sales)
FROM sample_table
GROUP BY Customer_ID
Er zijn tal van aggregatiefuncties zoals SUM, MEAN, MAX en MIN waarmee we snel een beeld van onze data krijgen. Door aggregaties te benutten, vereenvoudig je de data-invoer in pijplijnen.
In deze sectie behandelen we enkele praktische voorbeelden en usecases voor data-wranglingtechnieken. De hoofddoelen zijn: data standaardiseren, databronnen samenvoegen en tekstverwerking.
Data standaardiseren naar dezelfde eenheden is belangrijk. Als je werkt met data die hetzelfde meet in verschillende eenheden of valuta, kan dat je analyse verstoren.
We behandelen een eenvoudig voorbeeld van het omrekenen van verschillende valuta naar USD in SQL. Stel dat we twee tabellen hebben. Tabel 1 is een sales-tabel met productverkopen voor verschillende regio's en Tabel 2 is een currency_exchange-tabel met wisselkoersen per regio per dag. Zo'n conversie kan er zo uitzien:
SELECT
a.sale_id,
a.region,
CASE WHEN region <> ‘US’
	THEN a.sale_price * b.exchange_rate
	ELSE a.sale_price
END AS sale_price
FROM sales AS a
LEFT OUTER JOIN
currency_exchange AS b
WHERE a.region = b.region
Dit pakt de sale_id en region uit de sales-tabel en joint met de referentietabel currency_exchange op regio om de wisselkoers op te halen. Vaak is er ook een datum nodig om de koers van die dag te gebruiken.
Een belangrijk onderdeel van data wrangling is het voorbereiden van data voor machinelearningmodellen. Veel recente modellen richten zich op natural language processing en een voorloper daarvan is sentimentanalyse op tekstdata.
Een cruciale stap is de voorbereiding van tekst door te normaliseren en interpunctie te verwijderen. Omdat interpunctie en hoofdletters vaak weinig context toevoegen voor een model, is normaliseren vaak beter.
Hiervoor gebruiken we basispakketten in Python en het pakket re. Hieronder staat een voorbeeld van het verwijderen van interpunctie, het normaliseren naar kleine letters en het trimmen van spaties.
# import regex
import re

# input string
test_string = "       Python 3.0, released in 2008, was a major revision of the language that is not completely backward compatible and much Python 2 code does not run unmodified on Python 3. With Python 2's end-of-life, only Python 3.6.x[30] and later are supported, with older versions still supporting e.g. Windows 7 (and old installers not restricted to 64-bit Windows)."
# remove whitespaces
no_space_string = test_string.strip()

# convert to lower case
lower_string = no_space_string .lower()

# remove numbers
no_number_string = re.sub(r'\d+','',lower_string)
print(no_number_string)
Bovenstaande code vormt een goede basis om witruimte te verwijderen, alle tekens naar kleine letters om te zetten en cijfers/niet-alfabetische data te verwijderen.
Data wrangling is een cruciaal onderdeel van het voorbereiden van onze data voor machinelearningmodellen en analyses. Er zijn talloze tools in Python, zoals de pakketten pandas en numpy, naast diverse SQL-methoden zoals WHERE- en GROUP BY-clausules, die ons helpen de data voor te bereiden.
Beheersing van deze technieken is essentieel voor elke ambitieuze dataprofessional. Wil je dieper in data wrangling duiken, bekijk dan deze resources:
Topcursussen op DataCamp
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min