course
Introducere în importul datelor în Python
3 oră
340.8K
Odată cu creșterea volumului, varietății și vitezei datelor, concentrarea pe construirea unor seturi de date de calitate, bine structurate, a devenit mai critică ca oricând, deoarece acestea influențează direct acuratețea insight-urilor și eficiența deciziilor în diverse industrii.
Datele prost organizate sau defectuoase pot duce la concluzii eronate, costând timp, bani și resurse. Aici intervine data wrangling ca proces esențial care asigură că datele brute, nestructurate, sunt transformate într-un format curat și organizat, gata pentru analiză.
Data wrangling implică o serie de pași pentru a te asigura că datele sunt corecte, fiabile și adaptate nevoilor specifice ale analizei. Stăpânind data wrangling, poți valorifica întregul potențial al datelor tale, transformându-le în insight-uri acționabile care susțin decizii informate și, în cele din urmă, conduc la succes.
Data wrangling este procesul de transformare a datelor brute într-un format mai ușor de utilizat. Acesta include curățarea, structurarea și îmbogățirea datelor, astfel încât să fie gata pentru analiză.
Imaginează-ți că tocmai ai primit un set uriaș de date — este dezordonat, cu valori lipsă, inconsistențe și informații irelevante. Data wrangling este ca un set de instrumente care te ajută să pui ordine în aceste date, asigurându-te că sunt organizate și consecvente.
Data wrangling este important pentru a garanta că datele sunt de înaltă calitate și bine structurate, lucru esențial pentru o analiză corectă. Datele curate și structurate sunt fundația tuturor pașilor următori în fluxul de lucru cu date — fie că construiești un model de machine learning, generezi vizualizări sau efectuezi analize statistice.
Datele de calitate înaltă reduc riscul de erori și biasuri în analiză, ducând la insight-uri mai fiabile. Înțelegerea importanței data wrangling este esențială, deoarece impactează direct validitatea deciziilor luate pe baza acelor date.
Datele prost prelucrate pot conduce la concluzii greșite, cu consecințe semnificative în aplicații reale. Prin urmare, stăpânirea data wrangling este esențială pentru oricine ia în serios deciziile bazate pe date.
Există 5 pași principali în data wrangling:
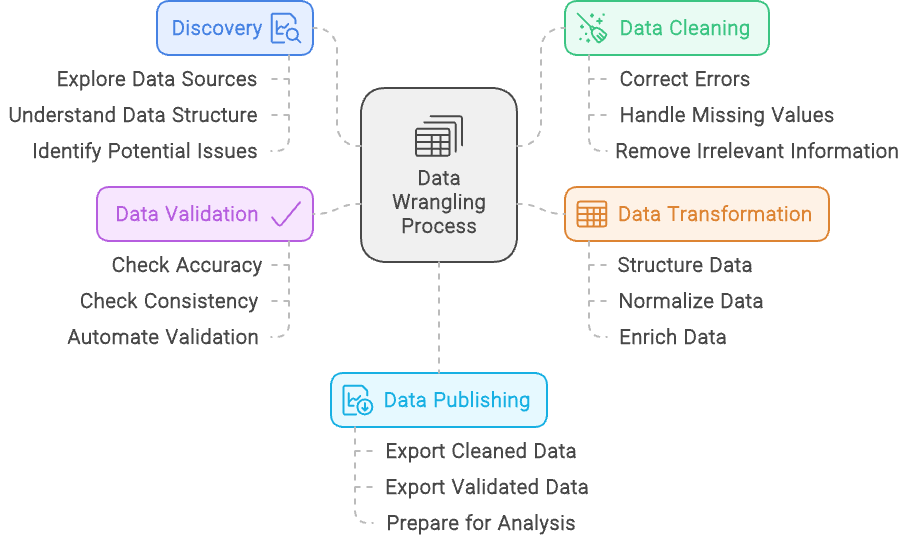
Procesul de data wrangling - creat cu Napkin.ai
Am prezentat cei cinci pași ai data wrangling, dar hai să-i analizăm pe fiecare în detaliu:
Pasul de descoperire în data wrangling e ca prima privire aruncată unui puzzle înainte să începi să pui piesele laolaltă. Implică examinarea setului de date pentru a înțelege clar cu ce lucrezi, inclusiv tipurile de date, sursele și structura lor.
Așa cum ai sorta piesele de puzzle după culoare sau muchii, descoperirea te ajută să categorizezi și să recunoști tipare în date, pregătind terenul pentru munca de mai departe.
Dar descoperirea înseamnă și identificarea problemelor potențiale — ca piese lipsă sau culori nepotrivite într-un puzzle.
În acest pas, identifici orice probleme din date, precum inconsistențe, valori lipsă sau tipare neașteptate. Descoperindu-le din timp, poți planifica cum să le abordezi în pașii următori, asigurând o cale mai lină către un set de date curat și utilizabil.
Curățarea datelor înseamnă rafinarea setului tău de date pentru a te asigura că este corect și fiabil.
Acest proces include rezolvarea problemelor precum corectarea erorilor, gestionarea valorilor lipsă și remedierea inconsistențelor. De exemplu, dacă setul tău de date conține înregistrări duplicate pentru aceeași persoană sau tranzacție, curățarea datelor va presupune eliminarea acestor duplicate pentru a evita distorsionarea rezultatelor.
În plus, dacă găsești intrări cu format greșit, cum ar fi numere de telefon în formate variate, le vei standardiza într-un format consecvent. Obiectivul este să crești calitatea și integritatea generală a datelor, făcându-le pregătite pentru o analiză corectă și relevantă.
Transformarea datelor este procesul de modificare și îmbunătățire a setului de date pentru a-l alinia mai bine cerințelor analizei. Acest pas implică structurarea datelor, precum remodelarea lor în formatul dorit sau combinarea mai multor surse într-o structură coerentă.
Normalizarea datelor este un alt aspect cheie, adică ajustarea valorilor la o scară sau un format comun, de exemplu convertirea tuturor valorilor monetare într-o singură monedă sau standardizarea unităților de măsură.
De asemenea, transformarea datelor include îmbogățirea setului prin adăugarea de variabile noi sau integrarea unor surse externe pentru mai mult context sau insight-uri. De exemplu, poți calcula noi metrici pe baza datelor existente sau poți adăuga informații suplimentare din alte baze de date pentru o imagine mai completă.
Scopul transformării datelor este să pregătească informația astfel încât să-i crească utilitatea și relevanța pentru analize în profunzime.
Validarea datelor presupune asigurarea acurateței și fiabilității setului de date prin verificări sistematice și procese automatizate. Acest pas este critic pentru a confirma că datele sunt corecte și consecvente.
În timpul validării, efectuezi diverse verificări pentru a identifica discrepanțe, cum ar fi compararea datelor cu repere cunoscute sau validarea față de reguli și constrângeri predefinite. Procesele automatizate pot include rularea unor scripturi care semnalează anomalii sau inconsistențe, asigurând respectarea formatelor și intervalelor așteptate.
Scopul validării este să depistezi problemele înainte ca datele să fie folosite în analiză, prevenind impactul erorilor asupra rezultatelor. Verificând riguros acuratețea și fiabilitatea, te asiguri că insight-urile se bazează pe informații solide.
Publicarea datelor este ultimul pas în procesul de data wrangling, în care datele curățate și structurate sunt puse la dispoziție pentru analiză și luarea deciziilor. Acest pas implică pregătirea datelor pentru diseminare, adesea prin crearea de dashboarduri, rapoarte sau vizualizări interactive care le fac accesibile și ușor de înțeles pentru stakeholderi.
În timpul publicării, poți configura pipeline-uri sau interfețe care permit utilizatorilor să interogheze și să interacționeze cu datele, livrându-le într-un format care le satisface nevoile.
Obiectivul este să oferi insight-uri clare și acționabile, facilitând deciziile informate și comunicarea rezultatelor în organizație. Publicând eficient datele, te asiguri că munca depusă în data wrangling se traduce în rezultate concrete și utile.
Termenii data wrangling și data cleaning sunt adesea folosiți interschimbabil, dar se referă la aspecte diferite ale pregătirii datelor. Deși ambele sunt esențiale pentru pregătirea datelor pentru analiză, au scopuri distincte și implică sarcini diferite. Înțelegerea diferenței clarifică rolurile lor și asigură gestionarea eficientă a fiecărui aspect al pregătirii datelor.
Data Wrangling este un proces cuprinzător care implică transformarea datelor brute într-un format potrivit pentru analiză. Include mai multe etape: obținerea datelor, structurarea, curățarea și validarea lor. Scopul data wrangling este să pregătească date din surse diverse pentru a putea fi analizate eficient și pentru a genera insight-uri. Acest proces asigură că datele sunt organizate, corecte și gata pentru analiză în detaliu.
Data Cleaning, pe de altă parte, este un subset specific al data wrangling. Se concentrează exclusiv pe îmbunătățirea calității datelor, abordând și corectând erorile și inconsistențele. Asta include sarcini precum eliminarea înregistrărilor duplicate, corectarea typo-urilor, gestionarea valorilor lipsă și standardizarea formatelor. Deși curățarea datelor este o parte crucială a data wrangling, ea reprezintă doar un pas dintr-un proces mai amplu.
Pe scurt, data wrangling este cadrul general care pregătește datele pentru analiză, incluzând mai mulți pași pentru a gestiona diverse aspecte ale pregătirii. Data cleaning este o componentă integrată a acestui cadru, dedicată în mod specific creșterii acurateței și consecvenței datelor.
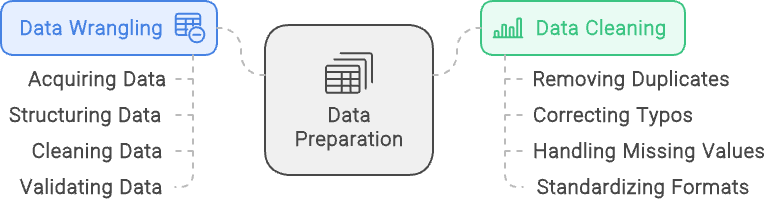
Data Wrangling vs Data Cleaning: Data Wrangling se concentrează pe structurarea și validarea datelor, în timp ce Data Cleaning se concentrează pe asigurarea faptului că sunt disponibile date curate și de calitate. Imagine creată cu napkin.ai
Există multe moduri de a prelucra datele, fie folosind instrumente fundamentale cu interfață grafică (GUI), precum Excel sau Alteryx, fie prin programare în limbaje precum R și Python. Vom explora câteva opțiuni aici.
Pentru sarcini simple de data wrangling, foile de calcul precum Microsoft Excel și Google Sheets sunt adesea primele alegeri. Aceste instrumente sunt foarte accesibile și oferă o interfață familiară, fiind ideale pentru sortare, filtrare și curățare de bază. Sunt deosebit de utile pentru seturi de date mici sau pentru cei care abia încep să învețe despre data wrangling.
Cu funcții și formule încorporate, permit efectuarea rapidă a calculelor și manipularea datelor fără cunoștințe tehnice avansate.
Pentru manipulare complexă și automatizare, limbaje precum Python și R sunt larg utilizate. Python, cu biblioteci puternice precum Pandas, NumPy și OpenRefine, este excelent pentru seturi mari de date și transformări complexe.
R, cu pachete precum dplyr și tidyr, este o altă opțiune solidă, preferată în special în mediile statistice și academice pentru capabilitățile robuste de analiză. Ambele limbaje oferă multă flexibilitate, permițând scrierea de fluxuri de lucru personalizate și automatizarea sarcinilor repetitive, fiind ideale pentru practicienii care lucrează cu nevoi mai sofisticate de data wrangling.
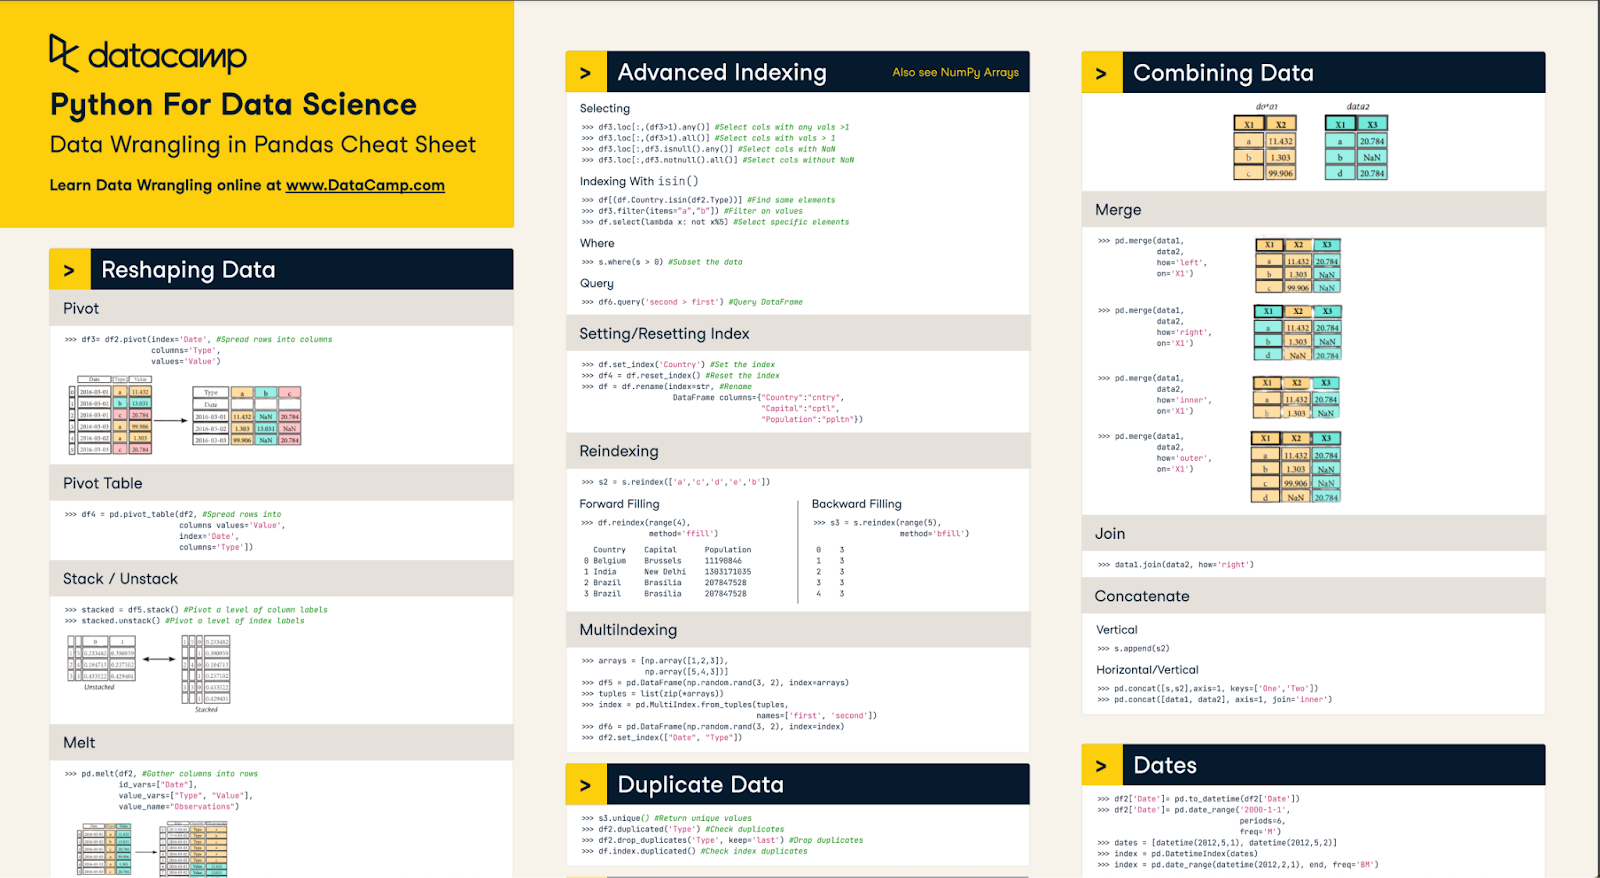
Fișa noastră de lucru Data Wrangling în Pandas te poate ajuta să stăpânești multe dintre bazele esențiale
Instrumentele software dedicate sunt concepute special pentru a eficientiza procesul de data wrangling, oferind funcții avansate care simplifică sarcinile complexe. Sunt ideale pentru utilizatorii care au nevoie de soluții puternice, dar accesibile, pentru a curăța, structura și pregăti datele pentru analiză fără a necesita multă programare.
Alteryx este un instrument de top în această categorie, cunoscut pentru interfața intuitivă drag-and-drop care permite curățarea, combinarea și transformarea ușoară a datelor din multiple surse. Vine cu o varietate de instrumente încorporate pentru manipularea datelor, facilitând sarcini precum filtrarea, unirea și agregarea.
Versiunea în cloud, Alteryx Designer Cloud, extinde aceste capabilități printr-o platformă scalabilă și colaborativă pentru data wrangling. Soluția permite echipelor să lucreze împreună în timp real, gestionând eficient seturi mari de date și fluxuri complexe în diferite medii. Fie on-premises, fie în cloud, Alteryx asigură pregătirea corectă a datelor pentru analize relevante.
Pentru proiecte complete ce necesită soluții end-to-end, platforme integrate precum KNIME, Apache NiFi și Microsoft Power BI sunt adesea folosite. Aceste platforme nu doar susțin data wrangling, ci oferă și instrumente pentru integrare, analiză și vizualizare într-un singur mediu.
KNIME, de exemplu, este cunoscut pentru interfața modulară bazată pe noduri, care permite construirea vizuală a fluxurilor complexe. Apache NiFi excelează în gestionarea și automatizarea fluxurilor de date între sisteme, iar Power BI combină pregătirea datelor cu capabilități puternice de vizualizare. Aceste platforme sunt ideale când datele trebuie pregătite, analizate și partajate fără întreruperi, oferind o abordare holistică a deciziilor bazate pe date.
Există multe opțiuni când vine vorba de data wrangling cu Python. Două pachete principale utilizate sunt Pandas și NumPy. Aceste două pachete au instrumente puternice care permit utilizatorilor să aplice cu ușurință tehnici-cheie de data wrangling pe seturile lor de date.
Atât de multă prelucrare a datelor are loc în Python, încât stăpânirea acestor pachete va fi esențială pentru orice practician. Deși există multe tehnici, câteva aspecte-cheie sunt curățarea la nivel înalt (de exemplu, eliminarea valorilor nule), îmbinarea seturilor de date și gestionarea valorilor lipsă.
Există multe situații în care datele trebuie curățate în Python înainte de a fi utilizate. Asta poate presupune eliminarea spațiilor la final din șiruri, eliminarea valorilor nule sau corectarea tipurilor de date, ca să numim doar câteva.
Fiecare set de date este diferit și are propriile nevoi, așa că explorează-ți datele pentru a înțelege dacă este necesară curățare suplimentară. Exersarea diverselor tehnici și abilități de codare este o modalitate excelentă de a învăța toate modurile în care putem curăța date în Python.
Când vine vorba de curățarea șirurilor, una dintre numeroasele probleme este spațiul alb la început/sfârșit. Acesta poate cauza dificultăți când încerci să parsezi șiruri în funcție de lungime, poziție sau potrivire. Cea mai bună abordare este folosirea metodei str.strip() pe o serie.
# Example utilizes a pandas series
# If working with a dataframe, call the series using df[col] syntax
s = pd.Series(['1. Ant.  ', '2. Bee!\n', '3. Cat?\t', np.nan, 10, True])
# It is important to include the .str or else the method will not work
s.str.strip()
Eliminarea valorilor nule în Pandas este ușoară. Vom discuta cum să completăm valorile nule mai târziu în acest articol. Poți folosi pur și simplu metoda dropna(). Există parametri opționali care îți permit să alegi condițiile exacte pentru eliminarea unei linii/coloane, dar comportamentul implicit este să elimine orice linie care are cel puțin o valoare nulă
# For any dataframe
df = pd.DataFrame({"name": ['Alfred', 'Batman', 'Catwoman'],
                   "toy": [np.nan, 'Batmobile', 'Bullwhip'],
                   "born": [pd.NaT, pd.Timestamp("1940-04-25"), pd.NaT]}
df.dropna()
Metoda .astype() le permite utilizatorilor să schimbe tipul de date al unei serii, însă corectarea tipurilor este puțin mai dificilă, pentru că trebuie să te asiguri că fiecare valoare din seria Pandas corespunde tipului respectiv.
De exemplu, convertirea unei serii de tip obiect în întreg presupune că știi că fiecare valoare este un întreg. Dacă există o singură valoare care nu este întreg, metoda va da eroare. Poți alege să o forțezi, transformând valorile invalide în nule, dar s-ar putea să merite să investighezi de ce anumite valori nu se convertesc.
Îmbinarea DataFrame-urilor în Pandas este similară cu join-urile din SQL. Comportamentul implicit al unei funcții merge() în Pandas este un inner join. Totuși, va face join și pe valori nule, deci ai grijă. Pentru un merge este necesară o cheie. Poți face join pe diverse coloane sau chiar pe index.
# Create two dataframes
df1 = pd.DataFrame({'lkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [1, 2, 3, 5]})
df2 = pd.DataFrame({'rkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [5, 6, 7, 8]})
# merge the df1 DataFrame to the df2 DataFrame using the columns key and rkey as keys
df1.merge(df2, left_on='lkey', right_on='rkey')
Codul de mai sus va îmbina cele două DataFrame-uri pe baza cheilor care se potrivesc în coloanele lkey și rkey. Valorile nepereche vor fi eliminate și vei rămâne doar cu cele potrivite. Totuși, poți schimba comportamentul și alege un merge left/right/outer. Este un instrument puternic care le permite data scientist-ilor să reunească seturi din surse diverse.
În privința valorilor lipsă, metodologia exactă poate varia în funcție de contextul de business. Când vorbim despre valori lipsă, trebuie să luăm în calcul de ce lipsesc. Dacă lipsesc din cauza unor erori tehnice, poate ar trebui să remediezi mai întâi problema tehnică înainte de analiză și să vezi dacă poți recupera date istorice.
Uneori, putem folosi restul datelor și pur și simplu ignora valoarea lipsă. Dacă datele istorice sunt importante și nerecuperabile, trebuie să completăm lipsurile. Hai să discutăm cum completăm informațiile lipsă.
Metoda principală pentru completare este fillna() din Pandas. Pentru șiruri, această metodă poate completa valorile nule, de exemplu: df.fillna(value=’missing’), ceea ce poate fi suficient! Frumusețea metodei este flexibilitatea. Combinând fillna() din Pandas cu diverse metode NumPy precum mean(), median() și funcții lambda, putem completa matematic valorile lipsă.
Alternativ, există chiar metode Pandas precum interpolate() care pot completa algoritmic golurile dacă datele sunt ordonate (de ex., bazate pe timp). Scopul este să completăm cât mai exact, astfel încât să reflecte datele reale.
A efectua data wrangling în SQL poate fi o modalitate eficientă de procesare, mai ales dacă baza ta SQL este în cloud. Asta limitează cantitatea de date procesate pe mașina locală și traficul de date pe rețele.
Accentul principal în SQL este limitarea volumului de date care trec prin pipeline-uri prin extragere, transformare și încărcare corectă. Câteva modalități sunt filtrarea datelor, join-urile la tabele de referință și agregările.
Modalitatea principală de filtrare a tabelelor în SQL este clauza WHERE. Este simplă de folosit, dar extraordinar de puternică. Condițiile pot fi egalități simple, căutări de șiruri similare sau chiar subinterogări. Poți combina mai multe condiții cu AND și OR!
Filtrarea în cazuri simple, precum căutarea unei valori specifice a unei coloane, poate arăta astfel:
SELECT *
FROM sample_table
WHERE sample_col = 23
Folosirea unor expresii mai complexe precum LIKE sau IN îți oferă flexibilitate în clauzele WHERE. De exemplu, interogarea următoare caută persoane al căror prenume începe cu J datorită wildcard-ului %, și al căror nume de familie este IN lista furnizată.
SELECT *
FROM sample_table
WHERE name LIKE ‘J%’ /* looks for people whose name starts with J */
AND last_name IN (‘Smith’, ‘Rockefeller’, ‘Williams’) /* Looks for people whose last name is in this list */
În final, folosirea subinterogărilor oferă flexibilitate filtrării. Aceasta se poate baza pe rezultatele altui tabel. Un exemplu comun este găsirea listei de ID-uri de clienți după un anumit moment temporal.
SELECT *
FROM sample_table
WHERE customer_id IN (SELECT id FROM reference_table WHERE date >= ‘2024-01-01’)
Folosind o combinație a acestor tehnici te asiguri că inputurile sunt exact ce cauți și că dimensiunea dataset-ului este minimizată. O utilizare foarte puternică a filtrelor este eliminarea duplicatelor și curățarea astfel a setului de date. Tehnici mai avansate includ filtre HAVING pentru agregări și QUALIFY cu funcții fereastră.
Efectuarea de join-uri ne permite să adunăm informații suplimentare necesare seturilor noastre. SQL are diverse tipuri de join-uri, precum INNER, OUTER, LEFT și RIGHT. Cu INNER și OUTER decidem ce date păstrăm. INNER păstrează doar datele care se potrivesc pe ambele părți, în timp ce OUTER păstrează și datele nepereche, în funcție de partea din care facem join-ul (stânga sau dreapta).
Join-ul LEFT păstrează datele din stânga, iar RIGHT păstrează datele din dreapta. Poți combina LEFT și RIGHT cu INNER și OUTER, precum și FULL OUTER JOIN, care reunește toate datele din ambele tabele.
Un exemplu de join ar putea fi:
SELECT *
FROM a
LEFT OUTER JOIN
b
WHERE a.id = b.id
Instrucțiunea de mai sus are tabela a în stânga (prima) și b în dreapta (a doua). LEFT OUTER JOIN spune: unește datele din a și b unde a.id = b.id, dar dacă nu există potrivire, păstrează toate datele din a. Join-urile sunt instrumente puternice pentru a aduce date suplimentare necesare inputului tău.
Un ultim instrument util în SQL pentru data wrangling este clauza GROUP BY pentru a realiza agregări. Aceasta simplifică datele și permite pre-procesarea lor înainte de a le trimite mai departe pe pipeline. Agregarea este un instrument puternic pentru a calcula statistici sumare. Iată un exemplu în care analizăm vânzările totale pe ID client:
SELECT
Customer_ID,
SUM(sales)
FROM sample_table
GROUP BY Customer_ID
Există numeroase funcții de agregare precum SUM, MEAN, MAX și MIN, care ne ajută să înțelegem rapid datele. Valorificarea agregărilor simplifică ingestia în pipeline-uri.
Această secțiune acoperă exemple practice și cazuri de utilizare pentru tehnici de data wrangling. Obiectivele principale sunt: standardizarea datelor, îmbinarea surselor și procesarea textului.
Standardizarea datelor în aceleași unități este importantă. Dacă lucrezi cu date care măsoară același lucru în unități diferite sau valute diferite, pot apărea probleme în analiză.
Vom acoperi un exemplu simplu de conversie a diferitelor monede în USD în SQL. Să presupunem că avem două tabele. Tabelul 1 este sales, care conține vânzări de produse pentru diverse regiuni, iar Tabelul 2 este currency_exchange, care conține cursul de schimb pentru diverse regiuni în diverse zile. Un exemplu de conversie poate arăta așa:
SELECT
a.sale_id,
a.region,
CASE WHEN region <> ‘US’
	THEN a.sale_price * b.exchange_rate
	ELSE a.sale_price
END AS sale_price
FROM sales AS a
LEFT OUTER JOIN
currency_exchange AS b
WHERE a.region = b.region
Aceasta ia sale_id și region din tabelul sales și face join cu tabelul de referință currency_exchange pe regiune, pentru a obține cursul de schimb. Adesea, se implică și data, pentru a folosi cursul din ziua respectivă.
O parte importantă a data wrangling este pregătirea datelor pentru modelele de machine learning. Recent, multe modele s-au concentrat pe procesarea limbajului natural, iar un precursor este analiza de sentiment pe date text.
Un pas critic este pregătirea textului prin normalizare și eliminarea punctuației. Din moment ce punctuația și majusculele pot să nu ofere context important pentru un model, adesea e mai bine să normalizăm.
Pentru asta, vom folosi pachete Python de bază și pachetul re. Vezi mai jos un exemplu de eliminare a punctuației, normalizare (litere mici) și tăiere a spațiilor goale.
# import regex
import re

# input string
test_string = "       Python 3.0, released in 2008, was a major revision of the language that is not completely backward compatible and much Python 2 code does not run unmodified on Python 3. With Python 2's end-of-life, only Python 3.6.x[30] and later are supported, with older versions still supporting e.g. Windows 7 (and old installers not restricted to 64-bit Windows)."
# remove whitespaces
no_space_string = test_string.strip()

# convert to lower case
lower_string = no_space_string .lower()

# remove numbers
no_number_string = re.sub(r'\d+','',lower_string)
print(no_number_string)
Fragmentul de cod de mai sus oferă o bază excelentă pentru eliminarea spațiilor albe, conversia în litere mici și eliminarea numerelor/datelo alfabetice.
Data wrangling este o componentă critică în pregătirea datelor pentru modelele de machine learning și analiză. Există o multitudine de instrumente în Python, precum pachetele pandas și numpy, alături de diverse metode SQL precum clauzele WHERE și GROUP BY, care ne permit să pregătim datele.
Stăpânirea acestor tehnici este esențială pentru orice viitor profesionist în domeniul datelor. Dacă vrei să aprofundezi subiectele legate de data wrangling, ia în considerare următoarele resurse:
Cursuri DataCamp de top
course
course
track