Courses
Python เบื้องต้น: การนำเข้าข้อมูล
3 ชม.
340.8K
เมื่อปริมาณ ความหลากหลาย และความเร็วของข้อมูลเพิ่มขึ้น การมุ่งสร้างชุดข้อมูลที่มีคุณภาพและมีโครงสร้างดีจึงสำคัญยิ่งกว่าที่เคย เพราะส่งผลโดยตรงต่อความแม่นยำของอินไซต์และประสิทธิผลของการตัดสินใจในทุกอุตสาหกรรม
ข้อมูลที่จัดการไม่ดีหรือมีข้อบกพร่องอาจนำไปสู่ข้อสรุปที่ผิดพลาด สูญเสียทั้งเวลา เงิน และทรัพยากร ตรงนี้เองที่ data wrangling เข้ามามีบทบาทในฐานะกระบวนการสำคัญที่เปลี่ยนข้อมูลดิบที่ไร้โครงสร้างให้กลายเป็นข้อมูลสะอาด เป็นระเบียบ และพร้อมต่อการวิเคราะห์
Data wrangling ประกอบด้วยขั้นตอนต่อเนื่องเพื่อให้ข้อมูลถูกต้อง น่าเชื่อถือ และสอดรับกับความต้องการเฉพาะของการวิเคราะห์ การเชี่ยวชาญ data wrangling จะปลดล็อกศักยภาพของข้อมูล เปลี่ยนให้เป็นอินไซต์ที่นำไปปฏิบัติได้ ช่วยขับเคลื่อนการตัดสินใจอย่างมีข้อมูลรองรับและนำไปสู่ความสำเร็จในที่สุด
Data wrangling คือกระบวนการแปลงข้อมูลดิบให้เป็นรูปแบบที่ใช้งานได้มากขึ้น ครอบคลุมการทำความสะอาด จัดโครงสร้าง และเสริมข้อมูลเพื่อให้พร้อมต่อการวิเคราะห์
ลองนึกภาพว่าเพิ่งได้รับชุดข้อมูลขนาดใหญ่—ทั้งรก ขาดค่า ไม่สอดคล้อง และมีข้อมูลที่ไม่เกี่ยวข้อง Data wrangling ก็เหมือนชุดเครื่องมือที่ช่วยจัดระเบียบข้อมูลให้เป็นระบบและสม่ำเสมอ
Data wrangling สำคัญต่อการทำให้ข้อมูลมีคุณภาพและมีโครงสร้างดี ซึ่งเป็นรากฐานของการวิเคราะห์ข้อมูลที่แม่นยำ ข้อมูลที่สะอาดและมีโครงสร้างเป็นฐานให้กับทุกขั้นตอนถัดไปของเวิร์กโฟลว์ข้อมูล—ไม่ว่าจะสร้างโมเดลแมชชีนเลิร์นนิง สร้างภาพข้อมูล หรือทำการวิเคราะห์เชิงสถิติ
ข้อมูลคุณภาพสูงช่วยลดความเสี่ยงของความผิดพลาดและอคติในการวิเคราะห์ ทำให้อินไซต์น่าเชื่อถือมากขึ้น การเข้าใจความสำคัญของ data wrangling จึงเป็นกุญแจสำคัญ เพราะมีผลโดยตรงต่อความถูกต้องของการตัดสินใจที่อ้างอิงข้อมูลนั้น
การจัดระเบียบข้อมูลที่ไม่ดีอาจนำไปสู่ข้อสรุปที่ผิดและส่งผลเสียอย่างมากในงานจริง ดังนั้น การเชี่ยวชาญ data wrangling จึงจำเป็นสำหรับผู้ที่จริงจังกับการตัดสินใจบนพื้นฐานข้อมูล
Data wrangling มี 5 ขั้นตอนหลัก:
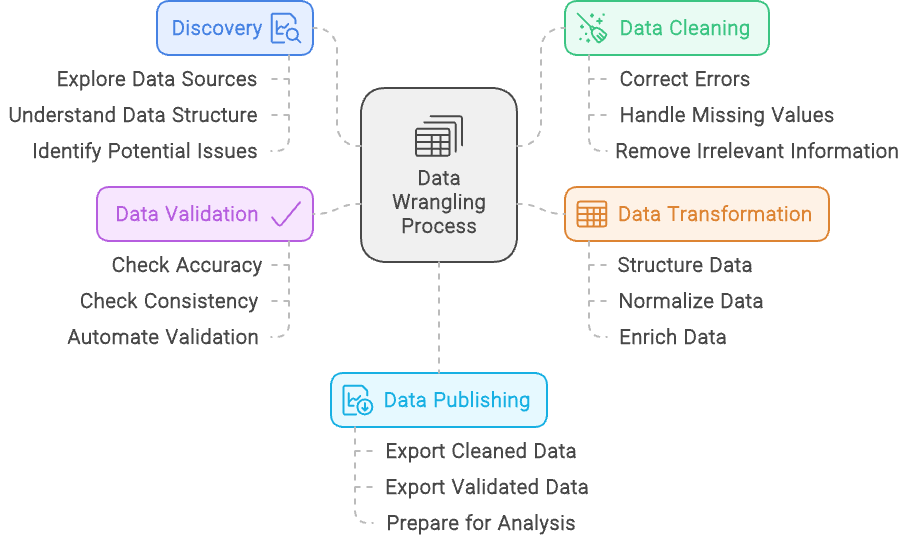
กระบวนการ data wrangling - สร้างด้วย Napkin.ai
ได้สรุป 5 ขั้นตอนของ data wrangling ไว้แล้ว ต่อไปมาดูรายละเอียดของแต่ละขั้นตอน:
ขั้นตอนการค้นพบ (discovery) ใน data wrangling เปรียบเสมือนการมองภาพรวมจิ๊กซอว์ก่อนเริ่มต่อ ช่วยให้เข้าใจว่ากำลังทำงานกับข้อมูลแบบใด มาจากแหล่งไหน และมีโครงสร้างอย่างไร
เช่นเดียวกับการคัดแยกชิ้นส่วนจิ๊กซอว์ตามสีหรือตามขอบ ขั้นตอนนี้ช่วยจัดหมวดหมู่และมองเห็นรูปแบบในข้อมูล วางพื้นฐานสำหรับงานถัดไป
นอกจากนี้ ยังเป็นช่วงมองหาปัญหาที่อาจเกิดขึ้น—คล้ายกับชิ้นส่วนที่หายไปหรือสีที่ไม่ตรงกันในจิ๊กซอว์
ในขั้นตอนนี้จะระบุปัญหาในข้อมูล เช่น ความไม่สอดคล้อง ค่าที่ขาด หรือรูปแบบที่ไม่คาดคิด การพบความท้าทายตั้งแต่เนิ่นๆ จะช่วยให้วางแผนรับมือในขั้นตอนถัดไปได้ราบรื่น มุ่งไปสู่ชุดข้อมูลที่สะอาดและใช้งานได้
การทำความสะอาดข้อมูล คือการปรับแต่งชุดข้อมูลให้ถูกต้องและน่าเชื่อถือ
รวมถึงการแก้ข้อผิดพลาด จัดการค่าที่ขาด และแก้ความไม่สอดคล้อง ตัวอย่างเช่น หากชุดข้อมูลมีระเบียนซ้ำสำหรับบุคคลหรือธุรกรรมเดียวกัน ก็ต้องลบระเบียนซ้ำเพื่อไม่ให้ผลลัพธ์เอนเอียง
หรือหากพบว่ารูปแบบข้อมูลไม่สอดคล้อง เช่น รูปแบบเบอร์โทรศัพท์ต่างกัน ก็ควรมาตรฐานให้เป็นรูปแบบเดียว เป้าหมายคือยกระดับคุณภาพและความถูกต้องของข้อมูลให้พร้อมต่อการวิเคราะห์ที่แม่นยำและมีความหมาย
การแปลงข้อมูล คือการปรับและเสริมชุดข้อมูลให้ตรงกับข้อกำหนดของการวิเคราะห์ ขั้นตอนนี้รวมถึงการจัดโครงสร้างข้อมูล เช่น ปรับรูปร่างให้ตรงรูปแบบที่ต้องการ หรือผสานข้อมูลจากหลายแหล่งให้เป็นโครงสร้างเดียวกัน
การทำให้ข้อมูลเป็นมาตรฐาน (normalizing) ก็สำคัญเช่นกัน เช่น ปรับค่าให้อยู่ในสเกลหรือรูปแบบเดียวกัน แปลงสกุลเงินให้เป็นสกุลเดียว หรือมาตรฐานหน่วยวัด
นอกจากนี้ ยังรวมถึงการเสริมข้อมูลด้วยการเพิ่มตัวแปรใหม่หรือผสานแหล่งข้อมูลภายนอกเพื่อเพิ่มบริบทหรืออินไซต์ เช่น คำนวณเมตริกใหม่จากข้อมูลเดิม หรือแนบข้อมูลเพิ่มเติมจากฐานข้อมูลอื่นเพื่อให้เห็นภาพที่ครบถ้วน
เป้าหมายคือเตรียมข้อมูลให้ใช้งานได้สะดวกและเกี่ยวข้องกับการวิเคราะห์เชิงลึกมากที่สุด
การตรวจสอบความถูกต้องของข้อมูล คือการรับประกันความถูกต้องและความน่าเชื่อถือของข้อมูลผ่านการตรวจเชิงระบบและกระบวนการอัตโนมัติ เป็นขั้นตอนสำคัญเพื่อยืนยันว่าข้อมูลทั้งถูกต้องและสม่ำเสมอ
ในขั้นตอนนี้จะทำการตรวจหลายรูปแบบเพื่อหาความคลาดเคลื่อน เช่น เปรียบเทียบกับค่ามาตรฐานที่ทราบ หรือเทียบกับกฎและข้อจำกัดที่กำหนดไว้ กระบวนการอัตโนมัติอาจมีการรันสคริปต์เพื่อตรวจจับความผิดปกติหรือความไม่สอดคล้อง เพื่อให้ข้อมูลอยู่ในรูปแบบและช่วงค่าที่คาดหวัง
เป้าหมายคือค้นหาและแก้ปัญหาก่อนนำข้อมูลไปวิเคราะห์ เพื่อกันไม่ให้ความผิดพลาดกระทบผลลัพธ์ เมื่อยืนยันความถูกต้องและความน่าเชื่อถืออย่างเข้มงวดแล้ว อินไซต์ที่ได้ก็จะตั้งอยู่บนข้อมูลที่ไว้วางใจได้
การเผยแพร่ข้อมูลคือขั้นตอนสุดท้ายของกระบวนการ data wrangling ซึ่งเป็นการทำให้ข้อมูลที่สะอาดและมีโครงสร้างพร้อมสำหรับการวิเคราะห์และการตัดสินใจ ขั้นตอนนี้เกี่ยวข้องกับการเตรียมข้อมูลเพื่อกระจายใช้งาน มักผ่านแดชบอร์ด รายงาน หรือภาพข้อมูลแบบอินเทอร์แอกทีฟ เพื่อให้ผู้มีส่วนได้ส่วนเสียเข้าถึงและเข้าใจได้
ระหว่างการเผยแพร่ข้อมูล อาจตั้งค่าท่อข้อมูลหรืออินเทอร์เฟซเพื่อให้ผู้ใช้สอบถามและโต้ตอบกับข้อมูลได้ ส่งมอบข้อมูลในรูปแบบที่ตรงความต้องการของผู้ใช้
เป้าหมายคือมอบอินไซต์ที่ชัดเจนและนำไปใช้ได้จริง เอื้อต่อการตัดสินใจอย่างมีข้อมูลรองรับ และช่วยสื่อสารผลลัพธ์ทั่วทั้งองค์กร การเผยแพร่อย่างมีประสิทธิภาพทำให้ความพยายามใน data wrangling แปรเปลี่ยนเป็นผลลัพธ์ที่จับต้องได้
คำว่า data wrangling และ data cleaning มักถูกใช้แทนกัน แต่จริงๆ แล้วหมายถึงแง่มุมต่างกันของกระบวนการเตรียมข้อมูล ทั้งสองสำคัญต่อการเตรียมข้อมูลเพื่อการวิเคราะห์ แต่มีวัตถุประสงค์และงานที่ต่างกัน การเข้าใจความแตกต่างช่วยให้จัดการแต่ละส่วนได้อย่างมีประสิทธิภาพ
Data Wrangling เป็นกระบวนการครอบคลุมในการแปลงข้อมูลดิบให้พร้อมต่อการวิเคราะห์ ครอบคลุมหลายช่วง ตั้งแต่การดึงข้อมูล จัดโครงสร้าง ทำความสะอาด จนถึงตรวจสอบความถูกต้อง เป้าหมายคือเตรียมข้อมูลจากแหล่งที่หลากหลายให้พร้อมต่อการวิเคราะห์และสร้างอินไซต์ ทำให้ข้อมูลเป็นระเบียบ ถูกต้อง และพร้อมสำหรับการวิเคราะห์เชิงลึก
Data Cleaning เป็นส่วนย่อยเฉพาะของ data wrangling มุ่งปรับปรุงคุณภาพข้อมูลด้วยการแก้ไขข้อผิดพลาดและความไม่สอดคล้อง เช่น ลบระเบียนซ้ำ แก้คำพิมพ์ผิด จัดการค่าที่ขาด และทำให้รูปแบบข้อมูลเป็นมาตรฐาน แม้จะเป็นส่วนสำคัญ แต่ก็เป็นเพียงหนึ่งขั้นตอนในกระบวนการที่กว้างกว่า
โดยสรุป data wrangling คือกรอบงานโดยรวมในการเตรียมข้อมูลเพื่อการวิเคราะห์ ครอบคลุมหลายขั้นเพื่อจัดการแง่มุมต่างๆ ของการเตรียมข้อมูล ส่วน data cleaning เป็นองค์ประกอบหนึ่งที่มุ่งยกระดับความถูกต้องและความสม่ำเสมอของข้อมูล
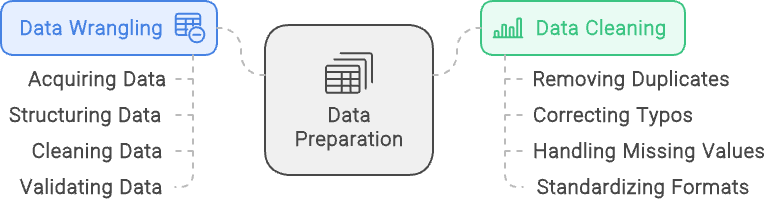
Data Wrangling vs Data Cleaning: Data Wrangling มุ่งจัดโครงสร้างและตรวจสอบความถูกต้องของข้อมูล ขณะที่ Data Cleaning มุ่งให้ได้ข้อมูลที่สะอาดและมีคุณภาพ ภาพสร้างด้วย napkin.ai
มีหลายวิธีในการจัดระเบียบข้อมูล ทั้งผ่านเครื่องมือแบบ GUI พื้นฐานอย่าง Excel หรือ Alteryx และผ่านการเขียนโค้ดด้วยภาษาอย่าง R และ Python ต่อไปนี้คือบางทางเลือกที่น่าสนใจ
สำหรับงาน data wrangling แบบง่าย สเปรดชีตอย่าง Microsoft Excel และ Google Sheets มักเป็นตัวเลือกแรก ใช้งานเข้าถึงง่ายและคุ้นเคย เหมาะกับงานเรียงลำดับ กรองข้อมูล และทำความสะอาดพื้นฐาน โดยเฉพาะชุดข้อมูลขนาดเล็กหรือผู้เริ่มต้นเรียนรู้ data wrangling
ด้วยฟังก์ชันและสูตรในตัว ทำให้คำนวณและปรับแต่งข้อมูลได้รวดเร็ว โดยไม่ต้องมีความรู้ทางเทคนิคมากนัก
สำหรับการจัดการข้อมูลที่ซับซ้อนและงานอัตโนมัติ มักใช้ภาษาอย่าง Python และ R โดย Python พร้อมไลบรารีทรงพลังเช่น Pandas, NumPy และ OpenRefine เหมาะอย่างยิ่งสำหรับชุดข้อมูลขนาดใหญ่และการแปลงข้อมูลที่ซับซ้อน
R พร้อมแพ็กเกจอย่าง dplyr และ tidyr ก็เป็นตัวเลือกที่แข็งแกร่ง โดยเฉพาะในแวดวงสถิติและวิชาการ เนื่องจากความสามารถด้านการวิเคราะห์ข้อมูลที่แข็งแรง ทั้งสองภาษายืดหยุ่นสูง เขียนเวิร์กโฟลว์เองและทำงานซ้ำๆ ได้อัตโนมัติ เหมาะกับผู้ปฏิบัติงานข้อมูลที่มีความต้องการ data wrangling ขั้นสูง
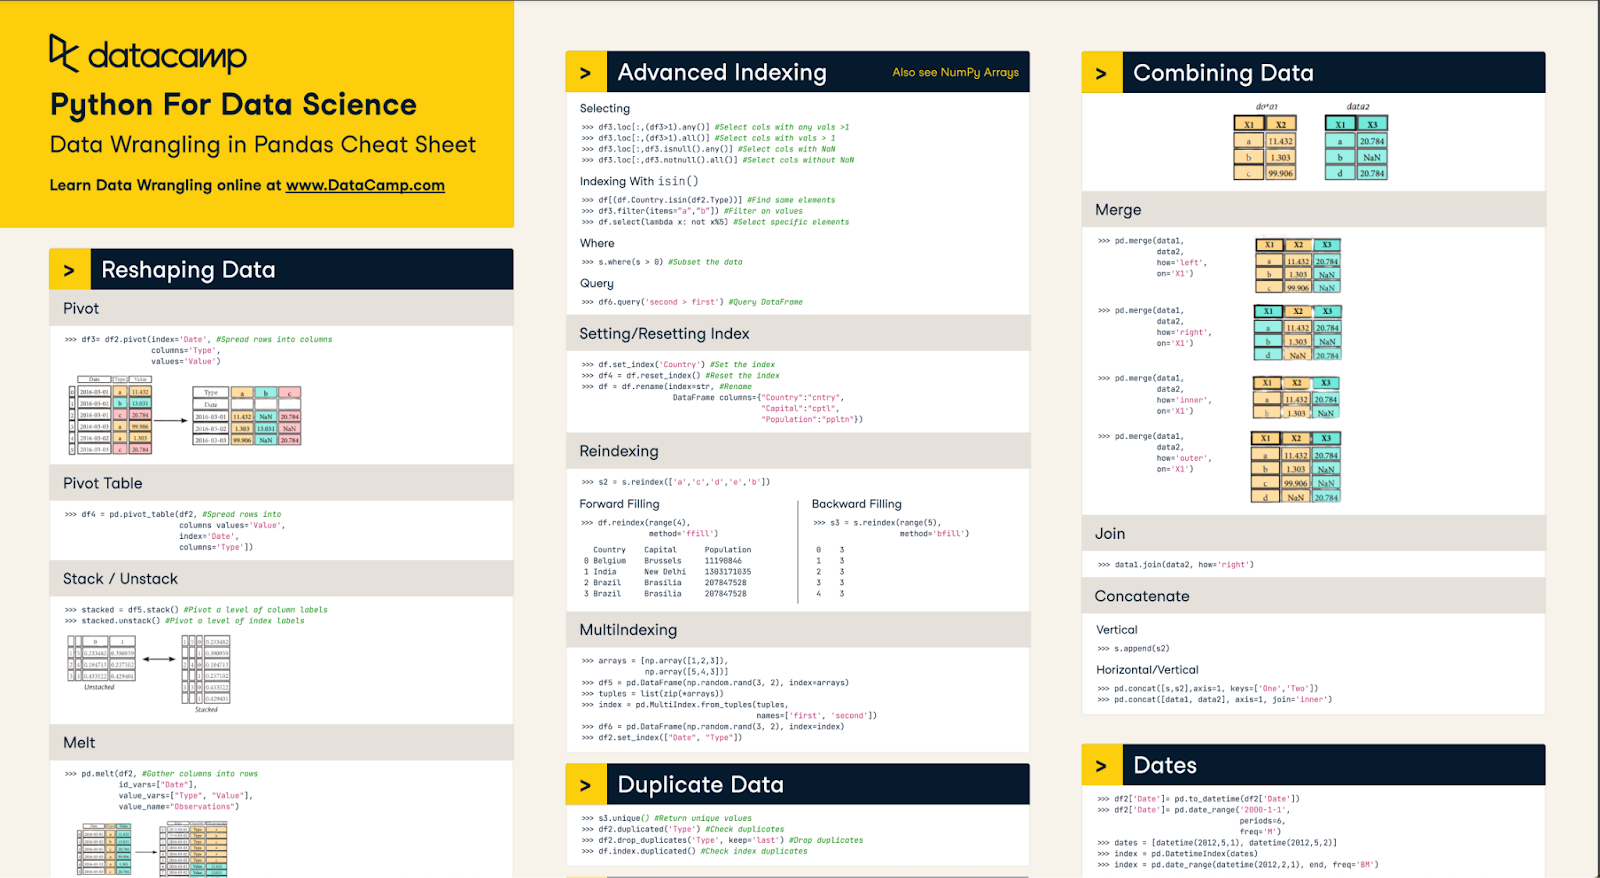
ชีตสรุปData Wrangling in Pandas ของเรา ช่วยให้เชี่ยวชาญพื้นฐานได้อย่างรวดเร็ว
ซอฟต์แวร์เฉพาะทางถูกออกแบบมาเพื่อทำให้กระบวนการ data wrangling มีประสิทธิภาพ สูงขึ้น ด้วยฟีเจอร์ขั้นสูงที่ทำให้งานซับซ้อนง่ายขึ้น เหมาะสำหรับผู้ใช้ที่ต้องการโซลูชันทรงพลังแต่เข้าถึงได้ เพื่อทำความสะอาด จัดโครงสร้าง และเตรียมข้อมูลโดยไม่ต้องเขียนโค้ดมาก
Alteryx เป็นเครื่องมือชั้นนำ โดดเด่นด้วยอินเทอร์เฟซลากวางที่ใช้ง่าย ช่วยทำความสะอาด ผสาน และแปลงข้อมูลจากหลายแหล่ง มาพร้อมเครื่องมือในตัวสำหรับปรับแต่งข้อมูล ทำให้งานกรอง จอยน์ และสรุปรวมข้อมูลทำได้ตรงไปตรงมา
เวอร์ชันคลาวด์อย่าง Alteryx Designer Cloud ยกระดับความสามารถด้วยแพลตฟอร์มทำงานร่วมกันที่ปรับขนาดได้ ให้ทีมทำงานแบบเรียลไทม์ จัดการชุดข้อมูลขนาดใหญ่และเวิร์กโฟลว์ซับซ้อนได้อย่างมีประสิทธิภาพ ทั้งแบบ on-premises และบนคลาวด์ เพื่อให้ข้อมูลถูกเตรียมอย่างแม่นยำและพร้อมต่อการวิเคราะห์เชิงลึก
สำหรับโปรเจกต์ข้อมูลแบบครบวงจร แพลตฟอร์มแบบบูรณาการอย่าง KNIME, Apache NiFi และ Microsoft Power BI มักถูกใช้ แพลตฟอร์มเหล่านี้ไม่เพียงรองรับ data wrangling แต่ยังมีเครื่องมือสำหรับบูรณาการ วิเคราะห์ และแสดงผลข้อมูลภายในสภาพแวดล้อมเดียว
เช่น KNIME มีอินเทอร์เฟซแบบโหนดที่ประกอบเวิร์กโฟลว์ซับซ้อนได้ด้วยสายตา Apache NiFi เด่นในการจัดการและทำให้งานไหลของข้อมูลระหว่างระบบเป็นอัตโนมัติ ส่วน Power BI ผสานการเตรียมข้อมูลกับการสร้างภาพข้อมูลที่ทรงพลัง เหมาะกับโปรเจกต์ที่ต้องเตรียม วิเคราะห์ และแชร์ข้อมูลอย่างไร้รอยต่อ ให้แนวทางแบบองค์รวมต่อการตัดสินใจด้วยข้อมูล
มีหลายทางเลือกสำหรับการทำ data wrangling ด้วยPython สองแพ็กเกจหลักที่ใช้กันมากคือ Pandas และ NumPy ทั้งสองมีเครื่องมือทรงพลังที่ช่วยให้ทำเทคนิค data wrangling สำคัญๆ ได้อย่างง่ายดาย
เนื่องจากงานประมวลผลข้อมูลจำนวนมากเกิดขึ้นใน Python การเชี่ยวชาญแพ็กเกจเหล่านี้จึงจำเป็นสำหรับผู้ปฏิบัติงานด้านข้อมูล แม้เทคนิคจะมีมากมาย แต่หัวใจสำคัญคือการทำความสะอาดระดับสูง (เช่น ลบค่า null) การผสานชุดข้อมูล และการจัดการค่าที่ขาด
มีหลายกรณีที่ข้อมูลต้องถูกทำความสะอาดใน Python ก่อนใช้งาน อาจเป็นการลบช่องว่างส่วนเกินท้าย/ต้นสตริง ลบค่า null หรือแก้ชนิดข้อมูล เป็นต้น
แต่ละชุดข้อมูลไม่เหมือนกันและมีความต้องการเฉพาะ ควรสำรวจชุดข้อมูลเพื่อดูว่าต้องทำความสะอาดเพิ่มเติมหรือไม่ การฝึกเทคนิคและทักษะการโค้ดหลากหลายเป็นวิธีที่ดีในการเรียนรู้แนวทางทำความสะอาดข้อมูลใน Pythonที่หลากหลาย
สำหรับการทำความสะอาดสตริง ปัญหาหนึ่งที่พบบ่อยคือช่องว่างขาวที่ต้น/ท้าย ซึ่งกระทบการพาร์สด้วยความยาว ตำแหน่ง หรือการแมตช์ วิธีที่เหมาะสมคือใช้เมธอด str.strip() กับซีรีส์
# Example utilizes a pandas series
# If working with a dataframe, call the series using df[col] syntax
s = pd.Series(['1. Ant.  ', '2. Bee!\n', '3. Cat?\t', np.nan, 10, True])
# It is important to include the .str or else the method will not work
s.str.strip()
การลบค่า null ใน Pandas ทำได้ง่าย เราจะพูดถึงการเติมค่า null ภายหลัง เพียงใช้เมธอด dropna() ซึ่งมีพารามิเตอร์เสริมให้กำหนดเงื่อนไขการลบแถว/คอลัมน์ได้ แต่พฤติกรรมเริ่มต้นคือการลบทุกแถวที่มีค่า null ใดๆ
# For any dataframe
df = pd.DataFrame({"name": ['Alfred', 'Batman', 'Catwoman'],
                   "toy": [np.nan, 'Batmobile', 'Bullwhip'],
                   "born": [pd.NaT, pd.Timestamp("1940-04-25"), pd.NaT]}
df.dropna()
เมธอด .astype() ช่วยเปลี่ยนชนิดข้อมูลของซีรีส์ได้ แต่การแก้ชนิดข้อมูลมีความท้าทาย เพราะต้องแน่ใจว่าทุกค่าตรงกับชนิดข้อมูลนั้นจริง
เช่น การแปลงซีรีส์ชนิด object เป็นจำนวนเต็ม แปลว่าทุกค่าต้องเป็นจำนวนเต็ม หากมีค่าเดียวที่ไม่ใช่ ก็จะเกิดข้อผิดพลาด สามารถเลือกบังคับให้ค่าที่ไม่ถูกต้องกลายเป็น null ได้ แต่ก็คุ้มค่าที่จะตรวจสอบเหตุผลว่าทำไมบางค่าจึงแปลงไม่ได้
การผสาน DataFrame ใน Pandas คล้ายกับการ join ใน SQL พฤติกรรมเริ่มต้นของ merge() คือ inner join อย่างไรก็ตาม จะรวมบนค่า null ได้ จึงต้องระวัง การ merge ต้องใช้คีย์เฉพาะ สามารถจอยน์ได้ทั้งหลายคอลัมน์หรือแม้แต่ดัชนี
# Create two dataframes
df1 = pd.DataFrame({'lkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [1, 2, 3, 5]})
df2 = pd.DataFrame({'rkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [5, 6, 7, 8]})
# merge the df1 DataFrame to the df2 DataFrame using the columns key and rkey as keys
df1.merge(df2, left_on='lkey', right_on='rkey')
โค้ดข้างต้นจะผสานสอง DataFrame ตามคีย์ที่แมตช์กันในคอลัมน์ lkey และ rkey ค่าที่ไม่แมตช์จะถูกตัดออก เหลือเฉพาะค่าที่ตรงกัน ทั้งนี้สามารถเปลี่ยนพฤติกรรมเป็น left/right/outer merge ได้เช่นกัน เป็นเครื่องมือทรงพลังในการรวบรวมชุดข้อมูลจากหลายแหล่ง
แนวทางจัดการค่าที่ขาดขึ้นอยู่กับบริบททางธุรกิจ ต้องพิจารณาสาเหตุที่ค่าหาย หากหายเพราะข้อผิดพลาดเชิงเทคนิค อาจต้องแก้ปัญหาเทคนิคก่อนวิเคราะห์ และลองกู้ข้อมูลย้อนหลัง
บางครั้งสามารถใช้ข้อมูลส่วนที่เหลือและมองข้ามค่าที่หายได้ หากข้อมูลในอดีตสำคัญและกู้ไม่ได้ จำเป็นต้องเติมค่า มาดูวิธีเติมข้อมูลที่ขาดกัน
วิธีหลักคือใช้เมธอด fillna() ของ Pandas สำหรับสตริง สามารถเติมค่า null ได้เช่น df.fillna(value=’missing’) ซึ่งอาจเพียงพอ จุดเด่นคือประยุกต์ได้หลากหลาย เมื่อผสาน fillna() กับเมธอดของ NumPy อย่าง mean(), median() และฟังก์ชัน lambda ก็สามารถเติมค่าที่ขาดเชิงคณิตศาสตร์ได้
ทางเลือกอื่นยังมีเมธอดอย่าง interpolate() ที่เติมช่องว่างเชิงอัลกอริทึมได้หากข้อมูลมีลำดับ (เช่น เวลา) เป้าหมายคือเติมให้ใกล้เคียงข้อมูลจริงมากที่สุด
การทำ data wrangling ใน SQL เป็นวิธีที่มีประสิทธิผล โดยเฉพาะเมื่อฐานข้อมูลอยู่บนคลาวด์ ช่วยลดภาระการประมวลผลบนเครื่องท้องถิ่นและลดการถ่ายโอนข้อมูลผ่านเครือข่าย
จุดมุ่งหมายหลักคือจำกัดขอบเขตของข้อมูลที่ไหลผ่านไปป์ไลน์ ผ่านการดึง แปลง และโหลดข้อมูลอย่างเหมาะสม วิธีที่ใช้ ได้แก่ การกรองข้อมูล การจอยน์กับตารางอ้างอิง และการทำ aggregation
วิธีหลักในการกรองตารางใน SQL คือคำสั่ง WHERE ใช้งานง่ายแต่ทรงพลังมาก เงื่อนไขอาจเป็นการเปรียบเทียบค่าเท่ากัน การค้นหาสตริงที่คล้ายกัน หรือใช้ซับคิวรีก็ได้ สามารถผสานหลายเงื่อนไขด้วย AND และ OR ได้ด้วย
ตัวอย่างการกรองแบบง่าย มองหาค่าหนึ่งในคอลัมน์ อาจเป็นดังนี้:
SELECT *
FROM sample_table
WHERE sample_col = 23
การใช้คำสั่งที่ยืดหยุ่นขึ้นอย่าง LIKE หรือ IN ช่วยเพิ่มความยืดหยุ่นให้ WHERE เช่น คิวรีด้านล่างค้นหาชื่อที่ขึ้นต้นด้วย J ด้วยไวลด์การ์ด % และนามสกุลที่อยู่ในรายการที่ระบุ
SELECT *
FROM sample_table
WHERE name LIKE ‘J%’ /* looks for people whose name starts with J */
AND last_name IN (‘Smith’, ‘Rockefeller’, ‘Williams’) /* Looks for people whose last name is in this list */
สุดท้าย การใช้ซับคิวรีช่วยให้การกรองยืดหยุ่นยิ่งขึ้น โดยอิงผลลัพธ์จากตารางอื่น ตัวอย่างที่พบได้บ่อยคือ ค้นหารายชื่อลูกค้า ID หลังวันที่กำหนด
SELECT *
FROM sample_table
WHERE customer_id IN (SELECT id FROM reference_table WHERE date >= ‘2024-01-01’)
การผสานเทคนิคเหล่านี้ทำให้ได้อินพุตข้อมูลตรงความต้องการและลดขนาดชุดข้อมูลได้ นอกจากนี้ การกรองยังใช้ลบระเบียนซ้ำเพื่อทำความสะอาดข้อมูลได้ด้วย เทคนิคขั้นสูงเพิ่มเติม เช่น ฟิลเตอร์ HAVING สำหรับ aggregation และคำสั่ง QUALIFY ร่วมกับ window functions
การจอยน์ช่วยดึงข้อมูลเพิ่มเติมที่จำเป็นต่อชุดข้อมูล SQL มีหลายแบบ เช่น INNER, OUTER, LEFT, และ RIGHT โดย INNER จะเก็บเฉพาะข้อมูลที่แมตช์ทั้งสองฝั่ง ส่วน OUTER จะเก็บข้อมูลที่ไม่แมตช์ด้วย ขึ้นกับฝั่งที่จอยน์ (ซ้ายหรือขวา)
LEFT join จะเก็บข้อมูลฝั่งซ้าย และ RIGHT join จะเก็บฝั่งขวา สามารถผสานกับ INNER/OUTER รวมถึง FULL OUTER JOIN ที่รวมข้อมูลทุกแถวจากทั้งสองตาราง
ตัวอย่างการจอยน์:
SELECT *
FROM a
LEFT OUTER JOIN
b
WHERE a.id = b.id
คำสั่งข้างต้นมีตาราง a อยู่ทางซ้าย (เพราะอยู่ก่อน) และ b ทางขวา (LEFT OUTER JOIN) หมายถึงจอยน์ข้อมูลเมื่อ a.id = b.id แต่ถ้าไม่แมตช์ ให้เก็บข้อมูลฝั่ง a ทั้งหมด การจอยน์เป็นเครื่องมือทรงพลังในการนำเข้าข้อมูลที่จำเป็นต่ออินพุตของคุณ
อีกเครื่องมือหนึ่งใน SQL คือคำสั่ง GROUP BY เพื่อทำ aggregation ช่วยย่อข้อมูลและพรีโพรเซสก่อนส่งต่อไปป์ไลน์ เป็นวิธีคำนวณสถิติสรุปที่ทรงพลัง ตัวอย่างต่อไปนี้คำนวณยอดขายรวมตามรหัสลูกค้า:
SELECT
Customer_ID,
SUM(sales)
FROM sample_table
GROUP BY Customer_ID
มีฟังก์ชัน aggregation มากมาย เช่น SUM, MEAN, MAX, และ MIN ที่ช่วยทำความเข้าใจข้อมูลได้อย่างรวดเร็ว การใช้ aggregation อย่างเหมาะสมช่วยทำให้การรับข้อมูลเข้าสู่ไปป์ไลน์ง่ายขึ้น
ส่วนนี้ครอบคลุมตัวอย่างเชิงปฏิบัติและกรณีใช้งานของเทคนิค data wrangling โดยมุ่งที่เป้าหมายหลัก ได้แก่ การทำข้อมูลให้เป็นมาตรฐาน การผสานแหล่งข้อมูล และการประมวลผลข้อความ
การทำข้อมูลให้อยู่ในหน่วยเดียวกันสำคัญมาก หากวัดสิ่งเดียวกันแต่ใช้หน่วยหรือสกุลเงินต่างกัน อาจทำให้การวิเคราะห์ผิดเพี้ยนได้
ตัวอย่างง่ายๆ คือการแปลงสกุลเงินต่างๆ เป็น USD ใน SQL สมมติว่ามี 2 ตาราง ตารางที่ 1 คือ sales ที่บันทึกยอดขายตามภูมิภาค และตารางที่ 2 คือ currency_exchange ที่เก็บอัตราแลกเปลี่ยนตามภูมิภาคและวัน ตัวอย่างการแปลงเช่น:
SELECT
a.sale_id,
a.region,
CASE WHEN region <> ‘US’
	THEN a.sale_price * b.exchange_rate
	ELSE a.sale_price
END AS sale_price
FROM sales AS a
LEFT OUTER JOIN
currency_exchange AS b
WHERE a.region = b.region
คิวรีนี้ดึง sale_id และ region จากตาราง sales แล้วจอยน์กับตารางอ้างอิง currency_exchange ตามภูมิภาคเพื่อรับอัตราแลกเปลี่ยน บ่อยครั้งจำเป็นต้องมีวันที่เพื่อใช้อัตราแลกเปลี่ยนของวันนั้น
ส่วนสำคัญของ data wrangling คือการเตรียมข้อมูลเพื่อโมเดลแมชชีนเลิร์นนิง ปัจจุบันมีโมเดลที่เน้นงานประมวลผลภาษาธรรมชาติ และหนึ่งในขั้นเตรียมการคือการวิเคราะห์อารมณ์จากข้อมูลข้อความ
ขั้นตอนสำคัญคือการเตรียมข้อความด้วยการทำให้เป็นมาตรฐานและลบเครื่องหมายวรรคตอน เนื่องจากเครื่องหมายวรรคตอนและตัวพิมพ์ใหญ่อาจไม่ให้บริบทสำคัญต่อโมเดล จึงมักทำให้เป็นมาตรฐาน
สำหรับงานนี้จะใช้แพ็กเกจพื้นฐานของ Python และแพ็กเกจ re ดูตัวอย่างการลบเครื่องหมายวรรคตอน ทำตัวพิมพ์เล็ก และตัดช่องว่างด้านล่าง
# import regex
import re

# input string
test_string = "       Python 3.0, released in 2008, was a major revision of the language that is not completely backward compatible and much Python 2 code does not run unmodified on Python 3. With Python 2's end-of-life, only Python 3.6.x[30] and later are supported, with older versions still supporting e.g. Windows 7 (and old installers not restricted to 64-bit Windows)."
# remove whitespaces
no_space_string = test_string.strip()

# convert to lower case
lower_string = no_space_string .lower()

# remove numbers
no_number_string = re.sub(r'\d+','',lower_string)
print(no_number_string)
โค้ดด้านบนเป็นพื้นฐานที่ดีสำหรับการลบช่องว่าง แปลงเป็นตัวพิมพ์เล็กทั้งหมด และลบตัวเลข/ข้อมูลที่ไม่ใช่ตัวอักษร
Data wrangling เป็นองค์ประกอบสำคัญในการเตรียมข้อมูลสำหรับโมเดลแมชชีนเลิร์นนิงและการวิเคราะห์ มีเครื่องมือมากมายใน Python เช่นแพ็กเกจ pandas และ numpy ควบคู่กับวิธีการของ SQL อย่างคำสั่ง WHERE และ GROUP BY ที่ช่วยให้เตรียมข้อมูลได้อย่างมีประสิทธิภาพ
การเชี่ยวชาญเทคนิคเหล่านี้สำคัญต่อความสำเร็จของผู้เชี่ยวชาญด้านข้อมูล หากต้องการศึกษาลึกขึ้นเกี่ยวกับ data wrangling ลองดูทรัพยากรต่อไปนี้:
คอร์สยอดนิยมจาก DataCamp
Courses
Courses
Tracks