Course
Введение в импорт данных в Python
3 ч
340.8K
С ростом объёма, разнообразия и скорости поступления данных фокус на формировании качественных, хорошо структурированных наборов данных стал важнее, чем когда‑либо, поскольку именно они напрямую влияют на точность выводов и эффективность принятия решений в различных отраслях.
Плохо организованные или некорректные данные могут привести к ошибочным выводам, что обходится во времени, деньгах и ресурсах. Здесь на помощь приходит приведение данных — ключевой процесс, который обеспечивает преобразование сырых, неструктурированных данных в чистый, упорядоченный формат, готовый к анализу.
Приведение данных включает серию шагов, гарантирующих точность, надёжность и соответствие конкретным потребностям выполняемого анализа. Овладев этим процессом, вы сможете раскрыть весь потенциал данных, превращая их в прикладные инсайты, которые поддерживают обоснованные решения и ведут к успеху.
Приведение данных — это процесс преобразования сырых данных в более удобный для использования формат. Он включает очистку, структурирование и обогащение данных, чтобы подготовить их к анализу.
Представьте, что вы получили огромный датасет: он «грязный», с пропусками, несоответствиями и нерелевантной информацией. Приведение данных — это как набор инструментов, который помогает «привести в порядок» эти данные, обеспечивая их организованность и согласованность.
Приведение данных важно для обеспечения высокого качества и чёткой структуры данных — это критично для точного анализа. Чистые, структурированные данные служат основой для всех последующих этапов работы с данными — будь то построение модели машинного обучения, создание визуализаций или проведение статистического анализа.
Высококачественные данные снижают риск ошибок и смещений в анализе, что ведёт к более надёжным инсайтам. Понимание важности приведения данных — ключевой момент, поскольку оно напрямую влияет на обоснованность решений, принимаемых на их основе.
Плохо проведённое приведение данных может привести к ошибочным выводам, что чревато серьёзными последствиями в реальных задачах. Поэтому овладение приведением данных необходимо всем, кто серьёзно относится к работе с данными.
Есть 5 основных шагов приведения данных:
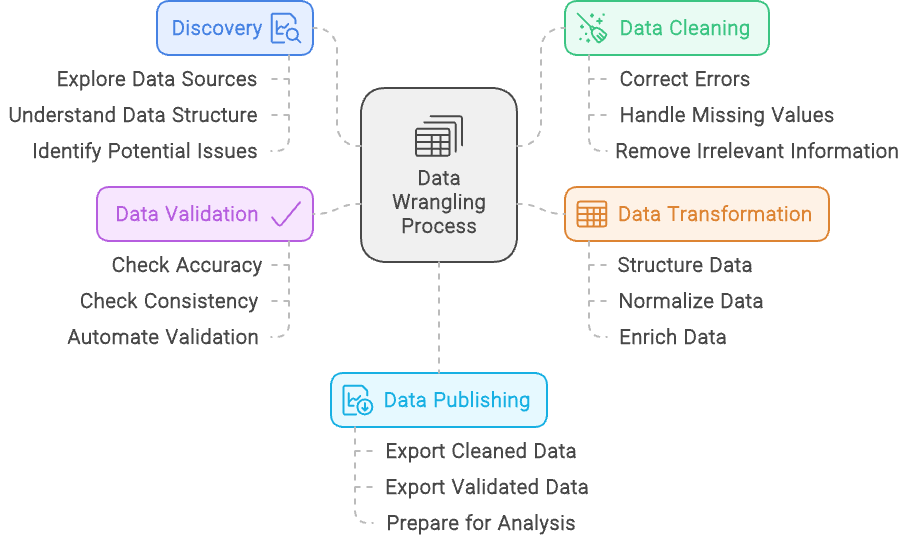
Процесс приведения данных — создано в Napkin.ai
Мы обозначили пять шагов приведения данных, но давайте рассмотрим каждый подробнее.
Этап обнаружения в приведении данных — как первый взгляд на пазл перед сборкой. Он предполагает изучение датасета, чтобы понять, с чем вы работаете: типы данных, их источники и структуру.
Точно так же, как вы сортируете детали пазла по цвету или форме края, обнаружение помогает классифицировать данные и распознавать в них шаблоны, задавая основу для дальнейшей работы.
Но обнаружение — это также поиск потенциальных проблем — как отсутствующие детали или несовпадающие цвета в пазле.
На этом этапе вы выявляете проблемы в данных — несогласованности, пропуски, неожиданные закономерности. Обнаружив их заранее, можно спланировать, как устранить их на последующих шагах приведения данных, обеспечив более плавный путь к чистому и пригодному для использования датасету.
Очистка данных предполагает доведение датасета до состояния точности и надёжности.
Этот процесс включает устранение ошибок, обработку пропусков и исправление несоответствий. Например, если в датасете есть дубли записей о том же человеке или транзакции, очистка данных подразумевает удаление дублей, чтобы избежать искажения результатов.
Кроме того, если вы видите, что некоторые записи имеют некорректный формат (например, номера телефонов в разных форматах), их нужно привести к единому стандарту. Цель — повысить общее качество и целостность данных, чтобы обеспечить точный и содержательный анализ.
Преобразование данных — это изменение и обогащение датасета в соответствии с требованиями анализа. Этот шаг включает структурирование данных, например, изменение их формы до нужного формата или объединение нескольких источников в единую структуру.
Нормализация данных — ещё один важный аспект: приведение значений к общей шкале или формату, например конвертация всех сумм в единую валюту или стандартизация единиц измерения.
Кроме того, преобразование данных включает обогащение датасета — добавление новых переменных или интеграцию внешних источников для расширения контекста. Например, можно рассчитать новые метрики на основе имеющихся данных или присоединить дополнительную информацию из других баз, чтобы получить более полную картину.
Цель преобразования — подготовить данные так, чтобы повысить их пригодность и значимость для углублённого анализа.
Валидация данных — это обеспечение точности и надёжности датасета посредством систематических проверок и автоматизированных процедур. Это критический шаг для подтверждения корректности и согласованности данных.
Во время валидации выполняются проверки на выявление несоответствий — сравнение данных с известными эталонами или проверка по заранее заданным правилам и ограничениям. Автоматизация может включать запуск скриптов, которые помечают аномалии или несоответствия, удостоверяясь, что данные соответствуют ожидаемым форматам и диапазонам.
Цель валидации — выявить проблемы до использования данных в анализе, предотвращая влияние ошибок на результаты. Тщательно проверяя точность и надёжность, вы обеспечиваете, что выводы основаны на достоверной информации.
Публикация данных — заключительный этап приведения, когда очищенные и структурированные данные становятся доступными для анализа и принятия решений. Этот шаг включает подготовку данных к распространению — создание дашбордов, отчётов или интерактивных визуализаций, делающих их доступными и понятными для заинтересованных сторон.
При публикации вы можете настраивать конвейеры данных или интерфейсы, позволяющие пользователям запрашивать и изучать данные, обеспечивая доставку в нужном для них формате.
Цель — предоставить ясные, практические инсайты, поддерживающие обоснованное принятие решений и облегчающие коммуникацию результатов по всей организации. Эффективная публикация данных обеспечивает превращение труда по приведению данных в значимые и прикладные результаты.
Термины приведение данных и очистка данных часто используют как синонимы, но они относятся к разным аспектам подготовки данных. Оба необходимы для подготовки к анализу, однако служат разным целям и включают различные задачи. Понимание различий помогает чётко разграничить роли и эффективно выполнять каждый этап подготовки.
Приведение данных — это комплексный процесс преобразования сырых данных в формат, пригодный для анализа. Он охватывает несколько этапов: получение данных, их структурирование, очистку и валидацию. Цель — подготовить данные из разных источников для эффективного анализа и получения инсайтов. Этот процесс обеспечивает организованность, точность и готовность данных к детальному анализу.
Очистка данных, в свою очередь, — это частный случай приведения данных. Она сосредоточена исключительно на повышении качества данных путём устранения ошибок и несоответствий: удаление дубликатов, исправление опечаток, обработка пропусков, стандартизация форматов. Хотя очистка — важная часть приведения, это лишь один из шагов более широкого процесса.
Проще говоря, приведение данных — это общая схема подготовки данных к анализу, включающая несколько шагов для разных аспектов подготовки. Очистка данных — неотъемлемая часть этой схемы, посвящённая повышению точности и согласованности данных.
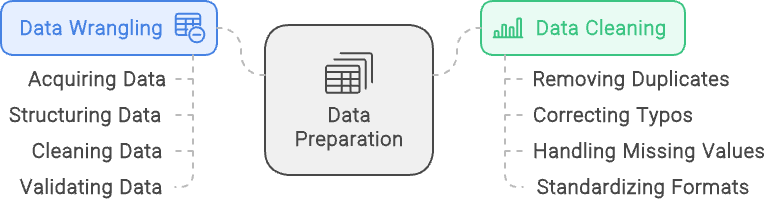
Приведение данных vs. очистка данных: приведение фокусируется на структурировании и валидации данных, тогда как очистка — на обеспечении чистоты и качества. Изображение создано в napkin.ai
Приводить данные можно по‑разному: используя базовые инструменты с графическим интерфейсом, такие как Excel или Alteryx, а также с помощью кодирования на языках R и Python. Рассмотрим несколько вариантов.
Для простых задач приведения данных электронные таблицы, такие как Microsoft Excel и Google Sheets, часто являются выбором по умолчанию. Они доступны и привычны, что делает их идеальными для сортировки, фильтрации и базовой очистки данных. Таблицы особенно полезны для небольших датасетов или для тех, кто только начинает изучать приведение данных.
Благодаря встроенным функциям и формулам они позволяют быстро выполнять вычисления и манипулировать данными без глубоких технических знаний.
Для более сложных преобразований и автоматизации широко применяются языки программирования Python и R. Python с мощными библиотеками, такими как Pandas, NumPy и OpenRefine, отлично подходит для работы с большими датасетами и сложных трансформаций.
R с пакетами dplyr и tidyr — ещё один сильный вариант, особенно в статистическом и академическом сообществах, благодаря развитым возможностям анализа данных. Оба языка предоставляют высокую гибкость, позволяя создавать кастомные сценарии и автоматизировать повторяющиеся задачи — это оптимально для специалистов, решающих более сложные задачи приведения данных.
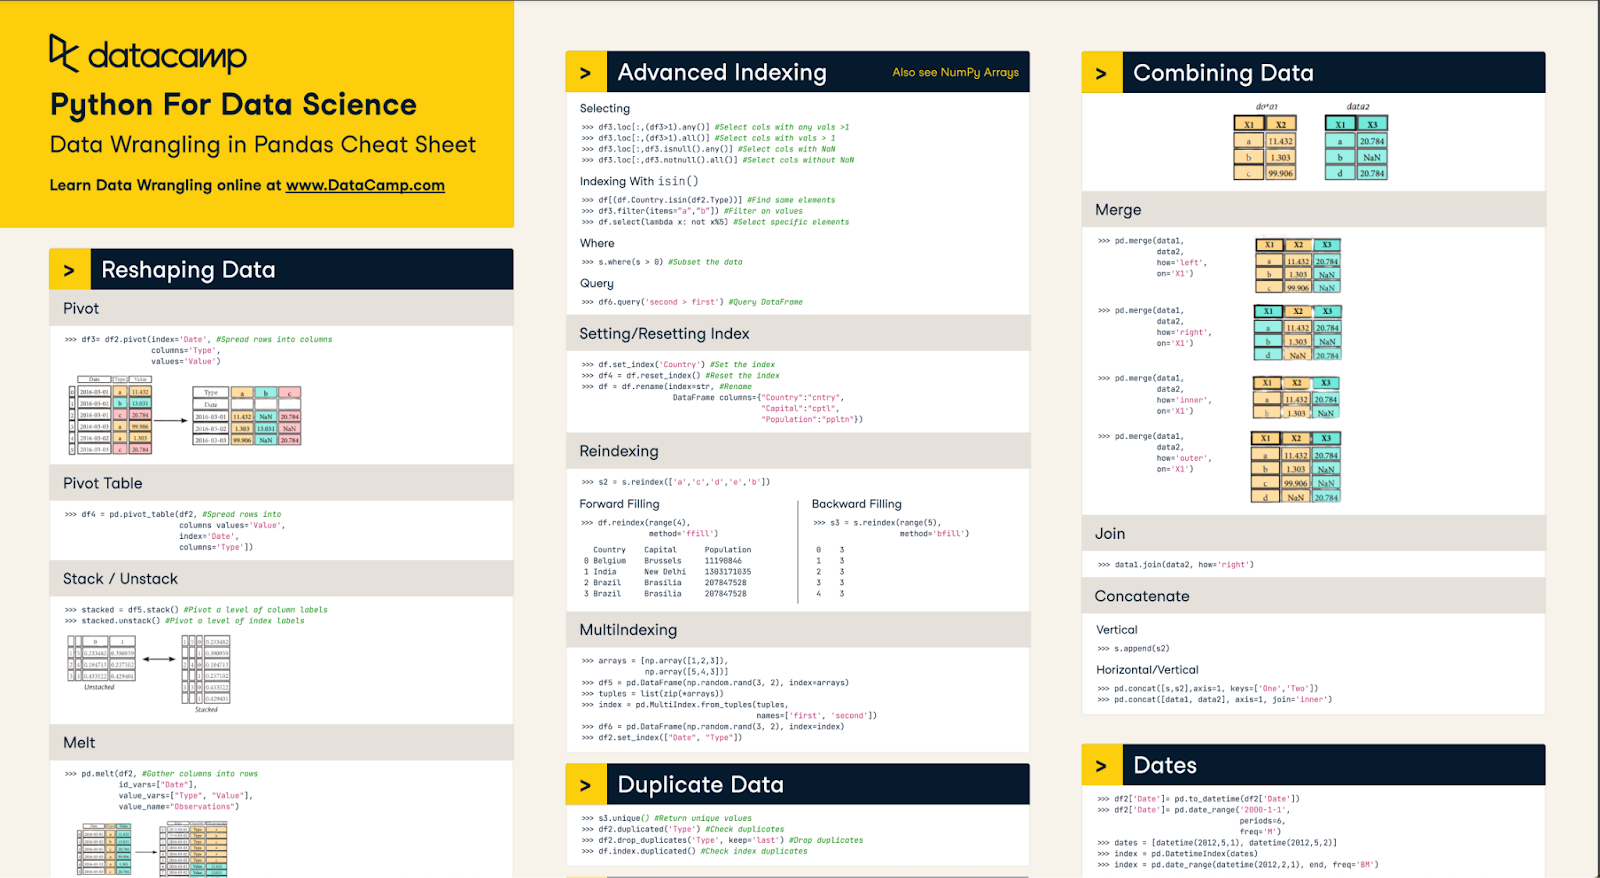
Наш шпаргалка по приведению данных в Pandas поможет освоить многие основы
Специализированные инструменты созданы для упрощения процесса приведения данных и предлагают расширенные возможности для решения сложных задач. Они подходят тем, кому нужны мощные и в то же время доступные средства для очистки, структурирования и подготовки данных к анализу без необходимости много кодировать.
Alteryx — один из лидеров в этой категории, известный интуитивным интерфейсом drag‑and‑drop, который позволяет легко очищать, объединять и преобразовывать данные из множества источников. В нём есть множество встроенных инструментов для манипуляций с данными, упрощающих фильтрацию, объединение и агрегирование.
Облачный Alteryx Designer Cloud ещё больше расширяет эти возможности, предоставляя масштабируемую, совместную платформу для приведения данных. Это решение позволяет командам работать в реальном времени, эффективно обрабатывать большие датасеты и сложные пайплайны в разных средах. Независимо от развертывания — локально или в облаке — Alteryx обеспечивает точную подготовку данных и их готовность к содержательному анализу.
Для комплексных проектов, требующих сквозных решений, часто используют интегрированные платформы, такие как KNIME, Apache NiFi и Microsoft Power BI. Эти платформы поддерживают не только приведение данных, но и интеграцию, анализ и визуализацию в одном окружении.
KNIME известна модульным, узловым интерфейсом для визуальной сборки сложных рабочих процессов. Apache NiFi превосходно управляет и автоматизирует потоки данных между системами, а Power BI сочетает подготовку данных с мощной визуализацией. Эти платформы идеальны там, где данные нужно бесшовно подготовить, проанализировать и распространить, обеспечивая целостный подход к принятию решений на основе данных.
Существует множество вариантов приведения данных на Python. Два основных пакета — Pandas и NumPy. Они предоставляют мощные инструменты, позволяющие легко применять ключевые техники приведения данных к вашим наборам данных.
Очень многое в обработке данных происходит в Python, поэтому владение этими пакетами необходимо любому специалисту по данным. Среди множества техник особенно важно уметь выполнять базовую очистку (например, удаление null-значений), объединять датасеты и обрабатывать пропуски.
Нередко данные нужно очистить в Python перед использованием. Это может включать удаление пробелов в начале/конце строк, удаление null-значений или исправление типов данных — и это лишь часть задач.
Каждый датасет уникален и имеет свои особенности, поэтому изучайте его, чтобы понять, нужна ли дополнительная очистка. Практика разных техник и навыков кодирования — отличный способ узнать, как именно можно очищать данные в Python.
При работе со строками одна из частых проблем — пробелы в начале/конце. Это мешает разбору строк по длине, позиции или совпадению. Лучший способ — использовать метод str.strip() для серии.
# Example utilizes a pandas series
# If working with a dataframe, call the series using df[col] syntax
s = pd.Series(['1. Ant.  ', '2. Bee!\n', '3. Cat?\t', np.nan, 10, True])
# It is important to include the .str or else the method will not work
s.str.strip()
Удалять null-значения в Pandas просто. О том, как их заполнять, поговорим ниже. Можно просто использовать метод dropna(). В этом методе есть необязательные параметры, позволяющие задать точные условия удаления строки/столбца, но по умолчанию удаляется любая строка с любыми null-значениями.
# For any dataframe
df = pd.DataFrame({"name": ['Alfred', 'Batman', 'Catwoman'],
                   "toy": [np.nan, 'Batmobile', 'Bullwhip'],
                   "born": [pd.NaT, pd.Timestamp("1940-04-25"), pd.NaT]}
df.dropna()
Метод .astype() позволяет изменять тип данных серии, но корректировка типов чуть сложнее, ведь нужно убедиться, что каждое значение в серии Pandas соответствует выбранному типу.
Например, преобразование серии типа object в целые числа предполагает, что каждое значение — целое. Если найдётся хотя бы одно нецелое значение, метод завершится с ошибкой. Можно принудительно привести, заменив неверные значения на null, но зачастую полезнее разобраться, почему некоторые значения не конвертируются.
Объединение DataFrame в Pandas похоже на join в SQL. Поведение по умолчанию у merge() — внутреннее соединение (inner join). Однако оно соединяет и по null, так что будьте внимательны. Для объединения нужно указать ключ. Можно объединять по нескольким столбцам или даже по индексу.
# Create two dataframes
df1 = pd.DataFrame({'lkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [1, 2, 3, 5]})
df2 = pd.DataFrame({'rkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [5, 6, 7, 8]})
# merge the df1 DataFrame to the df2 DataFrame using the columns key and rkey as keys
df1.merge(df2, left_on='lkey', right_on='rkey')
Этот код объединит два DataFrame по совпадающим ключам в столбцах lkey и rkey. Неподходящие значения будут отброшены, останутся только совпавшие. Однако можно изменить поведение и выбрать левое/правое/полное объединение. Это мощный инструмент, позволяющий объединять разные наборы данных из различных источников.
Методика обработки пропусков зависит от бизнес‑кейса. Важно понять, почему значение отсутствует. Если пропуск вызван технической ошибкой, возможно, стоит сначала исправить её и попытаться восстановить историю, прежде чем анализировать данные.
Иногда можно использовать остальную информацию и просто игнорировать пропуск. Если исторические данные важны и невосстановимы, нужно заполнять пропуски. Обсудим способы заполнения.
Основной метод — fillna() из Pandas. Для строк можно, к примеру, заполнить null так: df.fillna(value=’missing’) — этого может быть достаточно! Прелесть метода в его гибкости. Комбинируя fillna() с функциями NumPy, такими как mean(), median(), и lambda‑функциями, можно математически заполнять пропуски.
Альтернативно существуют методы Pandas, такие как interpolate(), которые алгоритмически заполняют разрывы, если данные упорядочены (например, по времени). Цель — заполнить как можно точнее, чтобы это отражало реальные данные.
Выполнять приведение данных в SQL — эффективный способ обработки, особенно если ваша база данных развернута в облаке. Это снижает нагрузку на локальную машину и объём передаваемых по сети данных.
Главная задача приведения данных в SQL — ограничение потока данных в пайплайнах через корректное извлечение, преобразование и загрузку. Для этого используют фильтрацию, соединение со справочными таблицами и агрегирования.
Основной способ фильтрации таблиц в SQL — оператор WHERE. Он прост в использовании, но чрезвычайно мощный. Условия могут быть простыми проверками на равенство, поиском похожих строк или подзапросами. Можно комбинировать условия с помощью AND и OR!
Фильтрация по простым случаям, таким как поиск конкретного значения в столбце, может выглядеть так:
SELECT *
FROM sample_table
WHERE sample_col = 23
Более сложные конструкции — LIKE или IN — добавляют гибкости вашим WHERE. Например, следующий запрос ищет людей, чьё имя начинается на J (благодаря подстановочному знаку %), и чья фамилия IN заданном списке.
SELECT *
FROM sample_table
WHERE name LIKE ‘J%’ /* looks for people whose name starts with J */
AND last_name IN (‘Smith’, ‘Rockefeller’, ‘Williams’) /* Looks for people whose last name is in this list */
Наконец, подзапросы добавляют гибкости фильтрации — условия могут основываться на результатах другой таблицы. Распространённый пример — поиск списка идентификаторов клиентов после определённой даты‑времени.
SELECT *
FROM sample_table
WHERE customer_id IN (SELECT id FROM reference_table WHERE date >= ‘2024-01-01’)
Комбинируя эти техники, вы получите именно те входные данные, которые нужны, и минимизируете размер датасетов. Дополнительно фильтры помогают убирать дубликаты и тем самым очищать данные. Из продвинутых приёмов — фильтры HAVING для агрегатов и QUALIFY с оконными функциями.
Соединения таблиц позволяют получать дополнительную информацию, нужную для датасетов. В SQL доступны различные соединения: INNER, OUTER, LEFT и RIGHT. В INNER и OUTER соединениях мы определяем, какие данные сохранять: INNER сохраняет только совпадающие записи с обеих сторон, а OUTER — также и несовпавшие, в зависимости от стороны соединения (левая/правая).
Соединение LEFT сохраняет данные из левой таблицы, RIGHT — из правой. Их комбинируют с INNER и OUTER, а также используют специальное FULL OUTER JOIN, которое объединяет все данные из обеих таблиц.
Пример соединения:
SELECT *
FROM a
LEFT OUTER JOIN
b
WHERE a.id = b.id
В этом примере таблица a — левая (указана первой), b — правая (вторая). LEFT OUTER JOIN означает: соедини данные из a и b, где a.id = b.id, но если соответствия нет, сохрани все данные из a. Соединения — мощный инструмент для подтягивания нужных дополнительных данных.
Ещё один инструмент SQL для приведения данных — оператор GROUP BY для агрегирования. Он упрощает данные и позволяет частично предварительно обработать их перед дальнейшей передачей по пайплайну. Агрегирование — мощный способ расчёта сводной статистики. Ниже пример подсчёта общих продаж по идентификатору клиента:
SELECT
Customer_ID,
SUM(sales)
FROM sample_table
GROUP BY Customer_ID
Существует множество агрегатных функций, таких как SUM, MEAN, MAX и MIN, которые помогают быстро и просто получить представление о данных. Использование агрегирования упрощает загрузку данных в пайплайны.
В этом разделе рассмотрим практические примеры использования техник приведения данных. Сфокусируемся на стандартизации данных, объединении источников и обработке текста.
Приведение данных к единым единицам измерения важно. Если вы работаете с одной и той же метрикой в разных единицах или валютах, это может исказить анализ.
Рассмотрим простой пример конвертации разных валют в USD на SQL. Допустим, у нас есть две таблицы. Таблица 1 — sales с продажами продуктов по регионам, таблица 2 — currency_exchange со значениями курсов валют по регионам и датам. Пример конвертации может выглядеть так:
SELECT
a.sale_id,
a.region,
CASE WHEN region <> ‘US’
	THEN a.sale_price * b.exchange_rate
	ELSE a.sale_price
END AS sale_price
FROM sales AS a
LEFT OUTER JOIN
currency_exchange AS b
WHERE a.region = b.region
Здесь мы берём sale_id и region из таблицы sales и присоединяем к справочной currency_exchange по региону, чтобы получить курс. Часто добавляют дату, чтобы использовать курс на конкретный день.
Важная часть приведения — подготовка данных для моделей машинного обучения. В последнее время многие модели ориентированы на обработку естественного языка, и один из предшествующих шагов — анализ тональности текстов.
Критический шаг — нормализация текста и удаление пунктуации. Поскольку знаки препинания и регистр часто не несут важного контекста для модели, их обычно нормализуют.
Для этого воспользуемся базовыми пакетами Python и модулем re. Ниже — пример удаления пунктуации, приведения к нижнему регистру и обрезки пустых пробелов.
# import regex
import re

# input string
test_string = "       Python 3.0, released in 2008, was a major revision of the language that is not completely backward compatible and much Python 2 code does not run unmodified on Python 3. With Python 2's end-of-life, only Python 3.6.x[30] and later are supported, with older versions still supporting e.g. Windows 7 (and old installers not restricted to 64-bit Windows)."
# remove whitespaces
no_space_string = test_string.strip()

# convert to lower case
lower_string = no_space_string .lower()

# remove numbers
no_number_string = re.sub(r'\d+','',lower_string)
print(no_number_string)
Этот фрагмент кода даёт отличную основу для удаления пробелов, приведения к нижнему регистру и удаления чисел/неалфавитных символов.
Приведение данных — ключевой компонент подготовки данных для моделей машинного обучения и аналитики. В вашем распоряжении множество инструментов Python, таких как пакеты pandas и numpy, а также разные средства SQL, включая операторы WHERE и GROUP BY, которые помогают подготовить данные.
Овладение этими техниками критично для успеха каждого начинающего специалиста по данным. Если хотите углубиться в тему приведения данных, обратитесь к следующим материалам:
Лучшие курсы DataCamp
Course
Course
Track