course
Introduktion till dataimport i Python
3 timmar
340.8K
Med den ökande datavolymen, -variationen och -hastigheten har det blivit viktigare än någonsin att fokusera på att bygga kvalitativa och välstrukturerade datamängder, eftersom de direkt påverkar träffsäkerheten i insikter och effektiviteten i beslutsfattandet i olika branscher.
Dåligt organiserade eller bristfälliga data kan leda till felaktiga slutsatser som kostar tid, pengar och resurser. Det är här data wrangling kommer in som den avgörande processen som säkerställer att rå, ostrukturerad data omvandlas till ett rent, organiserat format som är redo för analys.
Data wrangling omfattar en serie steg för att säkerställa att datan är korrekt, tillförlitlig och anpassad till de specifika behoven i den aktuella analysen. Genom att bemästra data wrangling kan du frigöra datans fulla potential och förvandla den till handlingsbara insikter som driver informerade beslut och i slutändan leder till framgång.
Data wrangling är processen att omvandla rådata till ett mer användbart format. Det innebär att rengöra, strukturera och berika data så att den är redo för analys.
Föreställ dig att du precis har fått en enorm datamängd—den är stökig, med saknade värden, inkonsekvenser och irrelevant information. Data wrangling är som en verktygslåda som hjälper dig att städa upp datan så att den blir organiserad och konsekvent.
Data wrangling är viktigt för att säkerställa att dina data håller hög kvalitet och är välstrukturerade, vilket är avgörande för korrekt dataanalys. Ren, strukturerad data utgör grunden för alla efterföljande steg i dataflödet—oavsett om du bygger en maskininlärningsmodell, skapar visualiseringar eller utför statistisk analys.
Data av hög kvalitet minskar risken för fel och bias i din analys, vilket leder till mer tillförlitliga insikter. Att förstå vikten av data wrangling är nyckeln, eftersom det direkt påverkar giltigheten i de beslut som fattas baserat på dessa data.
Bristfälligt bearbetade data kan leda till felaktiga slutsatser, vilket kan få stora konsekvenser i verkliga tillämpningar. Därför är det nödvändigt att behärska data wrangling för alla som på allvar vill fatta datadrivna beslut.
Det finns fem huvudsteg i data wrangling:
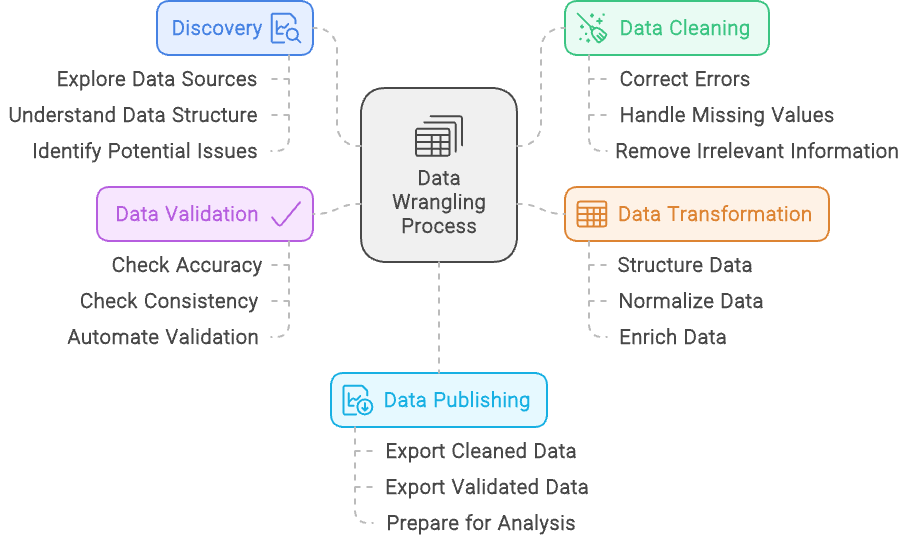
Processen för data wrangling - skapad med Napkin.ai
Vi har beskrivit de fem stegen i data wrangling, men låt oss titta närmare på vart och ett:
Steget discovery i data wrangling är som att först kasta en blick på ett pussel innan du börjar lägga bitarna. Det innebär att granska datamängden för att få en tydlig bild av vad du arbetar med, inklusive att förstå datatyperna, dess källor och hur den är strukturerad.
Precis som du kan sortera pusselbitar efter färg eller kantform hjälper utforskningen dig att kategorisera och känna igen mönster i datan och lägger grunden för det fortsatta arbetet.
Men utforskning handlar också om att upptäcka potentiella problem—som saknade bitar eller missmatchade färger i ett pussel.
Under detta steg identifierar du eventuella problem i datan, såsom inkonsekvenser, saknade värden eller oväntade mönster. Genom att avslöja dessa utmaningar tidigt kan du planera hur de ska hanteras i kommande steg av data wrangling och därmed bana väg för en smidigare resa mot en ren och användbar datamängd.
Datastädning innebär att förfina din datamängd så att den är korrekt och tillförlitlig.
Processen omfattar att hantera problem som att rätta fel, hantera saknade värden och åtgärda inkonsekvenser. Om din datamängd till exempel innehåller dubbletter för samma person eller transaktion, innebär datastädning att ta bort dessa dubbletter för att undvika snedvridna resultat.
Dessutom, om du märker att vissa poster är felaktigt formaterade, till exempel telefonnummer i varierande format, standardiserar du dem till ett enhetligt format. Målet är att höja datans övergripande kvalitet och integritet så att den blir redo för korrekt och meningsfull analys.
Datatransformering är processen att modifiera och förbättra din datamängd så att den bättre passar kraven i din analys. Detta steg innebär att strukturera datan, till exempel att forma om den till önskat format eller att kombinera flera källor till en sammanhängande struktur.
Normalisering av data är en annan viktig del, vilket innebär att justera värden till en gemensam skala eller ett gemensamt format, som att konvertera alla valutavärden till en enda valuta eller standardisera måttenheter.
Dessutom innebär datatransformering att berika datamängden genom att lägga till nya variabler eller integrera externa datakällor för att ge mer kontext eller insikter. Till exempel kan du beräkna nya mått baserat på befintliga data eller lägga till ytterligare information från andra databaser för att ge en fylligare bild.
Målet med datatransformering är att förbereda datan på ett sätt som förbättrar dess användbarhet och relevans för djupgående analys.
Datavalidering innebär att säkerställa att din datamängd är korrekt och tillförlitlig genom systematiska kontroller och automatiserade processer. Detta steg är avgörande för att bekräfta att datan är både korrekt och konsekvent.
Under datavalideringen utför du olika kontroller för att identifiera avvikelser, såsom att jämföra data mot kända riktmärken eller validera mot fördefinierade regler och begränsningar. Automatiserade processer kan inkludera skript som flaggar anomalier eller inkonsekvenser och säkerställer att datan följer förväntade format och intervall.
Målet med datavalidering är att fånga upp problem innan datan används för analys, så att fel inte påverkar resultaten. Genom att noggrant verifiera datans korrekthet och tillförlitlighet säkerställer du att de insikter som dras från datan bygger på pålitlig information.
Publicering av data är det sista steget i processen för data wrangling, där den rengjorda och strukturerade datan görs tillgänglig för analys och beslutsfattande. Detta steg innebär att förbereda datan för spridning, ofta genom att skapa instrumentpaneler, rapporter eller interaktiva visualiseringar som gör den tillgänglig och begriplig för intressenter.
Under publiceringen kan du sätta upp datapipelines eller gränssnitt som gör det möjligt för användare att göra frågor mot och interagera med datan, och säkerställa att den levereras i ett format som möter deras behov.
Målet är att tillhandahålla tydliga, handlingsbara insikter från datan, vilket möjliggör informerade beslut och underlättar kommunikationen av resultat i hela organisationen. Genom att effektivt publicera datan säkerställer du att arbetet med data wrangling mynnar ut i meningsfulla och praktiska resultat.
Termerna data wrangling och datastädning används ofta omväxlande, men de syftar på olika delar av dataprepareringen. Båda är nödvändiga för att förbereda data för analys, men de fyller olika syften och innefattar olika uppgifter. Att förstå skillnaden mellan dem klargör deras roller och säkerställer att varje del av dataprepareringen hanteras effektivt.
Data wrangling är en omfattande process som innebär att omvandla rådata till ett format som lämpar sig för analys. Den omfattar flera steg, inklusive att hämta data, strukturera den, städa den och validera den. Målet med data wrangling är att förbereda data från olika källor så att den effektivt kan analyseras och användas för att generera insikter. Processen säkerställer att data är organiserad, korrekt och redo för fördjupad analys.
Datastädning, å andra sidan, är en specifik delmängd av data wrangling. Den fokuserar enbart på att förbättra datakvaliteten genom att åtgärda och korrigera fel och inkonsekvenser. Detta inkluderar uppgifter som att ta bort dubbletter, rätta stavfel, hantera saknade värden och standardisera dataformat. Även om datastädning är en avgörande del av data wrangling är det bara ett steg i den bredare processen.
Enkelt uttryckt är data wrangling det övergripande ramverket som förbereder data för analys, inklusive flera steg för att hantera olika aspekter av dataprepareringen. Datastädning är en integrerad komponent i detta ramverk, specifikt inriktad på att förbättra datans noggrannhet och konsekvens.
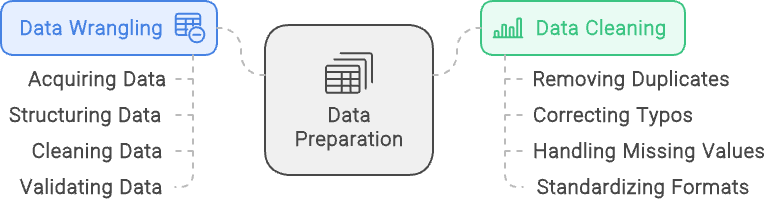
Data wrangling vs datastädning: Data wrangling fokuserar på att strukturera och validera data medan datastädning fokuserar på att säkerställa att rena och kvalitativa data finns tillgängliga. Bild skapad med napkin.ai
Det finns många sätt att bearbeta data, antingen med grundläggande GUI-baserade verktyg som Excel eller Alteryx, eller genom kodning med språk som R och Python. Vi utforskar några alternativ här.
För enklare uppgifter inom data wrangling är kalkylblad som Microsoft Excel och Google Kalkylark ofta förstahandsvalet. Dessa verktyg är mycket tillgängliga och har ett välbekant gränssnitt, vilket gör dem idealiska för uppgifter som sortering, filtrering och grundläggande datastädning. Kalkylblad är särskilt användbara för mindre datamängder eller för den som precis börjar lära sig data wrangling.
Med inbyggda funktioner och formler kan användare snabbt göra beräkningar och manipulera data utan omfattande teknisk kunskap.
För mer komplex datamanipulation och automatisering används programmeringsspråk som Python och R i stor utsträckning. Python, med sina kraftfulla bibliotek som Pandas, NumPy och OpenRefine, är utmärkt för att hantera stora datamängder och utföra avancerade datatransformationer.
R, med paket som dplyr och tidyr, är ett annat starkt alternativ, särskilt uppskattat inom statistik- och akademiska kretsar för sina robusta analysmöjligheter. Båda språken erbjuder stor flexibilitet och låter användare skripta egna arbetsflöden och automatisera repetitiva uppgifter, vilket gör dem idealiska för datautövare med mer avancerade behov av data wrangling.
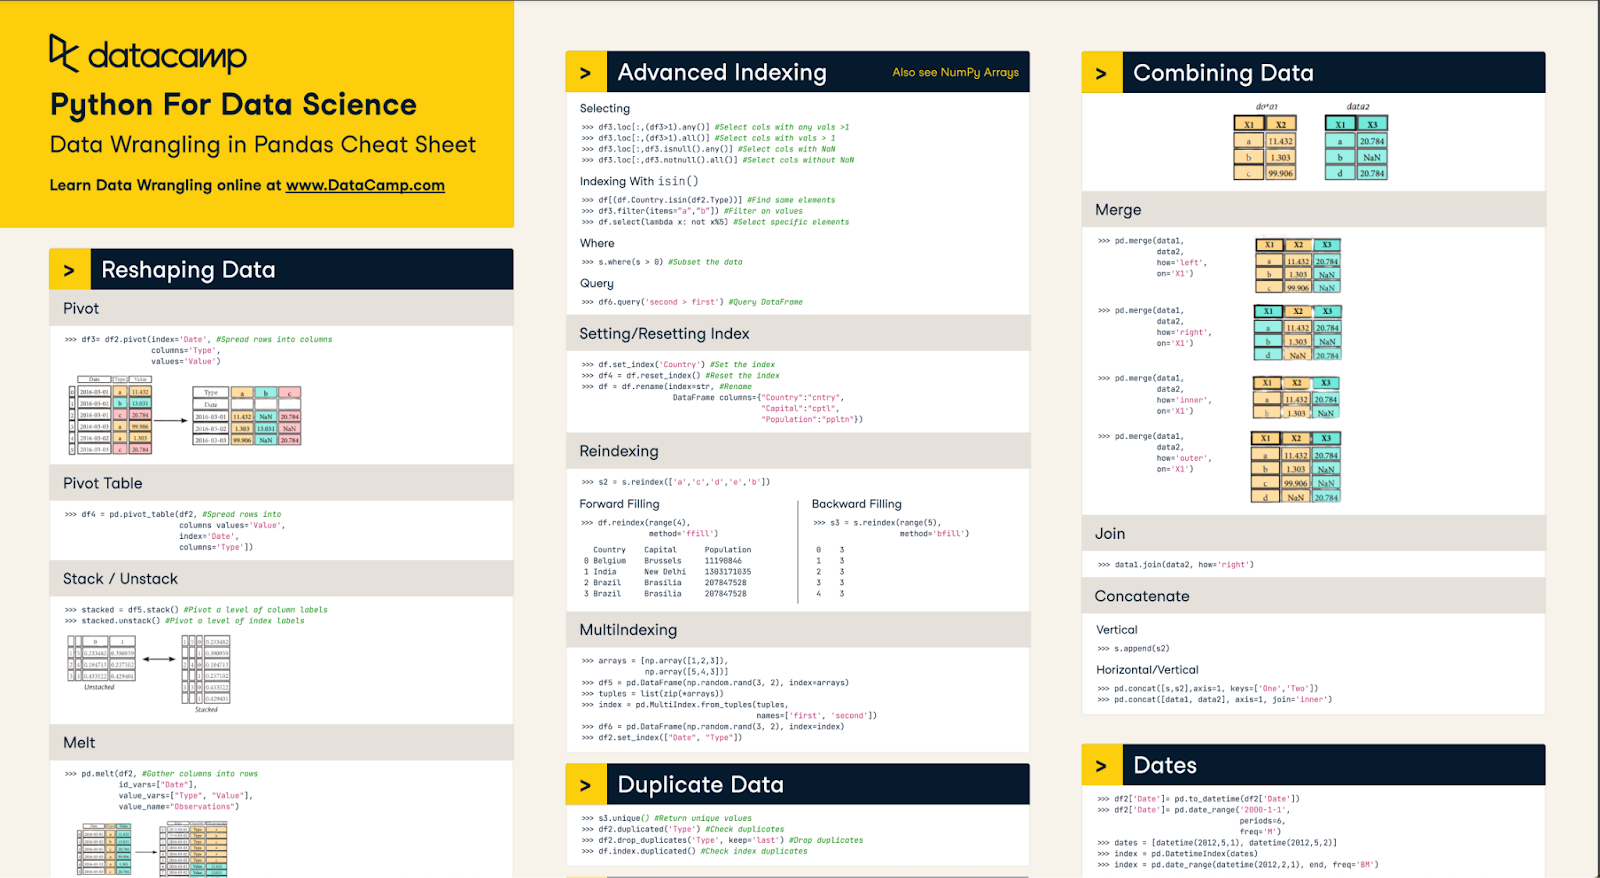
Vårt fusklapp för Data wrangling i Pandas kan hjälpa dig att bemästra många av grunderna
Dedikerade programvaruverktyg är särskilt utformade för att effektivisera processen för data wrangling och erbjuder avancerade funktioner som förenklar komplexa datauppgifter. Dessa verktyg är idealiska för användare som behöver kraftfulla men lättillgängliga lösningar för att städa, strukturera och förbereda data för analys utan att behöva omfattande kodning.
Alteryx är ett ledande verktyg i denna kategori, känt för sitt intuitiva dra-och-släpp-gränssnitt som gör det enkelt att rensa, blanda och transformera data från flera källor. Det har en rad inbyggda verktyg för datamanipulation, vilket gör det enkelt att utföra uppgifter som filtrering, sammanslagning och aggregering av data.
Det molnbaserade Alteryx Designer Cloud förstärker dessa möjligheter ytterligare genom att erbjuda en skalbar, samarbetsinriktad plattform för data wrangling. Denna lösning gör att team kan arbeta tillsammans i realtid och hantera stora datamängder och komplexa arbetsflöden effektivt i olika miljöer. Oavsett om den används lokalt eller i molnet säkerställer Alteryx att data förbereds korrekt och är redo för insiktsfull analys.
För omfattande dataprojekt som kräver helhetslösningar används ofta integrerade plattformar som KNIME, Apache NiFi och Microsoft Power BI. Dessa plattformar stöder inte bara data wrangling utan erbjuder även verktyg för dataintegration, analys och visualisering i en och samma miljö.
KNIME är till exempel känt för sitt modulära, nodbaserade gränssnitt som låter användare bygga komplexa arbetsflöden visuellt. Apache NiFi utmärker sig i att hantera och automatisera dataflöden mellan system, medan Power BI kombinerar datapreparering med kraftfulla visualiseringsmöjligheter. Dessa plattformar är idealiska för projekt där data behöver förberedas, analyseras och delas sömlöst, och erbjuder ett holistiskt angreppssätt för datadrivet beslutsfattande.
Det finns många alternativ när det gäller data wrangling med Python. Två huvudpaket som används är Pandas och NumPy. Dessa två paket har kraftfulla verktyg som gör det enkelt för användare att utföra centrala tekniker för data wrangling på sina datamängder.
Så mycket databehandling sker i Python att det är avgörande för alla datautövare att behärska dessa paket. Även om det finns många tekniker är några nyckelkunskaper att kunna utföra övergripande datastädning (till exempel ta bort null-värden), slå ihop datamängder och hantera saknade värden.
Det finns många tillfällen då data behöver rengöras i Python innan de används. Det kan handla om att ta bort inledande/efterföljande mellanslag i strängar, ta bort null-värden eller korrigera datatyper, för att nämna några exempel.
Varje datamängd är unik och har sina egna behov, så utforska din datamängd för att förstå om ytterligare städning krävs. Att öva på olika tekniker och kodningsfärdigheter är ett bra sätt att lära sig alla olika sätt vi kan städa data i Python.
När det gäller att städa upp strängar är ett av många problem inledande/efterföljande mellanslag. Det kan orsaka problem när du försöker parsa strängar baserat på längd, position eller matchning. Det bästa sättet att hantera detta är att använda metoden str.strip() på en serie.
# Example utilizes a pandas series
# If working with a dataframe, call the series using df[col] syntax
s = pd.Series(['1. Ant.  ', '2. Bee!\n', '3. Cat?\t', np.nan, 10, True])
# It is important to include the .str or else the method will not work
s.str.strip()
Att ta bort null-värden i Pandas är enkelt. Vi diskuterar hur man fyller i null-värden senare i artikeln. Du kan helt enkelt använda metoden dropna(). Det finns valfria parametrar i metoden som låter dig välja de exakta villkoren som tar bort en rad/kolumn, men standardbeteendet är att ta bort alla rader med någon form av null-värden
# For any dataframe
df = pd.DataFrame({"name": ['Alfred', 'Batman', 'Catwoman'],
                   "toy": [np.nan, 'Batmobile', 'Bullwhip'],
                   "born": [pd.NaT, pd.Timestamp("1940-04-25"), pd.NaT]}
df.dropna()
Metoden .astype() låter användare ändra datatypen för en serie, men att korrigera datatyper är lite knepigare eftersom du måste försäkra dig om att varje värde i din Pandas-serie matchar den datatypen.
Att till exempel konvertera en serie av typen object till heltal innebär att du vet att varje värde är ett heltal. Om det finns ett enda värde som inte är ett heltal kommer metoden att ge fel. Du kan välja att tvinga detta genom att göra ogiltiga värden till null, men det kan vara mer värt att undersöka varför vissa värden inte konverteras.
Att slå samman DataFrames i Pandas liknar join i SQL. Standardbeteendet för en Pandas-merge() är en inner join. Den joinar dock på null-värden, så var försiktig. För att göra en merge behöver du använda en specifik nyckel. Du kan joina på olika kolumner eller till och med indexet.
# Create two dataframes
df1 = pd.DataFrame({'lkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [1, 2, 3, 5]})
df2 = pd.DataFrame({'rkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [5, 6, 7, 8]})
# merge the df1 DataFrame to the df2 DataFrame using the columns key and rkey as keys
df1.merge(df2, left_on='lkey', right_on='rkey')
Koden ovan slår samman de två DataFrames baserat på matchande nycklar i respektive kolumner lkey och rkey. Omatchade värden tas bort och du får bara de matchade värdena kvar. Du kan dock ändra merge-beteendet och välja vänster/höger/outer merge också. Detta är ett kraftfullt verktyg som gör det möjligt för data scientists att föra samman olika datamängder från olika datakällor.
När det gäller saknade värden kan metodiken variera beroende på affärsfallet. När vi pratar om saknade värden måste vi överväga varför värdet saknas. Om värdet saknas på grund av tekniska fel kanske vi bör fokusera på att åtgärda det tekniska felet innan vi analyserar våra data och se om vi kan återställa historiska data.
Ibland kan vi använda resten av datan och helt enkelt ignorera det saknade värdet. Om historiska data är viktiga och inte går att återställa måste vi fylla i de saknade uppgifterna. Låt oss diskutera hur man fyller i saknad information.
Huvudmetoden för att fylla i data är att använda Pandas-metoden fillna(). För strängvärden kan denna metod användas för att fylla i null-värden, till exempel: df.fillna(value=’missing’), vilket kan räcka! Det fina med denna metod är att vi kan vara kreativa. Genom att kombinera Pandas-metoden fillna() med en rad NumPy-metoder såsom mean(), median() och lambda-funktioner kan vi matematiskt fylla i våra saknade värden.
Alternativt finns det även Pandas-metoder som interpolate() som algoritmiskt kan fylla luckor om din data är ordnad (t.ex. tidsbaserad). Målet är att fylla i datan så korrekt som möjligt så att den speglar den verkliga datan.
Att utföra data wrangling i SQL kan vara ett effektivt sätt att bearbeta din data, särskilt om din SQL-databas finns i molnet. Detta begränsar mängden data som bearbetas av din lokala dator och mängden datautflöde/inflöde över nätverk.
Huvudfokus i data wrangling med SQL är att begränsa omfånget på den data som flödar genom våra pipelines genom korrekt dataextrahering, transformering och laddning. Några sätt att hantera detta är att filtrera data, joina mot referenstabeller och utföra aggregeringar.
Det primära sättet att filtrera tabeller i SQL är med WHERE-klausulen. Den är ganska enkel att använda men kan vara oerhört kraftfull. Villkoren kan vara enkla likhetsuttryck, att söka efter liknande strängar eller till och med använda andra subfrågor. Du kan också kombinera flera where-klausuler med AND- och OR-uttryck!
Filtrering baserat på enkla fall, som att leta efter ett visst värde i en kolumn, kan se ut så här:
SELECT *
FROM sample_table
WHERE sample_col = 23
Att använda mer komplexa uttryck som LIKE eller IN kan ge flexibilitet i dina WHERE-klausuler. I följande fråga letar vi till exempel efter personer vars förnamn börjar på J tack vare %-jokertecknet och vars efternamn även finns IN den angivna listan.
SELECT *
FROM sample_table
WHERE name LIKE ‘J%’ /* looks for people whose name starts with J */
AND last_name IN (‘Smith’, ‘Rockefeller’, ‘Williams’) /* Looks for people whose last name is in this list */
Slutligen kan användning av andra subfrågor ge flexibilitet i filtreringen. Den kan baseras på resultat från en annan tabell. Ett vanligt exempel är att hitta en lista över kund-ID efter ett visst datum och klockslag.
SELECT *
FROM sample_table
WHERE customer_id IN (SELECT id FROM reference_table WHERE date >= ‘2024-01-01’)
Genom att kombinera dessa tekniker säkerställer du att dina datainflöden är exakt det du söker och att datamängdernas storlek kan minimeras. En extra kraftfull användning av filter är att ta bort dubbletter i din datamängd och på så sätt städa upp den. Några mer avancerade tekniker att implementera är HAVING-filter för aggregeringar och QUALIFY-uttryck med fönsterfunktioner.
Att utföra table joins gör att vi kan hämta extra information vi kan behöva för våra datamängder. SQL har en rad olika joins såsom INNER, OUTER, LEFT och RIGHT. Med INNER- och OUTER-joins bestämmer vi vilken data som behålls. INNER behåller data endast om det finns en matchning på båda sidor, medan OUTER behåller data som inte matchar beroende på vilken sida vi joinar från (vänster eller höger).
LEFT-join behåller data på vänster sida av joinen och RIGHT-join behåller data på höger sida. Du kombinerar LEFT och RIGHT med INNER och OUTER-joins samt den speciella FULL OUTER JOIN som helt enkelt joinar all data från båda tabellerna.
Ett exempel på join kan vara:
SELECT *
FROM a
LEFT OUTER JOIN
b
WHERE a.id = b.id
Uttalandet ovan har tabell a till vänster eftersom den kommer först och tabell b till höger eftersom den kommer sist. LEFT OUTER JOIN säger: joina data från tabell a och tabell b där a.id = b.id, men om det inte finns någon matchning, behåll all data från tabell a. Joins är kraftfulla verktyg för att ta in extra data som kan vara nödvändig för dina datainflöden.
Ett sista verktyg vi kan använda i SQL för data wrangling är GROUP BY-klausulen för att utföra aggregeringar. Detta förenklar datan och låter oss förbehandla den något innan den skickas vidare i pipelinen. Aggregering är ett kraftfullt verktyg för att beräkna sammanfattande statistik. Här är ett exempel där vi tittar på total försäljning per kund-ID:
SELECT
Customer_ID,
SUM(sales)
FROM sample_table
GROUP BY Customer_ID
Det finns många aggregeringsfunktioner såsom SUM, MEAN, MAX och MIN som gör att vi snabbt och enkelt kan få en förståelse för våra data. Att utnyttja aggregeringar förenklar datainflödet till pipelines.
I det här avsnittet går vi igenom några praktiska exempel och användningsfall för tekniker inom data wrangling. Huvudmålen vi fokuserar på är: standardisering av data, sammanslagning av datakällor och textbearbetning.
Att standardisera data till samma enheter är viktigt. Om du arbetar med data som mäter samma sak i olika enheter eller valutor kan det orsaka problem i analysen.
Vi går igenom ett enkelt exempel på att konvertera olika valutor till USD i SQL. Anta först att vi har två tabeller. Tabell 1 är en sales-tabell som har produktförsäljning för olika regioner och Tabell 2 är currency_exchange-tabellen som innehåller växelkurser för olika regioner för olika dagar. Ett exempel på denna konvertering kan se ut så här:
SELECT
a.sale_id,
a.region,
CASE WHEN region <> ‘US’
	THEN a.sale_price * b.exchange_rate
	ELSE a.sale_price
END AS sale_price
FROM sales AS a
LEFT OUTER JOIN
currency_exchange AS b
WHERE a.region = b.region
Detta tar sale_id och region från tabellen sales och joinar till referenstabellen currency_exchange på region för att få växelkursen. Ofta kan ett datum vara inblandat så att vi kan få växelkursen för den aktuella dagen.
En stor del av data wrangling är att bearbeta data för våra maskininlärningsmodeller. På senare tid har många modeller fokuserat på naturlig språkbehandling, och ett steg på vägen dit är sentimentsanalys av textdata.
Ett kritiskt steg är att förbereda text genom normalisering och borttagning av skiljetecken. Eftersom skiljetecken och versaler kanske inte ger viktig kontext för en maskininlärningsmodell är det ofta bättre att normalisera.
För att göra detta använder vi grundläggande Python-paket och paketet re. Se nedan för ett exempel på att ta bort skiljetecken, normalisera text för att ta bort versaler och trimma tomma utrymmen.
# import regex
import re

# input string
test_string = "       Python 3.0, released in 2008, was a major revision of the language that is not completely backward compatible and much Python 2 code does not run unmodified on Python 3. With Python 2's end-of-life, only Python 3.6.x[30] and later are supported, with older versions still supporting e.g. Windows 7 (and old installers not restricted to 64-bit Windows)."
# remove whitespaces
no_space_string = test_string.strip()

# convert to lower case
lower_string = no_space_string .lower()

# remove numbers
no_number_string = re.sub(r'\d+','',lower_string)
print(no_number_string)
Kodsnutten ovan ger en bra grund för att ta bort blanksteg, konvertera tecken till gemener och ta bort siffror/ickebokstavliga tecken.
Data wrangling är en avgörande del i att förbereda våra data för maskininlärningsmodeller och analys. Det finns en mängd verktyg i Python såsom paketen pandas och numpy samt en rad SQL-metoder såsom WHERE- och GROUP BY-klausuler som gör att vi kan förbereda våra data.
Att bemästra dessa tekniker är avgörande för att en blivande dataprofessionell ska lyckas i yrket. Om du vill fördjupa dig i ämnena kring data wrangling kan du överväga följande resurser:
Top DataCamp Courses
course
course
track