course
Python में डेटा आयात का परिचय
3 घंटा
340.8K
डेटा की मात्रा, विविधता और वेग बढ़ने के साथ, उच्च गुणवत्ता और सुव्यवस्थित डेटासेट बनाना पहले से कहीं अधिक महत्वपूर्ण हो गया है, क्योंकि वे सीधे तौर पर अंतर्दृष्टियों की सटीकता और विभिन्न उद्योगों में निर्णयों की प्रभावशीलता को प्रभावित करते हैं।
खराब ढंग से व्यवस्थित या त्रुटिपूर्ण डेटा गलत निष्कर्षों तक ले जा सकता है, जिससे समय, धन और संसाधनों की लागत आती है। यहीं डेटा रैंगलिंग काम आती है—एक आवश्यक प्रक्रिया जो कच्चे, असंरचित डेटा को विश्लेषण के लिए तैयार, स्वच्छ और सुव्यवस्थित स्वरूप में बदल देती है।
डेटा रैंगलिंग में कई चरण शामिल होते हैं ताकि यह सुनिश्चित किया जा सके कि डेटा सटीक, विश्वसनीय और मौजूदा विश्लेषण की विशिष्ट आवश्यकताओं के अनुरूप हो। डेटा रैंगलिंग में दक्षता हासिल करके, आप अपने डेटा की पूरी क्षमता को उजागर कर सकते हैं, उसे क्रियाशील अंतर्दृष्टियों में बदल सकते हैं जो सूचित निर्णयों को आगे बढ़ाती हैं और अंततः सफलता दिलाती हैं।
डेटा रैंगलिंग कच्चे डेटा को अधिक उपयोगी प्रारूप में बदलने की प्रक्रिया है। इसमें डेटा की सफाई, संरचना और समृद्धि शामिल है ताकि वह विश्लेषण के लिए तैयार हो।
कल्पना कीजिए कि आपको एक विशाल डेटासेट मिला है—यह बिखरा हुआ है, उसमें मिसिंग वैल्यू, असंगतियां और अप्रासंगिक जानकारी है। डेटा रैंगलिंग एक टूलकिट की तरह है जो आपको इस डेटा को व्यवस्थित करने में मदद करता है, यह सुनिश्चित करता है कि यह संगठित और सुसंगत हो।
डेटा रैंगलिंग यह सुनिश्चित करने के लिए महत्वपूर्ण है कि आपका डेटा उच्च गुणवत्ता और अच्छी संरचना वाला हो, जो सटीक डेटा विश्लेषण के लिए अनिवार्य है। स्वच्छ, संरचित डेटा डेटा वर्कफ़्लो के सभी अगले चरणों की नींव के रूप में कार्य करता है—चाहे आप मशीन लर्निंग मॉडल बना रहे हों, विज़ुअलाइज़ेशन बना रहे हों, या सांख्यिकीय विश्लेषण कर रहे हों।
उच्च गुणवत्ता वाला डेटा आपके विश्लेषण में त्रुटियों और पक्षपात के जोखिम को कम करता है, जिससे अधिक विश्वसनीय अंतर्दृष्टियां प्राप्त होती हैं। डेटा रैंगलिंग का महत्व समझना महत्वपूर्ण है, क्योंकि इसका सीधा प्रभाव उन निर्णयों की वैधता पर पड़ता है जो उस डेटा के आधार पर लिए जाते हैं।
खराब तरीके से रैंगल किया गया डेटा त्रुटिपूर्ण निष्कर्षों तक ले जा सकता है, जिनके वास्तविक दुनिया के अनुप्रयोगों में महत्वपूर्ण परिणाम हो सकते हैं। इसलिए, डेटा-चालित निर्णय लेने के प्रति गंभीर किसी भी व्यक्ति के लिए डेटा रैंगलिंग में पारंगत होना आवश्यक है।
डेटा रैंगलिंग के 5 मुख्य चरण होते हैं:
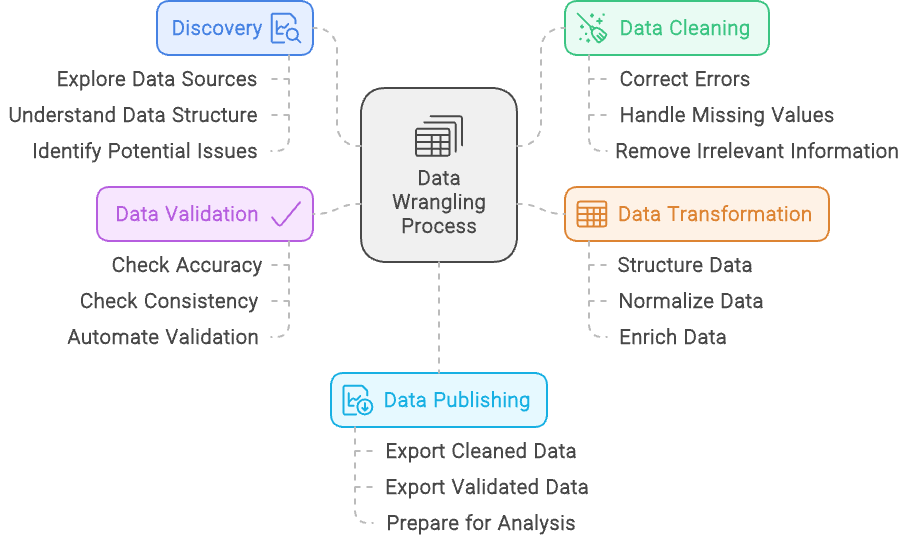
डेटा रैंगलिंग प्रक्रिया - Napkin.ai के साथ बनाई गई
हमने डेटा रैंगलिंग के पाँच चरणों की रूपरेखा दी है, लेकिन अब प्रत्येक को थोड़ी विस्तार से देखते हैं:
डेटा रैंगलिंग में डिस्कवरी चरण वैसा ही है जैसे पहेली को जोड़ना शुरू करने से पहले उस पर पहली नजर डालना। इसमें डेटासेट की जाँच शामिल है ताकि आप यह स्पष्ट रूप से समझ सकें कि आप किस पर काम कर रहे हैं—डेटा के प्रकार, उसके स्रोत और उसकी संरचना सहित।
जैसे आप पहेली के टुकड़ों को रंग या किनारे के आकार से छाँट सकते हैं, वैसे ही डिस्कवरी आपको डेटा में पैटर्न पहचानने और वर्गीकृत करने में मदद करती है, और आगे के काम की नींव रखती है।
लेकिन डिस्कवरी संभावित समस्याओं को पकड़ने के बारे में भी है—जैसे किसी पहेली में गायब टुकड़े या मेल न खाते रंग।
इस चरण के दौरान, आप डेटा में मौजूद किसी भी मुद्दे की पहचान करते हैं, जैसे असंगतियां, मिसिंग वैल्यू, या अप्रत्याशित पैटर्न। इन चुनौतियों को शुरू में ही सामने लाकर, आप अगले रैंगलिंग चरणों में उन्हें दूर करने की योजना बना सकते हैं, और एक स्वच्छ, उपयोगी डेटासेट तक सहज पहुँच सुनिश्चित कर सकते हैं।
डेटा क्लीनिंग आपके डेटासेट को परिष्कृत करने की प्रक्रिया है ताकि वह सटीक और विश्वसनीय हो।
इस प्रक्रिया में त्रुटियों को सुधारना, मिसिंग वैल्यू को संभालना और असंगतियों को ठीक करना जैसे मुद्दों का समाधान शामिल है। उदाहरण के लिए, यदि आपके डेटासेट में एक ही व्यक्ति या लेनदेन के लिए डुप्लिकेट प्रविष्टियाँ हैं, तो परिणामों में विकृति से बचने के लिए डेटा क्लीनिंग के तहत इन डुप्लिकेट्स को हटाया जाएगा।
इसके अलावा, यदि आपको पता चलता है कि कुछ प्रविष्टियाँ गलत फ़ॉर्मैट में हैं—जैसे फ़ोन नंबरों के अलग-अलग फ़ॉर्मैट—तो आप उन्हें एक समान फ़ॉर्मैट में मानकीकृत करेंगे। उद्देश्य डेटा की समग्र गुणवत्ता और अखंडता को बढ़ाना है, ताकि वह सटीक और सार्थक विश्लेषण के लिए तैयार हो।
डेटा ट्रांसफॉर्मेशन आपके डेटासेट को संशोधित और बेहतर करने की प्रक्रिया है ताकि वह आपके विश्लेषण की आवश्यकताओं के साथ बेहतर ढंग से मेल खाए। इस चरण में डेटा को संरचना देना शामिल है—जैसे वांछित फ़ॉर्मैट में ढालना या कई स्रोतों को एक सुसंगत संरचना में जोड़ना।
नॉर्मलाइज़ेशन भी एक प्रमुख पहलू है—यानी मूल्यों को एक सामान्य स्केल या फ़ॉर्मैट में लाना, जैसे सभी मुद्रा मूल्यों को एक ही मुद्रा में बदलना या माप की इकाइयों का मानकीकरण करना।
साथ ही, डेटा ट्रांसफॉर्मेशन में डेटासेट को समृद्ध करना भी शामिल है—नए वेरिएबल जोड़कर या बाहरी डेटा स्रोतों को एकीकृत करके ताकि अधिक संदर्भ या अंतर्दृष्टि मिल सके। उदाहरण के लिए, आप मौजूदा डेटा के आधार पर नए मैट्रिक्स की गणना कर सकते हैं या अधिक संपूर्ण चित्र देने के लिए अन्य डेटाबेस से अतिरिक्त जानकारी जोड़ सकते हैं।
डेटा ट्रांसफॉर्मेशन का उद्देश्य डेटा को इस तरह तैयार करना है कि उसकी उपयोगिता और गहन विश्लेषण के लिए प्रासंगिकता बढ़े।
डेटा वेलिडेशन में व्यवस्थित जाँचों और स्वचालित प्रक्रियाओं के माध्यम से आपके डेटासेट की सटीकता और विश्वसनीयता सुनिश्चित करना शामिल है। यह चरण यह पुष्टि करने के लिए महत्वपूर्ण है कि डेटा सही और सुसंगत दोनों है।
डेटा वेलिडेशन के दौरान, आप विभिन्न जाँचें करते हैं ताकि किसी भी विसंगति की पहचान हो सके—जैसे ज्ञात बेंचमार्क के मुकाबले डेटा की तुलना करना या पूर्वनिर्धारित नियमों और बाधाओं के अनुरूपता की जाँच करना। स्वचालित प्रक्रियाओं में ऐसे स्क्रिप्ट चलाना शामिल हो सकता है जो विसंगतियों या असंगतियों को फ़्लैग करें, और सुनिश्चित करें कि डेटा अपेक्षित फ़ॉर्मैट और रेंज का पालन करता है।
डेटा वेलिडेशन का लक्ष्य यह है कि विश्लेषण में उपयोग से पहले ही समस्याएँ पकड़ ली जाएँ, ताकि त्रुटियाँ परिणामों को प्रभावित न कर सकें। सटीकता और विश्वसनीयता का कठोर सत्यापन करके, आप सुनिश्चित करते हैं कि डेटा से प्राप्त अंतर्दृष्टियाँ भरोसेमंद जानकारी पर आधारित हों।
डेटा पब्लिशिंग डेटा रैंगलिंग प्रक्रिया का अंतिम चरण है, जहाँ स्वच्छ और संरचित डेटा को विश्लेषण और निर्णय लेने के लिए उपलब्ध कराया जाता है। इस चरण में डेटा का प्रसार हेतु तैयारी शामिल है—अक्सर डैशबोर्ड, रिपोर्ट या इंटरेक्टिव विज़ुअलाइज़ेशन बनाकर—ताकि हितधारकों के लिए वह सुलभ और समझने योग्य हो।
डेटा पब्लिशिंग के दौरान, आप ऐसे डेटा पाइपलाइन या इंटरफ़ेस स्थापित कर सकते हैं जो उपयोगकर्ताओं को डेटा को क्वेरी करने और उसके साथ इंटरेक्ट करने दें, और यह सुनिश्चित करें कि वह उनकी आवश्यकताओं के अनुरूप प्रारूप में प्रदान किया जाए।
उद्देश्य डेटा से स्पष्ट, क्रियाशील अंतर्दृष्टियाँ प्रदान करना है, ताकि सूचित निर्णय संभव हो सकें और संगठन भर में निष्कर्षों का संप्रेषण सुगम हो। डेटा को प्रभावी ढंग से प्रकाशित करके, आप सुनिश्चित करते हैं कि डेटा रैंगलिंग की कठिन मेहनत सार्थक और व्यावहारिक परिणामों में बदले।
अक्सर डेटा रैंगलिंग और डेटा क्लीनिंग शब्दों का एक-दूसरे के स्थान पर उपयोग किया जाता है, लेकिन ये डेटा तैयारी प्रक्रिया के अलग-अलग पहलुओं को दर्शाते हैं। दोनों ही विश्लेषण के लिए डेटा तैयार करने में आवश्यक हैं, परन्तु इनके उद्देश्य और कार्य अलग-अलग होते हैं। इनके बीच के अंतर को समझना उनकी भूमिकाएँ स्पष्ट करता है और सुनिश्चित करता है कि डेटा तैयारी के प्रत्येक पहलू को प्रभावी ढंग से संभाला जाए।
डेटा रैंगलिंग एक व्यापक प्रक्रिया है जिसमें कच्चे डेटा को विश्लेषण के अनुकूल प्रारूप में बदलना शामिल है। यह कई चरणों को समाहित करती है—डेटा प्राप्त करना, उसे संरचना देना, साफ़ करना और वेलिडेट करना। डेटा रैंगलिंग का उद्देश्य विविध स्रोतों से डेटा तैयार करना है ताकि उसका प्रभावी ढंग से विश्लेषण किया जा सके और अंतर्दृष्टियाँ प्राप्त की जा सकें। यह प्रक्रिया सुनिश्चित करती है कि डेटा संगठित, सटीक और विस्तृत विश्लेषण के लिए तैयार हो।
डेटा क्लीनिंग, दूसरी ओर, डेटा रैंगलिंग का एक विशिष्ट उपसमुच्चय है। यह केवल त्रुटियों और असंगतियों को संबोधित करके डेटा की गुणवत्ता सुधारने पर केंद्रित है। इसमें डुप्लिकेट रिकॉर्ड हटाना, टाइपो सुधारना, मिसिंग वैल्यू संभालना, और डेटा फ़ॉर्मैट का मानकीकरण करना जैसे कार्य शामिल हैं। जबकि डेटा क्लीनिंग डेटा रैंगलिंग का एक महत्वपूर्ण हिस्सा है, यह व्यापक प्रक्रिया का केवल एक चरण है।
संक्षेप में, डेटा रैंगलिंग विश्लेषण के लिए डेटा तैयार करने का समग्र ढाँचा है, जिसमें डेटा तैयारी के विभिन्न पहलुओं को संभालने के लिए कई चरण शामिल होते हैं। डेटा क्लीनिंग इस ढाँचे का अभिन्न घटक है, जो विशेष रूप से डेटा की सटीकता और सुसंगतता बढ़ाने के लिए समर्पित है।
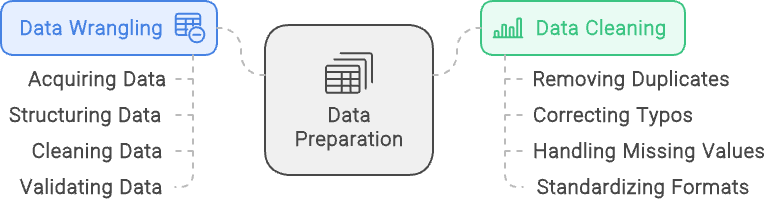
डेटा रैंगलिंग बनाम डेटा क्लीनिंग: डेटा रैंगलिंग का फोकस डेटा को संरचना देने और वेलिडेट करने पर है, जबकि डेटा क्लीनिंग का फोकस स्वच्छ और गुणवत्ता वाला डेटा उपलब्ध कराना है। चित्र napkin.ai से बनाया गया
डेटा रैंगलिंग के कई तरीके हैं—बुनियादी GUI-आधारित टूल्स जैसे Excel या Alteryx से लेकर R और Python जैसी भाषाओं में कोडिंग तक। यहाँ हम कुछ विकल्पों का अन्वेषण करेंगे।
सरल डेटा रैंगलिंग कार्यों के लिए, Microsoft Excel और Google Sheets जैसे स्प्रेडशीट्स अक्सर पसंदीदा विकल्प होते हैं। ये टूल्स अत्यधिक सुलभ हैं और परिचित इंटरफ़ेस प्रदान करते हैं, जो सॉर्टिंग, फ़िल्टरिंग और बुनियादी डेटा क्लीनिंग जैसे कार्यों के लिए आदर्श हैं। स्प्रेडशीट्स विशेष रूप से छोटे डेटासेट या डेटा रैंगलिंग सीखना शुरू करने वालों के लिए उपयोगी हैं।
इनमें निर्मित फ़ंक्शंस और फ़ॉर्मूलों के साथ, उपयोगकर्ता व्यापक तकनीकी ज्ञान के बिना ही तेजी से गणनाएँ कर सकते हैं और डेटा में हेरफेर कर सकते हैं।
जटिल डेटा मैनिपुलेशन और ऑटोमेशन के लिए Python और R जैसी प्रोग्रामिंग भाषाओं का व्यापक रूप से उपयोग होता है। Python अपनी शक्तिशाली लाइब्रेरीज़—Pandas, NumPy और OpenRefine—के साथ बड़े डेटासेट संभालने और जटिल डेटा ट्रांसफॉर्मेशन करने में बेहतरीन है।
R, dplyr और tidyr जैसे पैकेजों के साथ, एक और मजबूत विकल्प है—विशेष रूप से सांख्यिकीय और शैक्षणिक समुदायों में अपने मज़बूत डेटा विश्लेषण क्षमताओं के लिए लोकप्रिय। दोनों भाषाएँ उच्च स्तर की लचीलापन देती हैं, जिससे उपयोगकर्ता कस्टम वर्कफ़्लो स्क्रिप्ट कर सकते हैं और दोहराए जाने वाले कार्यों को स्वचालित कर सकते हैं—उन्नत रैंगलिंग आवश्यकताओं पर काम करने वाले डेटा पेशेवरों के लिए आदर्श।
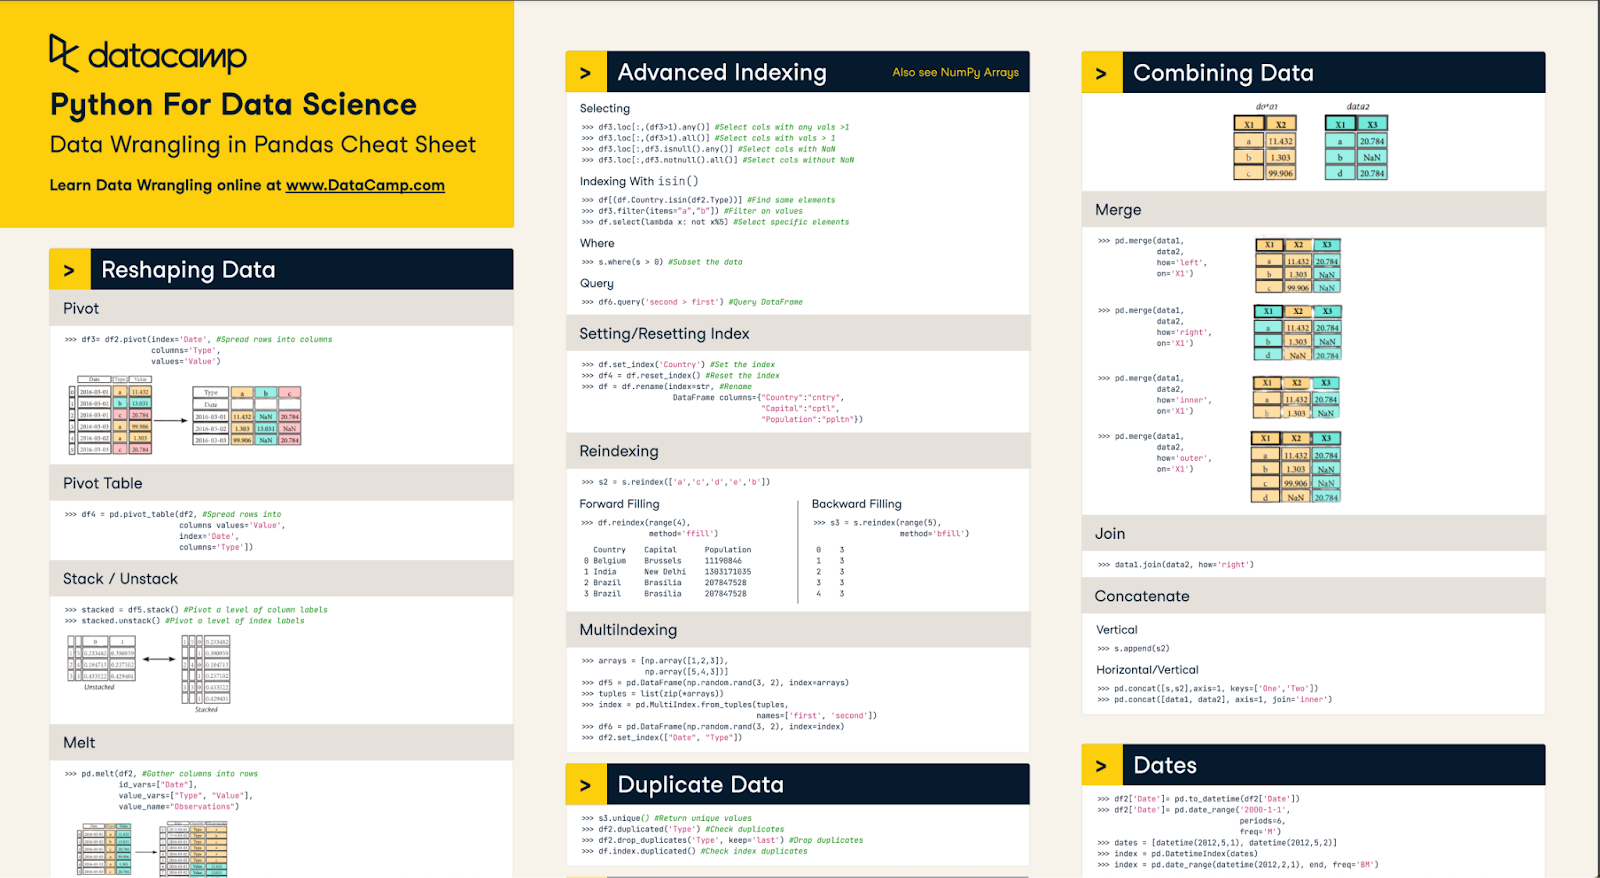
हमारी Pandas में डेटा रैंगलिंग चीट शीट आपको कई बुनियादी बातों में महारत हासिल करने में मदद कर सकती है
समर्पित सॉफ़्टवेयर टूल्स विशेष रूप से डेटा रैंगलिंग प्रक्रिया को सुगम बनाने के लिए डिज़ाइन किए गए हैं, जो जटिल डेटा कार्यों को सरल करने वाली उन्नत सुविधाएँ प्रदान करते हैं। ये टूल्स उन उपयोगकर्ताओं के लिए आदर्श हैं जिन्हें व्यापक कोडिंग के बिना डेटा की सफाई, संरचना और विश्लेषण के लिए तैयारी हेतु शक्तिशाली, फिर भी सुलभ समाधान चाहिए।
Alteryx इस श्रेणी का एक अग्रणी टूल है, जो अपने सहज ड्रैग-एंड-ड्रॉप इंटरफ़ेस के लिए जाना जाता है, जिससे उपयोगकर्ता कई स्रोतों से डेटा को आसानी से शुद्ध, मिश्रित और ट्रांसफ़ॉर्म कर सकते हैं। यह डेटा मैनिपुलेशन के लिए कई बिल्ट-इन टूल्स के साथ आता है, जिससे फ़िल्टरिंग, जॉइनिंग और एग्रीगेशन जैसे कार्य सीधे-सपाट हो जाते हैं।
क्लाउड-आधारित Alteryx Designer Cloud इन क्षमताओं को और बढ़ाता है—डेटा रैंगलिंग के लिए एक स्केलेबल, सहयोगात्मक प्लेटफ़ॉर्म प्रदान करके। यह समाधान टीमों को रियल-टाइम में साथ काम करने देता है, और विभिन्न वातावरणों में बड़े डेटासेट और जटिल वर्कफ़्लोज़ को कुशलतापूर्वक संभालता है। ऑन-प्रेम या क्लाउड—कहीं भी उपयोग हो—Alteryx सुनिश्चित करता है कि डेटा सटीक रूप से तैयार हो और अंतर्दृष्टिपूर्ण विश्लेषण के लिए तैयार हो।
एंड-टू-एंड समाधानों की आवश्यकता वाले व्यापक डेटा प्रोजेक्ट्स के लिए, KNIME, Apache NiFi और Microsoft Power BI जैसे इंटीग्रेटेड प्लेटफ़ॉर्म अक्सर उपयोग किए जाते हैं। ये प्लेटफ़ॉर्म न केवल डेटा रैंगलिंग का समर्थन करते हैं, बल्कि एक ही वातावरण में डेटा इंटीग्रेशन, विश्लेषण और विज़ुअलाइज़ेशन के लिए टूल्स भी प्रदान करते हैं।
उदाहरण के लिए, KNIME अपने मॉड्यूलर, नोड-आधारित इंटरफ़ेस के लिए जाना जाता है जो उपयोगकर्ताओं को विज़ुअली जटिल वर्कफ़्लो बनाने देता है। Apache NiFi सिस्टमों के बीच डेटा फ्लो को प्रबंधित और स्वचालित करने में उत्कृष्ट है, जबकि Power BI डेटा तैयारी को शक्तिशाली विज़ुअलाइज़ेशन क्षमताओं के साथ जोड़ता है। ये प्लेटफ़ॉर्म उन प्रोजेक्ट्स के लिए आदर्श हैं जहाँ डेटा को बिना रुकावट तैयार, विश्लेषित और साझा करना होता है—डेटा-चालित निर्णय लेने के लिए समग्र दृष्टिकोण प्रदान करते हैं।
जब Python के साथ डेटा रैंगलिंग की बात आती है, तो कई विकल्प मौजूद हैं। दो मुख्य पैकेज जिनका उपयोग होता है, वे हैं Pandas और NumPy। ये दोनों पैकेज शक्तिशाली टूल्स प्रदान करते हैं जिनसे उपयोगकर्ता अपने डेटासेट्स पर प्रमुख रैंगलिंग तकनीकें आसानी से लागू कर सकते हैं।
बहुत सा डेटा प्रोसेसिंग Python में होता है, इसलिए इन पैकेजों में महारत किसी भी डेटा प्रोफेशनल के लिए आवश्यक होगी। अनेक तकनीकें हैं, पर कुछ प्रमुख बातें हैं—हाई-लेवल डेटा क्लीनिंग करना (जैसे nulls ड्रॉप करना), डेटासेट्स को मर्ज करना, और मिसिंग वैल्यू को संभालना।
कई मौकों पर डेटा को उपयोग से पहले Python में साफ़ करना पड़ता है। इसमें स्ट्रिंग्स से trailing whitespaces हटाना, null वैल्यू ड्रॉप करना, या डेटा टाइप्स सुधारना जैसी चीजें शामिल हो सकती हैं।
हर डेटासेट अलग होता है और उसकी अपनी ज़रूरतें होती हैं, इसलिए यह समझने के लिए अपने डेटासेट का अन्वेषण करें कि क्या अतिरिक्त सफाई आवश्यक है। विभिन्न तकनीकों और कोडिंग कौशलों का अभ्यास करना यह सीखने का एक अच्छा तरीका है कि हम किन-किन तरीकों से Python में डेटा साफ़ कर सकते हैं।
स्ट्रिंग्स की सफाई में एक आम समस्या trailing/leading whitespace है। यह लंबाई, स्थान या मिलान के आधार पर स्ट्रिंग्स पार्स करते समय समस्याएँ पैदा कर सकता है। इसे संभालने का सबसे अच्छा तरीका है कि किसी Series पर str.strip() मेथड का उपयोग करें।
# Example utilizes a pandas series
# If working with a dataframe, call the series using df[col] syntax
s = pd.Series(['1. Ant.  ', '2. Bee!\n', '3. Cat?\t', np.nan, 10, True])
# It is important to include the .str or else the method will not work
s.str.strip()
Pandas में null वैल्यू ड्रॉप करना आसान है। हम इस लेख में आगे null वैल्यू भरने पर चर्चा करेंगे। आप सरलता से dropna() मेथड का उपयोग कर सकते हैं। इस मेथड में वैकल्पिक पैरामीटर हैं जो आपको वह सटीक शर्तें चुनने देते हैं जिन पर कोई पंक्ति/स्तंभ ड्रॉप किया जाएगा, लेकिन डिफ़ॉल्ट व्यवहार है कि किसी भी null वैल्यू वाली पंक्ति को ड्रॉप करना।
# For any dataframe
df = pd.DataFrame({"name": ['Alfred', 'Batman', 'Catwoman'],
                   "toy": [np.nan, 'Batmobile', 'Bullwhip'],
                   "born": [pd.NaT, pd.Timestamp("1940-04-25"), pd.NaT]}
df.dropna()
.astype() मेथड उपयोगकर्ताओं को किसी Series का डेटा टाइप बदलने देता है, पर डेटा टाइप्स को सुधारना थोड़ा पेचीदा है क्योंकि आपको सुनिश्चित करना होता है कि आपकी Pandas Series में हर वैल्यू उस डेटा टाइप से मेल खाती हो।
उदाहरण के लिए, किसी object टाइप Series को integer में बदलना तभी संभव है जब आपको पता हो कि हर वैल्यू integer है। यदि एक भी वैल्यू integer नहीं है, तो मेथड एरर दे देगा। आप invalid वैल्यू को null करके coerce कर सकते हैं, लेकिन यह समझना अधिक उपयोगी हो सकता है कि कुछ वैल्यू कन्वर्ट क्यों नहीं हो रहीं।
Pandas में DataFrames को मर्ज करना SQL में join करने जैसा है। Pandas merge() का डिफ़ॉल्ट व्यवहार inner join करना है। हालाँकि, यह nulls पर भी join करेगा, इसलिए सावधानी रखें। मर्ज करने के लिए एक विशेष key की आवश्यकता होती है। आप कई कॉलम्स या यहाँ तक कि index पर भी join कर सकते हैं।
# Create two dataframes
df1 = pd.DataFrame({'lkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [1, 2, 3, 5]})
df2 = pd.DataFrame({'rkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [5, 6, 7, 8]})
# merge the df1 DataFrame to the df2 DataFrame using the columns key and rkey as keys
df1.merge(df2, left_on='lkey', right_on='rkey')
उपरोक्त कोड दोनों DataFrames को उनकी क्रमशः lkey और rkey कॉलम्स में मिलते-जुलते keys के आधार पर मर्ज करेगा। न मिलने वाले मान ड्रॉप हो जाएँगे और आपके पास केवल मिलान वाले मान रहेंगे। हालाँकि, आप मर्ज का व्यवहार बदलकर left/right/outer मर्ज भी चुन सकते हैं। यह विभिन्न स्रोतों से आए अलग-अलग डेटासेट्स को साथ लाने के लिए डेटा वैज्ञानिकों को एक शक्तिशाली साधन देता है।
मिसिंग वैल्यू के मामले में, सटीक कार्यप्रणाली बिज़नेस केस पर निर्भर कर सकती है। हमें यह समझना चाहिए कि वैल्यू गायब क्यों है। यदि तकनीकी त्रुटियों के कारण वैल्यू गायब है, तो शायद हमें पहले तकनीकी त्रुटि को ठीक करने पर ध्यान देना चाहिए और देखना चाहिए कि क्या हम ऐतिहासिक डेटा पुनर्प्राप्त कर सकते हैं।
कभी-कभी हम बाकी डेटा का उपयोग कर सकते हैं और बस मिसिंग वैल्यू को अनदेखा कर सकते हैं। यदि ऐतिहासिक डेटा महत्वपूर्ण है और पुनर्प्राप्त नहीं हो सकता, तो हमें मिसिंग डेटा भरना होगा। आइए देखें कि मिसिंग जानकारी कैसे भरी जा सकती है।
डेटा भरने की मुख्य विधि Pandas का fillna() मेथड है। स्ट्रिंग वैल्यू के लिए, उदाहरण के तौर पर df.fillna(value=’missing’) का उपयोग करके nulls भरे जा सकते हैं—जो पर्याप्त हो सकता है! इस मेथड की खूबी है रचनात्मकता—Pandas के fillna() को NumPy के mean(), median() और lambda फ़ंक्शंस जैसी विभिन्न विधियों के साथ जोड़कर हम अपने मिसिंग वैल्यू गणितीय रूप से भर सकते हैं।
वैकल्पिक रूप से, Pandas का interpolate() जैसा मेथड भी मौजूद है, जो क्रमबद्ध (जैसे समय-आधारित) डेटा में अंतरालों को एल्गोरिथमिक रूप से भर सकता है। लक्ष्य है डेटा को यथासंभव सटीकता से भरना, ताकि वह वास्तविक डेटा को प्रतिबिंबित करे।
SQL में डेटा रैंगलिंग करना आपके डेटा को प्रोसेस करने का एक प्रभावी तरीका हो सकता है—खासकर यदि आपका SQL डेटाबेस क्लाउड पर है। इससे आपकी लोकल मशीन द्वारा प्रोसेस किए जाने वाले डेटा और नेटवर्क पर डेटा egress/ingress की मात्रा सीमित रहती है।
SQL में डेटा रैंगलिंग का मुख्य फोकस सही डेटा एक्सट्रैक्शन, ट्रांसफॉर्मेशन और लोडिंग के माध्यम से हमारी पाइपलाइनों से गुजरने वाले डेटा के दायरे को सीमित करना है। इसे प्रबंधित करने के कुछ तरीके हैं—डेटा फ़िल्टर करना, रेफरेंस टेबल्स से जॉइन करना, और एग्रीगेशन करना।
SQL में टेबल्स को फ़िल्टर करने का प्राथमिक तरीका WHERE क्लॉज़ का उपयोग है। इसका उपयोग सरल है, लेकिन यह अत्यंत शक्तिशाली हो सकता है। शर्तें सरल समानता कथन हो सकती हैं, मिलते-जुलते स्ट्रिंग्स ढूँढना हो सकता है, या अन्य सबक्वेरीज़ का उपयोग करना भी हो सकता है। आप कई where क्लॉज़ को AND और OR स्टेटमेंट्स के साथ जोड़ भी सकते हैं!
सरल मामलों के आधार पर फ़िल्टरिंग—जैसे किसी कॉलम में किसी विशेष मान को खोजना—कुछ इस तरह दिख सकती है:
SELECT *
FROM sample_table
WHERE sample_col = 23
LIKE या IN जैसी जटिल स्टेटमेंट्स का उपयोग आपके WHERE क्लॉज़ को लचीलापन दे सकता है। उदाहरण के लिए, निम्न क्वेरी % वाइल्डकार्ड के चलते उन लोगों को ढूँढती है जिनका नाम J से शुरू होता है और जिनका last_name दिए गए सूची में IN है।
SELECT *
FROM sample_table
WHERE name LIKE ‘J%’ /* looks for people whose name starts with J */
AND last_name IN (‘Smith’, ‘Rockefeller’, ‘Williams’) /* Looks for people whose last name is in this list */
अंततः, सबक्वेरीज़ का उपयोग करना आपके फ़िल्टरिंग को काफी लचीला बना सकता है। यह किसी अन्य टेबल के परिणामों पर आधारित हो सकता है। एक आम उदाहरण है—किसी विशेष datetime के बाद के customer IDs की सूची खोजना।
SELECT *
FROM sample_table
WHERE customer_id IN (SELECT id FROM reference_table WHERE date >= ‘2024-01-01’)
इन तकनीकों के संयोजन का उपयोग करके आप सुनिश्चित करते हैं कि आपके डेटा इनपुट वही हों जिनकी आपको तलाश है और डेटासेट का आकार न्यूनतम रहे। फ़िल्टर्स का एक अतिरिक्त शक्तिशाली उपयोग आपके डेटासेट में डुप्लिकेट्स हटाना और इस तरह उसे साफ़ करना है। कुछ उन्नत तकनीकें हैं—एग्रीगेशंस के लिए HAVING फ़िल्टर्स और विंडो फ़ंक्शंस के साथ QUALIFY स्टेटमेंट्स।
टेबल जॉइन्स करने से हम अपने डेटासेट्स के लिए आवश्यक अतिरिक्त जानकारी एकत्र कर पाते हैं। SQL में कई प्रकार के joins होते हैं, जैसे INNER, OUTER, LEFT और RIGHT। INNER और OUTER joins के साथ, हम तय करते हैं कि कौन-सा डेटा रखा जाए। INNER join केवल तभी डेटा रखता है जब दोनों ओर मिलान हो, जबकि OUTER join उस डेटा को भी रखता है जिसका मिलान नहीं हुआ—यह इस पर निर्भर करता है कि हम किस ओर से (left या right) जॉइन कर रहे हैं।
LEFT join बाएँ ओर के डेटा को रखता है और RIGHT join दाएँ ओर के डेटा को। आप LEFT और RIGHT joins को INNER और OUTER joins के साथ जोड़ सकते हैं, साथ ही विशेष FULL OUTER JOIN भी है जो दोनों टेबल्स का सारा डेटा जोड़ता है।
एक उदाहरण join इस प्रकार हो सकता है:
SELECT *
FROM a
LEFT OUTER JOIN
b
WHERE a.id = b.id
उपरोक्त स्टेटमेंट में टेबल a बाईं ओर है क्योंकि वह पहले है और टेबल b दाईं ओर है क्योंकि वह दूसरी है। LEFT OUTER JOIN कहता है—टेबल a और b का डेटा a.id = b.id पर जॉइन करो, लेकिन यदि मिलान न हो तो भी टेबल a का सारा डेटा रखो। जॉइन्स आपके डेटा इनपुट के लिए आवश्यक अतिरिक्त डेटा लाने का एक शक्तिशाली साधन हैं।
SQL में डेटा रैंगलिंग के लिए हम एक अंतिम टूल GROUP BY क्लॉज़ का उपयोग एग्रीगेशन के लिए कर सकते हैं। यह डेटा को सरल बनाता है और पाइपलाइन में आगे भेजने से पहले कुछ हद तक प्री-प्रोसेस करने देता है। एग्रीगेशन सार-सांख्यिकी निकालने का एक शक्तिशाली साधन है। यहाँ एक उदाहरण है जहाँ हम customer ID द्वारा कुल बिक्री देखते हैं:
SELECT
Customer_ID,
SUM(sales)
FROM sample_table
GROUP BY Customer_ID
अनेक एग्रीगेशन फ़ंक्शंस होते हैं—SUM, MEAN, MAX, MIN—जो हमें अपने डेटा की त्वरित और आसान समझ देते हैं। एग्रीगेशन का लाभ उठाना पाइपलाइनों में डेटा इनजेस्ट को सरल करता है।
इस अनुभाग में हम डेटा रैंगलिंग तकनीकों के कुछ व्यावहारिक उदाहरणों और उपयोग मामलों को कवर करेंगे। मुख्य लक्ष्य होंगे: डेटा का मानकीकरण, डेटा स्रोतों का मर्ज, और टेक्स्ट प्रोसेसिंग।
एक ही इकाइयों में डेटा का मानकीकरण महत्वपूर्ण है। यदि एक ही चीज़ को अलग-अलग इकाइयों या अलग-अलग मुद्राओं में मापा जा रहा है, तो यह विश्लेषण में समस्याएँ पैदा कर सकता है।
हम SQL में अलग-अलग मुद्राओं को USD में बदलने का एक सरल उदाहरण देखेंगे। मान लीजिए हमारे पास दो टेबल हैं। टेबल 1 एक sales टेबल है जिसमें विभिन्न क्षेत्रों की उत्पाद बिक्री है और टेबल 2 currency_exchange टेबल है जिसमें अलग-अलग दिनों के लिए विभिन्न क्षेत्रों की विनिमय दरें हैं। इस रूपांतरण का उदाहरण कुछ इस तरह दिख सकता है:
SELECT
a.sale_id,
a.region,
CASE WHEN region <> ‘US’
	THEN a.sale_price * b.exchange_rate
	ELSE a.sale_price
END AS sale_price
FROM sales AS a
LEFT OUTER JOIN
currency_exchange AS b
WHERE a.region = b.region
यह sales टेबल से sale_id और region लेता है और region पर रेफरेंस currency_exchange टेबल से जॉइन करता है ताकि हम विनिमय दर प्राप्त कर सकें। अक्सर, इसमें दिनांक भी शामिल होगा ताकि हम उसी दिन की मुद्रा विनिमय दर ले सकें।
डेटा रैंगलिंग का एक बड़ा हिस्सा हमारे मशीन लर्निंग मॉडलों के लिए डेटा तैयार करना है। हाल के समय में कई मॉडल प्राकृतिक भाषा प्रसंस्करण पर केंद्रित रहे हैं, और उसका एक पूर्ववर्ती चरण है—टेक्स्ट डेटा के माध्यम से सेंटिमेंट विश्लेषण।
इसका एक महत्वपूर्ण चरण है टेक्स्ट की तैयारी—नॉर्मलाइज़ेशन और विराम चिह्नों को हटाना। चूँकि विराम चिह्न और कैपिटलाइज़ेशन अक्सर किसी ML मॉडल के लिए महत्वपूर्ण संदर्भ प्रदान नहीं करते, इसलिए सामान्यतः नॉर्मलाइज़ करना बेहतर होता है।
इसके लिए हम बुनियादी Python पैकेजों और re पैकेज का उपयोग करेंगे। नीचे उदाहरण देखें—विराम चिह्न हटाना, टेक्स्ट को लोअरकेस में नॉर्मलाइज़ करना, और खाली स्पेस ट्रिम करना।
# import regex
import re

# input string
test_string = "       Python 3.0, released in 2008, was a major revision of the language that is not completely backward compatible and much Python 2 code does not run unmodified on Python 3. With Python 2's end-of-life, only Python 3.6.x[30] and later are supported, with older versions still supporting e.g. Windows 7 (and old installers not restricted to 64-bit Windows)."
# remove whitespaces
no_space_string = test_string.strip()

# convert to lower case
lower_string = no_space_string .lower()

# remove numbers
no_number_string = re.sub(r'\d+','',lower_string)
print(no_number_string)
उपरोक्त कोड स्निपेट whitespace हटाने, सभी अक्षरों को लोअरकेस में बदलने, और अंकों/गैर-वर्णमाला डेटा को हटाने की एक मजबूत नींव देता है।
डेटा रैंगलिंग हमारे डेटा को मशीन लर्निंग मॉडलों और विश्लेषण के लिए तैयार करने का एक महत्वपूर्ण घटक है। Python में pandas और numpy जैसे अनेक टूल्स, तथा SQL में WHERE और GROUP BY जैसे क्लॉज़ हमें अपना डेटा तैयार करने में सक्षम बनाते हैं।
इन तकनीकों में महारत हासिल करना किसी भी उदीयमान डेटा प्रोफेशनल के लिए सफलता का मूल है। यदि आप डेटा रैंगलिंग के विषयों में और गहराई से जाना चाहते हैं, तो निम्न संसाधनों पर विचार करें:
शीर्ष DataCamp कोर्स
course
course
Track