Courses
Python でのデータインポート入門
3時間
340.8K
データの量・種類・速度が増す中で、品質が高く構造化されたデータセットを構築することはこれまで以上に重要になっています。これは、業界を問わず、インサイトの精度や意思決定の有効性に直結するためです。
不適切に整理されたり欠陥のあるデータは、誤った結論を招き、時間・コスト・リソースの損失につながります。ここで重要な役割を果たすのがデータラングリングです。これは、生の非構造化データを、分析に適したクリーンで整理された形式へと変換するための不可欠なプロセスです。
データラングリングは、分析の目的に合うよう、データを正確で信頼できる状態に整える一連の手順から成ります。データラングリングを習得すれば、データの可能性を最大限に引き出し、意思決定を支える実用的なインサイトへと転換し、最終的な成功につなげられます。
データラングリングとは、生データをより使いやすい形式へと変換するプロセスです。具体的には、データのクリーニング、構造化、エンリッチメントを行い、分析に備えます。
巨大なデータセットを受け取ったと想像してください。欠損値や不整合、不要な情報が混在していて散らかっています。データラングリングは、こうしたデータを整理し、一貫性を持たせるためのツールキットのようなものです。
データラングリングは、データの品質を高め、適切に構造化するうえで重要であり、正確なデータ分析には不可欠です。クリーンで構造化されたデータは、機械学習モデルの構築、可視化の作成、統計分析の実施など、データワークフローのその後の全ステップの土台となります。
高品質なデータは、分析におけるエラーやバイアスのリスクを低減し、より信頼できるインサイトをもたらします。データラングリングの重要性を理解することは不可欠であり、それはデータに基づく意思決定の妥当性に直接影響します。
不十分にラングリングされたデータは誤った結論につながり、実世界の応用で重大な結果を招く可能性があります。したがって、データに基づく意思決定を本気で目指すなら、データラングリングの習得は不可欠です。
データラングリングには主に5つのステップがあります。
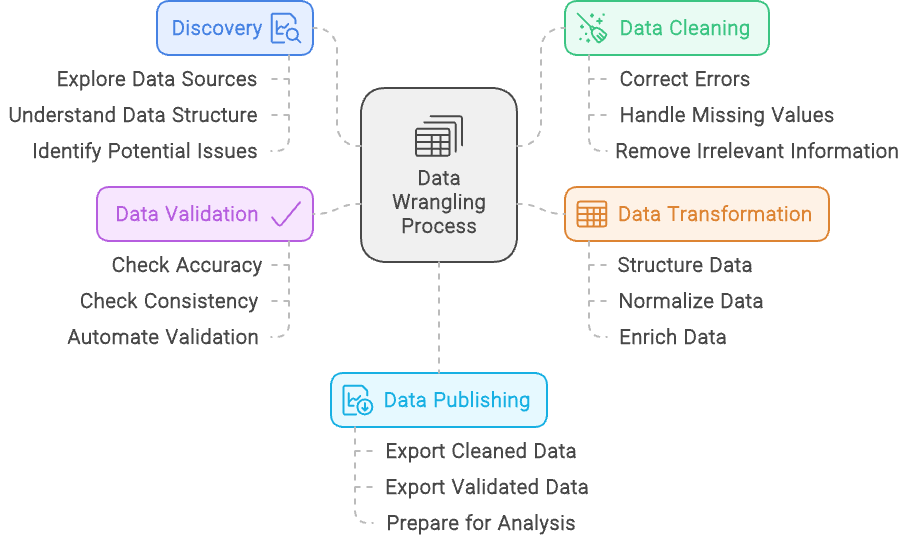
データラングリングのプロセス - Napkin.ai で作成
データラングリングの5つのステップを概観しましたが、ここでは各ステップをもう少し詳しく見ていきます。
データラングリングにおける探索ステップは、パズルを組み始める前に全体を見渡すことに似ています。データの種類、出所、構造など、扱う対象を把握するためにデータセットを検討します。
パズルのピースを色や形で仕分けするように、探索によってデータを分類し、パターンを見極め、後続の作業の基盤を整えます。
同時に、探索は潜在的な問題を見つける段階でもあります。パズルでいえば、ピースの不足や色の不一致の発見にあたります。
このステップでは、不整合、欠損値、想定外のパターンなどの問題を特定します。初期段階で課題を洗い出すことで、後続のラングリング工程での対処計画を立てやすくなり、クリーンで使えるデータセットへの道のりがスムーズになります。
データクリーニングは、データセットを精査し、正確かつ信頼できる状態に整える工程です。
たとえば、同一人物や同一取引の重複レコードが含まれている場合は、結果を歪めないよう重複を削除します。また、電話番号の書式がバラバラといった不統一があるなら、共通の形式に標準化します。目的は、データの品質と整合性を高め、正確で有意義な分析に備えることです。
データ変換は、分析要件に合わせてデータセットを修正・強化するプロセスです。所望の形式に合わせた形状変更や、複数ソースの統合など、データの構造化を行います。
正規化も重要な要素で、すべての通貨を単一通貨に換算したり、計測単位を標準化したりと、値を共通の尺度・形式に揃えます。
さらに、既存データから新しい指標を算出したり、外部データを取り込んで文脈や洞察を補うなど、データセットのエンリッチメントも含まれます。
データ変換の狙いは、詳細な分析にとって使いやすく、関連性の高い形にデータを整えることです。
データ検証は、体系的なチェックや自動化プロセスを通じて、データセットの正確性と信頼性を確かめる工程です。データが正しく一貫していることを確認するうえで、極めて重要です。
既知のベンチマークと照合したり、あらかじめ定義したルールや制約で検証したりして不一致を洗い出します。自動化では、形式や値域の逸脱を検知するスクリプトで異常値や不整合をフラグ付けすることもあります。
分析に用いる前に問題を捕捉し、結果への影響を防ぐことがデータ検証の目的です。精緻な検証により、得られるインサイトが信頼できる情報に基づくことを保証します。
データ公開はデータラングリングの最終段階で、クリーンかつ構造化されたデータを、分析や意思決定に活用できるよう提供します。ダッシュボード、レポート、インタラクティブな可視化の作成など、関係者にとってアクセスしやすく理解しやすい形に整備します。
また、ユーザーがニーズに合った形式でデータにクエリや操作ができるよう、データパイプラインやインターフェースを用意することもあります。
目的は、明確で実行可能なインサイトを提供し、意思決定を支援するとともに、組織内での知見共有を促進することです。適切に公開することで、ラングリングの労力が実践的で意味のある成果へと結実します。
「データラングリング」と「データクリーニング」はしばしば同義で使われますが、データ準備プロセスの異なる側面を指します。どちらも分析の前段階として不可欠ですが、目的と作業内容は異なります。両者の違いを理解することで、それぞれの役割が明確になり、適切に対処できます。
データラングリングは、生データを分析可能な形式へと変換する包括的なプロセスです。データの取得、構造化、クリーニング、検証といった複数の段階を含みます。多様なソースからのデータを、インサイト創出に資する形で分析可能に整えることが目的です。これにより、データは整理され、正確で、詳細分析の準備が整います。
データクリーニングは、その中の特定のサブセットです。エラーや不整合の是正に専念し、データ品質の向上に焦点を当てます。重複レコードの削除、タイプミスの修正、欠損値の処理、データ形式の標準化などが含まれます。クリーニングはラングリングにおける重要工程ですが、全体の一ステップに過ぎません。
要するに、データラングリングは複数の側面を扱う全体枠組みであり、分析に向けてデータを整えます。データクリーニングはその中核要素で、データの正確さと一貫性の向上に特化しています。
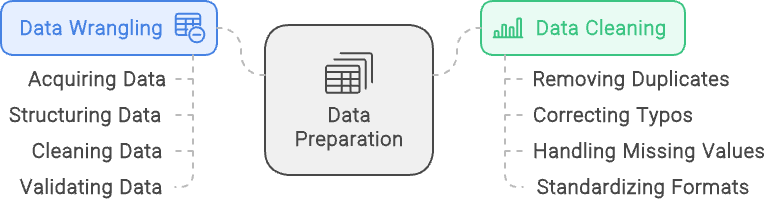
データラングリング vs データクリーニング:データラングリングはデータの構造化と検証に重点を置き、データクリーニングはクリーンで質の高いデータの確保に重点を置きます。画像は napkin.ai で作成
データラングリングの方法はさまざまで、Excel や Alteryx のようなGUIベースの基本ツールから、R や Python といった言語を用いたコーディングまであります。ここではいくつかの選択肢を紹介します。
単純なラングリング作業には、Microsoft Excelや Google スプレッドシートなどのスプレッドシートが定番です。これらはアクセスしやすく、馴染みのあるインターフェースを備えており、並べ替え、フィルタリング、基本的なクリーニングに最適です。特に小規模データセットや、ラングリングを学び始めたばかりの方に有用です。
組み込みの関数や数式により、高度な技術知識がなくても迅速に計算やデータ操作ができます。
より複雑なデータ操作や自動化には、Python や R が広く使われます。Python は Pandas、NumPy、OpenRefine といった強力なライブラリにより、大規模データや高度な変換に適しています。
Rは dplyr や tidyrといったパッケージを備え、統計・アカデミアで特に支持されています。両言語とも柔軟性が高く、カスタムワークフローのスクリプト化や定型作業の自動化が可能で、高度なニーズに適しています。
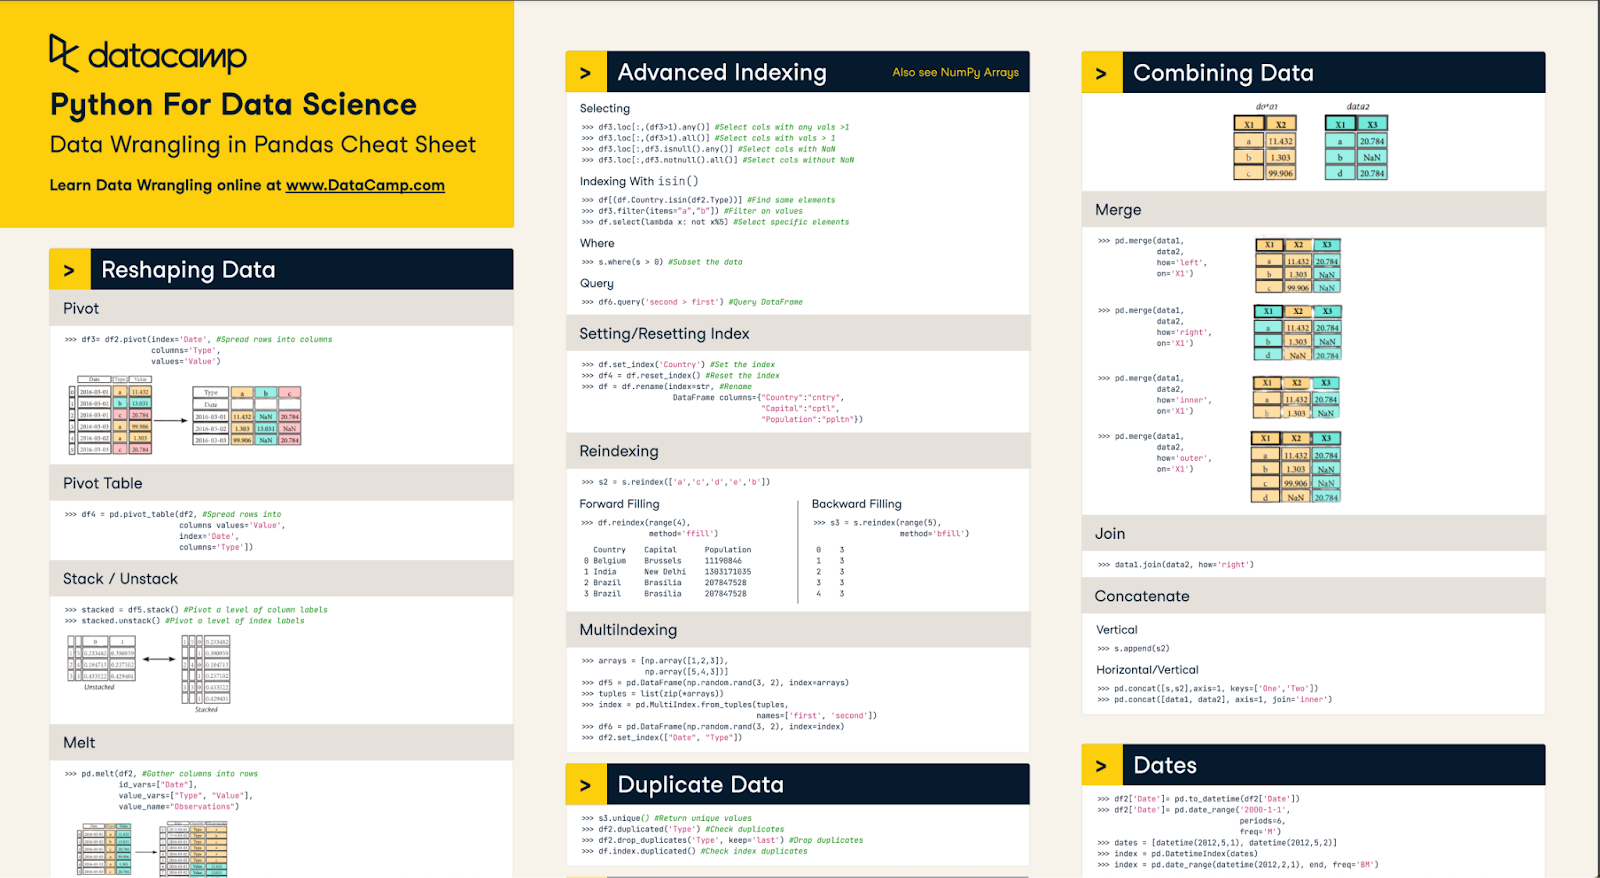
当社のPandas によるデータラングリング チートシートは、基本の習得に役立ちます
専用のソフトウェアツールは、複雑なデータ作業を簡素化する高度な機能を備え、ラングリングを効率化するために設計されています。コーディングの知識が少なくても、データのクレンジング、構造化、準備を強力かつ扱いやすく行いたいユーザーに最適です。
Alteryx はこの分野を代表するツールで、直感的なドラッグ&ドロップ操作により、複数ソースからのデータのクレンジング、ブレンド、変換を容易に行えます。フィルタリング、結合、集計などに使える豊富な組み込みツールを備えています。
クラウド版のAlteryx Designer Cloudは、スケーラブルでコラボレーション可能なラングリング基盤を提供します。チームがリアルタイムで協働し、大規模データや複雑なワークフローを、オンプレミスでもクラウドでも効率的に扱えます。Alteryx は、データを正確に準備し、洞察に富んだ分析に備えることを保証します。
エンドツーエンドの対応が必要な包括的なデータプロジェクトには、KNIME、Apache NiFi、Microsoft Power BI といった統合プラットフォームがよく使われます。これらはラングリングだけでなく、単一環境内でのデータ統合、分析、可視化の機能も提供します。
例えば KNIME は、モジュール式のノードベースUIで複雑なワークフローを視覚的に構築できます。Apache NiFi はシステム間のデータフロー管理と自動化に優れ、Power BI はデータ準備と強力な可視化機能を兼ね備えます。これらは、データの準備・分析・共有をシームレスに行う必要があるプロジェクトに最適で、データドリブンな意思決定を包括的に支援します。
Python でデータラングリングを行う方法は数多くあります。主に利用されるパッケージはPandas とNumPyです。これらのパッケージには強力なツールが揃っており、データセットに対して主要なラングリング手法を容易に実施できます。
Python では多くのデータ処理が行われるため、これらの習得はデータ実務者にとって必須です。手法は多岐にわたりますが、上位レベルのクリーニング(例:null の削除)、データセットの結合、欠損値の扱いは特に重要です。
活用前に Python でクリーニングが必要な場面は多くあります。文字列の末尾・先頭の空白除去、null 値の削除、データ型の修正などが代表例です。
データセットごとに必要な処理は異なるため、追加のクリーニングが必要かどうかを見極めるには探索が不可欠です。さまざまな手法やコーディングを練習し、Python でデータをクリーンにする多様な方法を身につけましょう。
文字列のクレンジングでは、前後の空白が問題になることがよくあります。長さ・位置・一致に基づく解析で不具合の原因になります。これにはシリーズに対して str.strip() メソッドを使うのが最適です。
# Example utilizes a pandas series
# If working with a dataframe, call the series using df[col] syntax
s = pd.Series(['1. Ant.  ', '2. Bee!\n', '3. Cat?\t', np.nan, 10, True])
# It is important to include the .str or else the method will not work
s.str.strip()
Pandas では null の削除は簡単です。null の補完については後述します。単に dropna() メソッドを使います。行/列を削除する条件を指定できるオプション引数もありますが、デフォルトでは「いずれかに null を含む行」を削除します。
# For any dataframe
df = pd.DataFrame({"name": ['Alfred', 'Batman', 'Catwoman'],
                   "toy": [np.nan, 'Batmobile', 'Bullwhip'],
                   "born": [pd.NaT, pd.Timestamp("1940-04-25"), pd.NaT]}
df.dropna()
.astype() メソッドはシリーズのデータ型を変更できますが、シリーズ内のすべての値がその型に適合している必要があるため、型の修正はやや難易度が上がります。
例えば、オブジェクト型のシリーズを整数に変換するには、すべての値が整数でなければなりません。1つでも整数でない値があるとエラーになります。無効値を null に強制変換することもできますが、なぜ変換できない値があるのか調査する方が有益な場合もあります。
Pandas の DataFrame の結合は、SQL の JOIN に似ています。merge() のデフォルトは内部結合です。ただし、null でも結合する点には注意が必要です。結合にはキーの指定が必要で、複数列やインデックスを使うこともできます。
# Create two dataframes
df1 = pd.DataFrame({'lkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [1, 2, 3, 5]})
df2 = pd.DataFrame({'rkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [5, 6, 7, 8]})
# merge the df1 DataFrame to the df2 DataFrame using the columns key and rkey as keys
df1.merge(df2, left_on='lkey', right_on='rkey')
このコードは、それぞれの lkey と rkey 列の一致に基づいて2つの DataFrame を結合します。一致しない値は落ち、合致したものだけが残ります。結合の種類は left/right/outer に変更可能です。これは、異なるデータソースのデータセットを統合する強力な手段です。
欠損値への対処法は、ビジネス要件によって異なります。まず、なぜ欠損しているのかを考える必要があります。技術的な不具合が原因なら、分析の前に不具合を修正し、可能であれば履歴データの復元を試みるべきかもしれません。
場合によっては、残りのデータのみで分析し、欠損値を無視しても差し支えないこともあります。履歴が重要で復元できないなら、欠損を補完する必要があります。以下で補完方法を説明します。
主な手段は Pandas の fillna() メソッドです。文字列の場合、例えば df.fillna(value=’missing’) のように null を埋めるだけで十分なこともあります。fillna() を NumPy の mean()、median()、ラムダ関数などと組み合わせれば、数理的に欠損を補完できます。
別の方法として、データが順序(例:時系列)を持つ場合は interpolate() による補間も利用できます。目標は、実データをできる限り忠実に反映する形で欠損を埋めることです。
SQL でラングリングを行うことは、特にデータベースがクラウド上にある場合、効率的です。ローカルマシンで処理するデータ量や、ネットワークでの入出量を抑えられます。
SQL におけるラングリングの主眼は、適切な抽出・変換・ロードを通じて、パイプラインを流れるデータ量を抑えることです。そのために、フィルタリング、リファレンステーブルとの結合、集計などを活用します。
SQL でテーブルをフィルタする主な方法は WHERE 句です。使い方はシンプルですが非常に強力です。条件は単純な等価比較、類似文字列の検索、サブクエリの活用などが可能です。AND や OR で条件を組み合わせることもできます。
特定の列の特定値を探すような単純なケースは、次のようになります。
SELECT *
FROM sample_table
WHERE sample_col = 23
LIKE や IN を使うと、WHERE 句に柔軟性を持たせられます。例えば次のクエリでは、% ワイルドカードにより名前が J で始まる人を探し、姓が指定リストに含まれる人を抽出しています。
SELECT *
FROM sample_table
WHERE name LIKE ‘J%’ /* looks for people whose name starts with J */
AND last_name IN (‘Smith’, ‘Rockefeller’, ‘Williams’) /* Looks for people whose last name is in this list */
サブクエリを用いたフィルタリングは、他テーブルの結果に基づく柔軟な抽出を可能にします。よくある例として、特定日時以降の顧客IDの一覧取得があります。
SELECT *
FROM sample_table
WHERE customer_id IN (SELECT id FROM reference_table WHERE date >= ‘2024-01-01’)
これらを組み合わせれば、必要なデータだけを的確に取り込み、データセットのサイズを最小化できます。重複の除去なども強力な用途です。さらに高度な手法として、集計に対する HAVING や、ウィンドウ関数と組み合わせた QUALIFY などがあります。
テーブル結合により、データセットに必要な追加情報を取り込めます。SQL には INNER、OUTER、LEFT、RIGHT などの結合があります。INNER と OUTER は保持するデータの範囲を決め、INNER は両側一致のみ、OUTER は結合元(左/右)に応じて不一致も保持します。
LEFT は左側テーブルのデータを保持し、RIGHT は右側を保持します。これらは INNER/OUTER と組み合わせられるほか、両テーブルの全データを結ぶ FULL OUTER JOIN もあります。
結合の例は次のとおりです。
SELECT *
FROM a
LEFT OUTER JOIN
b
WHERE a.id = b.id
このステートメントでは、a が左、b が右です。LEFT OUTER JOIN は a.id = b.id で結合しつつ、一致がない場合でも a の行は保持します。必要な追加データを取り込むのに有効です。
SQL でラングリングに使える最後のツールとして、GROUP BY による集計があります。これによりデータを簡素化し、パイプライン下流に渡す前の前処理が可能です。例えば、顧客IDごとの売上合計を計算する例は以下のとおりです。
SELECT
Customer_ID,
SUM(sales)
FROM sample_table
GROUP BY Customer_ID
集計関数には SUM、MEAN、MAX、MIN などがあり、データの概況把握を迅速に行えます。集計を活用すれば、パイプラインへのデータ取り込みを簡素化できます。
このセクションでは、データラングリング手法の実践例とユースケースを取り上げます。主に、標準化、データソースの結合、テキスト処理に焦点を当てます。
同じ対象を異なる単位や通貨で測っている場合は、単位の標準化が重要です。標準化されていないと、分析で問題が生じます。
ここでは、異なる通貨を USD に換算する単純な SQL 例を示します。テーブル1は各地域の製品売上を持つ sales、テーブル2は各地域・各日の為替レートを持つ currency_exchange とします。変換の例は以下のようになります。
SELECT
a.sale_id,
a.region,
CASE WHEN region <> ‘US’
	THEN a.sale_price * b.exchange_rate
	ELSE a.sale_price
END AS sale_price
FROM sales AS a
LEFT OUTER JOIN
currency_exchange AS b
WHERE a.region = b.region
sales の sale_id と region を取り出し、地域でリファレンスの currency_exchange と結合して為替レートを取得しています。多くの場合、当日のレートを取得するために日付条件も加えます。
データラングリングの大きな一分野が、機械学習モデル向けのデータ前処理です。近年は自然言語処理のモデルが増えており、その前段としてテキストデータによる感情分析が行われます。
その重要ステップが、正規化と句読点の除去です。句読点や大文字小文字がモデルに重要な文脈を与えない場合、正規化した方が良いことが多いです。
ここでは、基本的な Python パッケージと re を使い、句読点の除去、すべて小文字への変換、空白のトリミングを行う例を示します。
# import regex
import re

# input string
test_string = "       Python 3.0, released in 2008, was a major revision of the language that is not completely backward compatible and much Python 2 code does not run unmodified on Python 3. With Python 2's end-of-life, only Python 3.6.x[30] and later are supported, with older versions still supporting e.g. Windows 7 (and old installers not restricted to 64-bit Windows)."
# remove whitespaces
no_space_string = test_string.strip()

# convert to lower case
lower_string = no_space_string .lower()

# remove numbers
no_number_string = re.sub(r'\d+','',lower_string)
print(no_number_string)
このコードスニペットは、空白の除去、すべて小文字への変換、数字や英字以外の除去の基礎を提供します。
データラングリングは、機械学習モデルや分析に向けたデータ準備の中核です。Python には pandas や numpy といったパッケージがあり、SQL には WHERE や GROUP BY などの句があり、これらを用いてデータを整えられます。
これらの手法を習得することは、データ分野で成功したい方にとって不可欠です。データラングリングをさらに深く学ぶなら、次のリソースをご検討ください。
人気の DataCamp コース
Courses
Courses
Tracks