Kursus
Pengantar Mengimpor Data di Python
3 Hr
340.7K
Dengan meningkatnya volume, variasi, dan kecepatan data, fokus untuk membangun kumpulan data yang berkualitas dan terstruktur dengan baik menjadi lebih krusial dari sebelumnya, karena secara langsung memengaruhi akurasi wawasan dan efektivitas pengambilan keputusan di berbagai industri.
Data yang buruk penataannya atau cacat dapat mengarah pada kesimpulan yang keliru, menghabiskan waktu, uang, dan sumber daya. Di sinilah data wrangling berperan sebagai proses penting yang memastikan data mentah yang tidak terstruktur diubah menjadi format yang bersih dan terorganisasi, siap untuk dianalisis.
Data wrangling melibatkan serangkaian langkah untuk memastikan data akurat, andal, dan disesuaikan dengan kebutuhan analisis yang spesifik. Dengan menguasai data wrangling, Anda dapat membuka potensi penuh data Anda, mengubahnya menjadi wawasan yang dapat ditindaklanjuti untuk mendorong keputusan yang tepat dan pada akhirnya membawa kesuksesan.
Data wrangling adalah proses mengubah data mentah menjadi format yang lebih mudah digunakan. Ini melibatkan pembersihan, penataan, dan pengayaan data agar siap untuk dianalisis.
Bayangkan Anda baru saja menerima kumpulan data besar—berantakan, dengan nilai hilang, inkonsistensi, dan informasi yang tidak relevan. Data wrangling seperti seperangkat alat yang membantu Anda merapikan data ini, memastikan data terorganisasi dan konsisten.
Data wrangling penting untuk memastikan data Anda berkualitas tinggi dan terstruktur dengan baik, yang krusial untuk analisis data yang akurat. Data yang bersih dan terstruktur menjadi fondasi bagi semua langkah selanjutnya dalam alur kerja data—baik saat Anda membangun model pembelajaran mesin, membuat visualisasi, atau melakukan analisis statistik.
Data berkualitas tinggi mengurangi risiko kesalahan dan bias dalam analisis, menghasilkan wawasan yang lebih andal. Memahami pentingnya data wrangling adalah kunci, karena secara langsung memengaruhi validitas keputusan yang dibuat berdasarkan data tersebut.
Data yang tidak ditangani dengan baik dapat mengarah pada kesimpulan yang cacat, yang dapat berdampak signifikan dalam penerapan dunia nyata. Oleh karena itu, menguasai data wrangling sangat penting bagi siapa pun yang serius membuat keputusan berbasis data.
Ada 5 langkah utama dalam data wrangling:
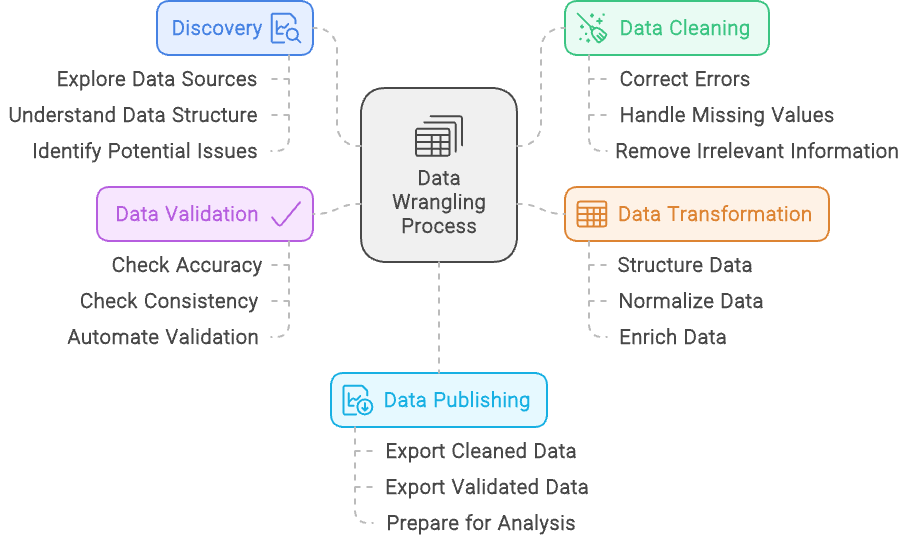
Proses data wrangling - dibuat dengan Napkin.ai
Kami telah menguraikan lima langkah data wrangling, tetapi mari melihat masing-masing secara lebih rinci:
Langkah discovery dalam data wrangling seperti melihat sekilas sebuah teka-teki sebelum mulai menyusun bagiannya. Ini melibatkan pemeriksaan dataset untuk memahami dengan jelas apa yang Anda hadapi, termasuk memahami jenis data, sumbernya, dan bagaimana strukturnya.
Seperti Anda mungkin mengelompokkan kepingan teka-teki berdasarkan warna atau bentuk pinggirnya, discovery membantu Anda mengategorikan dan mengenali pola dalam data, menyiapkan panggung untuk pekerjaan berikutnya.
Namun discovery juga tentang menemukan potensi masalah—seperti kepingan yang hilang atau warna yang tidak cocok dalam sebuah teka-teki.
Pada tahap ini, Anda mengidentifikasi masalah dalam data, seperti inkonsistensi, nilai hilang, atau pola yang tidak terduga. Dengan menemukan tantangan ini sejak awal, Anda dapat merencanakan cara menanganinya pada langkah-langkah selanjutnya dari data wrangling, memastikan jalur yang lebih mulus menuju dataset yang bersih dan siap digunakan.
Pembersihan data melibatkan penyempurnaan dataset Anda untuk memastikan akurasi dan keandalannya.
Proses ini mencakup menyelesaikan masalah seperti memperbaiki kesalahan, menangani nilai hilang, dan memperbaiki inkonsistensi. Misalnya, jika dataset Anda mengandung entri duplikat untuk individu atau transaksi yang sama, pembersihan data akan melibatkan penghapusan duplikat ini agar hasil tidak bias.
Selain itu, jika Anda mendapati beberapa entri salah format, seperti nomor telepon dengan format bervariasi, Anda akan menstandarkannya ke format yang konsisten. Tujuannya adalah meningkatkan kualitas dan integritas data secara keseluruhan, sehingga siap untuk analisis yang akurat dan bermakna.
Transformasi data adalah proses memodifikasi dan meningkatkan dataset Anda agar lebih selaras dengan kebutuhan analisis. Langkah ini melibatkan penataan data, seperti membentuk ulang agar sesuai format yang diinginkan atau menggabungkan beberapa sumber menjadi struktur yang padu.
Normalisasi data adalah aspek kunci lainnya, yaitu menyesuaikan nilai ke skala atau format yang sama, seperti mengonversi semua nilai mata uang ke satu mata uang atau menstandarkan satuan pengukuran.
Selain itu, transformasi data mencakup memperkaya dataset dengan menambahkan variabel baru atau mengintegrasikan sumber data eksternal untuk memberikan konteks atau wawasan lebih. Misalnya, Anda dapat menghitung metrik baru berdasarkan data yang ada atau menambahkan informasi tambahan dari database lain untuk memberikan gambaran yang lebih utuh.
Tujuan transformasi data adalah menyiapkan data dengan cara yang meningkatkan kegunaan dan relevansinya untuk analisis mendalam.
Validasi data melibatkan memastikan akurasi dan keandalan dataset Anda melalui pemeriksaan sistematis dan proses otomatis. Langkah ini penting untuk menegaskan bahwa data benar dan konsisten.
Selama validasi data, Anda melakukan berbagai pemeriksaan untuk mengidentifikasi diskrepansi, seperti membandingkan data dengan tolok ukur yang diketahui atau memvalidasi terhadap aturan dan batasan yang telah ditentukan. Proses otomatis dapat mencakup menjalankan skrip yang menandai anomali atau inkonsistensi, memastikan data mengikuti format dan rentang yang diharapkan.
Tujuan validasi data adalah menangkap masalah apa pun sebelum data digunakan untuk analisis, mencegah kesalahan memengaruhi hasil. Dengan memverifikasi akurasi dan keandalan data secara ketat, Anda memastikan bahwa wawasan yang dihasilkan didasarkan pada informasi yang tepercaya.
Publikasi data adalah langkah akhir dalam proses data wrangling, di mana data yang telah dibersihkan dan ditata disediakan untuk analisis dan pengambilan keputusan. Langkah ini melibatkan menyiapkan data untuk diseminasi, sering kali dengan membuat dasbor, laporan, atau visualisasi interaktif yang membuatnya dapat diakses dan dipahami oleh para pemangku kepentingan.
Selama publikasi data, Anda mungkin menyiapkan pipeline atau antarmuka data yang memungkinkan pengguna menanyakan dan berinteraksi dengan data, memastikan data disajikan dalam format yang sesuai dengan kebutuhan mereka.
Tujuannya adalah menyediakan wawasan yang jelas dan dapat ditindaklanjuti dari data, memungkinkan pengambilan keputusan yang tepat dan memfasilitasi komunikasi temuan di seluruh organisasi. Dengan mempublikasikan data secara efektif, Anda memastikan kerja keras data wrangling berujung pada hasil yang bermakna dan praktis.
Istilah data wrangling dan data cleaning sering digunakan secara bergantian, tetapi merujuk pada aspek yang berbeda dari proses persiapan data. Keduanya penting untuk menyiapkan data bagi analisis, namun memiliki tujuan yang berbeda dan melibatkan tugas yang berbeda. Memahami perbedaan keduanya membantu memperjelas peran masing-masing dan memastikan setiap aspek persiapan data ditangani secara efektif.
Data Wrangling adalah proses komprehensif yang melibatkan transformasi data mentah menjadi format yang cocok untuk analisis. Ini mencakup beberapa tahap, termasuk memperoleh data, menatanya, membersihkannya, dan memvalidasinya. Tujuan data wrangling adalah menyiapkan data dari berbagai sumber agar dapat dianalisis secara efektif dan menghasilkan wawasan. Proses ini memastikan data terorganisasi, akurat, dan siap untuk analisis mendetail.
Data Cleaning, di sisi lain, adalah subset spesifik dari data wrangling. Fokusnya semata pada peningkatan kualitas data dengan menangani dan memperbaiki kesalahan serta inkonsistensi. Ini mencakup tugas seperti menghapus catatan duplikat, memperbaiki salah ketik, menangani nilai hilang, dan menstandarkan format data. Meskipun pembersihan data merupakan bagian penting dari data wrangling, ini hanyalah satu langkah dalam proses yang lebih luas.
Singkatnya, data wrangling adalah kerangka keseluruhan untuk menyiapkan data bagi analisis, termasuk berbagai langkah untuk menangani berbagai aspek persiapan data. Data cleaning adalah komponen integral dari kerangka ini, yang didedikasikan khusus untuk meningkatkan akurasi dan konsistensi data.
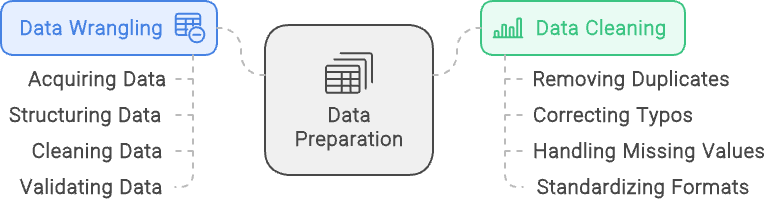
Data Wrangling vs Data Cleaning: Data Wrangling berfokus pada penataan dan validasi data sedangkan Data Cleaning berfokus pada memastikan data bersih dan berkualitas tersedia. Gambar dibuat dengan napkin.ai
Ada banyak cara untuk melakukan data wrangling, baik melalui penggunaan alat GUI dasar seperti Excel atau Alteryx maupun melalui pengodean dengan bahasa seperti R dan Python. Kami akan membahas beberapa opsi di sini.
Untuk tugas data wrangling sederhana, spreadsheet seperti Microsoft Excel dan Google Sheets sering menjadi pilihan utama. Alat-alat ini sangat mudah diakses dan menyediakan antarmuka yang familier, sehingga ideal untuk tugas seperti pengurutan, pemfilteran, dan pembersihan data dasar. Spreadsheet sangat berguna untuk dataset yang lebih kecil atau bagi mereka yang baru mulai mempelajari data wrangling.
Dengan fungsi dan rumus bawaan, alat ini memungkinkan pengguna dengan cepat melakukan perhitungan dan memanipulasi data tanpa memerlukan pengetahuan teknis yang luas.
Untuk manipulasi data yang lebih kompleks dan otomatisasi, bahasa pemrograman seperti Python dan R banyak digunakan. Python, dengan pustaka kuat seperti Pandas, NumPy, dan OpenRefine, sangat baik untuk menangani dataset besar dan melakukan transformasi data yang rumit.
R, dengan paket seperti dplyr dan tidyr, merupakan opsi kuat lainnya, yang banyak digemari di komunitas statistik dan akademik karena kapabilitas analisis datanya yang tangguh. Kedua bahasa menawarkan tingkat fleksibilitas tinggi, memungkinkan pengguna membuat skrip alur kerja kustom dan mengotomatiskan tugas berulang, sehingga ideal bagi praktisi data dengan kebutuhan data wrangling yang lebih canggih.
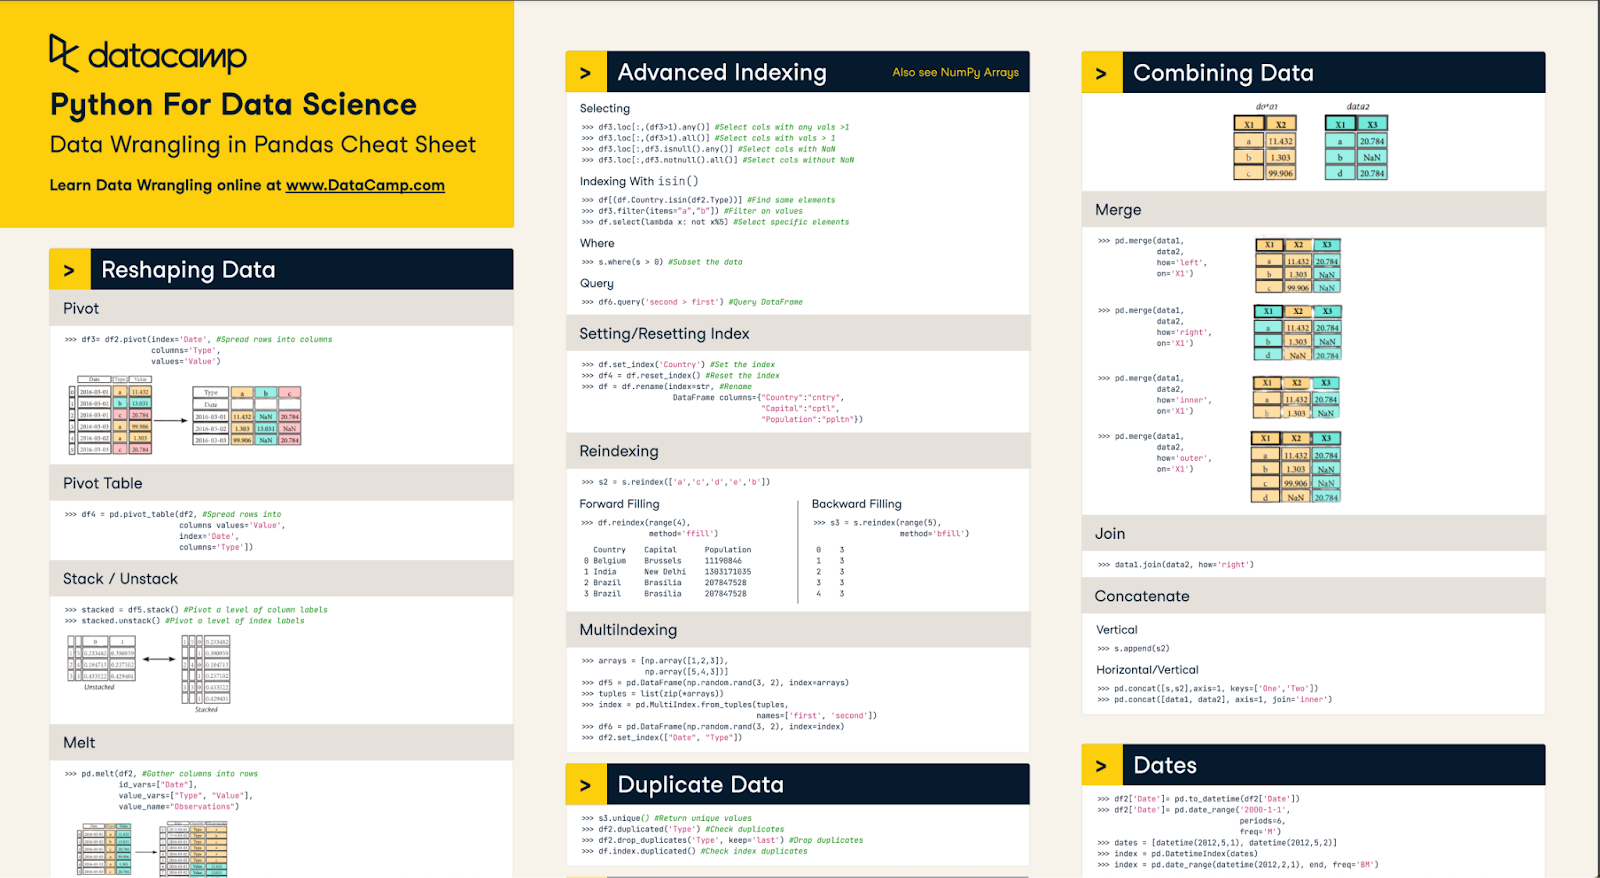
Cheat Sheet Data Wrangling in Pandas kami dapat membantu Anda menguasai banyak dasar-dasarnya
Perangkat lunak khusus dirancang khusus untuk merampingkan proses data wrangling, menawarkan fitur canggih yang menyederhanakan tugas data yang kompleks. Alat ini ideal bagi pengguna yang membutuhkan solusi kuat namun mudah diakses untuk membersihkan, menata, dan menyiapkan data untuk analisis tanpa perlu banyak pengodean.
Alteryx adalah alat terdepan dalam kategori ini, dikenal dengan antarmuka seret-dan-lepas yang intuitif yang memungkinkan pengguna dengan mudah membersihkan, memadukan, dan mentransformasi data dari berbagai sumber. Alat ini dilengkapi beragam fitur bawaan untuk manipulasi data, sehingga mudah melakukan tugas seperti pemfilteran, penggabungan, dan pengagregasian data.
Versi berbasis cloud, Alteryx Designer Cloud, semakin meningkatkan kapabilitas ini dengan menyediakan platform data wrangling yang skalabel dan kolaboratif. Solusi ini memungkinkan tim bekerja bersama secara real-time, menangani dataset besar dan alur kerja yang kompleks secara efisien di berbagai lingkungan. Baik digunakan di lokasi maupun di cloud, Alteryx memastikan data dipersiapkan dengan akurat dan siap untuk analisis yang bermakna.
Untuk proyek data komprehensif yang memerlukan solusi ujung ke ujung, platform terintegrasi seperti KNIME, Apache NiFi, dan Microsoft Power BI sering digunakan. Platform ini tidak hanya mendukung data wrangling tetapi juga menyediakan alat untuk integrasi data, analisis, dan visualisasi dalam satu lingkungan.
KNIME, misalnya, dikenal dengan antarmuka modular berbasis node yang memungkinkan pengguna membangun alur kerja kompleks secara visual. Apache NiFi unggul dalam mengelola dan mengotomatiskan aliran data antar sistem, sementara Power BI menggabungkan persiapan data dengan kemampuan visualisasi yang kuat. Platform ini ideal untuk proyek di mana data perlu disiapkan, dianalisis, dan dibagikan secara mulus, menawarkan pendekatan holistik terhadap pengambilan keputusan berbasis data.
Ada banyak opsi saat melakukan data wrangling dengan Python. Dua paket utama yang digunakan adalah Pandas dan NumPy. Kedua paket ini memiliki alat yang kuat yang memungkinkan pengguna dengan mudah melakukan teknik data wrangling utama pada dataset mereka.
Begitu banyak pemrosesan data terjadi di Python sehingga menguasai paket-paket ini akan esensial bagi setiap praktisi data. Meskipun ada banyak teknik, beberapa hal kunci yang perlu diketahui adalah cara melakukan pembersihan data tingkat tinggi (misalnya menghapus nilai null), menggabungkan dataset, dan menangani nilai hilang.
Ada banyak kesempatan di mana data perlu dibersihkan di Python sebelum digunakan. Ini bisa mencakup hal-hal seperti menghapus spasi kosong di akhir dari string, menghapus nilai null, atau memperbaiki tipe data, dan lainnya.
Setiap dataset berbeda dan memiliki kebutuhannya sendiri, jadi jelajahi dataset Anda untuk memahami apakah diperlukan pembersihan tambahan. Melatih berbagai teknik dan keterampilan pengodean adalah cara yang bagus untuk mempelajari berbagai cara kita dapat membersihkan data di Python.
Saat membersihkan string, salah satu masalah yang sering muncul adalah spasi di awal/akhir. Ini dapat menyebabkan masalah saat mencoba mengurai string berdasarkan panjang, posisi, atau pencocokan. Cara terbaik menanganinya adalah menggunakan metode str.strip() pada series.
# Example utilizes a pandas series
# If working with a dataframe, call the series using df[col] syntax
s = pd.Series(['1. Ant.  ', '2. Bee!\n', '3. Cat?\t', np.nan, 10, True])
# It is important to include the .str or else the method will not work
s.str.strip()
Menghapus nilai null di Pandas itu mudah. Kami akan membahas cara mengisi nilai null nanti dalam artikel ini. Anda cukup menggunakan metode dropna(). Ada parameter opsional dalam metode ini yang memungkinkan Anda memilih kondisi tepat untuk menghapus baris/kolom, tetapi perilaku defaultnya adalah menghapus baris apa pun yang memiliki nilai null apa pun
# For any dataframe
df = pd.DataFrame({"name": ['Alfred', 'Batman', 'Catwoman'],
                   "toy": [np.nan, 'Batmobile', 'Bullwhip'],
                   "born": [pd.NaT, pd.Timestamp("1940-04-25"), pd.NaT]}
df.dropna()
Metode .astype() memungkinkan pengguna mengubah tipe data sebuah series, tetapi memperbaiki tipe data sedikit lebih rumit karena Anda harus memastikan setiap nilai dalam series Pandas sesuai dengan tipe data tersebut.
Misalnya, mengonversi series bertipe objek menjadi integer berarti Anda tahu bahwa setiap nilainya adalah integer. Jika ada satu nilai saja yang bukan integer, metode akan menghasilkan error. Anda dapat memilih untuk memaksa (coerce) dengan membuat nilai tidak valid menjadi null, tetapi mungkin lebih baik menyelidiki mengapa nilai tertentu tidak dapat dikonversi.
Menggabungkan DataFrame di Pandas mirip dengan join di SQL. Perilaku default dari merge() Pandas adalah melakukan inner join. Namun, ia akan melakukan join pada nilai null, jadi berhati-hatilah. Melakukan merge mengharuskan Anda menggunakan kunci tertentu. Anda dapat melakukan join pada berbagai kolom atau bahkan index.
# Create two dataframes
df1 = pd.DataFrame({'lkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [1, 2, 3, 5]})
df2 = pd.DataFrame({'rkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [5, 6, 7, 8]})
# merge the df1 DataFrame to the df2 DataFrame using the columns key and rkey as keys
df1.merge(df2, left_on='lkey', right_on='rkey')
Kode di atas akan menggabungkan dua DataFrame berdasarkan kunci yang cocok pada kolom lkey dan rkey masing-masing. Nilai yang tidak cocok akan dihapus dan Anda hanya akan mendapatkan nilai yang cocok. Namun, Anda dapat mengubah perilaku merge dan memilih left/right/outer merge juga. Ini adalah alat yang ampuh untuk memungkinkan data scientist menggabungkan berbagai dataset dari berbagai sumber data.
Terkait nilai hilang, metodologinya dapat bervariasi berdasarkan kasus bisnis. Saat kita membicarakan nilai hilang, kita harus mempertimbangkan mengapa nilai itu hilang. Jika nilai hilang karena kesalahan teknis, mungkin kita harus fokus memperbaiki kesalahan teknis tersebut sebelum menganalisis data dan melihat apakah kita bisa memulihkan data historis.
Terkadang, kita dapat menggunakan sisa data dan mengabaikan nilai yang hilang. Jika data historis penting dan tidak dapat dipulihkan, kita harus mengisi data yang hilang. Mari bahas cara mengisi informasi yang hilang.
Metode utama untuk mengisi data adalah menggunakan metode fillna() dari Pandas. Untuk nilai string, metode ini dapat digunakan untuk mengisi nilai null, misalnya: df.fillna(value=’missing’) yang mungkin sudah cukup! Keunggulan metode ini adalah kita bisa kreatif. Dengan mengombinasikan metode fillna() Pandas dengan berbagai metode NumPy seperti mean(), median(), dan fungsi lambda, kita dapat mengisi nilai hilang secara matematis.
Sebagai alternatif, ada juga metode Pandas seperti interpolate() yang dapat mengisi celah secara algoritmik jika data Anda berurutan (misalnya berbasis waktu). Tujuannya adalah mengisi data seakurat mungkin sehingga mencerminkan data sebenarnya.
Melakukan data wrangling di SQL bisa menjadi cara efektif memproses data Anda, terutama jika basis data SQL Anda berada di cloud. Ini membatasi jumlah data yang diproses oleh mesin lokal Anda dan jumlah egress/ingress data melalui jaringan.
Fokus utama data wrangling di SQL adalah membatasi cakupan data yang mengalir melalui pipeline kita melalui ekstraksi, transformasi, dan pemuatan data yang tepat. Beberapa cara kita mengelolanya adalah memfilter data, melakukan join ke tabel referensi, dan melakukan agregasi.
Cara utama kita memfilter tabel di SQL adalah menggunakan klausa WHERE. Penggunaannya cukup lugas tetapi bisa sangat kuat. Kondisinya bisa berupa pernyataan kesetaraan sederhana, mencari string serupa, atau bahkan menggunakan subkueri lain. Anda juga dapat menggabungkan beberapa klausa WHERE menggunakan pernyataan AND dan OR!
Memfilter berdasarkan kasus sederhana seperti mencari nilai tertentu dari suatu kolom dapat terlihat seperti ini:
SELECT *
FROM sample_table
WHERE sample_col = 23
Menggunakan pernyataan yang lebih kompleks seperti LIKE atau IN dapat memberikan fleksibilitas pada klausa WHERE Anda. Misalnya, kueri berikut mencari orang yang namanya diawali huruf J berkat wildcard % dan juga yang nama belakangnya IN daftar yang diberikan.
SELECT *
FROM sample_table
WHERE name LIKE ‘J%’ /* looks for people whose name starts with J */
AND last_name IN (‘Smith’, ‘Rockefeller’, ‘Williams’) /* Looks for people whose last name is in this list */
Terakhir, penggunaan subkueri lain dapat memberikan fleksibilitas pada pemfilteran Anda. Ini dapat didasarkan pada hasil dari tabel lain. Salah satu contoh umum adalah mencari daftar ID pelanggan setelah waktu tertentu.
SELECT *
FROM sample_table
WHERE customer_id IN (SELECT id FROM reference_table WHERE date >= ‘2024-01-01’)
Menggunakan kombinasi teknik-teknik ini memastikan masukan data Anda sesuai dengan yang dicari dan ukuran dataset dapat diminimalkan. Satu penggunaan filter yang sangat kuat adalah menghapus duplikat dalam dataset Anda dan membersihkannya dengan cara itu. Beberapa teknik lanjutan untuk diterapkan adalah filter HAVING untuk agregasi dan pernyataan QUALIFY dengan fungsi jendela.
Melakukan join tabel memungkinkan kita mengumpulkan informasi tambahan yang mungkin kita perlukan untuk dataset. SQL memiliki berbagai jenis join seperti INNER, OUTER, LEFT, dan RIGHT. Dengan join INNER dan OUTER, kita menentukan data mana yang disimpan. Join INNER menyimpan data hanya jika ada kecocokan di kedua sisi sedangkan OUTER menyimpan data yang tidak cocok juga tergantung sisi mana kita melakukan join (kiri atau kanan).
Join LEFT menyimpan data di sisi kiri join dan join RIGHT menyimpan data di sisi kanan join. Anda mengombinasikan join LEFT dan RIGHT dengan join INNER dan OUTER serta FULL OUTER JOIN khusus yang menggabungkan semua data dari kedua tabel.
Contoh join mungkin seperti:
SELECT *
FROM a
LEFT OUTER JOIN
b
WHERE a.id = b.id
Pernyataan di atas memiliki tabel a di kiri karena berada pertama dan tabel b di kanan karena berada kedua. LEFT OUTER JOIN mengatakan, gabungkan data dari tabel a dan b di mana a.id = b.id, tetapi jika tidak ada kecocokan simpan semua data dari tabel a. Join adalah alat yang kuat untuk memasukkan data tambahan yang mungkin diperlukan untuk masukan data Anda.
Satu alat terakhir yang dapat kita manfaatkan di SQL untuk data wrangling adalah klausa GROUP BY untuk melakukan agregasi. Ini menyederhanakan data dan memungkinkan kita melakukan pra-pemrosesan data sebelum mengirimnya lebih jauh ke pipeline. Agregasi adalah alat yang kuat untuk menghitung statistik ringkasan. Berikut contoh saat kita melihat total penjualan berdasarkan ID pelanggan:
SELECT
Customer_ID,
SUM(sales)
FROM sample_table
GROUP BY Customer_ID
Ada banyak fungsi agregasi seperti SUM, MEAN, MAX, dan MIN yang memungkinkan kita dengan cepat dan mudah memahami data. Memanfaatkan agregasi menyederhanakan pemasukan data ke pipeline.
Bagian ini akan membahas beberapa contoh praktis dan use case untuk teknik data wrangling. Tujuan utama yang akan kami fokuskan adalah: standarisasi data, penggabungan sumber data, dan pemrosesan teks.
Menstandarkan data ke satuan yang sama itu penting. Jika bekerja dengan data yang mengukur hal yang sama dalam satuan berbeda atau perbedaan mata uang maka itu dapat menyebabkan masalah dalam analisis.
Kami akan membahas contoh sederhana mengonversi mata uang berbeda ke USD di SQL. Pertama, mari asumsikan kita memiliki dua tabel. Tabel 1 adalah tabel sales yang berisi penjualan produk untuk berbagai wilayah dan Tabel 2 adalah tabel currency_exchange yang berisi kurs untuk berbagai wilayah pada berbagai hari. Contoh konversinya mungkin seperti:
SELECT
a.sale_id,
a.region,
CASE WHEN region <> ‘US’
	THEN a.sale_price * b.exchange_rate
	ELSE a.sale_price
END AS sale_price
FROM sales AS a
LEFT OUTER JOIN
currency_exchange AS b
WHERE a.region = b.region
Ini mengambil sale_id dan region dari tabel sales dan melakukan join ke tabel referensi currency_exchange pada kolom region sehingga kita bisa mendapatkan kurs. Sering kali, mungkin ada tanggal yang terlibat agar kita bisa mendapatkan kurs pada hari tersebut.
Salah satu porsi besar dari data wrangling adalah memproses data untuk model pembelajaran mesin kita. Baru-baru ini, banyak model berfokus pada pemrosesan bahasa alami dan salah satu prasyaratnya adalah analisis sentimen melalui data teks.
Langkah pentingnya adalah menyiapkan teks melalui normalisasi dan penghapusan tanda baca. Karena tanda baca dan kapitalisasi mungkin tidak memberikan konteks penting bagi model pembelajaran mesin, sering kali lebih baik dinormalisasi.
Untuk melakukan ini, kita akan memanfaatkan paket Python dasar dan paket re. Lihat di bawah untuk contoh menghapus tanda baca, menormalkan teks untuk menghapus kapitalisasi, dan memangkas spasi kosong.
# import regex
import re

# input string
test_string = "       Python 3.0, released in 2008, was a major revision of the language that is not completely backward compatible and much Python 2 code does not run unmodified on Python 3. With Python 2's end-of-life, only Python 3.6.x[30] and later are supported, with older versions still supporting e.g. Windows 7 (and old installers not restricted to 64-bit Windows)."
# remove whitespaces
no_space_string = test_string.strip()

# convert to lower case
lower_string = no_space_string .lower()

# remove numbers
no_number_string = re.sub(r'\d+','',lower_string)
print(no_number_string)
Potongan kode di atas memberikan dasar yang baik untuk menghapus spasi, mengonversi karakter menjadi huruf kecil semua, dan menghapus angka/data non-alfabet.
Data wrangling adalah komponen krusial dalam menyiapkan data kita untuk model pembelajaran mesin dan analisis. Ada banyak alat di Python seperti paket pandas dan numpy bersama beragam metode SQL seperti klausa WHERE dan GROUP BY yang memungkinkan kita menyiapkan data.
Penguasaan teknik-teknik ini penting bagi setiap calon profesional data untuk berhasil dalam profesinya. Jika Anda ingin menggali lebih dalam topik data wrangling, pertimbangkan sumber daya berikut:
Kursus Teratas DataCamp
Kursus
Kursus
Program
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt