Corso
Introduzione all'importazione dei dati in Python
3 h
340.7K
Con l’aumento del volume, della varietà e della velocità dei dati, concentrarsi sulla costruzione di dataset di qualità e ben strutturati è più critico che mai, perché influiscono direttamente sull’accuratezza degli insight e sull’efficacia delle decisioni in tutti i settori.
Dati mal organizzati o difettosi possono portare a conclusioni fuorvianti, con costi in termini di tempo, denaro e risorse. Qui entra in gioco il data wrangling, il processo essenziale che trasforma i dati grezzi e non strutturati in un formato pulito e organizzato, pronto per l’analisi.
Il data wrangling comprende una serie di passaggi per garantire che i dati siano accurati, affidabili e adattati alle esigenze specifiche dell’analisi. Padroneggiando il data wrangling, puoi sbloccare tutto il potenziale dei tuoi dati, trasformandoli in insight azionabili che guidano decisioni informate e, in definitiva, portano al successo.
Il data wrangling è il processo di trasformazione dei dati grezzi in un formato più utilizzabile. Ciò comporta la pulizia, la strutturazione e l’arricchimento dei dati in modo che siano pronti per l’analisi.
Immagina di aver appena ricevuto un enorme dataset: è disordinato, con valori mancanti, incongruenze e informazioni irrilevanti. Il data wrangling è come una cassetta degli attrezzi che ti aiuta a mettere in ordine questi dati, assicurandoti che siano organizzati e coerenti.
Il data wrangling è importante per garantire che i tuoi dati siano di alta qualità e ben strutturati, aspetto cruciale per un’analisi accurata. Dati puliti e strutturati sono la base per tutti i passaggi successivi del flusso di lavoro dei dati, che si tratti di costruire un modello di machine learning, generare visualizzazioni o eseguire analisi statistiche.
Dati di alta qualità riducono il rischio di errori e bias nell’analisi, portando a insight più affidabili. Capire l’importanza del data wrangling è fondamentale, poiché influisce direttamente sulla validità delle decisioni prese sulla base di quei dati.
Un data wrangling eseguito male può portare a conclusioni errate, con conseguenze significative nelle applicazioni reali. Perciò, padroneggiare il data wrangling è essenziale per chiunque prenda sul serio le decisioni data-driven.
Ci sono 5 passaggi principali nel data wrangling:
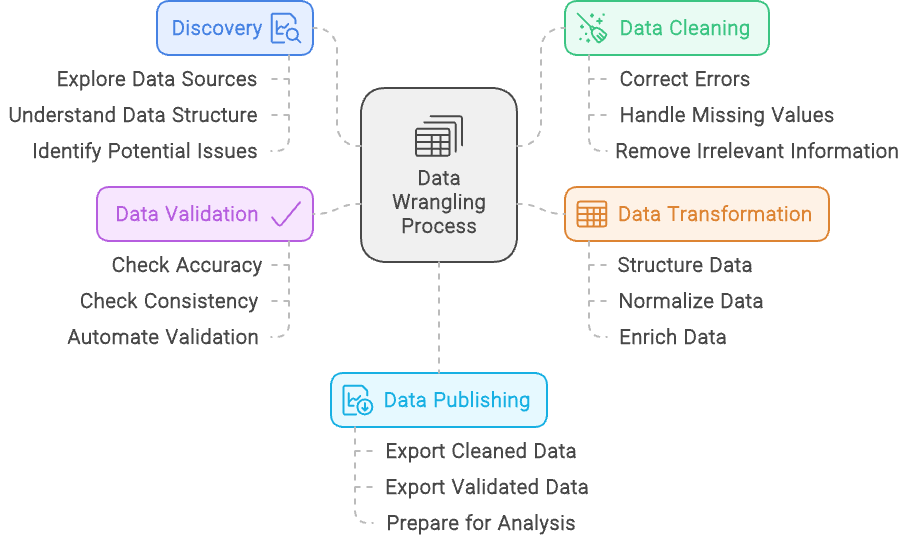
Il processo di data wrangling - creato con Napkin.ai
Abbiamo delineato i cinque passaggi del data wrangling, ma vediamoli più nel dettaglio:
La fase di discovery nel data wrangling è come dare una prima occhiata a un puzzle prima di iniziare a comporlo. Comporta l’esame del dataset per capire con cosa stai lavorando, compresi i tipi di dati, le fonti e come sono strutturati.
Come potresti ordinare i pezzi del puzzle per colore o forma dei bordi, l’esplorazione ti aiuta a categorizzare e riconoscere pattern nei dati, preparando il terreno per il lavoro successivo.
Ma l’esplorazione serve anche a individuare potenziali problemi, come pezzi mancanti o colori non corrispondenti in un puzzle.
In questa fase identifichi eventuali criticità nei dati, come incoerenze, valori mancanti o pattern inattesi. Scoprendo queste sfide in anticipo, puoi pianificare come affrontarle nei passaggi successivi del data wrangling, garantendo un percorso più fluido verso un dataset pulito e utilizzabile.
La pulizia dei dati consiste nel perfezionare il dataset per garantirne accuratezza e affidabilità.
Questo processo include affrontare problemi come la correzione di errori, la gestione dei valori mancanti e la risoluzione delle incongruenze. Ad esempio, se il tuo dataset contiene voci duplicate per lo stesso individuo o transazione, la pulizia dei dati comporterebbe la rimozione di questi duplicati per evitare risultati distorti.
Inoltre, se trovi voci con formattazioni incoerenti, come numeri di telefono in formati diversi, le standardizzeresti in un formato uniforme. L’obiettivo è migliorare la qualità e l’integrità complessive dei dati, rendendoli pronti per un’analisi accurata e significativa.
La trasformazione dei dati è il processo di modifica e miglioramento del dataset per allinearlo meglio ai requisiti dell’analisi. Questo passaggio prevede la strutturazione dei dati, ad esempio rimodellandoli per adattarli al formato desiderato o combinando più fonti in una struttura coerente.
Un altro aspetto chiave è la normalizzazione dei dati, ovvero l’adattamento dei valori a una scala o a un formato comune, come convertire tutte le valute in una singola valuta o standardizzare le unità di misura.
Inoltre, la trasformazione dei dati include l’arricchimento del dataset aggiungendo nuove variabili o integrando fonti esterne per fornire più contesto o insight. Ad esempio, potresti calcolare nuove metriche a partire dai dati esistenti o aggiungere informazioni da altri database per avere un quadro più completo.
L’obiettivo della trasformazione è preparare i dati in modo da migliorarne l’usabilità e la pertinenza per analisi approfondite.
La validazione dei dati consiste nell’assicurare accuratezza e affidabilità del dataset tramite controlli sistematici e processi automatizzati. Questo passaggio è fondamentale per confermare che i dati siano corretti e coerenti.
Durante la validazione, esegui vari controlli per individuare discrepanze, ad esempio confrontando i dati con benchmark noti o verificandoli rispetto a regole e vincoli predefiniti. I processi automatici possono includere l’esecuzione di script che segnalano anomalie o incoerenze, assicurando che i dati rispettino formati e intervalli attesi.
L’obiettivo della validazione è intercettare i problemi prima che i dati vengano usati per l’analisi, evitando che errori impattino i risultati. Verificando rigorosamente accuratezza e affidabilità, garantisci che gli insight siano basati su informazioni attendibili.
La pubblicazione dei dati è l’ultimo passaggio del processo di data wrangling, in cui i dati puliti e strutturati vengono messi a disposizione per analisi e decisioni. Questo passaggio prevede la preparazione dei dati per la diffusione, spesso tramite dashboard, report o visualizzazioni interattive che li rendono accessibili e comprensibili agli stakeholder.
Durante la pubblicazione, potresti impostare pipeline o interfacce che consentono agli utenti di interrogare e interagire con i dati, assicurandoti che siano forniti in un formato adatto alle loro esigenze.
L’obiettivo è fornire insight chiari e azionabili, abilitando decisioni informate e facilitando la comunicazione dei risultati in tutta l’organizzazione. Pubblicando efficacemente i dati, ti assicuri che il lavoro svolto nel data wrangling si traduca in risultati concreti e utili.
I termini data wrangling e data cleaning sono spesso usati in modo intercambiabile, ma si riferiscono ad aspetti diversi della preparazione dei dati. Pur essendo entrambi essenziali per preparare i dati all’analisi, hanno scopi distinti e includono attività differenti. Capire la differenza aiuta a chiarirne i ruoli e a garantire che ogni aspetto della preparazione sia gestito in modo efficace.
Il Data Wrangling è un processo completo che trasforma i dati grezzi in un formato adatto all’analisi. Comprende diverse fasi, tra cui acquisizione, strutturazione, pulizia e validazione. L’obiettivo è preparare dati provenienti da fonti diverse affinché possano essere analizzati efficacemente e generare insight. Questo processo assicura che i dati siano organizzati, accurati e pronti per analisi dettagliate.
Il Data Cleaning, invece, è un sottoinsieme specifico del data wrangling. Si concentra esclusivamente sul miglioramento della qualità dei dati affrontando e correggendo errori e incoerenze. Include attività come rimuovere i record duplicati, correggere refusi, gestire i valori mancanti e standardizzare i formati. Pur essendo una parte cruciale del data wrangling, la pulizia è solo uno dei passaggi di un processo più ampio.
In poche parole, il data wrangling è il quadro complessivo che prepara i dati all’analisi, includendo più passaggi per gestire vari aspetti della preparazione. Il data cleaning è un componente integrante di questo quadro, dedicato specificamente a migliorare accuratezza e coerenza dei dati.
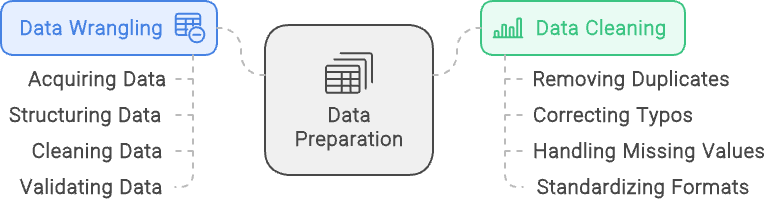
Data Wrangling vs Data Cleaning: il Data Wrangling si concentra sulla strutturazione e la validazione dei dati, mentre il Data Cleaning si concentra nel garantire che i dati siano puliti e di qualità. Immagine creata con napkin.ai
Ci sono molti modi per fare data wrangling, sia tramite strumenti GUI di base come Excel o Alteryx, sia programmando con linguaggi come R e Python. Qui esploreremo alcune opzioni.
Per attività semplici di data wrangling, i fogli di calcolo come Microsoft Excel e Google Fogli sono spesso le scelte più immediate. Sono strumenti molto accessibili e con un’interfaccia familiare, ideali per operazioni come ordinamento, filtro e pulizia di base. I fogli di calcolo sono particolarmente utili per dataset piccoli o per chi sta iniziando a imparare il data wrangling.
Grazie a funzioni e formule integrate, consentono di eseguire rapidamente calcoli e manipolare i dati senza richiedere conoscenze tecniche approfondite.
Per manipolazioni più complesse e automazione, sono ampiamente utilizzati linguaggi come Python e R. Python, con le sue potenti librerie come Pandas, NumPy e OpenRefine, è eccellente per gestire grandi dataset ed eseguire trasformazioni intricate.
R, con pacchetti come dplyr e tidyr, è un’altra opzione valida, particolarmente apprezzata nelle comunità accademiche e statistiche per le sue robuste capacità di analisi. Entrambi i linguaggi offrono grande flessibilità, permettendo di scrivere workflow personalizzati e automatizzare attività ripetitive, ideali per chi lavora con esigenze di data wrangling più sofisticate.
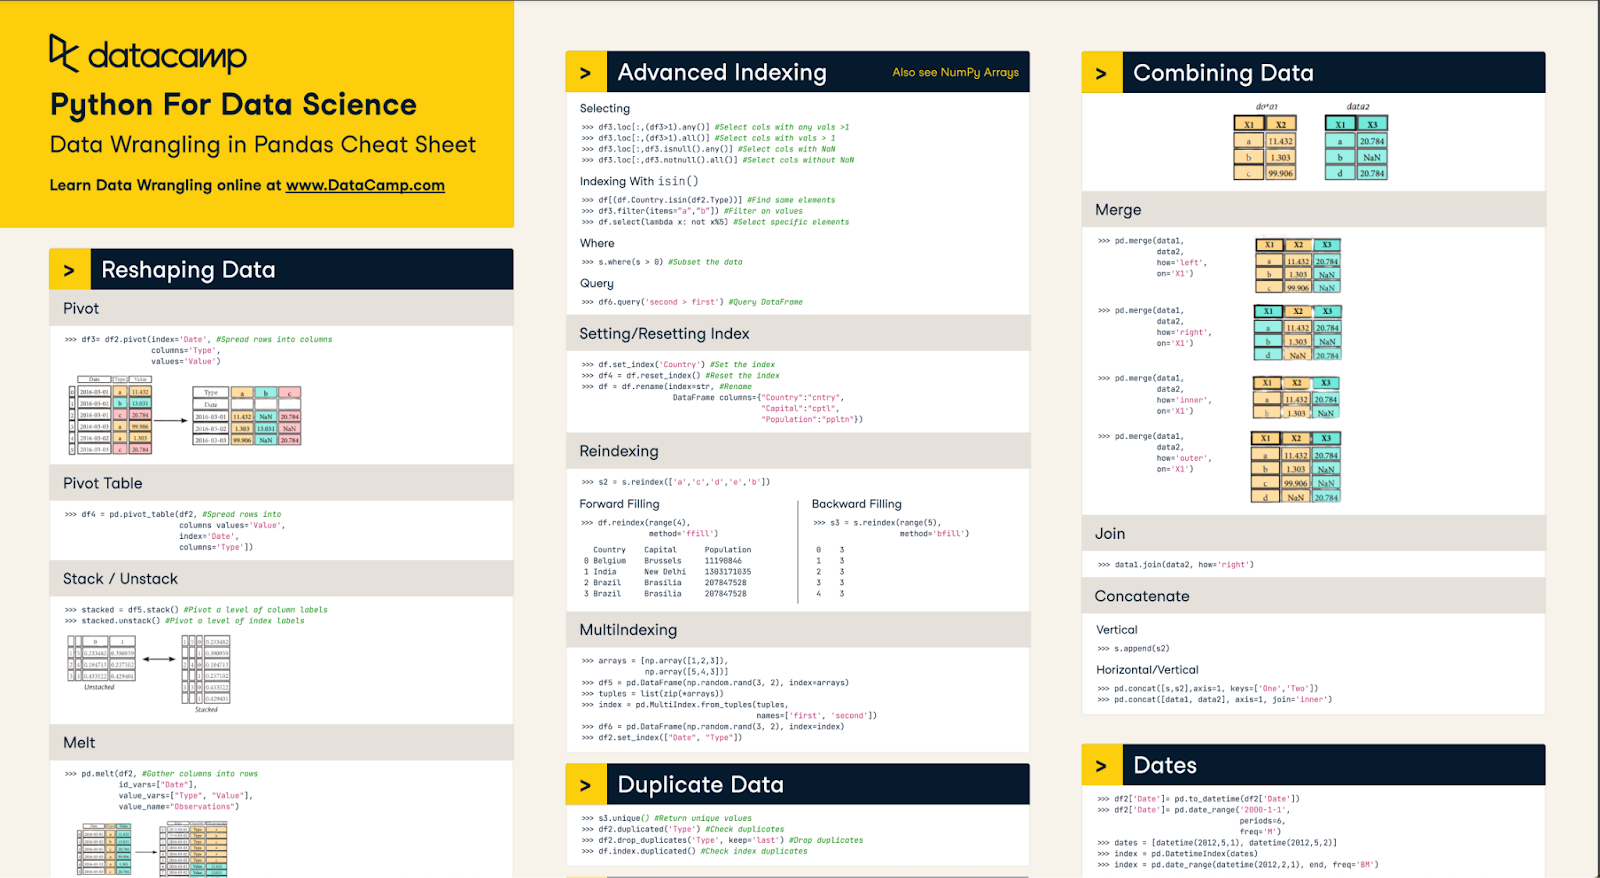
La nostra cheat sheet Data Wrangling in Pandas può aiutarti a padroneggiare molte basi
Gli strumenti software dedicati sono progettati specificamente per semplificare il processo di data wrangling, offrendo funzionalità avanzate che rendono più semplici attività complesse. Sono ideali per chi ha bisogno di soluzioni potenti ma accessibili per pulire, strutturare e preparare i dati all’analisi senza dover programmare troppo.
Alteryx è un riferimento in questa categoria, noto per l’interfaccia intuitiva drag-and-drop che consente di pulire, combinare e trasformare facilmente dati da più fonti. Dispone di numerosi strumenti integrati per la manipolazione, rendendo semplici operazioni come filtrare, unire e aggregare.
La soluzione cloud Alteryx Designer Cloud potenzia ulteriormente queste capacità offrendo una piattaforma scalabile e collaborativa per il data wrangling. Consente ai team di lavorare insieme in tempo reale, gestendo grandi dataset e workflow complessi in modo efficiente in ambienti diversi. On-premise o in cloud, Alteryx garantisce che i dati siano preparati accuratamente e pronti per analisi significative.
Per progetti completi che richiedono soluzioni end-to-end, spesso si usano piattaforme integrate come KNIME, Apache NiFi e Microsoft Power BI. Queste piattaforme non solo supportano il data wrangling, ma offrono strumenti per integrazione, analisi e visualizzazione dei dati in un unico ambiente.
KNIME, ad esempio, è noto per l’interfaccia modulare basata su nodi che permette di costruire workflow complessi in modo visuale. Apache NiFi eccelle nella gestione e automazione dei flussi tra sistemi, mentre Power BI combina preparazione dei dati e potenti capacità di visualizzazione. Queste piattaforme sono ideali quando i dati devono essere preparati, analizzati e condivisi senza soluzione di continuità, offrendo un approccio olistico alle decisioni data-driven.
Le opzioni per fare data wrangling con Python sono molte. Due pacchetti principali sono Pandas e NumPy. Questi pacchetti offrono potenti strumenti che consentono di applicare facilmente le principali tecniche di data wrangling ai propri dataset.
Gran parte dell’elaborazione dei dati avviene in Python, quindi padroneggiare questi pacchetti è essenziale per qualsiasi professionista dei dati. Sebbene le tecniche siano molte, alcune competenze chiave sono la pulizia ad alto livello (ad esempio rimuovere i null), l’unione di dataset e la gestione dei valori mancanti.
Capita spesso che i dati debbano essere puliti in Python prima di essere utilizzati. Questo può includere la rimozione degli spazi bianchi finali dalle stringhe, l’eliminazione dei valori null o la correzione dei tipi di dato, per citarne alcuni.
Ogni dataset è diverso e ha esigenze proprie, quindi esplora il tuo dataset per capire se sono necessarie pulizie aggiuntive. Esercitarsi con varie tecniche e competenze di coding è un ottimo modo per imparare tutti i diversi modi in cui possiamo pulire i dati in Python.
Per quanto riguarda la pulizia delle stringhe, uno dei tanti problemi sono gli spazi bianchi iniziali/finali. Possono creare problemi quando si analizzano le stringhe in base a lunghezza, posizione o corrispondenza. Il modo migliore per gestirli è usare il metodo str.strip() su una series.
# Example utilizes a pandas series
# If working with a dataframe, call the series using df[col] syntax
s = pd.Series(['1. Ant.  ', '2. Bee!\n', '3. Cat?\t', np.nan, 10, True])
# It is important to include the .str or else the method will not work
s.str.strip()
Eliminare i valori null in Pandas è semplice. Più avanti parleremo di come riempirli. Puoi usare il metodo dropna(). Sono disponibili parametri opzionali per definire le condizioni esatte che eliminano una riga/colonna, ma il comportamento predefinito è rimuovere qualsiasi riga con valori null.
# For any dataframe
df = pd.DataFrame({"name": ['Alfred', 'Batman', 'Catwoman'],
                   "toy": [np.nan, 'Batmobile', 'Bullwhip'],
                   "born": [pd.NaT, pd.Timestamp("1940-04-25"), pd.NaT]}
df.dropna()
Il metodo .astype() consente di cambiare il tipo di dato di una series, ma correggere i tipi è un po’ più delicato perché devi assicurarti che ogni valore nella series Pandas corrisponda a quel tipo.
Per esempio, convertire una series di tipo object in intero implica che ogni valore sia un intero. Se c’è anche un solo valore che non lo è, il metodo andrà in errore. Puoi scegliere di forzare la conversione trasformando i valori non validi in null, ma potrebbe valere la pena indagare perché certi valori non vengono convertiti.
Unire DataFrame in Pandas è simile alle join in SQL. Il comportamento predefinito di merge() è una inner join. Tuttavia, effettua la join anche su valori null, quindi fai attenzione. Per eseguire una merge devi usare una chiave specifica. Puoi unire su varie colonne o persino sull’indice.
# Create two dataframes
df1 = pd.DataFrame({'lkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [1, 2, 3, 5]})
df2 = pd.DataFrame({'rkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [5, 6, 7, 8]})
# merge the df1 DataFrame to the df2 DataFrame using the columns key and rkey as keys
df1.merge(df2, left_on='lkey', right_on='rkey')
Il codice sopra unirà i due DataFrame in base alle chiavi corrispondenti nelle colonne lkey e rkey. I valori non corrispondenti verranno scartati e rimarranno solo quelli corrispondenti. Puoi però cambiare il tipo di merge e scegliere una left/right/outer merge. È uno strumento potente che permette di riunire diversi dataset da varie fonti.
Per i valori mancanti, la metodologia esatta può variare a seconda del caso d’uso. Quando parliamo di valori mancanti, dobbiamo considerare perché mancano. Se il valore manca per errori tecnici, forse è meglio correggere l’errore prima di analizzare i dati e vedere se si possono recuperare dati storici.
A volte possiamo usare il resto dei dati e semplicemente ignorare il valore mancante. Se i dati storici sono importanti e irrecuperabili, dobbiamo riempire i mancanti. Vediamo come farlo.
Il metodo principale per riempire i dati è fillna() di Pandas. Per le stringhe, può essere usato per riempire i null, ad esempio: df.fillna(value=’missing’), che potrebbe bastare! Il bello di questo metodo è che possiamo essere creativi. Combinando fillna() con varie funzioni NumPy come mean(), median() e funzioni lambda, possiamo riempire i mancanti in modo matematico.
In alternativa, esistono anche metodi Pandas come interpolate() che possono colmare le lacune in modo algoritmico se i dati sono ordinati (ad es. nel tempo). L’obiettivo è riempire i dati nel modo più accurato possibile, così da riflettere la realtà.
Eseguire data wrangling in SQL può essere un modo efficace di processare i dati, soprattutto se il database SQL è nel cloud. Questo limita la quantità di dati elaborati sulla tua macchina locale e il traffico in ingresso/uscita sulla rete.
Nel data wrangling con SQL l’attenzione principale è limitare il perimetro dei dati che scorrono nelle pipeline tramite corretta estrazione, trasformazione e caricamento. Alcuni modi per farlo sono filtrare i dati, unire tabelle di riferimento ed eseguire aggregazioni.
Il modo principale per filtrare le tabelle in SQL è usare la clausola WHERE. È piuttosto semplice da usare ma estremamente potente. Le condizioni possono essere semplici uguaglianze, ricerche di stringhe simili o anche subquery. Puoi combinare più clausole con AND e OR!
Un filtro basato su casi semplici, come cercare un valore specifico di una colonna, può apparire così:
SELECT *
FROM sample_table
WHERE sample_col = 23
Utilizzare istruzioni più complesse come LIKE o IN dà flessibilità alle clausole WHERE. Ad esempio, la query seguente cerca persone il cui nome inizia con J grazie al wildcard % e il cui cognome è IN nell’elenco fornito.
SELECT *
FROM sample_table
WHERE name LIKE ‘J%’ /* looks for people whose name starts with J */
AND last_name IN (‘Smith’, ‘Rockefeller’, ‘Williams’) /* Looks for people whose last name is in this list */
Infine, usare subquery offre ulteriore flessibilità al filtraggio. Può basarsi sui risultati di un’altra tabella. Un esempio comune è trovare un elenco di ID cliente dopo una certa data/ora.
SELECT *
FROM sample_table
WHERE customer_id IN (SELECT id FROM reference_table WHERE date >= ‘2024-01-01’)
Usare una combinazione di queste tecniche garantisce che gli input siano esattamente quelli desiderati e che le dimensioni dei dataset siano minimizzate. Un uso molto potente dei filtri è rimuovere i duplicati dal dataset. Tecniche più avanzate includono i filtri HAVING per le aggregazioni e le istruzioni QUALIFY con funzioni finestra.
Le join tra tabelle permettono di raccogliere informazioni aggiuntive utili per i dataset. SQL offre varie join come INNER, OUTER, LEFT e RIGHT. Con le INNER e OUTER decidiamo quali dati mantenere: INNER mantiene solo i dati con corrispondenza su entrambi i lati, mentre OUTER mantiene anche i non corrispondenti a seconda del lato (left o right).
La LEFT join mantiene i dati della tabella a sinistra della join e la RIGHT quelli della tabella a destra. Puoi combinare LEFT e RIGHT con INNER e OUTER, così come usare la speciale FULL OUTER JOIN che unisce tutti i dati di entrambe le tabelle.
Ecco un esempio di join:
SELECT *
FROM a
LEFT OUTER JOIN
b
WHERE a.id = b.id
Nell’istruzione sopra, la tabella a è a sinistra (prima) e la tabella b a destra (seconda). La LEFT OUTER JOIN dice di unire i dati di a e b dove a.id = b.id, ma se non c’è corrispondenza mantieni tutti i dati di a. Le join sono strumenti potenti per portare dati aggiuntivi necessari all’input.
Un ultimo strumento che possiamo usare in SQL per il data wrangling è la clausola GROUP BY per eseguire aggregazioni. Semplifica i dati e consente un pre-processing prima di inviarli più avanti nella pipeline. L’aggregazione è potente per calcolare statistiche riepilogative. Ecco un esempio in cui osserviamo il totale delle vendite per ID cliente:
SELECT
Customer_ID,
SUM(sales)
FROM sample_table
GROUP BY Customer_ID
Esistono numerose funzioni di aggregazione come SUM, MEAN, MAX e MIN che consentono di comprendere rapidamente i dati. Sfruttare le aggregazioni semplifica l’ingresso dei dati nelle pipeline.
Questa sezione copre alcuni esempi pratici e casi d’uso delle tecniche di data wrangling. Gli obiettivi principali sono: standardizzare i dati, unire fonti diverse ed elaborare testo.
Standardizzare i dati nelle stesse unità è importante. Se si lavora con dati che misurano la stessa cosa in unità diverse o in valute differenti, potrebbero sorgere problemi nell’analisi.
Vedremo un semplice esempio di conversione di valute diverse in USD in SQL. Supponiamo di avere due tabelle. La Tabella 1 è una tabella sales con le vendite di prodotti per varie regioni e la Tabella 2 è currency_exchange con i tassi di cambio per varie regioni e giorni. Un esempio di conversione potrebbe essere:
SELECT
a.sale_id,
a.region,
CASE WHEN region <> ‘US’
	THEN a.sale_price * b.exchange_rate
	ELSE a.sale_price
END AS sale_price
FROM sales AS a
LEFT OUTER JOIN
currency_exchange AS b
WHERE a.region = b.region
Questo prende sale_id e region dalla tabella sales e fa una join con la tabella di riferimento currency_exchange sulla regione per ottenere il tasso di cambio. Spesso si include anche la data per ottenere il tasso di cambio del giorno.
Una parte importante del data wrangling è preparare i dati per i modelli di machine learning. Di recente, molti modelli si sono concentrati sull’elaborazione del linguaggio naturale e un passo preliminare è l’analisi del sentiment tramite dati testuali.
Un passaggio critico è la preparazione del testo tramite normalizzazione e rimozione della punteggiatura. Poiché punteggiatura e maiuscole potrebbero non apportare contesto importante a un modello, spesso è meglio normalizzare.
Per farlo, useremo pacchetti Python di base e il pacchetto re. Qui sotto un esempio per rimuovere la punteggiatura, normalizzare il testo togliendo le maiuscole e tagliare gli spazi vuoti.
# import regex
import re

# input string
test_string = "       Python 3.0, released in 2008, was a major revision of the language that is not completely backward compatible and much Python 2 code does not run unmodified on Python 3. With Python 2's end-of-life, only Python 3.6.x[30] and later are supported, with older versions still supporting e.g. Windows 7 (and old installers not restricted to 64-bit Windows)."
# remove whitespaces
no_space_string = test_string.strip()

# convert to lower case
lower_string = no_space_string .lower()

# remove numbers
no_number_string = re.sub(r'\d+','',lower_string)
print(no_number_string)
Lo snippet qui sopra offre un’ottima base per rimuovere spazi bianchi, convertire i caratteri in minuscolo e rimuovere numeri/dati non alfabetici.
Il data wrangling è un componente fondamentale per preparare i dati ai modelli di machine learning e all’analisi. Esistono numerosi strumenti in Python, come i pacchetti pandas e numpy, insieme a varie tecniche SQL come le clausole WHERE e GROUP BY, che consentono di preparare i dati.
La padronanza di queste tecniche è cruciale per chiunque aspiri a una carriera nei dati. Se vuoi approfondire il data wrangling, considera le seguenti risorse:
I migliori corsi DataCamp
Corso
Corso
Programma
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min