Courses
Nhập dữ liệu vào Python: Giới thiệu
3 giờ
340.7K
Với khối lượng, đa dạng và tốc độ dữ liệu ngày càng tăng, việc tập trung xây dựng các bộ dữ liệu chất lượng và có cấu trúc tốt trở nên quan trọng hơn bao giờ hết, vì chúng ảnh hưởng trực tiếp đến độ chính xác của thông tin chuyên sâu và hiệu quả của các quyết định trong nhiều ngành.
Dữ liệu tổ chức kém hoặc có lỗi có thể dẫn đến kết luận sai lệch, gây tốn thời gian, tiền bạc và nguồn lực. Đây là lúc data wrangling trở thành quy trình thiết yếu nhằm chuyển đổi dữ liệu thô, không có cấu trúc thành định dạng sạch, có tổ chức, sẵn sàng cho phân tích.
Data wrangling bao gồm một loạt bước để đảm bảo dữ liệu chính xác, đáng tin cậy và phù hợp với nhu cầu cụ thể của phân tích. Nắm vững data wrangling giúp bạn khai thác tối đa tiềm năng dữ liệu, biến dữ liệu thành thông tin có thể hành động để đưa ra quyết định sáng suốt và dẫn đến thành công.
Data wrangling là quá trình chuyển đổi dữ liệu thô thành định dạng dễ sử dụng hơn. Quá trình này gồm làm sạch, cấu trúc và làm giàu dữ liệu để dữ liệu sẵn sàng cho phân tích.
Hãy tưởng tượng bạn vừa nhận được một bộ dữ liệu khổng lồ—mọi thứ lộn xộn, thiếu giá trị, không nhất quán và có nhiều thông tin không liên quan. Data wrangling giống như một bộ dụng cụ giúp bạn dọn dẹp dữ liệu này, đảm bảo dữ liệu được tổ chức và nhất quán.
Data wrangling quan trọng để đảm bảo dữ liệu có chất lượng cao và cấu trúc tốt, điều then chốt cho phân tích dữ liệu chính xác. Dữ liệu sạch, có cấu trúc là nền tảng cho mọi bước tiếp theo trong quy trình dữ liệu—dù bạn đang xây dựng mô hình học máy, tạo trực quan hóa hay thực hiện phân tích thống kê.
Dữ liệu chất lượng cao giúp giảm rủi ro sai sót và thiên lệch trong phân tích, từ đó mang lại thông tin chuyên sâu đáng tin cậy hơn. Hiểu được tầm quan trọng của data wrangling là chìa khóa vì nó tác động trực tiếp đến tính hợp lệ của các quyết định dựa trên dữ liệu đó.
Data wrangling kém có thể dẫn đến kết luận sai, gây hậu quả đáng kể trong các ứng dụng thực tế. Do đó, nắm vững data wrangling là điều thiết yếu với bất kỳ ai nghiêm túc về việc ra quyết định dựa trên dữ liệu.
Có 5 bước chính trong data wrangling:
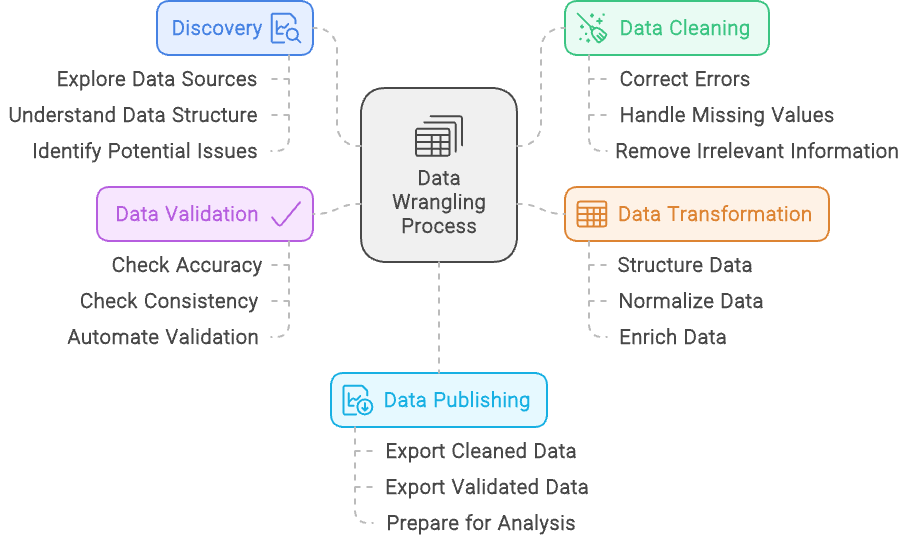
Quy trình data wrangling - được tạo với Napkin.ai
Chúng ta đã điểm qua năm bước của data wrangling, giờ hãy xem chi tiết từng bước:
Bước khám phá trong data wrangling giống như xem qua một bức tranh ghép trước khi bắt đầu ráp các mảnh lại. Nó bao gồm việc xem xét bộ dữ liệu để nắm rõ bạn đang làm việc với gì, gồm loại dữ liệu, nguồn gốc và cách dữ liệu được cấu trúc.
Cũng như bạn có thể phân loại các mảnh ghép theo màu hoặc theo cạnh, bước khám phá giúp phân loại và nhận ra các mẫu trong dữ liệu, đặt nền tảng cho công việc tiếp theo.
Nhưng khám phá cũng là để phát hiện các vấn đề tiềm ẩn—như thiếu mảnh hoặc màu không khớp trong bức tranh ghép.
Trong bước này, bạn xác định các vấn đề trong dữ liệu như không nhất quán, thiếu giá trị hoặc các mẫu bất ngờ. Bằng cách phát hiện sớm những thách thức này, bạn có thể lập kế hoạch xử lý ở các bước tiếp theo của data wrangling, đảm bảo con đường trơn tru để có bộ dữ liệu sạch, dùng được.
Làm sạch dữ liệu là tinh chỉnh bộ dữ liệu để đảm bảo tính chính xác và độ tin cậy.
Quy trình này bao gồm khắc phục các vấn đề như sửa lỗi, xử lý giá trị thiếu và chỉnh sửa điểm không nhất quán. Ví dụ, nếu bộ dữ liệu có bản ghi trùng lặp cho cùng một cá nhân hoặc giao dịch, làm sạch dữ liệu sẽ loại bỏ các bản ghi trùng để tránh sai lệch kết quả.
Ngoài ra, nếu bạn thấy một số mục bị sai định dạng, như số điện thoại ở nhiều định dạng khác nhau, bạn sẽ chuẩn hóa chúng về một định dạng nhất quán. Mục tiêu là nâng cao chất lượng và tính toàn vẹn của dữ liệu, giúp dữ liệu sẵn sàng cho phân tích chính xác và có ý nghĩa.
Chuyển đổi dữ liệu là quá trình sửa đổi và tăng cường bộ dữ liệu để phù hợp hơn với yêu cầu phân tích. Bước này bao gồm cấu trúc dữ liệu, như biến đổi hình dạng để phù hợp định dạng mong muốn hoặc kết hợp nhiều nguồn thành một cấu trúc thống nhất.
Chuẩn hóa dữ liệu là một khía cạnh quan trọng khác, nghĩa là điều chỉnh các giá trị về cùng một thang đo hoặc định dạng, như quy đổi tất cả giá trị tiền tệ về một loại tiền hoặc chuẩn hóa đơn vị đo lường.
Ngoài ra, chuyển đổi dữ liệu còn bao gồm làm giàu bộ dữ liệu bằng cách thêm biến mới hoặc tích hợp các nguồn dữ liệu bên ngoài để cung cấp thêm ngữ cảnh hoặc thông tin. Ví dụ, bạn có thể tính các chỉ số mới dựa trên dữ liệu hiện có hoặc nối thêm thông tin từ cơ sở dữ liệu khác để có bức tranh đầy đủ hơn.
Mục tiêu của chuyển đổi dữ liệu là chuẩn bị dữ liệu theo cách nâng cao khả năng sử dụng và mức độ phù hợp cho phân tích chuyên sâu.
Xác thực dữ liệu là đảm bảo độ chính xác và độ tin cậy của bộ dữ liệu thông qua các kiểm tra có hệ thống và quy trình tự động. Bước này rất quan trọng để xác nhận dữ liệu vừa đúng vừa nhất quán.
Trong xác thực dữ liệu, bạn thực hiện nhiều kiểm tra để phát hiện sai lệch, như so sánh với các chuẩn đã biết hoặc xác thực theo quy tắc và ràng buộc định sẵn. Quy trình tự động có thể gồm chạy các script gắn cờ bất thường hoặc không nhất quán, đảm bảo dữ liệu tuân theo định dạng và phạm vi mong đợi.
Mục tiêu của xác thực dữ liệu là phát hiện vấn đề trước khi dữ liệu được dùng để phân tích, ngăn lỗi ảnh hưởng đến kết quả. Kiểm chứng chặt chẽ độ chính xác và độ tin cậy của dữ liệu giúp đảm bảo các thông tin rút ra dựa trên dữ liệu đáng tin cậy.
Công bố dữ liệu là bước cuối cùng trong quy trình data wrangling, nơi dữ liệu đã làm sạch và cấu trúc được cung cấp cho phân tích và ra quyết định. Bước này bao gồm chuẩn bị dữ liệu để phổ biến, thường bằng cách tạo bảng điều khiển, báo cáo hoặc trực quan hóa tương tác giúp các bên liên quan dễ tiếp cận và hiểu được.
Trong công bố dữ liệu, bạn có thể thiết lập các pipeline hoặc giao diện cho phép người dùng truy vấn và tương tác với dữ liệu, đảm bảo dữ liệu được phân phối theo định dạng đáp ứng nhu cầu của họ.
Mục tiêu là cung cấp thông tin rõ ràng, có thể hành động từ dữ liệu, hỗ trợ ra quyết định sáng suốt và tạo điều kiện truyền đạt phát hiện trong toàn tổ chức. Công bố dữ liệu hiệu quả giúp nỗ lực data wrangling chuyển hóa thành kết quả thiết thực và có ý nghĩa.
Thuật ngữ data wrangling và data cleaning thường được dùng thay thế cho nhau, nhưng chúng đề cập đến các khía cạnh khác nhau của quy trình chuẩn bị dữ liệu. Dù cả hai đều thiết yếu để chuẩn bị dữ liệu cho phân tích, chúng phục vụ mục đích khác nhau và bao gồm các nhiệm vụ khác nhau. Hiểu sự khác biệt giúp làm rõ vai trò của từng phần và đảm bảo mỗi khía cạnh của chuẩn bị dữ liệu được xử lý hiệu quả.
Data Wrangling là một quy trình toàn diện nhằm chuyển đổi dữ liệu thô thành định dạng phù hợp phân tích. Nó bao gồm nhiều giai đoạn: thu thập dữ liệu, cấu trúc, làm sạch và xác thực. Mục tiêu của data wrangling là chuẩn bị dữ liệu từ nhiều nguồn để có thể phân tích hiệu quả và tạo ra thông tin chuyên sâu. Quy trình này đảm bảo dữ liệu được tổ chức, chính xác và sẵn sàng cho phân tích chi tiết.
Data Cleaning, mặt khác, là một phần cụ thể trong data wrangling. Nó chỉ tập trung cải thiện chất lượng dữ liệu bằng cách xử lý và sửa lỗi cùng điểm không nhất quán. Bao gồm các tác vụ như xóa bản ghi trùng, sửa lỗi chính tả, xử lý giá trị thiếu và chuẩn hóa định dạng dữ liệu. Dù làm sạch dữ liệu là phần quan trọng của data wrangling, nó chỉ là một bước trong quy trình rộng hơn.
Nói ngắn gọn, data wrangling là khuôn khổ tổng thể để chuẩn bị dữ liệu cho phân tích, bao gồm nhiều bước xử lý các khía cạnh khác nhau của chuẩn bị dữ liệu. Data cleaning là thành phần không thể thiếu trong khuôn khổ này, chuyên biệt để nâng cao độ chính xác và tính nhất quán của dữ liệu.
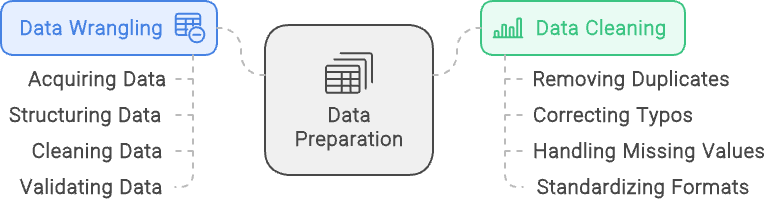
Data Wrangling vs Data Cleaning: Data Wrangling tập trung vào cấu trúc và xác thực dữ liệu trong khi Data Cleaning tập trung đảm bảo dữ liệu sạch và chất lượng. Hình được tạo với napkin.ai
Có nhiều cách thực hiện data wrangling, hoặc thông qua các công cụ GUI cơ bản như Excel hay Alteryx, hoặc bằng mã với các ngôn ngữ như R và Python. Chúng ta sẽ khám phá một vài lựa chọn tại đây.
Với các tác vụ data wrangling đơn giản, bảng tính như Microsoft Excel và Google Sheets thường là lựa chọn phổ biến. Các công cụ này rất dễ tiếp cận và giao diện quen thuộc, lý tưởng để sắp xếp, lọc và làm sạch dữ liệu cơ bản. Bảng tính đặc biệt hữu ích với bộ dữ liệu nhỏ hoặc cho người mới học data wrangling.
Với các hàm và công thức tích hợp sẵn, chúng cho phép người dùng nhanh chóng tính toán và thao tác dữ liệu mà không cần kiến thức kỹ thuật sâu.
Với các thao tác phức tạp và tự động hóa, các ngôn ngữ như Python và R được sử dụng rộng rãi. Python với các thư viện mạnh như Pandas, NumPy và OpenRefine, rất xuất sắc trong xử lý bộ dữ liệu lớn và thực hiện các chuyển đổi dữ liệu phức tạp.
R, với các gói như dplyr và tidyr, cũng là lựa chọn mạnh mẽ, đặc biệt được ưa chuộng trong cộng đồng thống kê và học thuật nhờ khả năng phân tích dữ liệu vững chắc. Cả hai ngôn ngữ đều rất linh hoạt, cho phép viết kịch bản tùy biến và tự động hóa tác vụ lặp lại, phù hợp với nhu cầu data wrangling phức tạp.
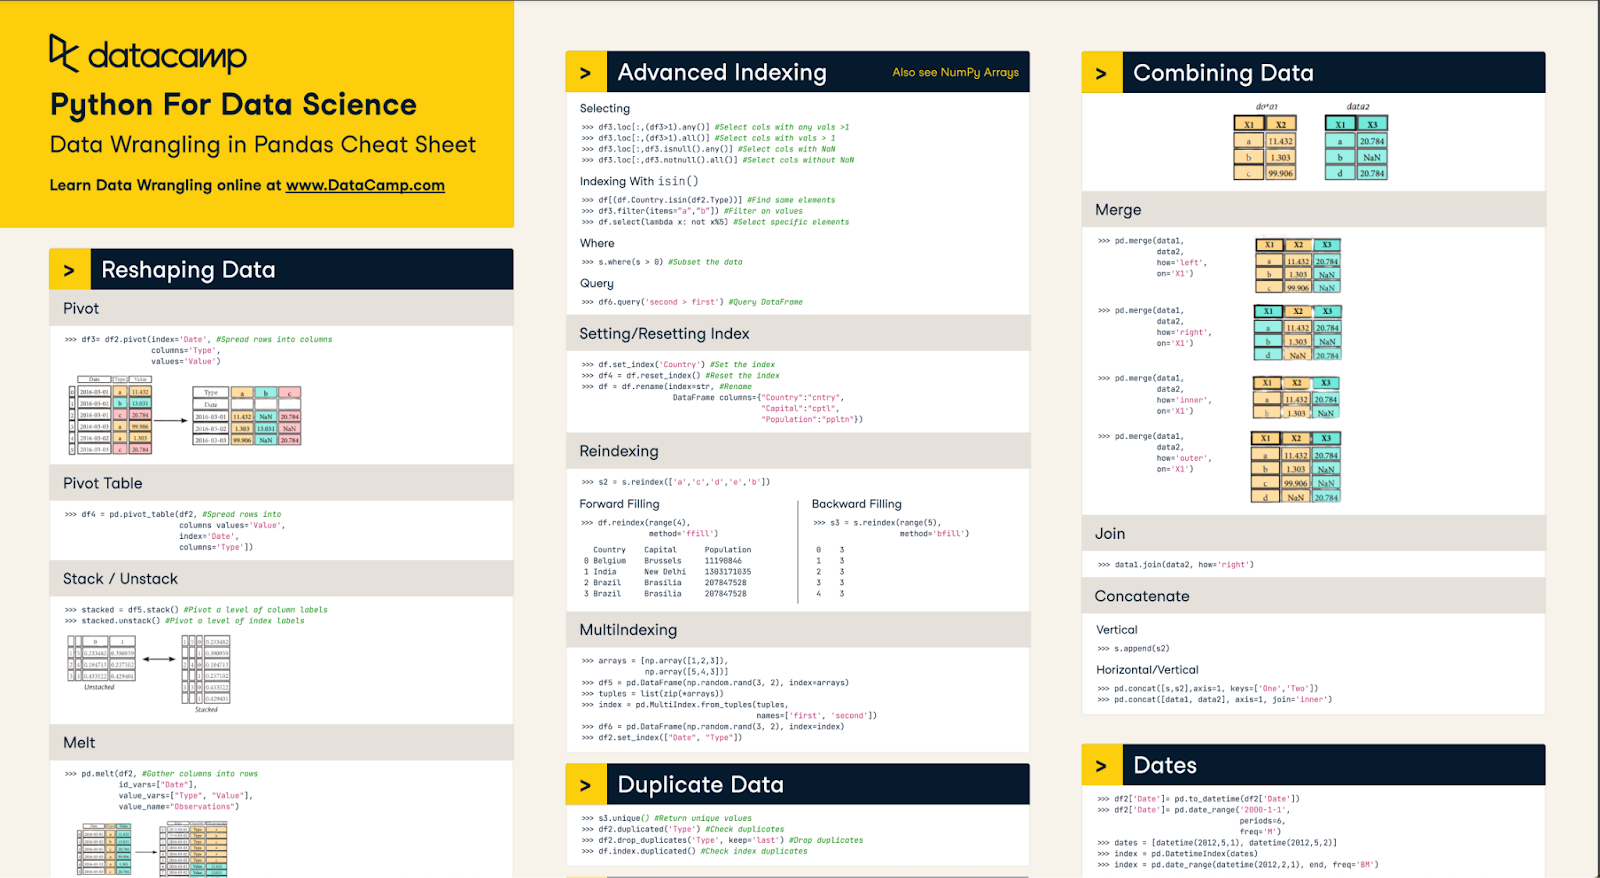
Tài liệu Cheat Sheet Data Wrangling trong Pandas của chúng tôi có thể giúp bạn nắm vững nhiều kiến thức cơ bản
Các công cụ phần mềm chuyên dụng được thiết kế đặc biệt để tinh gọn quy trình data wrangling, cung cấp tính năng nâng cao giúp đơn giản hóa các tác vụ dữ liệu phức tạp. Chúng lý tưởng cho người dùng cần giải pháp mạnh mẽ nhưng thân thiện để làm sạch, cấu trúc và chuẩn bị dữ liệu cho phân tích mà không cần nhiều mã.
Alteryx là công cụ hàng đầu trong nhóm này, nổi tiếng với giao diện kéo‑thả trực quan cho phép người dùng dễ dàng làm sạch, trộn và chuyển đổi dữ liệu từ nhiều nguồn. Nó đi kèm nhiều công cụ dựng sẵn cho thao tác dữ liệu, giúp việc lọc, nối và tổng hợp dữ liệu trở nên đơn giản.
Phiên bản đám mây Alteryx Designer Cloud còn tăng cường khả năng bằng nền tảng mở rộng, cộng tác cho data wrangling. Giải pháp này cho phép nhóm làm việc thời gian thực, xử lý bộ dữ liệu lớn và quy trình phức tạp hiệu quả trên nhiều môi trường. Dù dùng tại chỗ hay trên đám mây, Alteryx đảm bảo dữ liệu được chuẩn bị chính xác và sẵn sàng cho phân tích chuyên sâu.
Với các dự án dữ liệu toàn diện cần giải pháp đầu‑cuối, các nền tảng tích hợp như KNIME, Apache NiFi và Microsoft Power BI thường được sử dụng. Các nền tảng này không chỉ hỗ trợ data wrangling mà còn cung cấp công cụ tích hợp, phân tích và trực quan hóa dữ liệu trong một môi trường duy nhất.
KNIME, chẳng hạn, nổi tiếng với giao diện dạng node theo mô‑đun cho phép người dùng xây dựng quy trình phức tạp bằng trực quan. Apache NiFi vượt trội trong quản lý và tự động hóa luồng dữ liệu giữa các hệ thống, còn Power BI kết hợp chuẩn bị dữ liệu với khả năng trực quan hóa mạnh. Đây là các nền tảng lý tưởng cho dự án cần chuẩn bị, phân tích và chia sẻ dữ liệu liền mạch, mang lại cách tiếp cận tổng thể cho quyết định dựa trên dữ liệu.
Có nhiều lựa chọn khi thực hiện data wrangling với Python. Hai gói chính được dùng là Pandas và NumPy. Hai gói này có công cụ mạnh cho phép người dùng dễ dàng thực hiện các kỹ thuật data wrangling chủ chốt trên bộ dữ liệu của mình.
Rất nhiều xử lý dữ liệu diễn ra trong Python nên nắm vững các gói này là điều thiết yếu với mọi nhà thực hành dữ liệu. Dù có nhiều kỹ thuật, một số điểm then chốt cần biết là cách làm sạch dữ liệu ở mức cao (ví dụ loại bỏ giá trị null), gộp bộ dữ liệu và xử lý giá trị thiếu.
Có rất nhiều trường hợp dữ liệu cần được làm sạch trong Python trước khi sử dụng. Điều này có thể gồm loại bỏ khoảng trắng thừa ở cuối/đầu chuỗi, loại bỏ giá trị null hoặc chỉnh kiểu dữ liệu, v.v.
Mỗi bộ dữ liệu khác nhau và có nhu cầu riêng nên hãy khám phá để hiểu liệu cần làm sạch bổ sung không. Luyện tập các kỹ thuật và kỹ năng mã hóa khác nhau là cách tuyệt vời để học mọi cách chúng ta có thể làm sạch dữ liệu trong Python.
Khi dọn dẹp chuỗi, một trong các vấn đề thường gặp là khoảng trắng ở đầu/cuối. Điều này có thể gây lỗi khi phân tích chuỗi theo độ dài, vị trí hoặc đối sánh. Cách xử lý tốt nhất là dùng phương thức str.strip() trên series.
# Example utilizes a pandas series
# If working with a dataframe, call the series using df[col] syntax
s = pd.Series(['1. Ant.  ', '2. Bee!\n', '3. Cat?\t', np.nan, 10, True])
# It is important to include the .str or else the method will not work
s.str.strip()
Loại bỏ giá trị null trong Pandas rất dễ. Chúng ta sẽ bàn cách điền giá trị null sau trong bài viết. Bạn có thể dùng phương thức dropna(). Có các tham số tùy chọn cho phép bạn chọn điều kiện chính xác để loại bỏ hàng/cột nhưng mặc định là loại mọi hàng có bất kỳ giá trị null nào
# For any dataframe
df = pd.DataFrame({"name": ['Alfred', 'Batman', 'Catwoman'],
                   "toy": [np.nan, 'Batmobile', 'Bullwhip'],
                   "born": [pd.NaT, pd.Timestamp("1940-04-25"), pd.NaT]}
df.dropna()
Phương thức .astype() cho phép người dùng đổi kiểu dữ liệu của một series, nhưng việc chỉnh kiểu dữ liệu khó hơn một chút vì bạn phải đảm bảo mọi giá trị trong series Pandas khớp kiểu dữ liệu đó.
Ví dụ, chuyển một series có kiểu object sang số nguyên nghĩa là bạn biết mọi giá trị đều là số nguyên. Nếu có một giá trị không phải số nguyên, phương thức sẽ báo lỗi. Bạn có thể ép về null với tùy chọn coerce cho các giá trị không hợp lệ, nhưng có thể đáng để điều tra vì sao một số giá trị không được chuyển đổi.
Gộp DataFrame trong Pandas tương tự join trong SQL. Hành vi mặc định của merge() trong Pandas là inner join. Tuy nhiên, nó vẫn join trên giá trị null nên hãy cẩn thận. Thực hiện merge cần dùng một khóa cụ thể. Bạn có thể join trên nhiều cột hoặc thậm chí chỉ số (index).
# Create two dataframes
df1 = pd.DataFrame({'lkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [1, 2, 3, 5]})
df2 = pd.DataFrame({'rkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [5, 6, 7, 8]})
# merge the df1 DataFrame to the df2 DataFrame using the columns key and rkey as keys
df1.merge(df2, left_on='lkey', right_on='rkey')
Đoạn mã trên sẽ gộp hai DataFrame dựa trên khóa khớp nhau ở cột lkey và rkey tương ứng. Giá trị không khớp sẽ bị loại và bạn chỉ còn giá trị khớp. Tuy nhiên, bạn có thể thay đổi hành vi merge và chọn left/right/outer merge. Đây là công cụ mạnh giúp nhà khoa học dữ liệu kết hợp các bộ dữ liệu từ nhiều nguồn.
Với giá trị thiếu, phương pháp cụ thể có thể khác nhau tùy trường hợp kinh doanh. Khi nói về giá trị thiếu, ta phải cân nhắc vì sao giá trị bị thiếu. Nếu do lỗi kỹ thuật, có lẽ nên sửa lỗi kỹ thuật trước khi phân tích và xem có thể khôi phục dữ liệu lịch sử không.
Đôi khi, ta có thể dùng phần dữ liệu còn lại và đơn giản là bỏ qua giá trị thiếu. Nếu dữ liệu lịch sử quan trọng và không thể khôi phục, ta phải điền dữ liệu thiếu. Hãy thảo luận cách điền thông tin bị thiếu.
Phương thức chính để điền dữ liệu là dùng fillna() của Pandas. Với giá trị chuỗi, có thể dùng để điền null, ví dụ: df.fillna(value='missing') — có thể là đủ! Điều thú vị là ta có thể linh hoạt. Kết hợp fillna() của Pandas với nhiều phương thức của NumPy như mean(), median() và hàm lambda, ta có thể điền giá trị thiếu theo cách toán học.
Ngoài ra, còn có phương thức interpolate() trong Pandas có thể thuật toán hóa việc lấp khoảng trống nếu dữ liệu có thứ tự (ví dụ theo thời gian). Mục tiêu là điền dữ liệu chính xác nhất có thể để phản ánh dữ liệu thực.
Thực hiện data wrangling trong SQL có thể là cách hiệu quả để xử lý dữ liệu, đặc biệt nếu cơ sở dữ liệu SQL của bạn nằm trên đám mây. Điều này hạn chế lượng dữ liệu xử lý trên máy cục bộ và lượng dữ liệu đi/đến qua mạng.
Trọng tâm của data wrangling trong SQL là giới hạn phạm vi dữ liệu chảy qua pipeline bằng trích xuất, chuyển đổi và nạp dữ liệu đúng cách. Một số cách quản lý là lọc dữ liệu, join với bảng tham chiếu và thực hiện tổng hợp.
Cách chủ yếu để lọc bảng trong SQL là dùng mệnh đề WHERE. Nó khá đơn giản để dùng nhưng cực kỳ mạnh. Điều kiện có thể là các mệnh đề bằng nhau đơn giản, tìm chuỗi tương tự hoặc thậm chí dùng các truy vấn con khác. Bạn cũng có thể kết hợp nhiều điều kiện WHERE bằng AND và OR!
Lọc theo các trường hợp đơn giản như tìm một giá trị cụ thể của cột có thể như sau:
SELECT *
FROM sample_table
WHERE sample_col = 23
Dùng các mệnh đề phức tạp hơn như LIKE hoặc IN có thể tăng tính linh hoạt cho WHERE. Ví dụ, truy vấn sau tìm những người có tên bắt đầu bằng J nhờ wildcard % và họ nằm IN danh sách cung cấp.
SELECT *
FROM sample_table
WHERE name LIKE ‘J%’ /* looks for people whose name starts with J */
AND last_name IN (‘Smith’, ‘Rockefeller’, ‘Williams’) /* Looks for people whose last name is in this list */
Cuối cùng, dùng truy vấn con khác có thể tăng linh hoạt cho lọc—nó có thể dựa trên kết quả của bảng khác. Ví dụ phổ biến là tìm danh sách mã khách hàng sau một thời điểm cụ thể.
SELECT *
FROM sample_table
WHERE customer_id IN (SELECT id FROM reference_table WHERE date >= ‘2024-01-01’)
Kết hợp các kỹ thuật này đảm bảo đầu vào dữ liệu đúng như mong muốn và kích thước bộ dữ liệu có thể được tối thiểu hóa. Một cách dùng bộ lọc rất mạnh là loại bỏ bản ghi trùng và làm sạch dữ liệu theo cách đó. Một số kỹ thuật nâng cao khác là bộ lọc HAVING cho tổng hợp và mệnh đề QUALIFY với hàm cửa sổ.
Thực hiện join bảng cho phép thu thập thêm thông tin cần cho bộ dữ liệu. SQL có nhiều loại join như INNER, OUTER, LEFT và RIGHT. Với INNER và OUTER, ta quyết định dữ liệu nào được giữ. INNER giữ dữ liệu chỉ khi có khớp ở cả hai phía, trong khi OUTER giữ cả dữ liệu không khớp tùy phía join (trái hoặc phải).
Join LEFT giữ dữ liệu phía trái của join và RIGHT giữ dữ liệu phía phải. Bạn kết hợp LEFT và RIGHT với INNER và OUTER, cũng như FULL OUTER JOIN đặc biệt—nối toàn bộ dữ liệu từ cả hai bảng.
Một ví dụ join có thể là:
SELECT *
FROM a
LEFT OUTER JOIN
b
WHERE a.id = b.id
Câu lệnh trên có bảng a ở bên trái (vì đứng trước) và bảng b ở bên phải (vì đứng sau). LEFT OUTER JOIN nghĩa là join dữ liệu từ bảng a và b nơi a.id = b.id, nhưng nếu không khớp thì vẫn giữ toàn bộ dữ liệu từ bảng a. Join là công cụ mạnh để đưa thêm dữ liệu cần thiết vào đầu vào dữ liệu của bạn.
Một công cụ cuối cùng có thể dùng trong SQL cho data wrangling là mệnh đề GROUP BY để tổng hợp. Điều này đơn giản hóa dữ liệu và cho phép tiền xử lý phần nào trước khi đẩy tiếp xuống pipeline. Tổng hợp là công cụ mạnh để tính thống kê tóm tắt. Đây là ví dụ tính tổng doanh số theo mã khách hàng:
SELECT
Customer_ID,
SUM(sales)
FROM sample_table
GROUP BY Customer_ID
Có nhiều hàm tổng hợp như SUM, MEAN, MAX và MIN cho phép nhanh chóng hiểu dữ liệu. Tận dụng tổng hợp giúp đơn giản hóa dữ liệu đưa vào pipeline.
Phần này sẽ đề cập một số ví dụ thực tiễn và trường hợp sử dụng cho các kỹ thuật data wrangling. Các mục tiêu chính tập trung gồm: tiêu chuẩn hóa dữ liệu, gộp nguồn dữ liệu và xử lý văn bản.
Chuẩn hóa dữ liệu về cùng đơn vị là quan trọng. Nếu làm việc với dữ liệu đo cùng một đại lượng nhưng ở đơn vị khác nhau hoặc khác biệt tiền tệ, điều đó có thể gây vấn đề trong phân tích.
Chúng ta sẽ đề cập ví dụ đơn giản quy đổi tiền tệ khác nhau về USD trong SQL. Giả sử có hai bảng. Bảng 1 là bảng sales có doanh số sản phẩm theo khu vực và Bảng 2 là currency_exchange chứa tỷ giá cho các khu vực theo ngày. Ví dụ quy đổi có thể như sau:
SELECT
a.sale_id,
a.region,
CASE WHEN region <> ‘US’
	THEN a.sale_price * b.exchange_rate
	ELSE a.sale_price
END AS sale_price
FROM sales AS a
LEFT OUTER JOIN
currency_exchange AS b
WHERE a.region = b.region
Điều này lấy sale_id và region từ bảng sales và join với bảng tham chiếu currency_exchange theo khu vực để lấy tỷ giá. Thường sẽ có thêm ngày để lấy tỷ giá theo ngày.
Một phần quan trọng của data wrangling là xử lý dữ liệu cho các mô hình học máy. Gần đây, nhiều mô hình tập trung vào xử lý ngôn ngữ tự nhiên và một bước tiền đề là phân tích cảm xúc qua dữ liệu văn bản.
Bước then chốt là chuẩn bị văn bản bằng cách chuẩn hóa và loại bỏ dấu câu. Vì dấu câu và viết hoa có thể không mang ngữ cảnh quan trọng cho mô hình học máy, thường tốt hơn là chuẩn hóa.
Để làm điều này, chúng ta sẽ dùng các gói Python cơ bản và gói re. Xem ví dụ dưới về cách loại bỏ dấu câu, chuẩn hóa văn bản về chữ thường và cắt khoảng trắng thừa.
# import regex
import re

# input string
test_string = "       Python 3.0, released in 2008, was a major revision of the language that is not completely backward compatible and much Python 2 code does not run unmodified on Python 3. With Python 2's end-of-life, only Python 3.6.x[30] and later are supported, with older versions still supporting e.g. Windows 7 (and old installers not restricted to 64-bit Windows)."
# remove whitespaces
no_space_string = test_string.strip()

# convert to lower case
lower_string = no_space_string .lower()

# remove numbers
no_number_string = re.sub(r'\d+','',lower_string)
print(no_number_string)
Đoạn mã trên cung cấp nền tảng tốt để loại bỏ khoảng trắng, chuyển toàn bộ ký tự thành chữ thường và loại bỏ số/dữ liệu không phải chữ cái.
Data wrangling là thành phần quan trọng trong việc chuẩn bị dữ liệu cho mô hình học máy và phân tích. Có vô số công cụ trong Python như các gói pandas và numpy cùng nhiều phương pháp SQL như mệnh đề WHERE và GROUP BY giúp chúng ta chuẩn bị dữ liệu.
Thành thạo các kỹ thuật này là điều then chốt để bất kỳ chuyên gia dữ liệu tương lai nào thành công trong nghề. Nếu bạn muốn tìm hiểu sâu hơn về data wrangling, hãy tham khảo các tài nguyên sau:
Các khóa học hàng đầu trên DataCamp
Courses
Courses
Tracks
blogs
Matt Crabtree
10 phút
