Kurs
Python'da Veri Aktarmaya Giriş
3 sa
340.7K
Verinin hacmi, çeşitliliği ve hızı arttıkça, kaliteli ve iyi yapılandırılmış veri kümeleri oluşturmak her zamankinden daha kritik hale geldi; çünkü bu veri kümeleri, sektörler genelinde içgörülerin doğruluğunu ve kararların etkinliğini doğrudan etkiler.
Kötü organize edilmiş veya hatalı veriler, yanlış yönlendirilmiş sonuçlara yol açabilir; bu da zaman, para ve kaynak kaybına neden olur. İşte bu noktada data wrangling devreye girer ve ham, yapılandırılmamış veriyi analize hazır, temiz ve düzenli bir formata dönüştüren temel süreç olarak görev yapar.
Data wrangling, verinin doğru, güvenilir ve eldeki analizin özel ihtiyaçlarına uygun olmasını sağlamak için bir dizi adımdan oluşur. Data wrangling’i ustalıkla uygulayarak verinizin tüm potansiyelini açığa çıkarabilir; onu, bilinçli kararları yönlendiren ve nihayetinde başarıya götüren eyleme dönüştürülebilir içgörülere çevirebilirsiniz.
Data wrangling, ham veriyi daha kullanışlı bir formata dönüştürme sürecidir. Bu, verinin analize hazır hale gelmesi için temizlenmesini, yapılandırılmasını ve zenginleştirilmesini içerir.
Diyelim ki elinize devasa bir veri seti geçti—dağınık, eksik değerler, tutarsızlıklar ve ilgisiz bilgilerle dolu. Data wrangling, bu veriyi toparlamanıza, düzenli ve tutarlı hale getirmenize yardımcı olan bir araç kutusu gibidir.
Data wrangling, verinizin yüksek kaliteli ve iyi yapılandırılmış olmasını sağlayarak doğru veri analizi için kritik bir temel oluşturur. Temiz, yapılandırılmış veri; makine öğrenimi modeli kurmaktan görselleştirmeler üretmeye veya istatistiksel analiz yapmaya kadar veri iş akışındaki tüm sonraki adımların temelidir.
Yüksek kaliteli veri, analizde hata ve önyargı riskini azaltır ve daha güvenilir içgörüler sağlar. Data wrangling’in önemini kavramak, bu veriye dayalı alınan kararların geçerliliğini doğrudan etkilediği için kilittir.
Kötü uygulanmış wrangling, gerçek dünyadaki uygulamalarda önemli sonuçları olabilecek hatalı çıkarımlara yol açabilir. Bu nedenle, veri odaklı kararlar almak konusunda ciddi olan herkes için data wrangling’i öğrenmek esastır.
Data wrangling’in 5 ana adımı vardır:
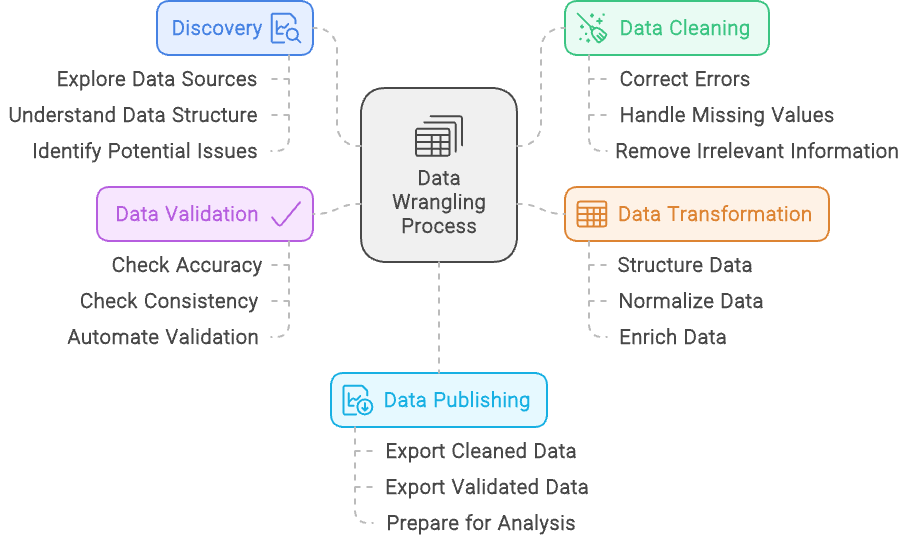
Data wrangling süreci - Napkin.ai ile oluşturuldu
Data wrangling’in beş adımını özetledik; şimdi her birine biraz daha yakından bakalım:
Data wrangling’deki keşif adımı, bir yapbozu birleştirmeye başlamadan önce ona ilk bakışı atmaya benzer. Verinin türlerini, kaynaklarını ve nasıl yapılandırıldığını anlamak dahil olmak üzere üzerinde çalışacağınız veri setini inceleyip net bir resim elde etmeyi içerir.
Nasıl ki yapboz parçalarını renge veya kenar şekline göre ayırabilirsiniz; keşif de verideki kalıpları kategorize etmenize ve tanımanıza yardımcı olur ve sonraki çalışmalar için zemin hazırlar.
Ancak keşif aynı zamanda olası sorunları fark etmektir—tıpkı bir yapbozda eksik parçaları veya uyumsuz renkleri görmeniz gibi.
Bu adımda, tutarsızlıklar, eksik değerler veya beklenmedik kalıplar gibi veriyle ilgili sorunları belirlersiniz. Bu zorlukları erken aşamada ortaya çıkararak, data wrangling’in sonraki adımlarında nasıl ele alacağınıza dair bir plan yapabilir ve temiz, kullanışlı bir veri setine daha sorunsuz bir yol sağlayabilirsiniz.
Veri temizleme, veri setinizi doğru ve güvenilir hale getirmek için onu iyileştirmeyi içerir.
Bu süreç; hataları düzeltmeyi, eksik değerleri ele almayı ve tutarsızlıkları gidermeyi kapsar. Örneğin, veri setinizde aynı kişi veya işlem için yinelenen kayıtlar varsa, veri temizleme sonuçları çarpıtmayı önlemek için bu kopyaları kaldırmayı içerir.
Ayrıca, bazı girişlerin yanlış biçimlendirildiğini fark ederseniz—örneğin telefon numaraları farklı formatlarda ise—bunları tutarlı bir formata standartlaştırırsınız. Amaç, verinin genel kalite ve bütünlüğünü artırarak onu doğru ve anlamlı analiz için hazır hale getirmektir.
Veri dönüştürme, veri setinizi analiz gereksinimlerine daha iyi uyacak şekilde değiştirme ve geliştirme sürecidir. Bu adım, veriyi istenen formata uydurmak için yeniden şekillendirmek veya birden fazla kaynağı tutarlı bir yapıda birleştirmek gibi yapılandırma işlemlerini içerir.
Normalleştirme de önemli bir unsurdur; bu, değerleri ortak bir ölçeğe veya formata uyarlamak anlamına gelir; örneğin tüm para birimlerini tek bir para birimine çevirmek veya ölçü birimlerini standartlaştırmak gibi.
Ayrıca, veri dönüştürme; yeni değişkenler ekleyerek veya harici veri kaynaklarını entegre ederek veri setini daha fazla bağlam veya içgörü sunacak şekilde zenginleştirmeyi de kapsar. Örneğin, mevcut verilerden yeni metrikler hesaplayabilir veya daha kapsamlı bir resim sunmak için diğer veritabanlarından ek bilgiler ekleyebilirsiniz.
Veri dönüştürmenin amacı, veriyi derinlemesine analiz için kullanılabilirliğini ve alaka düzeyini artıracak şekilde hazırlamaktır.
Veri doğrulama, sistematik kontroller ve otomatik süreçler aracılığıyla veri setinizin doğruluğunu ve güvenilirliğini sağlamayı içerir. Bu adım, verinin hem doğru hem de tutarlı olduğunu teyit etmek açısından kritiktir.
Veri doğrulama sırasında, veriyi bilinen kıyaslarla karşılaştırmak veya önceden tanımlanmış kural ve kısıtlamalara göre doğrulamak gibi çeşitli kontroller yaparsınız. Otomatik süreçler, beklenen format ve aralıklara uyumu sağlamak için anomali veya tutarsızlıkları işaretleyen betikler çalıştırmayı içerebilir.
Veri doğrulamanın amacı, veri analiz için kullanılmadan önce sorunları yakalamak ve hataların sonuçları etkilemesini önlemektir. Verinin doğruluğunu ve güvenilirliğini titizlikle teyit ederek, veriden elde edilen içgörülerin güvenilir bilgilere dayandığından emin olursunuz.
Veri yayınlama, data wrangling sürecinin son adımıdır; burada temizlenmiş ve yapılandırılmış veri analiz ve karar alma için erişime açılır. Bu adım, veriyi paylaşıma hazırlamayı; sıklıkla paydaşların erişip anlayabilmesi için panolar, raporlar veya etkileşimli görselleştirmeler oluşturmayı içerir.
Veri yayınlama sırasında, kullanıcıların veriyi sorgulayıp etkileşime girmesine olanak tanıyan veri hatları veya arayüzler kurabilir ve verinin ihtiyaçlarına uygun bir formatta sunulmasını sağlayabilirsiniz.
Amaç, veriden net ve eyleme dönüştürülebilir içgörüler sunarak bilinçli karar almayı mümkün kılmak ve bulguların organizasyon genelinde iletişimini kolaylaştırmaktır. Veriyi etkili biçimde yayımlayarak, data wrangling’e harcanan emeğin anlamlı ve pratik sonuçlara dönüşmesini sağlarsınız.
Data wrangling ve veri temizleme terimleri sıklıkla birbirinin yerine kullanılsa da, veri hazırlama sürecinin farklı yönlerine karşılık gelir. Her ikisi de analize hazırlık için gerekli olmakla birlikte, farklı amaçlara hizmet eder ve farklı görevler içerir. Aralarındaki farkı anlamak, rollerini netleştirir ve veri hazırlamanın her yönünün etkili şekilde ele alınmasını sağlar.
Data Wrangling, ham veriyi analize uygun bir formata dönüştürmeyi içeren kapsamlı bir süreçtir. Veriyi edinme, yapılandırma, temizleme ve doğrulama gibi çeşitli aşamaları kapsar. Data wrangling’in amacı, farklı kaynaklardan gelen verileri etkili şekilde analiz edilebilecek ve içgörü üretmek için kullanılabilecek hale getirmektir. Bu süreç, verinin organize, doğru ve ayrıntılı analiz için hazır olmasını sağlar.
Veri Temizleme, ise data wrangling’in belirli bir alt kümesidir. Yalnızca hataları ve tutarsızlıkları ele alıp düzelterek verinin kalitesini iyileştirmeye odaklanır. Bu, yinelenen kayıtların kaldırılması, yazım hatalarının düzeltilmesi, eksik değerlerin işlenmesi ve veri formatlarının standartlaştırılması gibi görevleri içerir. Veri temizleme, data wrangling’in kritik bir parçası olsa da, daha geniş sürecin yalnızca bir adımıdır.
Kısacası, data wrangling; veri hazırlamanın çeşitli yönlerini ele almak için birden çok adımdan oluşan ve veriyi analize hazırlayan genel çerçevedir. Veri temizleme ise bu çerçevenin ayrılmaz bir bileşenidir ve verinin doğruluğunu ve tutarlılığını artırmaya özel olarak odaklanır.
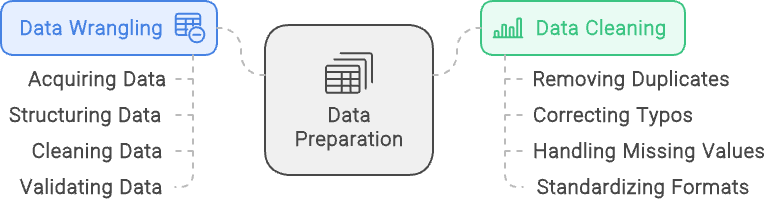
Data Wrangling vs Veri Temizleme: Data Wrangling verinin yapılandırılması ve doğrulanmasına odaklanırken, Veri Temizleme temiz ve kaliteli verinin sağlanmasına odaklanır. Görsel napkin.ai ile oluşturulmuştur
Veriyi wrangle etmenin birçok yolu vardır; Excel veya Alteryx gibi temel GUI tabanlı araçların yanı sıra R ve Python gibi dillerle kodlama da bunlara dahildir. Burada birkaç seçeneği inceleyeceğiz.
Basit data wrangling görevleri için, Microsoft Excel ve Google Sheets gibi hesap tabloları sıklıkla ilk tercih edilen seçeneklerdir. Bu araçlar oldukça erişilebilirdir ve tanıdık bir arayüz sunar; bu da sıralama, filtreleme ve temel veri temizleme gibi görevler için idealdir. Özellikle daha küçük veri setleri veya data wrangling’i yeni öğrenenler için uygundurlar.
Yerleşik fonksiyon ve formüller sayesinde, kapsamlı teknik bilgi gerektirmeden hızlıca hesaplamalar yapmayı ve veriyi manipüle etmeyi mümkün kılarlar.
Daha karmaşık veri manipülasyonu ve otomasyon için Python ve R gibi programlama dilleri yaygın olarak kullanılır. Python, Pandas, NumPy ve OpenRefine gibi güçlü kütüphaneleriyle büyük veri setlerini işleme ve karmaşık veri dönüşümleri yapma konusunda oldukça etkilidir.
R ise dplyr ve tidyr gibi paketleriyle, özellikle istatistiksel ve akademik çevrelerde güçlü veri analizi yetenekleri nedeniyle tercih edilir. Her iki dil de yüksek esneklik sunar; kullanıcıların özel iş akışları yazmasına ve tekrarlayan görevleri otomatikleştirmesine olanak tanır; bu da daha sofistike data wrangling ihtiyaçları olan veri profesyonelleri için idealdir.
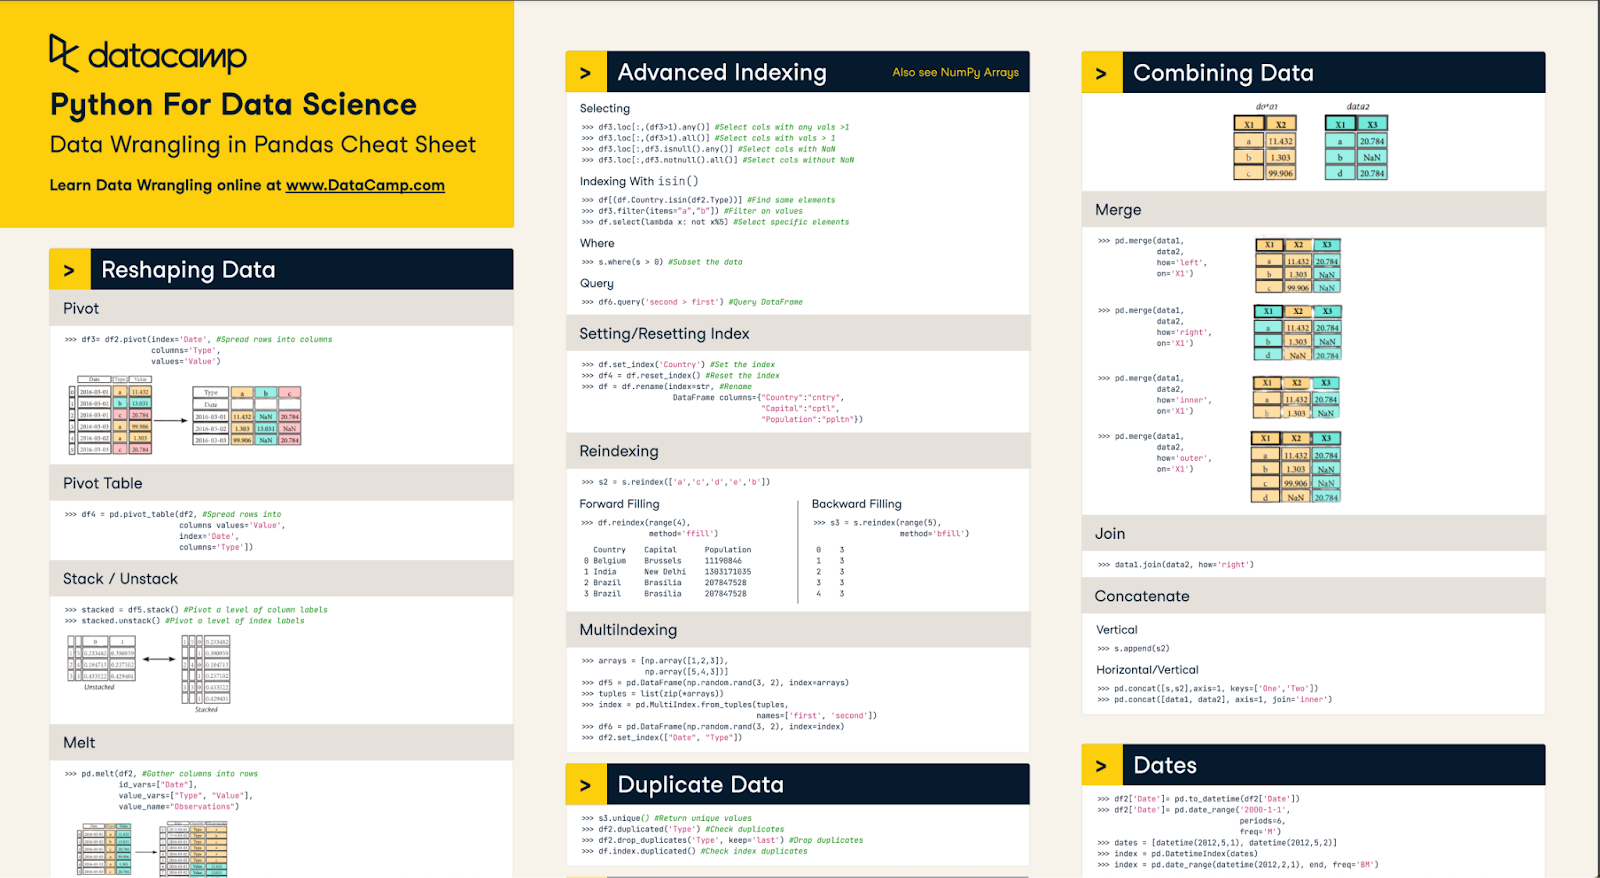
Pandas ile Data Wrangling Cheat Sheet’imiz temel noktaların çoğunu öğrenmenize yardımcı olabilir
Özel yazılım araçları, karmaşık veri görevlerini basitleştiren gelişmiş özellikler sunarak data wrangling sürecini kolaylaştırmak üzere özel olarak tasarlanmıştır. Bu araçlar, kapsamlı kodlama gereksinimi olmadan veriyi temizlemek, yapılandırmak ve analize hazırlamak için güçlü ama erişilebilir çözümlere ihtiyaç duyan kullanıcılar için idealdir.
Alteryx bu kategoride önde gelen bir araçtır; kullanıcıların birden çok kaynaktan veri temizleme, harmanlama ve dönüştürme işlemlerini sezgisel sürükle-bırak arayüzüyle kolayca yapmasına olanak tanır. Veri manipülasyonu için çok sayıda yerleşik araçla birlikte gelir ve filtreleme, birleştirme ve toplulaştırma gibi görevleri doğrudan hale getirir.
Bulut tabanlı Alteryx Designer Cloud bu yetenekleri daha da geliştirir ve ölçeklenebilir, işbirliğine dayalı bir data wrangling platformu sunar. Bu çözüm, ekiplerin farklı ortamlarda büyük veri setlerini ve karmaşık iş akışlarını verimli bir şekilde, gerçek zamanlı olarak birlikte yönetmesine olanak tanır. İster kurum içinde ister bulutta kullanılsın, Alteryx verinin doğru şekilde hazırlandığını ve içgörü üreten analizlere hazır olduğunu garanti eder.
Uçtan uca çözümler gerektiren kapsamlı veri projeleri için KNIME, Apache NiFi ve Microsoft Power BI gibi entegre platformlar sıkça kullanılır. Bu platformlar yalnızca data wrangling’i desteklemekle kalmaz; aynı ortam içinde veri entegrasyonu, analiz ve görselleştirme için araçlar da sunar.
Örneğin KNIME, kullanıcıların görsel olarak karmaşık iş akışları kurmasına olanak tanıyan modüler, düğüm tabanlı arayüzüyle bilinir. Apache NiFi, sistemler arası veri akışlarını yönetme ve otomatikleştirmede öne çıkar; Power BI ise veri hazırlığını güçlü görselleştirme yetenekleriyle birleştirir. Bu platformlar, verinin kesintisiz şekilde hazırlanıp analiz edilmesi ve paylaşılması gereken projeler için idealdir ve veri odaklı karar alma için bütünsel bir yaklaşım sunar.
Python ile data wrangling söz konusu olduğunda birçok seçenek vardır. En çok kullanılan iki paket Pandas ve NumPy’dır. Bu iki paket, kullanıcıların veri setleri üzerinde temel data wrangling tekniklerini kolayca uygulamasını sağlayan güçlü araçlar sunar.
Python’da çok fazla veri işleme gerçekleştiği için bu paketleri öğrenmek her veri uzmanı için zorunludur. Pek çok teknik olsa da, bilinmesi gereken temel konular arasında üst düzey veri temizleme (örneğin null değerleri düşürme), veri setlerini birleştirme ve eksik değerleri ele alma yer alır.
Verinin kullanılmadan önce Python’da temizlenmesi gereken pek çok durum vardır. Buna örnek olarak; dizgilerde sondaki boşlukların kaldırılması, null değerlerin düşürülmesi veya veri türlerinin düzeltilmesi sayılabilir.
Her veri seti farklıdır ve kendine özgü ihtiyaçları vardır; bu yüzden ek temizleme gerekip gerekmediğini anlamak için veri setinizi keşfedin. Çeşitli teknikleri ve kodlama becerilerini uygulamak, Python’da veriyi nasıl temizleyebileceğimizin farklı yollarını öğrenmenin harika bir yoludur.
Dizgileri temizlerken karşılaşılan birçok sorundan biri baştaki/sondaki boşluklardır. Bu durum, uzunluk, konum veya eşleştirmeye dayalı ayrıştırmalarda sorun yaratabilir. Bunu ele almanın en iyi yolu, bir seri üzerinde str.strip() yöntemini kullanmaktır.
# Example utilizes a pandas series
# If working with a dataframe, call the series using df[col] syntax
s = pd.Series(['1. Ant.  ', '2. Bee!\n', '3. Cat?\t', np.nan, 10, True])
# It is important to include the .str or else the method will not work
s.str.strip()
Pandas’ta null değerleri düşürmek kolaydır. Null değerleri doldurmayı bu yazının ilerleyen kısımlarında tartışacağız. Basitçe dropna() yöntemini kullanabilirsiniz. Bu yöntemde, hangi koşullarda satır/sütun düşürüleceğini seçmenizi sağlayan isteğe bağlı parametreler vardır; ancak varsayılan davranış, herhangi bir null değeri olan satırları düşürmektir
# For any dataframe
df = pd.DataFrame({"name": ['Alfred', 'Batman', 'Catwoman'],
                   "toy": [np.nan, 'Batmobile', 'Bullwhip'],
                   "born": [pd.NaT, pd.Timestamp("1940-04-25"), pd.NaT]}
df.dropna()
.astype() yöntemi, kullanıcıların bir serinin veri türünü değiştirmesine olanak tanır; ancak veri türlerini düzeltmek biraz daha zordur çünkü Pandas serinizdeki her değerin o veri türüyle uyumlu olduğundan emin olmanız gerekir.
Örneğin, türü object olan bir seriyi tamsayıya dönüştürmek, her değerin tamsayı olduğu anlamına gelir. Tamsayı olmayan tek bir değer bile varsa, yöntem hata verir. Geçersiz değerleri null yaparak zorlayabilirsiniz; ancak bazı değerlerin neden dönüştürülemediğini araştırmak daha değerli olabilir.
Pandas’ta DataFrame birleştirme, SQL’deki join işlemine benzer. Pandas merge()’ün varsayılan davranışı iç birleşim (inner join) yapmaktır. Ancak null değerlerde de birleştirme yapar; bu nedenle dikkatli olun. Birleştirme yapmak, belirli bir anahtar kullanmayı gerektirir. Birden fazla sütun üzerinde veya hatta indeks üzerinden birleştirme yapabilirsiniz.
# Create two dataframes
df1 = pd.DataFrame({'lkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [1, 2, 3, 5]})
df2 = pd.DataFrame({'rkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [5, 6, 7, 8]})
# merge the df1 DataFrame to the df2 DataFrame using the columns key and rkey as keys
df1.merge(df2, left_on='lkey', right_on='rkey')
Yukarıdaki kod, lkey ve rkey sütunlarındaki eşleşen anahtarlara dayanarak iki DataFrame’i birleştirir. Eşleşmeyen değerler atılır ve yalnızca eşleşenler kalır. Ancak birleştirme davranışını değiştirerek sol/sağ/dış birleşim de seçebilirsiniz. Bu, veri bilimcilerin farklı veri kaynaklarından gelen veri setlerini bir araya getirmesi için güçlü bir araçtır.
Eksik değerlere geldiğimizde, izlenecek yöntem iş senaryosuna göre değişebilir. Eksik değerden bahsederken, değerin neden eksik olduğunu da düşünmeliyiz. Değer teknik hatalar nedeniyle eksikse, verimizi analiz etmeden önce teknik hatayı düzeltmeye ve mümkünse geçmiş veriyi kurtarmaya odaklanmak daha doğru olabilir.
Bazı durumlarda, geri kalan veriyi kullanarak eksik değeri görmezden gelebiliriz. Geçmiş veri önemli ve kurtarılamaz ise, eksik veriyi doldurmamız gerekir. Eksik bilgileri nasıl dolduracağımızı konuşalım.
Veri doldurmanın temel yöntemi, Pandas’ın fillna() metodunu kullanmaktır. Dizgiler için bu yöntem, örneğin df.fillna(value=’missing’) şeklinde null değerleri doldurmak için kullanılabilir ve bu yeterli olabilir! Bu yöntemin güzelliği, yaratıcı olabilmemizdir. Pandas fillna() metodunu mean() , median() ve lambda fonksiyonları gibi çeşitli NumPy metodlarıyla birleştirerek eksik değerlerimizi matematiksel olarak doldurabiliriz.
Alternatif olarak, veriniz sıralıysa (ör. zamana dayalı) boşlukları algoritmik olarak doldurabilen interpolate() gibi Pandas yöntemleri de mevcuttur. Amaç, veriyi gerçeği yansıtacak şekilde olabildiğince doğru doldurmaktır.
SQL’de data wrangling uygulamak, özellikle SQL veritabanınız bulutta ise, verinizi işlemenin etkili bir yolu olabilir. Bu, yerel makineniz tarafından işlenen veri miktarını ve ağ üzerinden giriş/çıkış yapılan veri hacmini sınırlar.
SQL’de data wrangling’in ana odağı, doğru veri çıkarımı, dönüşümü ve yüklemesi yoluyla boru hatlarımızdan akan verinin kapsamını sınırlamaktır. Bunu; veriyi filtreleyerek, referans tablolarıyla birleştirerek ve toplulaştırmalar yaparak yönetiriz.
SQL’de tabloları filtrelemenin birincil yolu WHERE ifadesini kullanmaktır. Kullanımı oldukça basittir ancak son derece güçlü olabilir. Koşullar basit eşitlik ifadeleri, benzer dizgileri arama veya hatta başka alt sorguları kullanma şeklinde olabilir. Birden fazla where ifadesini AND ve OR ile de birleştirebilirsiniz!
Bir sütunun belirli bir değerini aramak gibi basit durumlara dayalı filtreleme şöyle görünebilir:
SELECT *
FROM sample_table
WHERE sample_col = 23
LIKE veya IN gibi daha karmaşık ifadeler kullanmak, WHERE koşullarınıza esneklik kazandırabilir. Örneğin aşağıdaki sorgu, % joker karakteri sayesinde adı J ile başlayan kişileri ve soyadı verilen listede olanları arar.
SELECT *
FROM sample_table
WHERE name LIKE ‘J%’ /* looks for people whose name starts with J */
AND last_name IN (‘Smith’, ‘Rockefeller’, ‘Williams’) /* Looks for people whose last name is in this list */
Son olarak, alt sorgular kullanmak filtrelemenize esneklik kazandırabilir. Bu, başka bir tablonun sonuçlarına dayanabilir. Yaygın bir örnek, belirli bir tarihten sonra olan müşteri kimliklerinin listesini bulmaktır.
SELECT *
FROM sample_table
WHERE customer_id IN (SELECT id FROM reference_table WHERE date >= ‘2024-01-01’)
Bu tekniklerin bir kombinasyonunu kullanmak, veri girişlerinizin tam olarak aradığınız gibi olmasını ve veri seti boyutlarının en aza indirilmesini sağlar. Filtrelerin bir diğer güçlü kullanımı, veri setinizdeki kopyaları kaldırmak ve bu yolla temizlemektir. Uygulanabilecek daha gelişmiş teknikler arasında toplulaştırmalar için HAVING filtreleri ve pencere fonksiyonlarıyla QUALIFY ifadeleri bulunur.
Tablo birleştirmeleri yapmak, veri setlerimiz için ihtiyaç duyabileceğimiz ek bilgileri toplamamıza olanak tanır. SQL’de INNER, OUTER, LEFT ve RIGHT gibi çeşitli join türleri vardır. INNER ve OUTER join’lerde hangi verinin tutulacağını belirleriz. INNER join, yalnızca her iki tarafta da eşleşme varsa veriyi tutar; OUTER ise birleştirdiğimiz tarafa (sol veya sağ) bağlı olarak eşleşmeyen verileri de tutar.
LEFT join, birleştirmenin sol tarafındaki veriyi; RIGHT join ise sağ tarafındaki veriyi tutar. LEFT ve RIGHT join’leri, INNER ve OUTER join’lerle birleştirebilir veya her iki tablodaki tüm veriyi birleştiren özel FULL OUTER JOIN’i kullanabilirsiniz.
Örnek bir join şu şekilde olabilir:
SELECT *
FROM a
LEFT OUTER JOIN
b
WHERE a.id = b.id
Yukarıdaki ifadede a tablosu soldadır (ilk yazıldığı için), b tablosu sağdadır (ikinci yazıldığı için). LEFT OUTER JOIN, a.id = b.id olduğu yerde a ve b tablolarındaki veriyi birleştir ama eşleşme yoksa a tablosundaki tüm veriyi tut demektir. Join’ler, veri girdileriniz için gerekli olabilecek ek verileri içeri almak açısından güçlü araçlardır.
SQL’de data wrangling için kullanabileceğimiz son bir araç da toplulaştırma yapmak üzere GROUP BY ifadesidir. Bu, veriyi basitleştirir ve boru hattının ilerleyen aşamalarına göndermeden önce bir miktar ön işleme yapmamızı sağlar. Toplulaştırma, özet istatistikleri hesaplamak için güçlü bir araçtır. Aşağıda müşteri kimliğine göre toplam satışlara baktığımız bir örnek yer alır.:
SELECT
Customer_ID,
SUM(sales)
FROM sample_table
GROUP BY Customer_ID SUM, MEAN, MAX ve MIN gibi çok sayıda toplulaştırma fonksiyonu vardır ve bunlar verimizi hızlı ve kolay şekilde anlamamıza yardımcı olur. Toplulaştırmalardan yararlanmak, verinin boru hatlarına girişini basitleştirir.
Bu bölümde data wrangling teknikleri için bazı pratik örnekler ve kullanım senaryolarını ele alacağız. Odaklanacağımız ana hedefler: veriyi standartlaştırma, veri kaynaklarını birleştirme ve metin işleme.
Veriyi aynı birimlere standartlaştırmak önemlidir. Aynı şeyin farklı birimlerle ölçüldüğü veya farklı para birimlerinin kullanıldığı verilerle çalışmak, analizde sorunlara yol açabilir.
SQL’de farklı para birimlerini USD’ye dönüştürmenin basit bir örneğini ele alacağız. Öncelikle iki tablomuz olduğunu varsayalım. Tablo 1, çeşitli bölgelerdeki ürün satışlarını içeren bir sales tablosu; Tablo 2 ise çeşitli günlerde bölgeler için döviz kurunu içeren currency_exchange tablosudur. Bu dönüşümün bir örneği şöyle görünebilir:
SELECT
a.sale_id,
a.region,
CASE WHEN region <> ‘US’
	THEN a.sale_price * b.exchange_rate
	ELSE a.sale_price
END AS sale_price
FROM sales AS a
LEFT OUTER JOIN
currency_exchange AS b
WHERE a.region = b.region
Bu, sales tablosundan sale_id ve region alanlarını alır ve döviz kurunu elde etmek için bölge üzerinden referans currency_exchange tablosuyla birleştirir. Çoğu zaman, ilgili günün döviz kurunu almak için bir tarih de işin içine dahil edilir.
Data wrangling’in önemli bir kısmı, makine öğrenimi modellerimiz için veriyi işlemektir. Son dönemde birçok model doğal dil işlemeye odaklandı ve bunun ön adımlarından biri metin verisi üzerinden duygu analizi yapmaktır.
Bunun kritik bir adımı, metni normalleştirme ve noktalama işaretlerini kaldırma yoluyla hazırlamaktır. Noktalama ve büyük/küçük harf kullanımı, bir makine öğrenimi modeli için her zaman önemli bağlam sağlamayabileceğinden, genellikle normalleştirmek daha iyidir.
Bunu yapmak için temel Python paketleri ve re paketini kullanacağız. Aşağıda noktalama işaretlerinin kaldırılması, metnin büyük/küçük harf duyarsızlaştırma için normalize edilmesi ve boşlukların kırpılması örneğini görebilirsiniz.
# import regex
import re

# input string
test_string = "       Python 3.0, released in 2008, was a major revision of the language that is not completely backward compatible and much Python 2 code does not run unmodified on Python 3. With Python 2's end-of-life, only Python 3.6.x[30] and later are supported, with older versions still supporting e.g. Windows 7 (and old installers not restricted to 64-bit Windows)."
# remove whitespaces
no_space_string = test_string.strip()

# convert to lower case
lower_string = no_space_string .lower()

# remove numbers
no_number_string = re.sub(r'\d+','',lower_string)
print(no_number_string)
Yukarıdaki kod parçacığı; boşlukları kaldırma, karakterleri tamamen küçük harfe çevirme ve sayıları/alfabetik olmayan verileri kaldırma için sağlam bir temel sunar.
Data wrangling, verimizi makine öğrenimi modelleri ve analiz için hazırlamanın kritik bir bileşenidir. Veriyi hazırlamamıza olanak tanıyan; Python’daki pandas ve numpy paketleri ile WHERE ve GROUP BY gibi çeşitli SQL yöntemleri dahil pek çok araç vardır.
Bu tekniklerde ustalaşmak, meslekte başarılı olmak isteyen her veri profesyoneli adayı için hayati öneme sahiptir. Data wrangling konularında daha derine inmek isterseniz, aşağıdaki kaynakları değerlendirin:
Öne Çıkan DataCamp Kursları
Kurs
Kurs
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme