course
Wprowadzenie do importowania danych w Pythonie
3 godz.
340.8K
Wraz ze wzrostem wolumenu, różnorodności i szybkości danych, budowanie jakościowych, dobrze ustrukturyzowanych zbiorów danych stało się ważniejsze niż kiedykolwiek, ponieważ bezpośrednio wpływa na trafność wniosków i skuteczność decyzji w różnych branżach.
Słabo zorganizowane lub wadliwe dane mogą prowadzić do błędnych wniosków, kosztując czas, pieniądze i zasoby. W tym miejscu wkracza data wrangling jako kluczowy proces, który zapewnia przekształcenie surowych, niestrukturyzowanych danych w czysty, uporządkowany format gotowy do analizy.
Data wrangling obejmuje szereg kroków, aby zapewnić, że dane są dokładne, wiarygodne i dopasowane do specyficznych potrzeb danej analizy. Opanowując data wrangling, możesz odblokować pełny potencjał swoich danych, zamieniając je w praktyczne wnioski wspierające świadome decyzje i prowadzące ostatecznie do sukcesu.
Data wrangling to proces przekształcania surowych danych w bardziej użyteczny format. Obejmuje czyszczenie, strukturyzowanie i wzbogacanie danych tak, aby były gotowe do analizy.
Wyobraź sobie, że właśnie otrzymałeś ogromny zbiór danych — jest nieuporządkowany, z brakującymi wartościami, niespójnościami i nieistotnymi informacjami. Data wrangling to jak zestaw narzędzi pomagający uporządkować te dane, zapewniając ich organizację i spójność.
Data wrangling jest ważny, aby zapewnić wysoką jakość i dobrą strukturę danych, co jest kluczowe dla rzetelnej analizy. Czyste, ustrukturyzowane dane stanowią fundament kolejnych etapów w pracy z danymi — czy to budowy modeli uczenia maszynowego, tworzenia wizualizacji, czy analizy statystycznej.
Dane wysokiej jakości zmniejszają ryzyko błędów i stronniczości w analizie, prowadząc do bardziej wiarygodnych wniosków. Zrozumienie znaczenia data wranglingu jest kluczowe, ponieważ bezpośrednio wpływa na ważność decyzji podejmowanych na podstawie danych.
Słabo przeprowadzony wrangling może prowadzić do błędnych wniosków, co może mieć poważne konsekwencje w praktycznych zastosowaniach. Dlatego opanowanie data wranglingu jest niezbędne dla każdego, kto poważnie podchodzi do decyzji opartych na danych.
Istnieje 5 głównych kroków data wranglingu:
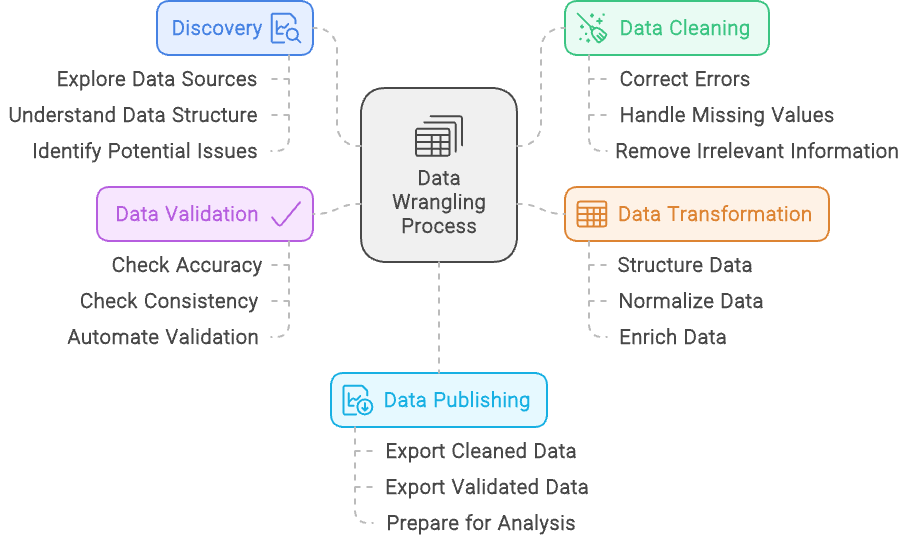
Proces data wrangling — stworzony w Napkin.ai
Wymieniliśmy pięć kroków data wranglingu, ale przyjrzyjmy się każdemu z nich bliżej:
Etap odkrywania w data wranglingu jest jak pierwsze spojrzenie na układankę, zanim zaczniesz układać elementy. Obejmuje zbadanie zbioru danych, aby jasno zrozumieć, z czym pracujesz — w tym typy danych, ich źródła i strukturę.
Tak jak sortujesz puzzle według koloru lub kształtu krawędzi, tak odkrywanie pomaga kategoryzować i rozpoznawać wzorce w danych, przygotowując grunt pod dalszą pracę.
Odkrywanie to także wypatrywanie potencjalnych problemów — jak brakujących elementów czy niedopasowanych kolorów w układance.
Na tym etapie identyfikujesz problemy w danych, takie jak niespójności, brakujące wartości czy nieoczekiwane wzorce. Wykrycie tych wyzwań na początku pozwala zaplanować, jak je rozwiązać w kolejnych krokach wranglingu, co ułatwia dojście do czystego, użytecznego zbioru danych.
Czyszczenie danych polega na dopracowaniu zbioru, aby zapewnić jego dokładność i wiarygodność.
Obejmuje to m.in. korygowanie błędów, obsługę braków i naprawę niespójności. Na przykład, jeśli zbiór zawiera zduplikowane wpisy dla tej samej osoby lub transakcji, czyszczenie danych polegałoby na usunięciu duplikatów, aby nie zaburzały wyników.
Dodatkowo, jeśli niektóre wpisy są źle sformatowane, np. numery telefonów w różnych formatach, należy je ujednolicić. Celem jest podniesienie ogólnej jakości i integralności danych, aby były gotowe do rzetelnej, wartościowej analizy.
Transformacja danych to proces modyfikowania i wzbogacania zbioru tak, by lepiej odpowiadał wymaganiom analizy. Obejmuje to strukturyzowanie danych, np. przekształcanie ich do pożądanego formatu lub łączenie wielu źródeł w spójną strukturę.
Kluczowym elementem jest normalizacja, czyli dostosowanie wartości do wspólnej skali lub formatu, np. konwersja wszystkich kwot do jednej waluty lub standaryzacja jednostek miary.
Transformacja danych obejmuje też wzbogacanie zbioru przez dodanie nowych zmiennych lub integrację zewnętrznych źródeł, aby dostarczyć więcej kontekstu lub wglądu. Przykładowo, możesz wyliczyć nowe metryki na podstawie istniejących danych albo dołączyć dodatkowe informacje z innych baz, aby uzyskać pełniejszy obraz.
Celem transformacji jest przygotowanie danych w sposób zwiększający ich użyteczność i trafność dla pogłębionej analizy.
Walidacja danych polega na zapewnieniu dokładności i wiarygodności zbioru poprzez systematyczne kontrole i procesy automatyczne. To krytyczny krok potwierdzający, że dane są poprawne i spójne.
Podczas walidacji wykonujesz różne sprawdzenia wykrywające rozbieżności, np. porównujesz dane do znanych punktów odniesienia lub weryfikujesz je względem zdefiniowanych reguł i ograniczeń. Automaty mogą obejmować skrypty wyłapujące anomalie czy niespójności, zapewniając zgodność z oczekiwanymi formatami i zakresami.
Celem walidacji jest wyłapanie problemów, zanim dane trafią do analizy, aby błędy nie wpłynęły na wyniki. Rygorystycznie weryfikując dokładność i wiarygodność, masz pewność, że wnioski opierają się na godnych zaufania informacjach.
Publikacja danych to ostatni krok w procesie data wranglingu, w którym wyczyszczone i ustrukturyzowane dane są udostępniane do analizy i podejmowania decyzji. Obejmuje przygotowanie danych do dystrybucji, często poprzez tworzenie pulpitów, raportów lub interaktywnych wizualizacji, aby były zrozumiałe i dostępne dla interesariuszy.
Podczas publikacji możesz skonfigurować potoki danych lub interfejsy pozwalające użytkownikom zapytywać i wchodzić w interakcję z danymi, dostarczając je w formacie odpowiadającym ich potrzebom.
Celem jest dostarczenie jasnych, praktycznych wniosków z danych, umożliwiających świadome decyzje i ułatwiających komunikację wniosków w całej organizacji. Skuteczna publikacja sprawia, że praca włożona w wrangling przekłada się na realne, praktyczne efekty.
Terminy data wrangling i czyszczenie danych często używane są zamiennie, ale odnoszą się do różnych aspektów przygotowania danych. Oba są niezbędne, lecz pełnią odmienne funkcje i obejmują różne zadania. Zrozumienie różnic pomaga jasno określić role i skutecznie zadbać o każdy element przygotowania danych.
Data wrangling to proces kompleksowy, obejmujący przekształcanie surowych danych do formatu odpowiedniego do analizy. Zawiera kilka etapów: pozyskiwanie, strukturyzowanie, czyszczenie i walidację. Jego celem jest przygotowanie danych z różnych źródeł tak, by mogły być skutecznie analizowane i wykorzystywane do generowania wniosków. Zapewnia, że dane są uporządkowane, dokładne i gotowe do szczegółowej analizy.
Czyszczenie danych, z kolei, to konkretny podzbiór data wranglingu. Koncentruje się wyłącznie na poprawie jakości danych poprzez usuwanie i korygowanie błędów oraz niespójności. Obejmuje m.in. usuwanie duplikatów, poprawianie literówek, obsługę braków i standaryzację formatów. Choć czyszczenie danych jest kluczowe, stanowi tylko jeden krok szerszego procesu.
Mówiąc prościej: data wrangling to całościowe podejście do przygotowania danych, obejmujące wiele kroków. Czyszczenie danych jest jego integralną częścią, poświęconą podniesieniu dokładności i spójności danych.
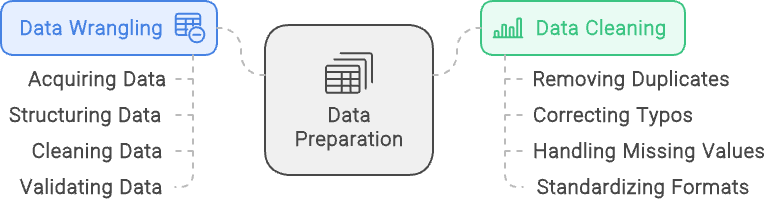
Data wrangling vs czyszczenie danych: data wrangling skupia się na strukturyzowaniu i walidacji danych, a czyszczenie danych — na zapewnieniu ich czystości i jakości. Obraz utworzony w napkin.ai
Istnieje wiele sposobów na wrangling danych — z użyciem podstawowych narzędzi z interfejsem graficznym, takich jak Excel czy Alteryx, lub poprzez kodowanie w językach takich jak R i Python. Poniżej omówimy kilka opcji.
Do prostych zadań wranglingu arkusze kalkulacyjne, takie jak Microsoft Excel i Google Sheets, są często pierwszym wyborem. To narzędzia łatwo dostępne i o znajomym interfejsie, idealne do sortowania, filtrowania i podstawowego czyszczenia danych. Świetnie sprawdzają się przy mniejszych zbiorach lub na początku nauki wranglingu.
Dzięki wbudowanym funkcjom i formułom pozwalają szybko wykonywać obliczenia i manipulacje bez potrzeby zaawansowanej wiedzy technicznej.
Do bardziej złożonej manipulacji i automatyzacji powszechnie używa się Pythona i R. Python z potężnymi bibliotekami takimi jak Pandas, NumPy i OpenRefine świetnie nadaje się do dużych zbiorów i złożonych transformacji.
R z pakietami takimi jak dplyr i tidyr to kolejna mocna opcja, szczególnie ceniona w środowiskach statystycznych i akademickich za solidne możliwości analizy. Oba języki są elastyczne, pozwalają skryptować własne przepływy i automatyzować powtarzalne zadania — idealne dla praktyków danych z bardziej zaawansowanymi potrzebami wranglingu.
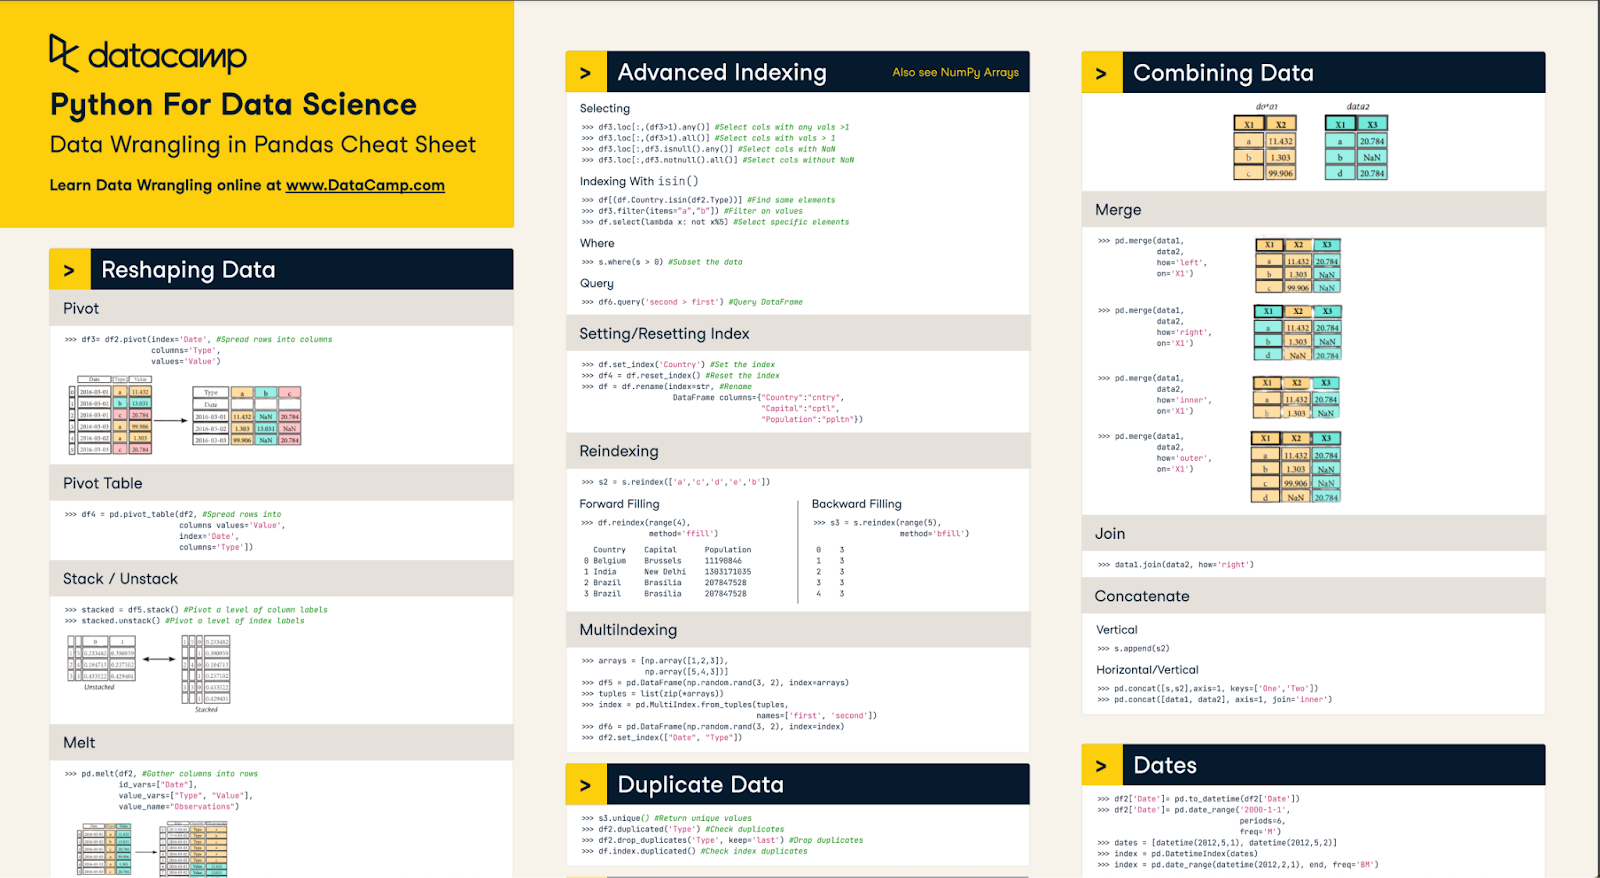
Nasz ściągawka Data Wrangling w Pandas pomoże ci opanować wiele podstaw
Dedykowane narzędzia są zaprojektowane, by usprawnić wrangling, oferując zaawansowane funkcje upraszczające złożone zadania. Idealne dla osób potrzebujących wydajnych, ale przystępnych rozwiązań do czyszczenia, strukturyzacji i przygotowania danych bez konieczności intensywnego kodowania.
Alteryx to wiodące narzędzie w tej kategorii, znane z intuicyjnego interfejsu „przeciągnij i upuść”, który pozwala łatwo oczyszczać, łączyć i przekształcać dane z wielu źródeł. Posiada bogaty zestaw wbudowanych narzędzi do manipulacji danymi, ułatwiających m.in. filtrowanie, złączanie i agregowanie.
Chmurowy Alteryx Designer Cloud dodatkowo wzmacnia te możliwości, oferując skalowalną, współpracującą platformę do wranglingu. Umożliwia zespołom pracę w czasie rzeczywistym, sprawne przetwarzanie dużych zbiorów i złożonych przepływów w różnych środowiskach. Niezależnie od wdrożenia lokalnego czy w chmurze, Alteryx zapewnia dokładne przygotowanie danych do wnikliwej analizy.
W kompleksowych projektach danych wymagających rozwiązań end‑to‑end stosuje się zintegrowane platformy, takie jak KNIME, Apache NiFi i Microsoft Power BI. Platformy te wspierają nie tylko wrangling, ale też integrację, analizę i wizualizację danych w jednym środowisku.
KNIME słynie z modularnego, węzłowego interfejsu do wizualnego budowania złożonych przepływów. Apache NiFi wyróżnia się zarządzaniem i automatyzacją przepływów danych między systemami, a Power BI łączy przygotowanie danych z potężną wizualizacją. To idealne rozwiązania, gdy dane trzeba płynnie przygotować, przeanalizować i udostępnić — oferują holistyczne podejście do decyzji opartych na danych.
Opcji wranglingu w Pythonie jest wiele. Dwa główne pakiety to Pandas i NumPy. Oferują potężne narzędzia umożliwiające łatwe wykonywanie kluczowych technik wranglingu na zbiorach.
Tak wiele przetwarzania danych dzieje się w Pythonie, że opanowanie tych pakietów jest niezbędne dla każdego praktyka danych. Choć technik jest wiele, kluczowe to m.in. czyszczenie na wysokim poziomie (np. usuwanie nulli), łączenie zbiorów i obsługa braków.
Często dane trzeba oczyścić w Pythonie przed użyciem. Może to obejmować np. usuwanie końcowych spacji w łańcuchach, usuwanie wartości null lub korektę typów danych, by wymienić kilka.
Każdy zbiór jest inny i ma własne potrzeby, więc eksploruj dane, aby zrozumieć, czy potrzeba dodatkowego czyszczenia. Ćwiczenie technik i umiejętności kodowania to świetny sposób, by poznać różne sposoby czyszczenia danych w Pythonie.
Podczas czyszczenia łańcuchów częstym problemem są spacje na początku/końcu. Mogą utrudniać parsowanie po długości, pozycji czy dopasowaniu. Najlepiej poradzić sobie z tym metodą str.strip() na serii.
# Example utilizes a pandas series
# If working with a dataframe, call the series using df[col] syntax
s = pd.Series(['1. Ant.  ', '2. Bee!\n', '3. Cat?\t', np.nan, 10, True])
# It is important to include the .str or else the method will not work
s.str.strip()
Usuwanie nulli w Pandas jest proste. O tym, jak je wypełniać, powiemy później. Wystarczy użyć metody dropna(). Ma ona opcjonalne parametry pozwalające wybrać warunki usuwania wierszy/kolumn, ale domyślnie usuwa każdy wiersz zawierający jakiekolwiek wartości null.
# For any dataframe
df = pd.DataFrame({"name": ['Alfred', 'Batman', 'Catwoman'],
                   "toy": [np.nan, 'Batmobile', 'Bullwhip'],
                   "born": [pd.NaT, pd.Timestamp("1940-04-25"), pd.NaT]}
df.dropna()
Metoda .astype() pozwala zmienić typ danych serii, ale korekta typów bywa trudniejsza, bo musisz upewnić się, że każda wartość w serii Pandas pasuje do wybranego typu.
Na przykład konwersja serii typu object na integer oznacza, że każda wartość jest liczbą całkowitą. Jeśli choć jedna nie jest, metoda zakończy się błędem. Możesz wymusić konwersję, zamieniając nieprawidłowe wartości na null, ale często warto zbadać, dlaczego niektóre pozycje się nie konwertują.
Łączenie DataFrame’ów w Pandas przypomina joiny w SQL. Domyślnie merge() wykonuje inner join. Uwaga: łączy także po nullach. Do scalenia potrzebny jest klucz — możesz łączyć po różnych kolumnach albo po indeksie.
# Create two dataframes
df1 = pd.DataFrame({'lkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [1, 2, 3, 5]})
df2 = pd.DataFrame({'rkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [5, 6, 7, 8]})
# merge the df1 DataFrame to the df2 DataFrame using the columns key and rkey as keys
df1.merge(df2, left_on='lkey', right_on='rkey')
Powyższy kod scali dwa DataFrame’y na podstawie dopasowanych kluczy w kolumnach lkey i rkey. Niedopasowane wartości zostaną odrzucone, pozostaną tylko dopasowane. Możesz jednak zmienić zachowanie na left/right/outer merge. To potężne narzędzie, które pozwala łączyć zbiory z różnych źródeł.
W przypadku braków konkretna metodologia zależy od kontekstu biznesowego. Trzeba rozważyć, dlaczego wartość jest brakująca. Jeśli wynika to z błędu technicznego, być może warto najpierw go naprawić i spróbować odzyskać dane historyczne.
Czasem można oprzeć się na pozostałych danych i zignorować braki. Jeśli jednak dane historyczne są ważne i nie do odzyskania, trzeba uzupełnić braki. Omówmy, jak uzupełniać brakujące informacje.
Główną metodą jest fillna() z Pandas. Dla tekstów można uzupełnić null np.: df.fillna(value=’missing’) — to może wystarczyć! Siła tej metody polega na elastyczności. Łącząc fillna() z funkcjami NumPy, takimi jak mean(), median() i funkcjami lambda, możemy matematycznie uzupełniać braki.
Alternatywnie istnieje metoda Pandas interpolate(), która algorytmicznie wypełnia luki, jeśli dane są uporządkowane (np. czasowo). Celem jest jak najwierniejsze odtworzenie rzeczywistych danych.
Wrangling w SQL może być bardzo efektywny, zwłaszcza gdy baza SQL działa w chmurze. Ogranicza to przetwarzanie po stronie lokalnej maszyny oraz transfer danych przez sieci.
Główny nacisk kładziemy na ograniczenie zakresu danych przepływających przez potoki poprzez właściwą ekstrakcję, transformację i ładowanie. Osiągamy to m.in. przez filtrowanie, łączenie z tabelami referencyjnymi i wykonywanie agregacji.
Podstawowym sposobem filtrowania tabel w SQL jest klauzula WHERE. Jest prosta w użyciu, a jednocześnie niezwykle potężna. Warunki mogą być proste (równość), wyszukiwać podobne łańcuchy, a nawet wykorzystywać podzapytania. Możesz łączyć wiele warunków przy pomocy AND i OR!
Filtrowanie po prostych przypadkach, np. szukanie konkretnej wartości w kolumnie, może wyglądać tak:
SELECT *
FROM sample_table
WHERE sample_col = 23
Bardziej złożone konstrukcje, takie jak LIKE lub IN, zwiększają elastyczność klauzul WHERE. Przykładowo, poniższe zapytanie wyszukuje osoby, których imię zaczyna się na J (dzięki symbolowi %), a nazwisko jest IN podanej liście.
SELECT *
FROM sample_table
WHERE name LIKE ‘J%’ /* looks for people whose name starts with J */
AND last_name IN (‘Smith’, ‘Rockefeller’, ‘Williams’) /* Looks for people whose last name is in this list */
Wreszcie podzapytania dają dodatkową elastyczność, bo filtr może opierać się na wynikach innej tabeli. Popularny przykład to lista ID klientów po określonej dacie i czasie.
SELECT *
FROM sample_table
WHERE customer_id IN (SELECT id FROM reference_table WHERE date >= ‘2024-01-01’)
Kombinacja tych technik zapewnia, że twoje dane wejściowe są dokładnie tym, czego szukasz, a rozmiary zbiorów są minimalizowane. Bardzo użyteczne jest też usuwanie duplikatów filtrami. Warto poznać bardziej zaawansowane techniki, jak filtry HAVING dla agregacji czy QUALIFY z funkcjami okna.
Łączenie tabel pozwala zebrać dodatkowe informacje potrzebne do zbiorów. SQL oferuje różne joiny: INNER, OUTER, LEFT i RIGHT. W INNER i OUTER decydujemy, które dane zachować: INNER zachowuje tylko dopasowane z obu stron, a OUTER także niedopasowane w zależności od strony (left lub right).
Join LEFT zachowuje dane z lewej strony, a RIGHT — z prawej. Możesz łączyć LEFT/RIGHT z INNER/OUTER oraz użyć specjalnego FULL OUTER JOIN, który łączy wszystkie dane z obu tabel.
Przykładowy join może wyglądać tak:
SELECT *
FROM a
LEFT OUTER JOIN
b
WHERE a.id = b.id
Powyżej tabela a jest po lewej (bo jest pierwsza), a b po prawej (druga). LEFT OUTER JOIN mówi: połącz dane z a i b, gdzie a.id = b.id, ale jeśli nie ma dopasowania, zachowaj wszystkie dane z a. Joiny są potężnym sposobem na wzbogacenie danych wejściowych.
Ostatnim narzędziem w SQL dla wranglingu jest klauzula GROUP BY do agregacji. Upraszcza dane i pozwala wstępnie je przetworzyć przed dalszym etapem potoku. Agregacja to potężny sposób na wyliczenie statystyk podsumowujących. Oto przykład sumy sprzedaży wg ID klienta:
SELECT
Customer_ID,
SUM(sales)
FROM sample_table
GROUP BY Customer_ID
Istnieje wiele funkcji agregujących, takich jak SUM, MEAN, MAX i MIN, które szybko dają ogląd danych. Wykorzystanie agregacji upraszcza dopływ danych do potoków.
W tej sekcji omówimy praktyczne przykłady i zastosowania technik wranglingu. Skupimy się na: standaryzacji danych, łączeniu źródeł oraz przetwarzaniu tekstu.
Standaryzacja do tych samych jednostek jest ważna. Jeśli mierzymy to samo w różnych jednostkach lub walutach, może to zaburzyć analizę.
Pokażemy prosty przykład konwersji różnych walut do USD w SQL. Załóżmy, że mamy dwie tabele. Tabela 1 to tabela sales z danymi sprzedaży produktów dla różnych regionów, a Tabela 2 to currency_exchange z kursami wymiany dla regionów w poszczególne dni. Przykładowa konwersja może wyglądać tak:
SELECT
a.sale_id,
a.region,
CASE WHEN region <> ‘US’
	THEN a.sale_price * b.exchange_rate
	ELSE a.sale_price
END AS sale_price
FROM sales AS a
LEFT OUTER JOIN
currency_exchange AS b
WHERE a.region = b.region
Pobieramy sale_id i region z tabeli sales i łączymy z tabelą referencyjną currency_exchange po regionie, aby uzyskać kurs. Często dochodzi też data, by użyć kursu z konkretnego dnia.
Duża część wranglingu to przygotowanie danych dla modeli uczenia maszynowego. Ostatnio wiele modeli koncentruje się na przetwarzaniu języka naturalnego, a wstępem bywa analiza sentymentu na danych tekstowych.
Kluczowym krokiem jest przygotowanie tekstu przez normalizację i usunięcie znaków interpunkcyjnych. Ponieważ interpunkcja i wielkość liter często nie wnoszą istotnego kontekstu dla modelu, zwykle lepiej jest je znormalizować.
Wykorzystamy podstawowe pakiety Pythona i pakiet re. Poniżej przykład usuwania interpunkcji, normalizacji do małych liter i przycinania pustych znaków.
# import regex
import re

# input string
test_string = "       Python 3.0, released in 2008, was a major revision of the language that is not completely backward compatible and much Python 2 code does not run unmodified on Python 3. With Python 2's end-of-life, only Python 3.6.x[30] and later are supported, with older versions still supporting e.g. Windows 7 (and old installers not restricted to 64-bit Windows)."
# remove whitespaces
no_space_string = test_string.strip()

# convert to lower case
lower_string = no_space_string .lower()

# remove numbers
no_number_string = re.sub(r'\d+','',lower_string)
print(no_number_string)
Powyższy fragment kodu to świetna podstawa do usuwania spacji, konwersji na małe litery i usuwania liczb/znaków niealfabetycznych.
Data wrangling to kluczowy element przygotowania danych do modeli uczenia maszynowego i analiz. W Pythonie mamy mnóstwo narzędzi, jak pakiety pandas i numpy, a w SQL — metody takie jak klauzule WHERE i GROUP BY, które pozwalają przygotować dane.
Opanowanie tych technik jest kluczowe dla każdego aspirującego specjalisty danych. Jeśli chcesz zgłębić temat, rozważ te materiały:
Najlepsze kursy DataCamp
course
course
Track