
Kurs
Einführung in die Statistik in Python
4 Std.
197.1K
Wenn du bereits unser Tutorial zur Kovarianz kennst, weißt du, dass es darum geht, wie sich zwei Variablen gemeinsam verändern. Korrelation geht einen Schritt weiter und standardisiert dieses Maß, sodass du Beziehungen über verschiedene Datensätze hinweg vergleichen kannst.
In diesem Guide erfährst du, was Korrelation ist (wir konzentrieren uns auf die gängigste Variante, die Pearson-Korrelation), worin sie sich von der Kovarianz unterscheidet und wie du sie mit Python und R berechnest und interpretierst. Am Ende schauen wir uns außerdem verschiedene Korrelationstypen für unterschiedliche Anwendungsfälle an.
Wenn du deine Statistikkompetenzen weiter ausbauen willst, schau dir unseren Lernpfad Statistics Fundamentals in Python oder den Kurs Introduction to Statistics in R an.
Korrelation misst Stärke und Richtung einer linearen Beziehung zwischen zwei quantitativen Variablen. Sie hilft dir zu verstehen, wie Änderungen der einen Variable mit Änderungen der anderen zusammenhängen.
Eine positive Korrelation bedeutet: Steigt die eine Variable, steigt tendenziell auch die andere. Eine negative Korrelation bedeutet: Steigt die eine Variable, sinkt die andere tendenziell.
Hier die Kernpunkte:
Wie erwähnt misst der Pearson-Korrelationskoeffizient die lineare Beziehung zwischen zwei stetigen Variablen. Was ich noch nicht gesagt habe: Er setzt normalverteilte Daten voraus (genauer: gemeinsame Normalverteilung der Variablen, bekannt als bivariat normalverteilt – hier gibt es Feinheiten) und ist empfindlich gegenüber Ausreißern. Der Pearson-Korrelationskoeffizient wird mit r bezeichnet.
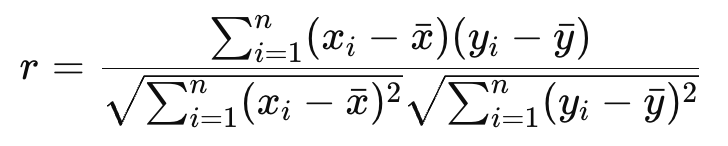
Dabei sind xi und yi Datenpunkte, und x bzw. y sind ihre jeweiligen Mittelwerte.
Schauen wir uns an, wie die Berechnung in Python und R funktioniert.
Den Pearson-Korrelationskoeffizienten berechnest du in Python mit der Funktion pearsonr() aus dem Modul scipy.stats:
import numpy as np
from scipy.stats import pearsonr

# Temperature data in Celsius and corresponding Fahrenheit
temperature_celsius = np.array([0, 10, 20, 30, 40])
temperature_fahrenheit = np.array([32, 50, 68, 86, 104])  # Converted from Celsius

# Calculate Pearson correlation coefficient
correlation_coefficient, p_value = pearsonr(temperature_celsius, temperature_fahrenheit)
print("Pearson correlation coefficient:", correlation_coefficient)
Pearson correlation coefficient: 1.0
p-value: 0.0Die Ausgabe zeigt eine perfekte positive lineare Beziehung zwischen x_values und y_values (denn wir haben y einfach als 2x definiert).
In R verwendest du die Funktion cor():
temperature_celsius <- c(0, 10, 20, 30, 40)
temperature_fahrenheit <- c(32, 50, 68, 86, 104)  # Converted from Celsius

# Calculate Pearson correlation coefficient
correlation_coefficient <- cor(temperature_celsius, temperature_fahrenheit, method = "pearson")
print(correlation_coefficient)
[1] 1Auch hier zeigt die Ausgabe eine perfekte positive lineare Beziehung – wie zuvor.
Eine Korrelationsmatrix zeigt die Korrelationskoeffizienten zwischen mehreren Variablenpaaren in einem Datensatz. Sie ist hilfreich, um Beziehungen in multivariaten Daten zu erkunden.
Üblich ist es, Variablen in Matrixform darzustellen, zum Beispiel als pandas DataFrame, und die Korrelationsmatrix direkt zu berechnen:
import pandas as pd

# Create a DataFrame with two perfectly correlated variables and one that isn't
data = pd.DataFrame({
    'temperature_celsius': [0, 10, 20, 30, 40],
    'temperature_fahrenheit': [32, 50, 68, 86, 104],  # Perfect linear transformation
    'ice_cream_sales': [100, 150, 200, 220, 230]      # Roughly increasing, not perfectly
})

# Calculate the Pearson correlation matrix
correlation_matrix = data.corr(method='pearson')
print(correlation_matrix)
temperature_celsius temperature_fahrenheit ice_cream_sales
temperature_celsius 1.000000 1.000000 0.993858
temperature_fahrenheit 1.000000 1.000000 0.993858
ice_cream_sales 0.993858 0.993858 1.000000Diese Ausgabe zeigt:
Eine perfekte positive Korrelation zwischen temperature_celsius und temperature_fahrenheit (wie erwartet, wie zuvor).
Eine starke, aber nicht perfekte Korrelation zwischen ice_cream_sales und sowohl temperature_celsius als auch temperature_fahrenheit.
In R erreichst du dasselbe mit der bereits genutzten Funktion cor(), angewendet auf ein Data Frame oder eine Matrix:
# Create a data frame with two perfectly correlated variables and one unrelated
data <- data.frame(
  temperature_celsius = c(0, 10, 20, 30, 40),
  temperature_fahrenheit = c(32, 50, 68, 86, 104),  # Perfect conversion from Celsius
  ice_cream_sales = c(100, 150, 200, 220, 230)      # Generally increases, but not perfectly
)

# Calculate the correlation matrix
correlation_matrix <- cor(data, method = "pearson")
print(correlation_matrix)
temperature_celsius temperature_fahrenheit ice_cream_sales
temperature_celsius 1.00 1.00 0.99
temperature_fahrenheit 1.00 1.00 0.99
ice_cream_sales 0.99 0.99 1.00Diese R-Ausgabe spiegelt das Python-Beispiel wider, mit:
Perfekter positiver Korrelation zwischen temperature_celsius und temperature_fahrenheit.
Starker positiver Korrelation zwischen ice_cream_sales und temperature_celsius bzw. temperature_fahrenheit.
Diese Matrixansicht ist besonders hilfreich, um potenzielle Multikollinearität in Regressionsmodellen zu erkennen oder Variablen für Dimensionsreduktionstechniken wie PCA auszuwählen.
Korrelation erfasst lineare Zusammenhänge. Lass uns sie nun klar von ähnlich klingenden Konzepten abgrenzen.
Beide messen, wie sich zwei Variablen gemeinsam verändern, unterscheiden sich jedoch in zwei Punkten: Skalierung und Interpretierbarkeit.
Kovarianz zeigt die Richtung einer linearen Beziehung, aber nicht ihre Stärke in standardisierter Form. Ihr Wert hängt von den Einheiten der Variablen ab, was Vergleiche über Datensätze hinweg erschwert.
Korrelation standardisiert die Kovarianz, indem sie durch die Standardabweichungen der Variablen teilt. So entsteht ein einheitenloser Wert zwischen -1 und 1.
R-squared (R²), auch Bestimmtheitsmaß, wird mitunter mit Korrelation verwechselt. Das sehe ich vor allem, wenn Analysten die Modellgüte interpretieren wollen.
Korrelation (Pearsons r) misst Stärke und Richtung einer linearen Beziehung zwischen zwei Variablen.
R-Quadrat gibt den Varianzanteil an, der in einer Variable durch eine andere Variable in einem linearen Regressionsmodell erklärt wird. Bei der einfachen linearen Regression ist es das Quadrat von Pearsons r.
Verwechsele Korrelation nicht mit Kausalität! Das ist ein häufiger Fehler.
Korrelation zeigt nur, dass zwei Variablen gemeinsam schwanken. Sie erklärt nicht, warum. Sie ist also deskriptiv, nicht erklärend. Korrelation kann durch Zufall, Störvariablen oder umgekehrte Kausalität entstehen.
Kausalität bedeutet, dass eine Änderung in einer Variable eine Änderung in der anderen direkt verursacht. Diskussionen über Kausalität gehören in kontrollierte Experimente oder in den Kontext kausaler Inferenzmethoden.
Es ist wichtig, typische Stolpersteine zu kennen, die Analysten passieren können:
In diesem Artikel haben wir den Pearson-Korrelationskoeffizienten behandelt, da er direkt auf dem Konzept der Kovarianz aufbaut und in der Praxis am häufigsten eingesetzt wird. Jetzt werfen wir einen Blick auf andere Typen.
Die Spearman-Rangkorrelation bewertet Stärke und Richtung einer monotonen Beziehung anhand von Rängen. Sie ist nichtparametrisch und eignet sich gut für ordinale Daten oder nichtlineare, aber konsistente Trends.
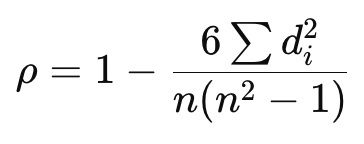
Dabei gilt:
Kendalls Tau misst ebenfalls monotone Beziehungen über Ränge, basiert jedoch auf der Anzahl konkordanter und diskordanter Paare. Es ist robuster bei Bindungen (Ties) und kleinen Stichproben.
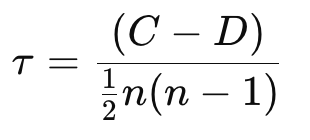
Dabei gilt:
Ich hoffe, dieser Artikel war hilfreich. Wie du gesehen hast, ist Korrelation ein grundlegendes Werkzeug der Datenanalyse, um Beziehungen zwischen Variablen zu verstehen.
Lerne mit unseren Kursen weiter. Ich empfehle dir den Lernpfad Statistics Fundamentals in Python oder den Kurs Introduction to Statistics in R als nächste Schritte.
Lerne mit DataCamp
Kurs
Kurs
Lernpfad