Khóa học
Nhập môn Thống kê với Python
4 giờ
200.4K
Nếu bạn đã xem qua hướng dẫn về hiệp phương sai, bạn biết đó là cách hai biến thay đổi cùng nhau. Tương quan đưa khái niệm này đi xa hơn bằng cách chuẩn hóa thước đo để bạn có thể so sánh các mối quan hệ trên những bộ dữ liệu khác nhau.
Trong hướng dẫn này, bạn sẽ học tương quan là gì (cụ thể, chúng ta sẽ tập trung vào loại phổ biến nhất, gọi là tương quan Pearson), nó khác gì so với hiệp phương sai, cũng như cách tính và diễn giải bằng Python và R. Cuối bài, chúng ta cũng sẽ đề cập đến các loại tương quan khác dùng cho những kịch bản khác nhau.
Để tiếp tục củng cố kỹ năng thống kê, đừng bỏ lỡ lộ trình kỹ năng Những nền tảng Thống kê với Python hoặc khóa học Nhập môn Thống kê với R.
Tương quan đo lường độ mạnh và chiều hướng của mối quan hệ tuyến tính giữa hai biến định lượng. Nó giúp bạn hiểu sự thay đổi ở một biến gắn liền với sự thay đổi ở biến còn lại như thế nào.
Tương quan dương nghĩa là khi một biến tăng, biến kia cũng có xu hướng tăng. Tương quan âm nghĩa là khi một biến tăng, biến kia có xu hướng giảm.
Tôi sẽ liệt kê những ý chính:
Như đã đề cập, hệ số tương quan Pearson đo mối quan hệ tuyến tính giữa hai biến liên tục. Điều tôi chưa nói: Nó giả định dữ liệu phân phối chuẩn (thực ra, chính xác hơn là giả định các biến cùng tuân theo phân phối chuẩn chung, được gọi là chuẩn song biến - có chút sắc thái ở đây), và nhạy cảm với các giá trị ngoại lai. Hệ số tương quan Pearson được ký hiệu là r.
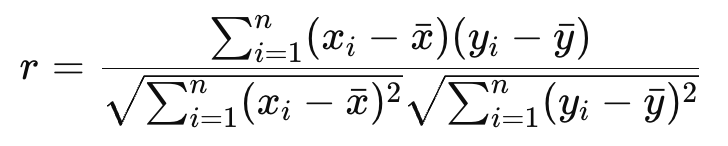
trong đó xi và yi là các điểm dữ liệu, và x và y là giá trị trung bình tương ứng của chúng.
Hãy xem cách tính trong Python và R.
Bạn có thể tính hệ số tương quan Pearson trong Python bằng hàm pearsonr() từ mô-đun scipy.stats:
import numpy as np
from scipy.stats import pearsonr

# Temperature data in Celsius and corresponding Fahrenheit
temperature_celsius = np.array([0, 10, 20, 30, 40])
temperature_fahrenheit = np.array([32, 50, 68, 86, 104])  # Converted from Celsius

# Calculate Pearson correlation coefficient
correlation_coefficient, p_value = pearsonr(temperature_celsius, temperature_fahrenheit)
print("Pearson correlation coefficient:", correlation_coefficient)
Pearson correlation coefficient: 1.0
p-value: 0.0Kết quả cho thấy mối quan hệ tuyến tính dương hoàn hảo giữa x_values và y_values (vì chúng ta vừa định nghĩa y là 2x).
Với R, bạn có thể dùng hàm cor():
temperature_celsius <- c(0, 10, 20, 30, 40)
temperature_fahrenheit <- c(32, 50, 68, 86, 104)  # Converted from Celsius

# Calculate Pearson correlation coefficient
correlation_coefficient <- cor(temperature_celsius, temperature_fahrenheit, method = "pearson")
print(correlation_coefficient)
[1] 1Kết quả này cũng cho thấy mối quan hệ tuyến tính dương hoàn hảo, giống như trước.
Ma trận tương quan hiển thị các hệ số tương quan giữa nhiều cặp biến trong một bộ dữ liệu. Nó hữu ích để khám phá các mối quan hệ trong dữ liệu đa biến.
Thông thường, biểu diễn biến trong dạng ma trận, như pandas DataFrame, và tính trực tiếp ma trận tương quan:
import pandas as pd

# Create a DataFrame with two perfectly correlated variables and one that isn't
data = pd.DataFrame({
    'temperature_celsius': [0, 10, 20, 30, 40],
    'temperature_fahrenheit': [32, 50, 68, 86, 104],  # Perfect linear transformation
    'ice_cream_sales': [100, 150, 200, 220, 230]      # Roughly increasing, not perfectly
})

# Calculate the Pearson correlation matrix
correlation_matrix = data.corr(method='pearson')
print(correlation_matrix)
temperature_celsius temperature_fahrenheit ice_cream_sales
temperature_celsius 1.000000 1.000000 0.993858
temperature_fahrenheit 1.000000 1.000000 0.993858
ice_cream_sales 0.993858 0.993858 1.000000Kết quả này cho thấy:
Tương quan dương hoàn hảo giữa temperature_celsius và temperature_fahrenheit (như kỳ vọng, giống trước đó).
Tương quan mạnh nhưng không hoàn hảo giữa ice_cream_sales và cả temperature_celsius lẫn temperature_fahrenheit.
Trong R, bạn có thể làm tương tự với hàm cor() chúng ta đã dùng trước đó, áp dụng cho một data frame hoặc ma trận:
# Create a data frame with two perfectly correlated variables and one unrelated
data <- data.frame(
  temperature_celsius = c(0, 10, 20, 30, 40),
  temperature_fahrenheit = c(32, 50, 68, 86, 104),  # Perfect conversion from Celsius
  ice_cream_sales = c(100, 150, 200, 220, 230)      # Generally increases, but not perfectly
)

# Calculate the correlation matrix
correlation_matrix <- cor(data, method = "pearson")
print(correlation_matrix)
temperature_celsius temperature_fahrenheit ice_cream_sales
temperature_celsius 1.00 1.00 0.99
temperature_fahrenheit 1.00 1.00 0.99
ice_cream_sales 0.99 0.99 1.00Kết quả R này phản chiếu ví dụ Python, với:
Tương quan dương hoàn hảo giữa temperature_celsius và temperature_fahrenheit.
Tương quan âm mạnh giữa ice_cream_sales và temperature_celsius hoặc temperature_fahrenheit.
Cách xem dạng ma trận này đặc biệt hữu ích để xác định tiềm năng đa cộng tuyến trong hồi quy hoặc chọn biến cho các kỹ thuật giảm chiều như PCA.
Ta thấy tương quan nắm bắt các liên kết tuyến tính. Giờ hãy cẩn trọng phân biệt nó với những khái niệm nghe có vẻ tương tự.
Cả tương quan và hiệp phương sai đều đo cách hai biến thay đổi cùng nhau, nhưng khác nhau ở hai điểm: thang đo và khả năng diễn giải.
Hiệp phương sai cho biết chiều hướng của mối quan hệ tuyến tính nhưng không chuẩn hóa độ mạnh của nó. Giá trị của nó phụ thuộc vào đơn vị của các biến, khiến việc so sánh giữa các bộ dữ liệu trở nên khó khăn.
Tương quan chuẩn hóa hiệp phương sai bằng cách chia cho độ lệch chuẩn của các biến, tạo ra một giá trị không đơn vị trong khoảng từ -1 đến 1.
R-squared (R²), hay hệ số xác định, cũng dễ bị nhầm với tương quan. Tôi thường thấy điều này khi các nhà phân tích cố diễn giải hiệu năng mô hình.
Tương quan (r của Pearson) đo độ mạnh và chiều hướng của mối quan hệ tuyến tính giữa hai biến.
R-squared biểu thị tỷ lệ phương sai ở một biến có thể dự đoán được từ biến khác trong mô hình hồi quy tuyến tính. Xét về mặt toán, trong hồi quy tuyến tính đơn, nó là bình phương của r Pearson.
Đừng đánh đồng tương quan với quan hệ nhân quả! Đây là lỗi thường gặp.
Tương quan chỉ cho thấy hai biến cùng biến động. Nó không giải thích vì sao. Vì thế, nó mang tính mô tả, không phải giải thích. Tương quan có thể do ngẫu nhiên, biến gây nhiễu, hoặc quan hệ nhân quả đảo ngược.
Quan hệ nhân quả ngụ ý rằng thay đổi ở một biến trực tiếp gây ra thay đổi ở biến khác. Hãy để bàn về nhân quả trong các thí nghiệm có kiểm soát hoặc trong bối cảnh các kỹ thuật suy luận nhân quả.
Điều quan trọng là nhận biết những điều các nhà phân tích hay mắc sai:
Trong bài viết này, chúng ta đã đề cập đến hệ số tương quan Pearson, vì đây là phiên bản tương quan được xây dựng trực tiếp trên khái niệm hiệp phương sai và là thước đo được dùng phổ biến nhất trong thực tế. Giờ hãy xem các loại khác.
Tương quan hạng Spearman đánh giá độ mạnh và chiều hướng của mối quan hệ đơn điệu bằng cách dùng các giá trị theo thứ hạng. Nó phi tham số và hoạt động tốt với dữ liệu thứ bậc hoặc xu hướng phi tuyến nhưng nhất quán.
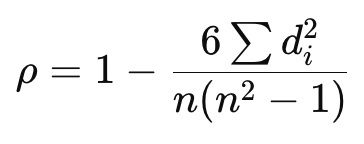
Trong đó:
Hệ số Kendall tau cũng đo các mối quan hệ đơn điệu bằng thứ hạng nhưng dựa trên số cặp tương hợp và bất hợp. Nó bền vững hơn khi có nhiều đồng hạng và cỡ mẫu nhỏ.
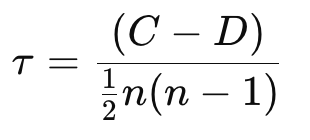
Trong đó:
Hy vọng bạn thấy bài viết này hữu ích. Như bạn đã thấy, tương quan là công cụ phân tích dữ liệu nền tảng để hiểu các mối quan hệ giữa các biến.
Hãy tham gia các khóa học của chúng tôi để tiếp tục học hỏi. Tôi gợi ý lộ trình kỹ năng Những nền tảng Thống kê với Python hoặc khóa học Nhập môn Thống kê với R như những bước tiếp theo tuyệt vời.
Học cùng DataCamp
Khóa học
Khóa học
Lộ trình
blog
Matt Crabtree
10 phút
