
Cours
Introduction aux statistiques en Python
4 h
197.2K
Si vous avez déjà parcouru notre tutoriel sur la covariance, vous savez qu’il s’agit de comprendre comment deux variables évoluent ensemble. La corrélation va plus loin en normalisant cette mesure pour comparer des relations entre différents jeux de données.
Dans ce guide, vous allez découvrir ce qu’est la corrélation (nous nous concentrerons sur la plus courante, la corrélation de Pearson), en quoi elle diffère de la covariance, et comment la calculer et l’interpréter avec Python et R. Pour finir, nous passerons en revue d’autres types de corrélations adaptés à des cas d’usage différents.
Pour continuer à renforcer vos compétences en statistiques, ne manquez pas notre parcours de compétences Statistics Fundamentals in Python ou le cours Introduction to Statistics in R.
La corrélation mesure l’intensité et la direction d’une relation linéaire entre deux variables quantitatives. Elle permet de comprendre comment les variations de l’une sont associées aux variations de l’autre.
Une corrélation positive signifie que lorsque l’une augmente, l’autre tend à augmenter. Une corrélation négative signifie que lorsque l’une augmente, l’autre tend à diminuer.
Voici les idées clés :
Comme indiqué, le coefficient de corrélation de Pearson mesure la relation linéaire entre deux variables continues. Ce que je n’ai pas encore précisé : il suppose des données suivant une loi normale (plus exactement, il suppose que les variables sont conjointement normales, ce que l’on appelle la normalité bivariée — nuance importante) et il est sensible aux valeurs aberrantes. Le coefficient de Pearson est noté r.
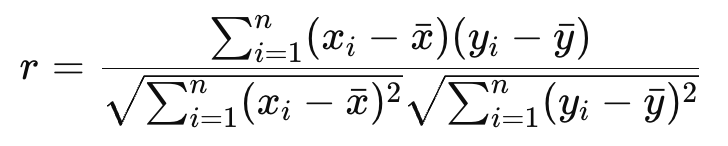
où xi et yi sont les observations, et x et y leurs moyennes respectives.
Voyons comment le calculer en Python et en R.
Vous pouvez calculer le coefficient de Pearson en Python avec la fonction pearsonr() du module scipy.stats :
import numpy as np
from scipy.stats import pearsonr

# Temperature data in Celsius and corresponding Fahrenheit
temperature_celsius = np.array([0, 10, 20, 30, 40])
temperature_fahrenheit = np.array([32, 50, 68, 86, 104])  # Converted from Celsius

# Calculate Pearson correlation coefficient
correlation_coefficient, p_value = pearsonr(temperature_celsius, temperature_fahrenheit)
print("Pearson correlation coefficient:", correlation_coefficient)
Pearson correlation coefficient: 1.0
p-value: 0.0La sortie montre une relation linéaire positive parfaite entre x_values et y_values (puisque nous avons défini y comme 2x).
En R, utilisez la fonction cor() :
temperature_celsius <- c(0, 10, 20, 30, 40)
temperature_fahrenheit <- c(32, 50, 68, 86, 104)  # Converted from Celsius

# Calculate Pearson correlation coefficient
correlation_coefficient <- cor(temperature_celsius, temperature_fahrenheit, method = "pearson")
print(correlation_coefficient)
[1] 1Cette sortie indique également une relation linéaire positive parfaite, comme précédemment.
Une matrice de corrélation affiche les coefficients de corrélation entre plusieurs paires de variables d’un jeu de données. Elle est utile pour explorer les relations dans des données multivariées.
On représente souvent les variables sous forme matricielle, par exemple un DataFrame pandas, puis on calcule directement la matrice de corrélation :
import pandas as pd

# Create a DataFrame with two perfectly correlated variables and one that isn't
data = pd.DataFrame({
    'temperature_celsius': [0, 10, 20, 30, 40],
    'temperature_fahrenheit': [32, 50, 68, 86, 104],  # Perfect linear transformation
    'ice_cream_sales': [100, 150, 200, 220, 230]      # Roughly increasing, not perfectly
})

# Calculate the Pearson correlation matrix
correlation_matrix = data.corr(method='pearson')
print(correlation_matrix)
temperature_celsius temperature_fahrenheit ice_cream_sales
temperature_celsius 1.000000 1.000000 0.993858
temperature_fahrenheit 1.000000 1.000000 0.993858
ice_cream_sales 0.993858 0.993858 1.000000Cette sortie montre :
Une corrélation positive parfaite entre temperature_celsius et temperature_fahrenheit (comme attendu, comme plus haut).
Une corrélation forte mais non parfaite entre ice_cream_sales et temperature_celsius ainsi que temperature_fahrenheit.
En R, vous obtenez le même résultat avec la fonction cor() déjà utilisée, appliquée à un data frame ou une matrice :
# Create a data frame with two perfectly correlated variables and one unrelated
data <- data.frame(
  temperature_celsius = c(0, 10, 20, 30, 40),
  temperature_fahrenheit = c(32, 50, 68, 86, 104),  # Perfect conversion from Celsius
  ice_cream_sales = c(100, 150, 200, 220, 230)      # Generally increases, but not perfectly
)

# Calculate the correlation matrix
correlation_matrix <- cor(data, method = "pearson")
print(correlation_matrix)
temperature_celsius temperature_fahrenheit ice_cream_sales
temperature_celsius 1.00 1.00 0.99
temperature_fahrenheit 1.00 1.00 0.99
ice_cream_sales 0.99 0.99 1.00Cette sortie R reflète l’exemple Python, avec :
Une corrélation positive parfaite entre temperature_celsius et temperature_fahrenheit.
Une corrélation forte entre ice_cream_sales et temperature_celsius ou temperature_fahrenheit.
Ce type de vue matricielle est particulièrement utile pour identifier les multicolinéarités en régression ou choisir des variables pour des techniques de réduction de dimension comme PCA.
La corrélation capture les associations linéaires. Prenons maintenant le temps de bien la distinguer d’idées proches.
La corrélation et la covariance mesurent toutes deux la co‑variation de deux variables, mais elles diffèrent sur deux points : l’échelle et l’interprétabilité.
Covariance indique la direction d’une relation linéaire, mais pas son intensité de manière standardisée. Sa valeur dépend des unités des variables, ce qui complique les comparaisons entre jeux de données.
Corrélation standardise la covariance en la divisant par les écarts types des variables, produisant une valeur sans unité comprise entre -1 et 1.
R-squared (R²), ou coefficient de détermination, est parfois confondu avec la corrélation. Je l’observe notamment lorsque l’on interprète les performances d’un modèle.
Corrélation (le r de Pearson) mesure l’intensité et la direction d’une relation linéaire entre deux variables.
R‑carré représente la part de variance d’une variable prédictible à partir d’une autre dans un modèle de régression linéaire. En régression linéaire simple, c’est le carré du r de Pearson.
Ne confondez pas corrélation et causalité ! C’est une erreur fréquente.
Corrélation montre seulement que deux variables évoluent ensemble. Elle n’explique pas pourquoi. Elle est descriptive, pas explicative. La corrélation peut résulter d’une coïncidence, de variables confondantes, ou d’une causalité inversée.
Causalité implique qu’une modification d’une variable provoque directement une modification de l’autre. Réservez les discussions sur la causalité aux expériences contrôlées ou aux approches d’inférence causale.
Voici quelques écueils classiques à connaître :
Dans cet article, nous avons présenté le coefficient de Pearson, car il découle directement de la covariance et reste la mesure la plus utilisée en pratique. Voyons maintenant d’autres variantes.
La corrélation de Spearman évalue l’intensité et la direction d’une relation monotone à partir des rangs. Elle est non paramétrique et convient bien aux données ordinales ou aux tendances non linéaires mais régulières.
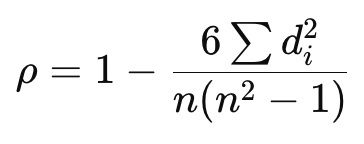
Où :
Le coefficient tau de Kendall mesure également les relations monotones via les rangs, mais se base sur le nombre de paires concordantes et discordantes. Il est plus robuste en présence d’égalités de rang et d’échantillons de petite taille.
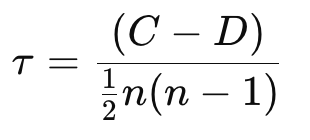
Où :
Nous espérons que cet article vous a été utile. Comme vous l’avez vu, la corrélation est un outil fondamental pour comprendre les relations entre variables.
Poursuivez votre apprentissage avec nos cours. Nous vous recommandons le parcours de compétences Statistics Fundamentals in Python ou le cours Introduction to Statistics in R comme prochaines étapes pertinentes.
Apprenez avec DataCamp
Cours
Cours
Cursus