
कोर्स
Python में Statistics परिचय
4 घंटा
198.9K
यदि आपने हमारा कोवेरिएंस पर ट्यूटोरियल देखा है, तो आप जानते हैं कि यह दो चरों के साथ-साथ बदलने के तरीके के बारे में है। कोरिलेशन उस अवधारणा को एक कदम आगे ले जाता है और माप को मानकीकृत करता है ताकि आप अलग-अलग डेटासेट्स में रिश्तों की तुलना कर सकें।
इस गाइड में, आप सीखेंगे कि कोरिलेशन क्या है (विशेष रूप से, हम सबसे सामान्य वाले, जिसे Pearson correlation कहा जाता है, पर ध्यान देंगे), यह कोवेरिएंस से कैसे अलग है, और Python और R का उपयोग करके इसे कैसे गणना और व्याख्यायित किया जाता है। अंत में, हम विभिन्न परिदृश्यों में उपयोग होने वाली अलग-अलग प्रकार की कोरिलेशन पर भी चर्चा करेंगे।
अपनी सांख्यिकी कौशल को और मजबूत करने के लिए, हमारे Statistics Fundamentals in Python स्किल ट्रैक या Introduction to Statistics in R कोर्स को न चूकें।
कोरिलेशन दो मात्रात्मक चरों के बीच रैखिक संबंध की शक्ति और दिशा को मापता है। यह समझने में मदद करता है कि एक चर में परिवर्तन दूसरे में परिवर्तनों से कैसे जुड़ा है।
सकारात्मक कोरिलेशन का अर्थ है कि जैसे एक चर बढ़ता है, दूसरा भी सामान्यतः बढ़ता है। नकारात्मक कोरिलेशन का अर्थ है कि जैसे एक चर बढ़ता है, दूसरा सामान्यतः घटता है।
मुख्य बातें सूचीबद्ध कर दूँ:
जैसा कि मैंने बताया, पीयर्सन कोरिलेशन गुणांक दो सतत चरों के बीच रैखिक संबंध को मापता है। जो मैंने अभी तक नहीं कहा: यह सामान्य रूप से वितरित डेटा मानता है (वास्तव में, अधिक सटीक रूप से, यह मानता है कि चर संयुक्त रूप से सामान्य रूप से वितरित हैं, जिसे बाइवेरिएट नॉर्मैलिटी कहते हैं — यहाँ थोड़ी बारीकी है), और आउटलायर्स के प्रति संवेदनशील होता है। पीयर्सन कोरिलेशन गुणांक को r द्वारा निरूपित किया जाता है।
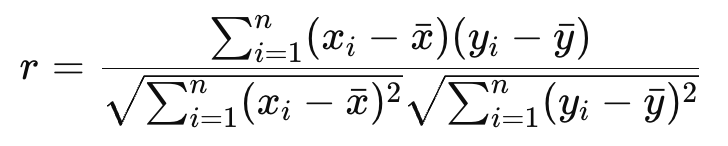
जहाँ xi और yi डेटा बिंदु हैं, और x तथा y उनके क्रमशः माध्य हैं।
आइए देखें कि इसे Python और R में कैसे गणना करें।
आप Python में scipy.stats मॉड्यूल की pearsonr() फ़ंक्शन का उपयोग करके पीयर्सन कोरिलेशन गुणांक की गणना कर सकते हैं:
import numpy as np
from scipy.stats import pearsonr

# Temperature data in Celsius and corresponding Fahrenheit
temperature_celsius = np.array([0, 10, 20, 30, 40])
temperature_fahrenheit = np.array([32, 50, 68, 86, 104])  # Converted from Celsius

# Calculate Pearson correlation coefficient
correlation_coefficient, p_value = pearsonr(temperature_celsius, temperature_fahrenheit)
print("Pearson correlation coefficient:", correlation_coefficient)
Pearson correlation coefficient: 1.0
p-value: 0.0यह आउटपुट x_values और y_values के बीच एक पूर्ण सकारात्मक रैखिक संबंध दिखाता है (क्योंकि हमने y को 2x के रूप में परिभाषित किया था)।
R में, आप cor() फ़ंक्शन का उपयोग कर सकते हैं:
temperature_celsius <- c(0, 10, 20, 30, 40)
temperature_fahrenheit <- c(32, 50, 68, 86, 104)  # Converted from Celsius

# Calculate Pearson correlation coefficient
correlation_coefficient <- cor(temperature_celsius, temperature_fahrenheit, method = "pearson")
print(correlation_coefficient)
[1] 1यह आउटपुट भी पहले की तरह ही एक पूर्ण सकारात्मक रैखिक संबंध को इंगित करता है।
कोरिलेशन मैट्रिक्स किसी डेटासेट में कई चरों के युग्मों के बीच कोरिलेशन गुणांकों को प्रदर्शित करता है। यह बहु-चर डेटा में रिश्तों की पड़ताल करने में उपयोगी है।
आमतौर पर चरों को मैट्रिक्स प्रारूप, जैसे pandas DataFrame, में दर्शाना और सीधे कोरिलेशन मैट्रिक्स निकालना प्रचलित है:
import pandas as pd

# Create a DataFrame with two perfectly correlated variables and one that isn't
data = pd.DataFrame({
    'temperature_celsius': [0, 10, 20, 30, 40],
    'temperature_fahrenheit': [32, 50, 68, 86, 104],  # Perfect linear transformation
    'ice_cream_sales': [100, 150, 200, 220, 230]      # Roughly increasing, not perfectly
})

# Calculate the Pearson correlation matrix
correlation_matrix = data.corr(method='pearson')
print(correlation_matrix)
temperature_celsius temperature_fahrenheit ice_cream_sales
temperature_celsius 1.000000 1.000000 0.993858
temperature_fahrenheit 1.000000 1.000000 0.993858
ice_cream_sales 0.993858 0.993858 1.000000यह आउटपुट दर्शाता है:
temperature_celsius और temperature_fahrenheit के बीच पूर्ण सकारात्मक कोरिलेशन (जैसा कि पहले अपेक्षित था)।
ice_cream_sales और temperature_celsius तथा temperature_fahrenheit दोनों के बीच मजबूत लेकिन अपूर्ण कोरिलेशन।
R में, आप पहले इस्तेमाल किए गए cor() फ़ंक्शन को डेटा फ्रेम या मैट्रिक्स पर लागू करके यही प्राप्त कर सकते हैं:
# Create a data frame with two perfectly correlated variables and one unrelated
data <- data.frame(
  temperature_celsius = c(0, 10, 20, 30, 40),
  temperature_fahrenheit = c(32, 50, 68, 86, 104),  # Perfect conversion from Celsius
  ice_cream_sales = c(100, 150, 200, 220, 230)      # Generally increases, but not perfectly
)

# Calculate the correlation matrix
correlation_matrix <- cor(data, method = "pearson")
print(correlation_matrix)
temperature_celsius temperature_fahrenheit ice_cream_sales
temperature_celsius 1.00 1.00 0.99
temperature_fahrenheit 1.00 1.00 0.99
ice_cream_sales 0.99 0.99 1.00यह R आउटपुट Python उदाहरण का प्रतिबिंब है, जिसमें:
temperature_celsius और temperature_fahrenheit के बीच पूर्ण सकारात्मक कोरिलेशन।
ice_cream_sales और temperature_celsius या temperature_fahrenheit के बीच मजबूत नकारात्मक कोरिलेशन।
इस तरह का मैट्रिक्स दृश्य विशेष रूप से ng संभावित रिग्रेशन में मल्टीकोलिनियरिटी की पहचान करने या PCA जैसी विमीयता न्यूनीकरण तकनीकों के लिए चर चुनने में उपयोगी है।
हम देखते हैं कि कोरिलेशन रैखिक सह-संबंधों को पकड़ता है। अब, आइए इसे मिलते-जुलते विचारों से स्पष्ट रूप से अलग करें।
कोरिलेशन और कोवेरिएंस दोनों इस बात को मापते हैं कि दो चर साथ में कैसे बदलते हैं, लेकिन वे दो बातों में भिन्न हैं: स्केल और व्याख्या-योग्यता।
कोवेरिएंस रैखिक संबंध की दिशा को दर्शाती है, पर इसकी शक्ति को मानकीकृत तरीके से नहीं। इसका मान चरों की इकाइयों पर निर्भर करता है, जिससे डेटासेट्स के बीच तुलना कठिन हो जाती है।
कोरिलेशन कोवेरिएंस को चरों के मानक विचलनों से विभाजित कर मानकीकृत करता है, जिससे -1 और 1 के बीच एक इकाई-रहित मान प्राप्त होता है।
R-squared (R²), या गुणांक निर्धारण, को भी कोरिलेशन से भ्रमित किया जा सकता है। मैंने इसे खासकर तब देखा है जब विश्लेषक मॉडल प्रदर्शन की व्याख्या करने की कोशिश करते हैं।
कोरिलेशन (पीयर्सन का r) दो चरों के बीच रैखिक संबंध की शक्ति और दिशा को मापता है।
R-squared रैखिक प्रतिगमन मॉडल में एक चर में उस वैरिएंस के अनुपात का प्रतिनिधित्व करता है, जिसकी भविष्यवाणी दूसरे चर से की जा सकती है। नतीजतन, सरल रैखिक प्रतिगमन में यह पीयर्सन के r का वर्ग होता है।
कोरिलेशन को कारण-कार्य संबंध न समझें! यह एक आम भूल है।
कोरिलेशन केवल यह दिखाता है कि दो चर साथ-साथ चलते हैं। यह यह नहीं बताता कि क्यों। इसलिए यह वर्णनात्मक है, व्याख्यात्मक नहीं। कोरिलेशन संयोग, भ्रमित करने वाले चरों, या उल्टे कार्य-कारण का परिणाम हो सकता है।
कार्य-कारण का अर्थ है कि एक चर में परिवर्तन दूसरे में सीधा कारण बनता है। कार्य-कारण की चर्चा नियंत्रित प्रयोगों या कारणात्मक अनुमान तकनीकों के संदर्भ में करें।
यह जानना महत्वपूर्ण है कि विश्लेषक आमतौर पर किन बातों में चूक सकते हैं:
इस लेख में, हमने पीयर्सन कोरिलेशन गुणांक को कवर किया, क्योंकि यह कोरिलेशन का वही संस्करण है जो सीधे कोवेरिएंस की अवधारणा पर आधारित है और व्यवहार में सबसे अधिक उपयोग होता है। लेकिन अब अन्य प्रकारों पर नज़र डालते हैं।
स्पीयरमैन रैंक कोरिलेशन क्रमबद्ध मानों का उपयोग करके मोनोटॉनिक संबंध की शक्ति और दिशा का आकलन करता है। यह नॉन-पैरामीट्रिक है और क्रमिक (ordinal) डेटा या गैर-रैखिक लेकिन सुसंगत ट्रेंड्स के लिए उपयुक्त है।
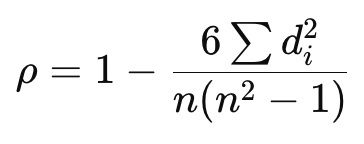
जहाँ:
केंडल टाउ गुणांक भी रैंकों का उपयोग करके मोनोटॉनिक संबंधों को मापता है, लेकिन यह समरूप (concordant) और विषम (discordant) युग्मों की संख्या पर आधारित होता है। टाईज़ और छोटे सैंपल्स की उपस्थिति में यह अधिक सुदृढ़ होता है।
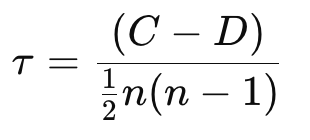
जहाँ:
मुझे आशा है कि यह लेख आपके लिए उपयोगी रहा होगा। जैसा कि आपने देखा, कोरिलेशन चरों के बीच संबंधों को समझने के लिए एक बुनियादी डेटा विश्लेषण उपकरण है।
सीखना जारी रखने के लिए हमारे कोर्स ज़रूर लें। अगले कदम के रूप में मैं हमारे Statistics Fundamentals in Python स्किल ट्रैक या हमारे Introduction to Statistics in R कोर्स की सिफारिश करता/करती हूँ।
DataCamp के साथ सीखें
कोर्स
कोर्स
लर्निंग पाथ