
Corso
Introduzione alla statistica in Python
4 ore
199.2K
Se hai già esplorato il nostro tutorial sulla covarianza, sai che riguarda il modo in cui due variabili cambiano insieme. La correlazione fa un passo in più standardizzando la misura, così puoi confrontare le relazioni tra dataset diversi.
In questa guida scoprirai cos’è la correlazione (in particolare ci concentreremo su quella più comune, la correlazione di Pearson), in cosa differisce dalla covarianza e come calcolarla e interpretarla con Python e R. Alla fine vedremo anche diversi tipi di correlazione usati in scenari differenti.
Per continuare a rafforzare le tue competenze di statistica, non perdere il nostro skill track Fondamenti di statistica in Python o il corso Introduzione alla statistica in R.
La correlazione misura l’intensità e la direzione di una relazione lineare tra due variabili quantitative. Ti aiuta a capire come i cambiamenti in una variabile sono associati ai cambiamenti in un’altra.
Una correlazione positiva significa che, all’aumentare di una variabile, tende ad aumentare anche l’altra. Una correlazione negativa significa che, all’aumentare di una variabile, l’altra tende a diminuire.
Ecco le idee principali:
Come accennato, il coefficiente di correlazione di Pearson misura la relazione lineare tra due variabili continue. Quello che non ho ancora detto: assume dati normalmente distribuiti (più precisamente, assume che le variabili siano congiuntamente normali, noto come normalità bivariata — c’è un po’ di sfumatura), ed è sensibile agli outlier. Il coefficiente di correlazione di Pearson si indica con r.
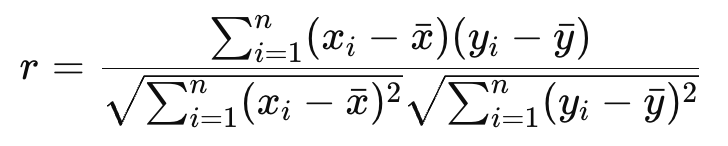
dove xi e yi sono i punti dati, e x e y sono le rispettive medie.
Vediamo come calcolarlo in Python e R.
Puoi calcolare il coefficiente di correlazione di Pearson in Python usando la funzione pearsonr() dal modulo scipy.stats:
import numpy as np
from scipy.stats import pearsonr

# Temperature data in Celsius and corresponding Fahrenheit
temperature_celsius = np.array([0, 10, 20, 30, 40])
temperature_fahrenheit = np.array([32, 50, 68, 86, 104])  # Converted from Celsius

# Calculate Pearson correlation coefficient
correlation_coefficient, p_value = pearsonr(temperature_celsius, temperature_fahrenheit)
print("Pearson correlation coefficient:", correlation_coefficient)
Pearson correlation coefficient: 1.0
p-value: 0.0L’output mostra una relazione lineare perfettamente positiva tra x_values e y_values (dato che abbiamo definito y come 2x).
In R, puoi usare la funzione cor():
temperature_celsius <- c(0, 10, 20, 30, 40)
temperature_fahrenheit <- c(32, 50, 68, 86, 104)  # Converted from Celsius

# Calculate Pearson correlation coefficient
correlation_coefficient <- cor(temperature_celsius, temperature_fahrenheit, method = "pearson")
print(correlation_coefficient)
[1] 1Anche questo output indica una relazione lineare perfettamente positiva, come prima.
Una matrice di correlazione mostra i coefficienti di correlazione tra più coppie di variabili in un dataset. È utile per esplorare le relazioni in dati multivariati.
È comune rappresentare le variabili in formato matriciale, come un DataFrame di pandas, e calcolare direttamente la matrice di correlazione:
import pandas as pd

# Create a DataFrame with two perfectly correlated variables and one that isn't
data = pd.DataFrame({
    'temperature_celsius': [0, 10, 20, 30, 40],
    'temperature_fahrenheit': [32, 50, 68, 86, 104],  # Perfect linear transformation
    'ice_cream_sales': [100, 150, 200, 220, 230]      # Roughly increasing, not perfectly
})

# Calculate the Pearson correlation matrix
correlation_matrix = data.corr(method='pearson')
print(correlation_matrix)
temperature_celsius temperature_fahrenheit ice_cream_sales
temperature_celsius 1.000000 1.000000 0.993858
temperature_fahrenheit 1.000000 1.000000 0.993858
ice_cream_sales 0.993858 0.993858 1.000000Questo output mostra:
Una correlazione perfettamente positiva tra temperature_celsius e temperature_fahrenheit (come previsto, come prima).
Una correlazione forte ma non perfetta tra ice_cream_sales e sia temperature_celsius che temperature_fahrenheit.
In R, puoi ottenere lo stesso risultato con la funzione cor() che abbiamo usato prima, applicata a un data frame o a una matrice:
# Create a data frame with two perfectly correlated variables and one unrelated
data <- data.frame(
  temperature_celsius = c(0, 10, 20, 30, 40),
  temperature_fahrenheit = c(32, 50, 68, 86, 104),  # Perfect conversion from Celsius
  ice_cream_sales = c(100, 150, 200, 220, 230)      # Generally increases, but not perfectly
)

# Calculate the correlation matrix
correlation_matrix <- cor(data, method = "pearson")
print(correlation_matrix)
temperature_celsius temperature_fahrenheit ice_cream_sales
temperature_celsius 1.00 1.00 0.99
temperature_fahrenheit 1.00 1.00 0.99
ice_cream_sales 0.99 0.99 1.00Questo output in R rispecchia l’esempio in Python, con:
Correlazione perfettamente positiva tra temperature_celsius e temperature_fahrenheit.
Forte correlazione negativa tra ice_cream_sales e temperature_celsius o temperature_fahrenheit.
Questo tipo di vista a matrice è particolarmente utile per identificare potenziale multicollinearità nella regressione o per scegliere le variabili per tecniche di riduzione della dimensionalità come la PCA.
Abbiamo visto che la correlazione cattura le associazioni lineari. Ora, facciamo attenzione a distinguerla chiaramente da idee simili.
Sia la correlazione che la covarianza misurano come due variabili cambiano insieme, ma differiscono in due aspetti: scala e interpretabilità.
Covarianza indica la direzione di una relazione lineare ma non la sua intensità in modo standardizzato. Il suo valore dipende dalle unità delle variabili, rendendo difficile il confronto tra dataset.
Correlazione standardizza la covarianza dividendola per le deviazioni standard delle variabili, producendo un valore senza unità compreso tra -1 e 1.
R-quadro (R²), o coefficiente di determinazione, può essere confuso con la correlazione. L’ho visto soprattutto quando si cerca di interpretare le prestazioni di un modello.
Correlazione (r di Pearson) misura l’intensità e la direzione di una relazione lineare tra due variabili.
R-quadro rappresenta la quota di varianza in una variabile prevedibile da un’altra variabile in un modello di regressione lineare. In regressione lineare semplice, risulta essere il quadrato dell’r di Pearson.
Non confondere correlazione e causalità! È un errore comune.
Correlazione mostra solo che due variabili si muovono insieme. Non spiega perché. Quindi è descrittiva, non esplicativa. La correlazione può essere dovuta a coincidenze, variabili confondenti o causalità inversa.
Causalità implica che un cambiamento in una variabile causi direttamente un cambiamento in un’altra. Rimanda la discussione sulla causalità a esperimenti controllati o alle tecniche di inferenza causale.
È importante conoscere le cose che più spesso gli analisti sbagliano:
In questo articolo abbiamo trattato il coefficiente di correlazione di Pearson, poiché è la versione di correlazione costruita direttamente sul concetto di covarianza ed è la misura più usata in pratica. Ma ora vediamo altri tipi.
La correlazione di rango di Spearman valuta l’intensità e la direzione di una relazione monotona usando i ranghi. È non parametrica e funziona bene con dati ordinali o con andamenti non lineari ma coerenti.
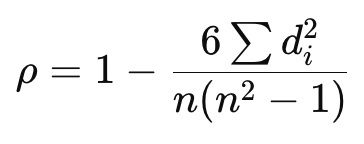
Dove:
Il coefficiente tau di Kendall misura anch’esso relazioni monotone usando i ranghi, ma si basa sul numero di coppie concordanti e discordanti. È più robusto in presenza di ex aequo e campioni piccoli.
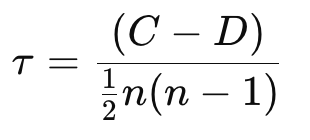
Dove:
Spero che questo articolo ti sia stato utile. Come hai visto, la correlazione è uno strumento fondamentale di analisi dei dati per comprendere le relazioni tra variabili.
Assicurati di seguire i nostri corsi per continuare a imparare. Ti consiglio lo skill track Fondamenti di statistica in Python o il corso Introduzione alla statistica in R come ottimi prossimi passi.
Impara con DataCamp
Corso
Corso
Programma
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min



